单张截图读得对,还不等于程序能自己从录像里找到有用的画面。这次不再手写几个容易识别的时点,而是交给它三段真实游戏录像:找到第一局开战,最多看到布阵结束后两分钟,再把结果按视频名称排成报告。
三段都完成了处理,共保留66张原图;英雄数字、行动卡、面板和部分魔法书已经能自动送到审阅页。 但它还没有读全敌军,也没有得到整场准确率。本文先看实际结果,再解释为什么“有输出”和“信息已经齐全”不同。
flowchart LR
 A[Original video] --> B[Find first battle]
 B --> C[Select short frame bursts]
 C --> D[Existing screenshot readers]
 D --> E[Values and unknowns]
 E --> F[Report per video]
图1:新工作是自动找图、调度已有读取器和整理结果,没有另训一个模型,也没有推断隐藏装备。
1. 三段录像,实际留下了什么?
三份原视频均为2560×1440,日期都是2026年10月2日。它们先前已经用于截图开发测试,因此本轮仍是开发回归,不是从未见过的验收集。下表的“开战”只是画面规则第一次连续通过的候选点,尚未逐帧标注真实的布阵结束事件。
窄屏可横向滚动表格,保留时间和字段的可读宽度。
| 文件名中的时间 | 开战候选 | 处理到 | 保留原图 | 自动采到的内容 |
|---|---|---|---|---|
00-44-09.901 |
411.985秒 | 450.685秒 | 12 | 英雄、行动条、预览候选;准备页拒识 |
01-21-14.461-partial |
402.025秒 | 521.026秒 | 30 | 准备页、英雄、行动条、面板、两页魔法书、预览 |
01-37-03.164 |
391.967秒 | 510.035秒 | 24 | 英雄、行动条、面板、预览;准备页拒识 |
第一份录像只有约451秒,先于两分钟上限结束;另外两份达到程序设定的截止时间。没有读到魔法书的那份,不能因此说玩家没有魔法:可能没有在窗口内打开,也可能采样错过了它。
本机逐场报告支持按文件名搜索、按时间展开每张图、放大原图和查看原始JSON。它需要这台电脑的标注服务运行;本文的图片与结论则可直接在公网阅读。
2. 数字读对了,为什么仍漏了一队敌军?
先看草地录像的一张开场图。上方一张生物卡代表一个可见的行动条条目,卡底数字是该条目的数量。战场上的身体下方还有红蓝数量牌,两处信息不能想当然地视为已经一一对应。
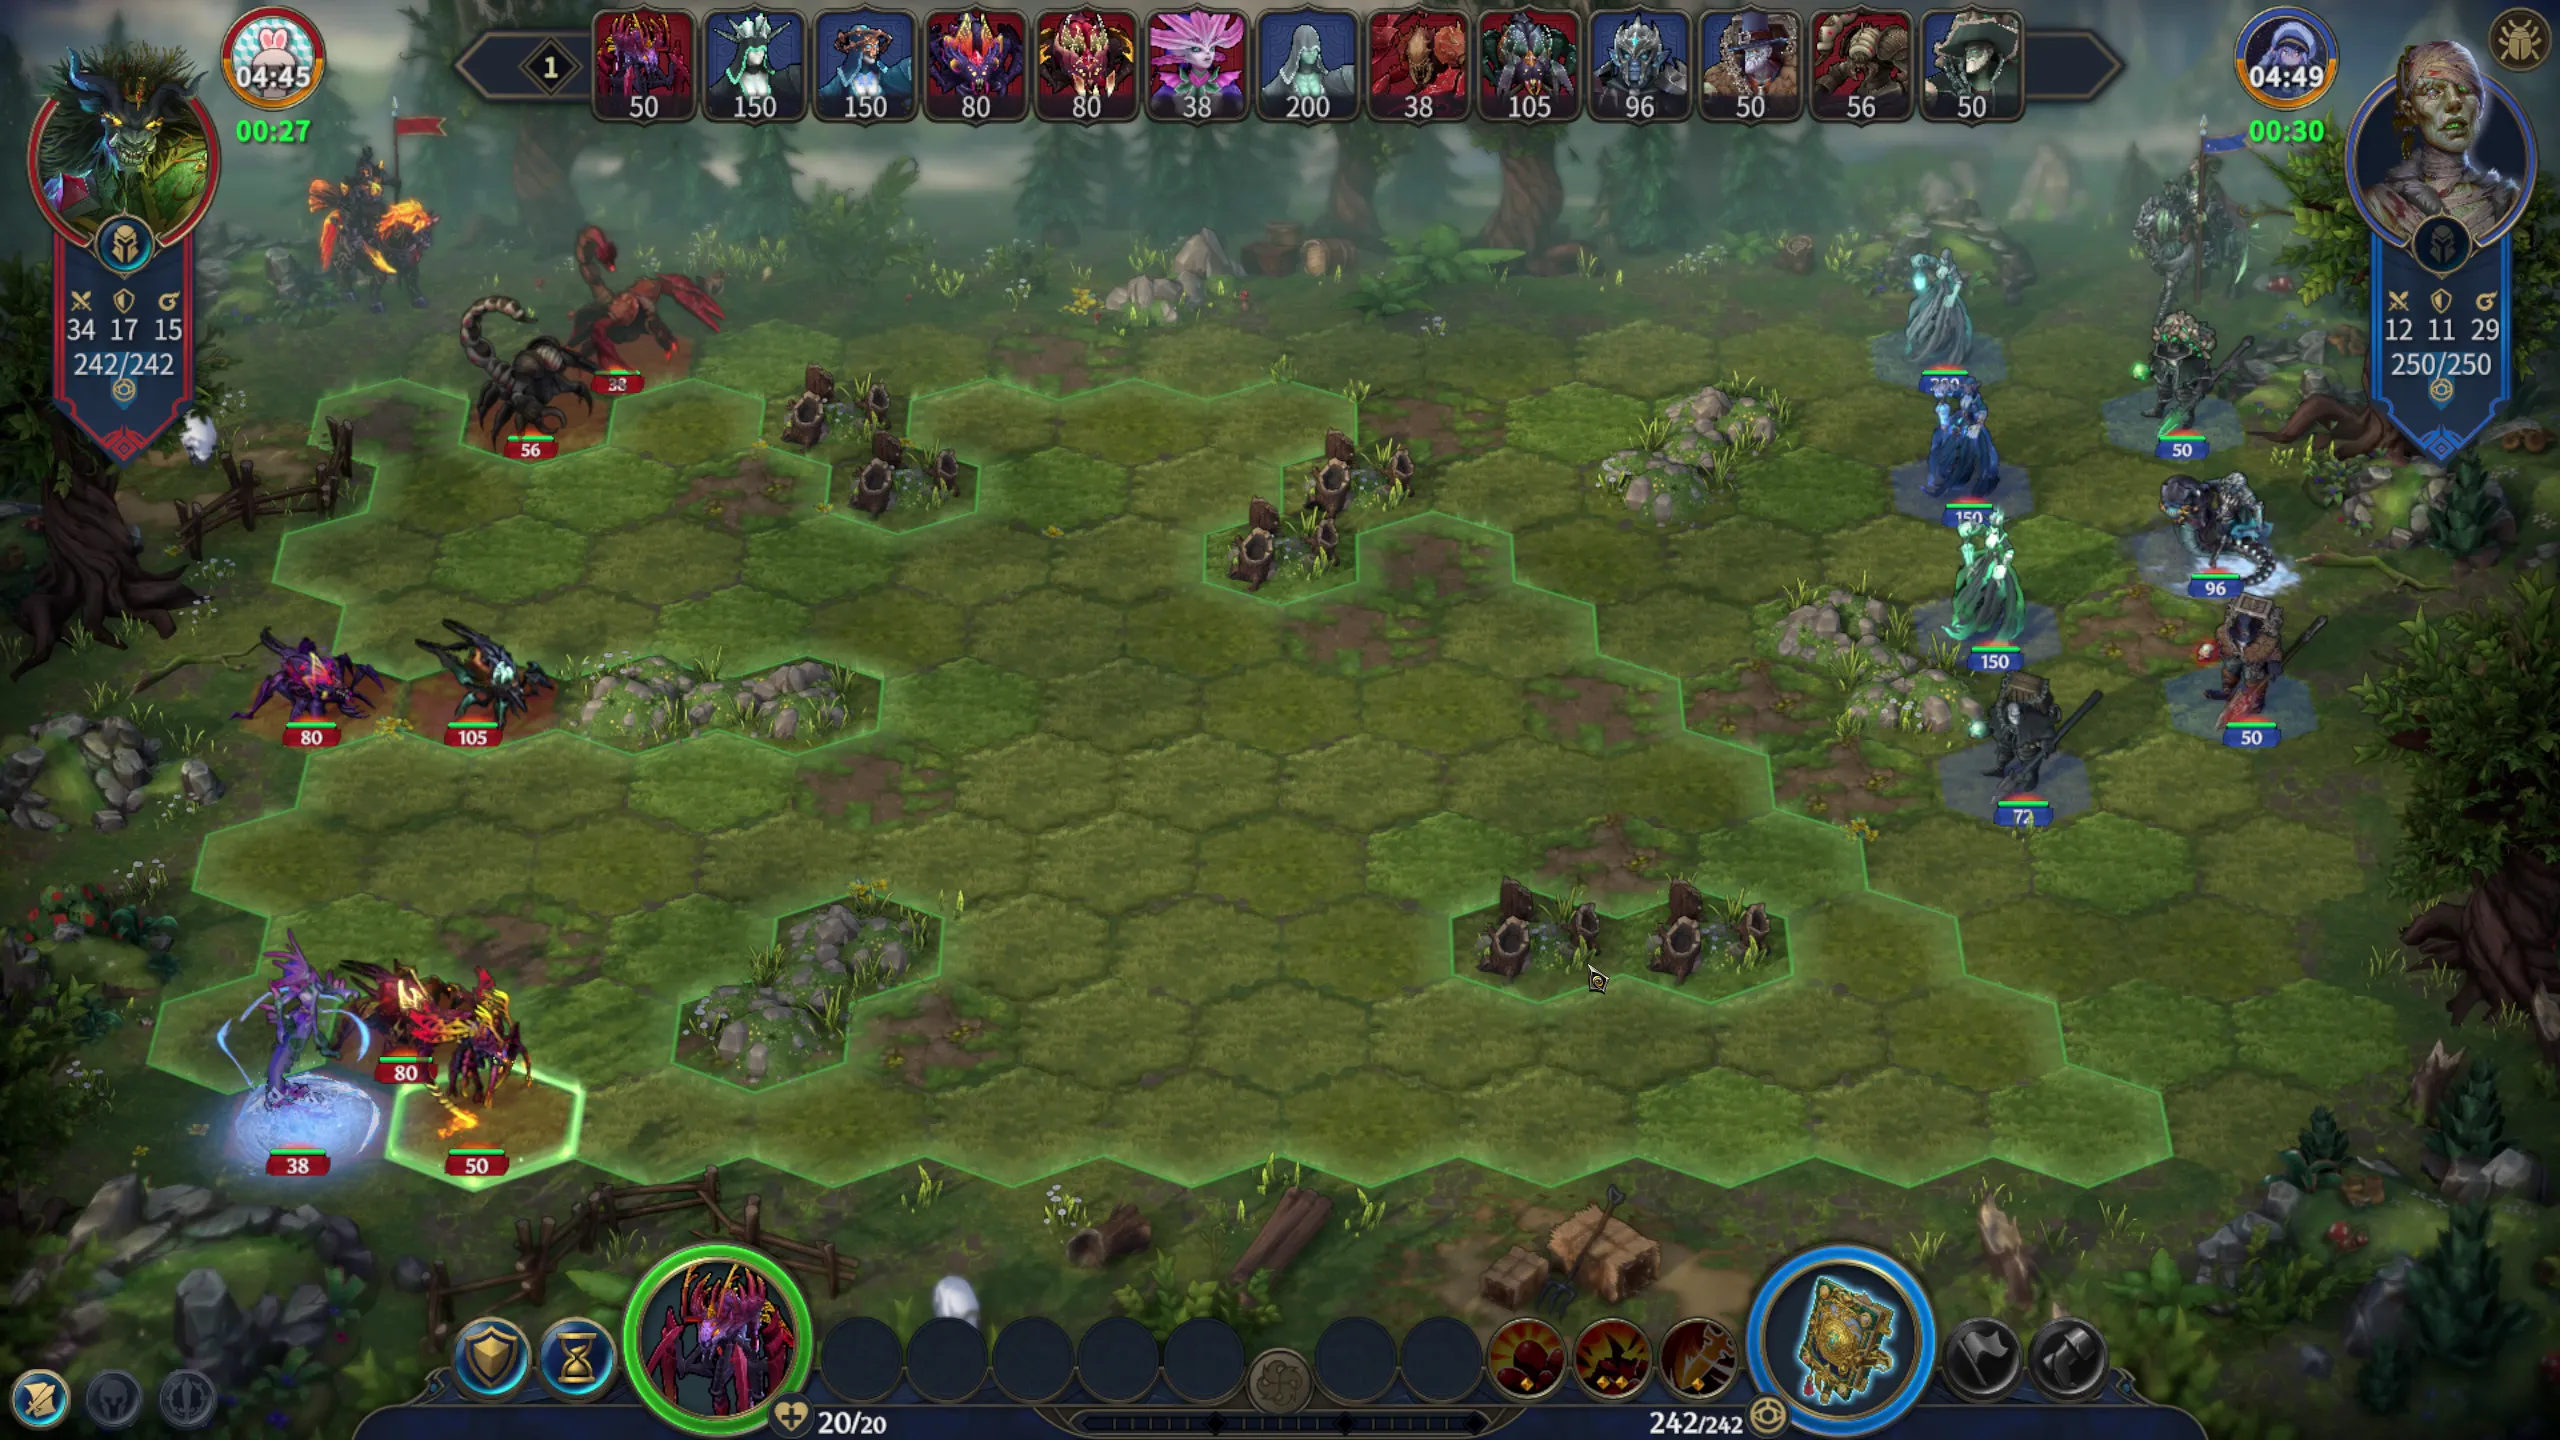
图2:412.986秒原图。程序读出敌方攻击12、防御11、法强29、魔法值250/250;但蓝方数量72的部队仍需从战场补全。点击可放大。
这张图里,兔子头像在左侧,因此右侧暂记为敌方。程序读到了右侧英雄的四组数字,以及六张可见敌方卡的数量:150、150、200、96、50、50。人工查看原图后,这些读数一致。
问题恰恰在没有进入这张列表的对象:战场上还能看到数量72的蓝方部队。即使六张卡全读对,也不能说找齐了敌军。接下来需要把身体、脚下数量牌和行动卡连在一起;两个同为50的单位,也不能按数量或兵种名称简单去重。
再看雪地录像。书页展开时第一张被拒绝,0.2秒和0.4秒后的两张各产生33个非空字段,对应11个可见法术的名称、消耗与显示等级。
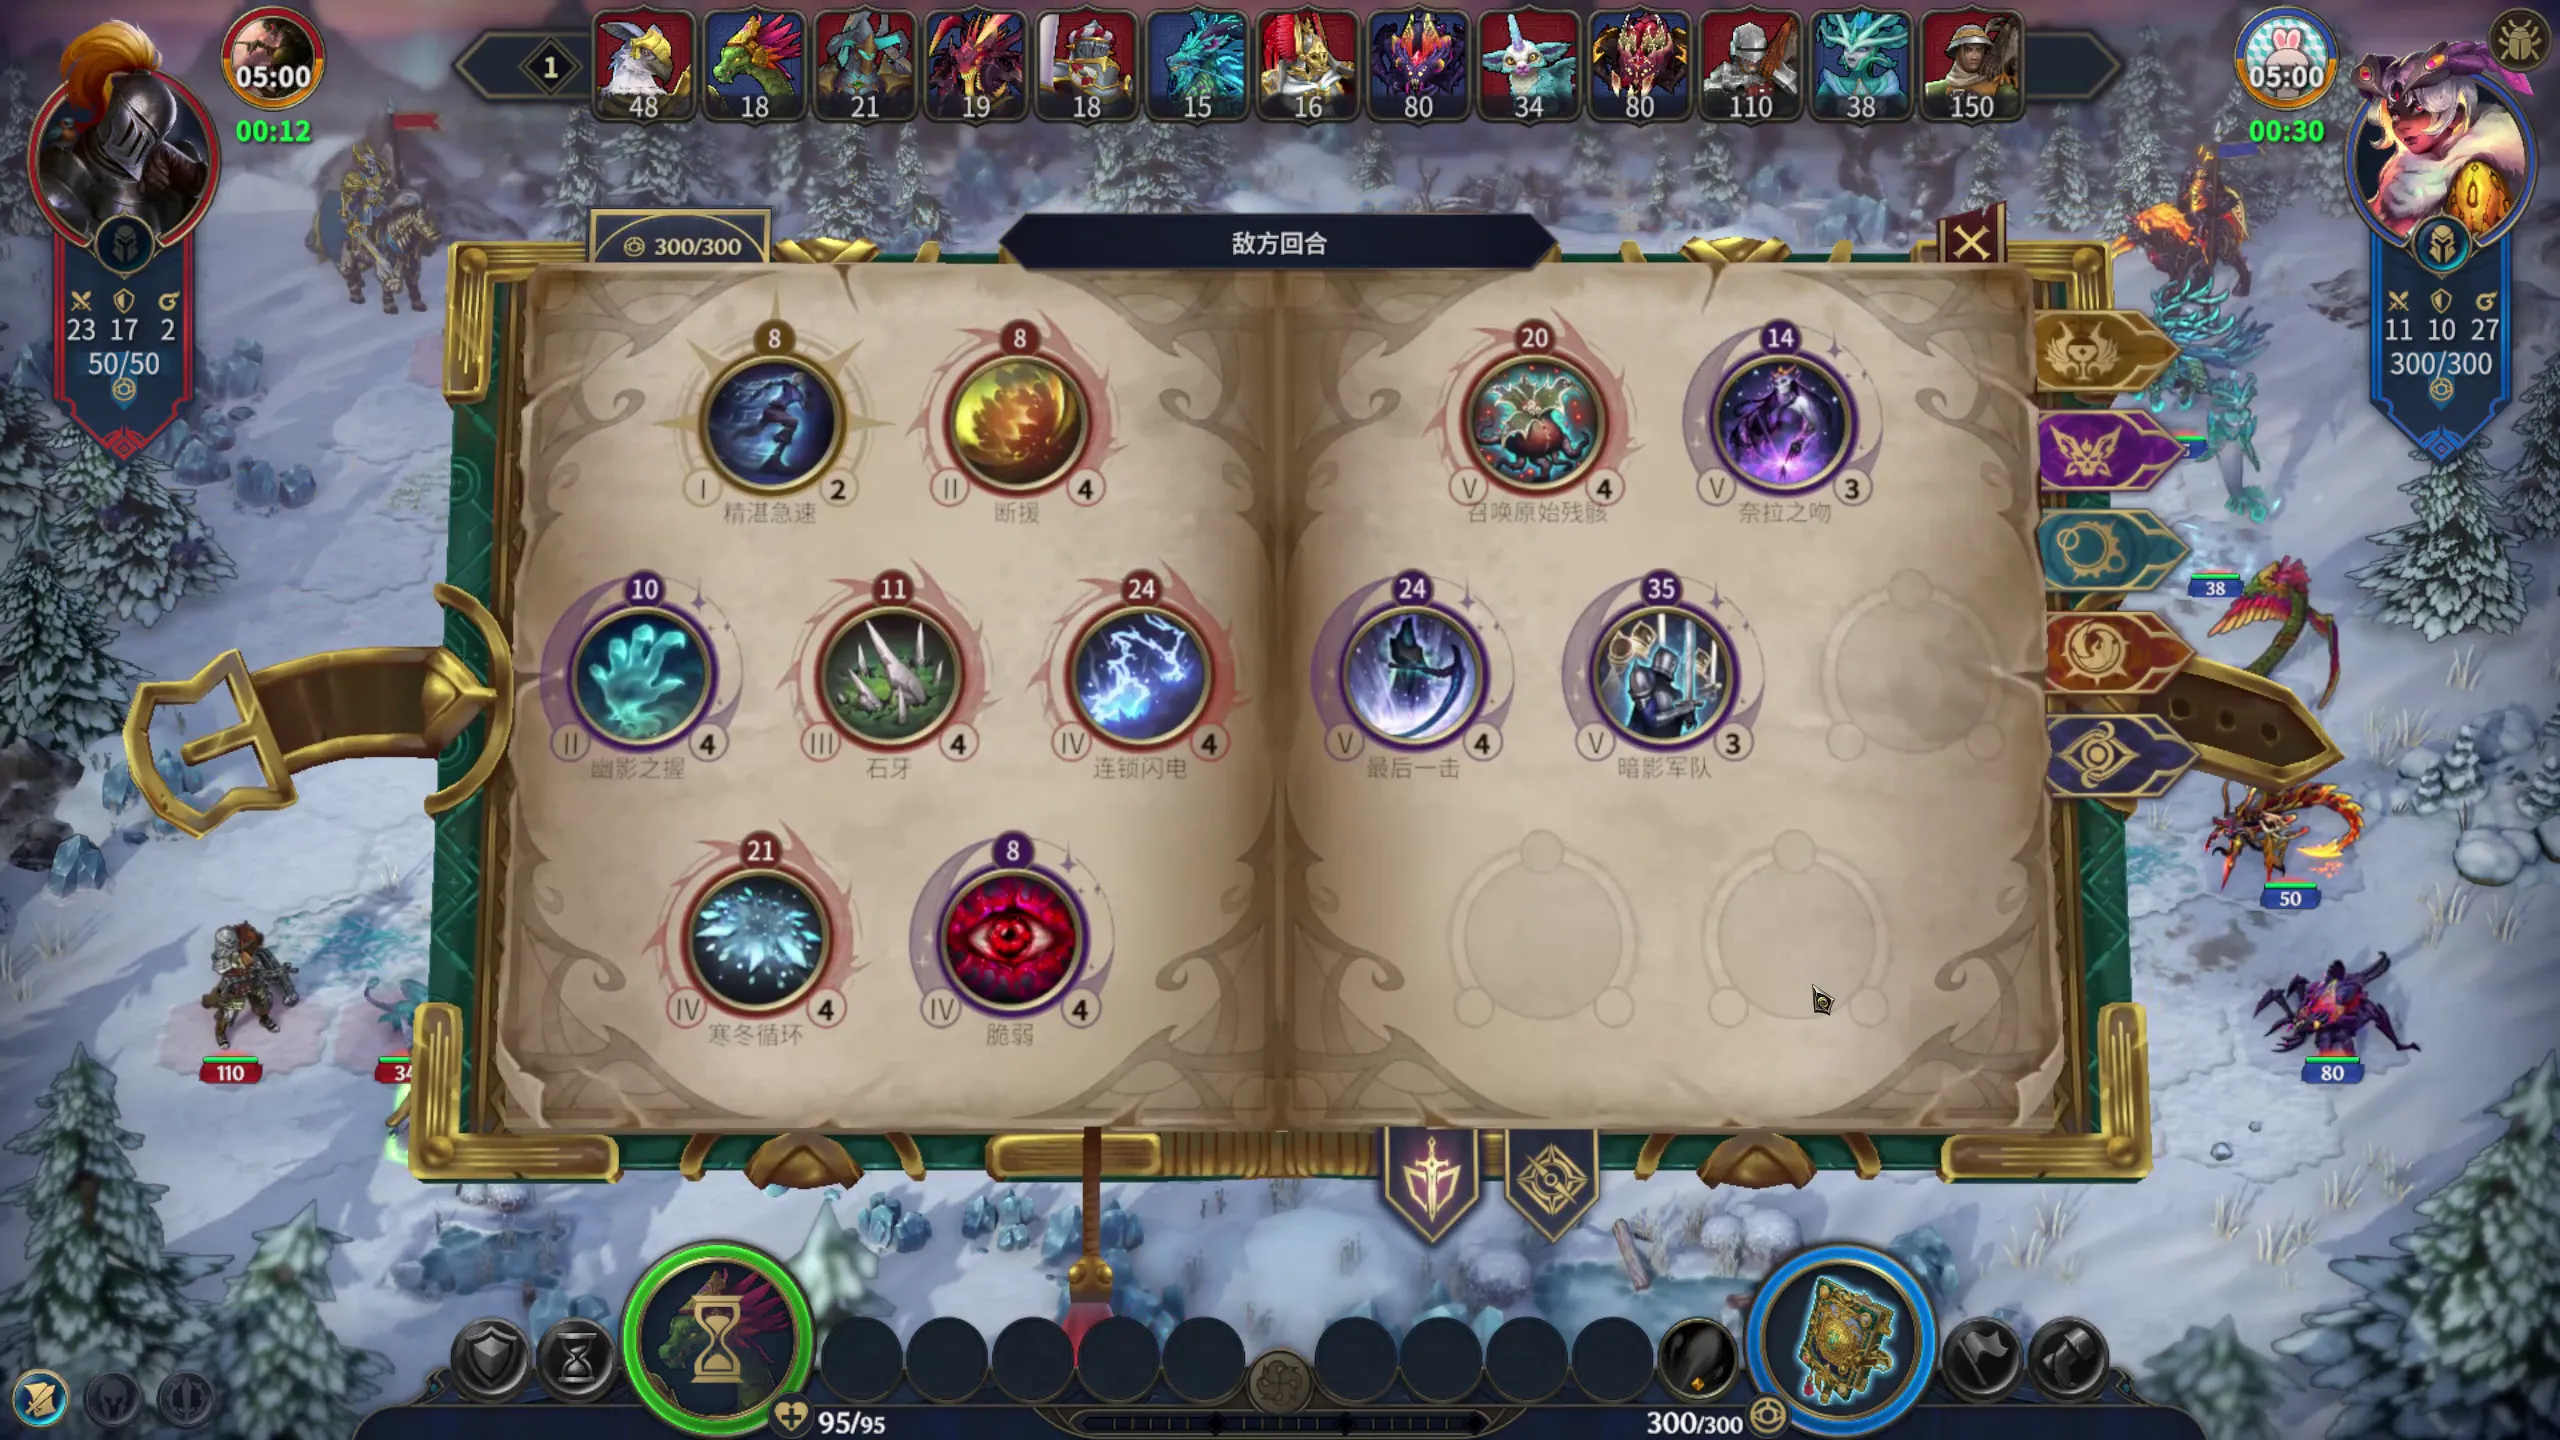
图3:418.189秒原图。这一帧有33个字段候选;“字段非空”不是这33项全部经过人工验收。另一页各有15项,两页不能直接当成完整法术列表。
保留相邻帧的价值就在这里:人能看见一次打开过程,也能看见算法何时开始输出。程序没有用后一张结果填回第一张,更没有把两张的一致读数自动升成已确认答案。
3. 怎样找到开场,又怎样控制工作量?
这条链路分四步,职责很窄:
- 找页面。 默认每秒取一帧,复用已有页面分类器帮助调度。准备页必须再通过自己的布局检查,不因为分类器说像准备页就直接填固定框。
- 找开战候选。 行动条、红蓝旗帜和双方可读英雄数字连续出现两次,才记录一个候选区间。它是视觉门槛,不是游戏内部的“布阵结束”事件。
- 选短窗口。 遇到面板、魔法书或数字预览线索,取当前、0.2秒后、0.4秒后三张。每类最多两个窗口,英雄/行动条最多三个;这会控制成本,也会漏掉后来更有价值的画面。
- 独立读图并报告。 复用App的单图读取器,左右两侧都读。兔子头像只帮助判断敌我,不确定就留未知;面板属于谁、是否带临时效果仍待关联。
比如雪地的候选区间是401.058—402.025秒,第二次确认在402.993秒。程序取区间左端加120秒,得到521.058秒上限;实际最后采样在521.026秒。这样不把确认延迟额外加到窗口里。如果前面的画面门槛误拒,整个候选区间仍可能偏晚,所以还需要开战边界参考,不能把这个规则当成严格事件识别。
重复解码到同一张视频帧时只计一次;真正解码时间超过截止则不交给读取器。后来补了连续两帧出现菜单、结算或新选秀时提前停止的规则,防止进入下一局。退出规则已经通过模拟回归,但本批运行早于这项补充,草地返回菜单后的拒识仍原样留在报告里。
这里的“视频处理”是按需定位解码的离线任务,不是每帧OCR,也不是App里的实时摄像流。现有App仍以单张截图为入口;视频导入、实时预览和模块状态页正在另行设计,不能把规划写成已经交付。
4. 现在到底好到什么程度?
这轮人工查看了每段最早的一张可读开场原图:敌方左右3/3一致,英雄攻击、防御、法强、魔法值共12/12一致,可见卡数量按原顺序20/20一致。只核对了这些字段;生物身份、全部截图、全部UI和敌方真实构筑没有完整参考。
这也不是此前“六场开场截图”的重复验收。那组实验中,可见卡识别很好,但真正敌方全军只覆盖38/42队,约90.5%,只有2/6场找全七队。两组都指向同一个缺口:先补没出现在行动条里的部队,而不是只优化已经清楚的数字。
耗时也不能只看一个漂亮数字。雪地任务曾因录屏掉帧、定位时间偏移而中断,修复后续跑。本批保留了初次失败和续跑记录;网页的“本次处理363.5秒”是雪地续跑这一次,不是从零处理全片的总时间。熔岩未中断的一次约605.4秒。它们没有统一冷启动和机器负载,当前不报告实时帧率或常驻延迟分位数。
66张选中原图与结果约283.8 MiB,不另存代理视频,也不逐框保存OCR放大图。两侧读取同一行动条时复用本帧匹配,换图立即失效。5432项Perception软件回归通过,检查了截止、重复帧、续跑和缓存等行为;这些测试不计入视觉准确率。
5. 代码、结果和视频分别在哪里?
下面路径相对于项目根目录 olden-era/。源码和人工参考由Git管理;原视频、截图、模型与生成网页在忽略的大数据目录里。公开博客不上传整段录像。
| 要找什么 | 项目内路径 |
|---|---|
| 离线调度和截图读取组合 | perception/src/olden_era_perception/first_battle_video.py |
| 报告生成器 | perception/src/olden_era_perception/first_battle_report.py |
| 本轮评估命令 | perception/modules/p120-observation-output/evaluation/first_battle_video_run.py |
| 三张开场人工核对 | perception/modules/p120-observation-output/evaluation/first-battle-video-review-2026-10-02.json |
| 三份原录像 | local_data/perception/recordings/captures-2026-10-02/ |
| 全部生成结果 | local_data/perception/reports/p123-first-battle-two-minutes-2026-10-02/ |
结果目录下,每段录像有自己的同名子目录。report.json记录扫描、边界、选图和错误;例如spellbook-00418189ms.json是418.189秒书页结果,旁边PNG是同帧原图。不要把三帧候选算成三场独立数据。
重跑命令、恢复旧任务和只刷新网页
& local_data/devtools/environments/perception/Scripts/python.exe -X utf8 `
  perception/modules/p120-observation-output/evaluation/first_battle_video_run.py `
  --video 'local_data/perception/recordings/captures-2026-10-02/HeroesOldenEra 2026-10-02 01-21-14.461-partial.mp4' `
--output local_data/perception/reports/first-battle-rerun重复传入--video可以批处理。新测量使用新的输出目录;只有原任务失败时才用相同参数加--resume。--report-only只重建网页,不运行识别。额外的--review只把人工核对加入报告,不传给识别器。
本轮已按作者要求把Captures中的已用录像整理到项目存储;三份10月2日录像早有完整副本,只移除了外部重复件。运行记录会指向保留位置,原始来源另留说明,避免重新从录屏目录把同一素材当成新视频。
6. 下一步:先补信息,再扩大视频量
优先补三件事:战场部队与行动卡关联;短面板和悬浮的采集率;面板属于哪方、哪支部队、哪个时刻。局部加密采样可以比较,但不能直接假设10 fps就会解决遗漏,也不用把全片每秒十张图全存下来。
另一条工作线负责App视频输入与运行状态,推断模块负责用游戏规则检验解释。Perception继续只报告可见内容和未知,不用推断结果替画面补值。
这次交付的是“录像自己找图,结果逐场可看”。它让漏项更容易暴露,却还没有让全场信息自动完整。想看整个系统的能力和各项成绩,从P00总报告开始;历史整帧组合与续跑在P120。
Comments