游戏录像里,大量画面只是等待。我们希望少处理重复图片,又别漏掉鼠标短暂停留时出现的说明。选帧组只决定哪些图值得读,不负责解释图上的数字。
这页先讲这组工作的用途,再列出现状。最新试验用三帧质量检查补回了一些短提示,但也留下半透明图片,暂不替换默认方法。P 编号表示责任,不表示已经完成;没有测过的质量和速度就写未测。
flowchart LR
  A["Original video"] --> B["Five-frame window"]
  B --> C["Check stability and change"]
  C --> D["Keep a clear frame"]
图 1:逐段查看原视频,在稳定且有新内容的区间留下清楚的候选图;这些图再交给文字和图标识别。
1. 先看一个例子
例如鼠标在状态图标上停留半秒:稀疏采样可能一张清楚图都没留下。下面已经按“一次提示有没有留下清楚代表”做了比较;三帧多留下提示,也带来了坏图。重复多少和完整视频覆盖率仍未统一测量,不能只数候选图片增加了多少。
2. 当前做到哪一步
现在程序直接读取原录像,每次查看相邻五帧,最多积攒 64 个窗口就计算一次;处理过的缩略图和特征随即释放。它不再先生成一段低清视频,也不把整段录像的缩略图留在内存里。
在同一段开发录像中,采样区间从 1 分钟增加到 10 分钟,样本从 600 张增加到 6,000 张,Python 的峰值内存约从 174 增至 175 MiB。10 分钟这次连同视频解码器约为 254 MiB,选出 262 张候选的时间约 69 秒。这里只测选帧,没有运行这 262 张图的 OCR;候选多不代表漏检少。
我们也检查了重构有没有改变选帧规则:给新旧程序相同的采样图,留下的区间和代表帧一致。不过,取消低清视频的有损压缩后,图像像素会变化;短对照中有一张代表帧提前了 0.1 秒。这需要后续看实际提示是否保留下来,不能仅凭程序跑通就说效果更好。
展开工程任务、各轮测量与接线明细
最后核对:2026-09-24 · 交付进度,不是完成证明
代码、历史报告与接线盘点;跨来源整帧验收未完成。统一环境的真实模型兼容检查见 p140,不计作准确率验收。
- 整帧准确率
- 未测
- 统一环境 p50 / p95 耗时
- 未测
- 独立录像 / 已审字段
- 未汇总
p50 是一半运行能达到的耗时,p95 是 95% 运行能达到的耗时。尚未在统一环境测量,不能用某个局部模型的速度替代。
p21 · 视频读取与时间
原型 / 待接入
活动视频入口直接读取原视频,取消采样代理;10 分钟、6,000 样本已实跑。选中段元数据仍累积,原始 PTS 与全链流式未验收。
p22 · 短提示采样
原型 / 待接入
三帧质量候选:新来源72点、5次可读事件由原五帧2次增至4次,但选中2张过渡;旧132点3/7→7/7也混入3过渡1未知。未采用、默认未改,待CTO、非全片验收。
p23 · 去重
原型 / 待接入
可减少相似候选;尚未单独测误删重要变化。
p24 · 稳定窗口与选帧质量
原型 / 待接入
P914三帧单独重训,旧89个C/T训练,新72点先标后测;11过渡中漏2且两张均被选中。新增12项测试覆盖三帧/五帧输入及模型版本隔离;仍不能保证排除半透明,默认不变。
已有测量能说明什么
三帧候选新来源留下的可读事件:4/5 events。 人工选3片段72点,原五帧2/5;新法同时选中2过渡,故未采用。61C/11T,参考待CTO;非单窗口变量消融、非随机整片或独立产品验收。
短提示与面板开发片段保留事件:3/7 events。 两录像6片段132点,7次有清楚样本事件;4漏均在稳定门,代表选择另漏0,变化候选补0。109清楚/20过渡/3不确定;旧18点单列。助手待CTO,非全视频或独立验收。
首轮新旧组合仍误放行的过渡帧:1/5 frames。 两段录像留出开发测试;同时拒绝10/27清楚帧,与旧模型相同。不是整段提示召回或独立验收。
下一步:短窗口本轮收束,保持默认。09-24两录像六个固定区间已跑完,留下32候选;后续补整帧UI参考和缺失模块,不再调这些曝光图。当前210/150/72点和新32候选均不再是未见测试来源。
半透明过渡:比“有没有动”多问一个问题
打开生物面板时,文字已经出现,底下的战场却还透出来。回到原录像看,370.014 秒仍是这种混叠画面,370.114 秒就清楚了。我们的目标很简单:跳过前一张,留下后面可读的一张。
这里先纠正一个容易误解的地方:原坏图来自旧的场景扫描,不是当前五帧选帧器挑出的。重新跑连续视频,原五帧方法就会跳过它,并在同一次打开面板中留下 371.0 秒的清楚画面。因此,不能拿这一个例子证明原选帧方法失败。
不过,小悬浮的淡入仍可能漏过。我们实际训练了两版小分类器:一版只看当前图的颜色、纹理;另一版还看相邻五帧的变化。训练用了两段录像里的 57 张助手目视标注图,另两段录像的 32 张整段留出,不把同一次悬浮的邻帧分到训练和测试两边;标签仍待 CTO 复核。
| 留出录像上的方法 | 5 张过渡图中误放行 | 27 张清楚图中误拒绝 |
|---|---|---|
| 原五帧稳定方法 | 1 | 10 |
| 只看当前图的新分类器 | 4 | 2 |
| 当前图加相邻变化的新分类器 | 1 | 2 |
| 原方法通过,并且新分类器也通过 | 1 | 10 |
第一轮训练还没有带来测试改善,所以不替换默认算法。 单图模型在训练图上很好,换录像就认不好;加入相邻变化后好一些,但仍漏过一张正在淡入的小提示。这些录像也曾被其他实验看过,表格只是小样本开发测试,不是整个产品的独立准确率。
逐帧判断还不是最终结果:有些清楚图因为前后正在变化被拒绝,同一段提示却仍能留下别的清楚图。我们另外跑了四个连续片段;新方法在训练录像里把九张候选减成七张,六个状态说明仍有可读代表。两段留出录像的结果没有改变,而且绿色地图短暂出现的“天堂之刃”仍漏掉了。查看标注、相邻帧和真正选出的图片。
这次没有保存成百上千张中间截图:必要拼图、来源时间、标签、两个小模型和报告合计约 5.1 MB。新增过滤已经能在私有试验入口跑起来,但普通录像入口仍用原方法。
3. 看得更细,是否就能认出淡入淡出?
上一轮仍会漏过小提示的淡入。这次我们试了一个直觉:别把全屏缩得太小,保留更细的图像,再比较面板附近小块的纹理和变化。这个研究编号是 P914,它为选帧组和场景组提供质量检查候选。
我们确实重新训练了分类器,但结果是:这一版不值得加入默认流程。 在新取的三段录像、七个短片段中,旧方法已经挡住全部 15 张过渡图;新分类器单独使用反而放过 5 张,叠加在旧方法后也没有再挡住任何坏帧。
| 方法 | 15 张过渡图中误放行 | 192 张清楚图中误拒绝 |
|---|---|---|
| 旧五帧稳定方法 | 0 | 35 |
| 新的局部质量分类器单独使用 | 5 | 0 |
| 两者都通过才保留 | 0 | 35 |
“清楚图零误拒”看上去很好,但它同时放进了正在淡出的选秀卡片、英雄面板和生物面板。我们需要的是留下可读图片,而不是让某一列数字更漂亮。
再看真正的选帧结果:三种处理方式都留下了 13 张代表图。选秀卡片、英雄面板右侧的提示、生物面板、打开后的法术书,这四次检查到的内容都有清楚的一张。新质量检查总共用了约 13.06 秒,原方法约 4.50 秒;这七段每段只有三秒,是单次运行计时,不是整场游戏的速度统计。
有四张代表的时间变了,但原因是高分辨率图再缩小后像素不同。专门去掉新分类器、只保留同样缩放的控制组,选出的区间和代表与新方法完全一致。因此不能把换了代表图当成质量改善。
打开 P914 相邻帧、标签与最终代表图。书页里重复出现的英雄魔法值不作为新任务;仍以英雄信息区和每个法术的费用为主。
这些数字怎样得到,有哪些不能据此下结论?
旧四段录像的参考已全部看过,这次其中 89 张用于训练,1 张不确定排除。另三段录像的 210 个中心时刻先目视标注,再看新模型的预测;192 张清楚、15 张过渡、3 张不确定。标签只检查中心面板区域,仍待 CTO 复核。相邻帧不是 210 次独立事件,这些录像也被其他任务查看过,所以这里只叫开发对照,不叫独立产品验收。
新方法输入 1280×720 的相邻五帧,把旧特征与五个固定区域的小格统计交给固定随机森林分类器;没有根据这次答案调整门槛。逐帧检查用原录像定位,连续回放另用实际流式解码器核对,二者采样并不保证逐点相同。只保存必要拼图、小模型和结果,没有另存视频或大量逐帧截图。
4. 图明明清楚,为什么一次提示仍没留下?
提高分辨率没有解决问题,我们换了一个检查角度:不再只数多少张图被拒绝,而是先在原录像里找出“一次提示出现”,再看它有没有留下一张清楚图。
新找的两份录像中,我们先标注六个片段的 132 个采样点,再运行原算法。7 次确实有清楚样本的提示或面板,只留下 3 次;另外 4 次都在稳定判定时被拒绝。 它们还没进入最后“每段挑一张”的步骤。这里包括法术说明、短暂生物面板和一个较长英雄面板对照,不是整个视频的提示召回率。
例如下面的羊人面板,先淡入,随后已有清楚画面,但很快又关闭。10fps 已经采到三张清楚图;五帧窗口却还包含周围的过渡,因此没有保留这一面板。
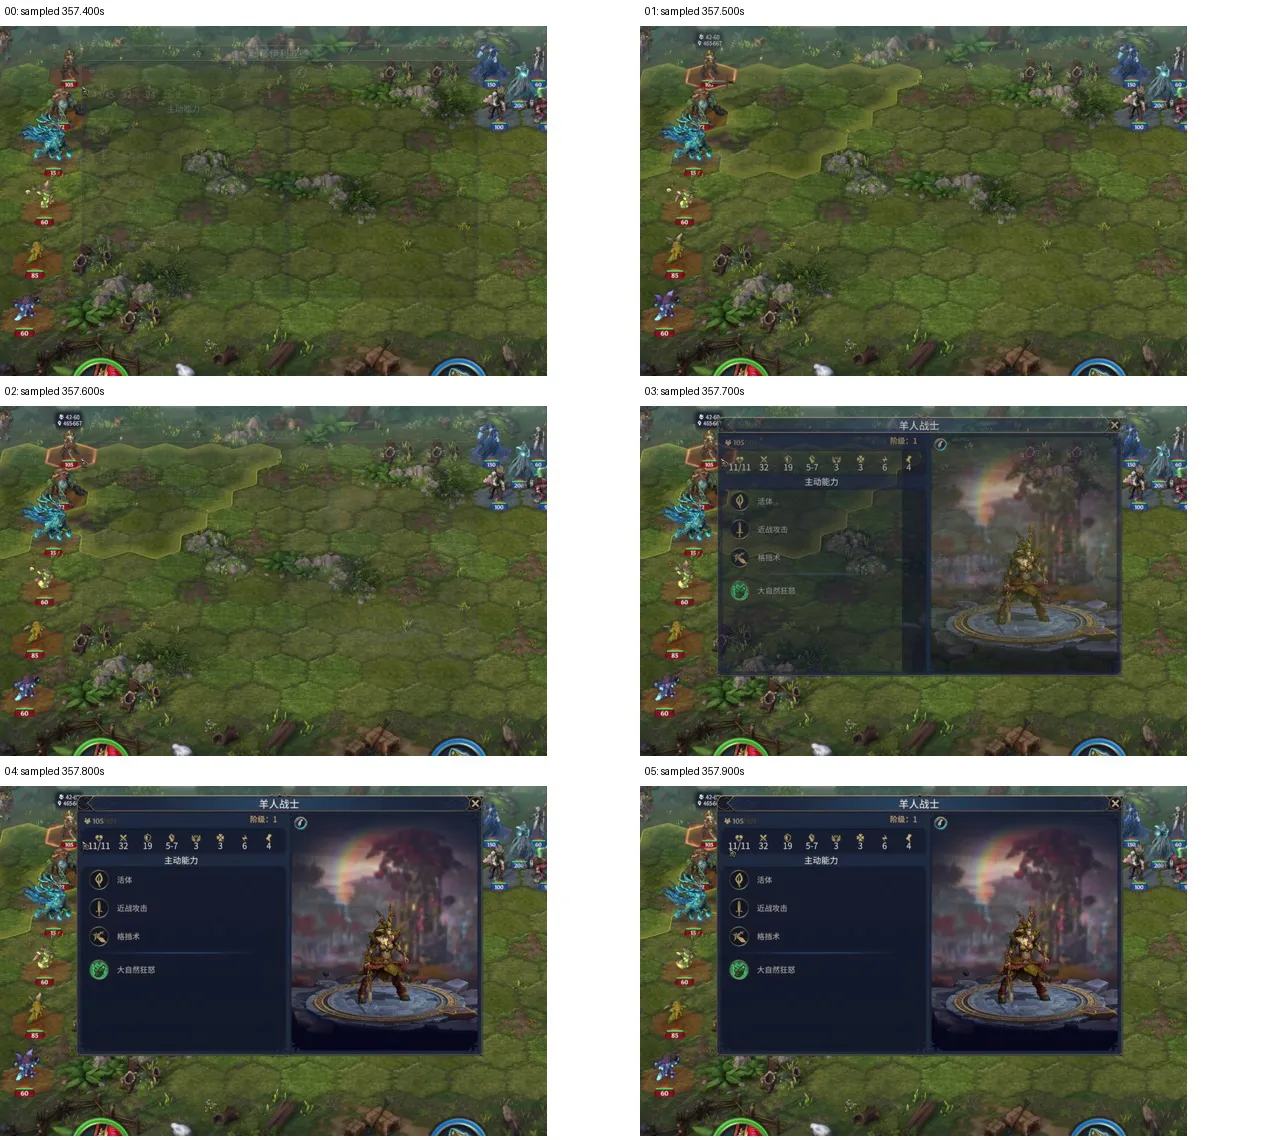
图 2:同一原录像的相邻采样图。357.7 秒仍在淡入,357.8 和 357.9 秒已清楚;后一页的 358.0 秒也清楚。算法仍把这次面板全部漏掉。图片时间是近似采样刻度。
| 这次检查的问题 | 结果 |
|---|---|
| 有清楚样本的事件留下几次? | 3/7;其余 4 次全被稳定判定拒绝 |
| 最后挑代表时又丢了几次? | 0 次 |
| 最终选出的 12 张有明显过渡吗? | 被审中央区域没有 |
| 原有“画面变化候选”能补回吗? | 不能;还提出了 9 张过渡图和 1 张不确定图 |
“变化候选”是在画面变化时提醒我们复查的另一条分支,不负责保证图片清楚。直接把它的输出并入关键帧,会重新带回我们想避开的半透明画面。
查看每次提示、相邻图片和角落的质量标签。C 表示被审区域清楚,T 表示过渡,U 表示看不准。另两次出现没有确认清楚的采样点,单列而不硬算漏选;旧录像的 18 个诊断点也不混入新来源成绩。所有参考仍待 CTO 审阅,没有用于训练。
怎样避免“评分的是另一帧”?
本次人工审阅和算法使用同一个 10fps 解码序列:先保留 1280×720 供人查看,再缩成 320×180 给原算法。结果按相同图号匹配,不拿附近一张清楚图代替本帧。它也不等于默认直接解码到 320×180 的像素完全一致回放。
七段共 15 秒、178 个含前后补充的解码样本,单次运行约 4.70 秒,含约 0.96 秒模型加载;不含人工找片和审核,不是整片速度统计。只保留必要拼图和小型结果文件,没有展开保存视频帧。人工挑片、片段边界和相邻点相关性,都限制了这些数字的推广范围。
5. 少看两张邻帧,能否留住短提示?
既然周围的过渡会让清楚图被拒绝,我们又试了更短的观察范围:只看当前图和前后各一张,同时检查面板附近的纹理。采样仍是每秒十张,三张图的首尾相隔 0.2 秒。这样,一次很短的提示也可能有完整的三张清楚图。
这不是把原五帧模型直接拿来处理三帧。我们用旧四份录像的 89 张可用参考,重新训练了三帧质量分类器,固定参数和门槛。最后“每段挑一张清楚代表”的办法没有变。原五帧稳定模型与新分类器不同,因此下面的改善不能全部归功于缩短窗口。
再从另一份录像找出三个短片段,先逐图标注 72 个采样点,再看预测。结果是:5 次有清楚样本的提示或面板,原方法留下 2 次,新方法留下 4 次;但新方法也把 2 张明显半透明图片选成了代表。
| 新录像的三个片段 | 原五帧稳定 | 三帧质量 |
|---|---|---|
| 5 次可读内容中留下几次? | 2 | 4 |
| 最后留下多少清楚图? | 7 | 14 |
| 最后混入多少明显过渡图? | 0 | 2 |
新方法补回了一个短暂的召唤法术提示和刚打开的英雄面板。生物技能“黑冰碎片”的说明只在一个采样点确认清楚,两种方法仍没留下它。这里数的是已采到的图片,不能说它在原录像中实际只显示了 0.1 秒。
下面是另一个失败例子:07 号提示还在淡入,08 号已经清楚。三帧方法最终选了半透明的 07 号,也选了后面的清楚图。多留一张好图,不能抵消同时混进一张坏图。
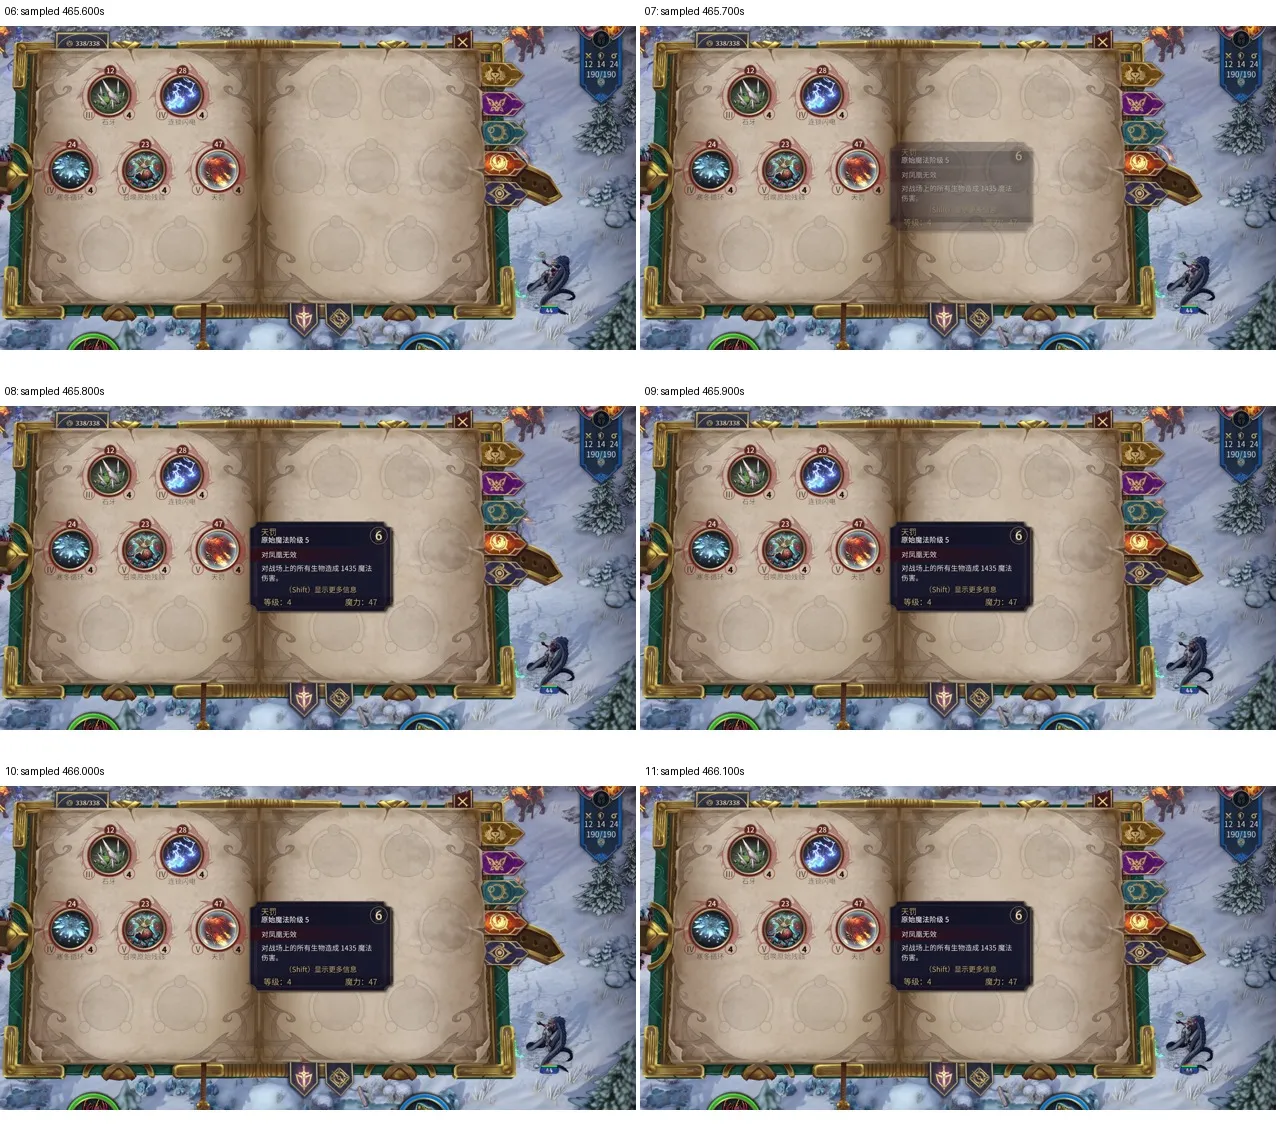
图 3:465.7 秒的 07 号是这次新方法留下的坏代表;465.8 秒的 08 号已可读。时间为近似采样刻度,图片标签不表示算法预测。原始相邻图帮助我们看到表格背后的实际错误。
把“旧方法或新方法任一通过”也试了一遍,最终代表没有改善。上轮已看过的 132 个开发点则从留下 3/7 次内容提高到 7/7 次,但也混入 3 张过渡和 1 张看不准的代表。因此这一版不接默认流程,也不把 7/7 写成关键帧问题已经解决。
打开三帧对照:逐次内容、所有相邻图和三种方法的代表。新来源与旧开发点分开显示;这批图片仍由助手标注、待 CTO 复核。它是人工挑出的少量片段,不是随机全视频准确率。
复现与时间:三帧检查仍是离线候选
新 72 点、旧 150 点和更早的 210 点都没有用于这次拟合或调门槛。三帧输入 1280×720,163 维颜色、纹理和变化统计;随机森林固定 200 棵树、最大深度 6、最小叶节点 2、类别平衡、种子 44、拒绝门槛 0.5。训练与五帧权重有不同版本,程序禁止混用。
人工审阅与预测使用同一组解码图号。三帧中心需要后面 0.1 秒的图片,五帧需要 0.2 秒;最后选代表仍要等片段结束,不能当成在线系统当时已经知道的结果。222 个中心点的整轮比较用了约 9.19 秒,包含解码、模型加载、对照和选择,不含 OCR 或人工标注,也不是单模型速度。旧模型加载时有依赖小版本警告,当前五帧对照与原选择器及上轮记录一致,仍不能保证所有输入上的跨版本兼容。
新留 12 张必要的审阅拼图和小型结果;原录像不复制,旧拼图直接链接复用。完整协议和结果位于项目 P914 实验目录。
6. 接下来怎么推进
选帧现在能减少等待画面,但短提示仍会漏,新质量检查也还会放进半透明图。这一轮试验到此收束,不再对已经看过的片段反复调参。下一步回到完整画面的 UI 清单和跨录像检查,把失败分清楚:没选到图、场景判断错、没找到元素,还是文字读错。短提示补样可使用这次研究候选供人工检查,不能直接当作合格关键帧。整帧识别验收仍未完成。
Comments