配套阅读:P912:试过哪些办法,为什么还会漏。 它把数量牌支持、降阈值、局部重检和联合大框训练放在同一批图上比较;有效和失败的方法都保留。
P82 · 战场生物检测与身份 · 实验记录与相关篇目
新增 360 帧已完成审核:3,783 个活体框及身份;另保留 24 个非活体裁图和 12 个尸体框。本篇保留此前两轮 96 帧模型测量,新数据的独立检测器比较已放入 B13;不包含跨帧跟踪。
在《英雄无敌:上古纪元》的生物选择页,名称和图标出现在固定位置。到了战场,生物会移动、转身、互相遮挡,屏幕也不再给每个单位显示名字。我们希望输入一张战场截图,得到每个存活部队的位置框和具体生物名称。
这包含两个问题:先找到部队,再认出生物种类。 框找对了,名字仍可能认错。目前保留的第二轮模型在同一批新测试画面中,框和身份同时正确的目标从 74/167 增加到 83/167;有改善,但离可靠的自动标注还有距离。
两轮模型实验共涉及 14 个录屏标识、96 张原图、1,108 个框。后来参考数据扩充到 722 张,不代表模型已经用新增数据重训。只想了解现在能用什么,可以先读第 10 节:当前保留的 FCOS 检测器负责找框,ConvNeXt 分类器给出前五个身份建议,仍需审核。
阅读顺序是:先看目标与两轮模型实验,再看扩充数据。更大数据集上的检测器比较另见 B13,不与本文的小批次结果合并。
如果关心“现在还能怎样少漏几个身体”,可以接着看身体与数量牌的联合定位对照。它使用 B13 的强身体基线,比较数量牌支持、数字条件、局部重检和联合框辅助训练。本文的 75.39% 是旧模型的定位 F1,不是当前召回率;找对身体位置也不等于认对物种名称。
flowchart LR
 A[Full battlefield screenshot] --> B[Detect visible troop stacks]
 B --> C[Crop each candidate]
 C --> D[Classify catalog identity]
 D --> E[Overlay boxes and names]
 F[Reviewed boxes and identities] -. Offline training and evaluation .-> B
 F -. Offline training and evaluation .-> D
图 1:检测器回答“在哪里”,分类器回答“是谁”。审核数据用于训练和评估;运行时不把人工框交给检测器。
1. 检测的是场上存活的部队
一个框对应一支可见部队,数量可能是 1,也可能是 200。框包围画面中可见的生物、坐骑和装备,尽量不包含脚下数量、光圈和影子。行动顺序栏中的头像、左右英雄头像、场边英雄模型、石头、树、尸体和短暂法术特效都不算目标。
输入的场景已经由前级确定为战场。这是 B021/B022 之后的场景内部理解模块;本篇不重新测场景分类,也不读取攻防数值、推断占据哪个六角格或维护跨帧部队 ID。
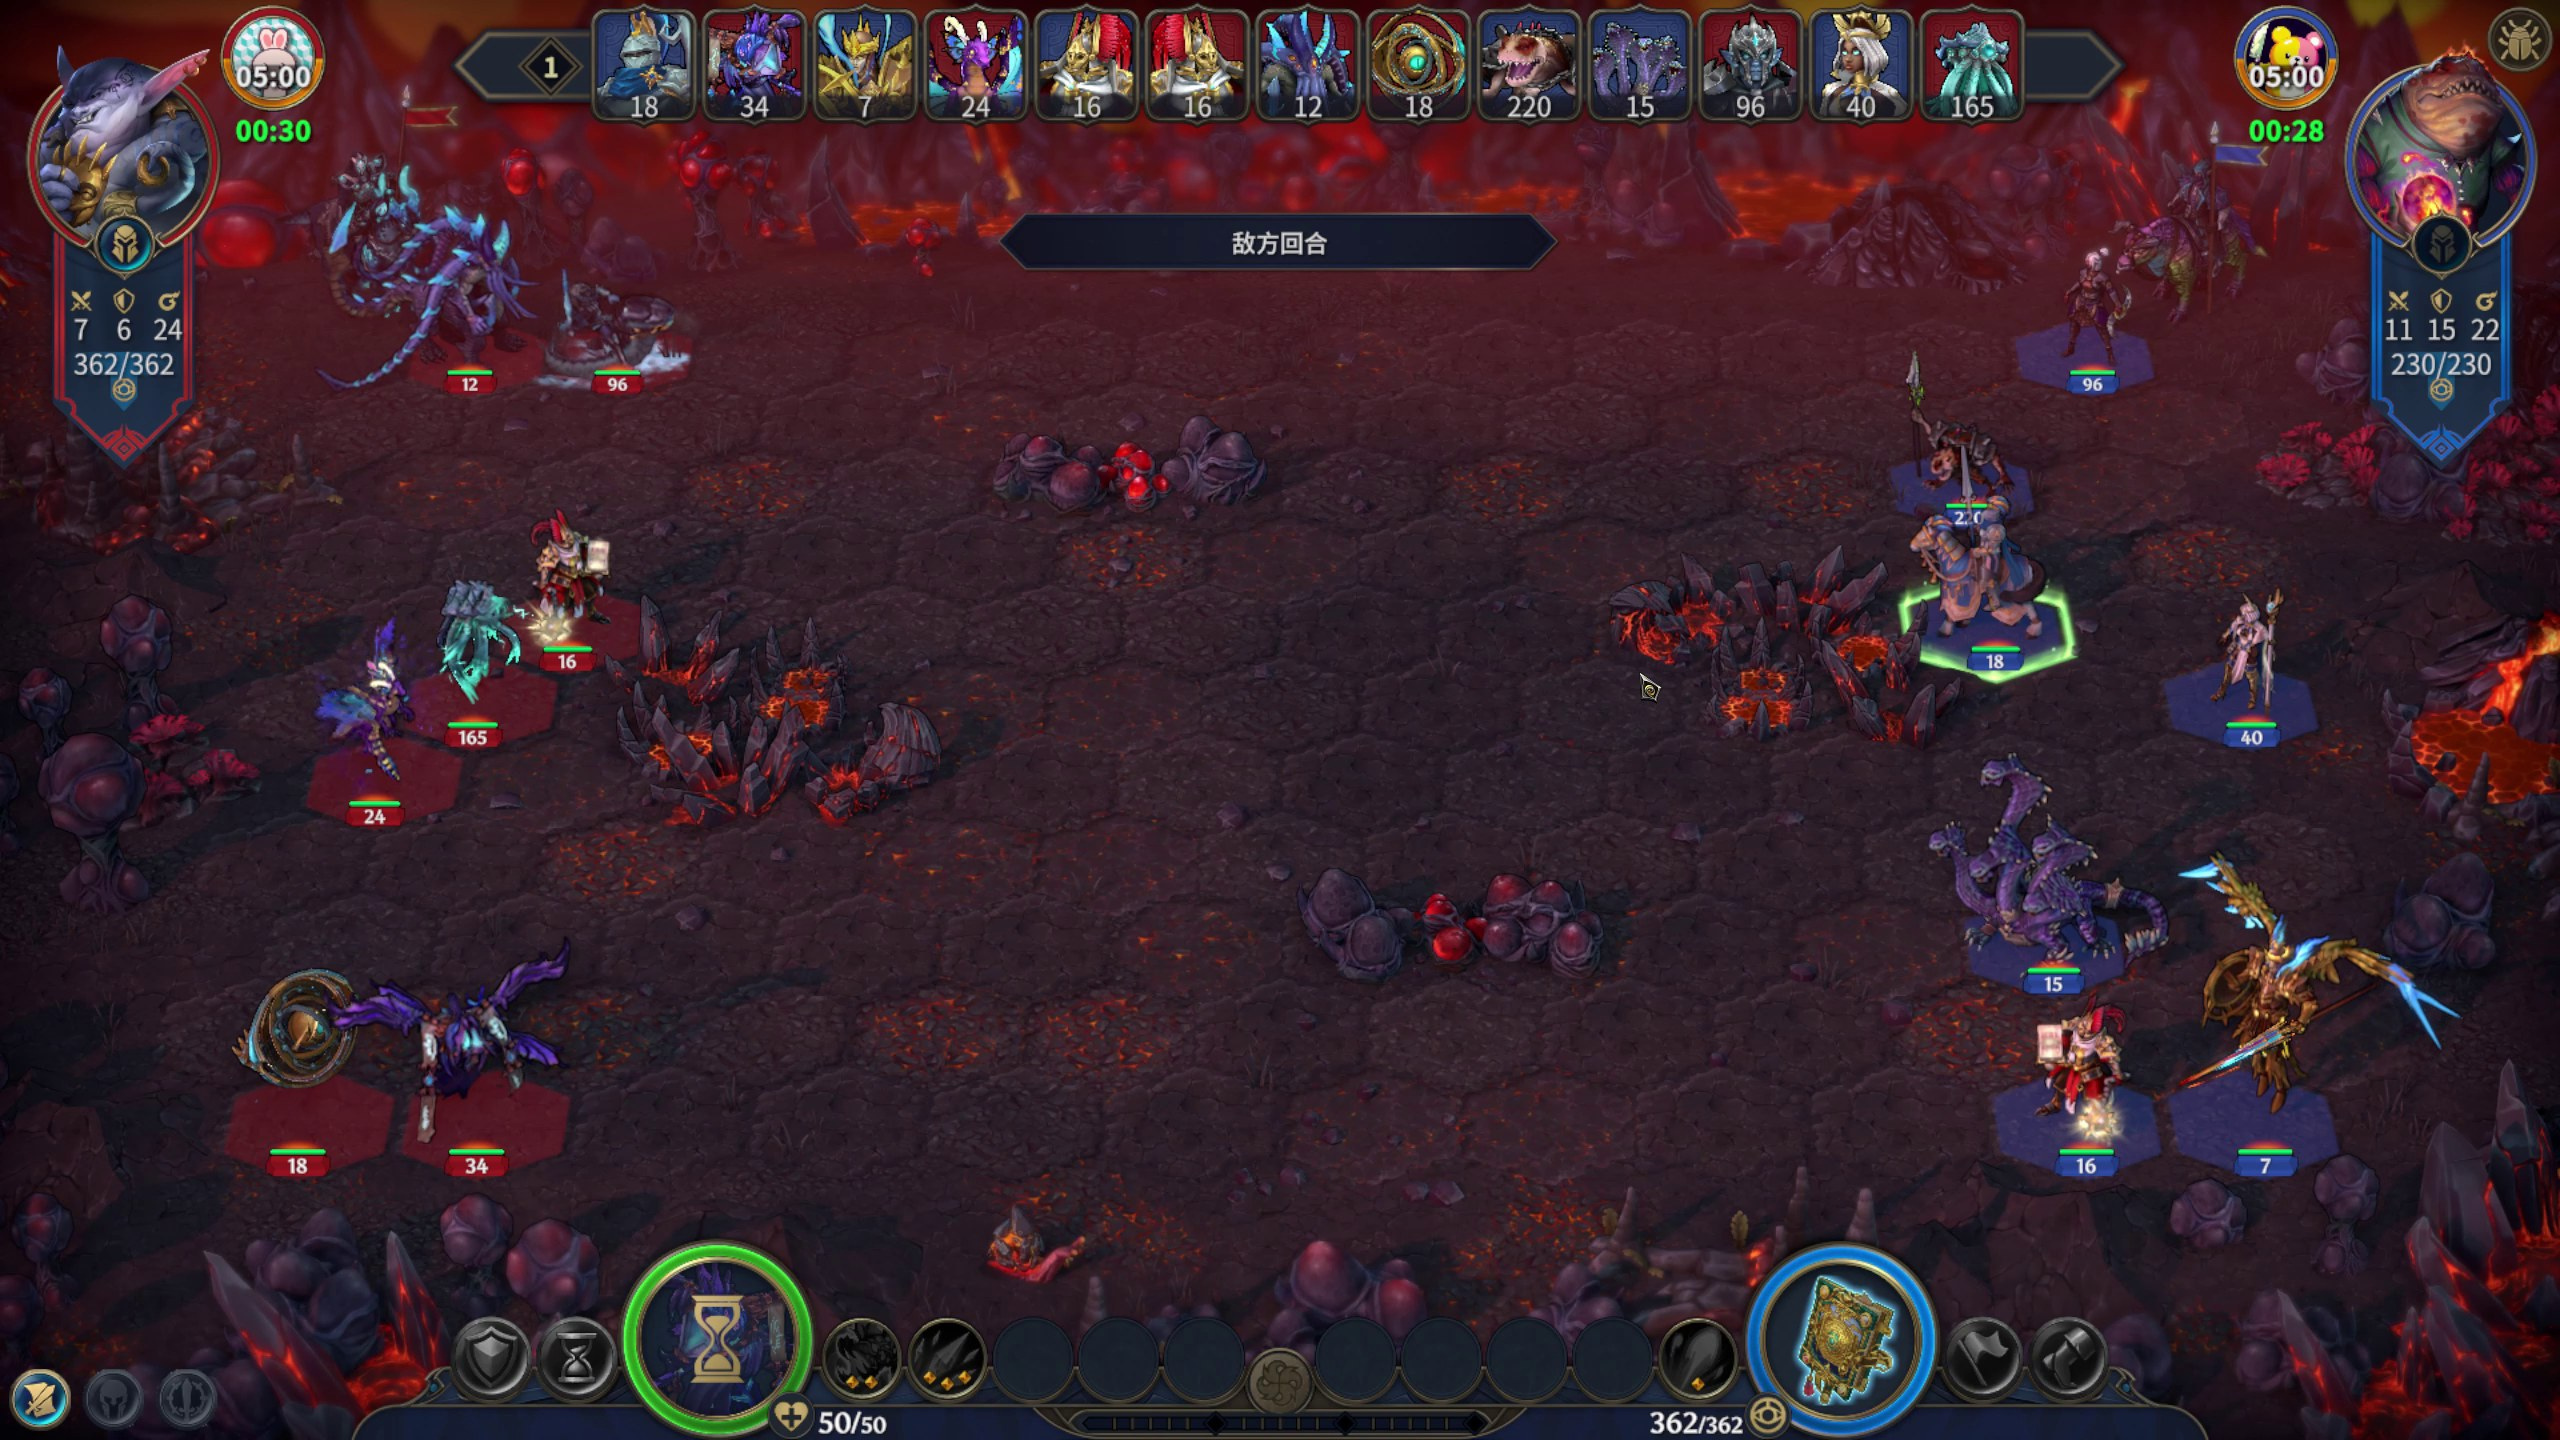
注意画面上同一类别可能出现两支部队。例如两边都可能拥有绝罚者。分类相同不表示它们是同一支部队,跟踪还需要位置、阵营和前后帧证据。
2. 先审核真实战场框,再隔离视频评估
后来的 722 张参考数据,和下面的模型实验是什么关系?
截至 2026 年 9 月 8 日,两批审核数据共 37 段录屏、722 张原图、7,651 个已知身份生物框:已有批次 362 张、3,868 个框,新增批次 360 张、3,783 个框。两批仍独立保存,合计 619 张完成全画面检查,可用于检测导出。部分遮挡身份需要结合同场阵容和相邻帧确认;这不代表单张裁图模型也能认出。
第 2–6 节是第一轮原始测量,第 7 节是第二轮模型对照,第 8–9 节才是这两批数据的扩充记录。第二轮新旧模型在同一批测试图上,检测 F1 从 70.83% 提高到 75.39%;两轮实验本身的测试图不同,不能直接相减它们的分数。
我们复用已保存的原始截图,在每段视频的战场区间取六个时间分位附近的画面,覆盖部署、开战、交战和后期。先冻结来源分组,再训练模型。五段视频训练,一段验证,两段测试;同一段视频的生物选择截图也不能进入另一组。
| 数据 | 用途 | 数量 |
|---|---|---|
| 生物选择裁图 | 身份分类,保留用户或助手审核来源 | 1,818 个正身份,141 类,21 段视频 |
| 战场训练 | 检测与分类学习 | 30 帧,其中 28 帧完成全部目标审核 |
| 战场验证 | 选择 checkpoint、阈值和分类方案 | 6 帧 |
| 战场测试 | 固定视频上的最终对照 | 12 帧,130 个框 |
选择页正样本分为训练 1,580、验证 36、测试 202;另有 27 个无效裁图作为单列负样本。本轮分类对照的正身份准确率不包含这些负样本。选择页身份标签不能充当战场检测框:它们只说明裁图是什么,不说明战场上哪个位置存在生物。
助手逐个查看原图、放大裁图、目录的三维外观和头像,必要时关联同帧行动条头像及数量。已有分类器的 Top 5 只帮助寻找候选,不能自动成为正确答案。510 个框中有 412 个清楚目标、98 个部分遮挡目标;509 个身份已确认,覆盖 110 类,1 个严重遮挡目标保留未知。训练、验证、测试分别有 317、62、130 个已知身份对象。
两张训练帧存在无法穷尽的疑似特效目标,因而不用于检测训练或检测指标。否则漏画的真实生物会被训练器错误当成背景。可见的单个已核实对象仍可以用于分类研究,且保留所在帧的非穷尽标记。
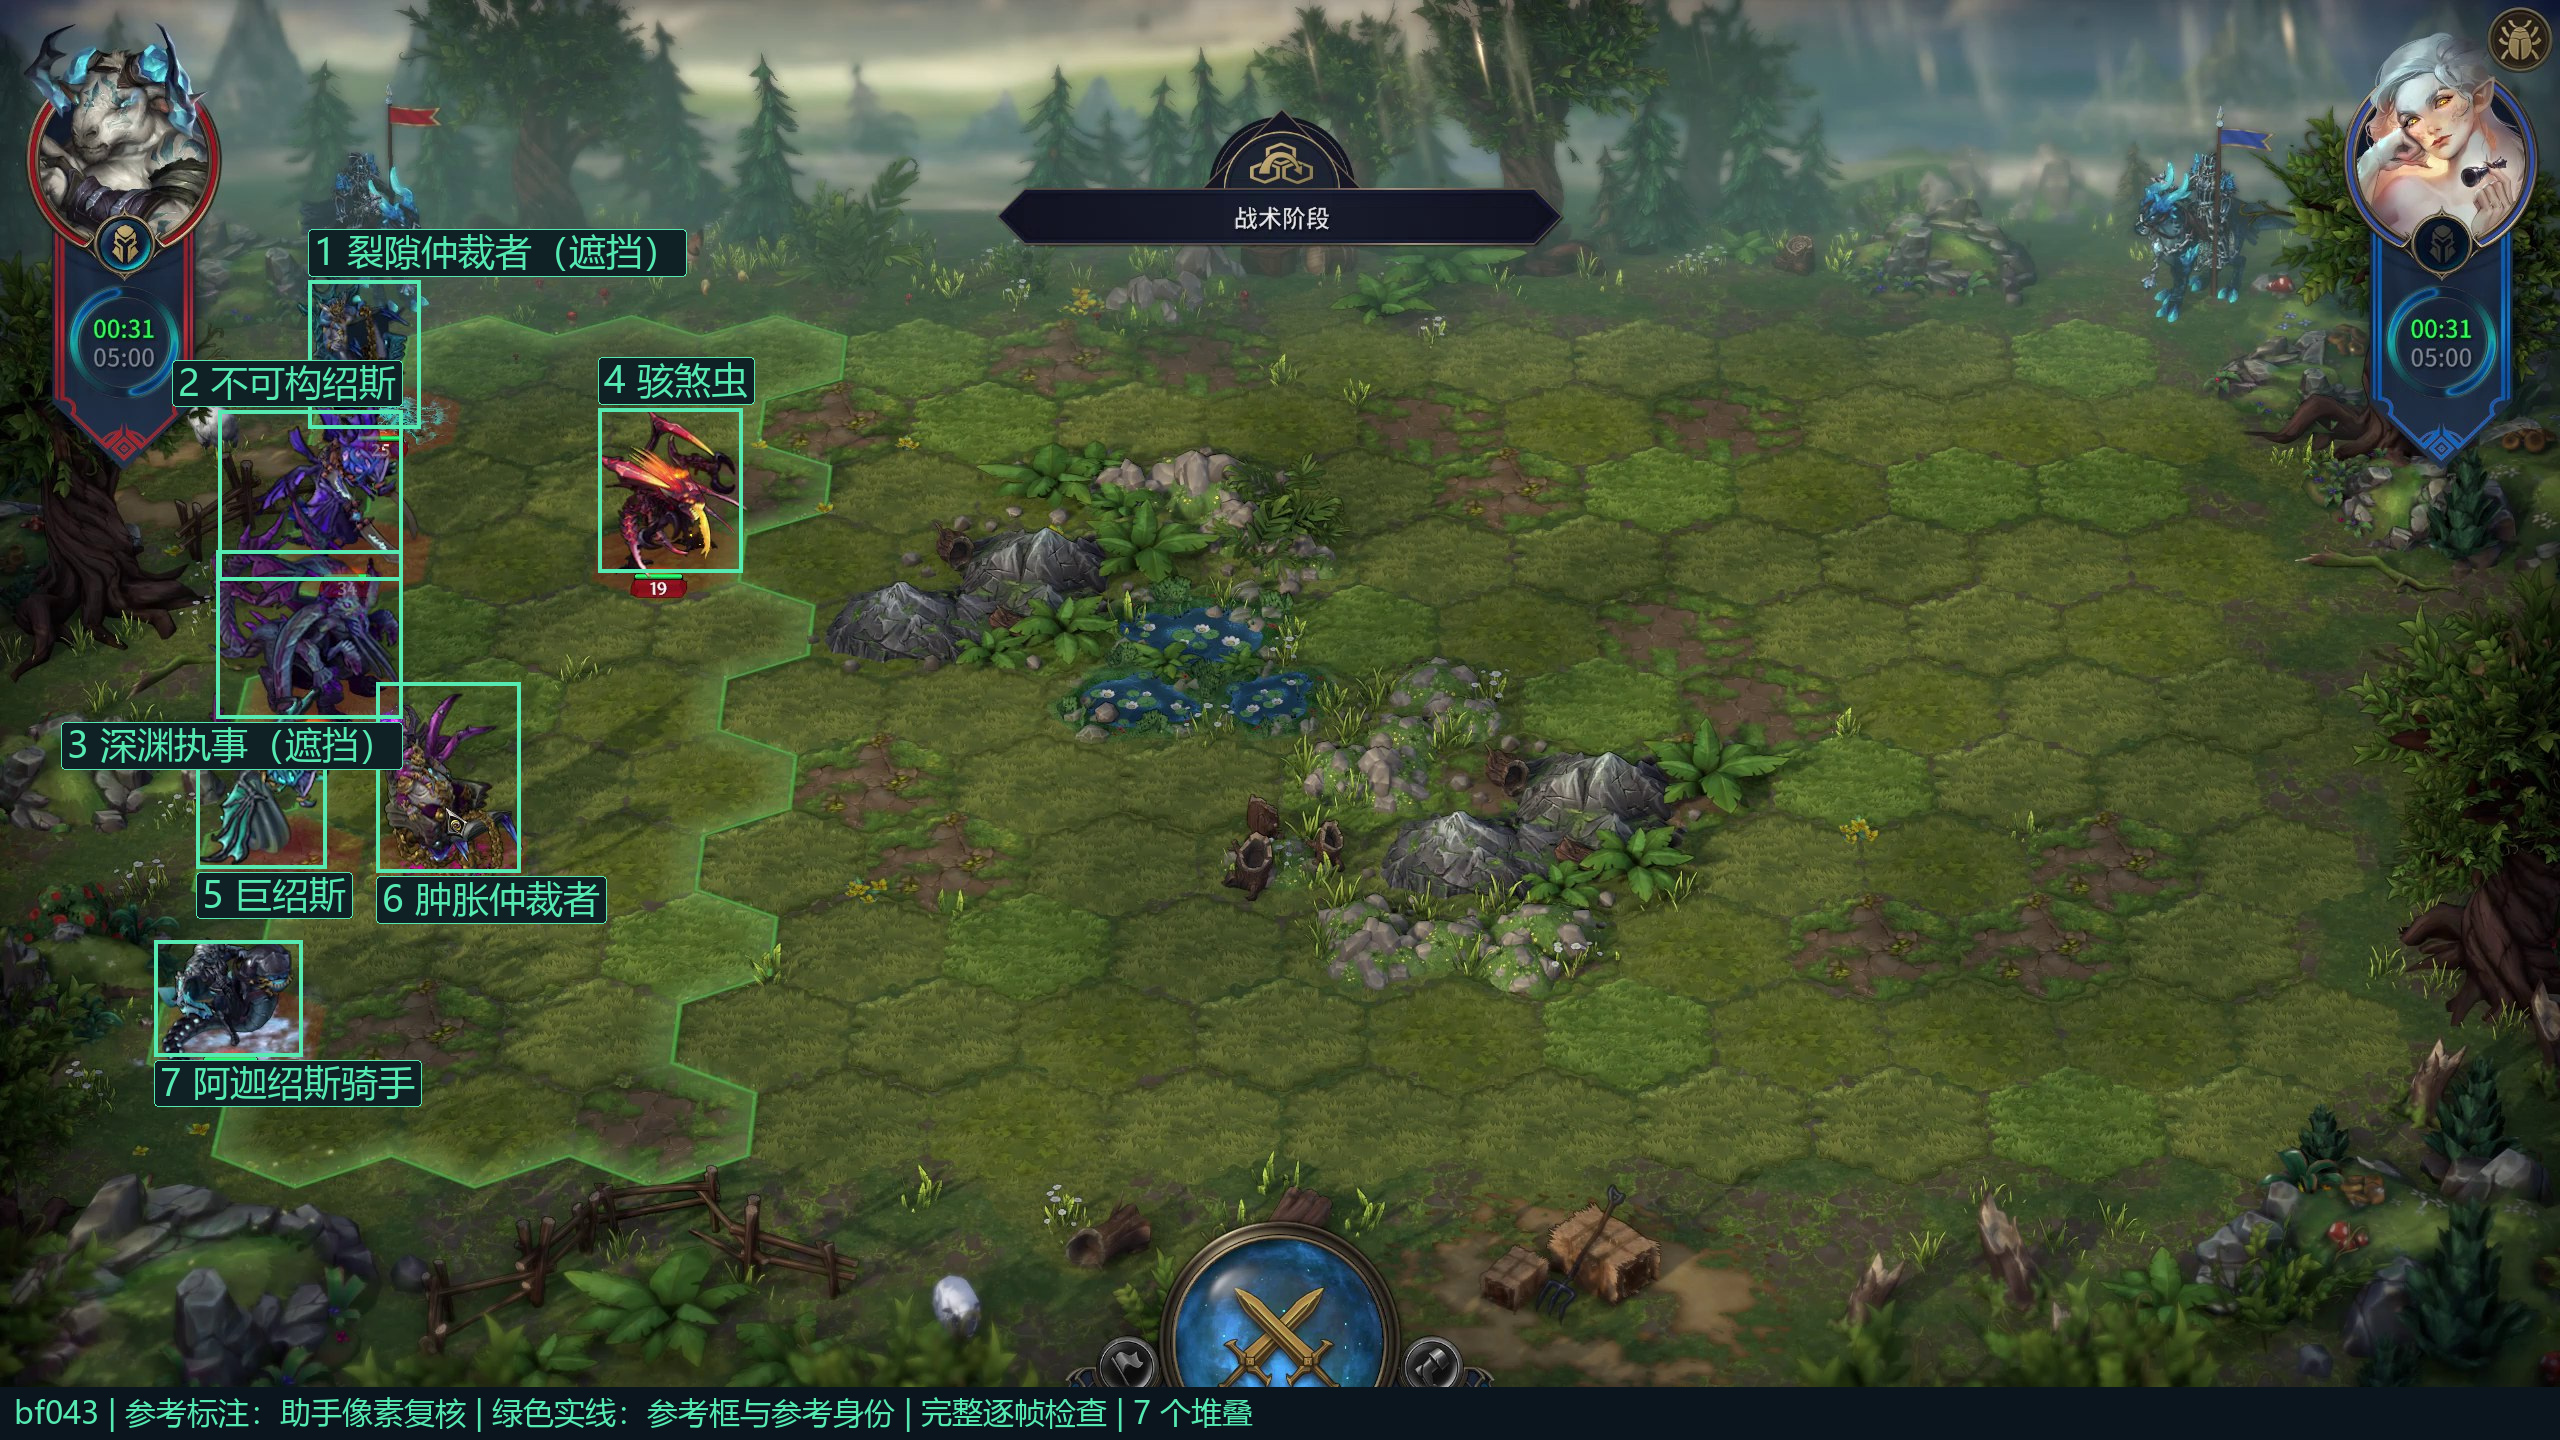
这些是用户授权采用的助手审核标签,来源没有改写成人工确认。48 张图也不是 48 次独立对局:同一视频内可能反复出现同一军队,样本相关性较强。本篇是可复现的小规模实验,尚不能代表所有地图、版本和录制条件。
3. 通用检测器可以提框,但不知道游戏生物是什么
三个公开模型都从 COCO 权重开始,接收整张原始截图。它们没有取得人工框或生物选择槽位。原图有 2560×1440、1920×1078 和 1920×1080 三种尺寸,内部保持比例缩放到约 1333×749,批张量补到 1344×768;结果坐标再映射回原图。
| 检测器 | 方法差别 | 官方 COCO val2017 box mAP |
|---|---|---|
| Faster R-CNN ResNet50 FPN v2 | 先生成区域,再判断类别并修正框;两阶段 | 46.7 |
| FCOS ResNet50 FPN | 从特征图位置直接预测框;不依赖预设 anchor | 39.2 |
| RetinaNet ResNet50 FPN v2 | 在多尺度预设框上判断目标;focal loss 降低大量简单背景的影响 | 41.5 |
模型与权重依据分别见 Faster R-CNN、FCOS、RetinaNet 官方文档。公开自然图像成绩不等于游戏效果。我们把它们的输出暂时看作位置候选,原始 person、horse、bird 类别不会映射成某种游戏生物。
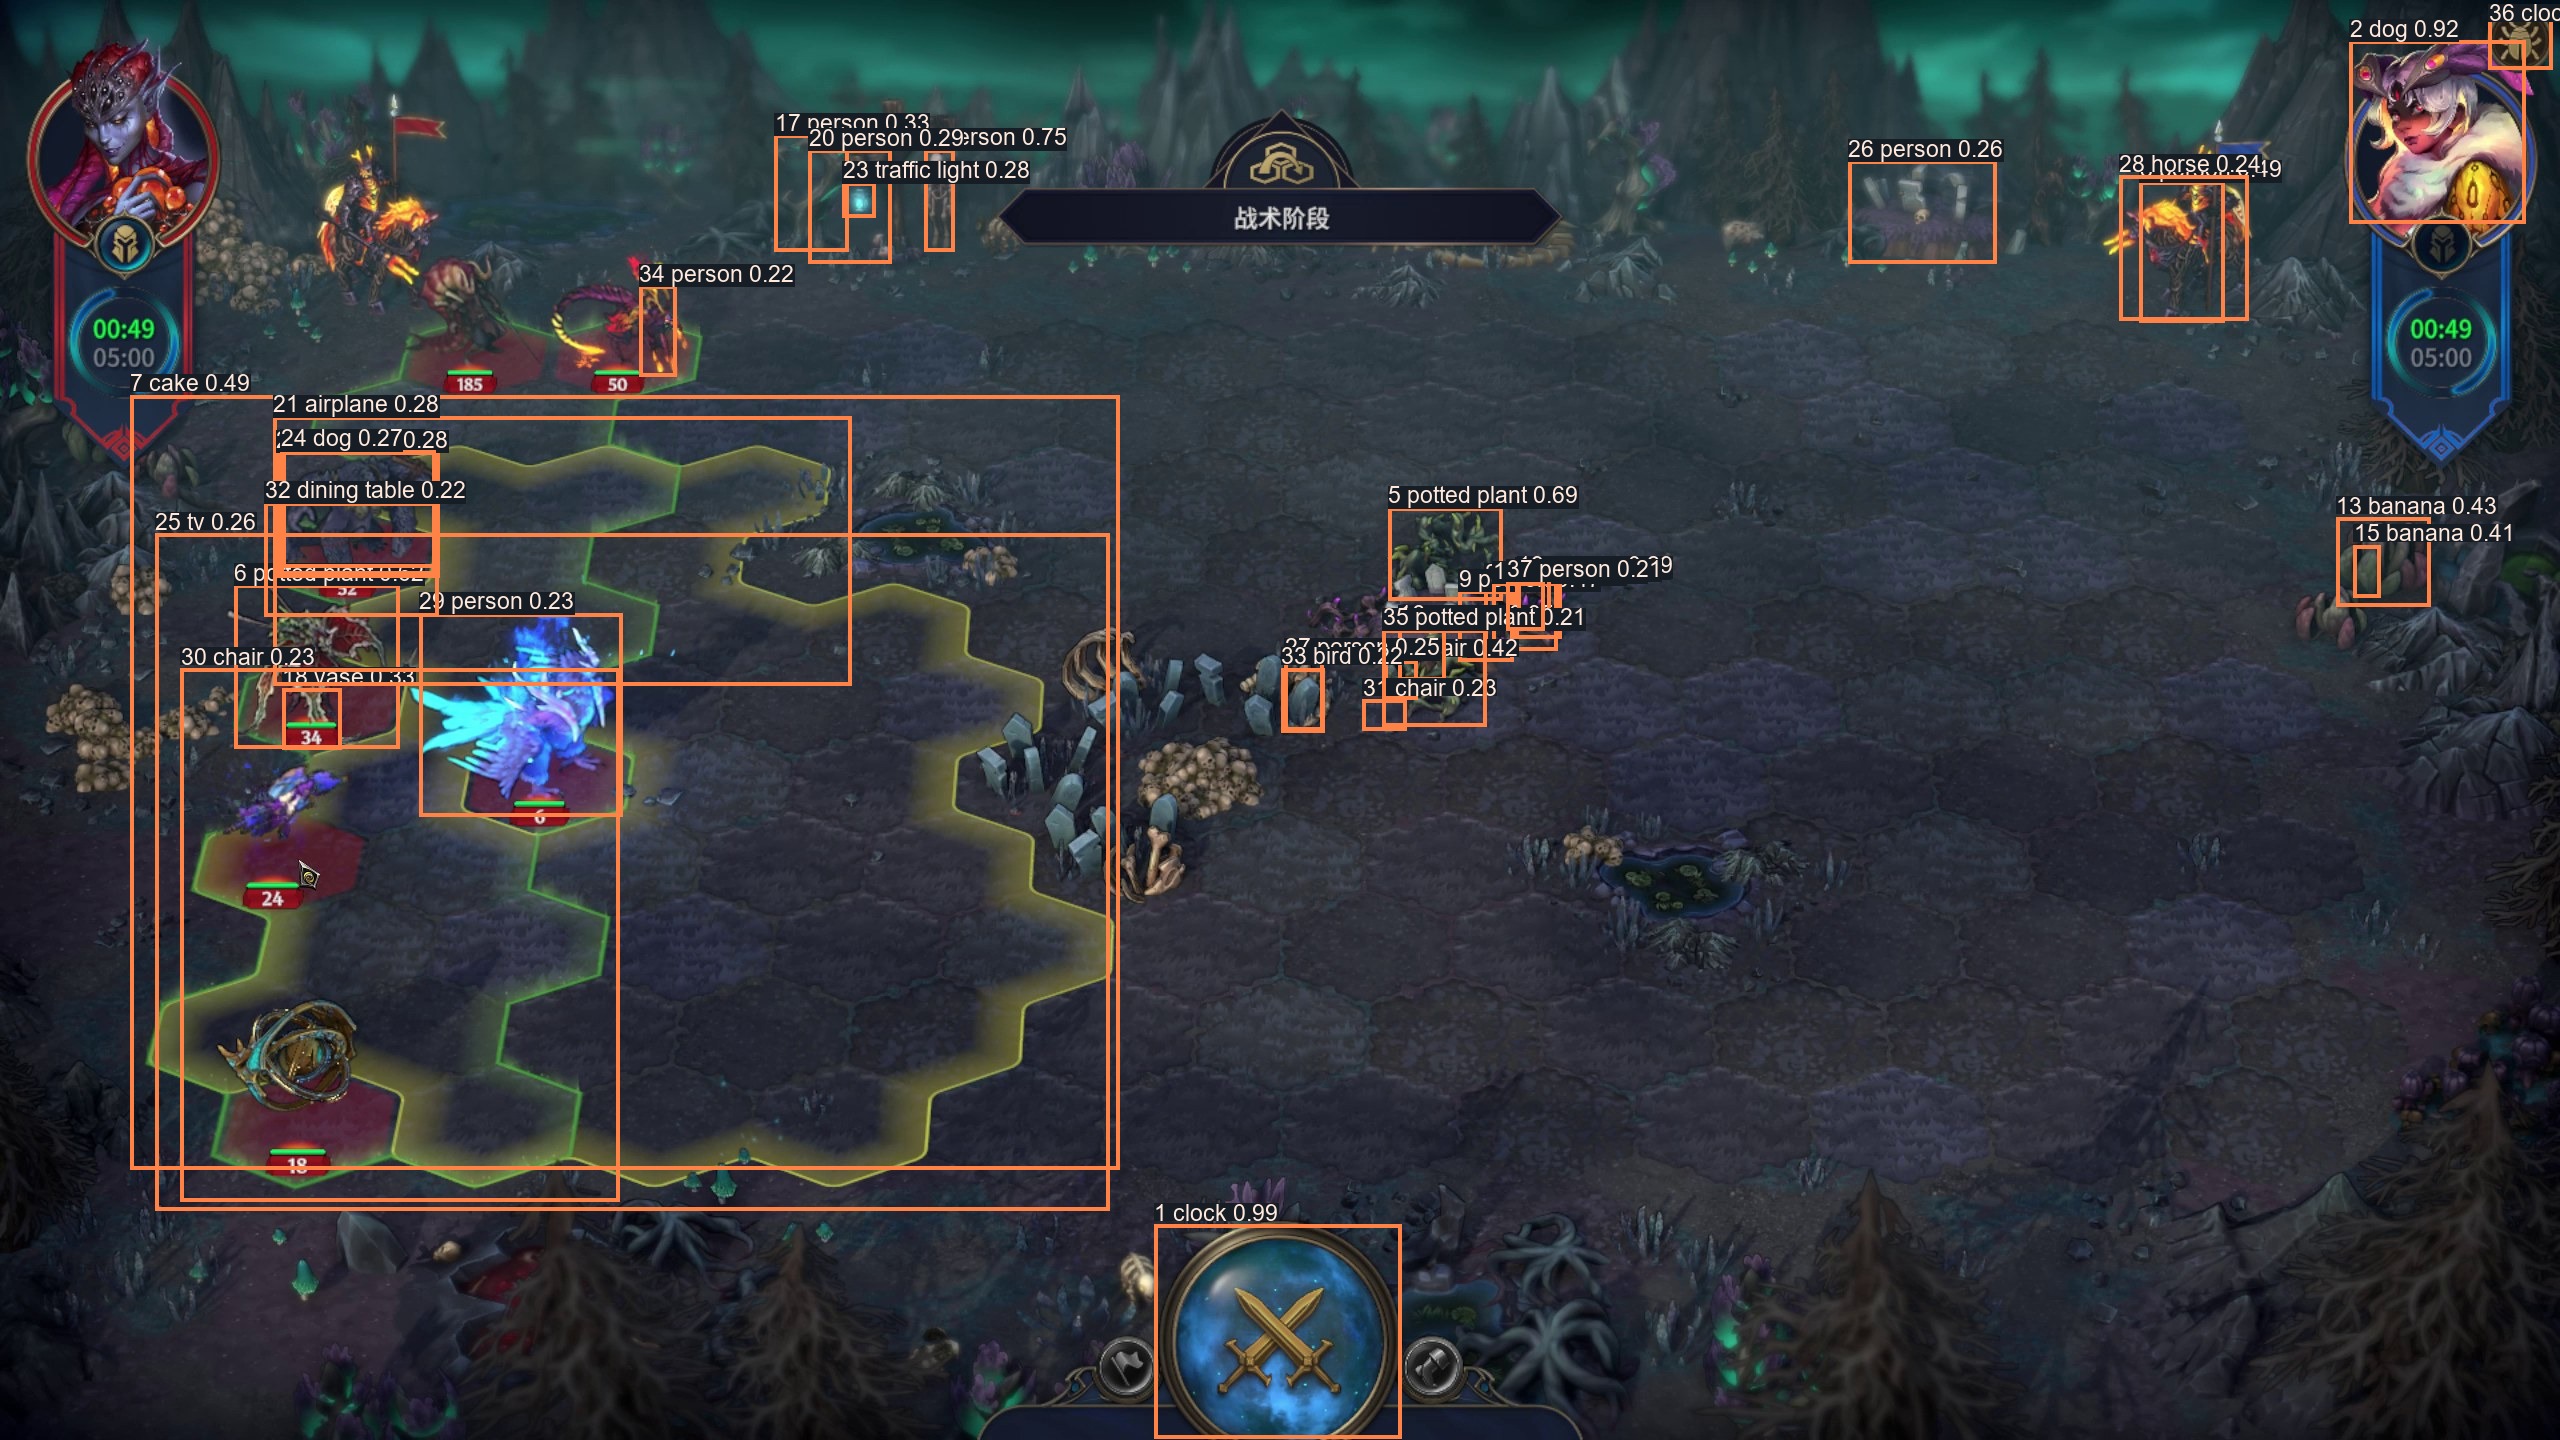
指标使用每图分数至少 0.05、最多 300 个保留候选。FCOS 每张图都达到上限,低分候选已经截断。验证集在固定阈值列表中选择工作点,并决定是否排除框中心位于 HUD 边缘带的候选。这个固定位置过滤是明确的后处理,不能算作公开模型本身的能力。
随后训练一个只判断“生物部队”的 FCOS:保留公开 ResNet/FPN 特征骨干并冻结,只更新分类和框回归等检测头。训练只使用 28 张已穷尽标注的战场图,带水平翻转、轻微亮度与对比度变化。验证集选择 checkpoint,并在测试推理之前保存工作阈值。原来的 B03 实验和游戏微调权重均未改动或拿来初始化。
| 方法(验证集选阈值) | 精确率 | 召回率 | F1 | AP50 | AP50:95 |
|---|---|---|---|---|---|
| 公开 Faster R-CNN(0.20,过滤 HUD) | 18.53% | 44.62% | 26.19% | 17.19% | 8.59% |
| 公开 FCOS(0.20,过滤 HUD) | 6.23% | 40.00% | 10.78% | 9.18% | 4.04% |
| 公开 RetinaNet(0.10,过滤 HUD) | 7.07% | 20.77% | 10.55% | 3.21% | 1.57% |
| 战场微调 FCOS(0.50,无 HUD 过滤) | 80.42% | 88.46% | 84.25% | 91.07% | 41.12% |
全部方法在同一组 12 张测试图、130 个框上评估。微调 FCOS 输出 143 个框,其中 115 个与参考框匹配,另有 28 个误检、15 个漏检。最佳 checkpoint 为第 35 轮;50 轮后满足预设提前停止条件。训练期间一次复核修正了两个训练框,因此使用相同配置重跑;旧运行仍单独保留,未修改测试框。
判对一个框要求它与某个未匹配的参考框 IoU 至少 0.5;IoU 是两个框的交集面积除以并集面积。重复框算误检。精确率回答“画出的框有多少是真的”,召回率回答“真实生物找到了多少”。AP 汇总不同分数阈值的精确率与召回率;这里用保留候选上的 101 点插值,不是完整的 pycocotools 官方评测。更严格的 AP50:95 会揭示框位置仍不够准的问题。
4. 选择页数据有帮助,但战场裁图改变了问题
先假设位置已经完全正确,把审核框里的生物裁出来,再比较分类方法。这样能单独回答“分类器认得出吗”,避免检测漏框掩盖分类错误。
基础特征提取器是公开 ImageNet 权重的 ConvNeXt-Tiny。裁图转成 224×224 RGB,输出 768 维特征。早期这一组实验统一去掉裁图底部 10%,原本是为了排除选择页数量栏,实际也用于战场训练、评估和推理。虽然三者一致,但会损失战场紧框里的部分身体。下方 DINOv3 新方案明确改成:选择页去掉 10%,战场和目录全身图保留完整。模型运行时只看图片,不读取 OCR 名称或标注答案。
我们比较两种使用特征的方法:一是把同类训练图的特征平均,找最相近的类别原型;二是训练平衡类别权重的线性 SVM,学习类别之间的分界。SVM 比较 C=0.1、1、10。分别只用选择页、只用战场训练裁图、两者合并,形成 12 个组合。
相同对象在选择页通常大而清楚,在战场可能只有几十像素,叠着红色地面、移动动作或其他单位的翅膀。因此选择页测试的高正确率,不能推出战场分类也正确。
| 人工参考框条件下的分类方法 | 验证:62 个对象 | 测试:130 个对象 |
|---|---|---|
| 冻结 ConvNeXt,选择页训练,SVM C=10 | 35.48% | 47.69% |
| 冻结 ConvNeXt,战场训练,SVM C=10 | 66.13% | 67.69% |
| 冻结 ConvNeXt,两者合并,SVM C=10 | 70.97% | 74.62% |
| 微调 ConvNeXt 最后阶段和分类头,两者合并 | 75.81% | 68.46% |
前三行固定同一分类器配置,观察训练数据来源;12 个冻结组合中,全局验证最优也是合并数据的 C=10。随后只微调 ConvNeXt 的最后阶段和分类头,使用按来源与类别平衡的抽样、轻微颜色变化和随机裁切。验证选择第 11 轮,提前停止于第 17 轮,训练用时 130.24 秒。验证更好而测试下降,是这个小数据集必须保留的结果,不能事后改用测试分数最高的一行宣称胜出。
还尝试了三个补充方向:
| 补充实验 | 输入变化 | 最佳验证结果 | 是否继续评估测试指标 |
|---|---|---|---|
| 冻结 ConvNeXt 加目录全身参考 | 额外加入 148 张完整渲染图,各有目录身份 | 45/62,72.58% | 否,未超过预定 47/62 门槛 |
| 冻结 DINOv3 ConvNeXt-Base | 1,024 维特征;完整战场裁图;比较有无目录参考及原型/SVM | 33/62,53.23% | 否,未超过门槛 |
| 已微调 ConvNeXt 特征再接原型/SVM | 冻结第 11 轮特征,只重新训练最后分类器;保留原裁图协议 | 46/62,74.19% | 否,未超过门槛 |
DINOv3 是通过自监督学习得到的公开视觉特征模型;这里使用已缓存的 timm ConvNeXt-Base 权重,只训练后面的分类器。方法与权重来源见 DINOv3 官方实现。冻结特征缓存可以包含测试图片;上表“未继续”指没有用这些特征计算测试分类或联合指标,训练和选择也不使用测试标签。这组比较同时改变了骨干和战场裁图预处理,不能把差异单独归因于某一因素。结果至少说明:更大的公开模型、更多目录图片,都没有自动解决本批游戏截图的身份问题。
模型相似度和 SVM 分数都不是“这个名字正确的概率”。当前还有无目录目标、误检框和不可见身份的拒识问题。把每个框强制分给一个最相近类别,会产生看似完整但错误的结果。
5. 最后必须同时检查框和身份
真实运行从检测器输出框,再裁图送给分类器。此时框可能漏掉翅膀、包含邻居或落在障碍物上。前面的成绩是在给定参考框条件下单独检查身份分类,不是数学上的上界;实际预测框的裁图范围和输入条件不同,不能用参考框成绩代替整条链路。
| 完整检测与分类组合 | 框与身份都正确 | 联合精确率 | 联合召回率 | 联合 F1 |
|---|---|---|---|---|
| 微调 FCOS + 冻结 ConvNeXt/SVM | 73/130 | 51.05% | 56.15% | 53.48% |
| 微调 FCOS + 微调 ConvNeXt | 79/130 | 55.24% | 60.77% | 57.88% |
两行都使用同一组 143 个预测框。微调分类器在“精确参考框”测试上下降,在“实际预测框”上却改善,说明两个测试条件不能互相替代。后一行定位正确的 115 个目标里,79 个身份也正确;36 个定位对但名字错,另有 15 个漏检和 28 个定位误检。身份错同时计入联合误检与漏检,不能只统计画面里出现了多少名字。
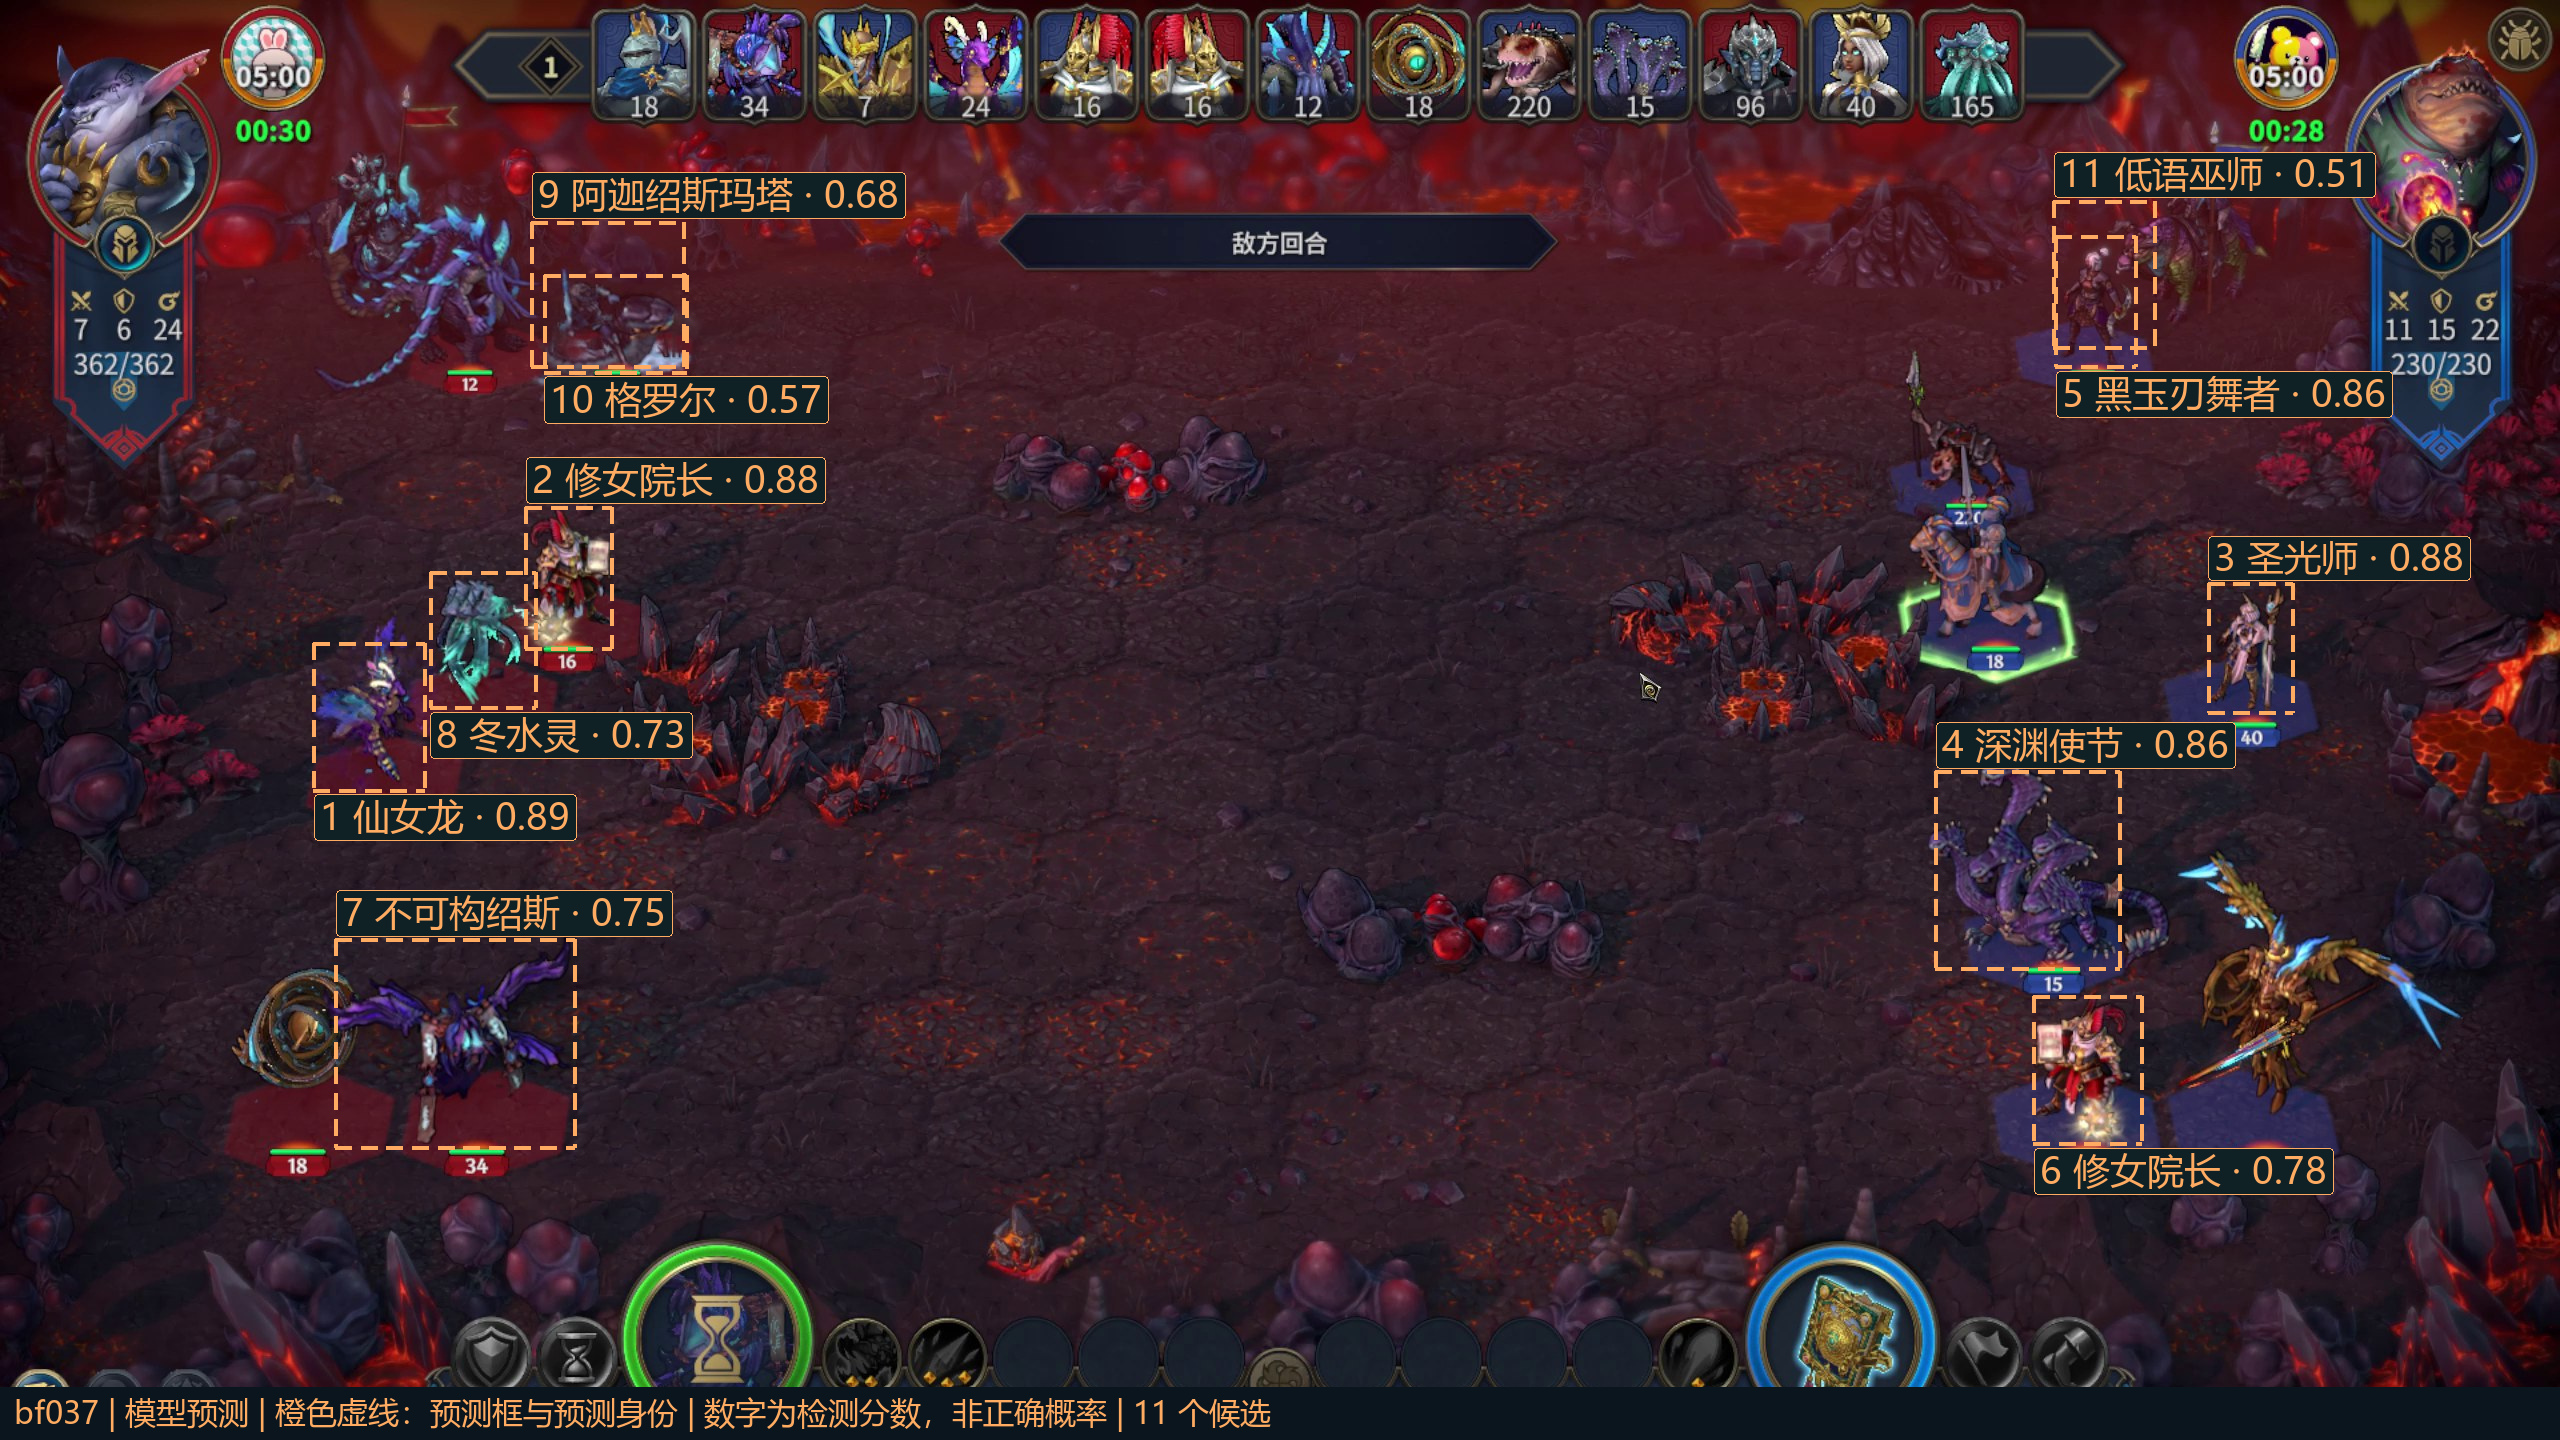
本机可以打开 48 帧结果浏览器,切换参考标注、不同检测器及“检测与身份预测”,左右键换图。绿色实线是参考,橙色虚线是预测,名称来源分别保留。它复用标注网站的报告入口,读取原分辨率图片;无需再逐张替助手做这一批标注。这个链接需要本机 Studio 服务运行,公开网页的读者可直接查看本文示例。
6. 加载、单帧推理和完整处理分别有多快?
测速环境为 Windows、RTX 5080、torch 2.13.0+cu130、torchvision 0.28.0+cu130,float32,检测 batch=1。每个公开模型独立启动进程并顺序运行,记录包导入、加载到 GPU、首次推理;预热三次后,48 张图各推理一次,GPU 计时前后同步。
| 公开检测器 | 包导入 | 模型加载到 GPU | 首次常驻调用 | 网络常驻均值 | 含张量准备与传输的常驻均值 |
|---|---|---|---|---|---|
| Faster R-CNN | 1.896 s | 0.492 s | 566.7 ms | 30.39 ms | 45.15 ms |
| FCOS | 1.875 s | 0.369 s | 333.0 ms | 23.56 ms | 39.19 ms |
| RetinaNet | 1.915 s | 0.417 s | 295.0 ms | 24.50 ms | 39.31 ms |
图像文件解码平均还需约 9.4 ms,不包含在上表最后一列。网络时间包含内部缩放、检测头和 NMS。没有清空操作系统文件缓存,所以这不是物理磁盘冷启动测量,也不是视频从解码到绘图的每秒帧数。
完整常驻程序还单独测了一次:每次输入整张截图,由 FCOS 生成框,再把该帧的 6–16 个候选裁图批量送入微调 ConvNeXt。48 张图共产生 521 个候选。没有人工框参与运行,也没有把所有视频裁图预先攒成一个大批次。
这次新进程中,框架导入 1.945 秒,身份模型加载 0.331 秒,检测器加载 0.315 秒。首张图片解码与完整推理 660.1 ms;从开始框架导入到首个结果共 3.252 秒,不含 Python 解释器启动。
| 完整链路,含 JPEG 解码 | 均值 | 中位数 | P95 |
|---|---|---|---|
| 预热首张图后,第一次遍历 48 图 | 122.49 ms | 62.58 ms | 370.20 ms |
| 所有已出现的裁图批大小均已运行后,再遍历一次 | 58.41 ms | 56.82 ms | 69.42 ms |
第二遍内部均值为:检测 34.66 ms、裁切 0.15 ms、身份分类 14.80 ms,另加解码等开销。第一遍仍有不同裁图批大小首次运行的启动开销;因此只预热一张图就报告“稳定速度”会误导。第二遍约相当于串行处理 17 张截图/秒,但尚未包含视频解码、场景分类、跨帧跟踪和绘图,不是整套视频应用的 FPS。
检测网络的主要计算与缩放后的像素面积有关,不会因为场上只有三支部队就少算大部分卷积。后处理随候选数量变化;分类器则需要逐个编码裁图,检测出的框越多,后续计算通常越多。因此降低误检也会降低完整链路的耗时。
7. 第二轮:扩充到96张,检验新对局迁移
第一轮结束后,我们又逐张审核了48张、598个活体框。累计1,107个身份确定,覆盖125类;唯一未知目标仍保留未知。全部96张里,813个目标清楚,295个部分遮挡;两张旧训练帧继续保留非穷尽标记。这里的标签是用户委托助手检查后采用的参考,来源没有改成人工确认。
新增图使用已有的原分辨率文件:12张1920×1078、36张2560×1440。11个场景入口原先只有小预览,改用同视频邻近的原分辨率缓存,并记录实际时间差、重新检查画面,没有把640像素缩略图放大当原图。
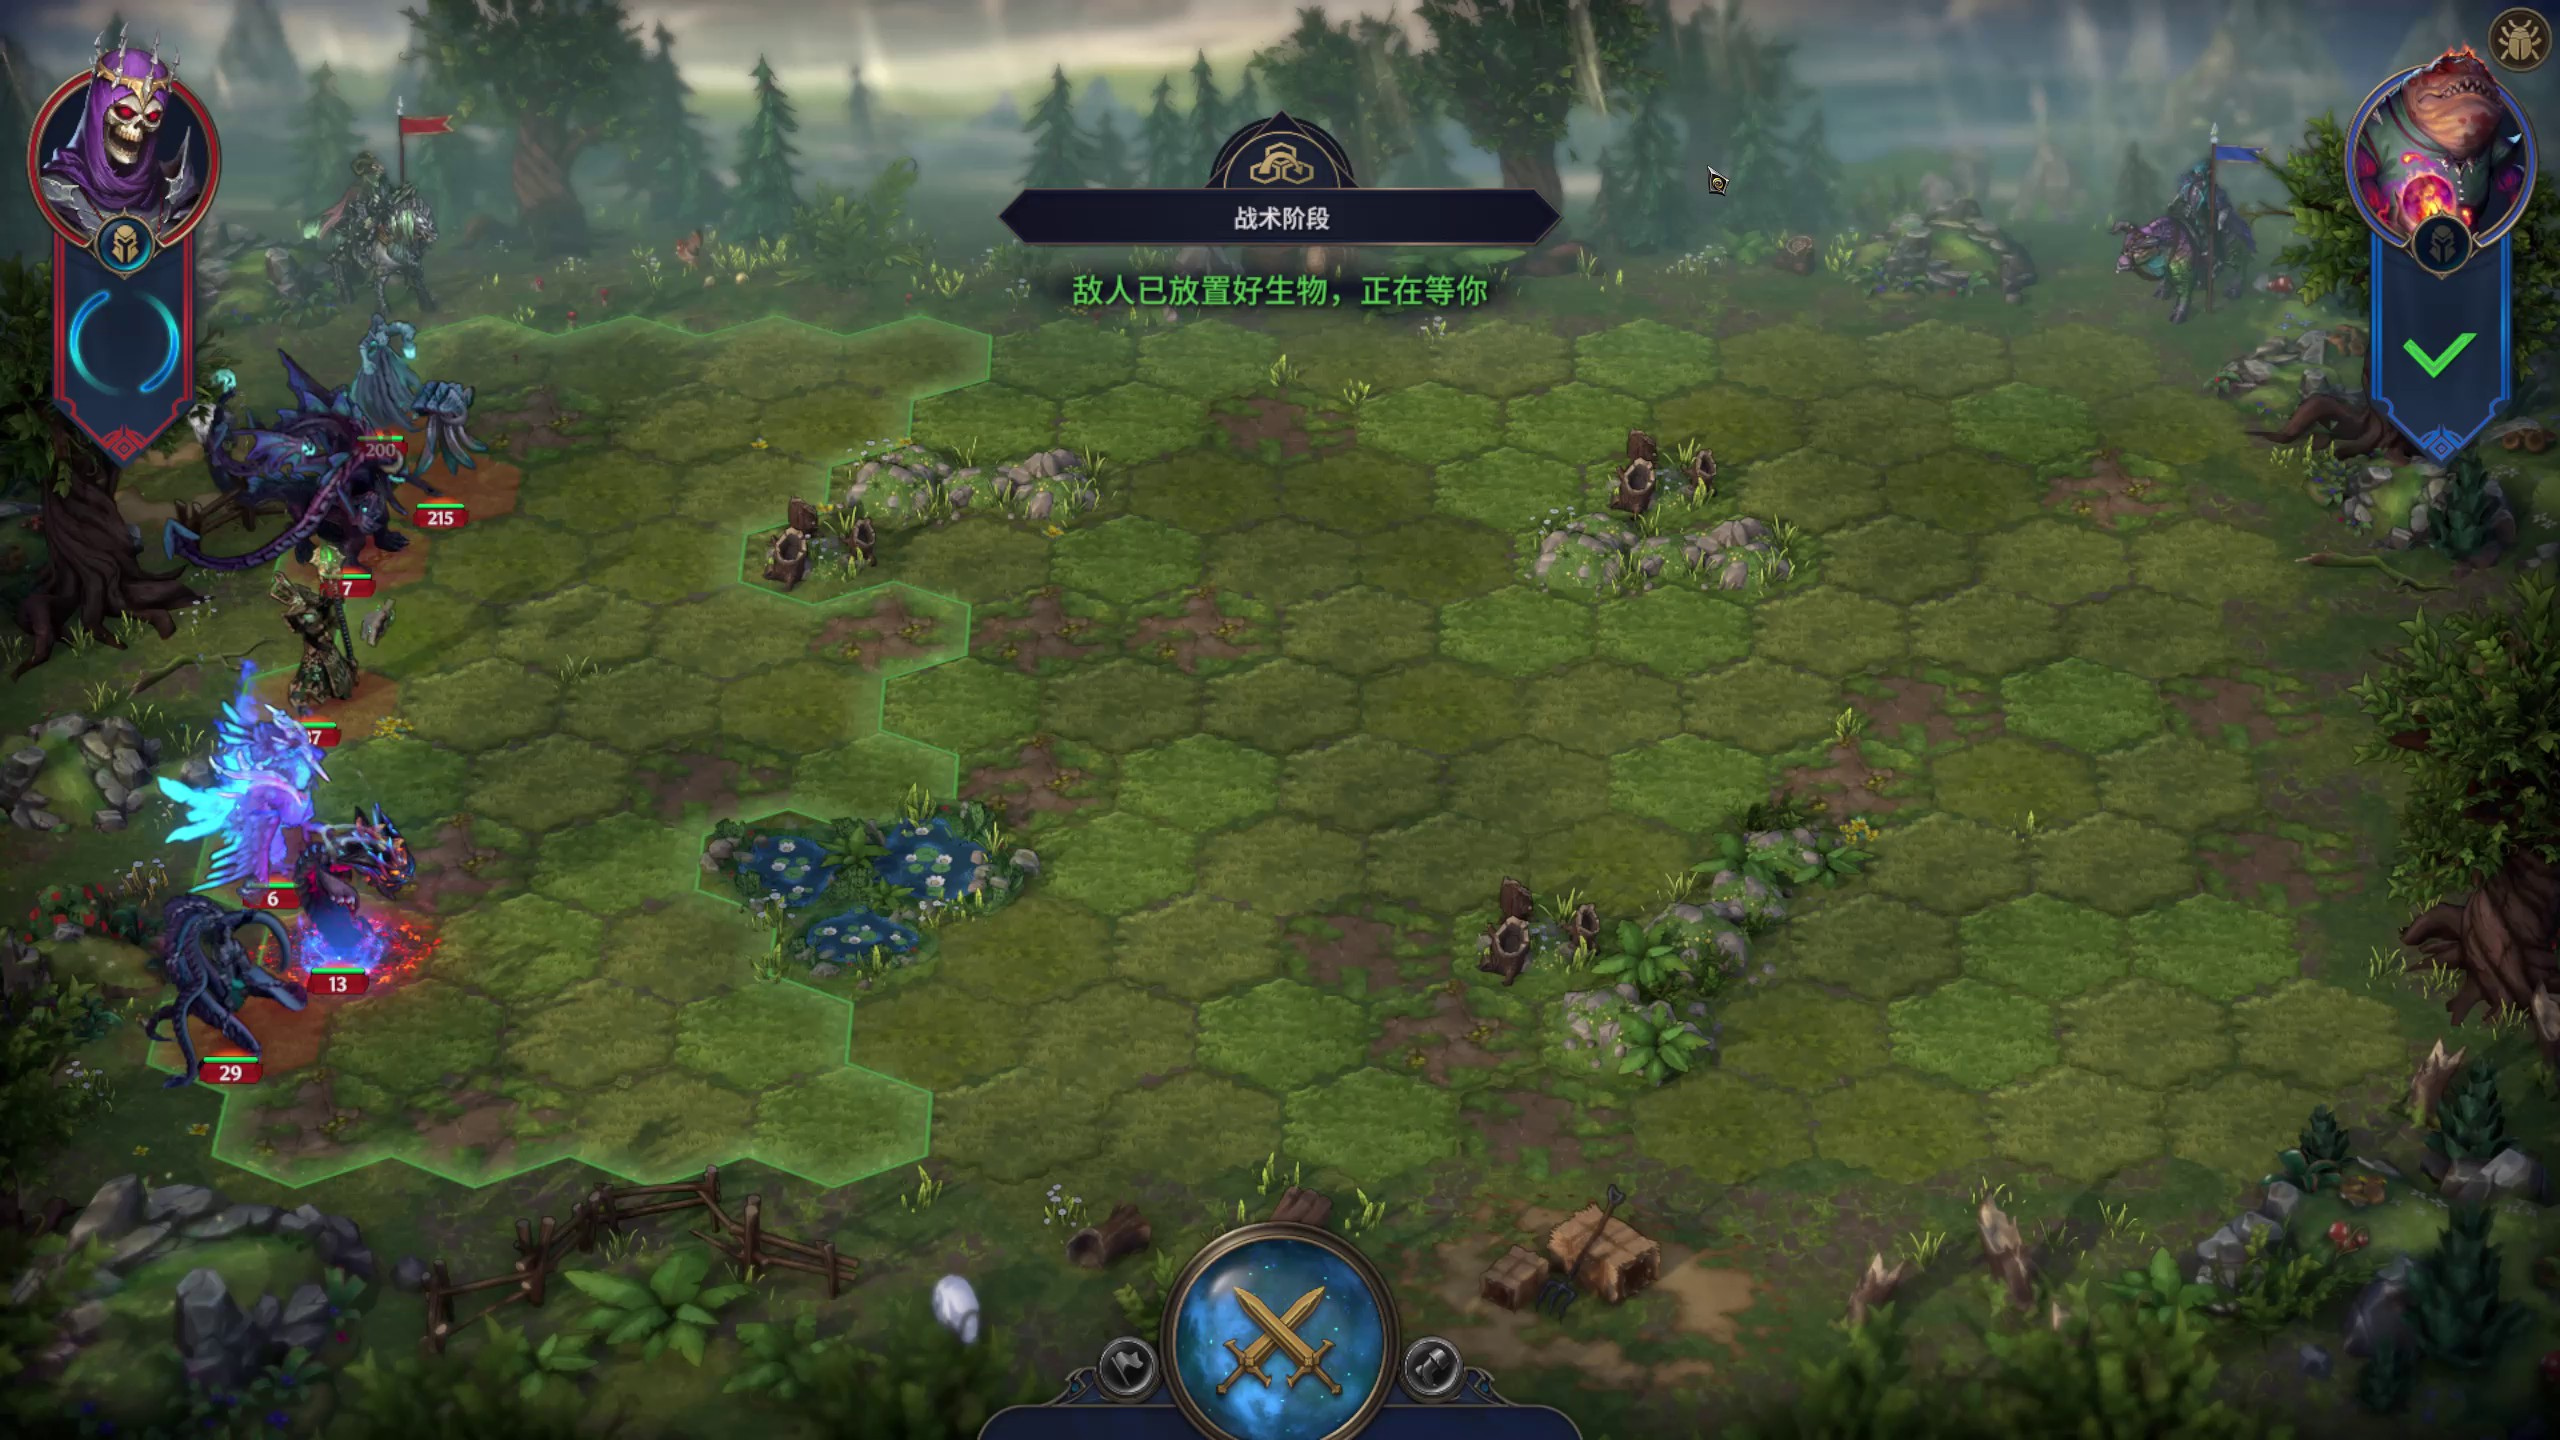
这次尤其检查了文件与对局的区别:session02开头仍延续session01的同一场洞穴战斗,不能因为换了MP4就当成独立测试。因此只把session02之后新开的草地对局作为新test。两个session以前已用于场景理解开发,只能说是B026检测与身份的新来源,不是整个项目从未见过的录屏。
| 第二轮分区 | 战场帧 | 活体框 | 已知身份crop |
|---|---|---|---|
| 训练:原30张 + 新24张 | 54 | 602 | 601 |
| 验证:session01一个对局 | 12 | 147 | 147 |
| 测试:session02的新对局 | 12 | 167 | 167 |
本轮共78张。第一轮另外18张验证/测试仍留在历史记录,完全没有转入本轮训练。检测只用52张已穷尽帧的579个框;身份训练则用601个已核实战场crop,加原来的1,580个选择页训练crop,共2,181个、141类。两组新验证/测试各只有一局,连续画面反复出现同一军队,不能把几百个框当成几百次独立实验。
我们还修正了目录边界:完整战场视觉目录有148类,竞技场选择页可抽选目录有141类。例如化身可以作为召唤物出现在战场,即使不在抽选列表里,也不能被标成背景。抽选资格没有改变,只是战场识别改用完整目录。
第二轮先保存第一轮模型在新画面上的直接迁移结果,再从相同公开权重重新训练FCOS。保持原优化配置,增加训练图,并改用新的validation选择checkpoint和阈值;这不是只改变数据量的单因素实验。最佳为第6轮,第21轮早停,训练94.55秒;阈值0.5,无HUD过滤。
| 同一组新test,167目标 | 定位正确 | 误检 / 漏检 | 精确率 | 召回率 | F1 |
|---|---|---|---|---|---|
| 第一轮FCOS直接迁移 | 119 | 50 / 48 | 70.41% | 71.26% | 70.83% |
| 扩充训练后的FCOS | 121 | 33 / 46 | 78.57% | 72.46% | 75.39% |
改善主要来自误检减少,漏检只少两个。扩充模型在validation的召回率为95.24%,新test却只有72.46%,这个差距不能省略。新test AP50为80.72%、AP50:95为39.45%,仍使用前面说明的候选截断与本地AP计算口径。旧迁移运行只保存阈值之后的框,因此没有为它补造不可比较的AP。
身份只比较训练前指定的两个方案。两者都从公开ImageNet ConvNeXt-Tiny开始,训练同一最后stage与分类头;选择页均去掉底部10%。A也去掉战场crop底部10%,B则保留完整战场crop。两者训练和比较时都不解码test图片。
| 第二轮身份方案 | 参考crop验证正确数 | 真实预测框验证联合正确数 | 验证联合F1 | 训练耗时 |
|---|---|---|---|---|
| A:战场底裁10% | 100/147 | 97 | 63.40% | 109.91秒 |
| B:保留战场全身 | 97/147 | 96 | 62.75% | 107.74秒 |
按照事先固定的联合F1规则选A,再保存选择凭据,最后只评估A的test。两个方案都选第11轮、在第17轮停止;B的test保持未评估。只有一个联合正确目标的差距,不足以断言底裁10%普遍更好,但应遵守预先规定的选择流程。
| 同一新test上的完整组合 | 框与身份均正确 | 联合精确率 | 联合召回率 | 联合F1 |
|---|---|---|---|---|
| 第一轮固定组合直接迁移 | 74/167 | 43.79% | 44.31% | 44.05% |
| 扩充FCOS + 身份A | 83/167 | 53.90% | 49.70% | 51.71% |
扩充组合产生154个预测框:121个位置合格,83个身份也正确;还有46个漏检、38个位置正确但身份错误、33个没有匹配到参考目标的预测。它在精确参考crop上的Top1为99/167=59.28%,Top5为82.63%。其中11个食尸鬼目标的身份根本没出现在分类训练类别中;仅看训练已见类别是99/156=63.46%,但整体准确率仍必须保留全部167个目标。
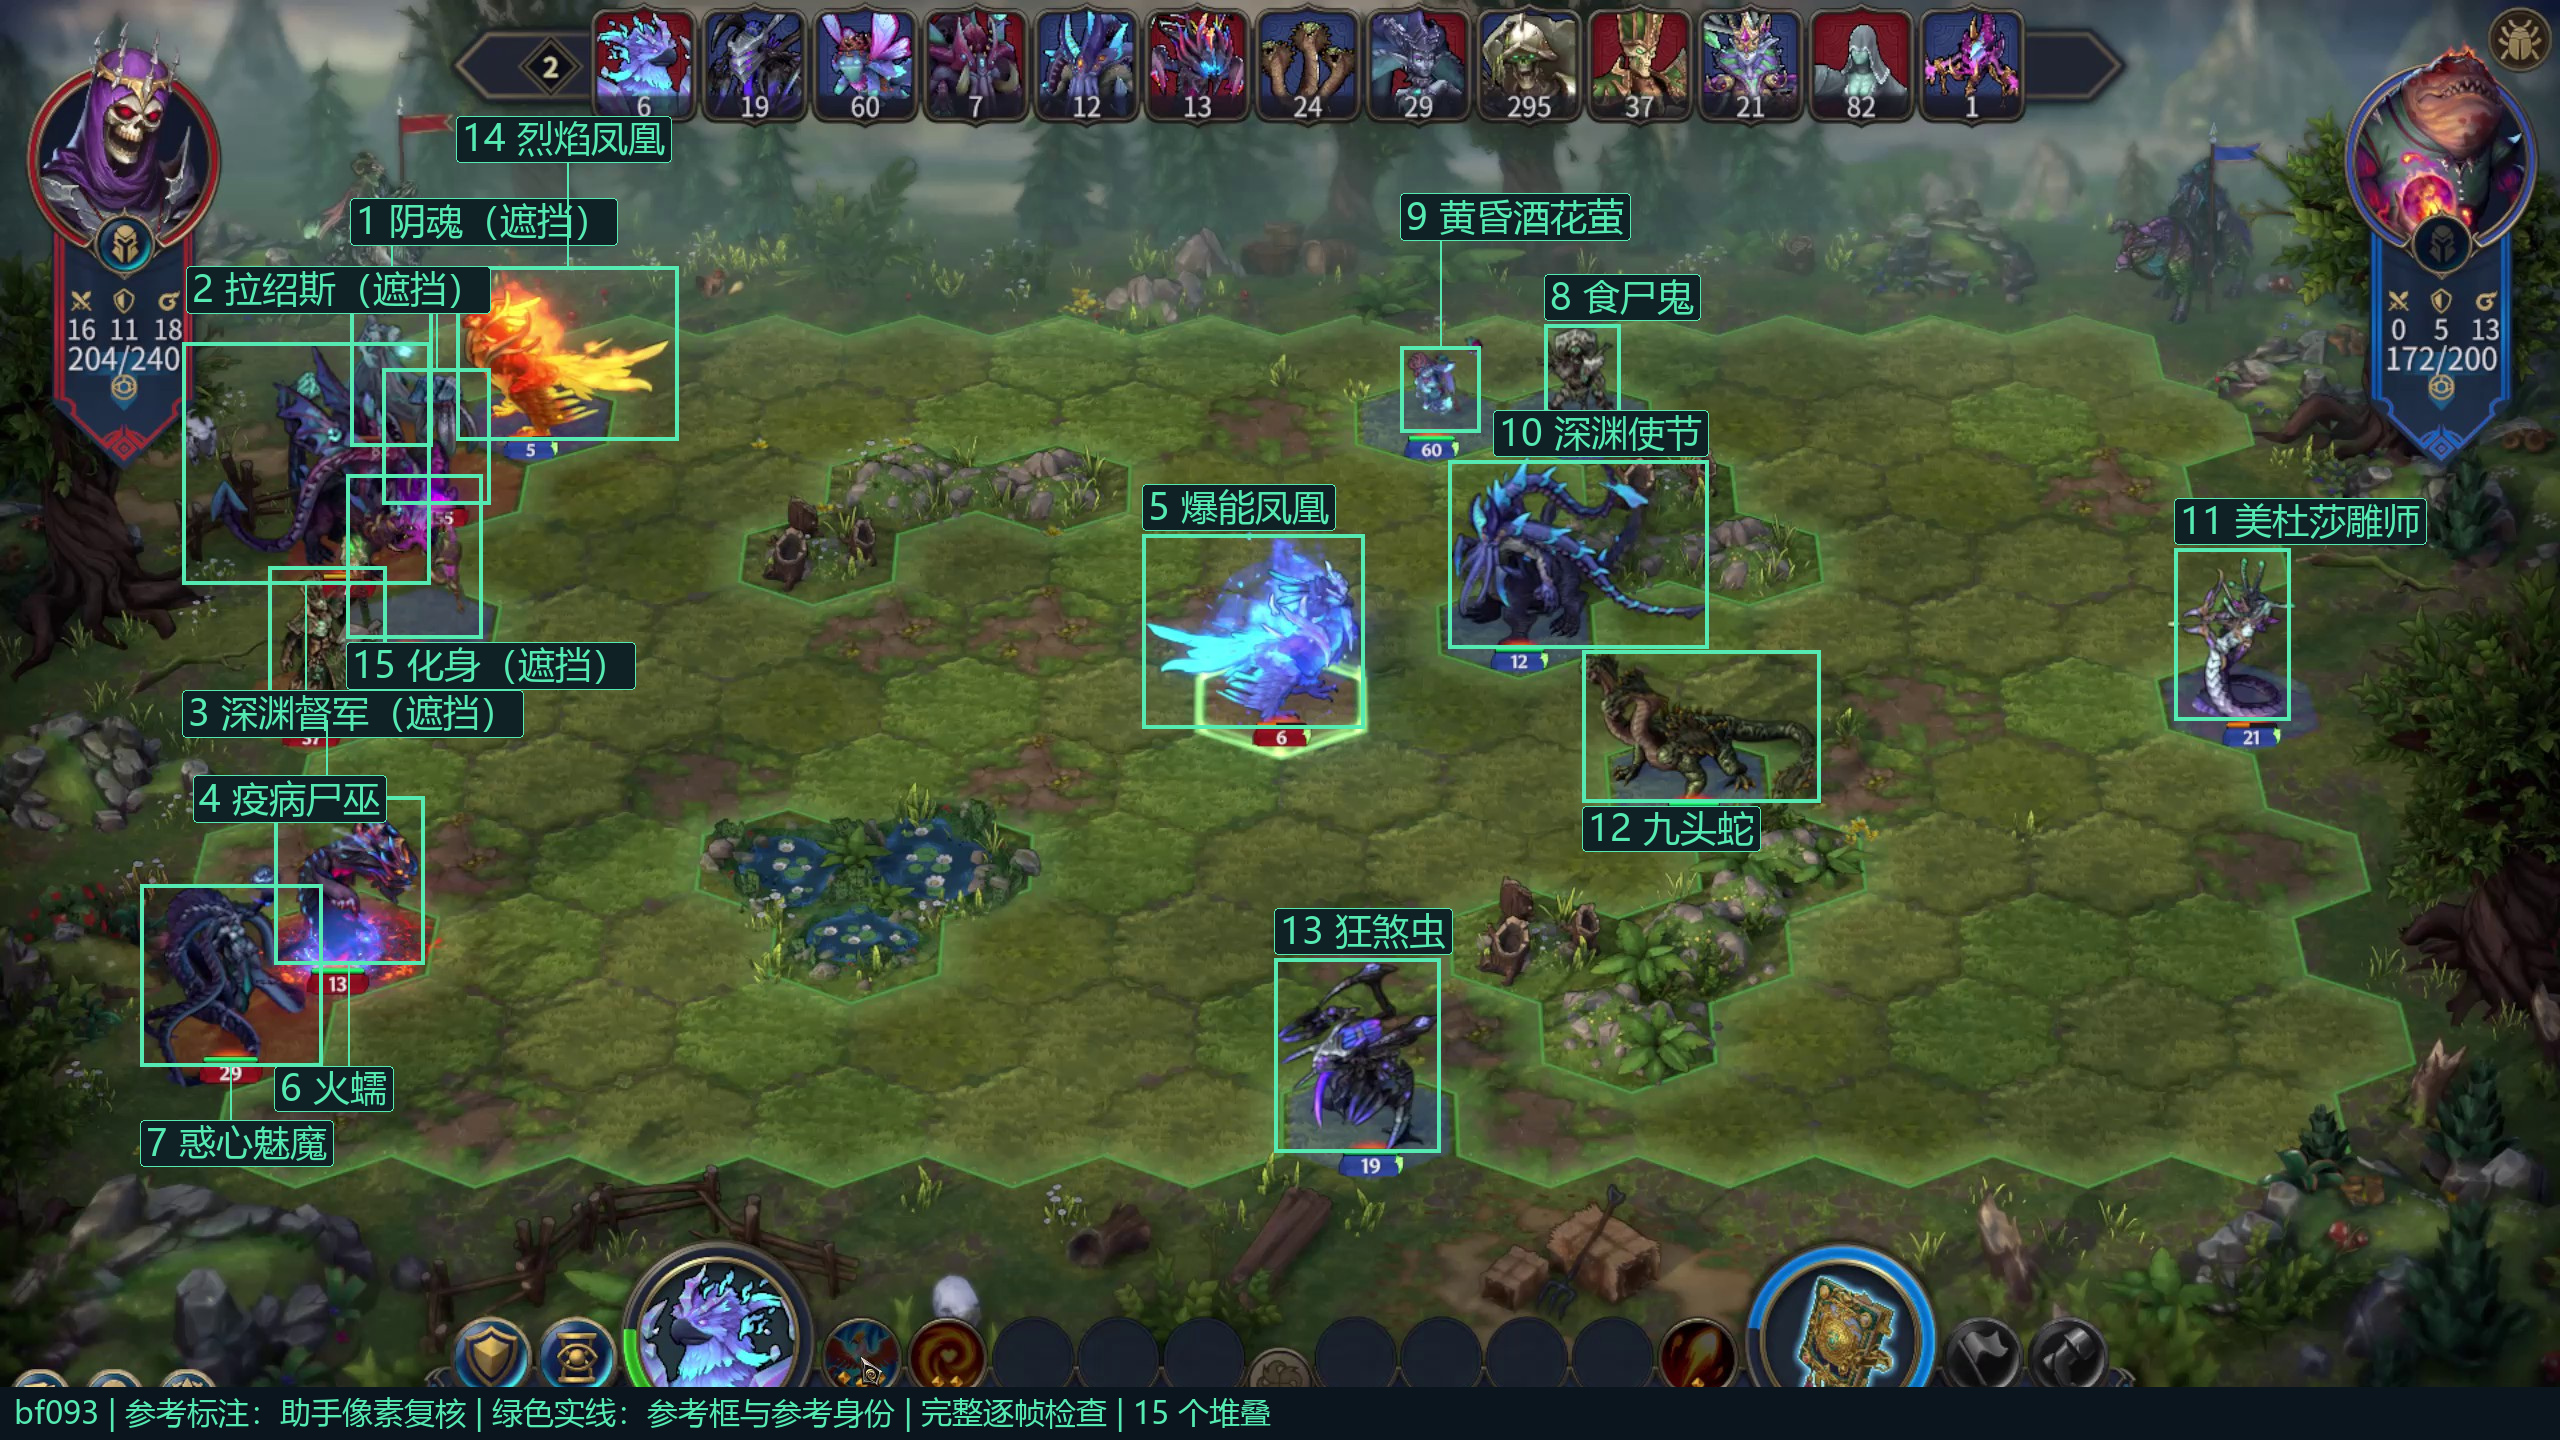
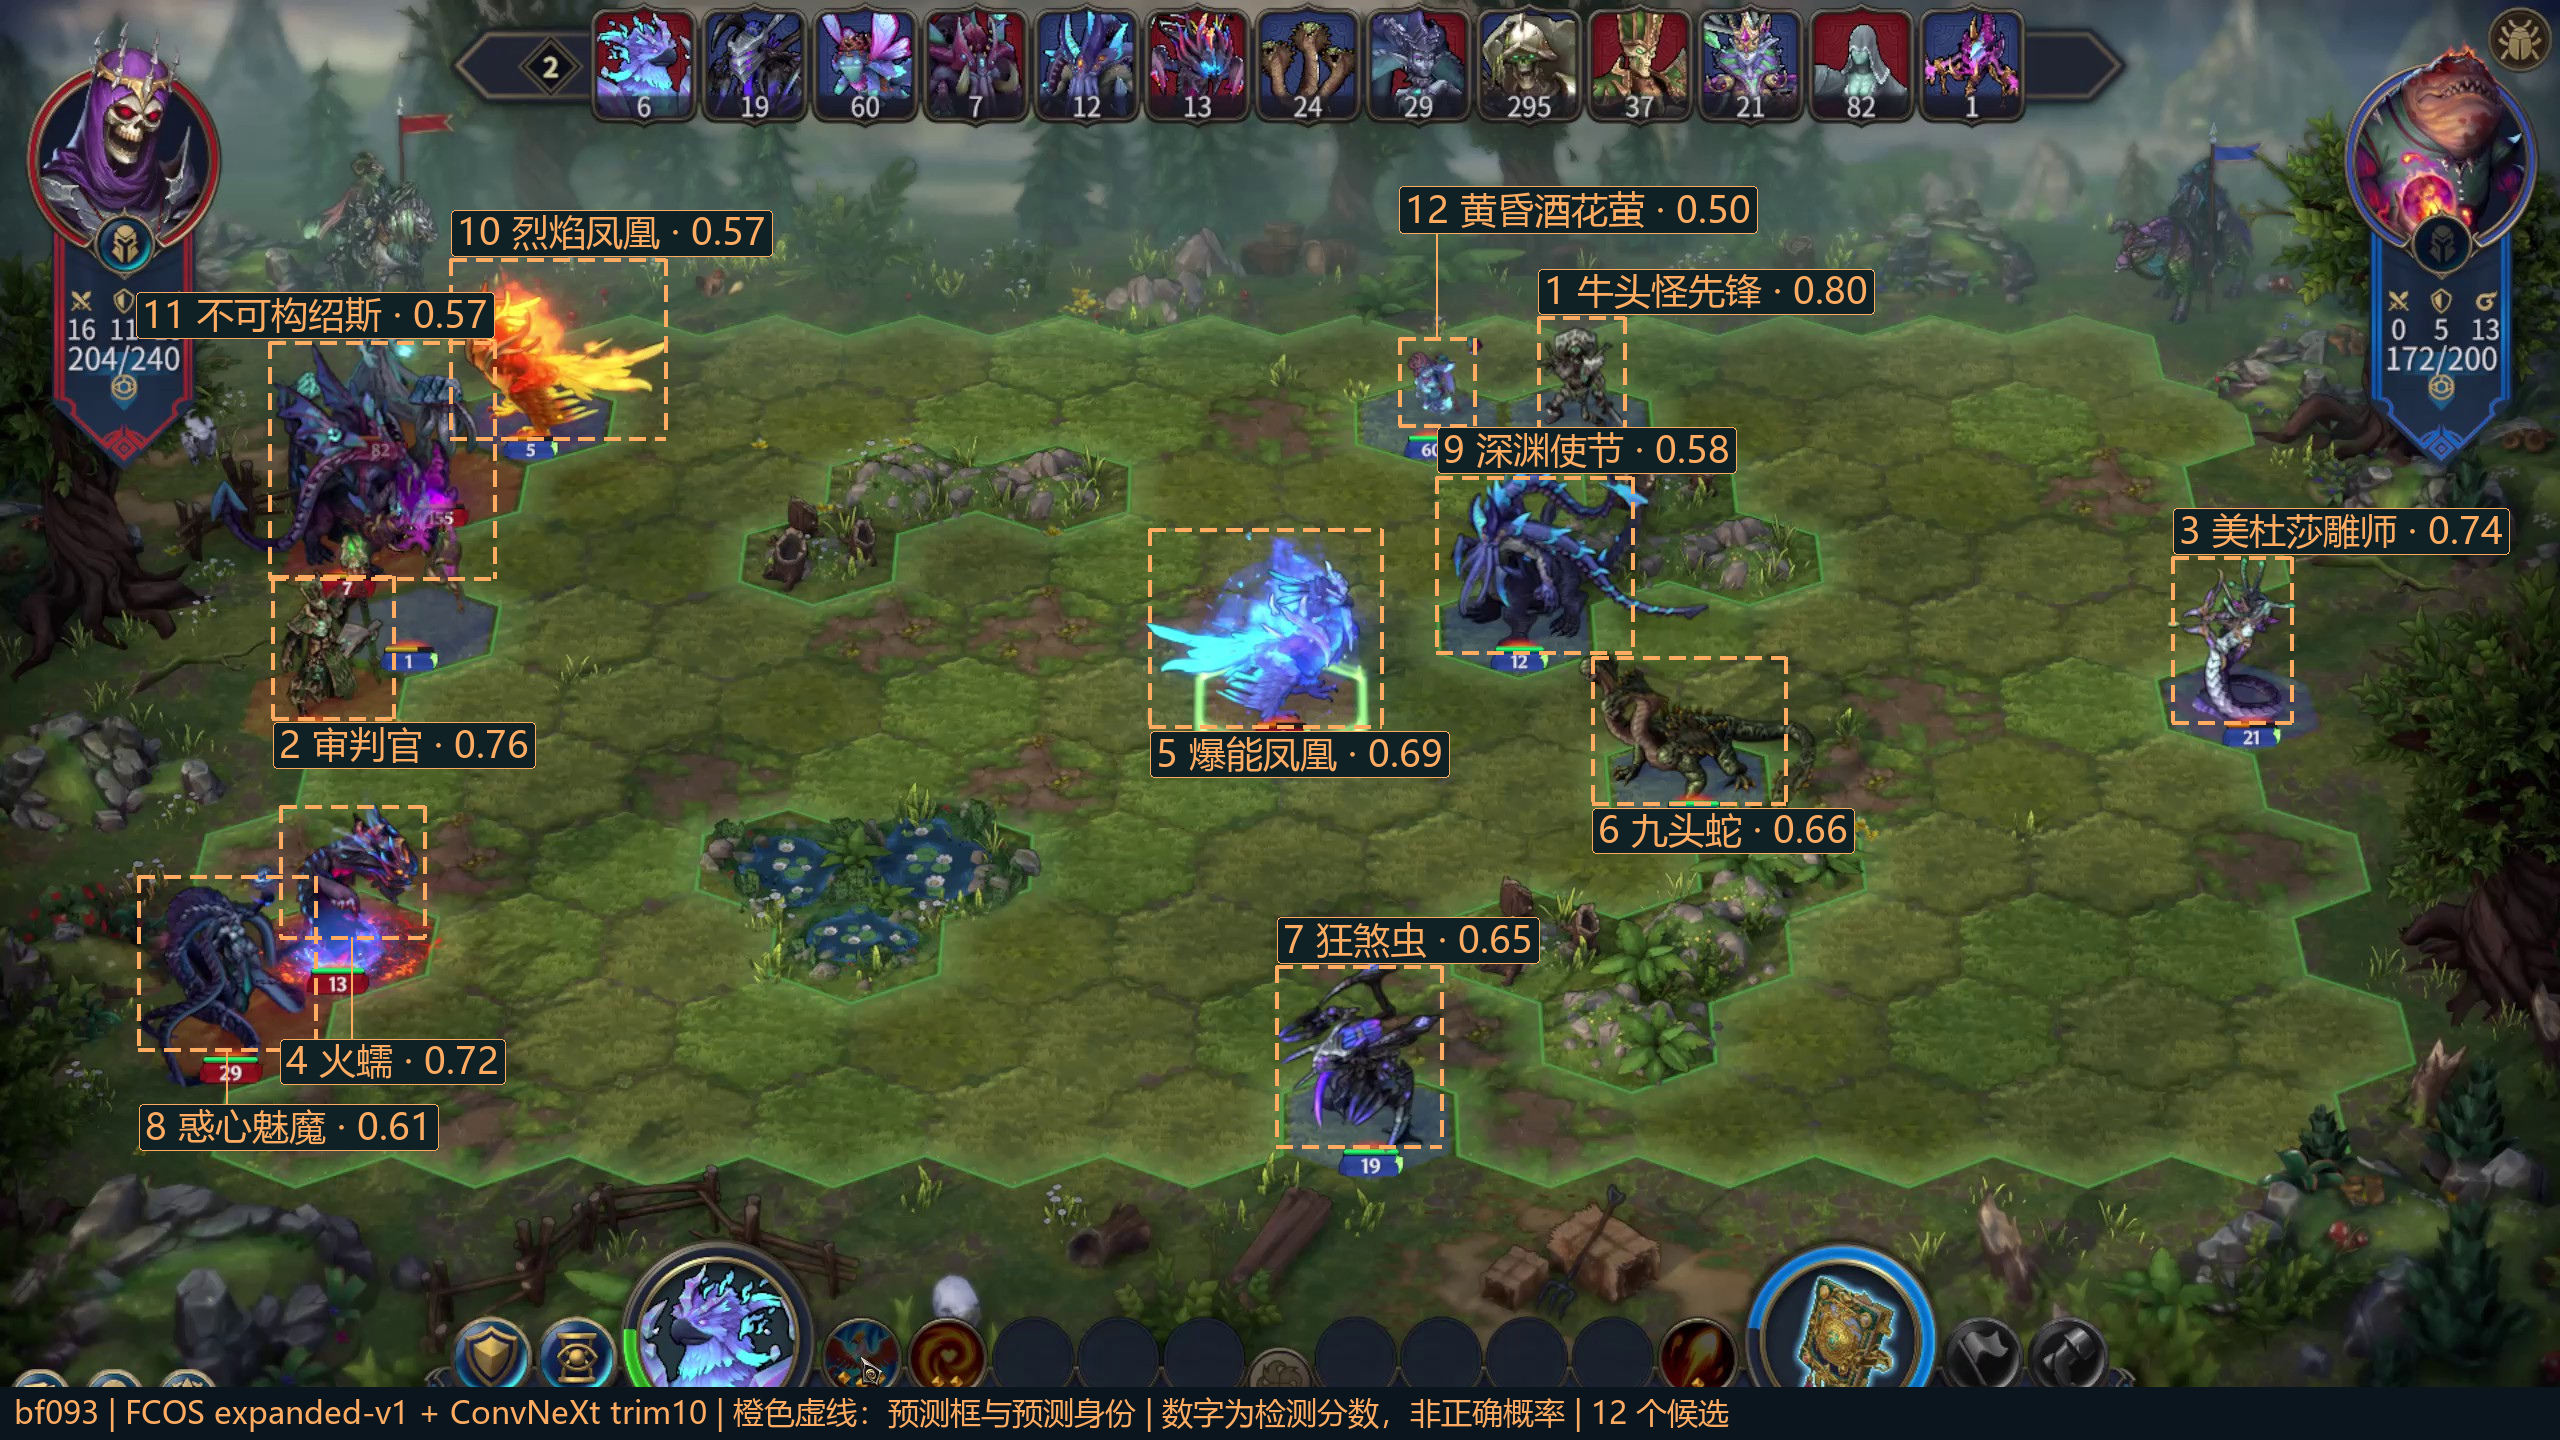
当前结果在第二轮78帧浏览器中可逐张检查,左右键换图,勾选参考或模型图层,点框看原像素裁图。旧18张heldout仍可在第一轮48帧报告查看;两个入口合起来去重后是96张不同图片,不是126张。主标注集只回写了新批次中精确对应的21张,其余27张保留在独立实验数据中。这批逐图标注已经由助手处理,无需用户再做一遍。
最后用同一选定模型测试完整常驻路径。78张共产生971个预测crop,每帧6–17个;框与身份和离线联合输出逐项一致。Windows、RTX5080、float32,新进程框架导入1.951秒、身份加载0.315秒、检测器加载0.313秒;首图解码与推理678.76ms,导入至首结果3.259秒。
| 第二轮完整路径,含JPEG解码 | 均值 | 中位数 | P95 |
|---|---|---|---|
| 首图预热三次后的第一遍78帧 | 104.53ms | 64.81ms | 365.58ms |
| 已见过所有crop batch大小后的第二遍 | 61.81ms | 62.66ms | 72.88ms |
第二遍内部均值为检测34.73ms、裁切0.18ms、身份17.74ms,常驻合计52.66ms;其余是读图等开销。第一遍仍有新batch大小的启动成本。和第一轮一样,没有清OS缓存,不含视频解码、场景分类、OCR、跟踪和显示;这里测的是截图处理链路。
8. 362 张原图的框与身份:数据已完成,模型待重测
这次继续使用已有原图缓存,逐张查看检测候选和修正后的裁图。分类器 Top 5 只是检索线索;审核还对照目录外观、同帧行动条、数量和同场相邻画面。作者已授权接受这批助手审核结果,数据保留实际审核来源和所用证据,无需再排入人工确认队列。
| 2026 年 9 月 8 日审核导出 | 数量与含义 |
|---|---|
| 原始截图 / 录屏 | 362 张 / 23 段;录屏数不等于独立对局数 |
| 已审框与身份 | 3,868 个 / 3,868 个,未知身份为 0 |
| 完成全画面目标检查 | 321 张,可进入本批检测导出 |
| 未进入检测导出的其余画面 | 41 张;已有单个框的身份不等于整张图已穷尽标注 |
| 单独保留的疑点候选 | 3 个,不计入 3,868 个已审框,不当作背景负样本 |
本轮 256 份补充审核记录新增了 2,741 个身份;另剔除两个重复或多目标组合框、一个士气金鸟特效框,并修正三个框的覆盖范围。因此先前的 3,871 个已审框变为 3,868 个。这三个被剔除框与另外保留的三个疑点候选是不同对象。
“身份已知”和“当前像素清楚”分别记录。严重遮挡的对象可能凭前后帧确认身份,仍保留 partial 可见性。它可以研究遮挡识别,却不能声称单张裁图独立提供了名字。321 张全图检查也仅对应这些采样时刻,不表示 23 段视频的每一帧都已标注。
读者可核对本轮数据完成记录。本机启动标注服务后,可在原图、框与身份浏览器逐张查看;此地址只访问读者自己的本机。导出中的旧 train、development、validation、test 表示数据来源角色,不能因为保留了这些字段,就把已经查看过的画面称为下一版模型的独立测试。
当前代码、数据与可重复验证入口
当前代码在 perception/experiments/b12_battlefield-creature-detection/,可复用运行模块仍为 olden_era_perception.battlefield_creatures。身份补充导出位于 project_data/perception/identity-review-2026-09-08/reviewed-export/,其中 summary.json 记录数量,validation.json 记录对原图几何和审核来源的检查。
从 Olden Era 仓库根目录,先用统一环境查看验证入口:
& local_data/devtools/environments/perception/Scripts/python.exe -X utf8 perception/experiments/b12_battlefield-creature-detection/validate_expanded_review.py --help9月24日仅核对了入口文件;上述旧导出路径不能视作现在一定存在的路径。实际验证需先确认审核导出,再显式传入--root与--export,本轮没有重跑历史数据验证。验证器检查数据一致性,不运行检测器,也不计算新精度。prepare_identity_review.py 与 build_expanded_review.py 分别准备身份审核材料、合并已核对决定;不因实验重编号而重新抽视频帧。
旧 b026.* schema、local_data/perception/battlefield-creatures/ 中的两轮测量、本文网址和旧图表资源地址保留。本文的原始预测、速度与准确率没有用新标签回写。
9. 从 14 段新录屏增加真实战场样本
检测器需要见过不同地图、阵容和战斗时刻。把同一张部署图附近的帧全部加入,虽然能很快增加框数,却没有增加多少新情况。这次先检查新录屏的战场区间,将连续的同场画面归入一个战斗组,再从组内分散取图,覆盖开场、移动交战与残局。
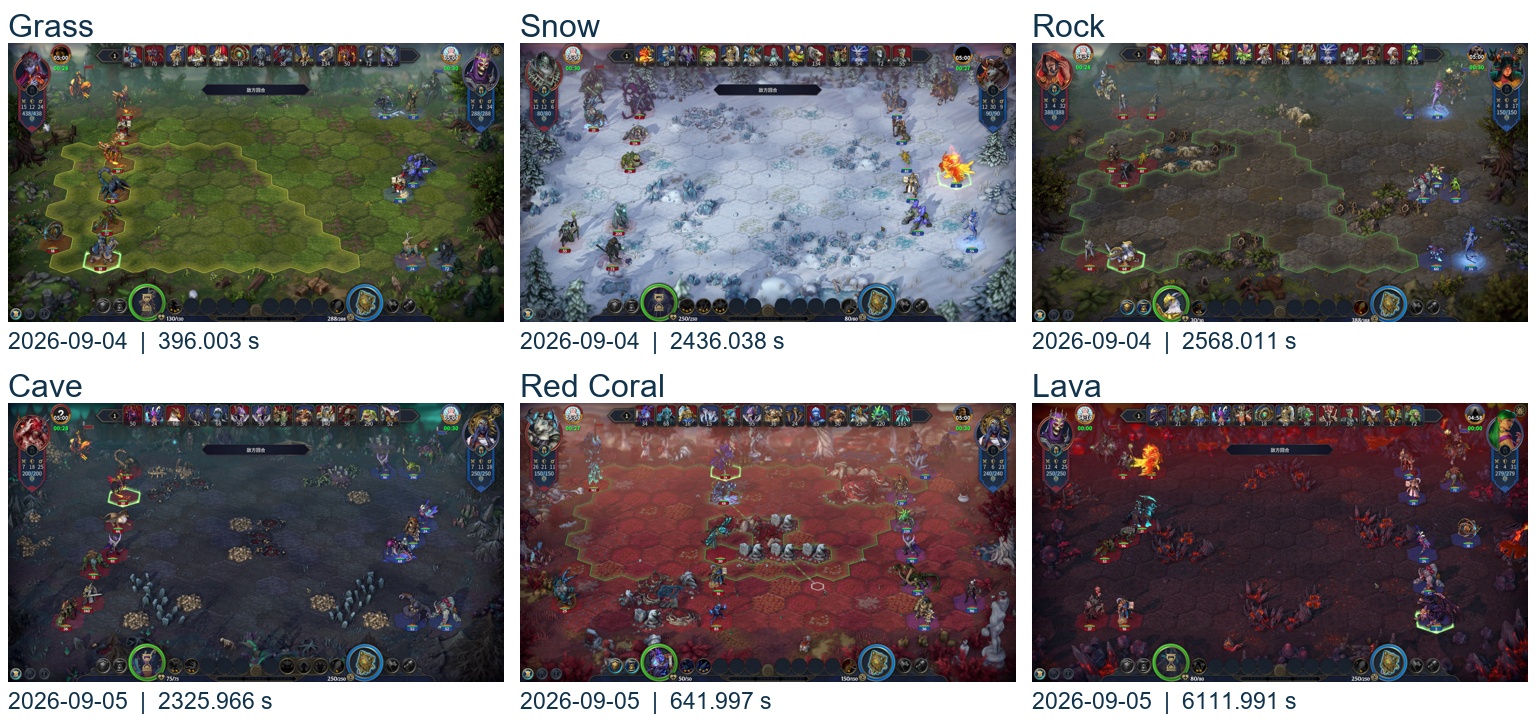
14 段录屏共选出 26 个战斗组、360 张 2560×1440 原图。其中 32 张复用原分辨率缓存,328 张从视频提取。草地、雪地、岩地、洞穴、红珊瑚和熔岩六类地图都有覆盖。这里的地图名称用于记录视觉条件;战斗组才是防止相邻帧跨训练、测试分区的重要单位。
360 张均已审核,保留 3,783 个活体框,覆盖 121 个目录身份,未知身份为零。其中 298 张完成全部目标检查,输出 3,759 个检测框;另两张只保留 24 个已核对对象用于分类研究。其余 60 张因画面条件不适合而排除。3,783 个框中 2,987 个清楚、796 个部分遮挡;修正了 1,114 个候选框,另补画 23 个漏框。
| 地图 | 检查原图 | 完整检测帧 | 已知身份框 |
|---|---|---|---|
| 草地 | 84 | 60 | 784 |
| 雪地 | 80 | 75 | 927 |
| 岩地 | 70 | 68 | 814 |
| 洞穴 | 42 | 30 | 384 |
| 红珊瑚 | 56 | 45 | 611 |
| 熔岩 | 28 | 20 | 263 |
最后一列包括那两张非穷尽画面中的已核对对象,因此不能直接当作第三列检测导出的框数。按“同一战斗组中的某种生物”统计,共 363 组:240 组出现于至少 10 张可用原图,84 组有 5–9 张,39 组只有 1–4 张。它们不代表 363 支经过跟踪的独立部队;少样本组会指导下一次抽样。
先提候选,再检查原图中的每个活体
本轮复用第二轮已冻结的 FCOS 和 ConvNeXt 模型,FCOS 接收整张战场截图,ConvNeXt 接收候选框裁图。分类器不知道整张图的阵容;行动条、数量和前后帧只在后续审核时作为额外证据。候选产生、审核后的参考框、参考身份分别保存。
FCOS 为 360 张图给出 4,747 个主候选,另保留 2,758 个低分候选供检查。审核逐张查看完整原图,接受或修正实际活体框,补回漏框,再对照生物目录外观和同场证据补齐身份。重复框和包含两支部队的组合框会被剔除;不能因为某个候选不合格,就把其中的生物当作背景。
尸体尤其容易造成误标。下面这张洞穴残局仍能看到许多原来生物的外观,但活体只剩六个;站立单位旁边还留着倒地的蓝色生物,不能因为分类器认得其外观,就继续算一支存活部队。
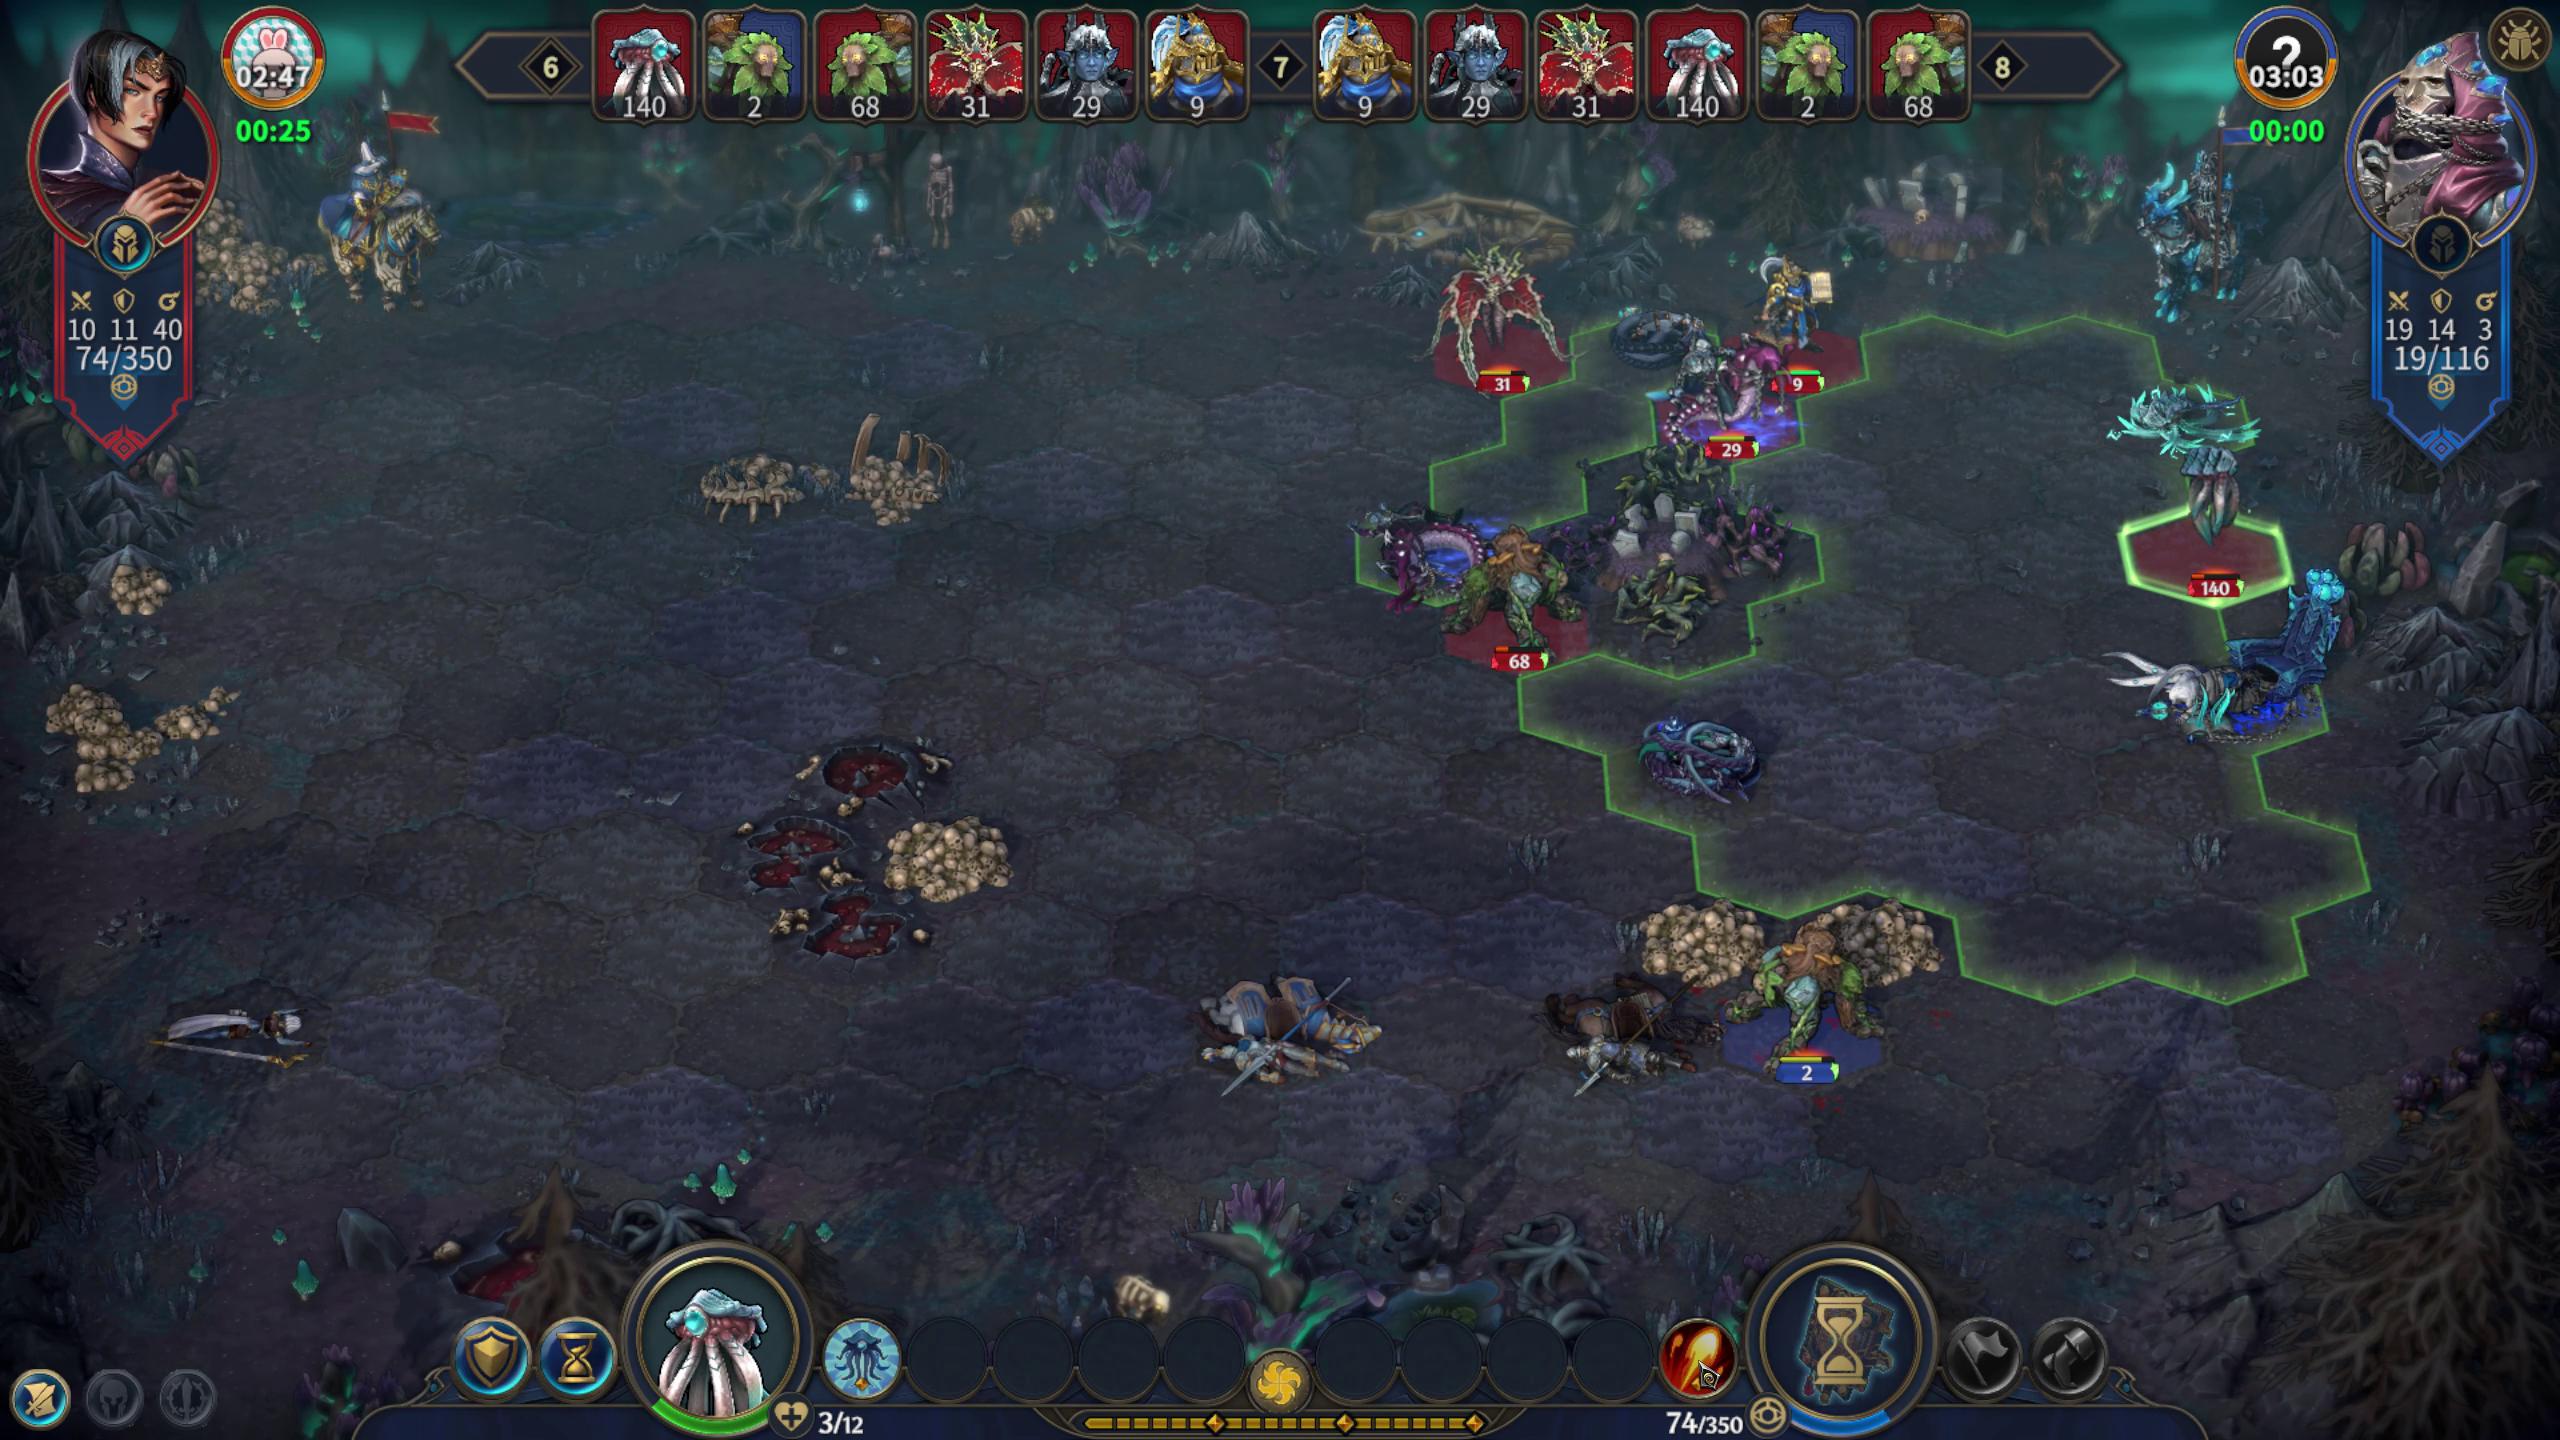
2026-09-08T02-42-52.657Z.mp4,约 31:36。点击查看原始 PNG;尚未叠加任何模型框或参考框。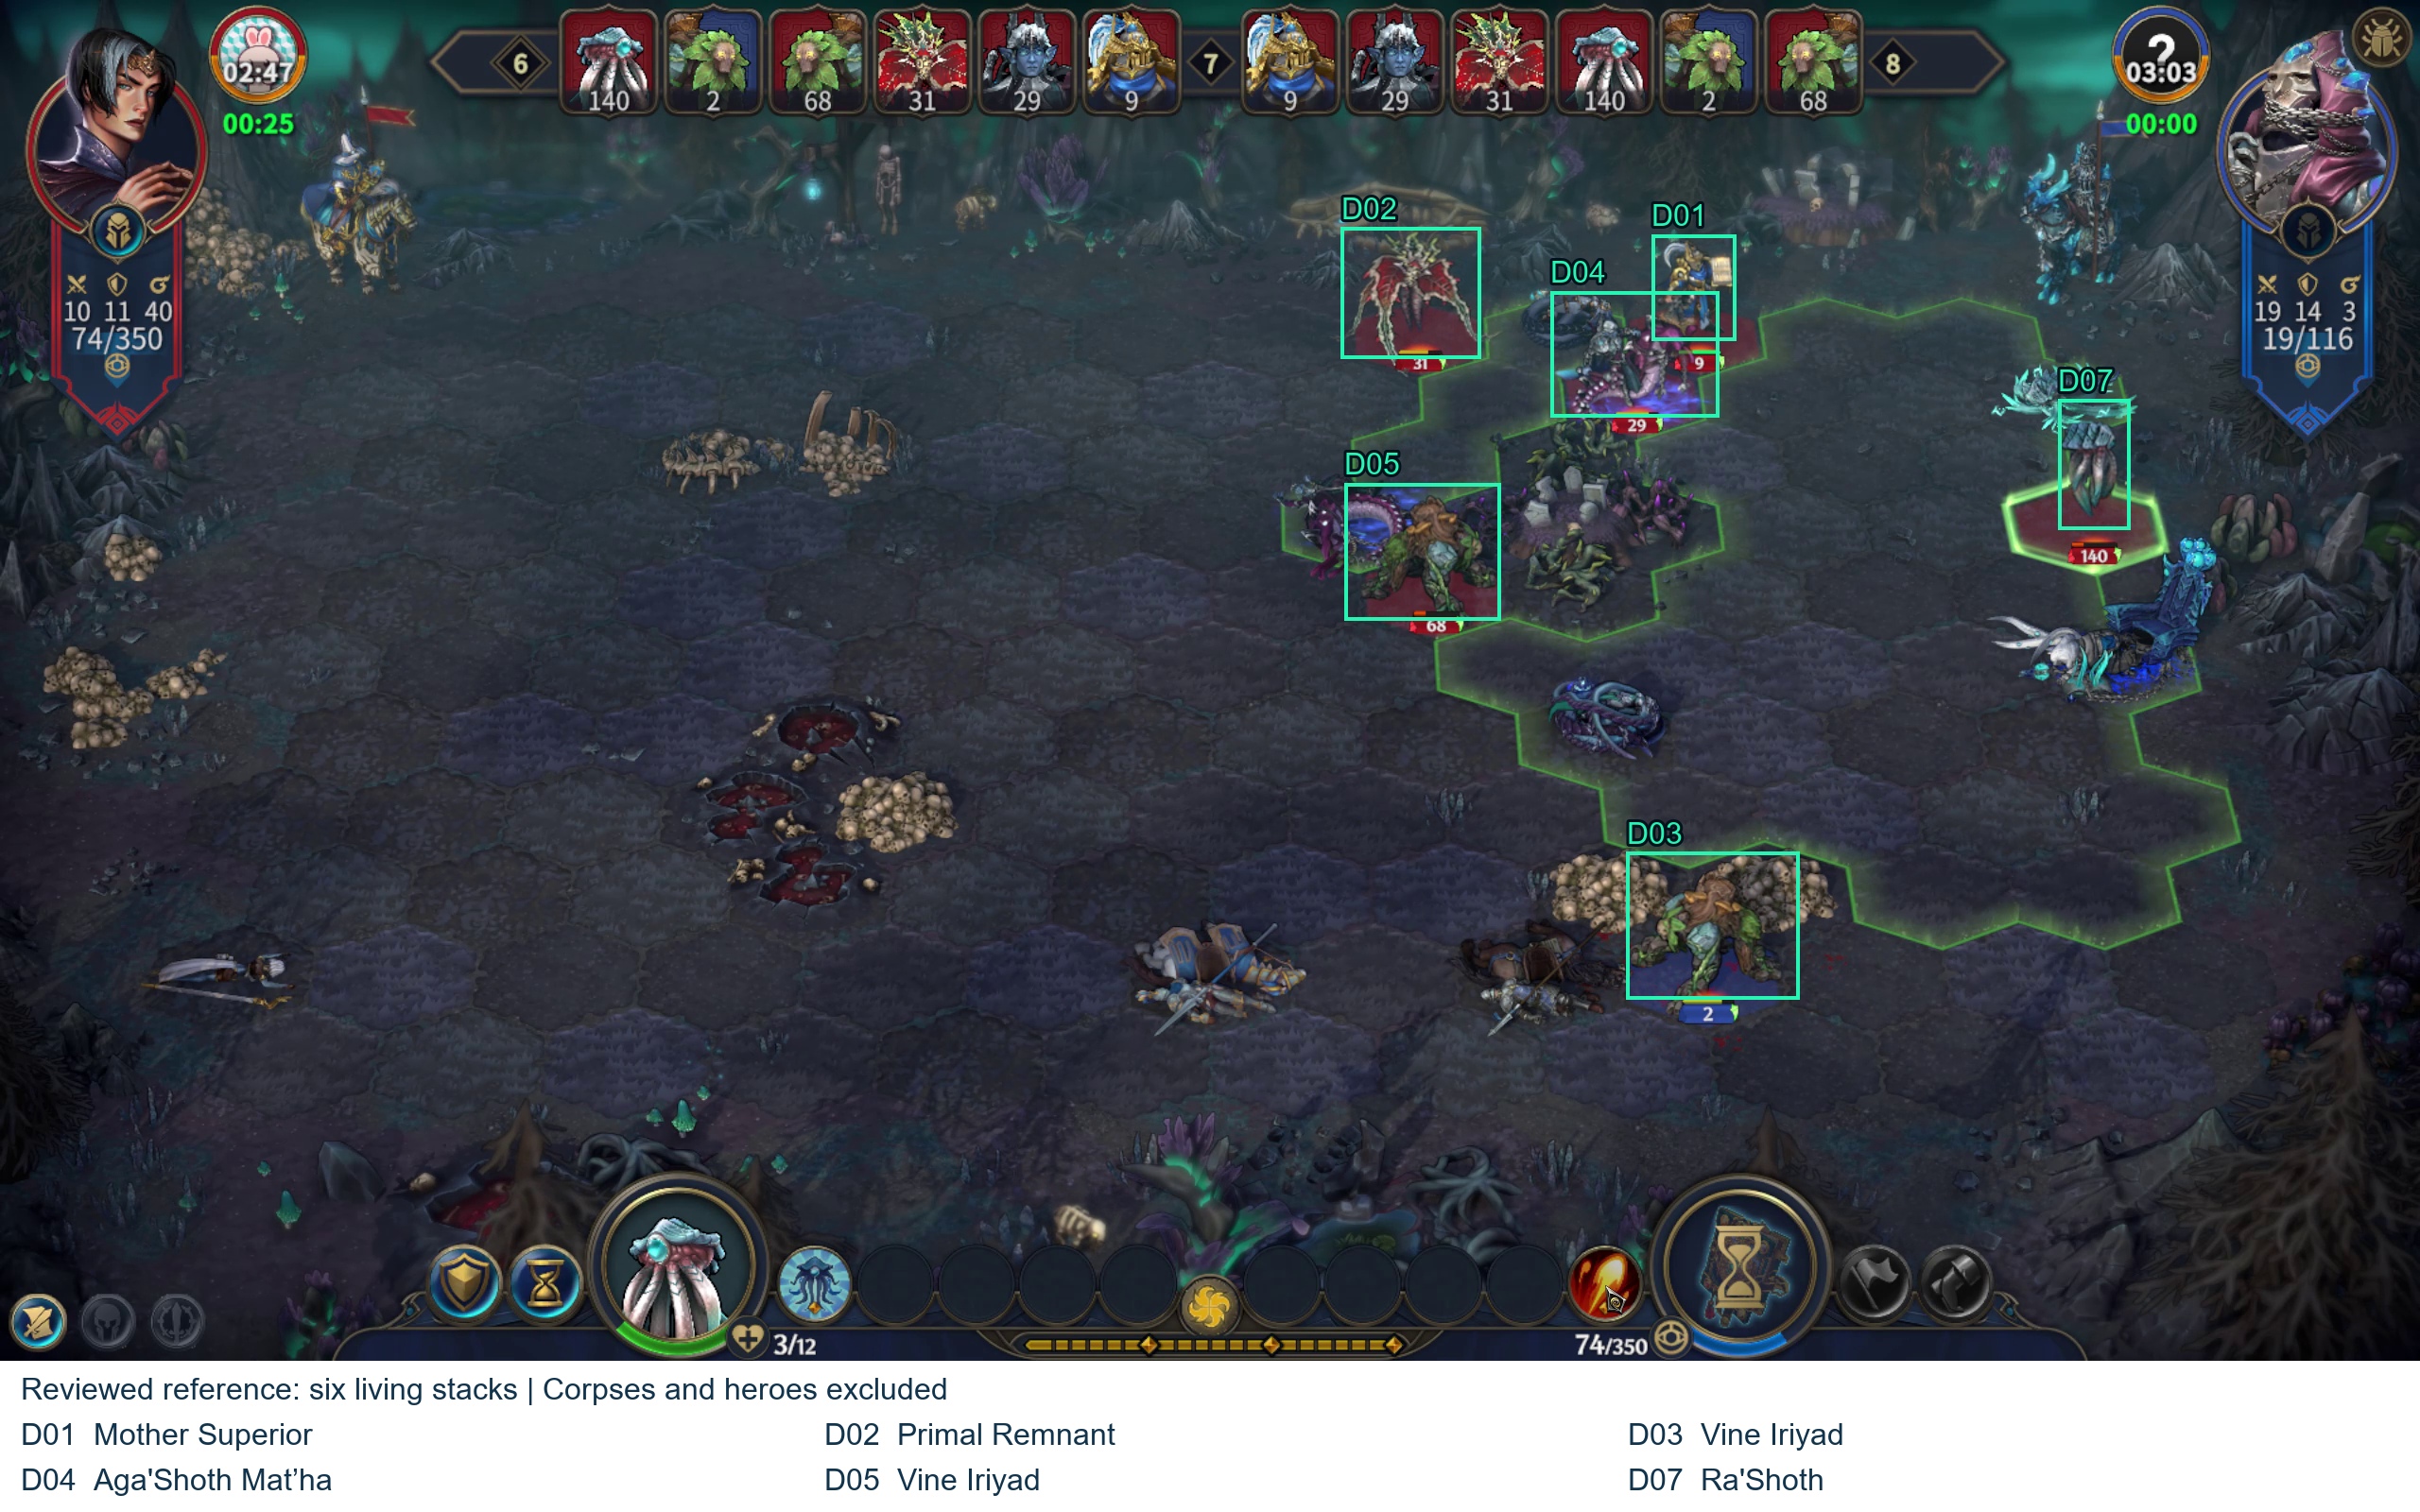
哪些错误可以变成负样本?
本轮另导出 24 个明确的非活体裁图:9 个尸体、13 个地形、1 个场外英雄和 1 个行动条头像。它们的意思是“这里没有当前任务需要检测的活体部队”,适合研究战场目标有效性。它们不自动等价于 B11 固定图标分类器的无效图标标签。
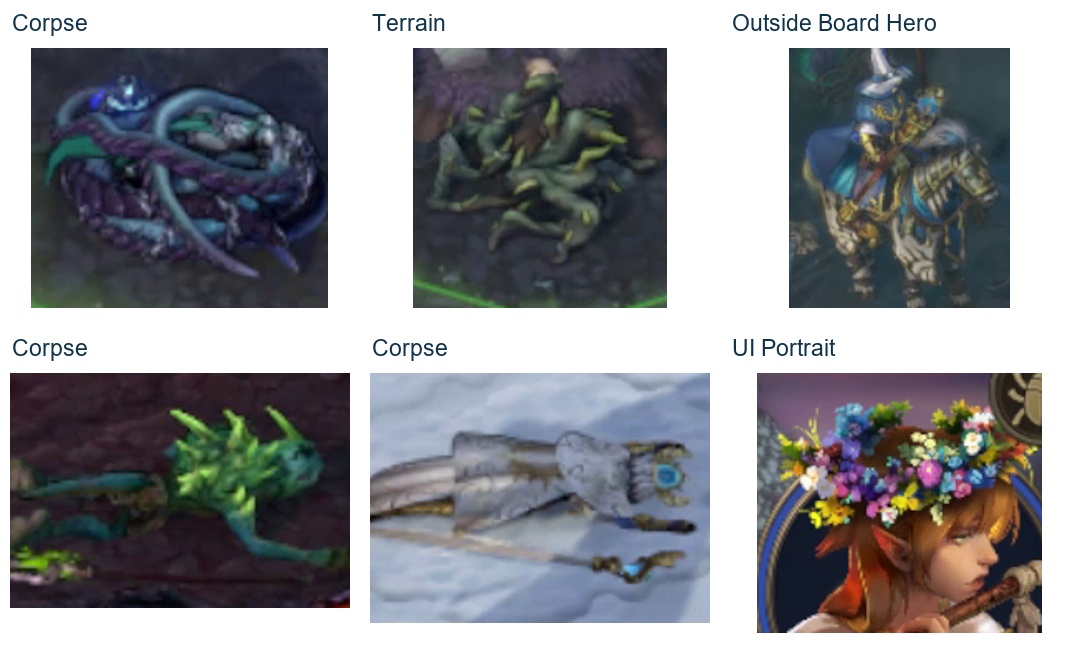
这些裁图均有明确的逐项选择和审核记录。导出程序还检查它们与已审活体框的重叠面积;本次最多允许重叠占负样本裁图面积的 2%。这个数只是数据检查规则,不是模型学习到的置信度阈值。最初选择的三个场外英雄候选因为夹带邻近活体而被排除,没有强行凑进负样本。
此外,我们在四张已审核原图上另外画出 12 个尸体框,逐个结合相邻画面确认死亡姿态,保存 corpse 辅助类别。其中 11 个清楚、1 个部分遮挡,均不与活体框相交。它们可用于“活体/尸体/其他”的裁图分类研究;只标了明确样例,没有声称整张图的所有尸体都已画完,因此不能直接当作完整的多类检测标注。相邻画面中的同一具尸体也可能多次出现,训练分区必须保持同场一致。
另一类画面需要退出全图检测训练和检测评估:弹窗覆盖战场、过渡过程中目标不可见,或无法检查完整画面。这些画面保留排除原因,不能作为“全图没有生物”的空标注训练图。如果场景仍可用,只是没有完成全部目标检查,已核对的单个裁图仍可用于分类研究,并继承原视频的数据分区。活体之间的普通遮挡则保留框、身份和 partial 可见性,方便之后单独评估遮挡识别。
从样本回到视频,也从视频找到实验
每个审核对象保留原视频名、实际取帧时间、原图、框坐标和身份来源。统一索引还能列出该图参与过的场景分类、网格分析、检测候选和参考标注。这样发现一个错框时,可以回到原视频查看前后画面,而不必猜它来自哪次运行。
本机的视频与分析索引和新增战场原图与身份提供这两种入口。所有新数据暂存为开发数据;没有随机拆散相邻帧,也没有据此改写前文的模型准确率。
复核覆盖率、复现图表与导出数据
本轮文件位于 project_data/perception/battlefield-creatures/captures-2026-09-08/diverse-native-cohort/。cohort.json 保存原图计划;box-decisions/ 保存逐图决定;reviewed-export/ 保存可训练对象、全图检测标注与浏览页面;living-target-negatives/ 保存负样本原像素裁图。
实验目录的 summarize_review_coverage.py 从审核结果计算每个视频、地图、战斗组和身份的覆盖率。这里按“同场某类别出现在多少张不同原图”计数,同帧两边都有同类时只算一张;它不是跨帧部队跟踪。提前死亡的单位或短暂召唤物可能不足五张,不能用相邻重复图补足数量后声称有五个独立实例。
render_expanded_cohort_figures.py 从这些原图和明确的负样本记录生成图 9–12,同时记录每幅图对应的来源。两个脚本的完整运行命令在 B12 的 README 中。模型没有因生成图表或重建索引而重新训练。
10. 当前结果与下一轮重点
2026-09-10 的新视频接线复用了本篇第二轮固定的 FCOS + ConvNeXt 组合:两段录屏共 275 张关键帧,其中 112 张本地战场候选实际运行身体检测,得到 1,234 个身体候选。每个框保留分类 Top-5,但 Top-1 只显示为类别建议,尚未经过未知类别拒识校准,不写成确认身份。这是历史基线接线,不是把它重新宣布为最新最优模型;B13 的定位候选需要按其协议另行接入比较。
抽看新视频的普通战场仍能看到重复框、场边英雄误检和类别错误,因此本轮没有新增身体检测准确率。自动结果已经进入纯本地语义时间线,与 B032 新接入的数量牌和数字同图显示;身体框、数量牌和空间关联分别保存,不会根据一个数量直接确认生物身份。
这次已经建立了从原图、逐图参考标注、训练、跨视频测试到结果浏览的完整实验路径。公开检测器可以提供起点,但真正的战场框和身份样本明显改变结果;选择页数据适合补充身份训练,不能替代战场数据。
对第一轮的六张验证图做了另一轮逐项复核:11 个漏检中,10 个已经有位置正确但分数偏低的候选;5 个定位误检实际都是生物,其中 3 个是重复框,2 个只是在 IoU 边界上不够准确。不能把这些裁图统统当成“背景负样本”。11 个身份错误里,10 个在人工参考框上也错,主要是相似兵种和升级分支,而非检测框导致所有认错。
第二轮的验证集也做了原像素复核:19个定位误检分为9个重复框、6个边界不准的框、4个骑乘英雄;7个漏检均存在位置合格的低分候选。重复生物框、骑乘英雄和纯背景应分别处理。把它们统统当背景训练,可能反而压低真实生物得分。
新增数据的来源分区与候选检测器训练已在 B13完成,后续仍需分别研究重复框抑制、低分真目标和身份拒识。第二轮历史 test 的联合召回仍不到 50%;B13 只测位置框,不能把它的检测成绩写成身份识别已经完成。两轮历史 test 保持冻结;此次反复审核的数据可以用于开发评估,但不能称为从未查看的新盲测。
当前标签入口、实验配置与评估脚本归入 B12(原 B026);大型截图、模型和运行输出留在各自数据目录。B11 研究已知槽位中的图标分类,B12 研究战场生物的框与身份,B15/B16 研究网格位置与格子状态;原有 B03 通用 UI 检测文章继续作为独立历史实验。
Comments