B16 · 战场格子状态 · 实验记录与相关篇目
输入截图和网格,输出可见的障碍物、分颜色范围与路径候选。9 月 8 日仅更新实验入口,保留此前模型、草稿标签与冻结测量;尚不保证移动合法性。
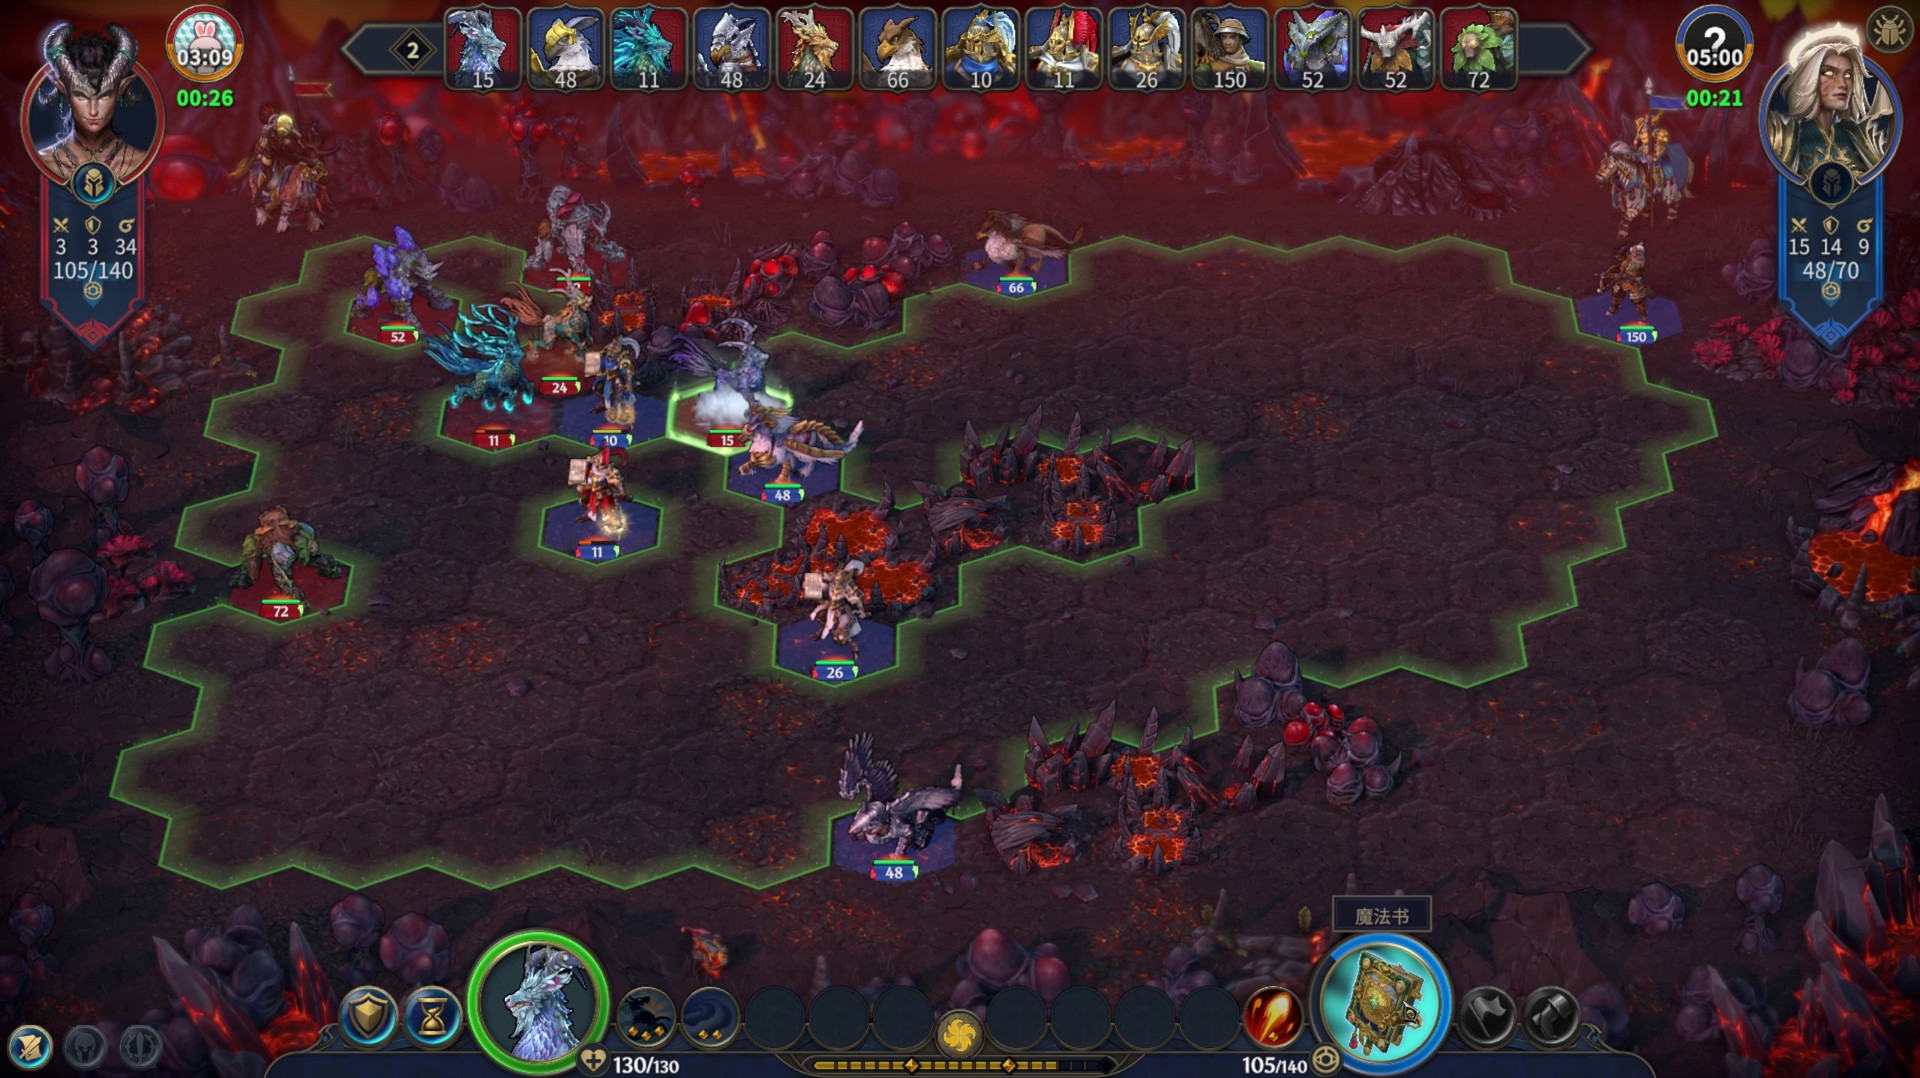
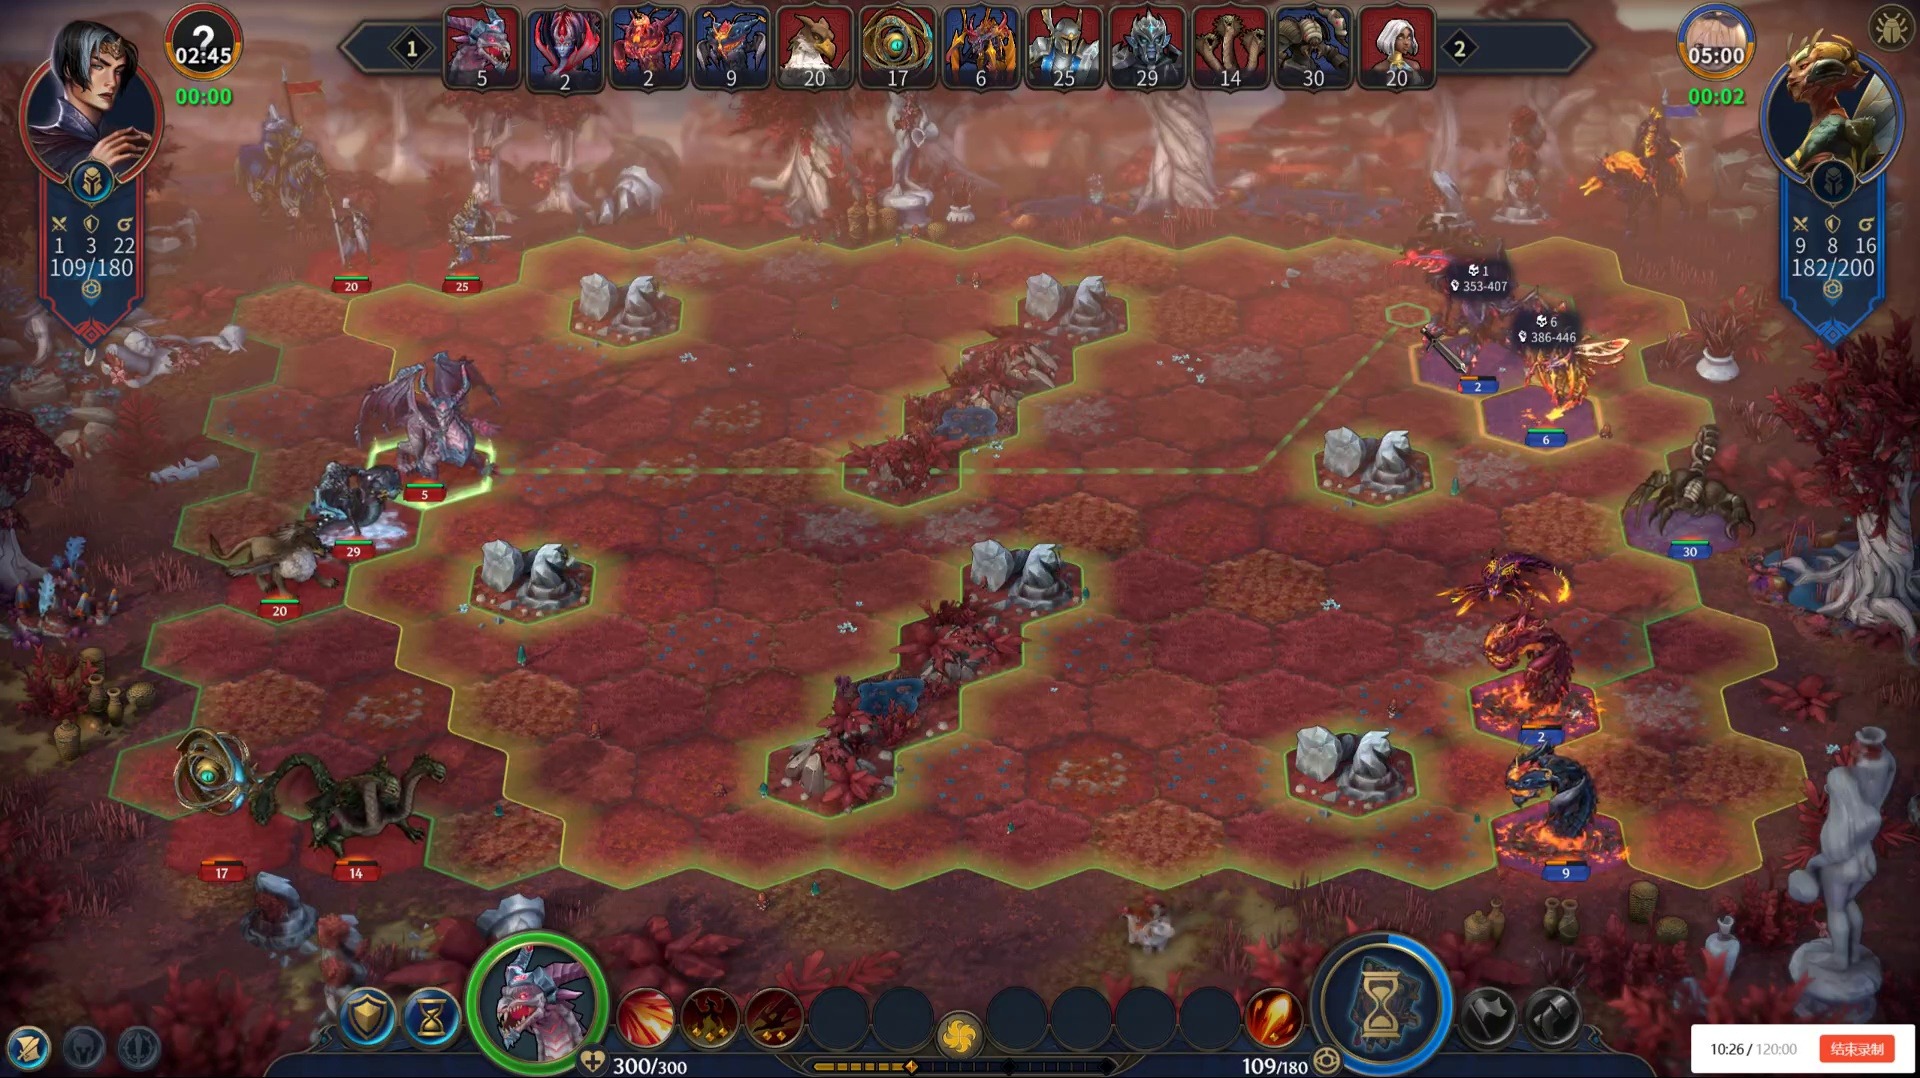
在《英雄无敌:上古纪元》的战斗中,石头可能挡路,鼠标悬停会显示一个兵种的活动区域,选择目的地还会出现路径。要让程序理解战场,除了知道六边形格子在哪里,还得读懂这些会变化的画面。这一轮优先解决高亮范围:把画面上的彩色边界,转换成一组格子坐标。
输入是一张完整截图和人工确认过的 137 格战场模板,左下角为 (0,0),向右增加 x,向上增加 y。输出是黄色、绿色分别围住哪些格子;一个格子可以同时属于两层。难点不只是辨认颜色:背景会改变高亮的外观,轮廓会断,移动路径又可能穿过它。
单靠固定颜色规则,遇到不同地面和重叠轮廓仍会大面积漏检。这次又从 7 段缺少分颜色标注的录像补充 31 张图,让小型树模型学习“哪些颜色变化更像一条范围边界”,再用已知网格恢复内部。模型固定后的 10 张检查中,黄色精确率 / 召回率为 100% / 97.1%,绿色为 100% / 97.5%。精确率问报出来的有多少正确,召回率问真实存在的找回多少。
新增训练数据确实有帮助:同一个模型只用旧 53 张训练时,这 10 张的黄、绿召回率是 89.3% 和 90.8%;加入 21 张训练图后,两者才升到上述结果。重叠格子找到 145/160,但它们只来自两张相似画面,不能据此宣布各种战场都已解决。下面保留从颜色规则到学习型边界的过程、失败尝试与每次冻结检查。所有标签仍是助手查看原图后的草稿,待人工复核;最新数据对照在新增录像实验。
图 1。网格给位置命名;这一轮重点改进中间的范围检测。障碍物与路径仍保留为独立观察,尚未组成可直接执行移动的地图。
1. 有颜色的边界,围住未必有颜色的格子
绿色、黄色的区域轮廓经常很明显,但它们包围的地面仍是原来的草地、雪地或熔岩颜色。这就是任务的关键:找出彩色像素,只完成了找边界;我们真正要输出的是边界里面有哪些格子。 两层区域可以同时出现,也可以重叠,不能给整张图只选一种颜色。
| 要观察的信号 | 输出 | 需要排除的干扰 |
|---|---|---|
| 绿色、黄色的范围轮廓 | 分颜色的格子集合,以及两层并集 | 草地颜色、兵种选中圈、单格目标框、路径线 |
| 岩石、树桩等环境物体 | 可见障碍物候选 | 活兵、尸体、地面装饰与遮挡 |
| 移动预览中的细线 | 可见路径片段 | 武器、白石、文字和其他光效 |
颜色与战术含义也要分开。玩家观察到当前行动、查看己方非行动单位、查看敌方单位时,范围显示有所不同。我们还没有为这三种交互建立可靠的一一对应表。回看一段录像的 07:25 → 07:26,绿色范围仍在右侧,黄色范围却随鼠标从左侧目标附近转到右侧选中单位附近;不能简单写成“黄色就是敌方”。
安装文件中的类型与配置也分别命名了可移动范围、潜在移动范围、攻击范围、单位选中圈和路径,并提供按战场类型覆盖的范围特效。它支持优先利用颜色与边界,却没有给这次截图检测提供现成的范围答案或完整颜色映射。因此,本轮衡量的是显示区域是否读对,尚未衡量它属于哪个兵种。
2. 同样的图片,怎样比较才不误导
数据逐步扩充,每次都把调参结果与首次检查分开:
| 数据阶段 | 图片 / 录像组 | 在什么时候使用 |
|---|---|---|
| 旧分颜色数据 | 24 / 6 | 方法设计与按录像留出的回顾比较 |
| 第一次冻结检查 | 20 / 5 个其他组 | 先固定候选,再选源图、标注和预测;暴露绿色漏检 |
| 扩充后的开发数据 | 44 / 11 | 将上述失败纳入开发,选择新版绿色线条规则 |
| 第二次冻结检查 | 9 / 3 个其他组 | 再次固定候选后才提取、标注和预测 |
| 本轮新增开发 | 21 / 5 个其他组 | 先标原图、跑旧规则,再与历史 53 张合成 74 张开发集 |
| 本轮预留检查 | 10 / 2 个其他组 | 树模型和参数固定后才提取、标注与预测;没有加入训练 |
前两次检查共选取 45 张源图,其中 16 张有大面积法术书或弹窗,在推理前排除,来源记录仍保留。保留的 29 张中,20 张有 1,950 格可判断、790 格未知;9 张有 925 格可判断、308 格未知。遮挡、兵种占位和看不清的格子不计分,程序本身尚不能可靠自动排除这些位置。
这次检查了全部 21 段录像:它们都有粗场景时间索引,但 7 段此前只有障碍物或范围并集样本,没有独立的黄、绿标签。我们从这 7 段解码 51 张候选图,保留 31 张;其他 20 张因大弹窗、部署阶段或已有相似无高亮对照而未纳入,均发生在预测前。预留组最初弹窗较多,按源图筛选后额外补抽 5 个时间点。最终分颜色数据达到 84 张 / 21 段录像,其中 74 张用于本轮开发,10 张保留作首次检查。新增开发图有 2,084 格可判断、793 格未知;预留图有 927 格可判断、443 格未知。
每段录像中的帧仍可能高度相似;例如两张雪地图显示了几乎相同的黄色形状。新增录像组未参与对应候选的颜色参数选择,但其中其他时间点曾用于更早的范围并集试验,因此不能称为完全从未看过的素材。第二次首测后,我们又用这 9 张图诊断重叠失败;后续消融都标为开发结果,首次冻结分数单独保留。
此前的数据、分组与 11 个版本如何比较
已有素材共 21 段录像、约 17.2 小时。此前完成了 40 张稀疏标注,旧方法在新录像上的范围 F1——综合考虑误报与漏检的分数——只有 60.9%,与全部判为区域内的 60.5% 几乎相同。这些已经看过的错误,现在用于开发新方法,不能再称为未见过的测试。
上一轮从另外 6 段录像中选取 24 张图,覆盖绿色、黄色、两层重叠和没有大范围高亮的对照。最初按录像分组,再开发和选参数:
| 数据 | 图片 / 录像数 | 用途 |
|---|---|---|
| 之前的 40 张 | 40 / 15 | 分析旧失败、开发方法;保留历史分数 |
| 新开发组 | 8 / 2 | 检查新的颜色与边界处理 |
| 新验证组 | 8 / 2 | 在预先列出的参数候选中选择 |
| 新测试组 | 8 / 2 | 参数固定后才运行,不能再按结果调整 |
这些图逐张查看原始截图,再按已有格子编号记录标签。共 2,251 条可见空地的区域内外判断;遮挡、占位或无法确定的 1,037 格保持未知。 每种颜色分别标区域内外,允许一个格子同时属于两层。所有这些仍是助手视觉标注,待作者复核;不是从颜色阈值自动生成的答案,也不是 24 张独立战场。
现在 24 张图都已经看过,因此本次比较是回顾性实验。 对需要选参数或训练的方法,每次留出一整段录像,用其他五段选择参数或训练,再预测这一段;轮流做六次,每张图只贡献一次留出预测。它比把同一录像的近邻帧随机拆开更严格,但算法设计已经受到这些失败图的启发,仍不能当成一次全新的独立测试。
原固定参数和“只放宽黄色色相”是两项不重新选参数的对照。其他颜色与线条方法分别为黄、绿选参数,优先提高精确率、召回率中较低的一项;两个小分类器则使用事先固定的训练设置。这是实际尝试版本的比较,不是对每个算法进行同样规模调优后的理论上限排名。 这组历史比较当时没有增加新录像标签,也没有因为预测错误修改已有标签。后续新增的 29 张单独记录。
下面保留上一轮的原始图库和结果。开发、验证、测试是当时的角色;本次 11 个版本的逐图对照在第 6 节,可以额外查看检测到的格边和重叠区域。
展开上一轮 24 张图的来源、标注与旧预测
画面与来源说明
图 2。橙色框是标签中的区域内格子,青色点是区域外格子。预测视图另用粉色表示误报、橙色表示漏检。没有标记的格子未评价;不能把它们看成正确排除。
另从已经用于开发的录像中提取了 12 张、间隔一秒的鼠标交互上下文,用于检查颜色变化,其中包含法术书遮挡画面。它们没有新增格子标签,不计入 24 张或任何检测分数。每张来源图都保留录像文件名、准确时间位置和采样用途。
3. 所有方法都要先找到线,再恢复内部格子
先解释比较的起点:上一轮的颜色边界方法分三步串联。它不读取兵种速度,不调用游戏规则,也没有学习分类器;标注只用于验证参数和评价输出。第 5 节的历史版本主要改变前两步;第 6 节的新方法进一步替换了区域恢复。
第一步:提取比两侧地面更明显的黄、绿线条
先将 RGB 转成 HSV:H 表示色相,S 表示饱和度,V 表示亮度。分别筛选黄、绿颜色,再计算颜色差异:绿色看“绿通道比红、蓝强多少”,黄色看“红和绿共同比蓝强多少”。这让检测不必依赖一个完全固定的 RGB 值。
仅筛色仍会把草地、发光物体和兵种算进去。因此程序沿每条已知格边检查:中间的颜色信号,是否比两侧地面都更强?连续的一大片绿色地面通常缺少这种局部突出,细边界则更容易留下来。饱和度门槛也不能过高,否则淡色轮廓会在第一步就消失。
第二步:允许少量偏移,把线条对齐到格边
已有的投影和真实线条不会处处重合。程序在每条格边附近一个有限的垂直带内寻找支持,再看这条边有多少采样点符合颜色差异要求。支持足够,才接纳整条格边;孤立的短小片段会被过滤。
这个办法利用的是已有网格形状,并没有重新拟合整个战场。搜索带太窄会漏掉真实线条,太宽又可能吸入附近草地和物体的颜色。因此,容差和阈值用独立验证录像选择,测试时保持不变。
第三步:从每个格子向外看,数穿过了多少条边界
旧几何方法要求轮廓完全闭合,再往里面填充。只要漏掉一段边,填充就可能从缺口漏出去,最后整片内部都为空。新方法换了一个判断:从格子中心向外画一条射线,数它穿过几次边界。完整边界下,奇数表示在范围内,偶数表示在外面;围住障碍物的空洞也能被保留下来。
图 3。判断的对象是格子中心的位置,不是它本身有没有彩色像素。图中的绿色填色只用于解释。
真实检测的边界会有缺口,所以程序沿 18 个方向重复计数。不同方向可能绕开不同缺口,再用验证组选出的阈值综合判断;本轮要求至少 8/18 个方向判为内部。黄色、绿色独立计算,最后才取并集。这个投票比例是几何一致性分数,不是“属于区域的概率”。
下面是开发图 more-001 的实际处理过程。它有大片未着色的内部、几组障碍物空洞和被兵种挡住的轮廓。
展开完整原图、提取出的边界和最终区域
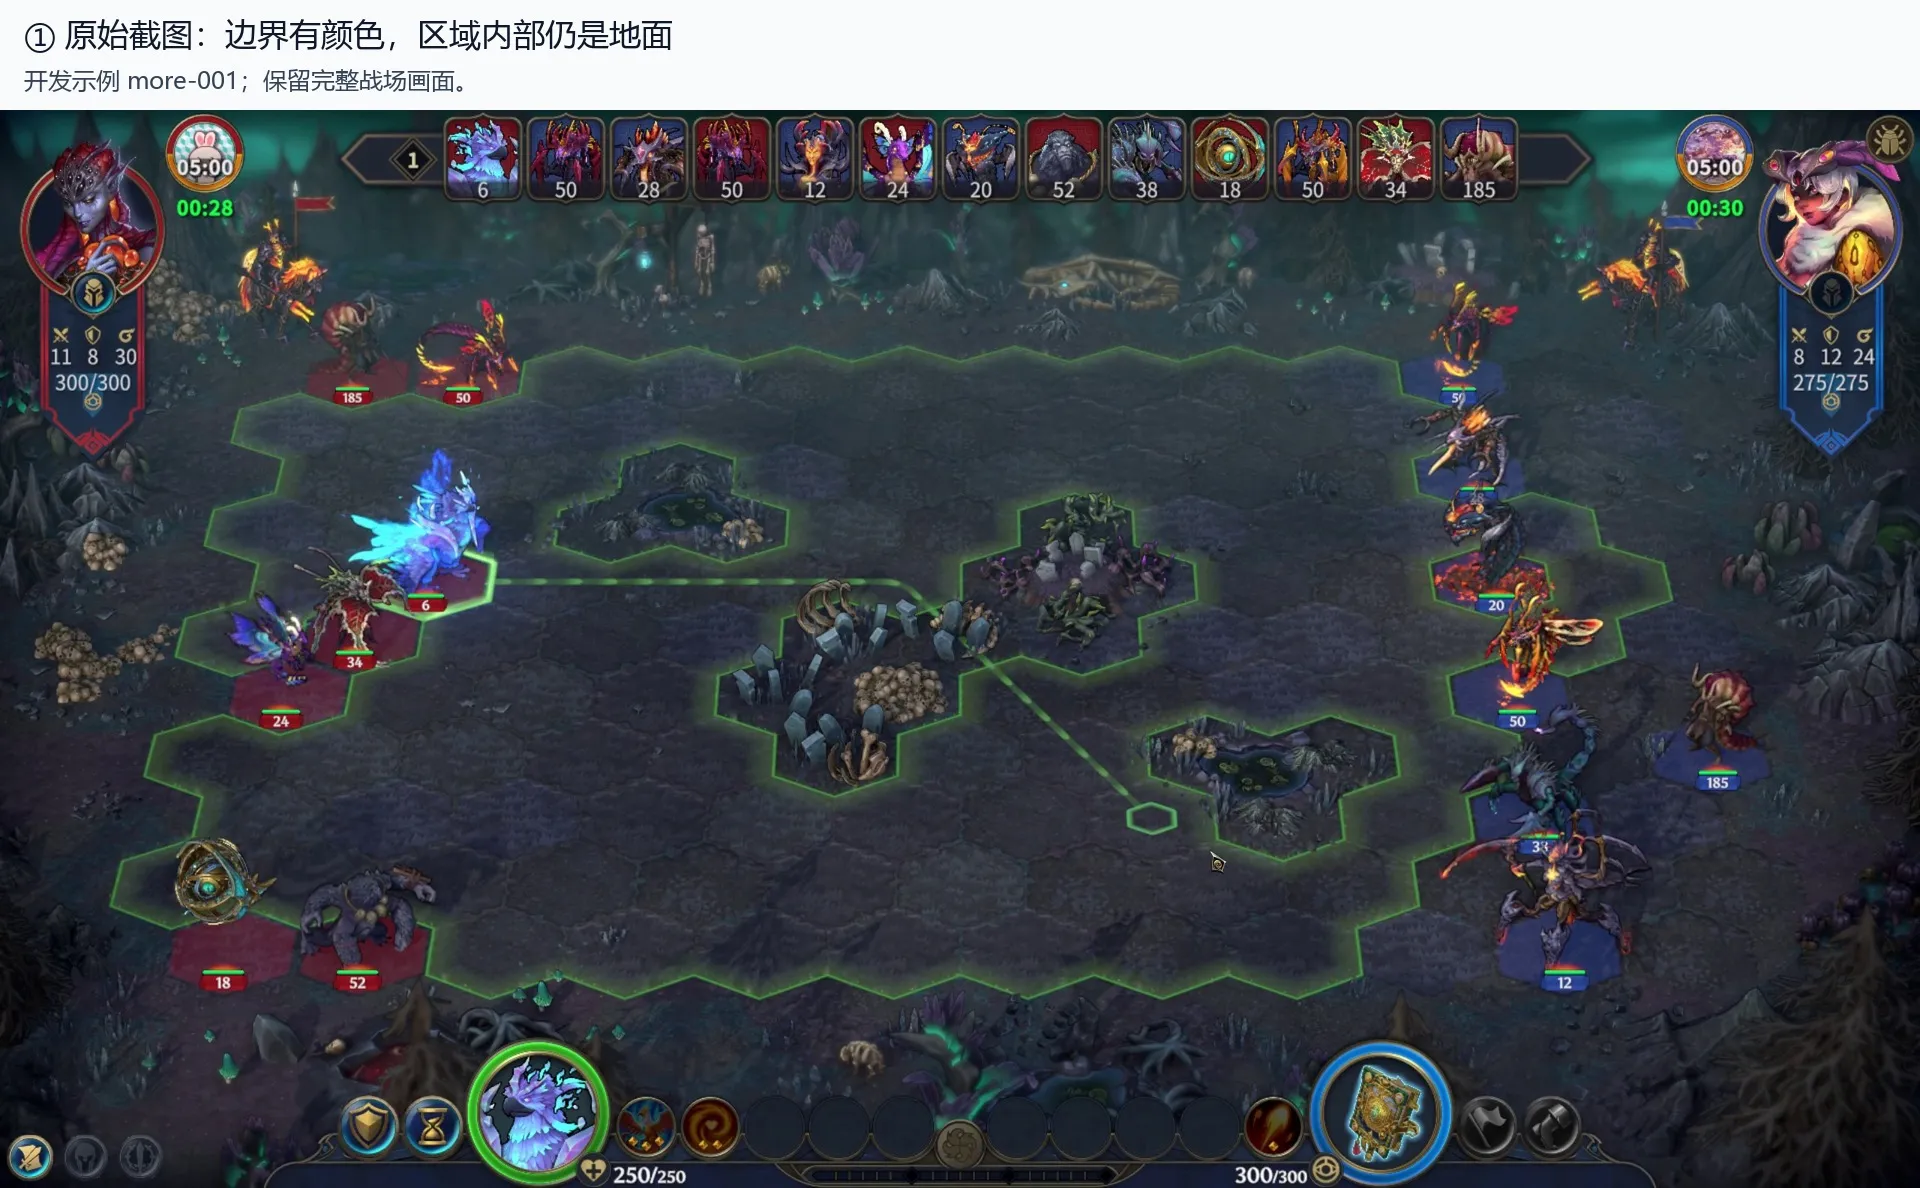
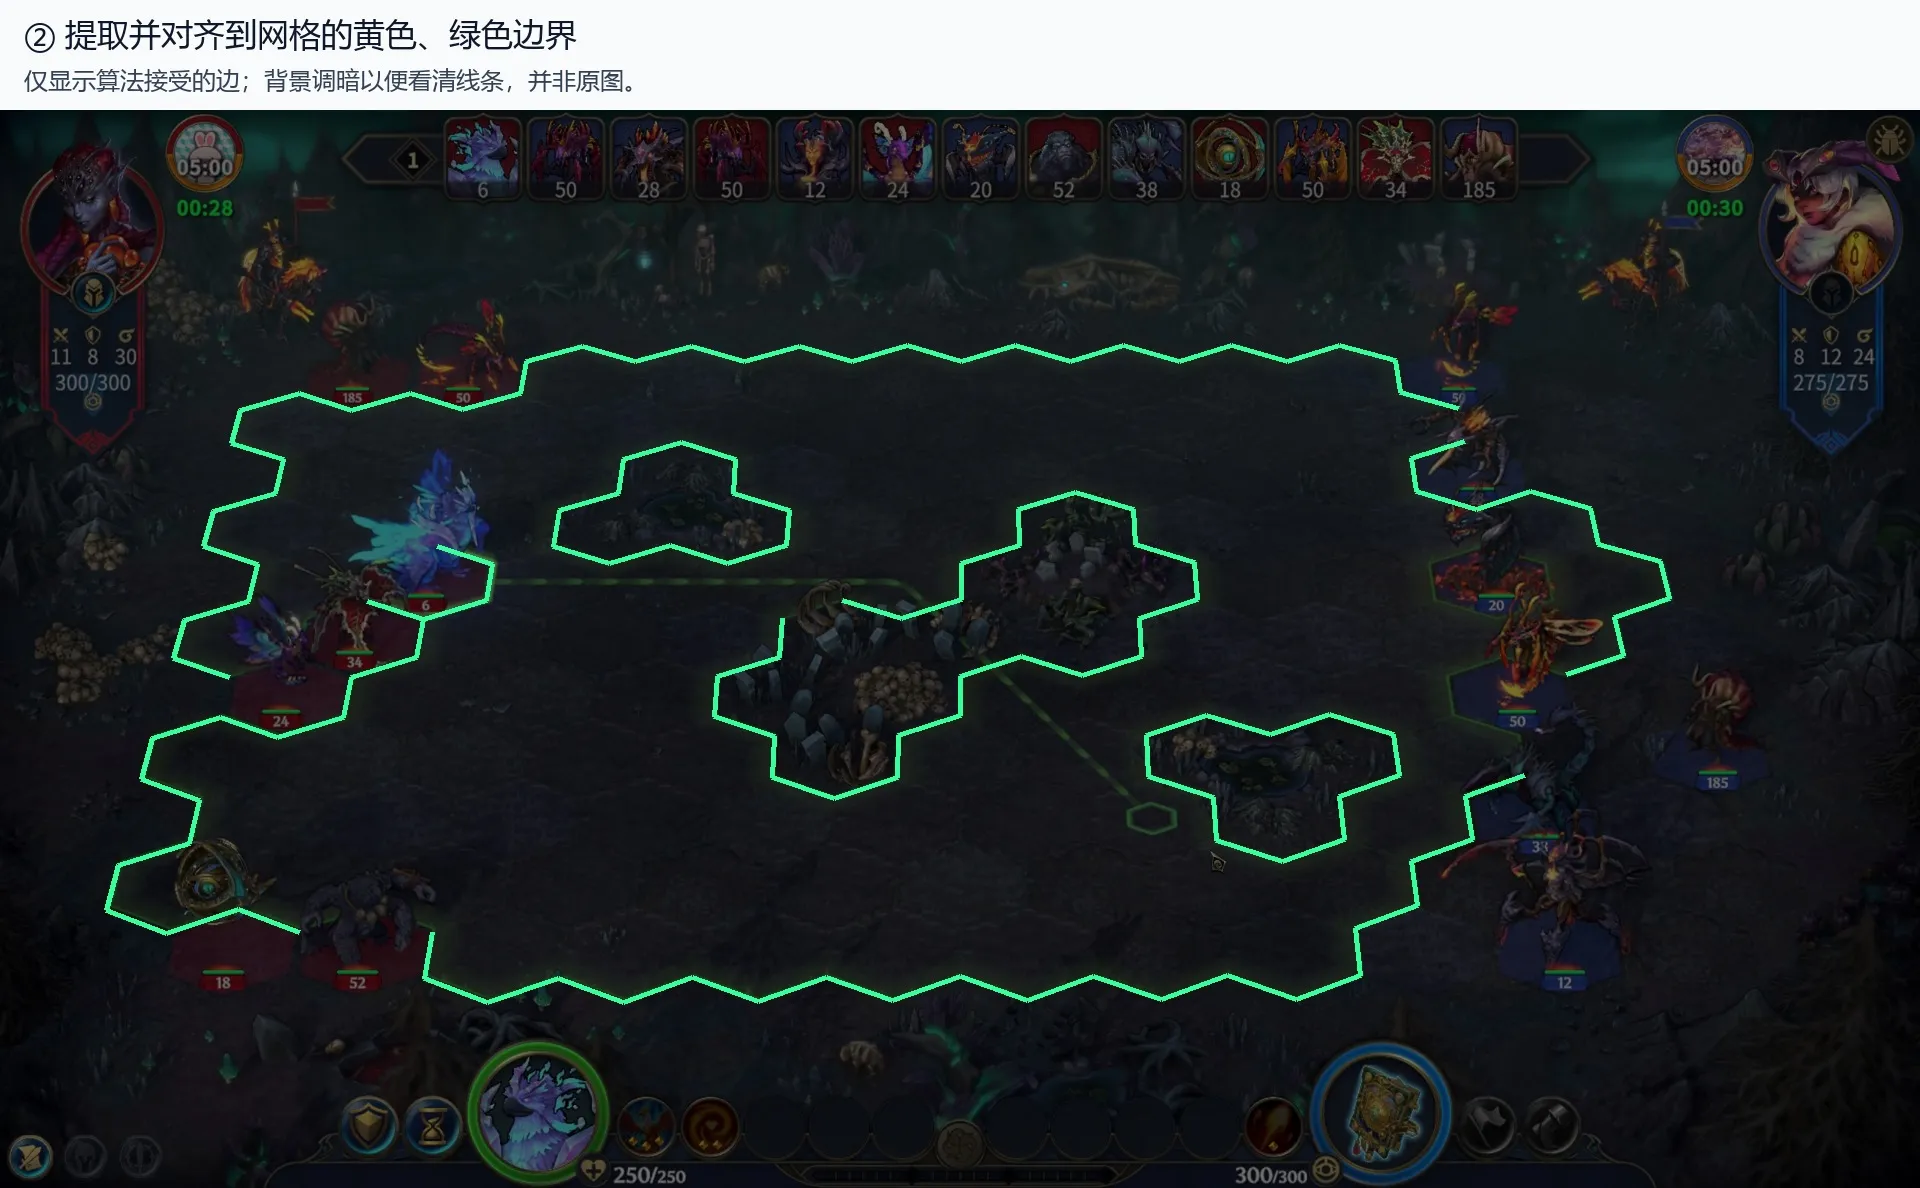
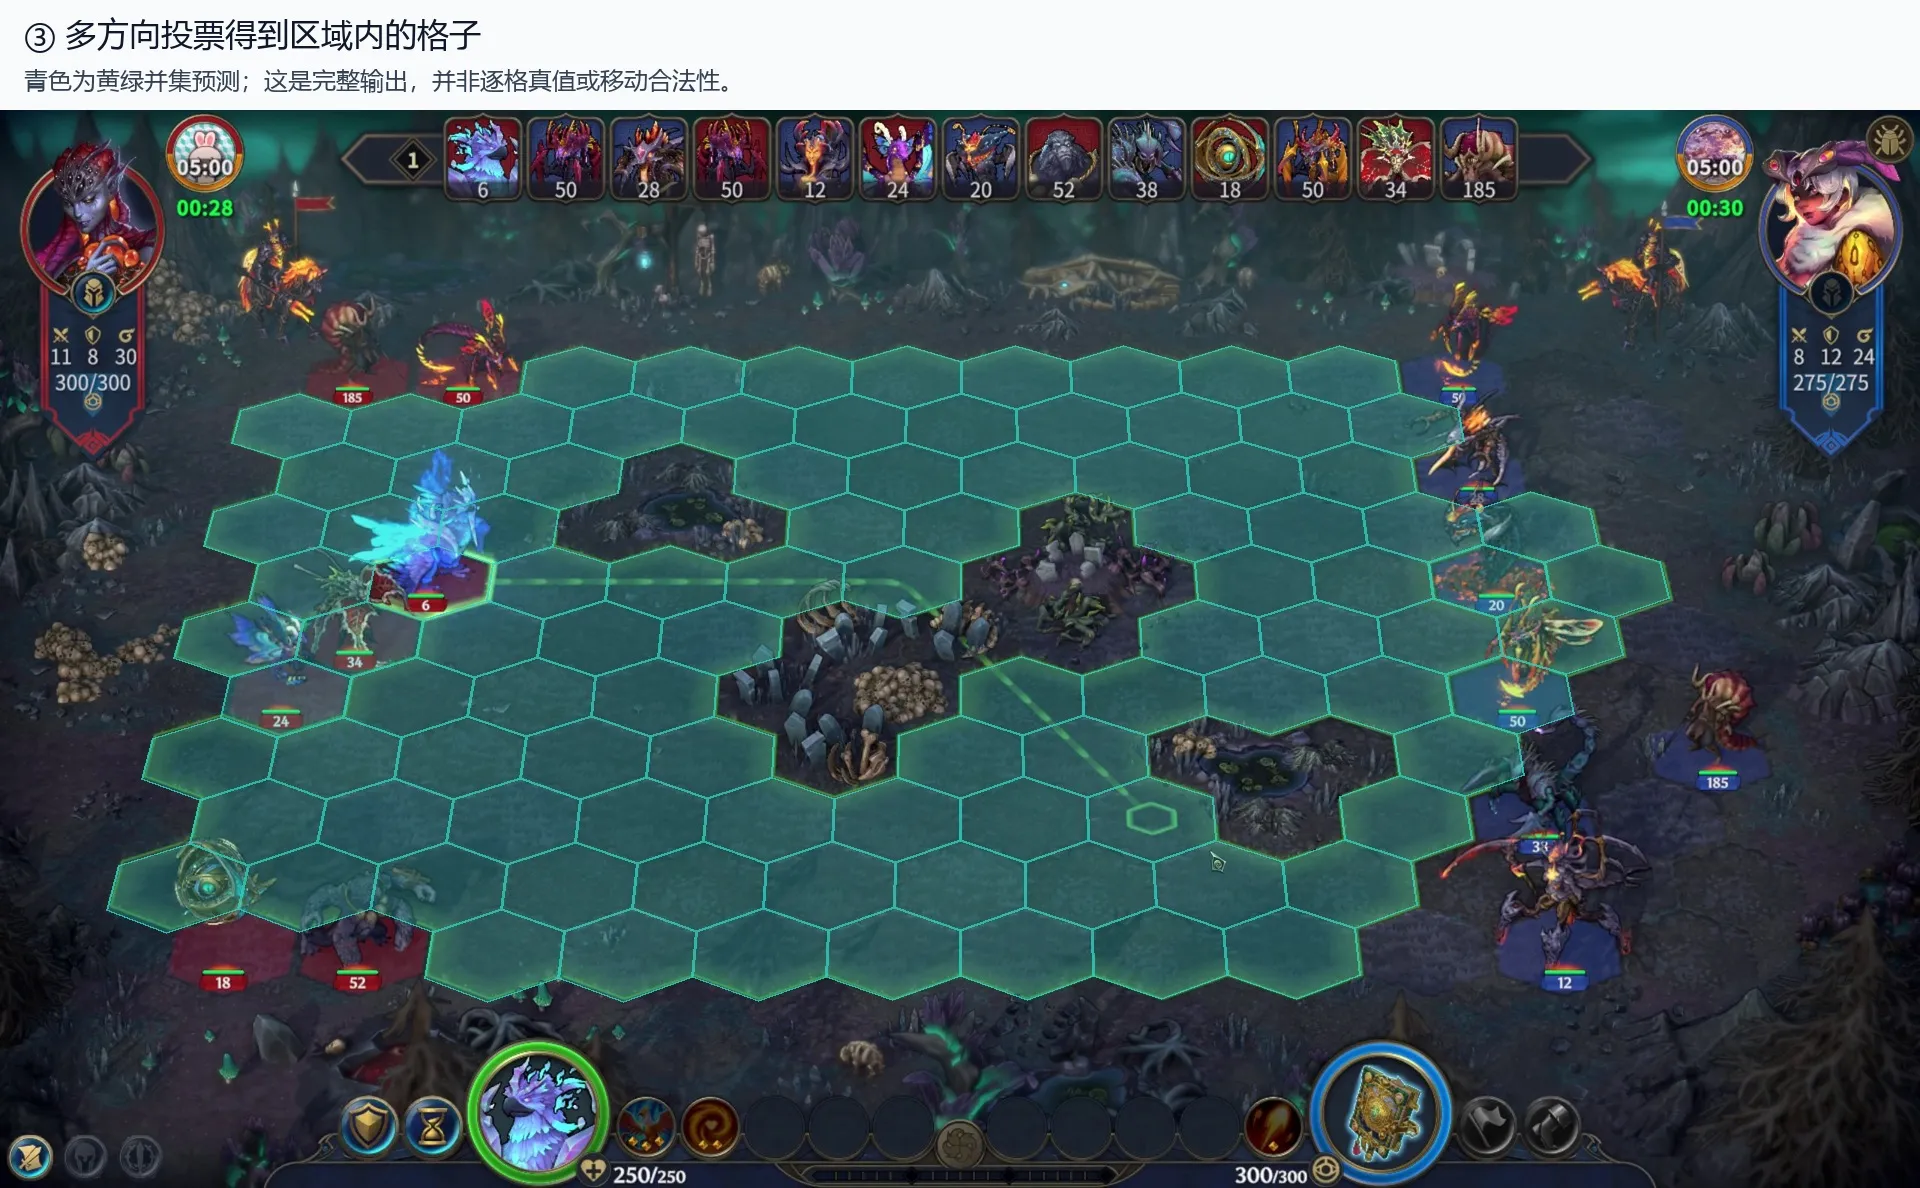
图 4。三张图使用同一张开发截图。最终图展示全部候选,不只展示被评价格子;放大后可检查完整战场。
在完全相同的一组新边界上,闭合填充仍漏掉全部 47 个已标注内部格子,多方向投票则找回 46/47,误报 0 格。这个对照说明,恢复内部的方式本身确实影响结果;不是只换一个颜色阈值就解释了全部改善。它是开发案例,最终效果仍要看其他录像。
4. 黄色信号消失了,还是程序把它删掉了
在 highlight-103 这张雪地图上,外面有宽的绿色光晕,右半边还有一条细黄色折线。原方法把 64 个黄色内部格子全部漏掉,却正确恢复了绿色范围。最初我们怀疑,黄色与绿色重叠后,部分边界被覆盖,无法组成独立闭环。仅凭漏检不能证明这个解释;必须检查原始像素和每一步留下的证据。
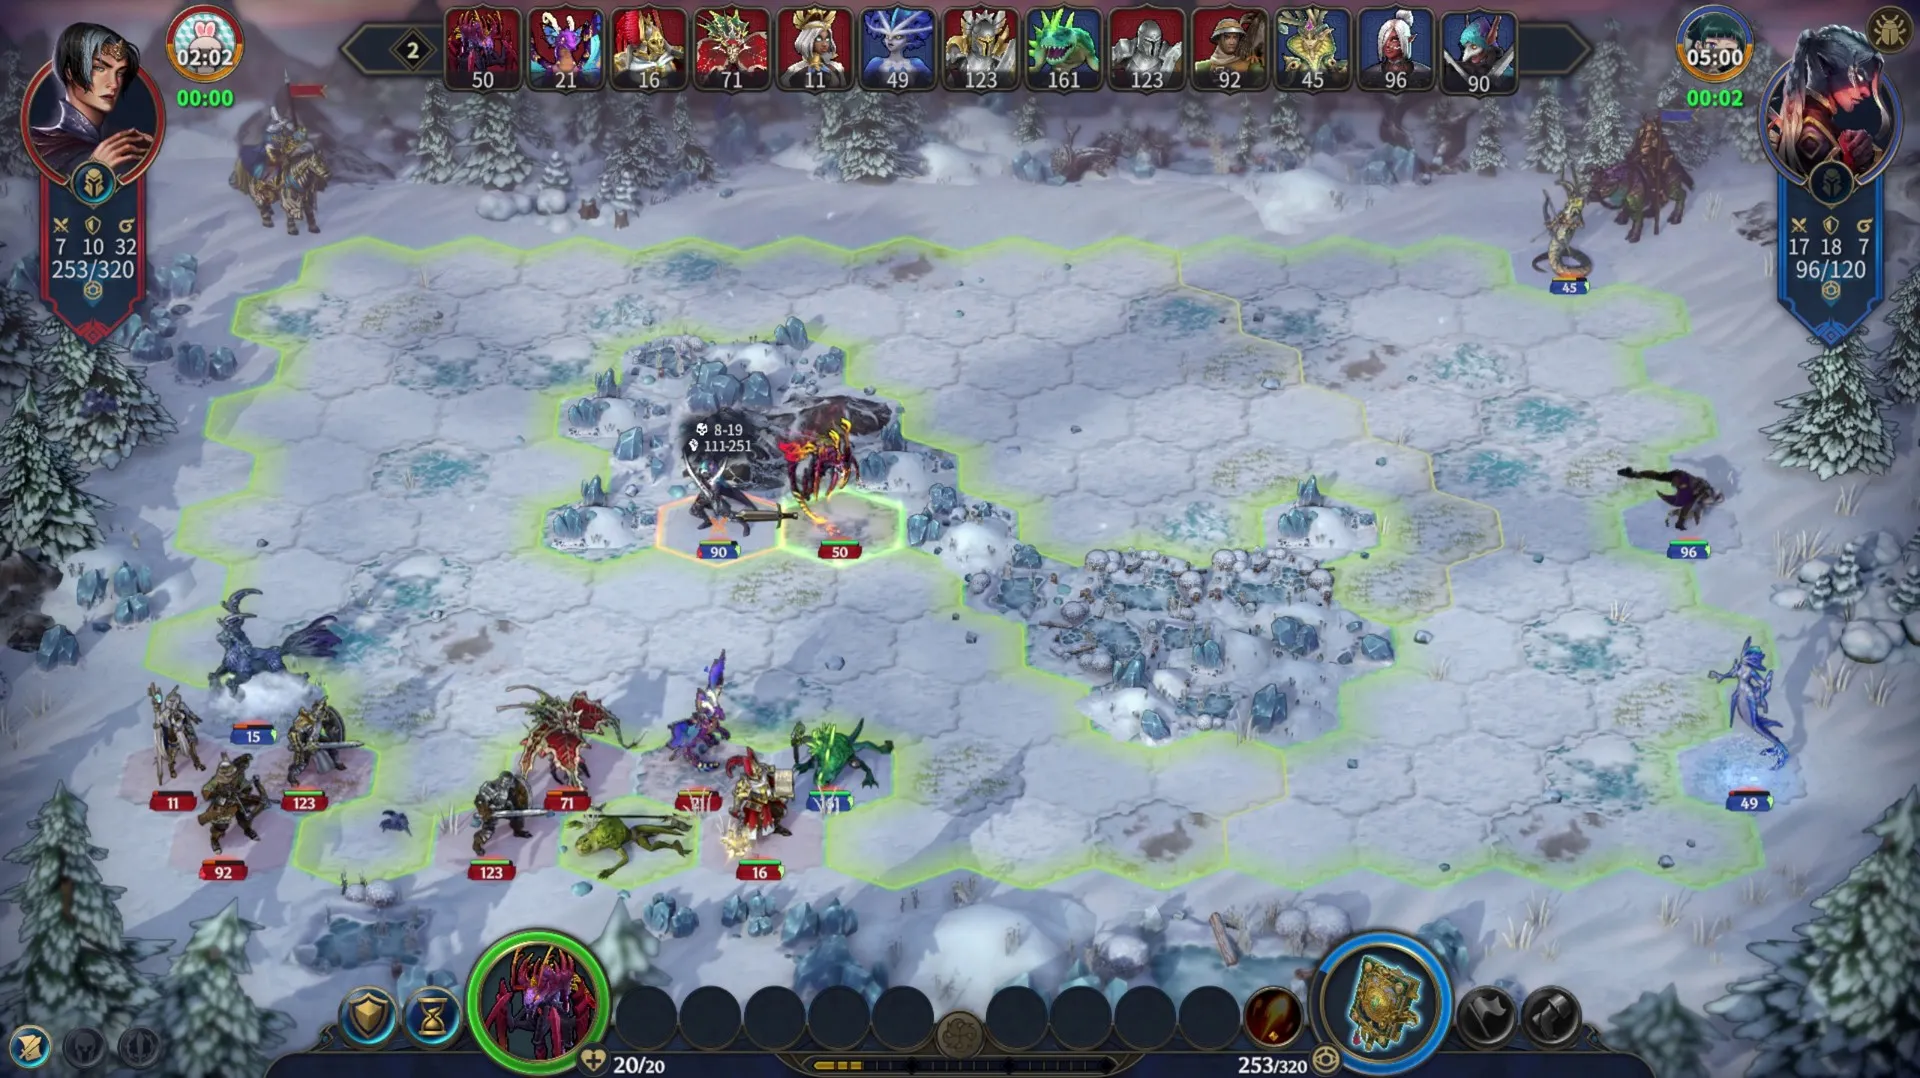
图 5。观察中央偏右的细黄色折线,以及左上外轮廓。人眼还能看到线,程序为何没有把黄色内部恢复出来?
重叠不一定变得更亮,也不一定有更大的 H
HSV 的 H 是颜色在色环上的位置,不是高亮强度。半透明颜色与地面混合,会同时改变 H、S 和 V;较淡的像素还容易受地面颜色影响。下面直接穿过三处轮廓取样,横轴表示距离取样中心多远。图中数值来自实际输入截图,没有重新着色。
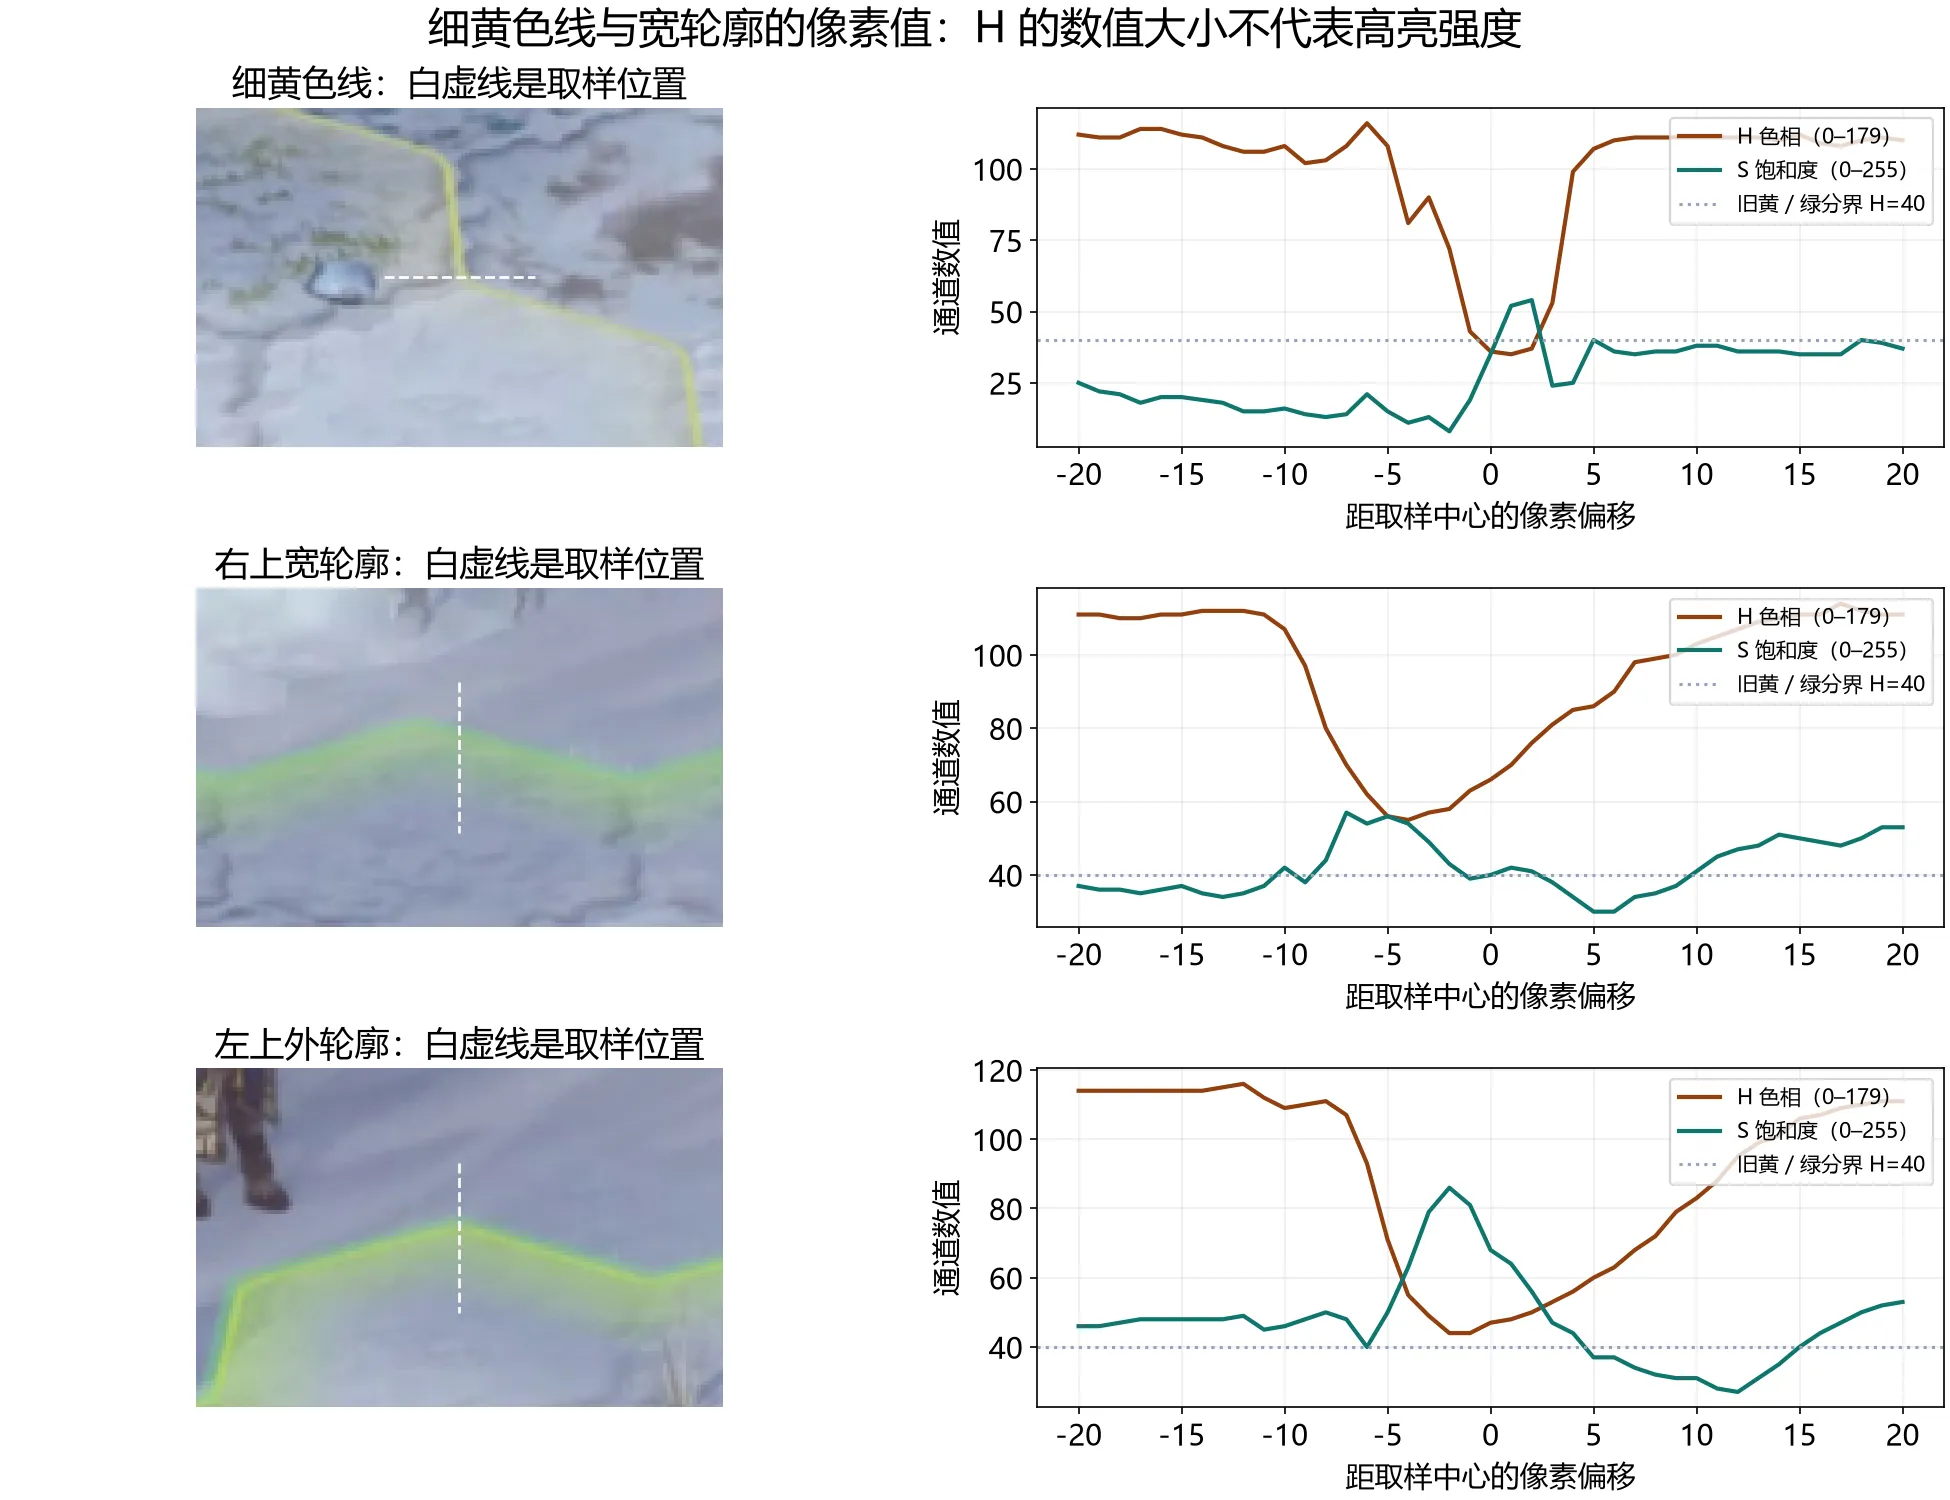
图 6。OpenCV 的 H 范围为 0–179。细黄色线的一小部分落在旧黄色门限内,但左上外轮廓的取样没有降到 H=40 以下。灰蓝雪地的 H 反而更高,所以“取 H 最大的像素”不是找高亮的方法。这些局部剖面不能证明渲染器具体叠了几层。
原代码把黄色限制在 19≤H≤40,绿色则从 H>40 开始。即使某段轮廓在几何上需要用于恢复黄色区域,只要它的颜色落到 40 以上,黄色通道就拿不到它。我们不改变网格、采样位置、线条支持比例或投票,只改一个条件,得到:
| 对同一雪地图只改哪一步 | 黄色检出 / 64 | 误报 / 29 |
|---|---|---|
| 原方法 | 0 | 0 |
| 降低颜色对比强度门限 | 0 | 0 |
| 降低整条边的支持比例 | 0 | 0 |
| 保留原先删除的短片段 | 1 | 0 |
| 降低内部投票门限 | 1 | 0 |
| 黄色色相上限从 40 改成 57 | 64 | 1 |
| 完全取消黄色色相门限,保留其余颜色条件 | 63 | 0 |
原设置最初接纳 15 条黄色候选格边,过滤短片段后只剩 4 条。放宽色相上限后,同样的过滤规则留下 107 条边,区域恢复随之成功。这个对照证明,原硬颜色门限是这张图失败的一个可修正原因。 它没有证明每条新增边都是真实的黄色,也没有证明 H=57 在所有场景中都正确。
把这个简单改动跑到全部 24 张图,黄色检出从 448 增加到 509,误报也从 184 增加到 213。再看更早 40 张图的范围并集,召回率反而从 84.7% 降到 83.2%。因为我们数的是边界穿越次数,增加一条错误的线可能把“奇数次”变成“偶数次”,让原先正确的内部判断翻转。增加候选像素,未必单调增加最终检出格子。
于是问题变得更具体:怎样保留淡色和混合色的真实轮廓,同时拒绝纯绿色范围、草地与物体造成的假黄色证据?
5. 从颜色、线宽、轮廓到小分类器,分别试什么
下面按它们解决的问题分组。除特别说明的补轮廓版本,所有方法都输出格边上的证据,再使用第 3 节的同一套多方向投票。它们不是一个必然越来越好的升级链;失败的方法也保留结果。
先试最便宜的改动:重新选阈值、软颜色与 Lab
分颜色重新选阈值保留原来的硬 HSV 特征,分别让黄色、绿色的精确率和召回率尽量平衡。它回答:重新选择参数,能否让现有特征工作得更好?结果是黄色 F1 从固定对照的 75.2% 变成 74.9%,绿色也下降。这次还改变了候选阈值和分组选择方式,因此不能把差异全部归因于优化目标。它至少说明,当前这次重新选参没有补上缺失的颜色特征。
软颜色与局部线对比把非此即彼的门限换成渐变得分。例如黄绿色可以同时为黄色和绿色提供部分证据,而不是越过一个 H 值就从某通道消失。饱和度和亮度也逐渐衰减,不立即归零。采样改为双线性插值,减少细线刚好落在两个像素之间时的跳变,再比较线条与两侧地面。黄色得到 83.2% 精确率、81.1% 召回率;在雪地失败图上找回 30/64 格。它说明保留弱颜色证据有帮助,但这不是只改变色相一个因素的消融。
Lab 颜色与局部线对比保留上述软色相权重与采样方式,换一种表示颜色差异的方式:L 表示明暗,a 大致描述绿—红方向,b 描述蓝—黄方向。程序寻找局部更偏黄或偏绿的线。它不保证不同地面上的颜色完全相同,但值得与 RGB 通道差作对照。雪地黄色找回 57/64 格、零误报;全部图片的黄色 F1 却只有 74.8%。换颜色空间解决了一部分局部问题,并没有成为普遍最优。OpenCV 颜色转换说明
再利用线的形状:多尺度、Top-hat 与 Canny
细黄色轮廓可能只有几像素宽,绿色光晕却宽得多。多尺度线对比用几种距离检查“中间是否比两侧更突出”,只要在其中一种宽度上像线,就保留得分。它是在已知格边附近进行的方向模板匹配;无需重新搜索整张图中的所有直线。雪地黄色找回 32/64 格,但全部图片的黄色 F1 为 80.6%,略低于软颜色的 82.1%。在这版实现中,增加线宽选择也增加了吸收杂乱纹理的机会。
形态学 Top-hat先用较大的局部结构估计背景,再从原来的颜色响应中减去背景,让细亮结构留下来。本次用了两种大小,输出仍沿网格采样。它是常见的细线增强办法,却不认识“游戏高亮”:草叶、岩石边缘和发光装饰也可能被增强。结果黄色 F1 为 77.0%;在没有大范围高亮的草地对照里,89 个反例中的 79 个被误报为范围内。OpenCV Top-hat 说明
Canny 边缘筛选从颜色响应中找变化明显的边缘,保留其附近的颜色,再交给网格检查。它可以减少平坦区域,但弱线可能过不了边缘门限;宽光晕还会产生两侧边缘。本次黄色 F1 为 73.7%,那张雪地图仍漏掉全部黄色。这个结果针对当前 Canny 配置,不能推断所有边缘检测方法都无效。我们没有再叠加 Hough 搜线,因为网格已提供预期的方向与位置。OpenCV Canny 说明
一条轮廓缺了一段,能否借另一种颜色连接
多尺度加共享边补缺口先得到黄色、绿色各自的格边。如果某条轮廓留下两个未连接的端点,就沿另一颜色已经检测到的格边寻找短路径,最多补 24 条边,再重新计算内部。它不会凭空跨过完全没有颜色支持的地面,也没有使用标签或“选面积更大的一侧”来决定答案。
在雪地图上,黄色从多尺度方法的 32/64 提高到 59/64,没有增加该图的误报;但全部图片中,黄色误报从 105 增加到 142,绿色误报也增加。因此,共享轮廓确实提供了一条恢复路径,却可能连接错区域。图库把这些推断出来的边画成紫色虚线,与直接接纳的颜色格边分开。它们是待验证的假设,不应被当作屏幕直接显示的黄色线。
让小模型学习哪种格边更可信
前面的规则都需要人工决定哪些颜色和线条组合更可靠。最后再试两种小型分类器:逻辑回归学习各项特征的加权组合;ExtraTrees用多棵随机化决策树学习条件组合,例如“黄色响应较强,而且沿边较连续”。这次训练的是格边分类器,原障碍物模型没有重训,也没有训练新的图像分割网络。
每条格边输入 72 个统计量:前面六种特征中,黄、绿两通道沿边的均值、波动、分位数、最大值和支持比例。模型不接收格子坐标、录像 ID 或兵种属性。然后输出黄色、绿色各自的格边分数,仍由同一套投票恢复内部。
训练标签来自已有格子标注:一条边两侧都明确可见,一侧在某颜色范围内、另一侧在外,就作为该颜色的边界训练例;两侧状态相同作为非边界例。这是从区域标签推导的弱边界标签,不是人工逐像素描出的可见轮廓。 遮挡和未知邻格不参加训练,战场外侧的边也不据此自动标正例。每次仅用其他五段录像训练,模型分数门限和内部投票门限固定为 0.5。
逻辑回归的绿色表现最好:精确率 98.1%、召回率 94.6%、F1 96.3%。ExtraTrees 的黄色 F1 是本次最高的 84.4%,精确率 91.5%,召回率 78.4%。但两者都没有恢复那张雪地图的黄色区域。小模型学会拒绝了一些误报,也保留了训练数据中难以学到的盲点;“使用机器学习”不是替代颜色与几何诊断的捷径。
6. 让线条证据和整片网格一起决定范围
此前的结果提示了两个问题:找到某种颜色,不等于找到了轮廓;找到几段轮廓,也不等于能稳定恢复内部。因此,新实验分别改进“如何给格边提供证据”和“如何从证据决定格子”。黄色和绿色仍分别检测,没有把另一层的答案直接复制过来。
黄色:先估计地面,再问它是否被黄光覆盖
假设一条线两侧的地面相近,就可以把两侧 RGB 的平均值当作线下背景 B,把线上像素记为 I。先计算变化 D = I − B。直接取 RGB 的变化比固定色相更能适应背景,但草纹和物体也会产生变化。
因此再检验一个更具体的解释:I 是否大致位于背景 B 和黄色 H 之间? 程序寻找 0 到 1 之间的比例 a,让 I ≈ B + a(H − B);解释不了的颜色差越大,分数越低。左右地面差别很大时,也降低分数,因为平均背景不再可信。这是常见透明叠加思路的经验近似,直接作用于 sRGB;我们没有证明游戏渲染器遵循这个精确公式。
在雪地上,背景已经很亮,黄色的绝对色值可能很淡;这个办法关心的是它相对于附近雪地如何改变。新图库默认打开的 confirm-006,40 个可判断黄色内部格子全部找回,没有误报。它不是靠把所有浅色格子填满:范围右侧的雪地仍被排除。
绿色:一条边必须沿着同一个位置持续出现
绿色直接看 RGB 背景差,第一次在新草地图上失败了。草地本身偏绿,微弱轮廓的 RGB 增量未必达到固定门槛;把门槛降低,又会把很多草纹接纳为边。
最后保留的是软颜色约束与整条线的一致性。先用连续的色相权重和“绿比红蓝强多少”构成绿色响应,再比较中间与两侧。程序允许线条在理论格边附近偏移,但一条格边的 32 个采样位置共用同一个偏移量,用去掉最高、最低各 4 个值的平均响应来选择它。不能在每个位置各挑一根不同的草叶,拼成一条假边。
这里的“软”指颜色权重连续变化,最终仍统计 32 个位置中有多少超过线条阈值。改成完全连续的支持比例也试过,结果见后面的失败对照。黄色的背景拟合同样使用整条边共享偏移。
整片网格:边界两侧的格子,状态应当不同
旧方法从每个格子分别向外数轮廓。新方法同时决定全部格子:每格只有“范围内”或“范围外”两种状态;相邻两格状态不同,它们之间才是一条区域边界。外部固定为范围外。
例如,四段清楚的线围着一小片格子,第五段很弱。程序可以接受第五段的少量证据冲突,让整片区域保持一致。反过来,一根孤立草纹若要求周围生成许多没有图像支持的新边,就不容易改变答案。它也允许内部空洞,没有规定必须填满最大区域,也没有使用兵种速度或游戏规则来猜答案。
具体求解使用混合整数线性规划:令格子变量 x 为 0 或 1,边变量 z 等于两侧 x 的异或,即“两侧不同”。正的线条证据鼓励 z=1,负证据鼓励 z=0;求解器寻找总冲突最小的配置。黄色、绿色各解一次,所以输出可以重叠,但这不是一个联合四色分类模型。网格外部固定为 0,隐含了范围在已标定战场边缘终止的假设。
背景拟合公式与固定参数
RGB 归一化至 0–1。黄色参考色 H=(1,1,0),v=H−B,拟合比例为 a=clip(dot(D,v)/(dot(v,v)+1e−6),0,1)。线条响应为 a·|v|·exp(−|D−a·v|/0.07)·exp(−|left−right|/0.25)。这些量衡量当前颜色解释是否合理,不是经过校准的概率。
线上取 32 个位置,覆盖格边中间的 80%;法向偏移限制为中位格边长度的 16%。背景采样距离为 3、7 和约 13 像素,比较几个尺度后选择响应。固定输入为 1920×1078;所有像素参数都相对于这一尺度。
两种颜色均以响应 0.05 为门槛,支持比例记为 c,边证据为 (c−0.25)/0.75。网格代价为每条边的 −证据×z 之和,无格子面积奖励。单色求解时间上限为 3 秒;超时可返回可行候选并标记未证最优,不能静默称为最优。本次 9 张首测的 18 次求解全部达到最优;最优只针对这个目标函数,不代表视觉判断正确。
第一次冻结为什么还不够
最初在旧 24 张图上,背景拟合与网格优化的黄色精确率 / 召回率为 99.8% / 91.8%,绿色采用 RGB 背景残差时为 99.3% / 99.9%。这看起来很好,但冻结后遇到另外 20 张图,绿色召回率降到 79.0%。其中 120 个绿色漏检集中在同段草地的两张图。
我们保留这次失败,再把 20 张加入开发,才改用绿色软颜色与共享偏移。以下 44 张成绩属于开发结果,不是对同一批图重新获得的独立测试:
| 44 张已见图上的候选 | 黄色精确率 / 召回率 | 绿色精确率 / 召回率 |
|---|---|---|
| 黄色背景拟合 + 绿色 RGB 残差 + 网格优化 | 99.6% / 92.9% | 99.4% / 90.4% |
| 黄色背景拟合 + 绿色连续彩色线 + 网格优化 | 99.6% / 92.9% | 99.3% / 99.2% |
在新增 20 张这个子组中,绿色从 469 个检出、2 个误报、125 个漏检,变成 583 个检出、2 个误报、11 个漏检。这才是下一次冻结候选的依据。
第二次冻结:另外 9 张的首次结果
再次固定参数后,从其他 3 个录像组取源图并标注,才进行预测。下面所有方法使用相同 925 个可判断格子:黄色 274 个正例,绿色 175 个正例。没有使用未知格子凑准确率。
| 方法与颜色 | 精确率 | 召回率 | 检出 / 误报 / 漏检 |
|---|---|---|---|
| 原 HSV 与投票 · 黄色 | 74.8% | 65.0% | 178 / 60 / 96 |
| 只放宽黄色色相 · 黄色 | 76.6% | 65.7% | 180 / 55 / 94 |
| 新版线条与网格优化 · 黄色 | 100% | 95.3% | 261 / 0 / 13 |
| 原 HSV 与投票 · 绿色 | 99.2% | 72.6% | 127 / 1 / 48 |
| 新版线条与网格优化 · 绿色 | 99.4% | 92.6% | 162 / 1 / 13 |
窄屏可左右滑动查看完整表格。
黄色少漏了 83 格,误报减少 60 格;绿色少漏了 35 格,误报仍为 1 格。这是同图、同标签的直接改善。两张没有范围的草地对照,在已知空地上均没有误报;被人工排除的选中环和兵种占位仍未接受这个检验。图片已经读入并缩放后,单张检测中位耗时约 290 毫秒,不含读盘、缩放、首次建网格或界面显示;目前没有整场实时运行成绩。
重叠图仍然暴露了什么
9 张图中,45 个重叠正例都来自 confirm-002。新版找到 27 格,误报 1 格,漏检 18 格,即精确率 96.4%、召回率 60.0%。其中 1 个重叠误报来自另一张雪地图;熔岩图本身没有重叠误报。这张图单独看,黄色召回率 88.3%,绿色 84.1%;其他图拉高了总体平均。
原图里有两层范围和一条绿色移动路径。漏检成片出现在黄色左上内部和绿色顶部。路径干扰、共边覆盖、弱边及标注歧义都需要进一步逐边核对;仅凭这个错误分布,不能断言是哪一种原因,也不能断言单图永远无法识别。
下面的图库保留全部 53 张:旧 24 张、新增开发 20 张、第二次首测 9 张。选择 confirm-002 → 黄绿重叠格子 查看这个失败;选择 check-030 → 绿色,对照第一次冻结与新版,查看草地漏检如何被修复。来源展开项保留录像名与时间;编号仍对应同一张 137 格模板。
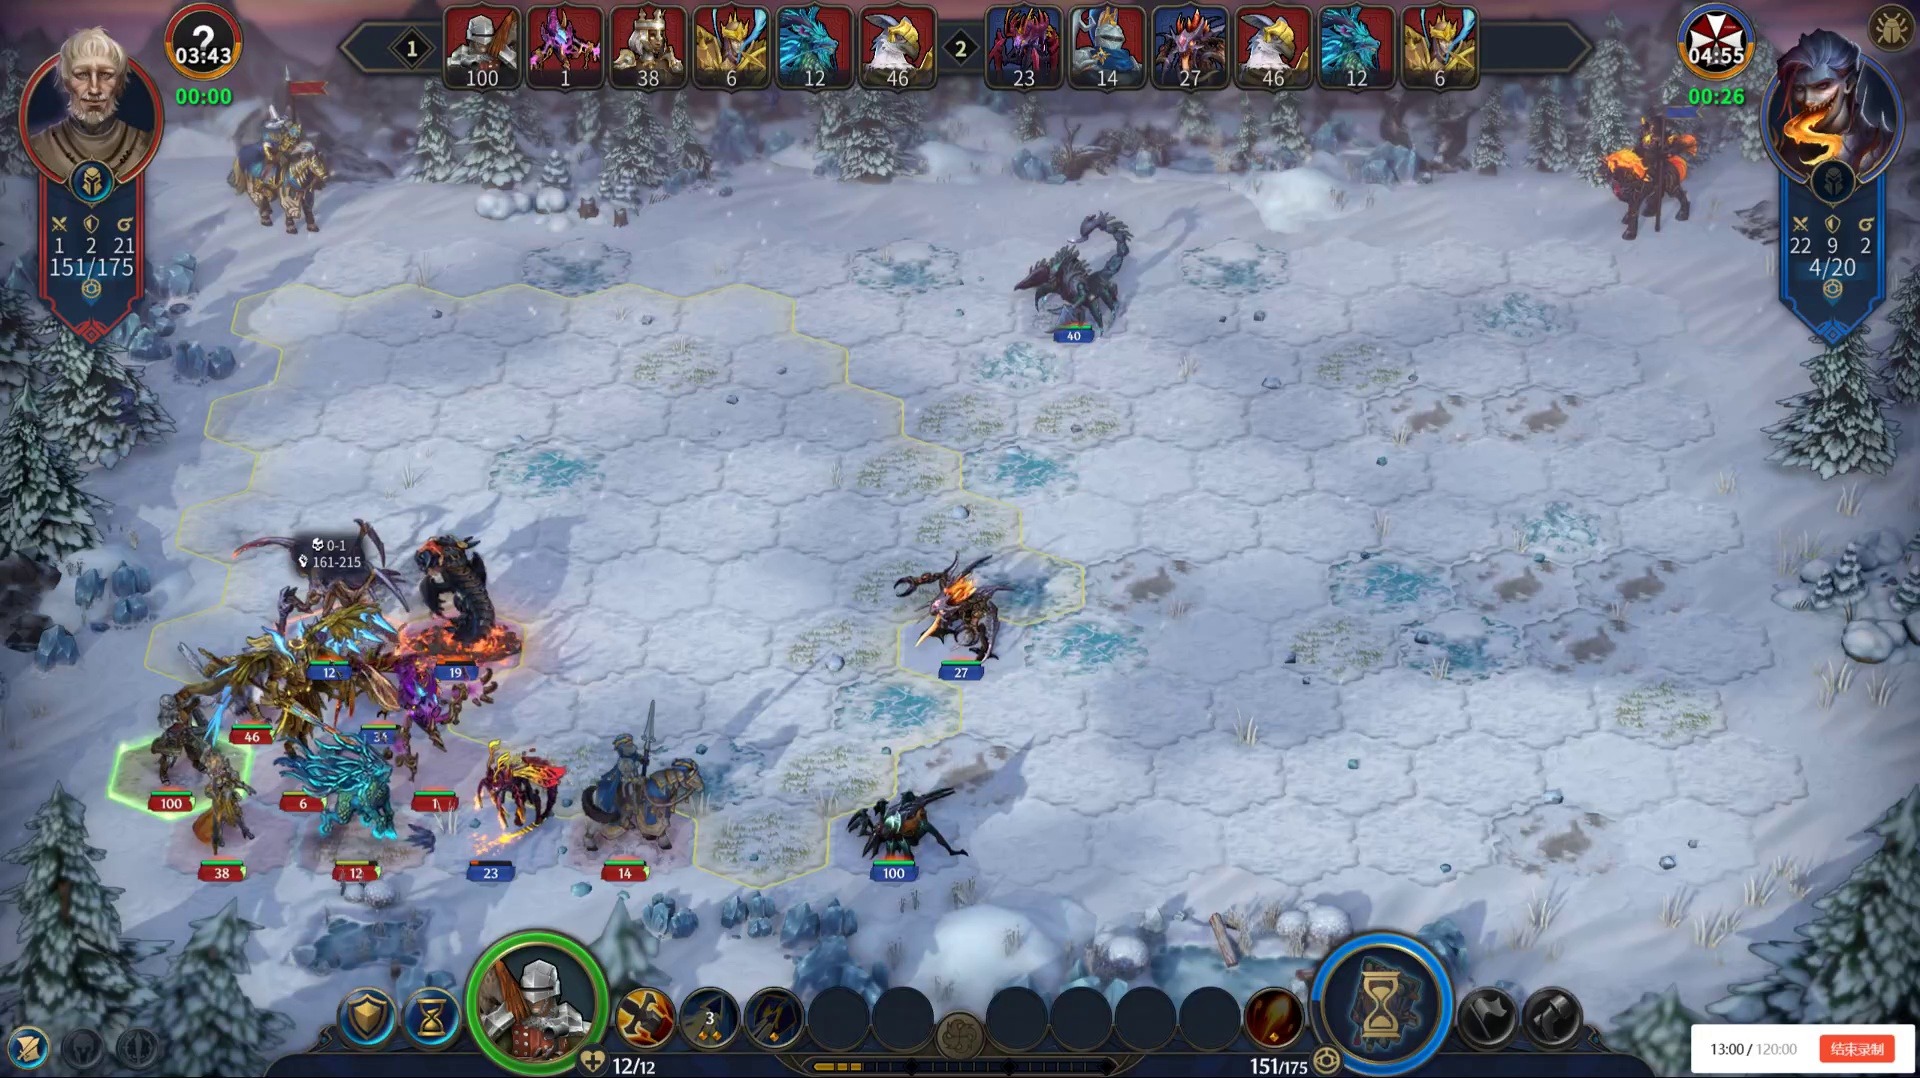
画面与来源说明
新图库默认显示完整雪地 confirm-006 的黄色预测。放大可检查原始线条,切换“原始截图”和“助手标注”可核对依据。紫色虚线是图优化补出的候选边,并不表示屏幕上已确认存在这种颜色。
哪些后续想法没有带来可靠改善
首测后,又在全部 53 张已见图上诊断。以下是开发消融,不是新的冻结测试;没有因此修改首测标签或原分数。
| 尝试 | 想解决什么 | 实际结果 |
|---|---|---|
| 弱化“没看到边”的惩罚至 1/4 | 允许遮住或被覆盖的轮廓继续围成区域 | 9 张中的重叠检出从 27 增至 35,误报却从 1 增至 81;拒绝采用 |
| 完全取消缺边惩罚 | 只相信看到的正证据 | 解出现大量歧义;重叠只找到 11/45,不能靠无限放宽恢复 |
| 整条边允许小倾斜 | 修正投影与真实线条夹角 | 重叠仍为 27/45,全部 53 张的绿色误报增加 3 格 |
连续支持值 r/(r+0.05) |
保留弱而连续的线 | 全部 53 张的黄色精确率降至 45.1%;大量背景响应累积成假边 |
| 门槛附近用窄 sigmoid 平滑 | 减少 0.049 与 0.051 的突变 | 平滑宽度 0.005 时略减普通错误,重叠仍为 27/45;更宽平滑明显增加误报 |
更早还比较过 RGB 背景残差、共享偏移残差、透明叠加拟合、软颜色共享偏移四类线条,以及旧格边分类器接网格优化的版本。它们的完整参数与结果保存在下载报告中。它们没有形成一个每步都更好的阶梯:合适的颜色证据与区域恢复必须一起匹配,单独把图优化放松并不能解决颜色归属。
补齐七段录像后:让模型综合判断边界
扩充数据首先改变了我们对旧规则的判断。新增开发组的 21 张图中,黄色召回率仍有 99.5%,绿色却降到 88.7%。59 个绿色漏检中,55 个集中在同一段红土地录像的两张图:一张是小绿色范围,一张是大范围重叠。草地和雪地上的成功,不能替这类画面作保证。
这次没有重新训练整张图的分割网络,而是保留前面的图像分析和网格,只让模型接替“哪些格边证据可信”的人工门槛。对每条格边,同时提取四组响应:软颜色与共享偏移、逐位置 RGB 背景差、共享偏移的 RGB 背景差、透明叠加拟合。每组都保留黄色和绿色,再将它们概括成 96 个数:强度、波动、分位数、超过几个门槛的比例,以及最长连续支持长度。
“最长连续长度”区分两种很不一样的情况:32 个位置里连续 16 个都有颜色,与隔一个位置才出现一次颜色,虽然支持比例同为一半,前者更像一条线。模型可以同时利用这些信号,学习哪些组合值得相信。它没有输入录像名、格子坐标或兵种信息,也没有将黄色区域直接复制给绿色。
我们比较三类小模型:逻辑回归将特征加权相加;ExtraTrees 用多棵随机化决策树学习不同特征的条件组合;直方图梯度提升树则逐轮学习前一轮未分好的例子。三者输出的仍是每条边的两种颜色分数,后面的异或网格求解保持相同。训练目标也仍由已知邻格的内外差异推导,属于弱边界标签。ExtraTrees 方法说明
旧 53 张与新开发 21 张合为 74 张 / 19 段录像,按整段录像分成五组。每次训练四组、预测另一组;每张图只贡献一次留出预测。同一张图的格子和同一录像的相邻帧不会分别落进训练与验证。每类模型比较 0.35、0.5、0.65 三个分数门槛;下面列出有代表性的设置,全部九种组合保留在下载报告中。这些分数参与了选择,属于开发比较。按组交叉验证说明
| 74 张开发图,按录像留出 | 黄色精确率 / 召回率 | 绿色精确率 / 召回率 |
|---|---|---|
| 旧颜色规则 + 网格 | 99.7% / 94.5% | 99.4% / 95.9% |
| 逻辑回归,门槛 0.5 | 96.6% / 99.4% | 99.7% / 95.9% |
| 梯度提升树,门槛 0.5 | 99.4% / 99.0% | 99.7% / 95.2% |
| ExtraTrees,门槛 0.35 | 99.7% / 99.5% | 99.7% / 98.1% |
ExtraTrees 在黄绿两层上比较均衡,因此两种颜色都采用这一种模型设置。只看新增 21 张子组,黄色 367 个正例全部找到,绿色找到 518/523,无误报;77 个重叠格全部找到。例子是 new-development-028:原规则只恢复 4/25 个绿色格子,按录像留出的树模型恢复 24/25,没有新增误报。这支持综合颜色线索的方向,但不是冻结测试的成绩。
树模型与训练设置
每种颜色训练 160 棵树,最大深度 16,叶节点至少 4 个训练边,特征抽样比例 0.8,类别权重平衡,固定随机种子 17。采用 96 维特征,未用图像增强或外部预训练模型。分数记为 p,边证据为 (p−0.35)/0.65;负证据仍反对生成边界,没有放松网格缺边惩罚。这是分类决策分数,不是校准过的“真实可见概率”。
逻辑回归使用标准化、C=0.3 与类别平衡;梯度提升树使用 130 轮、每树最多 15 个叶节点、学习率 0.08 与类别平衡。所有需要拟合的步骤均在训练录像内执行,未知邻格不用于构造正负训练边。
只增加训练数据,是否真的改善了结果
为了回答这个问题,固定 ExtraTrees 设置和门槛,训练两套权重:一套只用旧 53 张,另一套用 53+21 张。两套模型都先保存,再打开预留的两段录像选图与标注。这样,下面两行树模型之间的变化来自新增训练样本,而不是同时更换算法或门槛。
10 张预留图共有 927 个可判断格子,黄色正例 347 个,绿色 315 个;其余位置按颜色分别作为反例。443 个未知格子不进入分母。以下三种方法检查完全相同的图和标签:
| 方法与训练数据 | 黄色精确率 / 召回率 | 黄色检出 / 误报 / 漏检 | 绿色精确率 / 召回率 | 绿色检出 / 误报 / 漏检 |
|---|---|---|---|---|
| 旧颜色规则 + 网格 | 100% / 51.0% | 177 / 0 / 170 | 99.4% / 49.5% | 156 / 1 / 159 |
| 同一树模型,旧 53 张训练 | 100% / 89.3% | 310 / 0 / 37 | 100% / 90.8% | 286 / 0 / 29 |
| 同一树模型,74 张训练 | 100% / 97.1% | 337 / 0 / 10 | 100% / 97.5% | 307 / 0 / 8 |
窄屏可左右滑动查看完整表格。
新增 21 张训练图让黄色漏检 37 → 10,绿色漏检 29 → 8,没有增加已知格子上的误报。旧规则在这里大幅退步,也说明前一轮九张图的高分不能代表所有录像。我们没有因为这次结果而继续调参,再把它包装成同一个未见测试。
| 同一批预留图的重叠区域 | 检出 / 误报 / 漏检 | 召回率 |
|---|---|---|
| 旧颜色规则 | 1 / 0 / 159 | 0.6% |
| 树模型,旧 53 张训练 | 123 / 0 / 37 | 76.9% |
| 树模型,74 张训练 | 145 / 0 / 15 | 90.6% |
两层必须同时正确,才算找对一个重叠格,所以这里的召回率低于单颜色。剩余错误也不平均:雪地与草地那段的 51 个绿色正例全部找到;所有黄色正例都来自另一段红土地录像。这段红土地仍漏 10 个黄色、8 个绿色。其中 new-holdout-016 一张图就漏了 10 个黄色、4 个绿色。
160 个重叠正例只来自 new-holdout-012 和 016 两张相似画面。 它们相隔约两分半钟,但范围形状相近;两段录像不是大量独立战场,927 个格子也不是 927 次独立试验。预留组没有黄色雪地正例。因此这个结果足以支持保留新候选,尚不足以证明对不同地图、交互模式和遮挡都可靠。
复用检测接口与冻结实验的 20 个颜色掩码和边界完全一致。十张完整图的单张推理中位耗时约 0.41 秒,使用一个数值计算线程,不含读图、缩放、加载权重与初次建网格。这是局部推理耗时,尚未测量整场游戏中的吞吐与响应延迟。
画面与来源说明
新增 31 张完整截图,包含 21 张开发图与 10 张冻结后检查图。默认显示检查图的重叠结果;切换“旧 53 张训练”和“加入 21 张后训练”,可以直接比较新增数据减少了哪些漏检。开发图只提供按录像留出的模型预测,避免把训练集拟合结果混在这里。
知道兵种起点和移动力,能补全漏掉的范围吗?
移动范围还包含一条有用的信息:它通常围绕同一个兵种,由同一份移动力限制。若每走一格消耗相同,合理的条件是 从起点沿可通行路线,到某格的最短步数不超过移动力。例如移动力为 5,走 1、2、3、4、5 步能到的格子都可能属于范围,并不是每个内部格子都离起点 5 步。这里数的是六边形之间的步数,不是透视截图上的像素长度。六边形距离与范围
没有障碍、没有特殊移动规则时,可以从起点逐层向外扩张,得到规则范围。遇到障碍需要绕路:一个直看只隔两格的位置,绕开石头后可能要四步。地图边缘、障碍边缘也会让轮廓提前结束,因此连整条可见边界都未必等距。已有的客户端移动轨迹审阅中,地面兵会绕开存活部队和硬障碍;不能仅凭外轮廓看起来像六边形就把这些缺口全部填满。
这个条件可以帮助恢复范围,但目前还缺“哪一层属于哪一个兵种”的输入。 现有分颜色标签没有记录每层的起点、当时移动力、移动方式、完整占位和可靠障碍图。这一轮先测试一个简化版本:假设棋盘内部可通行,枚举各个起点和步数,寻找最符合已有彩色边界的形状。也加入“没有高亮”的空集合;黄、绿仍分别拟合。拟合出的中心只是候选,不能当作已经识别到的兵种位置。
程序得到 1,210 个不同的候选形状后,比较两种用法。强制距离形状直接用最佳候选替换原结果。轻量距离辅助保留原来的图像判断,只让多个得分接近的候选共同支持的格子稍微更容易入选;图像证据仍可以反对这个建议。后一种就是把距离当作软约束。
为保持可比,下面都使用同一批 74 张开发图、按录像留出的树模型边界分数,每种颜色评价同样的 7,210 个已知格子。没有重新训练模型,没有改标签,也没有拿上一节的 10 张预留图来选权重;这是开发阶段对新想法的比较。
| 距离条件的用法 | 黄色:检出 / 误报 / 漏检 | 绿色:检出 / 误报 / 漏检 | 重叠召回率 |
|---|---|---|---|
| 原树模型与网格 | 1877 / 6 / 10 | 1975 / 6 / 39 | 93.5% |
| 强制距离形状 | 1827 / 32 / 60 | 1829 / 28 / 185 | 78.3% |
| 轻量辅助,权重 0.05 | 1877 / 6 / 10 | 1982 / 6 / 32 | 95.1% |
| 辅助权重 0.2 | 1876 / 6 / 11 | 1951 / 6 / 63 | 88.8% |
| 辅助权重 0.5 | 1877 / 5 / 10 | 1934 / 5 / 80 | 86.8% |
轻量辅助补回 7 个绿色漏检,绿色召回率从 98.06% 到 98.41%,已知格子的误报没有增加。但这 7 格全在下面一张草地重叠图中;其他发生变化的格子没有可靠标签,不能算作改善。权重增大以后,形状开始压过图像证据,绿色漏检反而增加。我们因此保留这个尝试,暂不替换默认检测器。
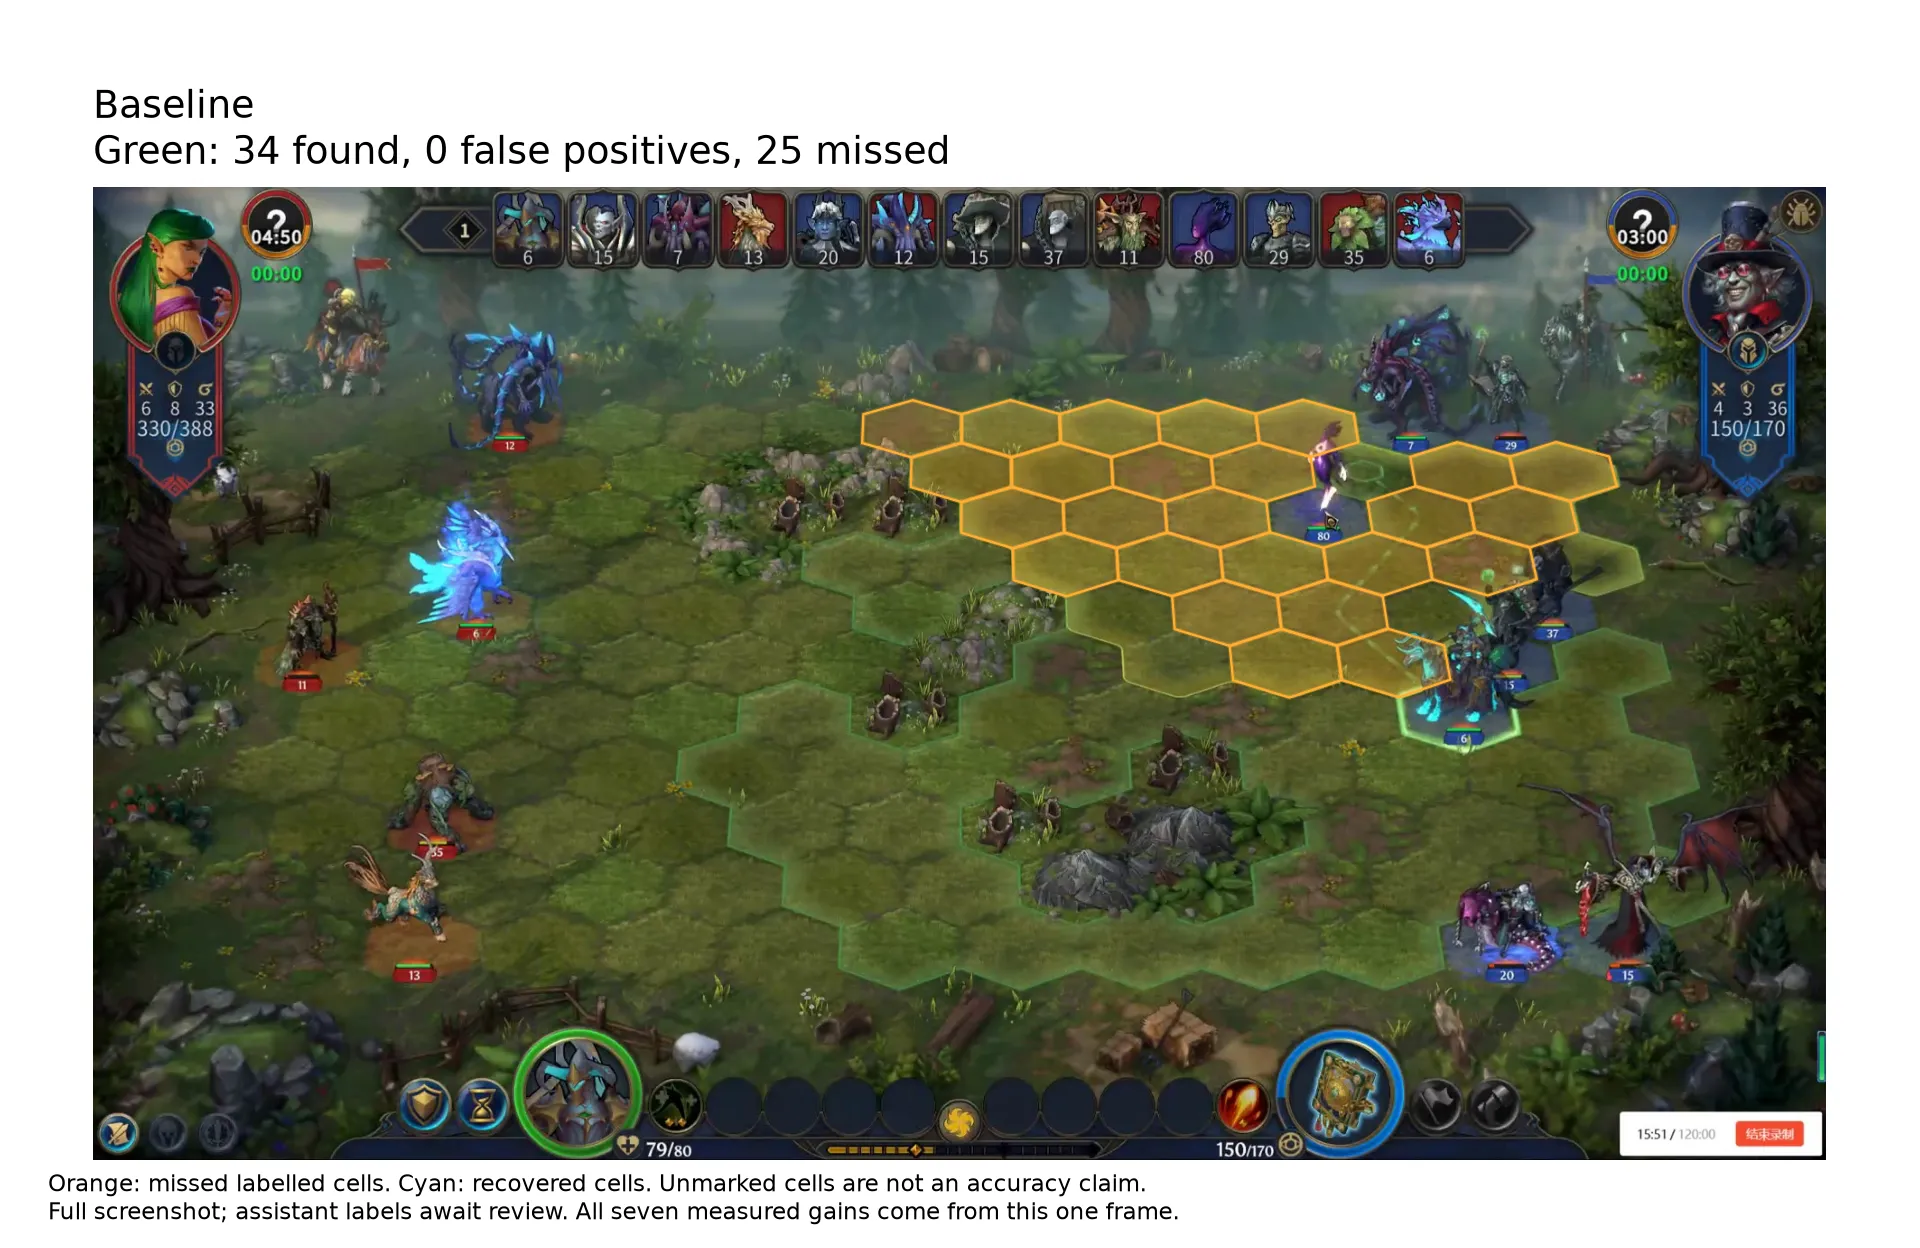
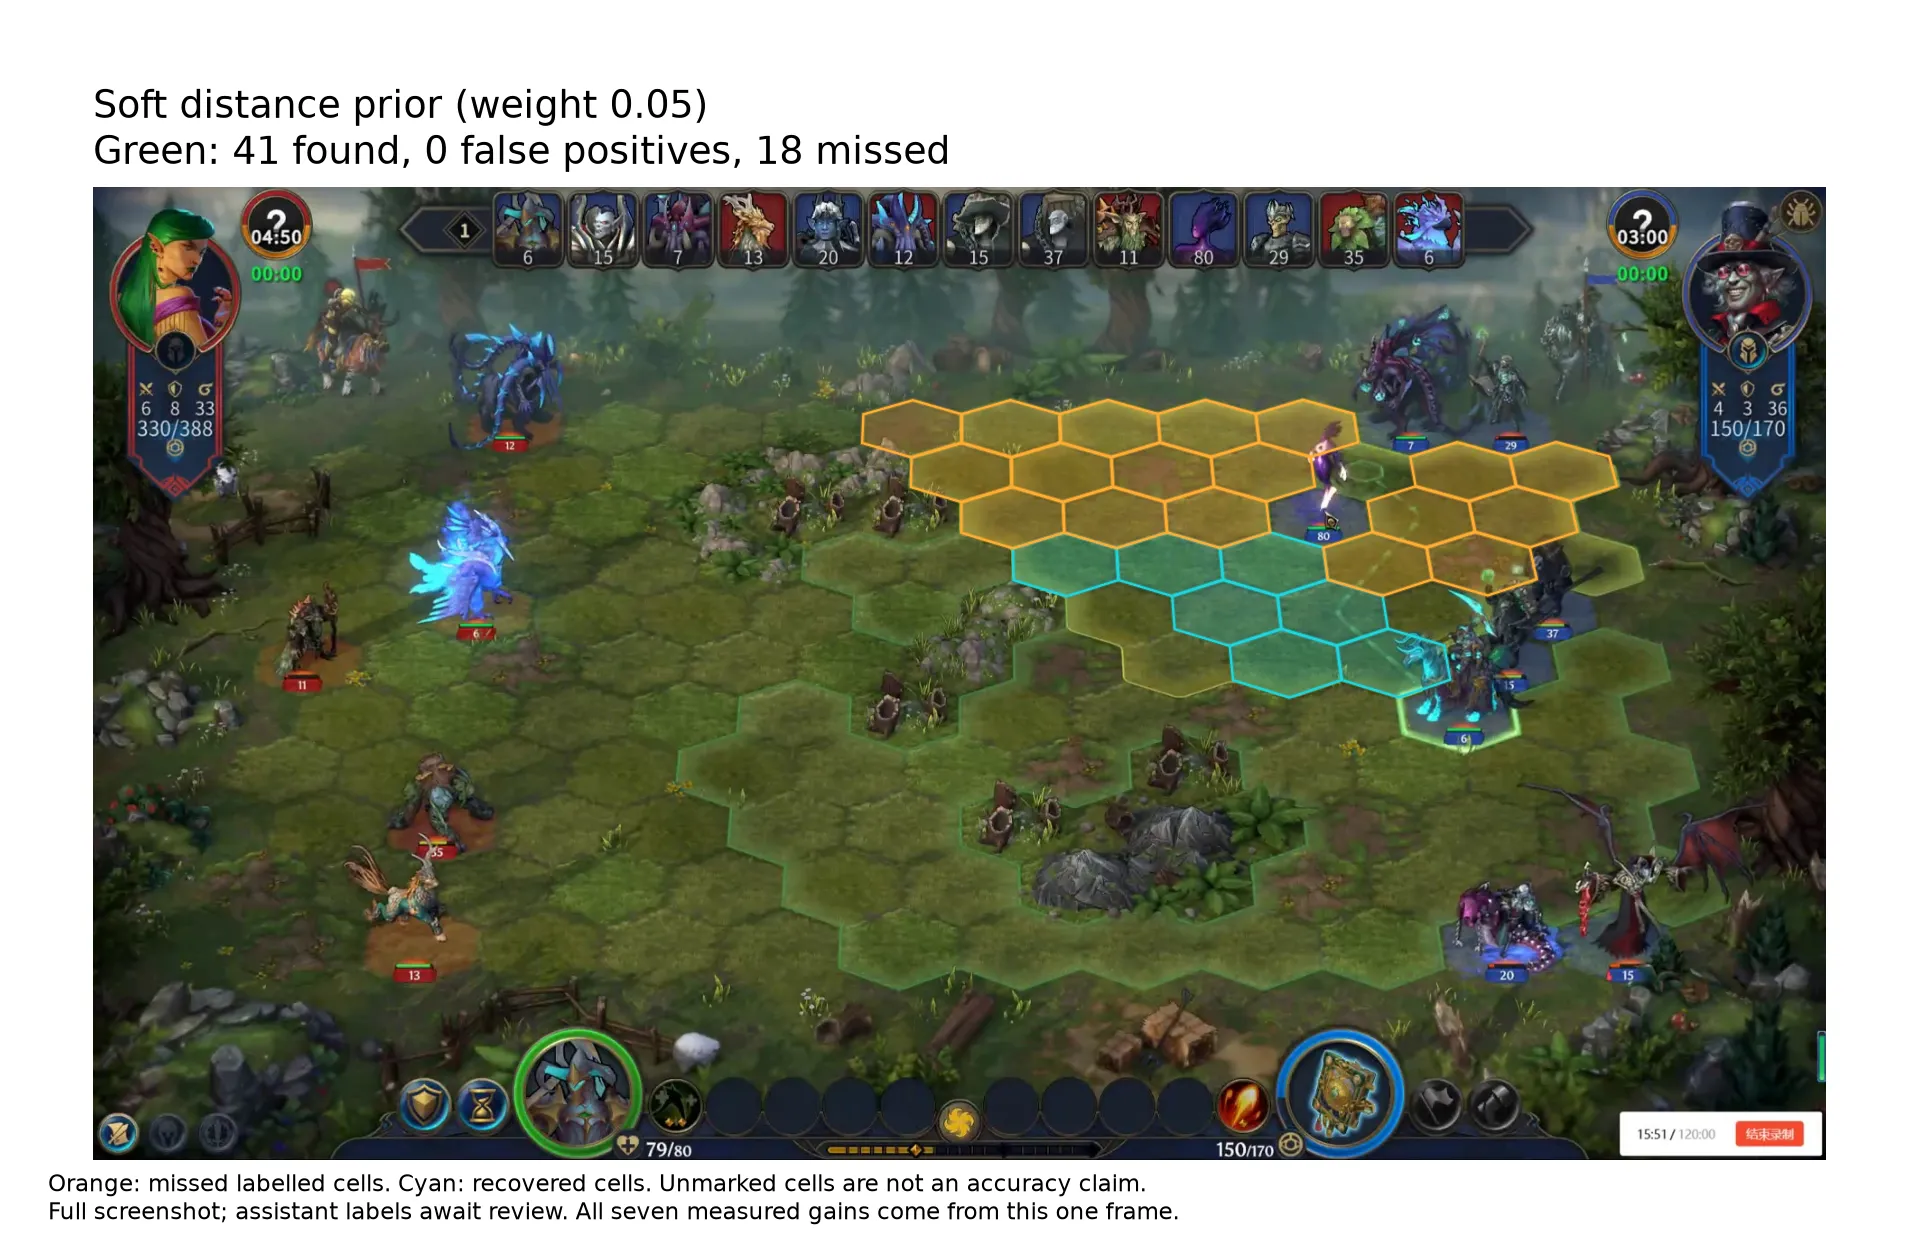
橙色表示对照标签中的漏检,青色表示这次补回的 7 格。该图绿色从检出 34/59 格变为 41/59 格,误报均为 0;两幅都保留完整截图。标签仍待人工复核,这个单例不能证明不同地图上的稳定收益。
退步来自哪里:选错了范围,还是范围形状不够用?
“强制距离形状退步”还不足以解释原因。这里实际测试的是不知道兵种起点、不知道移动力,在空棋盘上搜索所有中心和半径。它没有完整实现“已知兵种位置与移动预算”的条件,因此不能据此否定使用真实移动条件的办法。逐图复查后,至少有两种问题需要分开。
第一种是存在正确形状,评分却选错了。红土地开发图 new-development-029 原来检出全部 77 个已知绿色格,误报为 0。强制模板只检出 47 格,漏掉 30 格;它的边界得分为 16.730,而能匹配全部已知标签的形状得分为 16.391。仅仅 0.339 的得分差,就让程序替换掉了一大片原本正确的范围。这个分数奖励边界线的匹配,并不保证中心落在实际兵种上。
复查完整原图,右上方绿色兵种底座位于网格约 (11,8)。把这个人工读出的候选起点固定住,再用原来的评分搜索半径,程序选择 10 步,恢复为 77 / 0 / 0。这直接表明:至少在这个失败例子里,可靠起点是有价值的。10 是拟合的步数,并没有从单位属性中读出真实移动力;人工补输入后的单例也不算新的独立测试。
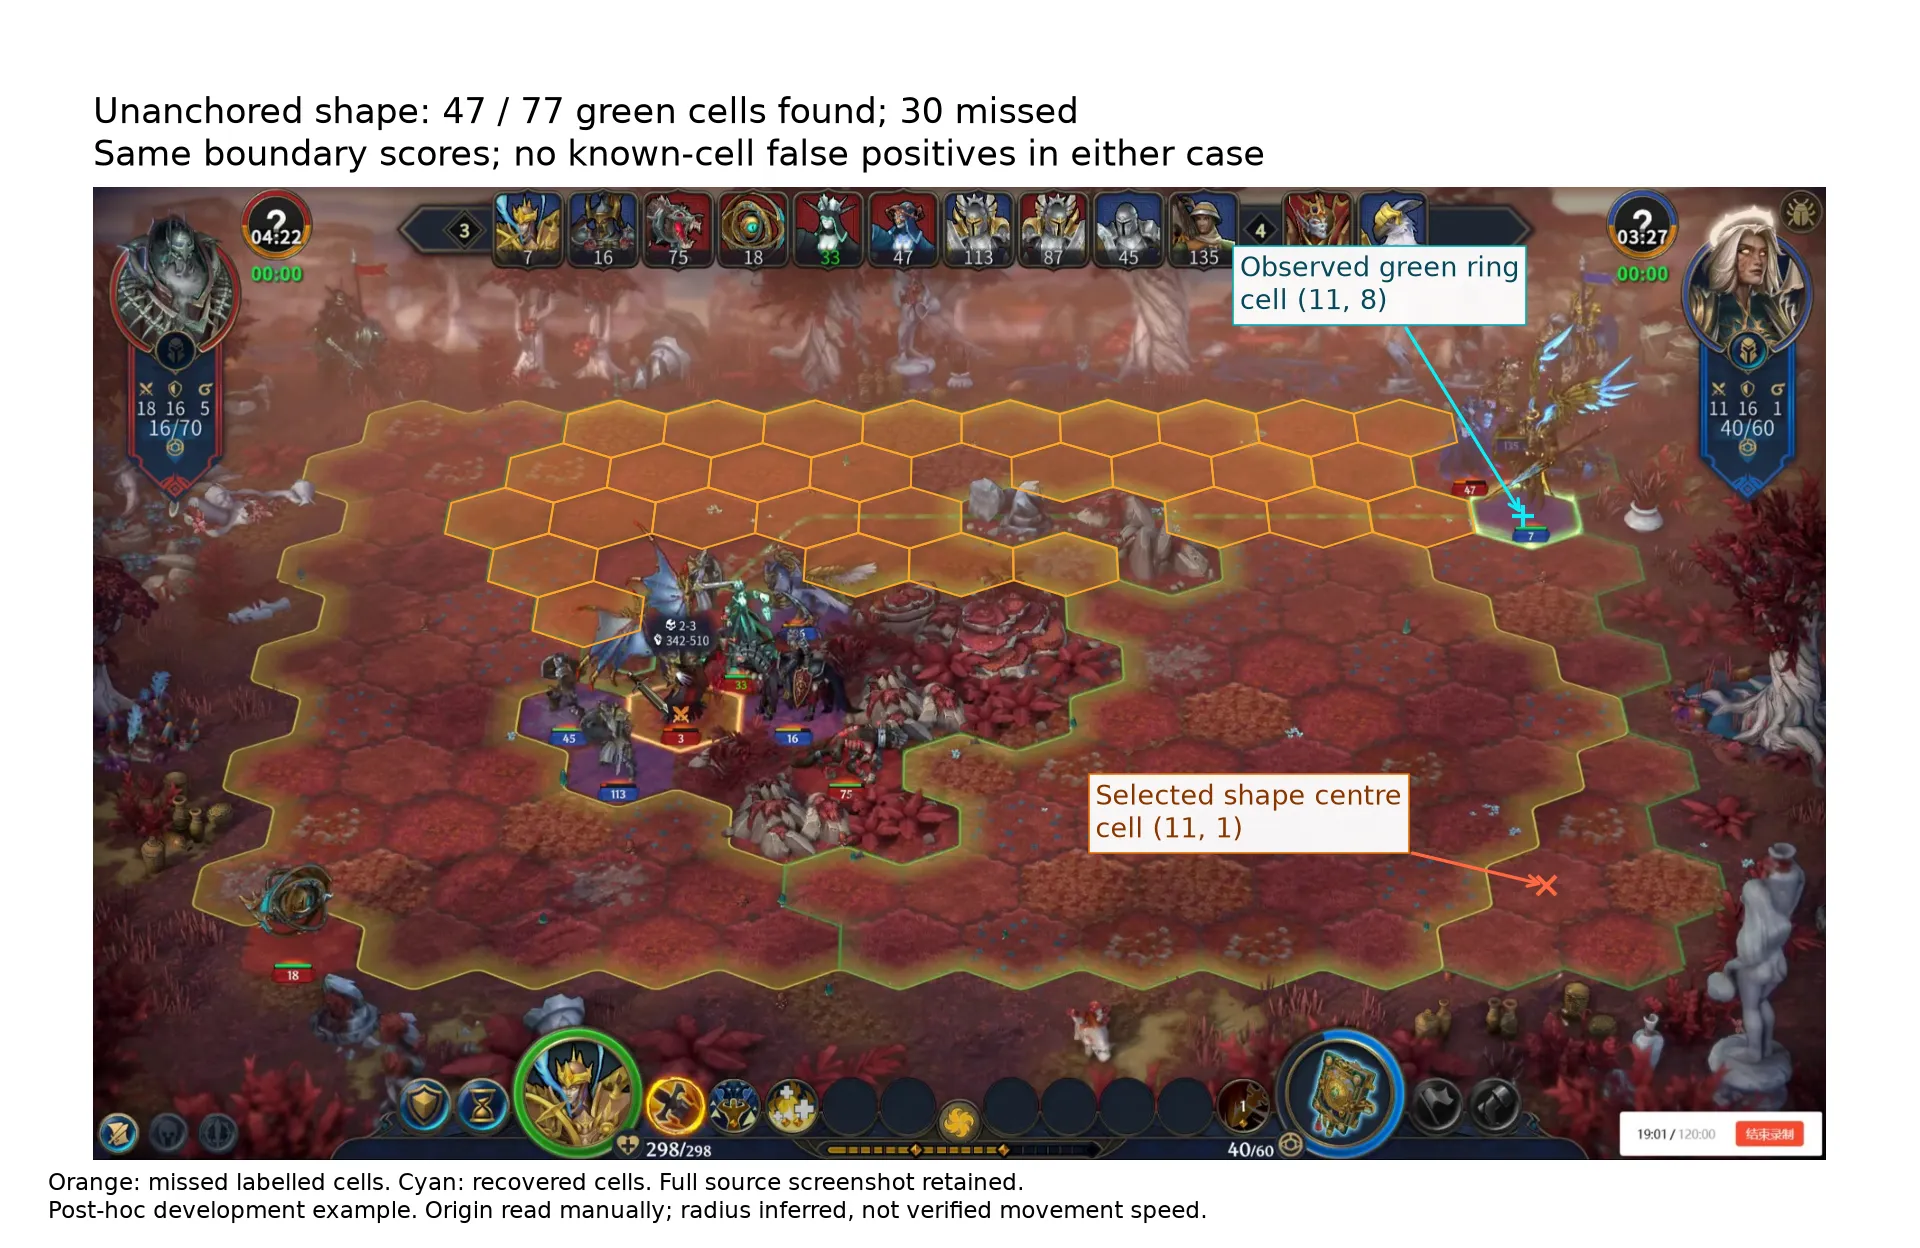
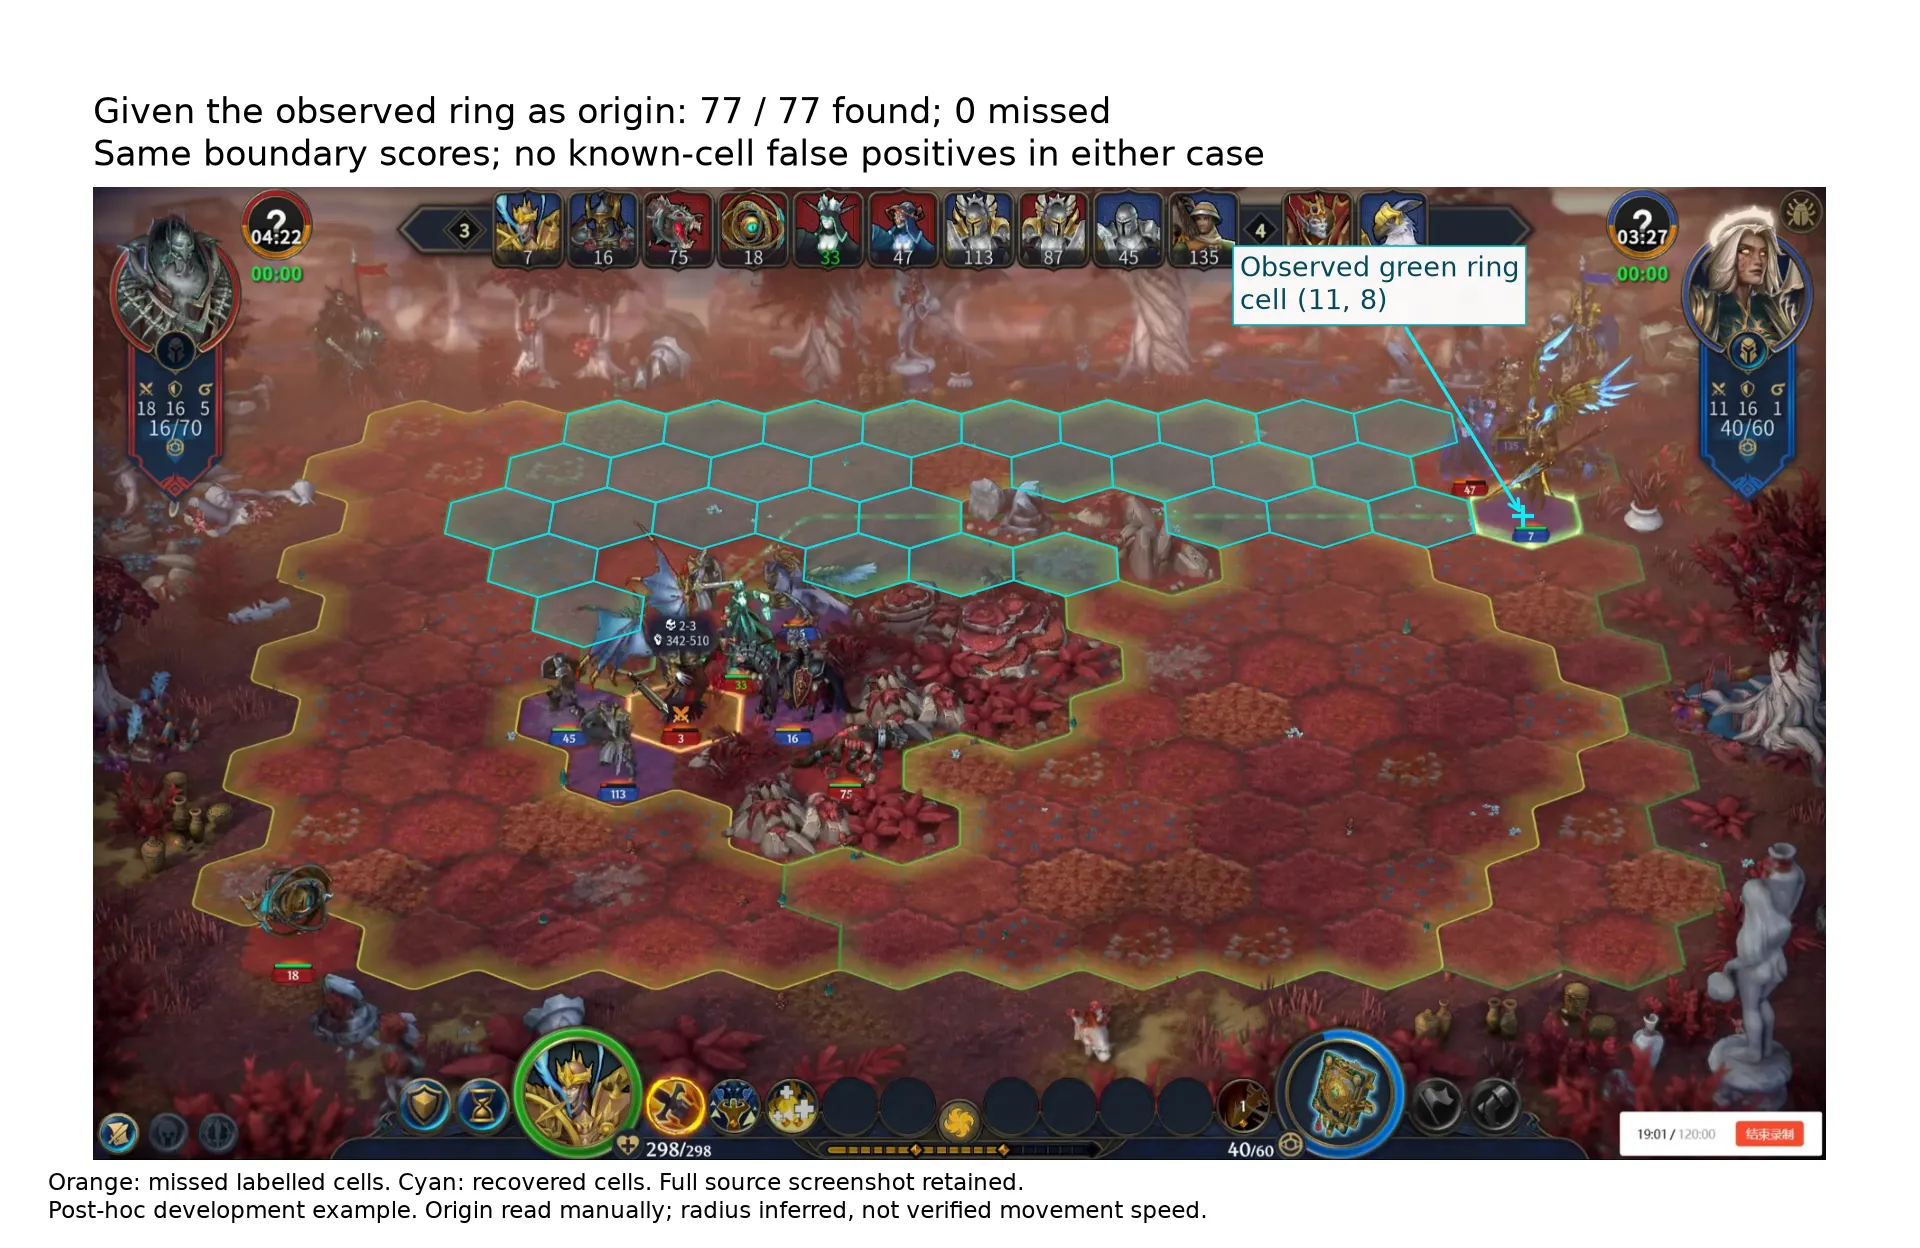
上下图使用相同边界分数;下图额外提供人工读取的起点。它展示缺少起点如何让模板选错,并非自动兵种定位的准确率。有限棋盘上,不同中心与半径还可能生成同一个格子集合,所以模板中心本身不能直接当作识别到的兵种。
第二种是把选中圈当成了移动范围。熔岩图 check-028 的原方法能找到 17 个绿色格;强制模板却只保留右下角兵种脚下的一格,半径为 0。那六条边确实很亮,模型证据全部为正,总得分 5.162,于是单格圈获胜。它们都接触被占用、未参与区域评分的格子。即使固定这个起点,程序仍选半径 0:它尚未识别线条的用途,也没有读取当前移动力。不能靠“看到一个闭合绿圈”就认定找到了整片移动范围。
形状本身也有限制。另一个诊断允许读取标签,为每张图挑误差最小的规则范围,用来检查候选集合是否足够丰富。全部硬模板结果有 305 次颜色判断错误,可以精确拆为:
| 错误来源 | 黄色 | 绿色 | 合计 |
|---|---|---|---|
| 最佳形状仍错 | 58 | 74 | 132 |
| 选错形状多错 | 34 | 139 | 173 |
| 总错误 | 92 | 213 | 305 |
原树模型与网格共错 61 次,因此总退步是 244 次;上表拆解的是 305 次总错误,不要把两个数字混用。标签参与选择的那一行是理想化诊断,不能当成可部署算法成绩。它也不能证明 132 次不匹配全是障碍造成的:绕路、完整占位、其他移动规则和草稿标注错误仍需独立核对。
一个辅助尝试让模板尽量少改变原来预测的格子,而非单纯追求边界得分。它不读取标签,把总错误从 305 降到 230,却仍远差于原来的 61 次。这说明调整选择方式有帮助,但继续强制替换成一种完整规则形状,还不能保留原方法的细节。
实现检查没有发现这几类数值问题:137 格的 18,769 对最短距离与独立六边形坐标公式完全一致;148 层硬模板都能重现,边界异或关系和优化目标符号也一致。目前证据更支持修正输入与任务定义:把兵种选中圈、移动路径和范围边界分开;将距离用于约束候选外范围,同时保留可靠的内部障碍与占位信息。被遮住的边界应保留不确定性,不能因为没看清线,就直接认定远处格子不可达。
距离辅助如何加入原来的优化
每个候选形状用与原网格相同的边界目标打分。保留距离最高分不超过 1.0 的不同形状;某格在这些形状中出现的比例记为 p。在原优化中,给该格判为内部增加代价 w × (1 − 2p):多数候选支持时降低代价,多数反对时提高代价。p 是形状投票比例,不是校准后的概率。一次比较预先列出 w=0.05、0.2、0.5,上表全部保留。最优权重是在这些开发图上选择的,需要新的独立数据检验。
接入实际战斗时,更有价值的输入是:颜色对应的兵种 → 起始格与完整占位 → 当前移动力和移动方式 → 通行图。这些输入可靠后,等代价移动可用广度优先搜索逐层扩张;代价不同时可用 Dijkstra 最短路,保留累计代价不超过移动力的落点。我们已实现接收外部起点、预算和阻挡图的条件范围计算,并测试绕路与不可达情况,但还没有测量真实战斗中这些输入的识别准确率。最短路算法接口
可靠的距离约束可以排除不可能到达的格子,也可以辅助解释被遮挡的范围;信息不全时应保留多个候选。尤其不能把“未高亮”直接变成“障碍物”:它还可能在移动力之外,或当前显示的是另一只兵的范围。
保留之前 11 个方法在 24 张图上的完整对比
以下是新网格优化之前的历史结果,不是本次 53 张数据的分数。
以下主表都使用同样的 24 张图、6 段录像、2,251 个已知格子。其中黄色正例 560 格、绿色正例 722 格,两者重叠 182 格,并集正例为 1,100 格。剩余格子按每种颜色分别计为反例;没有标注的 1,037 格不计分。
精确率表示“报出来的有多少正确”,召回率表示“真实存在的找回多少”,F1 综合两者。原固定设置和放宽色相是固定对照;需要拟合或选参数的方法使用第 2 节说明的六次整段录像留出预测。这些都是已看过数据上的回顾性成绩,不能与上一轮 8 张独立留出图的百分比直接相减。
黄色:提高召回与压低误报,尚未兼得
| 方法 | 精确率 | 召回率 | F1 |
|---|---|---|---|
| 原 HSV 固定参数 | 70.9% | 80.0% | 75.2% |
| 只放宽黄色色相 | 70.5% | 90.9% | 79.4% |
| 硬 HSV 分颜色选参 | 70.0% | 80.5% | 74.9% |
| 软颜色与局部线对比 | 83.2% | 81.1% | 82.1% |
| Lab 颜色与局部线对比 | 73.3% | 76.4% | 74.8% |
| 多尺度线对比 | 81.0% | 80.2% | 80.6% |
| 形态学 Top-hat | 75.6% | 78.4% | 77.0% |
| Canny 边缘筛选 | 69.7% | 78.2% | 73.7% |
| 多尺度加共享边补缺口 | 77.1% | 85.4% | 81.0% |
| 逻辑回归识别格边 | 67.1% | 74.5% | 70.6% |
| ExtraTrees 识别格边 | 91.5% | 78.4% | 84.4% |
ExtraTrees 找到 439/560 个黄色正例,误报 41 格;放宽色相找到 509/560,误报 213 格。如果只看召回率,会偏向后者;如果只看精确率,会偏向前者。自动理解战场同时需要两者,所以目前还不能选一个版本就宣称完成。
绿色:几种方法达到目标,小分类器减少了误报
| 方法 | 精确率 | 召回率 | F1 |
|---|---|---|---|
| 原 HSV 固定参数 | 91.8% | 91.3% | 91.5% |
| 只放宽黄色色相 | 91.8% | 91.3% | 91.5% |
| 硬 HSV 分颜色选参 | 78.6% | 85.9% | 82.1% |
| 软颜色与局部线对比 | 80.9% | 95.4% | 87.5% |
| Lab 颜色与局部线对比 | 91.7% | 94.7% | 93.2% |
| 多尺度线对比 | 78.8% | 95.6% | 86.4% |
| 形态学 Top-hat | 75.7% | 95.3% | 84.4% |
| Canny 边缘筛选 | 76.8% | 93.6% | 84.4% |
| 多尺度加共享边补缺口 | 76.9% | 97.5% | 86.0% |
| 逻辑回归识别格边 | 98.1% | 94.6% | 96.3% |
| ExtraTrees 识别格边 | 98.8% | 92.4% | 95.5% |
逻辑回归找到 683/722 个绿色正例,误报 13 格;ExtraTrees 找到 667/722,误报 8 格。两者在这组回顾比较中都达到了 90% 双指标。原固定方法为 659 个检出、59 个误报。这是有价值的改善,但每组只有四张图片,录像内的格子又高度相关,不能把上千格当成上千次独立试验。
同时看成功图与失败图
下面可以切换全部 11 个版本,查看每张图的误报、漏检,或者直接显示提取出的格边。重叠模式要求黄色和绿色同时判对,而不是只要任意一层正确。
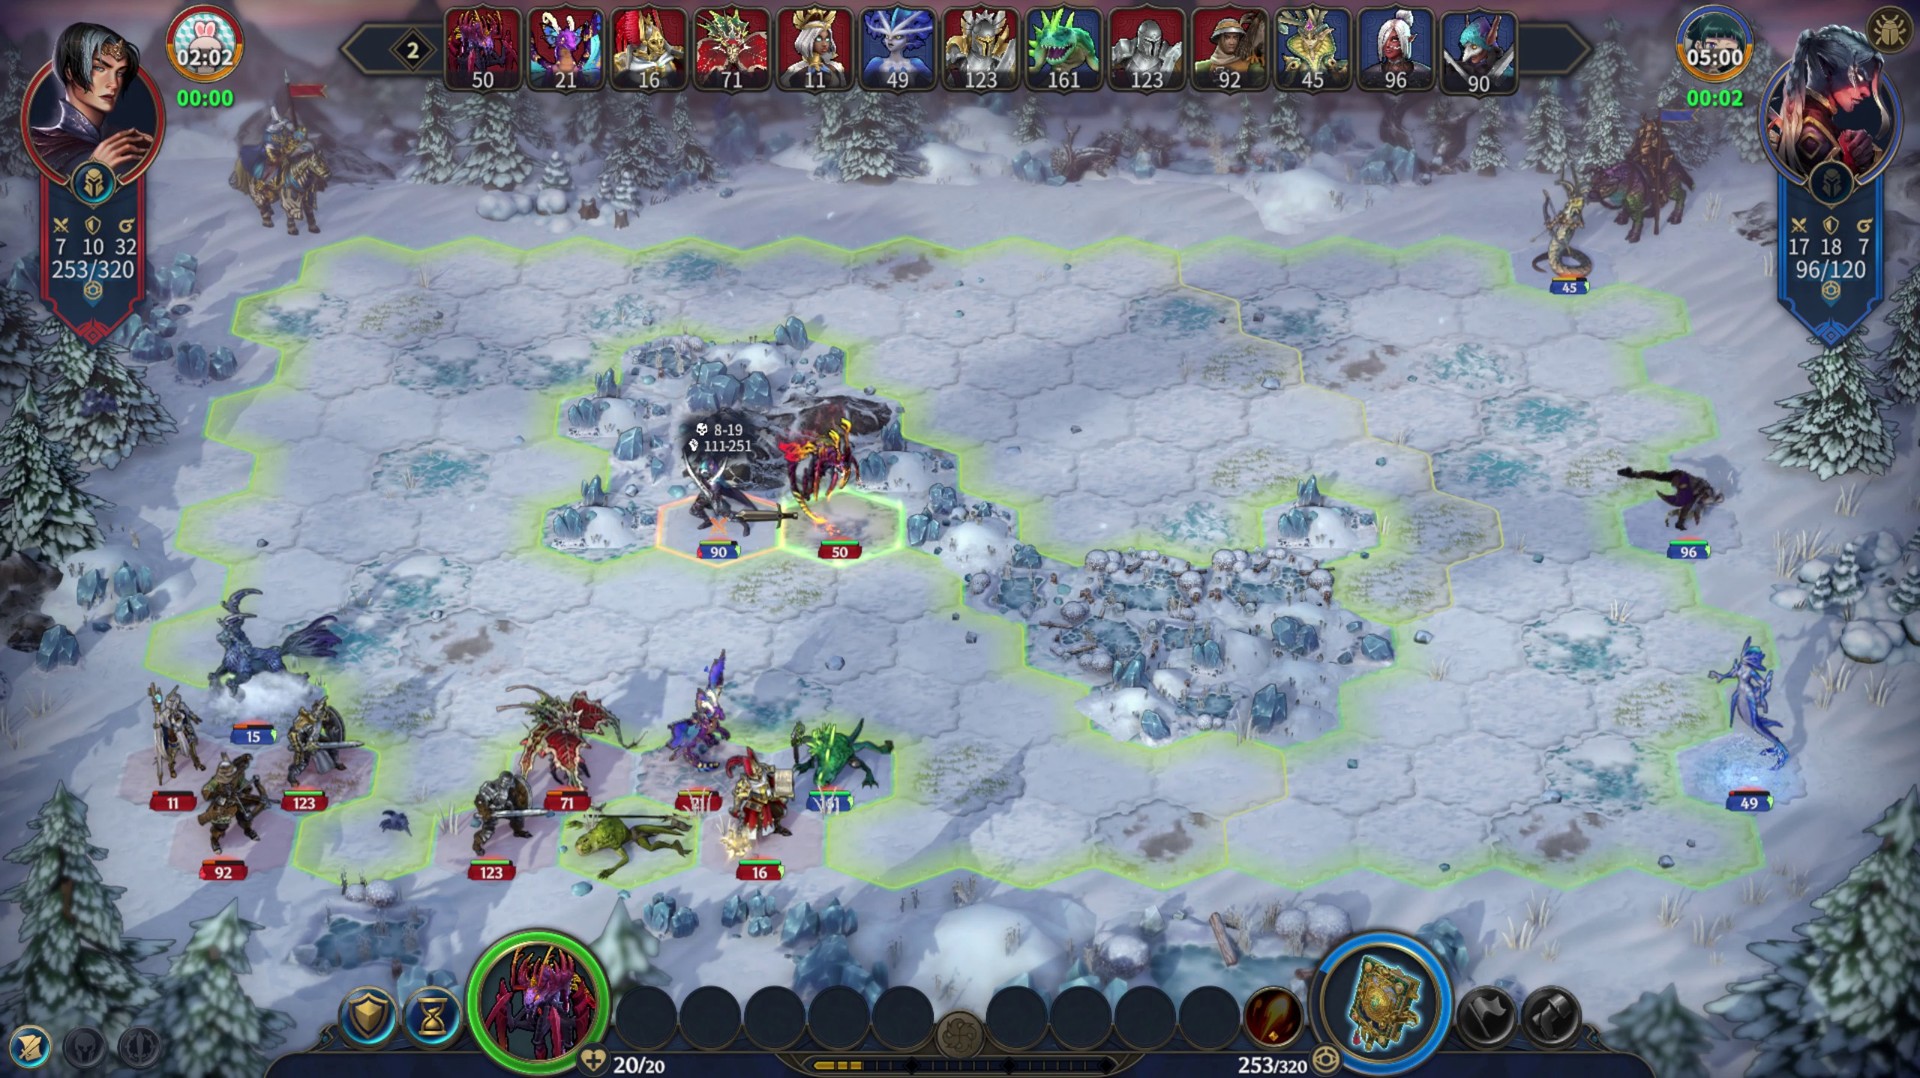
画面与来源说明
图 7。默认打开引发问题的雪地图。选择“黄色 → 只放宽黄色色相”看 64 个检出与 1 个误报,再选择“多尺度加共享边补缺口 → 检测到的格边”检查紫色补线。图层切换只改变显示,不会重新训练或修改标签。
| 方法 | 雪地图黄色:检出 / 误报 | 无大范围高亮草地图:并集误报 / 89 |
|---|---|---|
| 原 HSV 固定参数 | 0 / 0 | 37 |
| 只放宽黄色色相 | 64 / 1 | 34 |
| Lab 颜色与局部线对比 | 57 / 0 | 28 |
| 多尺度加共享边补缺口 | 59 / 0 | 71 |
| ExtraTrees 识别格边 | 0 / 0 | 1 |
雪地图为 highlight-103,黄色有 64 个正例、29 个反例;草地图为 highlight-087,并集有 89 个反例。零检出且零误报不等于成功。
这个对照阻止我们只挑最好看的截图:补轮廓救回雪地,却显著扩大草地误报;树模型几乎消除了这张草地图的误报,却仍漏掉雪地黄色。更直接看 182 个重叠正例,放宽色相找到 128 个,但误报 185 个重叠格;ExtraTrees 只找到 59 个,误报 21 个。两层同时读对仍是明确的缺口。
保留上一轮的 8 张留出测试结果:它为何曾经给出 99.5% 召回率
以下仅记录上一轮冻结配置后的测试。现在这些图已用于诊断,所以不能再给新方法提供一次独立测试。
精确率问“报出来的区域内格子有多少是对的”;召回率问“标签中的区域内格子找到了多少”。我们把两者都达到 90% 作为目标,而不是只要求 F1 或总体准确率高。
以下测试共 743 条判断:366 个正例、377 个反例。这些是可见、可判断空地上的助手标签;未知格子从一开始就排除,没有根据算法错误再改成未知。三个方法用相同图片、网格和标签计分。
| 方法(黄绿并集) | 精确率 | 召回率 | F1 | 检出 / 误报 / 漏检 |
|---|---|---|---|---|
| 原方法:格子内部颜色阈值 | 92.6% | 51.4% | 66.1% | 188 / 15 / 178 |
| 原方法:闭合边界填充 | 100% | 52.2% | 68.6% | 191 / 0 / 175 |
| 新方法:颜色边界与多方向投票 | 100% | 99.5% | 99.7% | 364 / 0 / 2 |
| 对照:所有格子都判为内部 | 49.3% | 100% | 66.0% | 366 / 377 / 0 |
窄屏可左右滑动查看完整表格。
在这组图里,新方法比旧闭合填充多找回了 173 个正例,没有增加误报。与此前两批不同画面的分数比较不同,这里是相同测试格子上的直接比较。不过,这个成绩回答的只是‘至少属于一个黄绿区域吗’,不能代替分颜色的成绩。
分开看颜色,得到:
| 单独检测哪一层? | 正例数 | 精确率 | 召回率 | 检出 / 误报 / 漏检 |
|---|---|---|---|---|
| 绿色 | 352 | 100% | 96.6% | 340 / 0 / 12 |
| 黄色 | 95 | 59.6% | 32.6% | 31 / 21 / 64 |
窄屏可左右滑动查看完整表格。
| 测试录像组 | 图数 | 并集精确率 / 召回率 | 黄色层的结果 |
|---|---|---|---|
| 9 月 2 日录像,熔岩与深色地面 | 4 | 100% / 98.6% | 找到 31 个正例,误报 21 个 |
| 8 月 22 日录像,雪地 | 4 | 100% / 100% | 64 个正例全部漏掉 |
黄色的 64 个漏检全部来自 highlight-103。这张图有明显的绿色大区域,也有一道更细的黄色内部边界。标签中的 64 个黄色内部格子同时都在绿色区域内,所以并集仍然正确;黄色单层却一个也没有恢复。
历史对照图。第 2 节的原图库选择 highlight-103 → 黄色 → 新方法,可以看到 64 个漏检;再切到黄绿并集,这 93 个评价格子却全部正确。这里的“新方法”指上一轮的固定版本。
当时提出的“重叠后无法恢复黄色闭环”只是待验证解释。第 4 节的新消融已经找到了可修正的硬色相门限问题,因此不再用那条解释替代算法诊断。渲染器具体如何混合两层、颜色分别属于哪个兵种,仍未由这些结果确定。
更早的开发数据仍然提醒我们不要只看新测试的平均数:固定参数后,旧 40 张加新开发 8 张的精确率为 93.9%,召回率为 87.2%。其中两张淡色雪地开发图,43 个和 27 个正例仍全部漏掉;新开发组的草地对照 highlight-087 没有大片高亮,却将 89 个反例中的 37 个误报为内部。区域恢复可以容忍少量断线,但第一步几乎没找到边,或地面产生很多假边时,投票也救不回来。
因此,这 8 张测试图上的并集和绿色层达到了 90% 双指标目标,黄色层没有达到。这次改进证明了利用颜色与已知网格的价值,但没有证明所有地图、所有悬停模式已经达到同样水平。遮挡格子的恢复、颜色到兵种的归属,还需要另外评价。
参数选择、运行时间与复现范围
预先列出 60 个边界强度、支持比例和投票阈值组合。验证组上若有精确率、召回率都达到 90% 的组合,就在其中选 F1 最高的;否则优先提高两者中较低的一项。选择写入文件后,才打开测试数据运行评价。验证组本身为 330 个检出、2 个误报、3 个漏检,属于选参数成绩。
测试图片已读入并缩放到 1920×1078 后,缓存网格的单张 CPU 检测中位耗时为 41.8 毫秒,95 分位为 44.6 毫秒。这里不含录像解码、读盘、缩放、首次网格建立和界面显示,不能直接称为端到端实时帧率。
新方法没有训练神经网络或重训旧的 RBF SVM。旧阈值法与闭合填充法仍使用之前选定的参数,作为固定对照;不是为新测试重新调出的最优基线。所有成绩只适用于这次给定的网格投影与评价标签。
7. 高亮能辅助判断障碍物,但范围外不等于障碍
如果能明确识别某个兵种当前显示的移动范围,就多了一份“哪些格子可达”的界面证据。反复观察不同兵种,可以减少只靠石头外观判断的依赖。但一个格子没有高亮,也可能只是距离不够、被单位占据或处于不同操作模式;不能直接标成石头。速度可以约束候选距离,移动方式和地图占位仍然影响可达范围。
障碍物检测本轮保留旧模型,没有重训。它在之前新增的 20 张图上找到了 171/322 个正例,误报 29 格:精确率 85.5%、召回率 53.1%、F1 65.5%。其中 26 个误报来自活兵占位;三张同场雪地图中的 57 个冰岩障碍物标注全部漏掉。新高亮方法的进步,不会自动把这些障碍物成绩变好。
查看之前 40 张图的障碍物、范围和路径结果
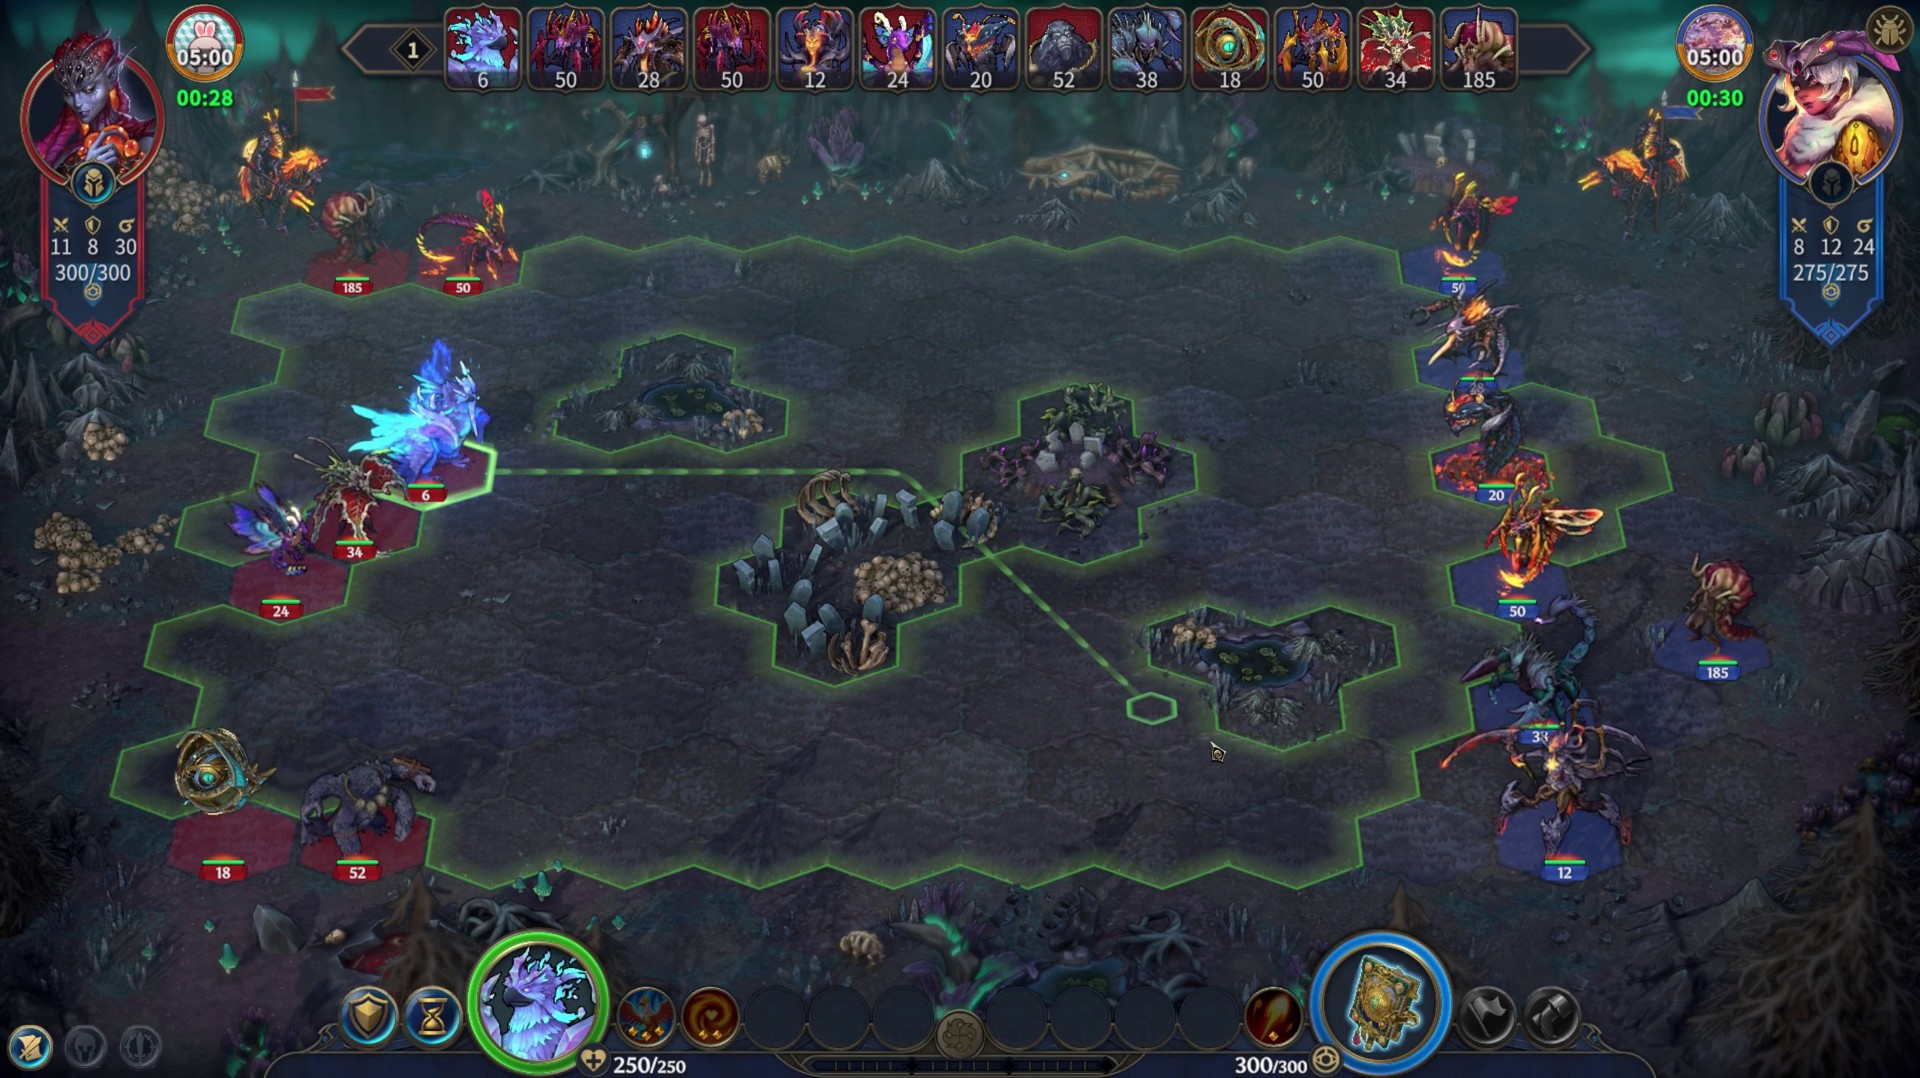
截图来源与标注说明
这里保留原始 20 张试验与第一次新增 20 张的独立历史分数。它们没有换成这次新高亮算法的预测,也没有合并成一个“新版准确率”。
战斗中还可能在空地上生成新障碍。早期样本 example-18 → example-19 → example-20 记录了同一战斗 09:06 → 10:36 → 16:06 的岩石变化,并非相邻帧。中间画面能明确看到 5 格新增岩石,另一个候选被遮挡;具体施法或死亡成因尚未确认。
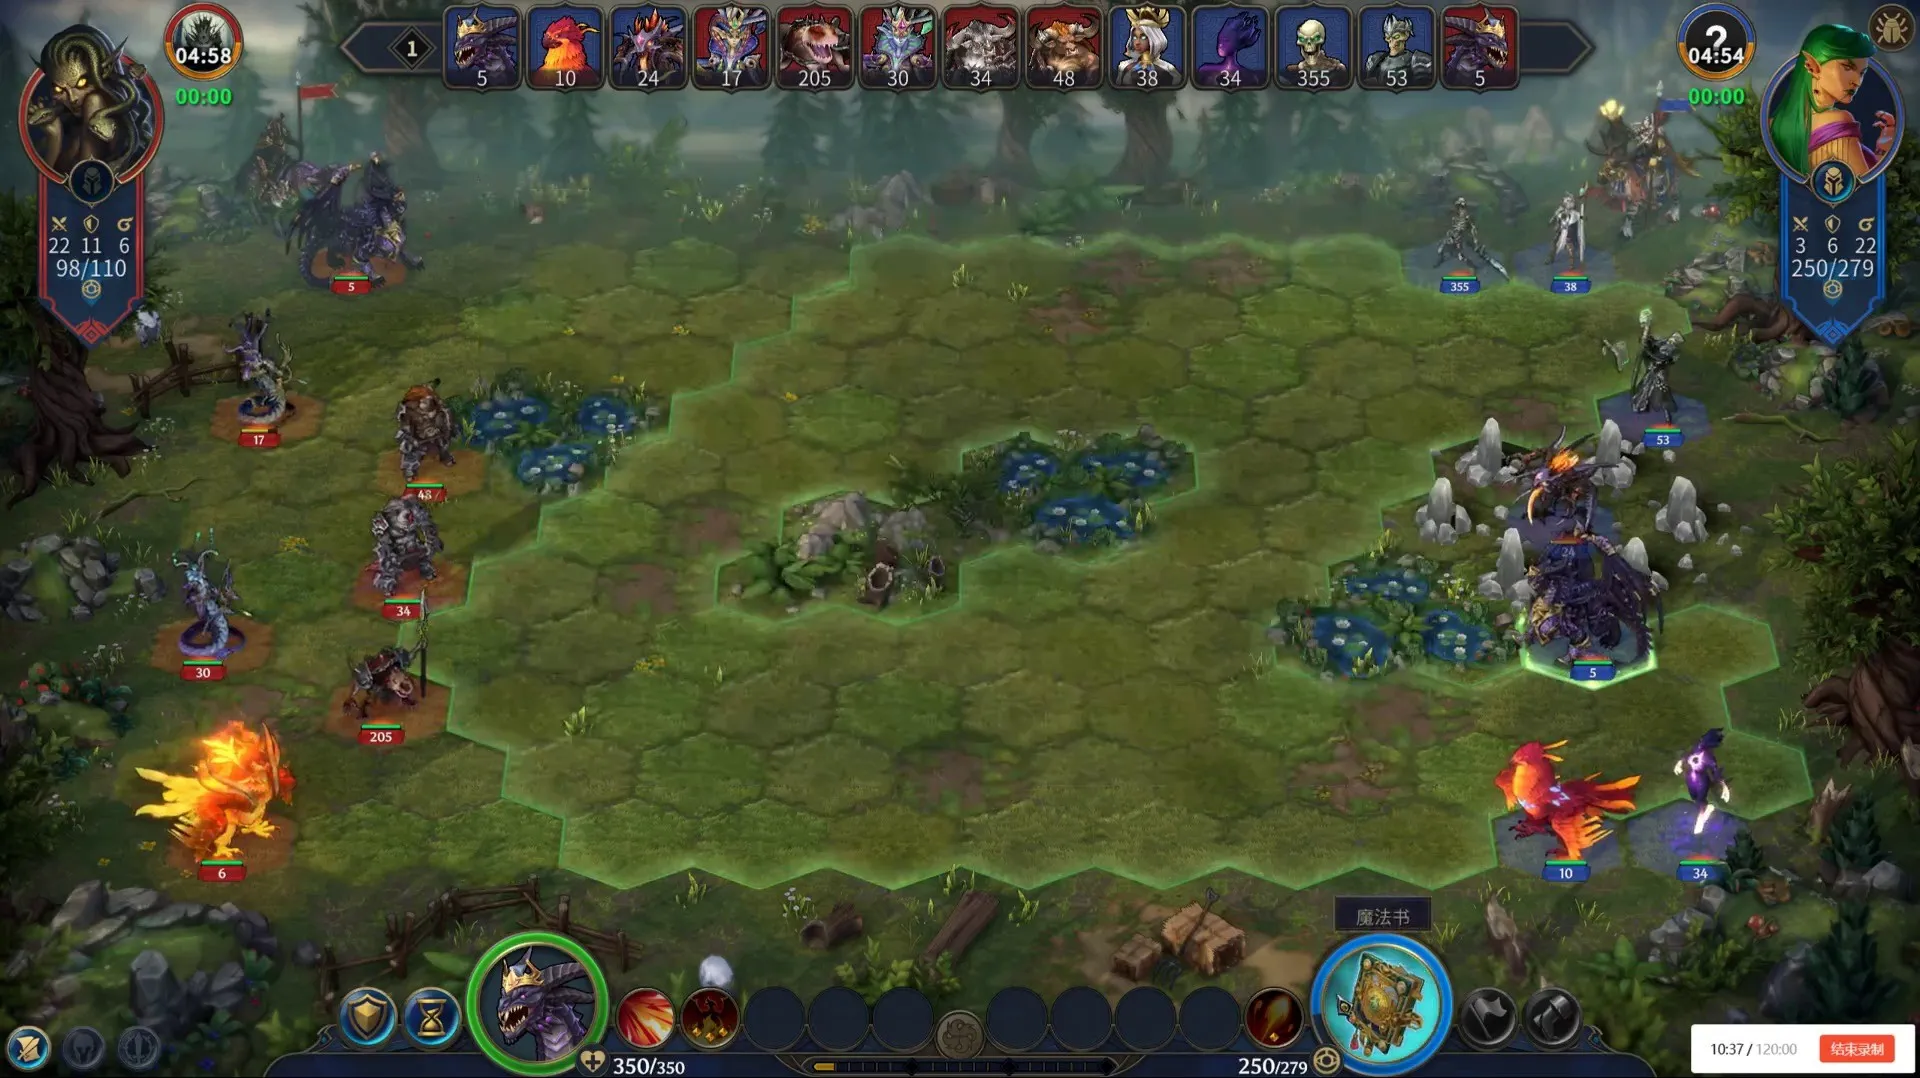
图 8。新增岩石位于右侧兵种周围。这是旧试验中的一个事件,高亮方法比较没有为它增加事件标注。
在 5 个新增岩石格和 77 个始终非障碍的格子中,按原始像素变化排序,前 5 名只找对 2 个;按“变化后更像障碍物多少”排序,前 5 名找对 5 个。它说明先判断变化的内容可能比直接减图更有用,但仍只是一个事件的排序结果,不是通用动态障碍物准确率。
8. 路径暂时输出可见片段,不阻塞范围改进
旧路径方法先找白色细线,再比较任意方向的 Hough 直线检测与只检查相邻格子中心连线的办法。后者减少了乱线,但在同一段测试录像的两张图中,片段 F1 仍只有 31.9% 和 23.7%,输出也没有恢复先后顺序。
这些分数只比较手工画出的可见白线部分:预测距离标签不超过参考截图上的 10 像素算匹配,额外片段算误报。绿色路径、被遮住的部分、起点和鼠标目的格还没完整覆盖。当前不能把几段检测到的线当成整条可执行路线。
这轮先把范围读清楚,路径保留为后续工作。它没有新训练、新标签或新的路径成绩。
9. 高分原型之后,还缺哪种证据
扩充录像来源后,学习型边界候选在新的冻结检查中达到黄色召回率 97.1%、绿色 97.5%,已知格子上没有误报;同一模型的训练数据对照也显示了改善。它适合继续辅助标注和检查画面,还不能作为无需确认的移动决策依据。重叠首测仅覆盖两张相似图,兵种归属、自动遮挡排除、障碍物和路径也各有尚未通过的检验。
下一步优先人工复核剩余红土地与熔岩错误,特别是逐边记录实际可见的本色边、双色共边、穿过的路径和确实看不清的位置。普通区域标签只能说明两格状态是否不同,不能证明某条颜色轮廓在截图里清晰可见。现有 21 段录像已全部有分颜色样本;继续采集应补充独立场景、黄色雪地和明确的悬停前后对照,避免主要增加同一种轮廓的近邻帧。
与 GPT 的算法讨论也指向两种更具体的实验:比较“沿格边的线”和“穿过格边的路径”的方向与连续长度;比较黄色、绿色在线条法向上的不同峰值与宽度。共边模型应要求两种颜色各自有可区分的图像证据,不能因为看到黄色,就自动替绿色补边。本次的小倾斜搜索只是前一种思路的局部消融,完整的路径竞争模型和双色空间模型尚未实测。
如果静态画面仍分不清,就从已有录像提取同一战场、镜头和行动者基本不变、只改变悬停目标的前后帧。对齐后观察哪条颜色出现或消失,能抵消固定背景,也更有机会区分移动路径与范围。两种不同隐藏状态若最终产生相同 RGB,单图方法本身无法保证还原;目前没有证据证明这张失败图一定属于这种情形。
本轮新增的只是范围标签与算法。旧障碍物和路径成绩保持不变。再收集数据时,优先补充明确的交互前后对照与独立人工复核,比继续增加很多同形状截图更有价值。
数据与实现
本轮新增三类模型、分组开发与冻结检查报告、31 张图的标签与逐格预测、51 张候选图的来源、时间与排除原因。模型训练帧列表、固定参数和软件版本保存在冻结报告中,每段录像的参考文件也增加了采样用途和标签路径。
新增可下载背景、线条、网格优化与两次冻结检查报告、53 张图的标签与预测、新增源图的录像时间和排除记录。每次冻结结果与后续开发消融分开存储。
此前可下载 11 个版本的完整报告、逐图分数与选参记录,以及所有方法的格子预测、格边与原始标签。方法名称、评价角色和单因素诊断都保留在文件中。每张图来自哪段录像、在哪个时间位置,仍由原来源索引追溯。
上一轮保留检测报告与固定参数、24 张来源与原分组、分颜色的助手标注和原格子预测。
历史试验保留原始报告、第一次新增数据的冻结复测和137 格投影。来源中的本地相对路径用于回到录像,不是网上的录像下载地址。
可复用检测代码在 Perception 包的 battlefield_highlights.py 、battlefield_highlight_features.py、battlefield_highlight_profiles.py、battlefield_highlight_graph.py 与 battlefield_highlight_detector.py;当前样本、训练、选参和评价脚本在 perception/experiments/b16_battlefield-cell-state/(原 B07),依赖的网格实验现在是 B15。完整门限搜索与模型保留在原 local_data/perception/experiments/b07_battlefield-cell-state/ 输出中。HSV 筛色可参考 OpenCV 的 inRange 说明;数据按录像分开,遵循分组评价原则。
2026 年 9 月 8 日迁移没有重跑模型。旧 b07.* 格式、日期配置和本文下载的测量文件不变。从仓库根目录继续开发,使用显式的新输出目录:
& local_data/devtools/environments/perception/Scripts/python.exe -X utf8 perception/experiments/b16_battlefield-cell-state/src/evaluate_new_videos.py development --output local_data/perception/experiments/b16_battlefield-cell-state/results/development-replay-after-review这是一条尚未执行的新运行示例,读取冻结开发标签;缺失输入或已有同名输出会明确失败。holdout 模式应在方案固定之后使用,不作为反复调参的入口。准备基础样本使用 src/prepare_pilot.py --output <新目录>,旧原型复跑使用 src/run_pilot.py --output <新目录>;具体输入见各脚本 --help,不把旧历史输出重写成新结果。
Comments