一场模拟战斗顺利结束,不能说明模拟器算对了。一个错误的伤害公式,也可以稳定运行几千场。更隐蔽的错误发生在组合上:陷阱让接近中的单位停在目标旁边,守望反应打到了相邻友军,处决发生在一个被限伤压成0的伤害包之后——每个机制单独都测过,两两相遇时才出错。
摘要
结论:组合错误主要靠“定向两两组合场景”和“长局随机合法动作”两种手段发现,所有已发现问题都已修复并转成回归测试;但这些检验只证明模拟器自洽,不证明它等于商业游戏。
我们要验证《英雄无敌:上古纪元》竞技场战斗的Simulator。方法分六层:中文受控场景、独立账本核算、预览与执行的差分比较、随机合法动作的崩溃模糊测试(失败时自动保存“失败前状态+失败动作”)、机制组合覆盖统计和代码行覆盖。2026-10-14测得Simulator行覆盖90.93%(110075/121060行),130个函数从未执行;随后三轮补测分别命中34、37、33个,其余26个判为不可达、仅测试调用或只在子进程运行。13个并行成对测试任务(C1–C13)与一轮后台补测共发现9个引擎或校验层问题、1个判定器问题,AI实验另撞出4个崩溃;完整Simulator套件从10-14的14903项通过增至10-15的16230项通过(2项跳过)。覆盖引导的novelty模糊测试只比最好的随机模式多5.0%组合,未达预先冻结的20%门槛。主要局限:初态多为合成夹具,覆盖率只说明代码被执行,规则依据仍需安装数据、原生代码审阅或实战录像。
1. 问题:为什么“能跑完”不等于“算对了”
一句话:程序可以稳定、可重复地算错,所以每种检查只能回答它被设计回答的那个问题。
Simulator的输入是明确的部队、英雄、装备、状态和动作,输出应是可解释的下一状态和事件回执。AI依赖它的预览决策,Battle Notes依赖它的规则查询解释真实对局。错误会以三种形式出现:
- 崩溃:合法菜单给出的动作,执行时被自检拒绝。例如2026-10-15,研究搜索在第6回合试用“吞噬圣杯”,两个敌人身上来自同一光织者的“内在光辉”被复制到施法者后共用一个编号,按单位顺序先复制第5回合那层、再复制第4回合那层,自检判定“同源延长时间倒流”而报错。
- 静默不一致:预览说伤害在某范围内,执行却在范围外;AI会据此选错动作。
- 规则偏差:程序自洽,但与游戏不同。这一类只能靠外部证据发现。
前两类可以由软件自动寻找,第三类不能。下图沿用此前的证据关系:真实规则依据和模拟执行是两条不同输入,不能由同一段被测代码同时生成答案和评分标准。
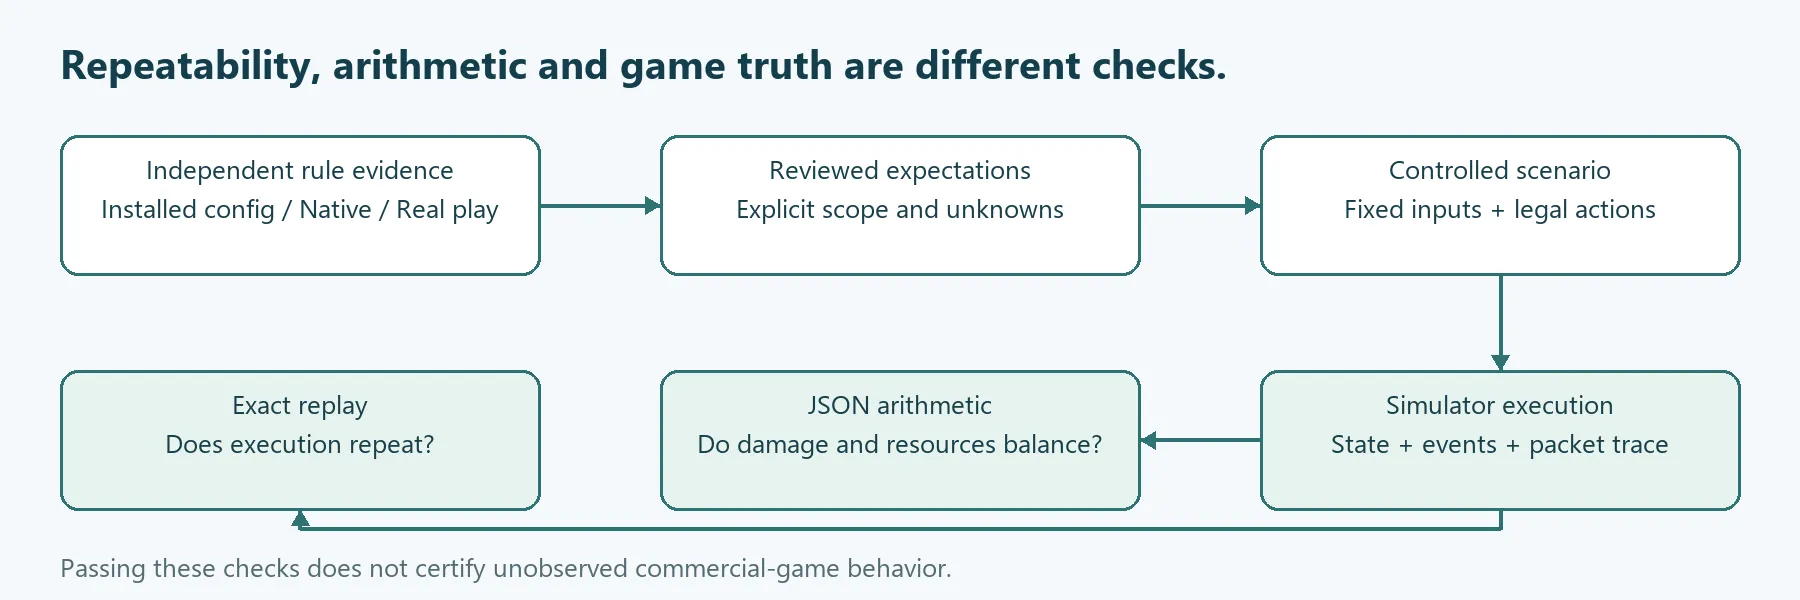
回放检查可重复性;独立账本检查收支;原生证据支持规则判断。三者没有互相替代的箭头。
| 检查 | 能说明什么 | 不能单独说明什么 |
|---|---|---|
| 机制单元测试与受控场景 | 给定输入产生固定结果 | 该预期就是商业游戏规则 |
| 内容绑定测试 | 单位或法术选择正确的配置机制 | 所有组合都已覆盖 |
| 序列化回放 | 规则版本、随机状态下可逐字节重复 | 重复出来的结果符合真实游戏 |
| 独立账本算术 | 伤害、治疗、资源与终态收支一致 | 触发顺序符合原生实现 |
| 预览差分 | AI看到的预览与执行一致 | 两者都正确 |
| 崩溃模糊测试与不变量 | 采样到的合法路径不崩溃、不同格、资源不越界 | 规则正确 |
| 覆盖统计 | 哪些代码与机制组合被执行过 | 被执行的路径结果正确 |
| 安装配置、原生调用链或可辨实战 | 某项规则有外部依据 | 全部未观测边界都相同 |
2. 方法
一句话:先用确定性场景固定已知规则,再用随机与成对组合去撞未知组合,撞到的失败自动缩成一步复现并变成永久测试。
2.1 中文受控场景:有白名单的小语言
我们有一套“假如/当/那么”的中文场景语言。它不是让语言模型自由理解一句话,而是字段、动作和断言都有白名单的小语言。下面的场景中,两只蓝兵各固定伤害20,在攻防均为0的控制条件下攻击,红兵生命应从200变为160:
场景:基础控制
规则:当前
种子:43
依据:game_knowledge/docs/game_rules/health-ledger.md
机制:普通攻击
边界:合法动作,生命连续性
假如 部队 蓝兵 阵营=蓝方 兵种=esquire 位置=5,5 数量=2 单体生命=100 当前生命=200 攻击=0 防御=0 伤害=20 主动=100
假如 部队 红兵 阵营=红方 兵种=minotaur 位置=6,5 数量=2 单体生命=100 当前生命=200 攻击=0 防御=0 伤害=20 主动=1
当 蓝兵 攻击 目标=红兵
那么 红兵 的 当前生命 应为 160
未知兵种、重复参数、越界位置和不认识的语句都报错,不会被猜成“差不多”的场景。场景写错是输入错误;场景合法而结果不符,才是行为不一致。把160改成159时,模拟步骤完全相同,只有断言失败——预期值不会反过来影响运行。语言模型以后可以帮忙起草这种文本,但预期结果应来自审核过的规则依据,而不是同一个模型的想象。
2.2 机制交互矩阵与成对任务
给每个技能写一个“施放成功”测试只覆盖最顺利的一条路径。更有用的是先列出机制维度,再两两组合。以反伤追加为例:从普攻还是主动能力进入;先普通反击还是先制反击;反伤是正数、被免疫还是被屏障挡住;来源是否死亡;追加能否治疗;自身追加是否再次触发自己。
完整笛卡尔积会产生大量重复和不合法场景,所以优先覆盖高风险族:死亡与回调、免疫与零伤害、临时生命与驱散、位移与陷阱、军队级标记与生命周期。两两覆盖只能降低遗漏风险,不能保证三个条件共同触发的错误不存在。每个场景必须标明初态是合法动作取得的,还是为隔离机制而构造的合成状态。
2026-10-14起,这些矩阵按模块拆成互不重叠的并行任务(见第3节)。任务只能新增测试文件,不能改引擎;发现引擎问题时用 strict=True 的预期失败标记,并限定为那个具体异常类型,这样夹具错误、其它断言或回放失败不会被“吞”成预期失败。修复后这些标记必须转为通过。
2.3 独立账本:最终生命正确还不够
来源受到20伤害又恢复20,前后生命不变;只比较终态就会漏掉受伤集能、状态中断和治疗记录。因此保存每个伤害包和非伤害变化,核对收支:
最终生命 = 初始生命 - 实际伤害 + 实际恢复 - 直接移除这只适用于固定生命上限、无变形的场景;生命上限变化、共享临时生命或形态转换要分别记账。2026-10-07(Core407下),一批74份受控历史含182个实际伤害包、38次嵌套追加和46条恢复记录,由不导入Simulator的JSON算术脚本逐项核对数值、父子包端点、集能与魔法值。这类核算独立于伤害执行函数,但仍读取该程序产生的日志:能抓漏账与重复账,抓不到一套自洽却错误的系数。
后来的修复表明,引擎内部的“阶段账本”自检也是重要的错误来源:例如龙翼飞行把幸存者推进伤害地形时,账本只重放伤害记录、漏了推开后的地形伤害,于是拒绝了合法结果(C1,提交 32c634112)。
2.4 预览与执行的差分比较
AI用预览估值,所以预览与执行不一致会直接误导AI。fuzz_preview_consistency 在随机完整构筑对局中,每个动作执行前取预览,执行后比对:普通攻击在没有途中场地、普通幸运、未被取消、无守望和先制反击时,实际伤害必须落在预览范围内;法术在无幸运时尝试伤害必须相等;技能逐个伤害操作比对执行回执中的同一操作。它只检查一致性,不检查规则是否等于游戏。
2.5 崩溃模糊测试与自动复现存档
fuzz_legal_actions 与 fuzz_arena_builds 用随机选秀或随机阵容开局,按种子走随机合法动作;每个技能和法术先预览再执行。任何来自合法动作生成、预览或转移的异常都是失败。每一步后检查不变量:活部队不同格、不在障碍或占格物体上、英雄魔法非负、共享集能在上限内。终局后整局写成JSON、读回并逐步重演,双方的公开观察投影必须能序列化,且始终未公开的字段不能泄漏给对方。
长局失败以前很难复现:第300步才崩,要重跑整局。2026-10-14起(提交 c35f20abf),预览、转移或不变量一旦失败,就把失败前的状态和那一个动作存为 fuzz-repro.v1 格式的gzip JSON。fuzz_repro check 在保存的规则版本上重放这一步;若存档状态的哈希与记录不符,报告为“过期”,而不是默默拿另一个状态去测。提交到 simulator/tests/fixtures/fuzz_repros/ 的存档由 test_fuzz_repros 逐个重放,要求整步通过,修过的崩溃就不会悄悄回来。
flowchart LR
 A[Seeded legal action] --> B[Preview / transition / invariants]
 B -- pass --> A
 B -- fail --> C[Save pre-step state + action]
 C --> D[fuzz_repro check reproduces]
 D --> E[Fix engine or validator]
 E --> F[Commit capture as fixture]
 F --> G[test_fuzz_repros must pass]
图1:一次失败如何变成永久回归测试。
2.6 机制组合覆盖与覆盖引导模式
数对局场数不能说明哪些组合被碰过。fuzz_mechanism_coverage(提交 4aeda4d53)对每次转移记录动作族和结果中所有非空的证据键(反应、回执、触发、状态列表、击杀归因及少数结果标志),统计单标签、动作×标签和标签×标签组合。它是覆盖工具,不是规则检查:一个标签只说明对应证据键非空。
在此基础上加了 novelty 模式(提交 4fd53b792):每步用不计数的转移试探最多6个合法动作,选能带来最少见标签与组合的那个。它的选择依赖前面种子已覆盖的内容,所以单凭种子不能复现,失败只能从存档复现——这正是2.5节存档机制的另一个用途。
2.7 代码行覆盖
行覆盖用仓库自带的 devtools/coverage/simcov.py(pytest插件)与 simcov_report.py 统计,只计 simulator/tests 对 simulator/src/olden_era_ai/simulator 的覆盖。从未执行的函数作为补测线索:要么经合法动作菜单、预览和转移补一个场景,要么证明它不可达后登记为死代码候选。按项目规则,删除前还需完整的调用审计,零文本命中不算证据。
3. 实验设置
一句话:所有随机检验都固定种子与规则版本,覆盖对比在运行前冻结了判读门槛,并行任务各写各的文件。
| 项目 | 设置 | 来源 |
|---|---|---|
| 预览差分(Core426) | 种子13000–13799与14000–14799各800场;接近攻击另测40与800个种子 | simulator/docs/CORE426_PREVIEW_CONSISTENCY_2026_10_08.md |
| 预览差分(Core450) | default 72000起100局、family 72300起60局、approaches 72500起60局、spells 72700起60局 | simulator/docs/HANDOFF.md(2026-10-14条) |
| 崩溃fuzz(Core424) | 完整构筑种子10000–10479,每场10回合、400步;随机阵容21440–21919 | simulator/docs/CORE424_LONG_BATTLE_FUZZ_2026_10_08.md |
| 崩溃fuzz(2026-10-14) | fuzz_arena_builds,20回合、400步,种子73000–73199,另一第2批 |
simulator/docs/HANDOFF.md |
| 覆盖对比0350 | 规则battle-core.v451、arena-battle-inputs.v5;种子73900–73939;三种模式同种子,每局最多20回合400步;判读门槛:novelty的标签×标签组合比另两种中较高者多20%以上才算“覆盖更广”;只跑一次 | game_ai/experiments/0350-coverage-guided-fuzz/README.md |
| 行覆盖 | 2026-10-14,全套 -n5,绑0–7核,约450秒 |
simulator/docs/HANDOFF.md |
| 并行任务C1–C10 | codex exec 无人值守,24逻辑核机器,每任务pytest最多2个worker,经 devtools/game_friendly_run.py --cores 8 低优先级运行;C9、C10用图形界面,串行 |
docs/handoff/2026-10-14-codex-parallel-tasks/README.md |
| 第二轮C11–C13 | 按GPT r9建议的P0–P2三类高风险组合;内存紧张,pytest一律 -n 1 |
docs/handoff/2026-10-14-codex-parallel-tasks/tasks/C11-death-transform-markers.md |
并行任务的启动有一次失败:npm安装的codex-cli 0.147.0不支持配置的模型,10个任务在开工前全部报错退出,没有改任何文件;改用Codex桌面版自带的0.162.0-alpha后重启(来源:docs/handoff/2026-10-14-codex-parallel-tasks/results/SUMMARY.md)。每个任务只提交自己的新测试和 results/ 下的结果文件;引擎文件只由simulator1修改。
4. 结果
一句话:随机与成对测试找到的问题大多是“自检拒绝了合法组合”,修复后全部转为回归测试;覆盖引导没有显著提高组合覆盖。
4.1 预览差分
| 日期与版本 | 规模 | 发现 | 处理 |
|---|---|---|---|
| 2026-10-08,Core426 | 第一批800场,约2.25万次攻击预览、6000次法术预览 | 0处不一致(期间1个执行崩溃) | — |
| 同上,纳入接近攻击 | 40个种子 | 16处:攻击方走到位后预览未重算“众志成城”等位置相关属性 | 预览在终点再刷新一次,复跑0处 |
| 同上,扩大 | 800个种子 | 约25处:预览漏算“移动完成”触发的娜伊拉之吻伤害 | 预览按执行顺序先结算该伤害 |
| 2026-10-14,Core450 | 4组共280局 | 1条(种子72032第59步,凤凰先制反击波次) | 属判定器缺口,先制分支改按锚点包规则(cfa99a0ff),引擎无错 |
另外,C4任务新增246项法术目标×免疫/抗性/等级×预测一致性测试,全部通过;C1修正了判定器以过地形前数量为基数而对“火墙+守望”误报的问题(32c634112)。来源:simulator/docs/CORE426_PREVIEW_CONSISTENCY_2026_10_08.md、docs/handoff/2026-10-14-codex-parallel-tasks/results/SUMMARY.md。
4.2 崩溃模糊测试与复现存档
历史上,Core421(2026-10-08)三轮完整选秀fuzz分别跑480、960、960场,找到化身属性派生参数过期、虫卵快照、周期伤害跳过已移除状态等多类问题;Core424的长局(10回合、400步)在480+480场中找到2类,修后600+480场0失败(来源:simulator/docs/CORE421_FULL_BUILD_FUZZ_2026_10_08.md、CORE424_LONG_BATTLE_FUZZ_2026_10_08.md)。
当前提交的四个复现存档如下:
| 存档 | 来源 | 原错误 | 修复 |
|---|---|---|---|
transition-seed73130-step-1.json.gz |
2026-10-14长局fuzz | 冰霜吐息接近途中踩陷阱停下、仍与目标相邻,技能接近回执误判 | f2950c456 |
transition-seed73331-step279.json.gz |
2026-10-14长局fuzz第2批 | 龙翔起飞遇范围守望打到相邻友军,落地范围结果检查误判 | 7f31cf028 |
transition-seed68261-step-1.json.gz |
0068 H3组第579局后中止 | 升级审判官的迅捷忏悔波及自身,范围驱散移除阿瑞娜圣歌使单体生命108→90;账本只在最终核对时刷新生命上限,指挥治疗前的核对报错 | 账本在治疗核对前刷新一次(94671fadb) |
transition-seed70703-step89.json.gz |
0074第1次运行 | 吞噬圣杯复制同源两层内在光辉,顺序倒置被判时间倒流 | 同编号快照按施加回合从早到晚复制(8d204c683) |
前两个是存档机制建立前的旧崩溃转换而来;四个存档都在修复前的代码上复现原错误,现在通过(来源:simulator/tests/test_fuzz_repros.py、simulator/docs/HANDOFF.md)。
4.3 机制组合覆盖与0350对比
2026-10-14第3批100局随机fuzz 0失败,出现85个标签、248个动作×标签、945个标签×标签组合;守望反应和协助反击各只出现2次,多目标法术10次、攻击地形格6次、完成法术放置4次。这一批统计时回放校验把每步多计一次,只影响次数,不影响出现过哪些标签和组合。
| 模式 | 转移 | 标签 | 动作×标签 | 标签×标签 | 有效墙钟 | 每分钟组合 | 崩溃 |
|---|---|---|---|---|---|---|---|
| default | 5910 | 77 | 198 | 773 | 385秒 | 120.5 | 0 |
| family | 10488 | 75 | 233 | 737 | 673秒 | 65.7 | 0 |
| novelty | 9842 | 82 | 265 | 812 | 989秒 | 49.3 | 0 |
按冻结标准判读为没有明显优势:novelty比default多5.0%(812对773),未达20%,每分钟新增组合最低。三种模式互补:合计1055个组合,novelty独有126个组合和5个标签;default与family中只出现≤2次的323个稀有组合,novelty覆盖了118个。novelty的墙钟中有1917秒是因整机内存紧张而挂起,表中只计有效时间。来源:game_ai/experiments/0350-coverage-guided-fuzz/README.md。
4.4 行覆盖与三轮补测
| 时间 | 结果 | 来源 |
|---|---|---|
| 2026-10-07 | 89.97%,141个函数从未执行 | simulator/docs/HANDOFF.md |
| 2026-10-14 | 90.93%(110075/121060行),130个函数从未执行 | 同上;汇总 local_data/simulator/coverage-2026-10-14/summary-sim.json |
| C5(10-14) | 新增14项,命中34个原未执行函数,增加674行 | docs/handoff/2026-10-14-codex-parallel-tasks/results/C5.md |
139ae726f(10-15) |
公开规则事实与投影96项全过,再命中37个 | simulator/docs/HANDOFF.md |
c98e81099(10-15) |
内部模块49项全过,再命中33个 | 同上 |
| 剩余 | 26个判为不可达、只有测试调用或只在子进程运行 | local_data/simulator/coverage-2026-10-15/internal/reachability.txt |
剩余26个包括:选秀模块4个没有调用者的私有函数、战斗模块2个没有调用者的函数、三个已注册但没有任何能力定义或绑定使用的状态组解析器(共15个函数,C5已列为候选)、一个只在旧回执形状下才可达的反击记录函数。后两轮是单进程simcov测量,只能把基线130个函数中按函数名和行号对得上的121个用于比对;因此34+37+33+26这四个数是分别测出的,之后没有重测整体行覆盖率,不能把它们合成一个新百分比。死代码候选只登记在待办,未删除。
同次还统计了网页:Arena的 app.js 251个函数中47个、replay.js 20个中10个从未在测试里出现;C7为其中57个函数补了69项Node单元测试。
4.5 并行成对测试任务C1–C13
| 任务 | 内容 | 新增 | 发现 | 处理 |
|---|---|---|---|---|
| C1 | 移动中断(陷阱、守望、地形、强制位移)两两组合 | 133项 | 7项strict xfail:龙翼飞行推入地形的账本漏账;火墙+守望判定器基数错误;陷阱杀死带编队守望标记的农民,被动“心爱的小猪”转化为0后尸体被消耗,下一次菜单报错 | 32c634112、792dc9364 |
| C2 | 死亡/复活/召唤×伤害包;20回合双输等终局 | 69场景 | 死亡之握伤害包被天选压成0后死亡之召仍处决,回执要求正伤害而报错 | 18e0877d6 |
| C3 | 反击次数边界×先制/守望/协助反击 | 106项 | 无 | — |
| C4 | 法术目标×免疫/抗性/等级×预测一致性 | 246项 | 无 | — |
| C5 | 行覆盖缺口 | 14项 | 无引擎问题;3个死代码候选 | 登记 |
| C6 | 公平策略隐藏信息与确定性审计 | 69项 | 未发现泄漏 | — |
| C7 | Arena网页未测函数 | 69项 | 3个展示缺陷(未知多目标伤害显示0等) | a90d05028 |
| C8 | GK既有失败 | 35项登记 | 33项缺历史版本安装;2项三头政治审计因安装数据新增字段失败 | 1bc6d5c9a(字段语义未认证) |
| C9 | Reference App失败与卡住的测试 | 6项条件跳过 | 345项通过、无超时 | — |
| C10 | 浏览器整局e2e | 5项 | 390px终局页按钮遮挡点评入口 | a90d05028 |
| C11 | 死亡/转化×军队标记×复活/召唤(P0) | 222场景 | 零转化后正义献身配置读取首个单位为载体,载体已消失时菜单报错 | 2cf1fe775 |
| C12 | 推/拉/飞×地形×多阶段伤害(P1) | 69项 | 无新问题;C1的地形账本修复在新组合中保持通过 | — |
| C13 | 处决/死亡召唤×拦截、限伤、零伤害(P2) | 183场景 | 17项strict xfail,4类:零伤害包后的处决漏记击杀;火墙回执写处决前生命;持续伤害混用处决前生命与处决后数量;地形处决丢失施法者归属 | Core452(adcdb8485) |
另一轮后台补测(73d6f6729,2026-10-15,39项,37通过、2项strict xfail)发现:黑洞先打死农民,后被拉的部队停在它的格子上,行动结算后农民原地转化为亡灵农民,两个活部队同格。修复为Core453:转化数量(初始数量一半向下取整)大于0时,在同批强制位移中预留该格。
合计,C1–C13与这轮后台补测发现了9个引擎或校验层问题(C1两个、C2一个、C11一个、C13四类、后台一个)、1个判定器问题、4个网页展示与布局问题和1个GK审计问题,全部已修复。C1、C2与C11的修复只放行以前会报错的状态,正常对局行为不变,没有升规则版本;C13与后台补测的修复改变事件内容,分别升为Core452、Core453。来源:docs/handoff/2026-10-14-codex-parallel-tasks/results/SUMMARY.md、C11.md、C12.md、C13.md,simulator/docs/CORE453_OWNER_DEATH_TRANSFORM_HEX_RESERVATION_2026_10_15.md。
4.6 AI实验本身撞出的错误
AI对战实验会长时间走大量真实决策路径,是另一种模糊测试。每次中止都保留原记录,修复后不补进原成绩。
| 日期 | 实验 | 现象 | 修复 |
|---|---|---|---|
| 2026-10-14 | 0067第1次(种子67268、67210) | 死亡之握额外杀兵回执:死亡之召处决剩余部队、阿瑞娜之选限伤后没有减员,回执均拒绝 | 回执记录处决与限伤(2455f851d) |
| 2026-10-14 | 0067随机对照(种子67421) | 英雄攻击“混乱打击”把麒麟的无限反击(−1)减成0,下一次状态替换又重置为−1 | Core451(7c3b1215c,实验0348) |
| 2026-10-14 | 0068 H3组 | 迅捷忏悔自我驱散后的治疗核对(见4.2) | 94671fadb |
| 2026-10-15 | 0074第1次 | 吞噬圣杯同源快照顺序(见4.2) | 8d204c683 |
更早的同类例子:2026-10-10布阵A/B种子7104(黑洞打死己方凤凰后把敌方拉进其格,Core446);2026-10-12 CEM训练中防御−21召唤化身触发的聚合伤害符号校验,以及全军阵亡后召唤技能来源读取(来源:simulator/docs/HANDOFF.md)。
4.7 完整套件数字
| 时间 | 规则版本 | 结果 | 来源 |
|---|---|---|---|
| 2026-10-07 | Core407 | 相关回归106个文件3995项通过、12项跳过(无创建符号链接权限,不算成功;非完整套件) | 本文旧版 |
| 2026-10-14 | Core451 | 完整Simulator套件14903项通过、2项跳过(覆盖测量同次) | simulator/docs/HANDOFF.md |
| 2026-10-14 | Core451 | 合并C1–C10修复后15480项通过、2项跳过 | 同上 |
| 2026-10-15 | Core452 | 16011项通过 | 同上 |
| 2026-10-15 | Core453 | 16228项通过、2项跳过;256局v452/v451存档重演逐字节一致 | 同上 |
| 2026-10-15 | Core453 | 吞噬圣杯修复后16230项通过、2项跳过 | 8d204c683 提交说明 |
参数化用例各算一项,增长主要来自新增场景,不代表独立真实战斗数增长。
5. 讨论
一句话:已确定的是“自检很严格、错误多在组合边界”;未验证的是这些规则本身是否与商业游戏一致。
**已确定。**第一,本轮找到的问题大多不是“算错了数”,而是回执与账本自检拒绝了合法组合:限伤为0的包之后的处决、陷阱停下后仍相邻、驱散改变生命上限后的治疗。这类修复多数只放宽以前必然报错的状态,因此不升规则版本、不影响已完成的对局。第二,凡是改变事件内容的修复都按规则版本门控:Core451、452、453各保留旧版本读取器,旧存档用旧规则逐字节重演。原因是回放比对的是事件字节,改了事件就必须能区分新旧。第三,复现存档把“长局第N步才崩”的问题缩成一步,本轮4个存档都在修复前复现、修复后通过。
**定向成对测试与随机测试各有所长。**Core453的同格问题有现成的不变量能抓住,但随机fuzz没有撞到,是按“死亡被动×同批推拉”写的确定性场景先发现的;反过来,冰霜吐息、龙翔起飞和吞噬圣杯的问题都是长局随机路径或AI决策先撞到的,事先没有人想到要写这些组合。
**未验证的解释。**novelty只多5%的组合,可能因为评分被常见的系统效果标签主导、每步6次试探降低了吞吐,或者40个种子太少——这些都没有单独测过。0350建议的改进(降低常见标签权重、按未出现组合打分、试探数降到3)需要另立实验。
6. 局限与威胁
一句话:通过的测试证明程序与它自己的规则一致,不证明这些规则等于游戏。
- 规则真值:所有预期来自Simulator现行规则或审核过的依据;只有安装配置、原生代码审阅或可辨实战才能支持规则判断。Core453的“预留格子”和吞噬圣杯的复制顺序都是使程序自洽的选择,商业游戏中的同类情形尚未用录像核对。
- 合成初态:C1–C13大量使用合成机制夹具,动作与结算走真实引擎,但初态不来自实际对局;能否在商业游戏中合法到达,按场景分别标注。
- 判定器与被测代码共享逻辑:预览差分与账本核对仍读取同一程序的回执;判定器本身也出过错(火墙+守望、先制反击波次)。
- 覆盖的含义:行覆盖只说明代码被执行;机制标签只说明证据键非空。90.93%是10-14的单次测量,之后三轮补测未重测整体百分比。
- 样本量:0350只跑一次、40个种子,不做显著性结论;novelty的选择依赖运行顺序。
- 未覆盖项:三个以上条件同时触发的组合;真实浏览器布局只覆盖部分;C8的33项需要旧版游戏安装,目前无法恢复;完整套件仍有2项跳过。
- 数字口径:各次完整套件在不同提交上运行,增长包含新增测试,不能当作通过率变化。
7. 结论与后续工作
一句话:分层检验加“失败即存档”的闭环,已让Simulator在大量规则组合上自洽;下一步是减少盲区,而不是追加通过数。
当前做法有效的部分:确定性场景固定已知规则;长局随机合法动作和AI实验撞出未想到的组合;失败自动缩成一步复现并成为永久测试;成对任务按机制族系统化地补边界。
后续工作:
- 按0350建议另立实验改进覆盖引导评分,并让default与novelty轮换长跑、合并覆盖统计。
- 在补测后重新测一次整体行覆盖;对26个判为不可达的函数完成调用审计后再决定删除。
- 继续GPT r9的三类高风险组合,扩展到三条件组合;范围法术预览尚未计入处决,按规则版本门控实现。
- 故障注入:临时让程序少记一个包、互换两个阶段或放宽免疫,检验测试能否失败。这仍是后续方案,没有做过全量变异测试。
- 对完整原生回调顺序做认证:来源死亡、治疗、清召唤和其他订阅者同时发生时的顺序,需要原生审阅或实战证据。
8. 复现方式
以下命令在仓库根目录运行,Python用 local_data/devtools/environments/core/Scripts/python.exe;用户玩游戏时经 devtools/game_friendly_run.py --cores 8 -- 低优先级运行。
# 崩溃fuzz(MODE: default / family / novelty)
python -m simulator.benchmarks.code.fuzz_arena_builds START COUNT [OUT.jsonl [MAX_ROUNDS [MAX_STEPS [MODE]]]]
python simulator/benchmarks/code/fuzz_legal_actions.py START COUNT [OUT.jsonl [MODE]]

# 重放复现存档
python -m simulator.benchmarks.code.fuzz_repro check simulator/tests/fixtures/fuzz_repros/*.json.gz
python -m pytest simulator/tests/test_fuzz_repros.py

# 预览差分
python -m simulator.benchmarks.code.fuzz_preview_consistency START COUNT [OUT.jsonl]

# 行覆盖(PowerShell环境变量写法见C5结果文件)
SIMCOV_ROOT=simulator/src/olden_era_ai/simulator SIMCOV_OUT=OUT_DIR/raw PYTHONPATH=devtools/coverage \
  python -m pytest simulator/tests -p simcov
python devtools/coverage/simcov_report.py simulator/src/olden_era_ai/simulator OUT_DIR/raw OUT_DIR/summary.json并行任务书与各任务结果:docs/handoff/2026-10-14-codex-parallel-tasks/。配套测试设计:docs/architecture/SIMULATOR_TEST_ASSURANCE_DESIGN.md。
9. 更新记录
2026-10-15:改写为方法与结果报告,截至Core453。新增预览差分、崩溃fuzz与 fuzz-repro.v1 复现存档(含0074的seed70703)、机制组合覆盖与0350覆盖引导对比、行覆盖90.93%及三轮补测、并行任务C1–C13与后台补测发现的问题和修复、AI实验撞出的错误、完整套件数字。原“文字场景/交互矩阵/独立查账/怎样计覆盖”内容并入第2节,原“下一步”并入第7节。本版由simulator1依据仓库文件整理,未另送外部审阅;转为非草稿。
2026-10-14:规则、回放与AI研究进展
交接说明:本篇当时仍为草稿;新增多类合法动作、来源去除和负例组合;目录包含实体不代表全机制覆盖,Simulator执行与查询也不是商业游戏独立真值。本轮仅更新本地来源,最近工作总览见从已读属性到有来源的战斗解释;软件回归、曝光训练样例和独立实战验收分别报告。
验证拆成四层:固定规则场景检查行为;保存事件和终态重演检查确定性;真实回放页面检查导入、拖动与英雄详情;独立来源整局才检验策略收益。任何一层通过都不能替代后一层。Core449那轮记录了738个不同软件检查,旧19条记录1467次转移仍按448语义重演;原有13个终局、6个未知和45个未开始槽保持原样,修后针对第96步生命周期缺陷的诊断属于正确性复现,不补进原训练成绩。所有新研究按0000–0099搜索、0100–0199构筑、0200–0299学习、0300–0399规则、0400–0499界面、0500–0599性能登记;失败报告同样写清问题、冻结门槛、全部尝试、原始证据、确定原因与未知解释。
2026-10-07:初稿,基于Core407审计记录(74份受控历史、440次操作,不是74场商业游戏实战)。R1接受外部GPT审阅;R1.1由Codex依据反馈补充核算范围,当时未再次送审。
Comments