战斗画面底部有一排圆形按钮。有的槽位是空的,有的显示技能图案,有的中央还叠着数字。要让程序读全一张截图,这一排也不能只留一块空白。
先解决最基础的三件事:找到位置、描述外观、读出明确的数字。先补两个大圆和旁边的资源分数,再补三个角落按钮与两个资源图标,既有整帧案例的底栏位置从15/22,经17/22补到22/22,没有额外框。 这只是位置补齐:小按钮中央数字仍会误读,技能身份和能不能用还不知道,默认流程暂不启用。
真实视频的120张邻帧又揭示了一个上游问题:底栏已经清楚,按钮外观也变了,整图稳定器却可能一张都不选。第8节用原图说明这次漏采,以及后来为什么尝试局部取样。
flowchart LR
 A["Source frame"] --> B["Normalize reviewed sizes"]
 B --> G["Check circles and scene"]
 G --> C["Empty or occupied"]
 C --> D["Color and literal digits"]
 D --> E["Review each slot"]
图1:流程先回答“在哪里、看到了什么”。位置和外观已有可选视频步骤;大圆旁分数新接到可选同帧字段步骤。小按钮中央数字尚未接入,外观也不直接变成游戏规则判断。
1. 先说清这一排包含什么
这是一款回合制战斗游戏。底部两个大圆之间,以及它们的外侧,排列着技能槽和控制按钮。旧实验检查 15个圆形位置:14个小圆,加中央装饰圆。空槽也要记录为空,不能把找到一个圆当成找到一个技能。后文“15圈”的历史分母始终是这组位置,不是所有底栏元素。
9月27日的同帧全景核对将底栏扩大到22个可见图形:旧15项都匹配,但两个大圆、三个左下角按钮和两个资源图标没有输出。那次只补参考,没有改算法;它暴露的是任务范围缺口。9月29日分两步补出这些位置,见第9、10节。旧实验的15圈分母仍保留,身份、含义和可用性也仍未完成。
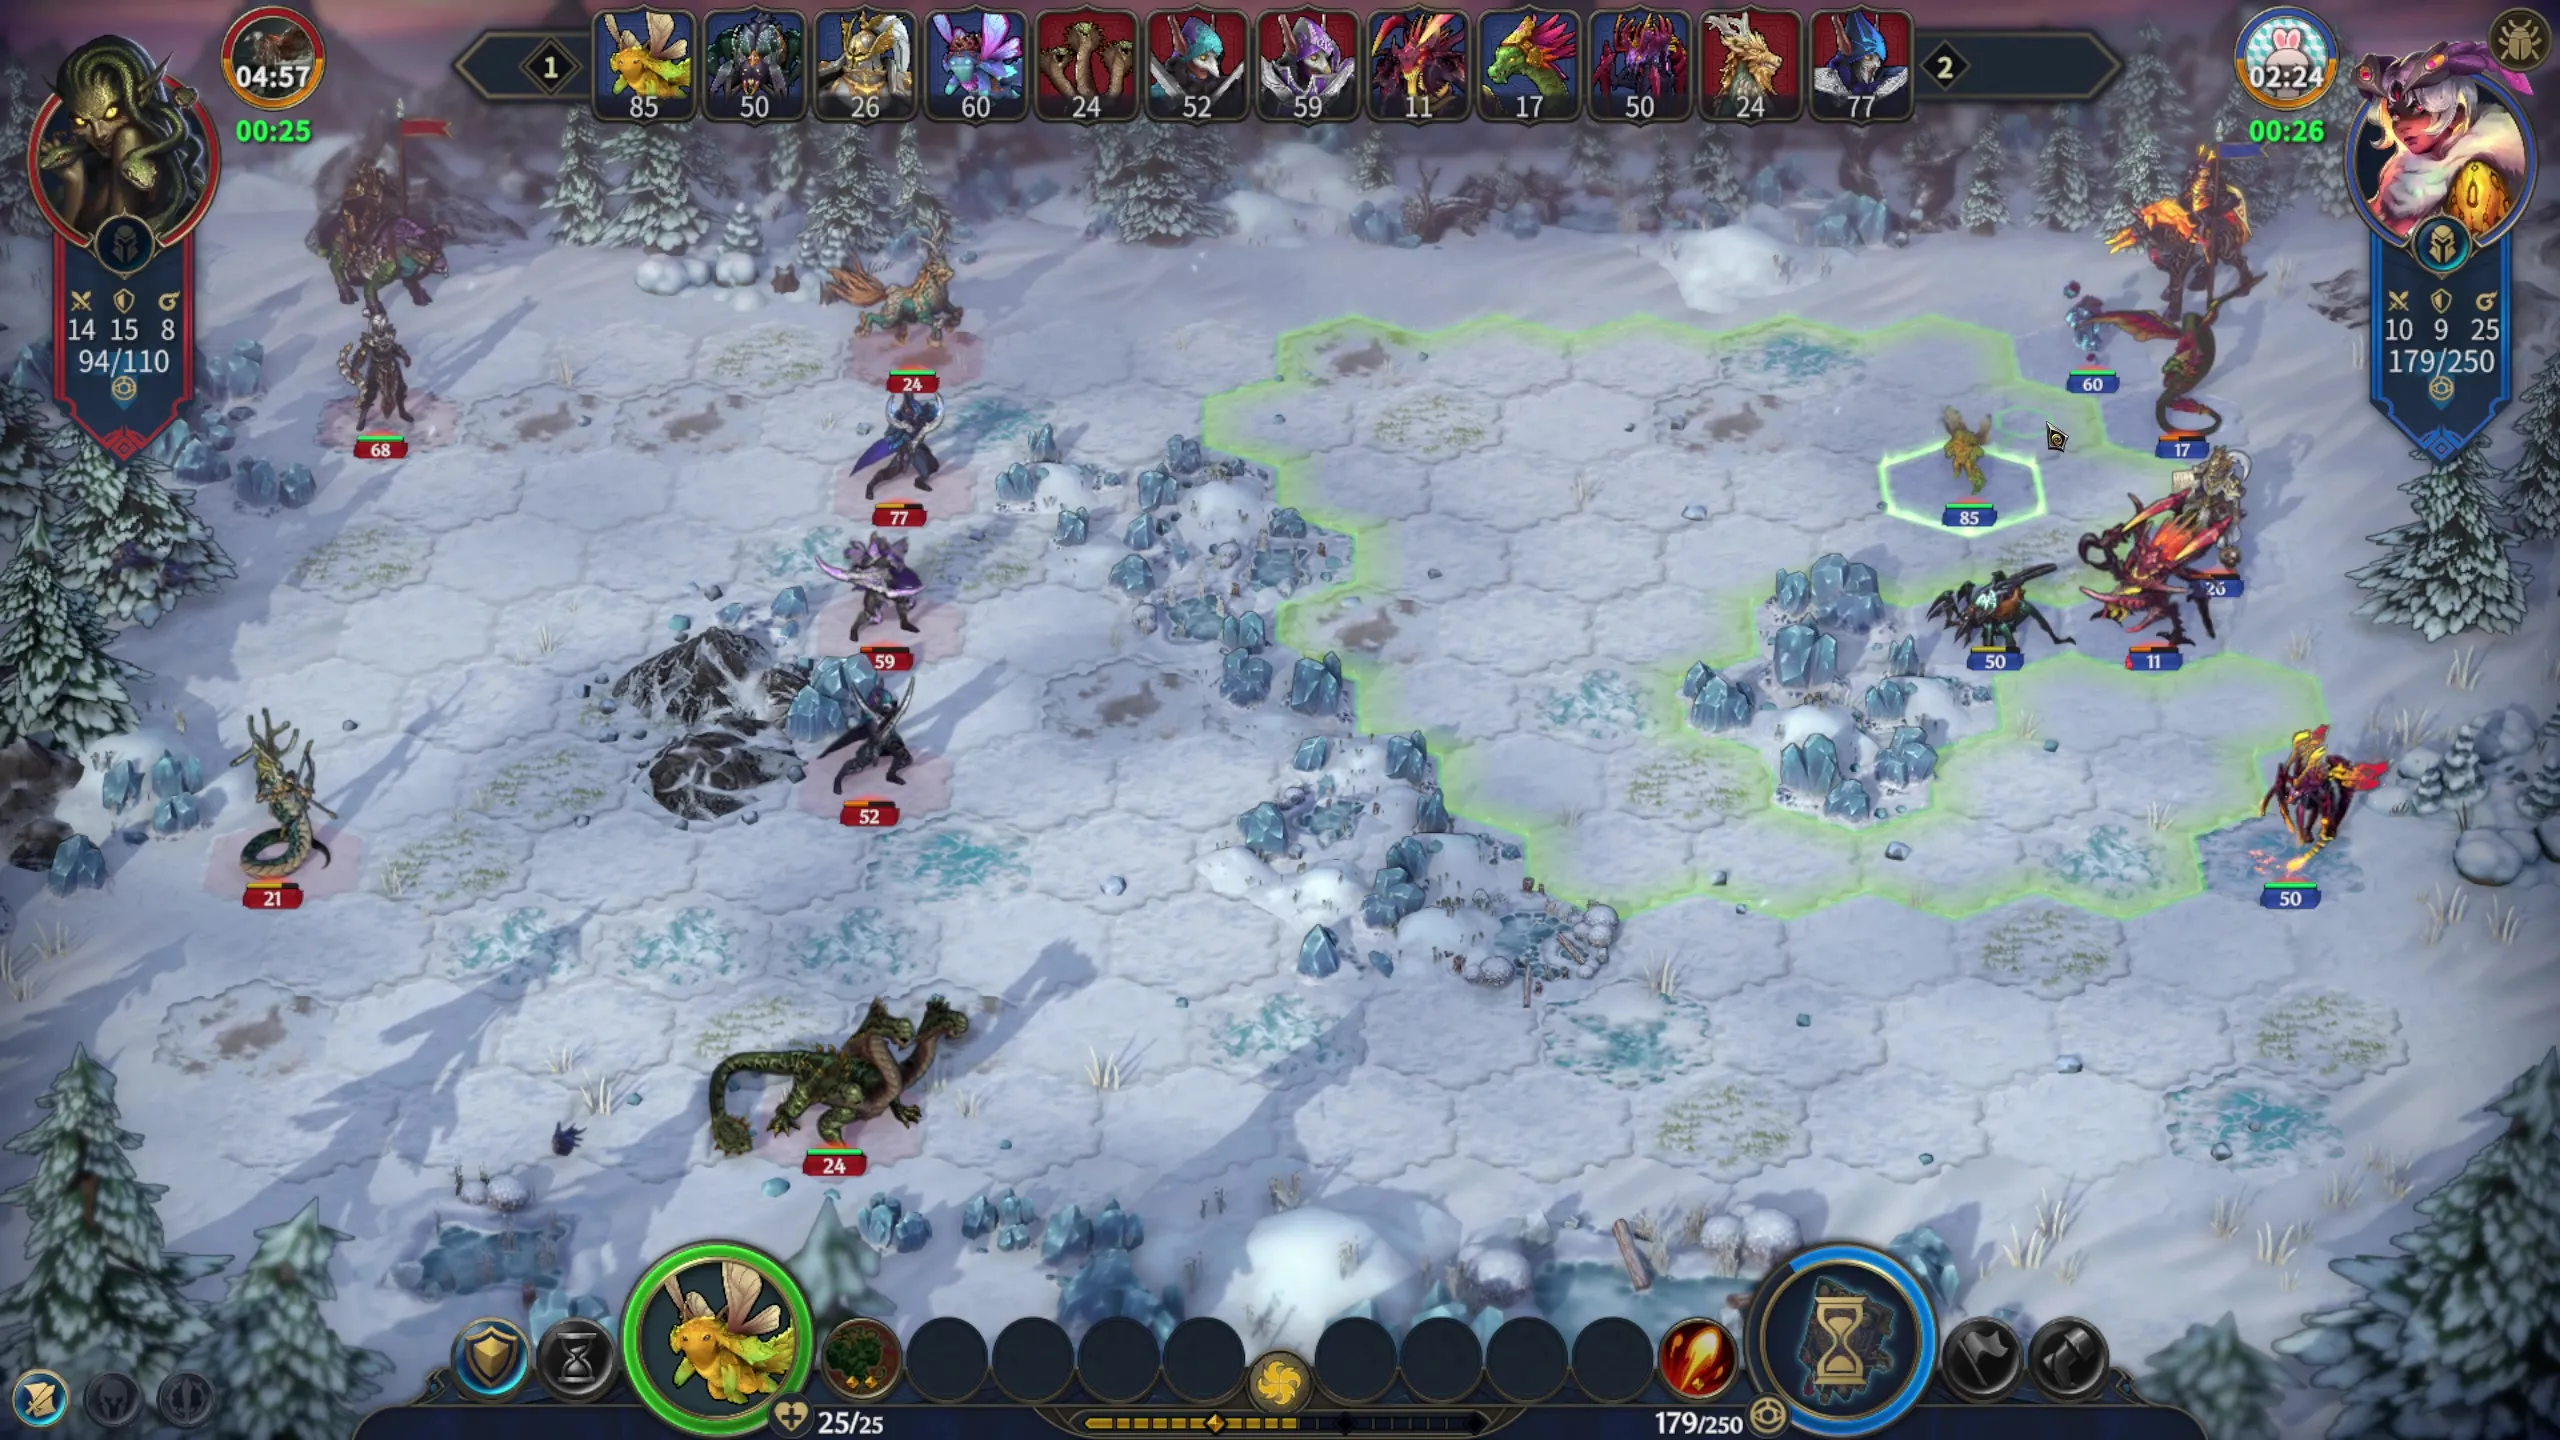
图2:点击可以放大看底部。旧方法用两个大圆确认布局,只输出15个预定圆形位置;大圆后来也成为输出对象,但不因此确认肖像身份。旧15项逐项框见本地审阅页。
输入是一张截图,输出是每个小圆的位置、空槽/亮色/灰暗/未知,以及可读数字。程序先在预期位置检查两个大圆的边缘,再检查各个小圆;没有足够边缘就不画框。第一轮只支持2560×1440,第二轮增加1920×1080。因此它利用了固定布局,但不是不看图片就固定画15个框;也还不支持任意裁切或UI缩放。
例如一张书页打开的战斗截图,底部仍能看到一个图标中央的2。程序先确认圆的位置,再读中心区域,最后保留“这个位置显示2”。它还不能据此说“某技能剩两回合”,因为图标身份和数字含义都没有得到确认。
2. 空槽是蓝的,灰暗按钮也会发亮
最直观的方法是看亮度:越亮,越像能操作的按钮。但灰暗图标仍可能有白色金属纹理,边上也可能带金色标记;空槽的蓝色底也容易让“看颜色”走错方向。
因此两种方法先做同一件事:只看圆内的区域,避开外圈和下方金色角标;如果像素几乎没有明暗变化,就先判为空槽。对剩余图标,再比较两种读法:
- 亮度法:内部较亮的那部分像素够亮,就记为亮色,否则灰暗。
- 颜色法:内部有足够比例的像素既明亮又有鲜明颜色,才记为亮色;比例很少记灰暗,中间区域留未知。
两者的框和判空步骤完全相同,只改变最后这一步。不训练新模型,也不读技能名称。这样比较回答的是“颜色能否减少亮暗误判”,不是哪个方法更懂游戏。
3. 圈都找到了,不代表技能都认出来了
全部34张已有截图都运行并展示,其中12张在预测前由助手逐项填写参考,仍待CTO审核。四张战斗首帧用来开发,四张同片段末帧用于固定回归,另外两张选秀画面检查误报,两张其他已曝光来源检查不同内容。这些都不是独立验收;相邻首末帧尤其不能算两个独立场景。 其余22张没有逐项参考,不记正确率。
十张战斗图共150个所选圆形位置,全部与参考位置匹配,没有漏框或多框;其中70个确实有图标,80个为空。匹配使用交集面积占并集面积的比例,至少达到一半,并且一个框只能匹配一次。两个选秀反例没有画出底栏框。
外观怎样?下表只看有图标的位置,把80个容易的空槽排除。另一个图标的亮暗参考本来就不确定,也不计正确。
| 数据组 | 可判定图标 | 亮度法相符 | 颜色法相符 |
|---|---|---|---|
| 4张开发首帧 | 27 | 19 | 26 |
| 4张相邻末帧 | 27 | 21 | 26 |
| 2张已曝光其他来源 | 15 | 15 | 15 |
| 合计 | 69 | 55 | 67 |
把空槽也算上,两方法分别是135/149和147/149。颜色法仍有两个不符:雪地片段首末帧左侧第一个图标,助手参考是亮色,程序却判为灰暗。它的暗绿、褐色没有达到当前颜色条件。我们没有为了提高分数修改参考;这两处也可能暴露“亮色”定义不够清楚,原图留给CTO复核。
亮度法则把一些灰暗图标的明亮纹理当成亮色。这说明内部颜色值得保留,但两种方法都没有验证“可以点击”。当前回合、技能可用性和图标外观是不同问题。
4. 把中心放大后,两处数字读到了
已有整屏OCR在八张战斗参考图的120个中心没有输出误数字,但这些中心本来都没有数字,所以它不能告诉我们数字能读对多少。
为补正例,另外固定三张图,对每张的全部15个自动框中心做局部OCR,共45块,不只挑有数字的地方。沿用本地PaddleOCR-VL-1.6模型,分别读原尺寸,以及加8像素边框后放大四倍的图。两次输出都完整、都是同一个一至三位纯数字,才留下候选;不一致、文字或杂乱输出就留未知。
这三张图里只有两个数字:左侧某图标的2和右侧某图标的1,均与参考相符;另外43个无数字中心没有最终误读。结果可用于继续做,但正例只有两个,不能称数字识别已经稳定。 两次处理还是同一个模型,也可能一致地犯错。这里没有把整屏与局部OCR的不同数据组做成精度排行榜。
审阅页保留原始读法,包括非数字。它显示数字属于哪个小圆,但不猜小圆的技能名称,也不推断剩余回合。
5. 换分辨率、打开暂停,结果怎样?
第二轮固定取已有的43张开发图,不按预测结果挑选:20张常规底栏、1张中央双剑的另一种布局、3张暂停、4张断线和15张非游戏。助手先看原像素,给20张底栏标了300个位置;场景反例沿用旧参考。所有标签仍待CTO审核,不作为独立验收或自动训练真值。
先只改尺寸处理。1080p与1440p都转换到同一检查尺寸,沿用原有圈边缘、判空和颜色阈值,最后把框映回各自原图。11张1080p操作栏的165个位置从全部拒识变成全部匹配;9张1440p的135个位置仍全部匹配。中央双剑的另一种布局没有被当成15圈底栏。旧34图的两种算法输出也逐字段一致,没有悄悄改写旧基线。
但能找到圈,不代表当时可以读取“当前操作栏”。暂停菜单会遮住其中一部分,断线后背景仍可能留着整条栏。因此第三种方法再检查同一帧OCR是否已经发现暂停、断线或非游戏;有明确阻断就不输出当前栏,原始可见圈仍保存给人查看。
| 反例 | 只检查圈时误放行 | 加场景检查后 |
|---|---|---|
| 暂停,3张 | 2 | 0 |
| 断线,4张 | 4 | 0 |
| 非游戏,15张 | 3 | 1 |
剩下的1张是Windows桌面。海滩草地的纹理恰好提供了很多边缘,让固定位置的圆检查通过,而OCR也没有认出明确的非游戏场景。这是检测器真正的误报,不能因为另外300个位置都找对就略过。 它促使我们进一步检查:这些边缘到底是不是圆?第7节会给出结果。
外观也比第一轮暴露了更多困难:176个有图标位置中,5个参考亮暗不清;剩余171个,157个相符、12个错误、2个拒识。124个空槽全部相符,另算。暗紫、暗红图案可能仍有颜色,但不满足程序的“足够亮且颜色鲜明”条件,因而被判灰暗;金色光晕也可能主要落在被排除的外圈。参考原样保留,不能把这些错误改成“都正确”。
这批图有些中央面板正在淡入,底栏却很清楚。所以“面板过渡”和“底栏可读”分别检查;这批素材没有充分验证底栏自身的半透明过渡。
再读全部300个算法圈中心,而不是只挑有数字的。三个真实数字都是1,均读对;297个无数字位置里,一个火焰图案在原尺寸与四倍放大下都被读成2。这是双读法一致仍然错的具体例子。300块两次OCR合计约72.9秒,不含模型载入;不是整段视频速度,也不是多位数字准确率。
打开第二轮逐帧审阅页,可切换旧版、尺寸适配版、加场景检查版;暂停时还可单独显示被挡住的原始圈。选qq-3774查看火焰误读,选非游戏图查看桌面假框。原图不复制,只增加三个小型审阅拼图和文字结果。
6. 为什么不把场景判断再严格一点?
面对桌面假框,一个自然想法是:先确定这是战场,再找底栏。我们用同一批43张图比较,没有重新训练,也没有改变原来的圈或参考标签。
已有场景算法会把当前图的颜色布局和边缘结构,分别与历史游戏画面比较。这里只排除与输入同录像、别名或已知同局的参考,不把待评分标签交给模型。在原有OCR阻断之外,再试两个规则:
- 必须有战场证据:文字或两种视觉比较支持战场,才保留底栏。
- 增加视觉反面否决:场景未知仍保留;只有颜色与边缘明确一致指向非游戏、暂停或过渡等情况时,才挡住。
“明确”沿用旧算法的距离和类别间隔要求,没有针对草地截图调整。
| 方法 | 保留的正常位置 / 300 | 22张反例误放行 |
|---|---|---|
| 原OCR阻断 | 300 | 1 |
| 必须有战场证据 | 90 | 0 |
| 增加视觉反面否决 | 285 | 1 |
第一种新规则确实挡住了桌面,却同时丢掉210个正常位置。第二种没有挡住桌面,还多丢了一张正常底栏。这两个方案都没有采用。
为什么?有一张生物面板正在淡入,整张图被判断为过渡,但底部按钮仍然清楚。拿整屏状态决定局部能不能读,会误伤这样的画面。另一方面,桌面草地的颜色最像加载画面,边缘却最像战场,两种比较没有达成一致,反面否决便没有生效。
打开三方法失败对照,选择sept07-green-faded-six,切换方法并勾选“显示被挡掉的原始框”,就能看到这一差别。最终43图视觉比较约25.1秒,含参考加载、不含已有OCR;这不是新视频的独立验收成绩。
7. 草地有边缘,但它们真的组成圆环吗?
原方法只问:“圆周附近有足够多的边缘吗?”一片草地也可能回答“有”。新的检查多问一步:“这些边缘的明暗变化,是否大致沿着圆的半径?”真实圆环的左侧边缘主要左右变化,上侧主要上下变化;草叶的方向则不一定配合这个圆。
程序用Sobel导数估计每处像素的明暗变化方向,再沿预期圆周取72个方向比较,允许圆边有少量厚度。我们固定参数,分别试“只检查两个大圆”和“再检查15个目标圆”。原框、颜色读法和OCR场景阻断都不变,没有重新训练,也没有看结果后调整阈值。
除了旧43图,还从23个旧录像标识中各取一张战场候选、一张其他场景候选,固定选择时间中位数,得到46张不同背景。助手在预测前检查原像素:29张有底栏、17张没有,参考仍待CTO。其中6张虽然来自“其他场景”检索桶,实际仍有底栏,所以没有照抄旧分类标签。这些来自已使用过的图库,不是新的独立验收。
46张中,只有19张尺寸受支持:11张底栏补了165个位置参考,另8张没有底栏。其余27张是640像素宽的缩略图或高度为1078的画面,本轮没有处理;其中18张明明有底栏,也必须列作覆盖缺口,而不是算成成功拒识。新46图没有输入同帧OCR,场景一律保留未知。
| 比较 | 正常位置保留 | 多出的框 | 没有当前底栏时误放行 |
|---|---|---|---|
| 旧43图,原方法 | 300/300 | 15 | 1/23 |
| 旧43图,加大圆方向 | 300/300 | 0 | 0/23 |
| 旧43图,加大小圆方向 | 300/300 | 0 | 0/23 |
| 新19图,三方法各自 | 165/165 | 0 | 0/8 |
这里的23张反例,比上一节22张多算了那张中央双剑的替代布局,并非新增一张反例。草地假框消失,而正常位置没有减少;进一步检查小圆没有额外收益。因此可选视频步骤先采用两个大圆的方向检查。
打开全部89张对照,可以来回切换原方法和新方法,也能看到全部不支持尺寸的图片。89图三路计算合计约2.59秒,含读图,不含先前OCR。结果只证明修复了一个已知纹理误报;这批补样主要增加游戏背景,没有足够的新桌面或底栏自身淡入画面,下一步仍要补这两类。
8. 底栏已经清楚,选帧程序却没留下它
静态截图能找到圈,还要再问:视频前面的选帧步骤,会不会把值得识别的图丢掉?我们从三份已用过的录像里,先目视寻找底栏出现过程,再固定取四个3秒窗口,每秒10张,共120张。先看原图填参考,再运行上节三种方法,参数不变。
其中三段是底栏从屏幕下方滑入,另一段是完整底栏上的内容变化。逐帧参考有64张完整、51张目标栏未出现、5张滑入未完整。三方法都在63/64张完整图上找到全部15个圈;51张未出现和5张未完整图都没有输出位置。 草地335.8秒已经能看全底栏,却仍在移动,固定位置检查只找到9个圈;下一张找全。我们保留这次遗漏,没有把它改成坏帧。
这些相邻图不是120个独立场景,参考仍待CTO,也未用于训练。这一轮只看15圈是否找齐,不增加框坐标准确率、外观或技能成绩。更重要的是,滑入并非半透明淡入,不能说淡入问题已经解决。
接着运行旧的五帧稳定模型和选帧器。它先看整张缩小图是否稳定,再从连续稳定画面中挑代表帧。三个滑入片段后来都选到了完整底栏,但内容切换片段的30张图,一张也没有留下。下面两张相隔0.1秒,沙漏遮盖消失、几个按钮变亮;我们希望采集到这种变化,而不是因为其他区域在动就一并跳过。

图3:350.1秒,底栏位置完整,沙漏仍盖在肖像上。点击可放大。

图4:350.2秒,外观已经改变。本轮只记录可见变化,没有据此推断是谁的回合、技能名称或是否可操作。
| 窗口 | 完整底栏帧 | 通过稳定判定 | 最终选中的完整帧 |
|---|---|---|---|
| 洞穴一滑入 | 10 | 8 | 1 |
| 洞穴二滑入 | 12 | 10 | 2 |
| 草地滑入 | 12 | 5 | 2 |
| 草地内容切换 | 30 | 0 | 0 |
为确认不是这次抽图方式造成的,又用生产代码的流式采样入口跑同四个窗口。它选出的总片段数是3、6、4、0,与原生源时间抽帧的3、5、4、0不完全相同,代表时刻也有差异;但最后一个窗口仍为0,漏采得到了复现。这里只测试短窗口,不声称整段录像再也找不到这个状态。
120图三路检测合计约6.03秒,不含解码;生产流式采样和选帧四窗共2.44秒,不含模型载入,两者处理内容不同。旧稳定模型载入时有scikit-learn小版本差异警告,仍用统一环境、未重训;这不是模型兼容性验收。
打开120帧邻帧审阅页可按左右键、拖进度条,查看原生裁片、整图上下文、三方法候选和是否入选。新数据只保留底栏裁片与小缩略图,不复制原录像或全尺寸帧库。
后续已做局部底栏补充采样对照:旧120帧用5张图覆盖5种外观;另取180帧,局部7张覆盖7/8,半秒抽样36张覆盖8/8。减少了同外观的额外图,但窗口开头的短状态仍漏,默认不换。300帧同页比较保留了这次失败。
9. 已经用来定位的大圆,为什么没有出现在结果里?
整帧检查发现,程序明明借两个大圆确定布局,却只输出旁边的小圆。资源分数也已被OCR读到,但没有连到对象。这不是先要训练一个更强的模型,而是先把已有像素依据变成完整些的输出。
新步骤仍要求两个大圆通过原有边缘和圆环方向检查,并服从暂停、断线等明确阻断。通过后,保留原小圆,再输出左右两个大圆的位置。然后只检查各自旁边的固定数字区域:至少两次完整覆盖该区域的原始OCR读数一致,才保存分数字符串;裁图不完整、读法冲突或证据不足,就留未知。这里复用旧OCR,没有重新识字或训练。
比如398.1秒这张底部裁片,左侧读到85/85,右侧读到169/169。输出分别连到左、右大圆,表示“这个位置看到这个字符串”,不把左侧自动当成我方,也不猜圆内角色或资源的游戏含义。左右两处均独立读本地像素,不从上方英雄面板借数字。
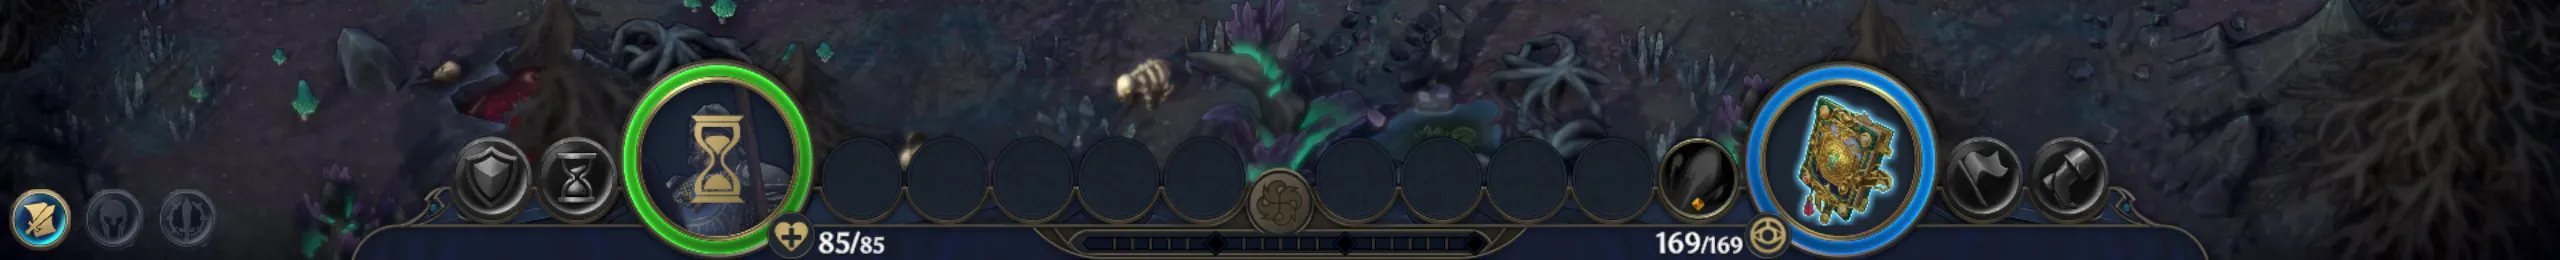
图5:398.1秒的原生底部像素,没有生成式放大。小按钮中央数字与大圆旁资源分数是两个任务;这次只补后者,不能抹掉前文的火焰假2。
先按固定序号从原65个时点取8张图,查看原像素填写参考,再运行新步骤。两张有目标底栏,六张是选择、布阵或过渡等非目标布局;布阵中央的双剑按钮不是这次两侧大圆的目标,拒绝它也不代表已识别那个按钮。另把已有385.2秒整帧参考单列,不重复算作新样本。
| 检查范围 | 观察到的结果 |
|---|---|
| 新8张参考,2张正例、6张非目标 | 4个大圆都匹配;4处分数及归属相符;6张非目标未误报双侧大圆 |
| 既有385.2秒整帧 | 底栏图形15/22→17/22,0额外框;两处分数及归属相符 |
| 全部65个原生时点 | 17张产生34个大圆和34处分数候选;原7项字段模块的输出全部不变 |
| 旧89张图 | 原小圆输出逐张不变;62张支持尺寸的布局存在性与旧参考相符,27张仍不支持 |
新8张按序号取自同一小段,正例只有两张,反例主要是战前过程,不能当作总体准确率。65张里的34处分数,只有上述新4处和旧2处有明确字面参考,其余不能计正确。旧89图也没有为大圆新增精确框或分数标签,不能用它补大圆定位准确率的分母。全部参考仍待CTO,未用于训练,也不是独立验收。
既有整帧中,已标文字的结构化输出从35项相符、2项未运行,变成37项相符;另2项未评价保持不变。原文39项、身体数量链与行动条结果均未改变。这一版仍没有输出三个左下角按钮和两个资源图标,因此接着做下一节的补全。圆内身份也仍未知。
这一遍65帧字段重放共19.12秒,包含解码、模型加载和既有字段读取,不含此前OCR;新增底栏步骤占其中3.76秒,不要再与19.12相加。另89旧图检查5.69秒。只新增8张必要的底部参考裁片,共5.78MiB,加少量文字结果,没有生成视频或保存整套OCR小块。
这一版154张新旧底栏对照和17项的整帧页保留当时结果。这是实际同帧字段处理器的可选分支,不是网页临时补框;默认视频CLI仍未启用。当前完整些的输出与已复查的审阅页见下一节。
10. 最后五个位置,不能只靠固定坐标画出来
图5左下角的三个小按钮,以及两处分数旁的图案,原先都没进入输出。它们的位置固定,不需要再训练一个全图检测器;但固定位置只是“去哪里找”,不能替代“那里确实有图形”。
这次继续沿用双侧大圆和场景检查,通过后再逐一检查五个位置的边缘及圆环方向,条件沿用旧小圆的门槛。像素支持不足就留未知。资源图标分别连到同侧大圆和分数记录;即使图标看得清、文字没读到,也只记录这个局部关系,不补数字或猜它代表什么。
先复看上一节8张底部裁片,再补看两张旧1080p面板图,填写五项的局部参考。四张正例共20个图形均匹配,六张没有目标的图片没有误框。既有385.2秒整帧单列,新增5项也匹配,使其底栏达到22/22,0额外框。所有样本都已曝光,参考待CTO;这不是陌生录像的准确率,也没有检验按钮身份。
实际仍跑全部65个原生时点和89张旧图,不只跑这几张参考。65帧中17张各输出五个新增候选,48张拒绝该布局;89张旧图中31张各输出五项,其余58张没有输出,其中27张尺寸仍不支持。未逐项标过的候选不能算正确。原17项、两处分数、行动卡身份与颜色等结果全部保留不变。
三张原图的五个目标又分别被人为遮住:15次检查都只保留其余四项,说明这一步确实依赖局部像素,而非无条件画框。这是受控检查,不能代替真实遮挡或半透明动画测试。
打开五项补全审阅页可以切图、叠加参考或原17项,查看拒识和资源链接;22项整帧对照仍保留其他未完成任务。桌面、窄屏、进度条、空筛选和整帧跳转已实测。
65帧完整字段重放189.92秒,其中整个底栏步骤4.98秒;另89图检查4.76秒,均不含已有OCR。完整字段流程这次包含后来接入的行动卡身份匹配,不能拿189.92与上一节19.12直接比较底栏性能。没有新增图片、模型或视频;续跑复用65份结果,不重新解码或改写。
11. 现在时间线上能看到什么?
已有视频时间线先接入位置和外观候选。大圆和资源分数的新输出目前在上一节的同帧对照页,不要把两个入口混为一谈。已有视频处理命令加--action-bar便会运行小圆步骤;不加参数时保持原行为。程序读取同一帧原图和OCR,保存少量JSON,网站只负责把框显示回原图,不在页面里重新推理。
实际复用了两段录像六个窗口的32帧,再加另一个短视频流程的2帧。这34帧与第一轮34图不是同一集合:29帧输出435个位置,5张选秀画面被挡住。435是候选数,不是正确数。 其中210个位置的场景尚未确认,右侧记录会明确写出来;其余225个也只是有战场场景候选支持。图上只放简短编号和问号,避免文字遮住图标。
这里的场景依据只取同帧OCR。页面总场景还可能显示另一条视觉候选,因此“页面判断像战场”不代表底栏这一步已有确认。
其中已有逐项参考的8张底栏,120个位置全部匹配;54个有图标位置的外观52相符、2错,另66空槽相符。那两处暗绿色图标错误仍在,接线没有改善算法。其余帧没有完整参考,不记正确率。
打开实际视频时间线,可在原有面板、行动条、身体和数量牌之外检查底栏位置。该链接只加载这次运行的8帧,不等待整个历史库。原始圈与场景依据可以从补充JSON查看。来源或算法变化使结果过期时,网站会隐藏这一批候选,而不是继续显示旧框。
新增的34份JSON共约0.48 MiB,没有复制原图或整份父模块结果。底栏步骤初次运行合计约1.27秒,不含上游解码和OCR;再次运行复用结果,没有重写旧文件。数字读法因为已有火焰假2,暂不接入;技能身份、回合归属和可用性也仍未知。
圆环方向检查也已接入:加--action-bar-radial会包含原底栏步骤,再保存一份小型检查结果。实际重跑上述34帧,435个候选全部保留,210个场景未知也仍是未知。新步骤只增加约65 KiB,初次运行约0.86秒,不含上游解码和OCR;重复运行不会重写原结果。网站只展示仍与原图、上游结果和当前算法对应的记录。
局部采样已进一步接成可选连续视频分支:三分钟实际读取留下23张底栏裁片,用时102.02秒。后续分区域邻帧审阅证实:按钮不变时,清楚的提示会被当成重复。新64帧都找到完整按钮布局,却没有留下14张可评分清楚提示中的任何一张。按钮位置测试通过,不等于提示采样成功。
另33张旧静态图的两种方法都没有误出框,但它们是选秀、布阵、大厅等画面,没有新增桌面或按钮淡入覆盖。下一步让提示独立供样,并补不同桌面、数字以及底栏自身淡入。已知草地误报修复了,外观误判和假数字仍在,默认流程仍不切换。
第一轮34图读图加颜色检测约1.09秒;45块中心两种OCR处理合计14.56秒,不含模型启动。第二轮数字处理的72.9秒来自更大的300块集合,两者不能直接当算法提速或变慢。继续复用统一Python环境、原图和本地模型,裁图只在内存。
可以从逐帧审阅页切换图片、参考框和预测框,比较两种方法并展开OCR原文。它需要本机服务运行。测试还检查了无像素证据不画框、空槽与未知不混用、角标不混作中央数字,以及冲突读法不强行合并;这些程序检查不能替代真实场景验收。
底栏的位置和外观已有可选通路;大圆、资源分数与五个小图形让既有同帧底栏位置补到22/22。圆环方向修复了一个已知假框,局部采样却仍漏短状态。下一步回到其他清楚场景的完整UI参考、身份和对象关系,不把一张图的位置补齐当作识别完成。尺寸、小按钮数字与可用性仍有缺口,默认入口不切换。
Comments