P101 · 场景内 UI 元素 · 实验记录与相关篇目
给定场景和布局,读取标题并关联图标及双语目录。本文新增五类真实连线示例;尚未验证全屏元素完整性或英雄数值提取。
选择英雄或技能时,名称通常印在图标旁边。我们不必只靠图像猜身份:先读名称,再根据同一张卡片的空间关系找到图标,最后查游戏名称表。它保存规范名称、别名和代码中的身份,下文也称“目录”,不是本书的阅读目录。
但三种判断要分开:文字读对了吗?标题与图标是否属于同一卡片?图标是否可见且确实对应这个身份?名称命中目录,只回答其中一部分。
flowchart LR
 A[Known scene and layout] --> B[Title text and icon slots]
 B --> C[Raw OCR and positions]
 C --> D[Bilingual catalog lookup by object type]
 D --> E[Suggested text-to-icon associations]
 E --> F[Independent identity and crop quality review]
图 1:连线表示空间关联,不能冒充图像分类器已经验证了身份。
本实验把场景与布局作为已给条件,因此测的是条件成立之后能否关联名称和图标。运行视频时,场景应先由 B021 的全图 OCR 或 B022 的视觉证据获得;全图 OCR 不依赖这些固定槽位。这里的历史离线结果没有把上游分类错误计入分母,不能当作从未知截图开始的端到端成功率。
1. 从一条名称看懂整个过程
例如 OCR 读到的原标题是 火 凤 凰。先把书写中的空格规范化,得到 火凤凰;再查游戏名称表中的既有别名,得到规范身份 烈焰凤凰 / Flaming Phoenix 与 creature:phoenix_upg。英文名来自查表,不是现场翻译。基础生物与升级生物是不同身份,不能因为外形类似就合并。
接下来才把名称指向附近的图标候选。这里的“槽位”是这个页面预先约定的图标区域,不是算法刚刚检测出的物体轮廓。标题清楚,不代表区域内的图像没有被挡住;下面的连线只是待核对的关联。
下列使用已保存的 186 帧关系预标注。每类每段录屏选择已解析槽位最多的一帧,这是有意挑选的展示,不是无偏准确率采样。每个框和连线来自保存的程序输出,下方列出文字与目录身份。后续场景审核发现其中两张处于翻页过渡:它们仍能产生看似完整的名称与连线,却不是可直接用于训练的干净图片。画廊现在明确显示这些条件和审核来源,保留失败示例而不把它们当作成功。
按标注网站的分类分组,更新于 2026-09-12。每张图分别注明用户确认、助手检查或算法候选;旧草稿不再用于分组。青框、橙框和连线仍是历史 OCR 与布局关联输出,不是已验证的物体框。点击图片放大。
选择英雄 · HERO_SELECTION 2 张示例
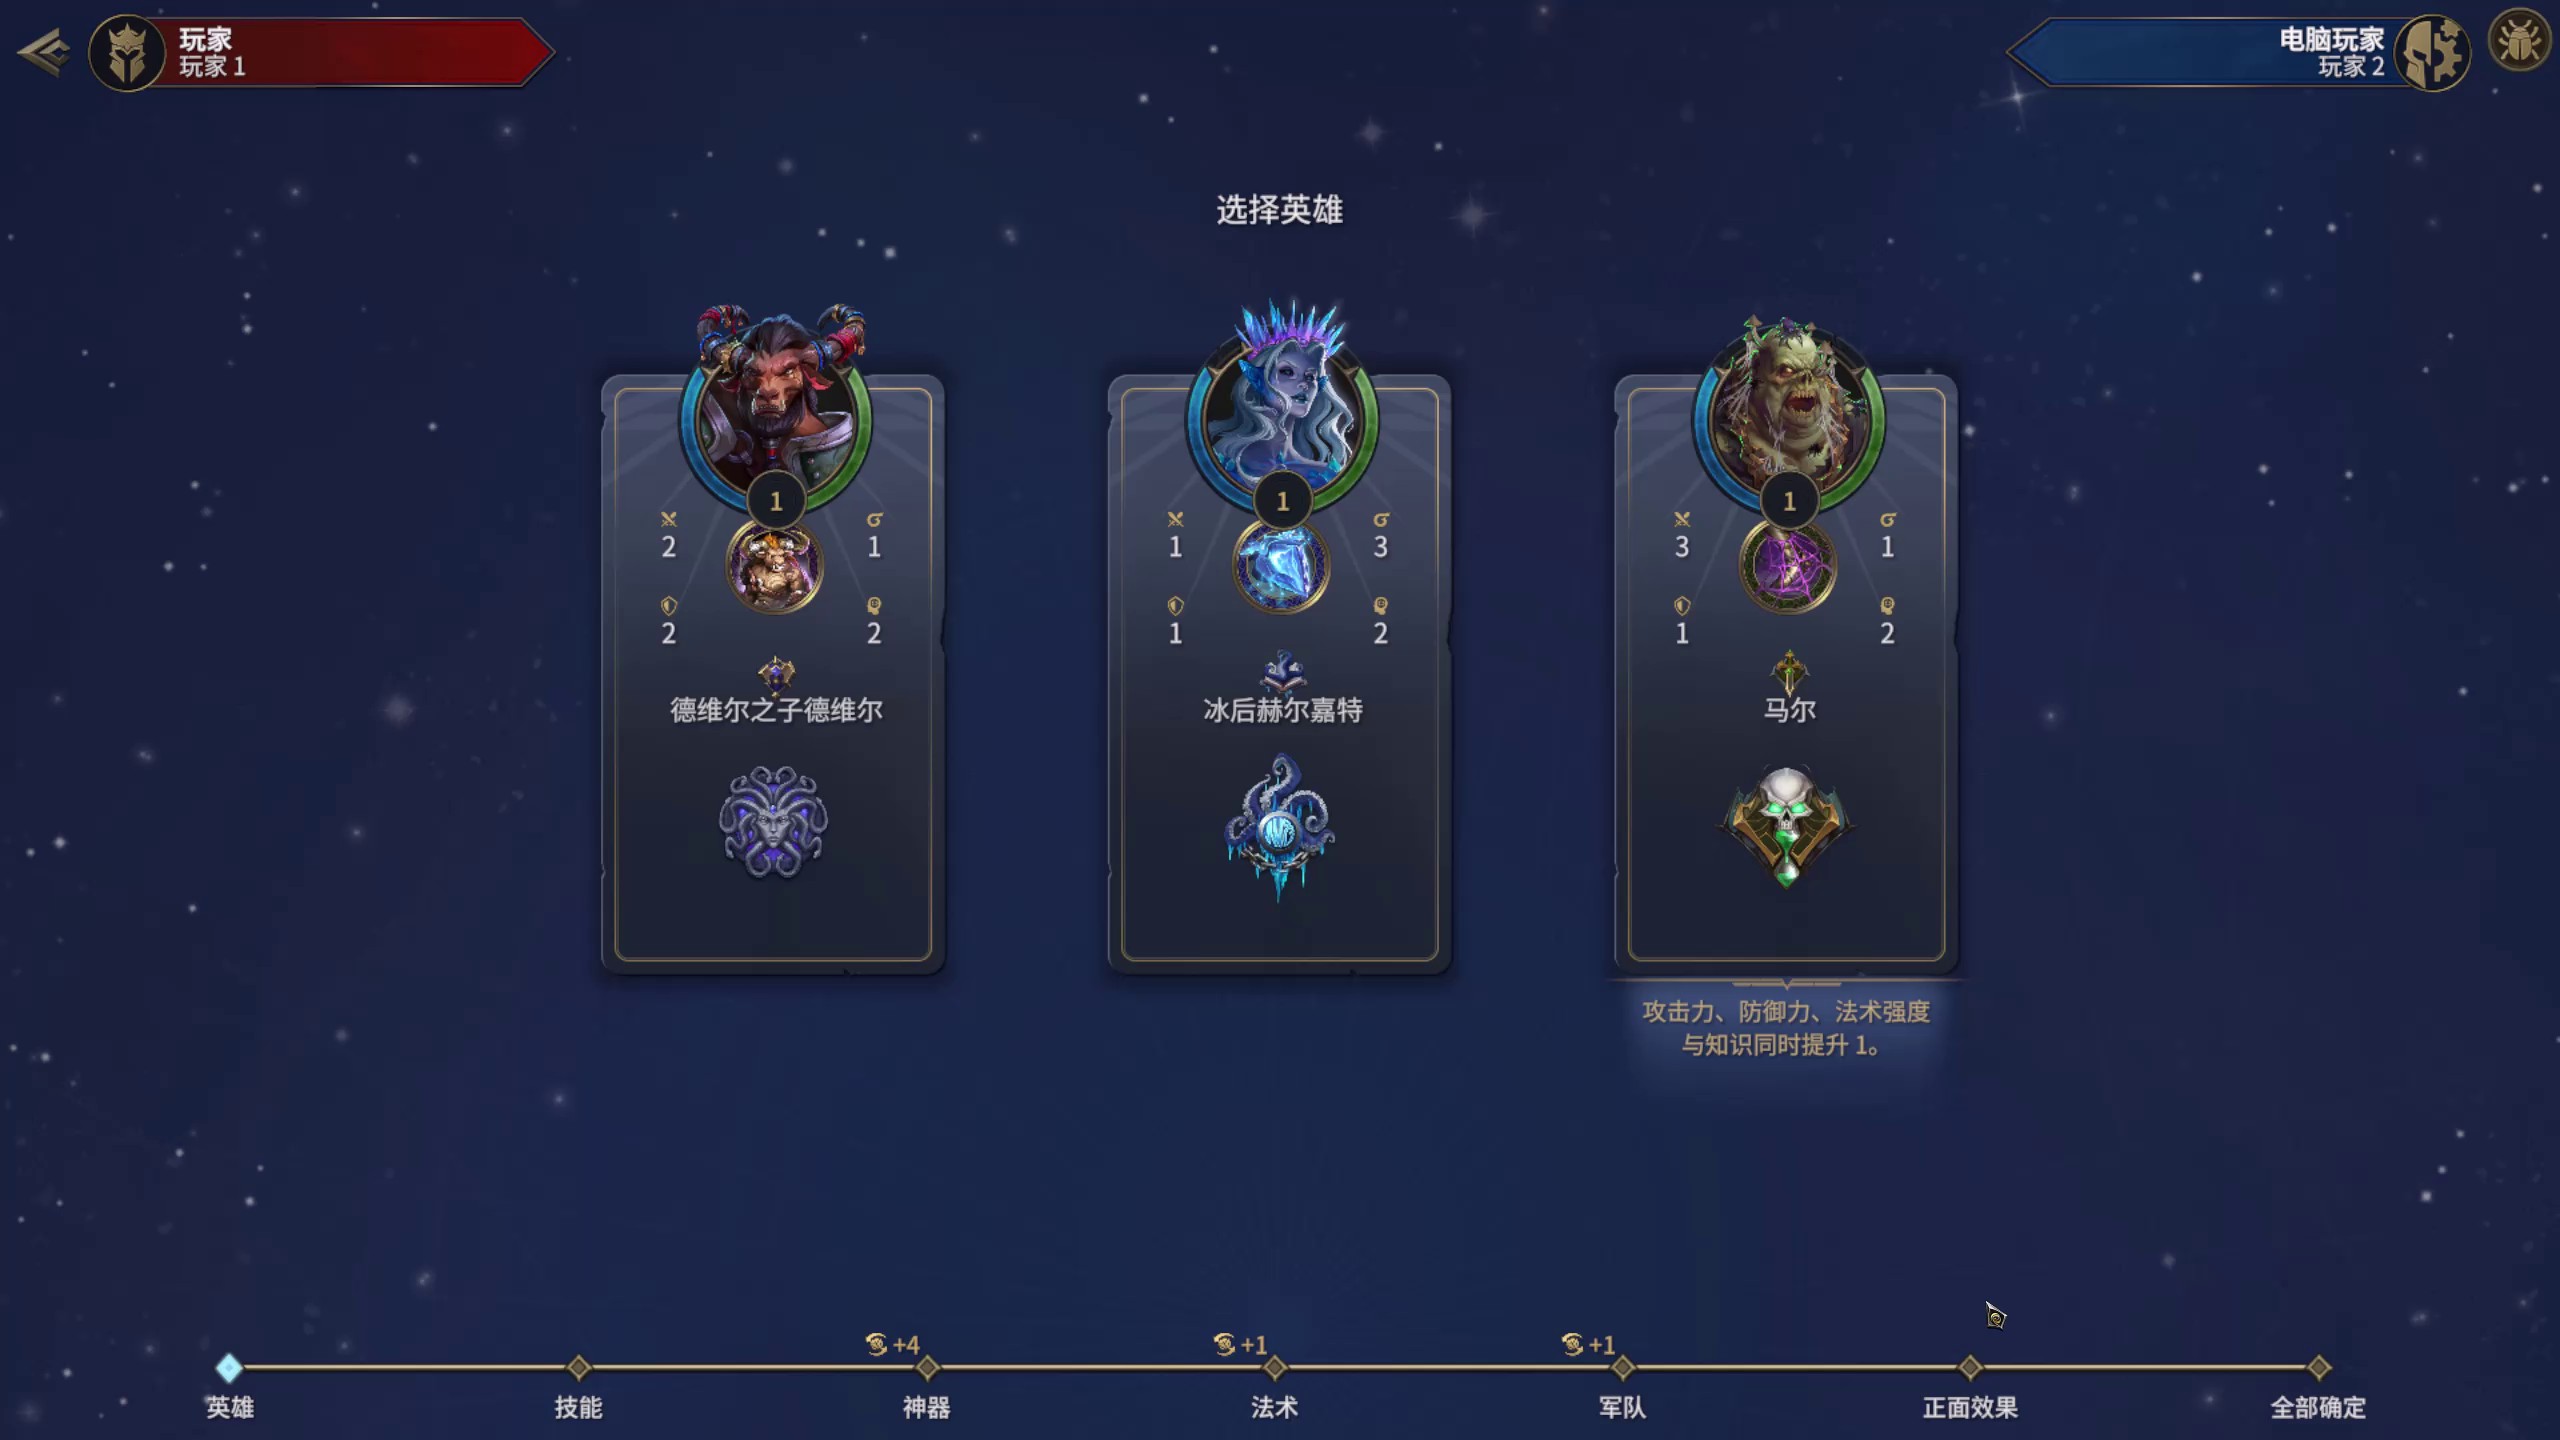
- hero-1:德维尔之子德维尔 → 德维尔,德维尔之子 / Devir, son of Devir (hero:dungeon_hero_6)
- hero-2:冰后赫尔嘉特 → 冰后赫尔嘉特 / Icequeen Hel'Ghat (hero:unfrozen_hero_11)
- hero-3:马尔 → 马尔 / Marl (hero:necro_hero_7)
查看历史预测与旧标签
历史关联程序采用的场景:选择英雄。图标身份与候选框可用性未独立验证;当前分类不会重写这些输出。
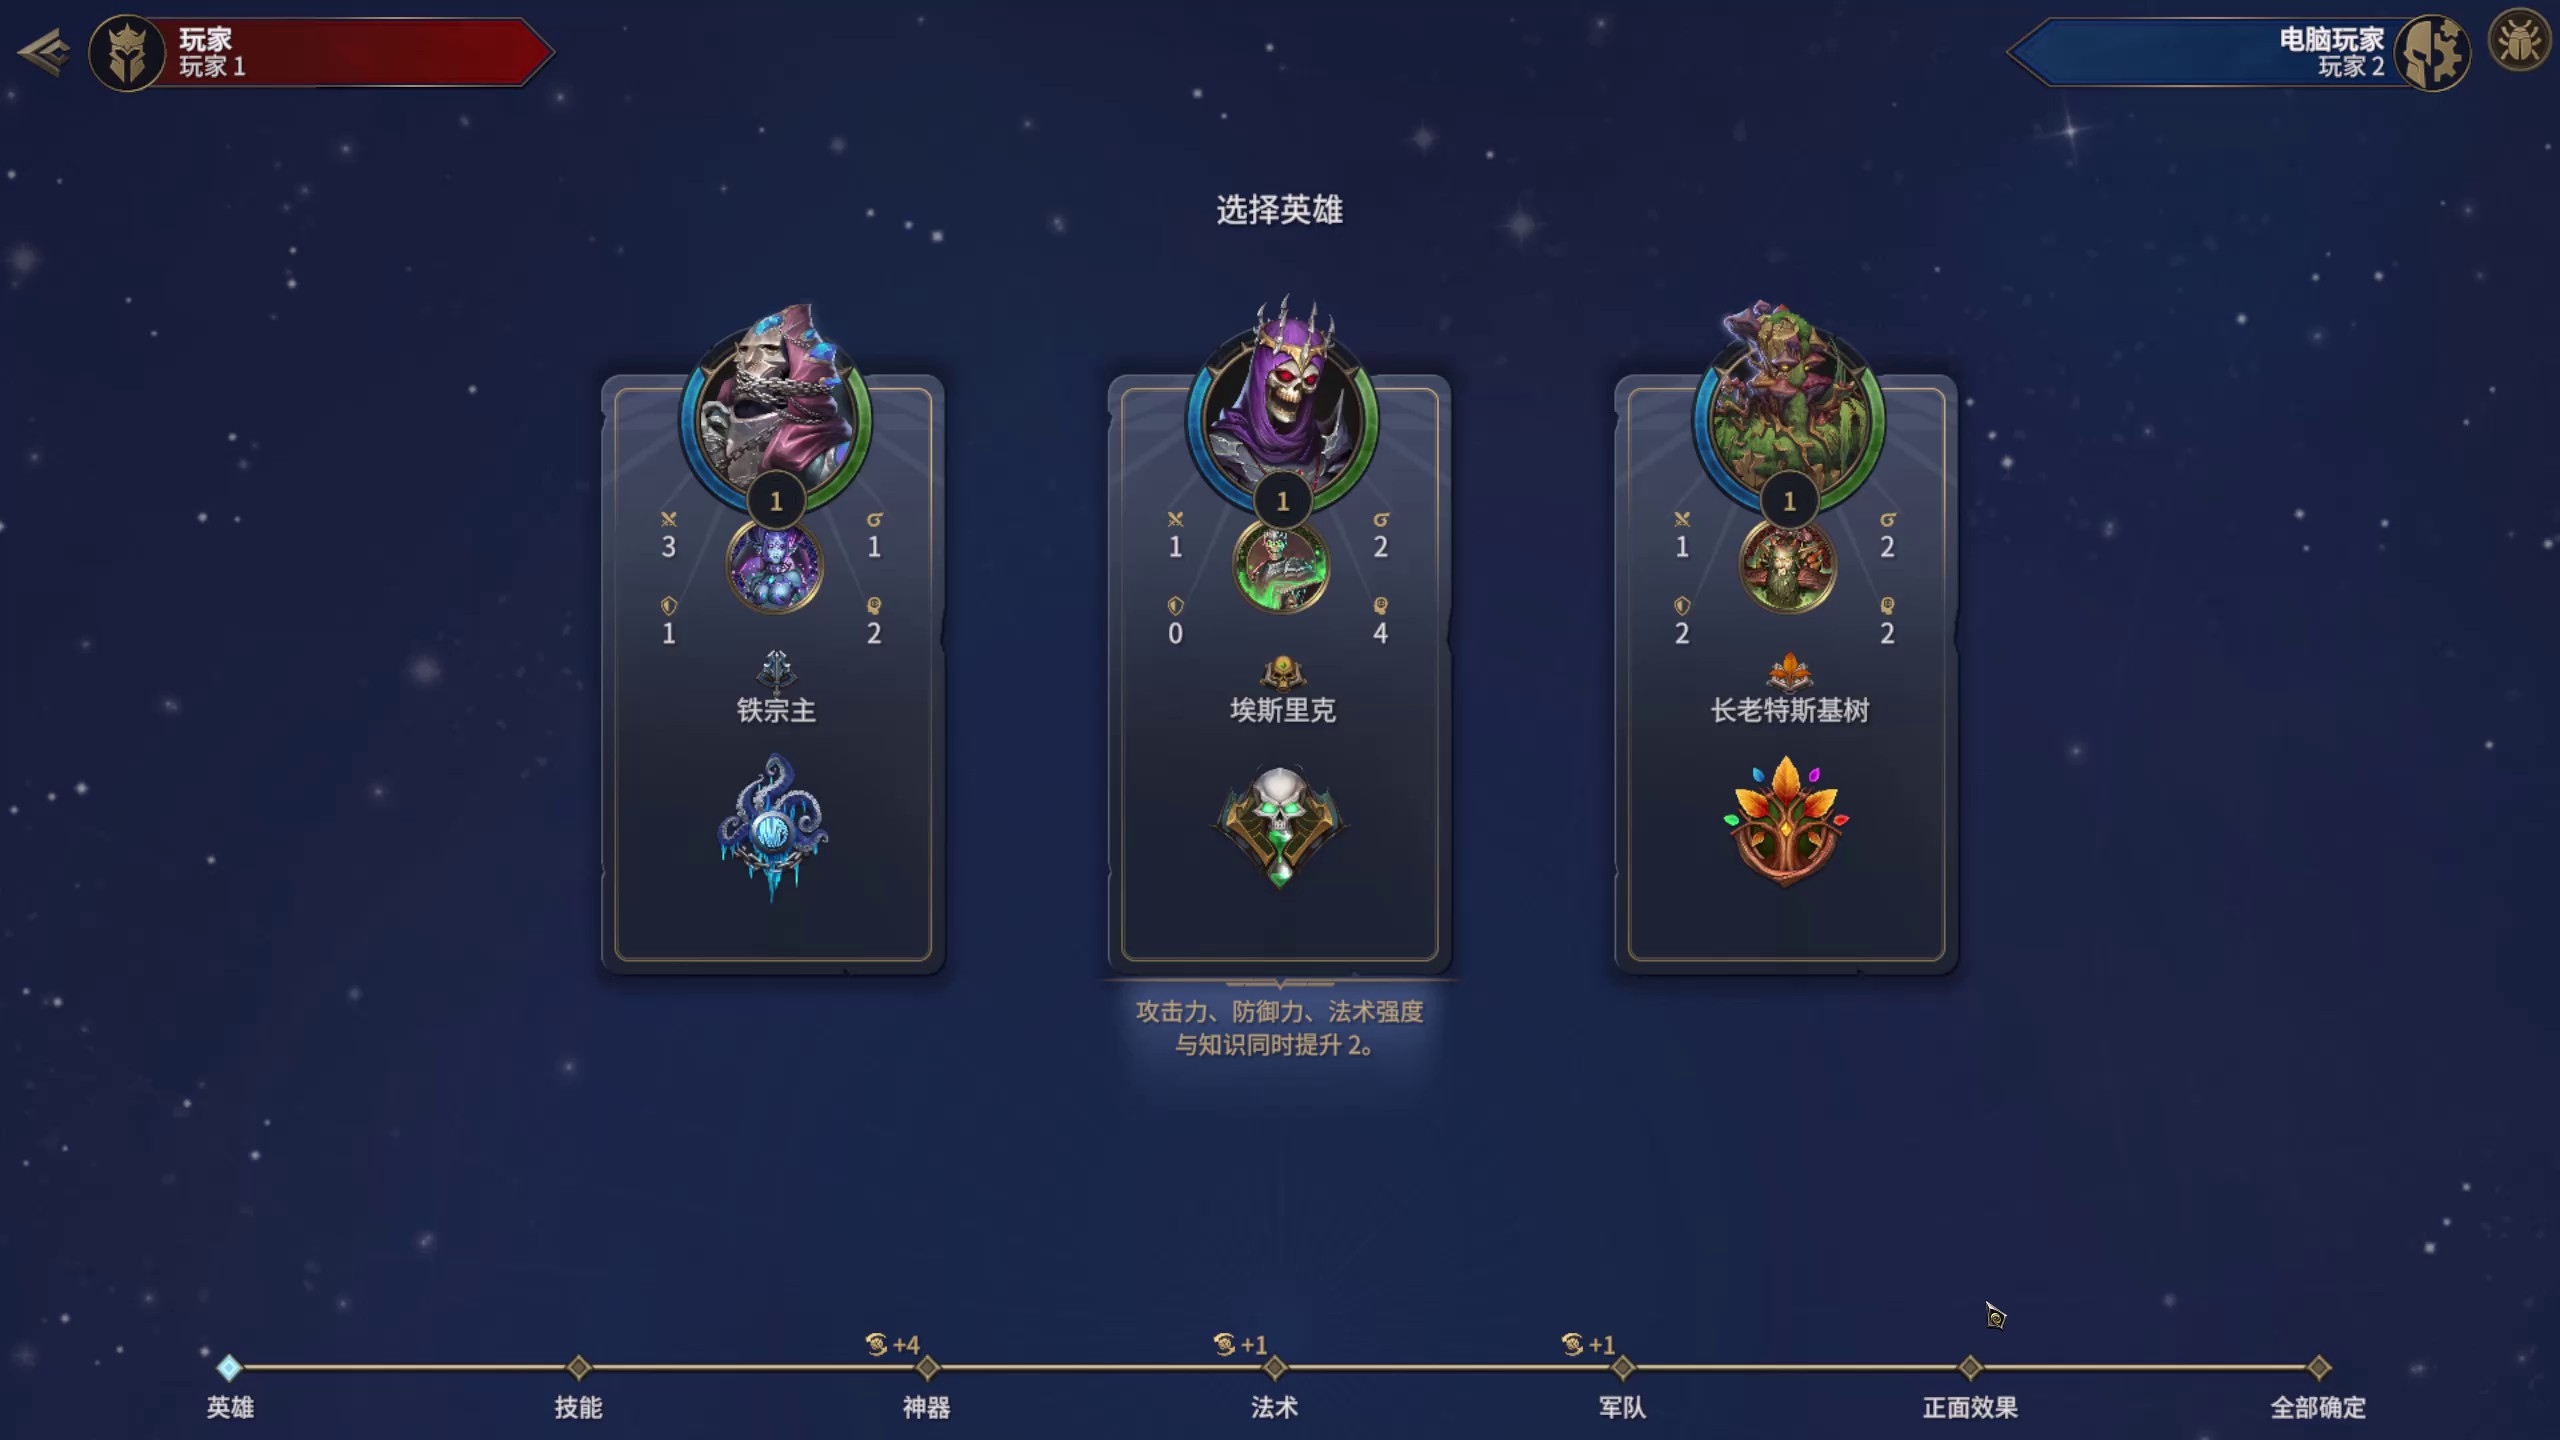
- hero-1:铁宗主 → 铁大师 / The Iron Master (hero:unfrozen_hero_6)
- hero-2:埃斯里克 → 埃斯里克 / Ethric (hero:necro_hero_12)
- hero-3:长老特斯基树 → 茨基什长老 / Elder Tss'kish (hero:nature_hero_11)
查看历史预测与旧标签
历史关联程序采用的场景:选择英雄。图标身份与候选框可用性未独立验证;当前分类不会重写这些输出。
选择主技能 · MAIN_SKILL_SELECTION 2 张示例
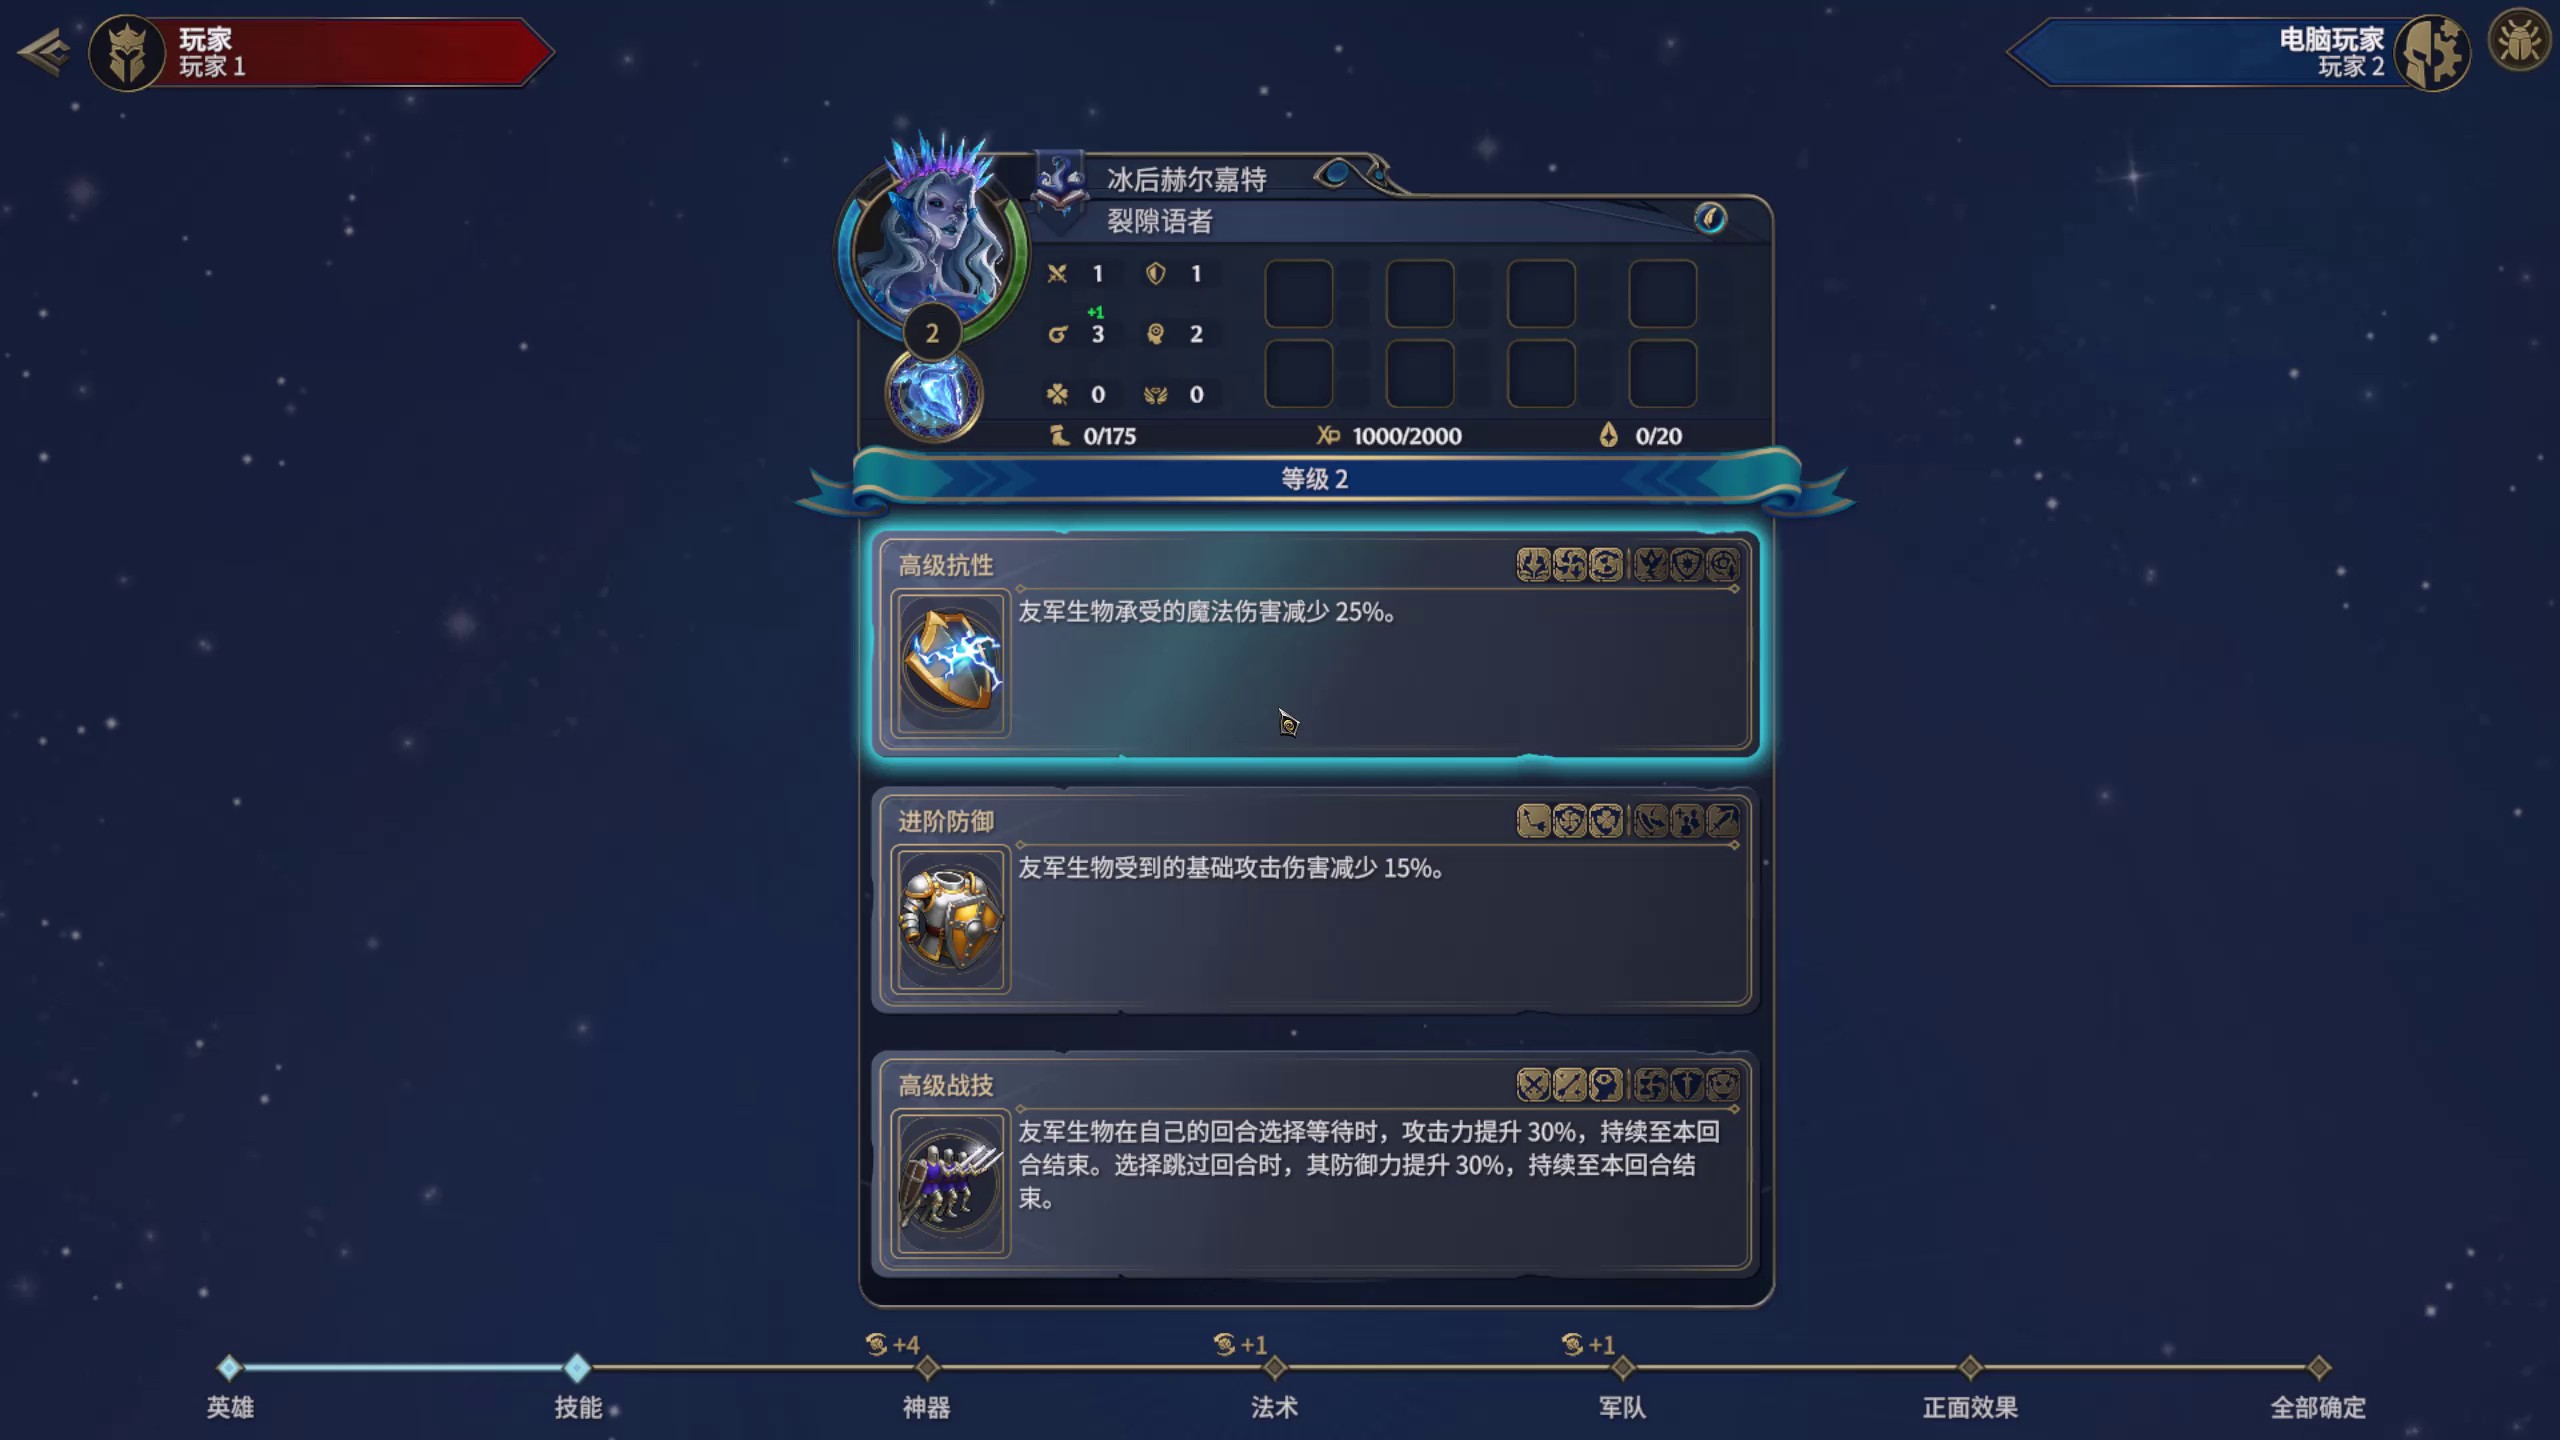
- main-skill-1:高级抗性 → 抵抗术 / Resistance (skill:Resistance)
- main-skill-2:进阶防御 → 防御术 / Defense (skill:Defense)
- main-skill-3:高级战技 → 战斗技巧 / Battlecraft (skill:Battlecraft)
查看历史预测与旧标签
历史关联程序采用的场景:选择主技能。图标身份与候选框可用性未独立验证;当前分类不会重写这些输出。
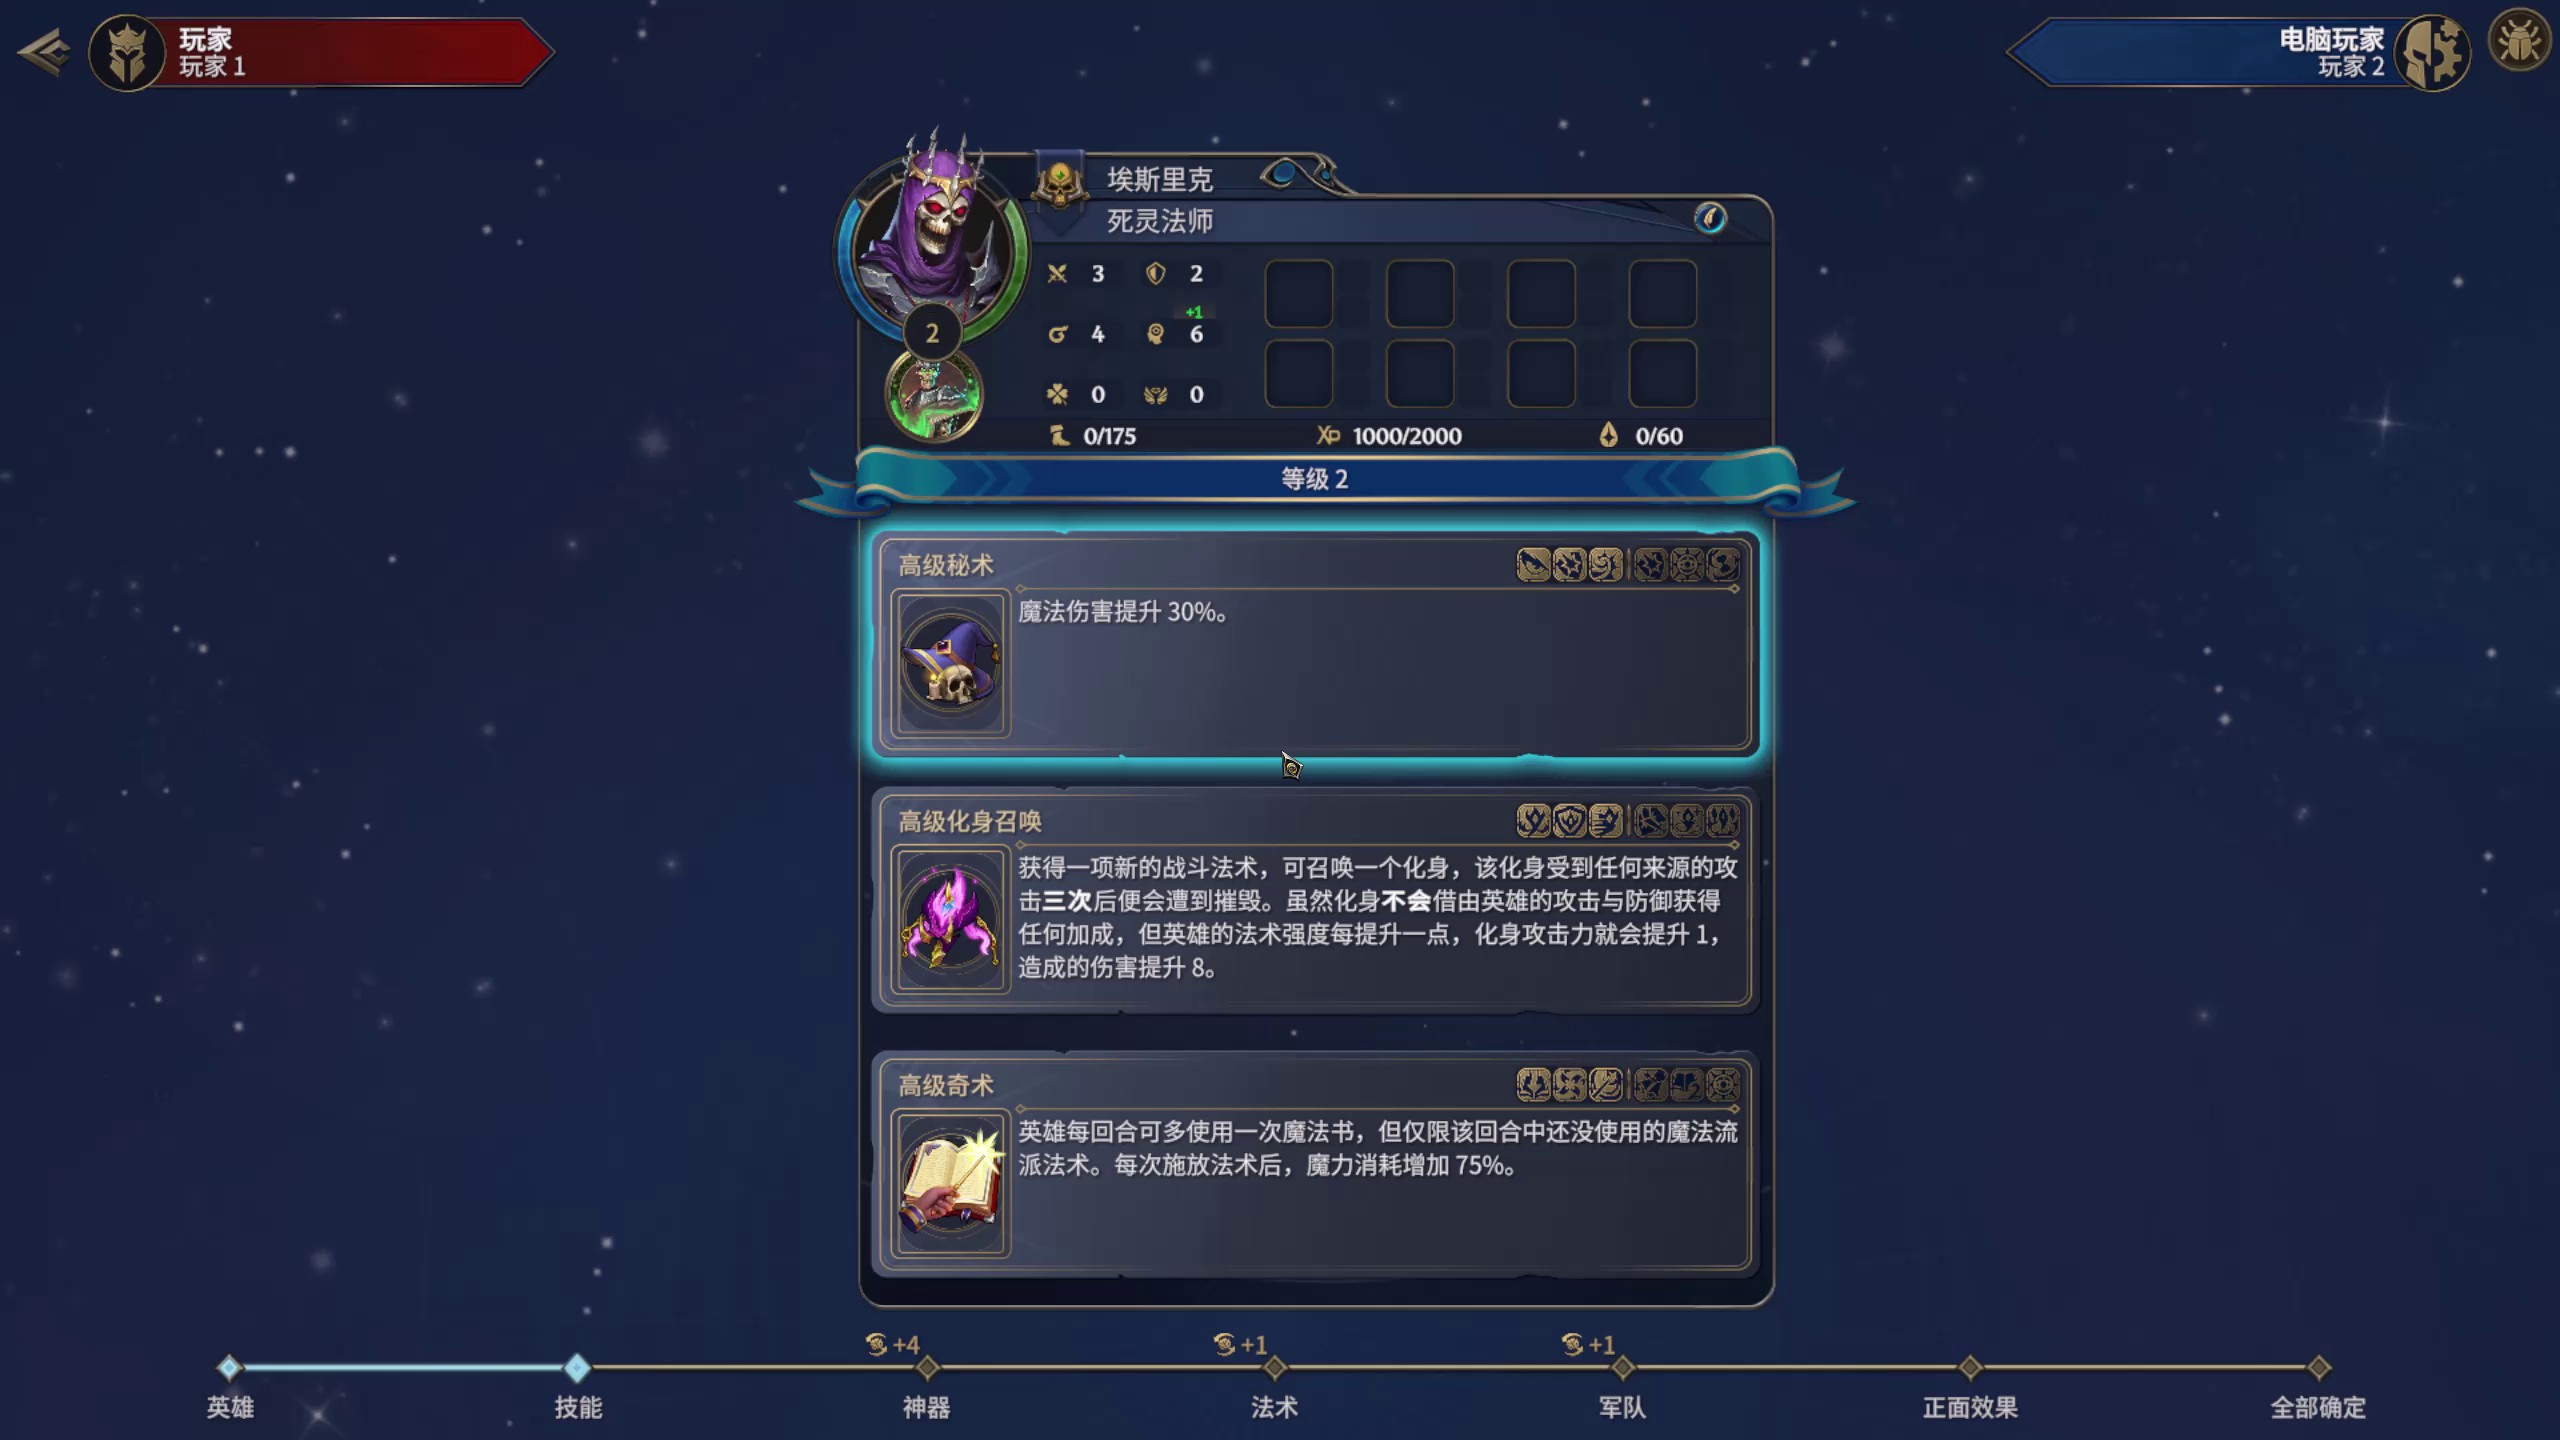
- main-skill-1:高级秘术 → 巫术 / Sorcery (skill:Sorcery)
- main-skill-2:高级化身召唤 → 召唤化身 / Summon Avatar (skill:SummonAvatar)
- main-skill-3:高级奇术 → 奇术 / Thaumaturgy (skill:Thaumaturgy)
查看历史预测与旧标签
历史关联程序采用的场景:选择主技能。图标身份与候选框可用性未独立验证;当前分类不会重写这些输出。
选择子技能 · SUBSKILL_SELECTION 2 张示例
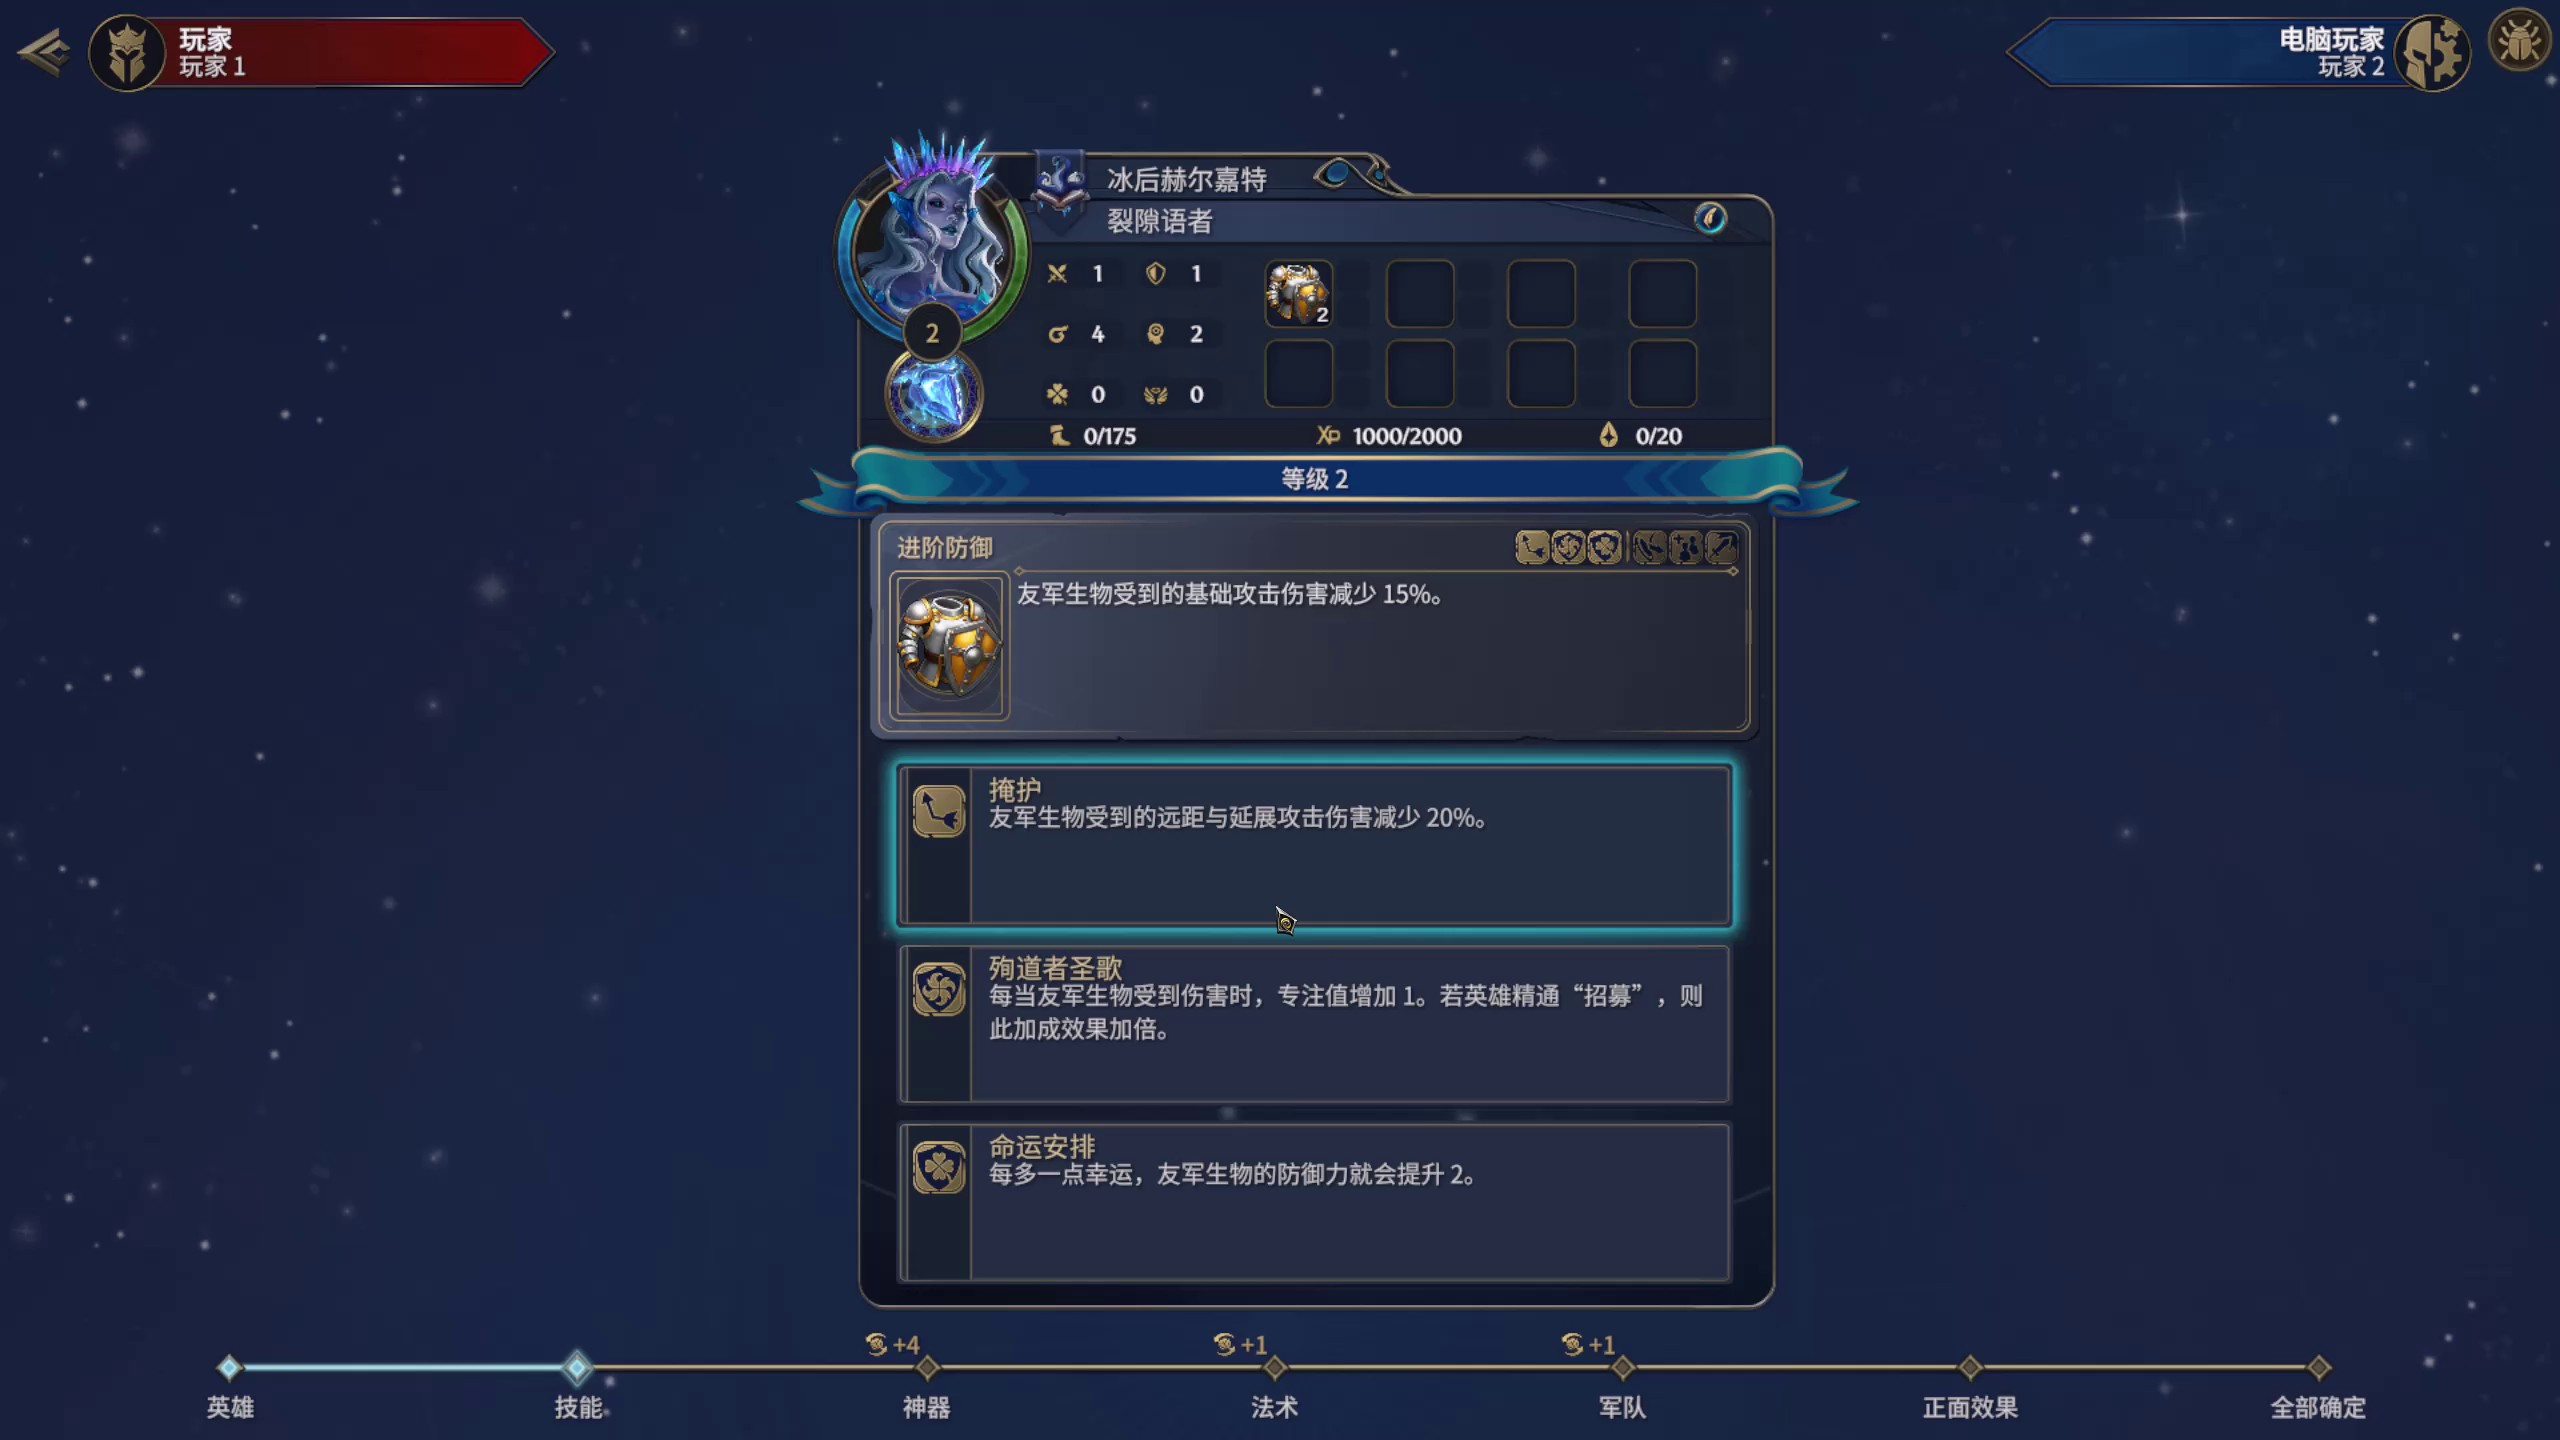
- parent-skill:进阶防御 → 防御术 / Defense (skill:Defense)
- subskill-1:掩护 → 掩护 / Cover (subskill:Cover)
- subskill-2:殉道者圣歌 → 烈士赞歌 / Hymn to the Martyrs (subskill:HymntotheMartyrs)
- subskill-3:命运安排 → 命运垂青 / As Luck Would Have It (subskill:AsLuckWouldHaveIt)
查看历史预测与旧标签
历史关联程序采用的场景:选择子技能。图标身份与候选框可用性未独立验证;当前分类不会重写这些输出。
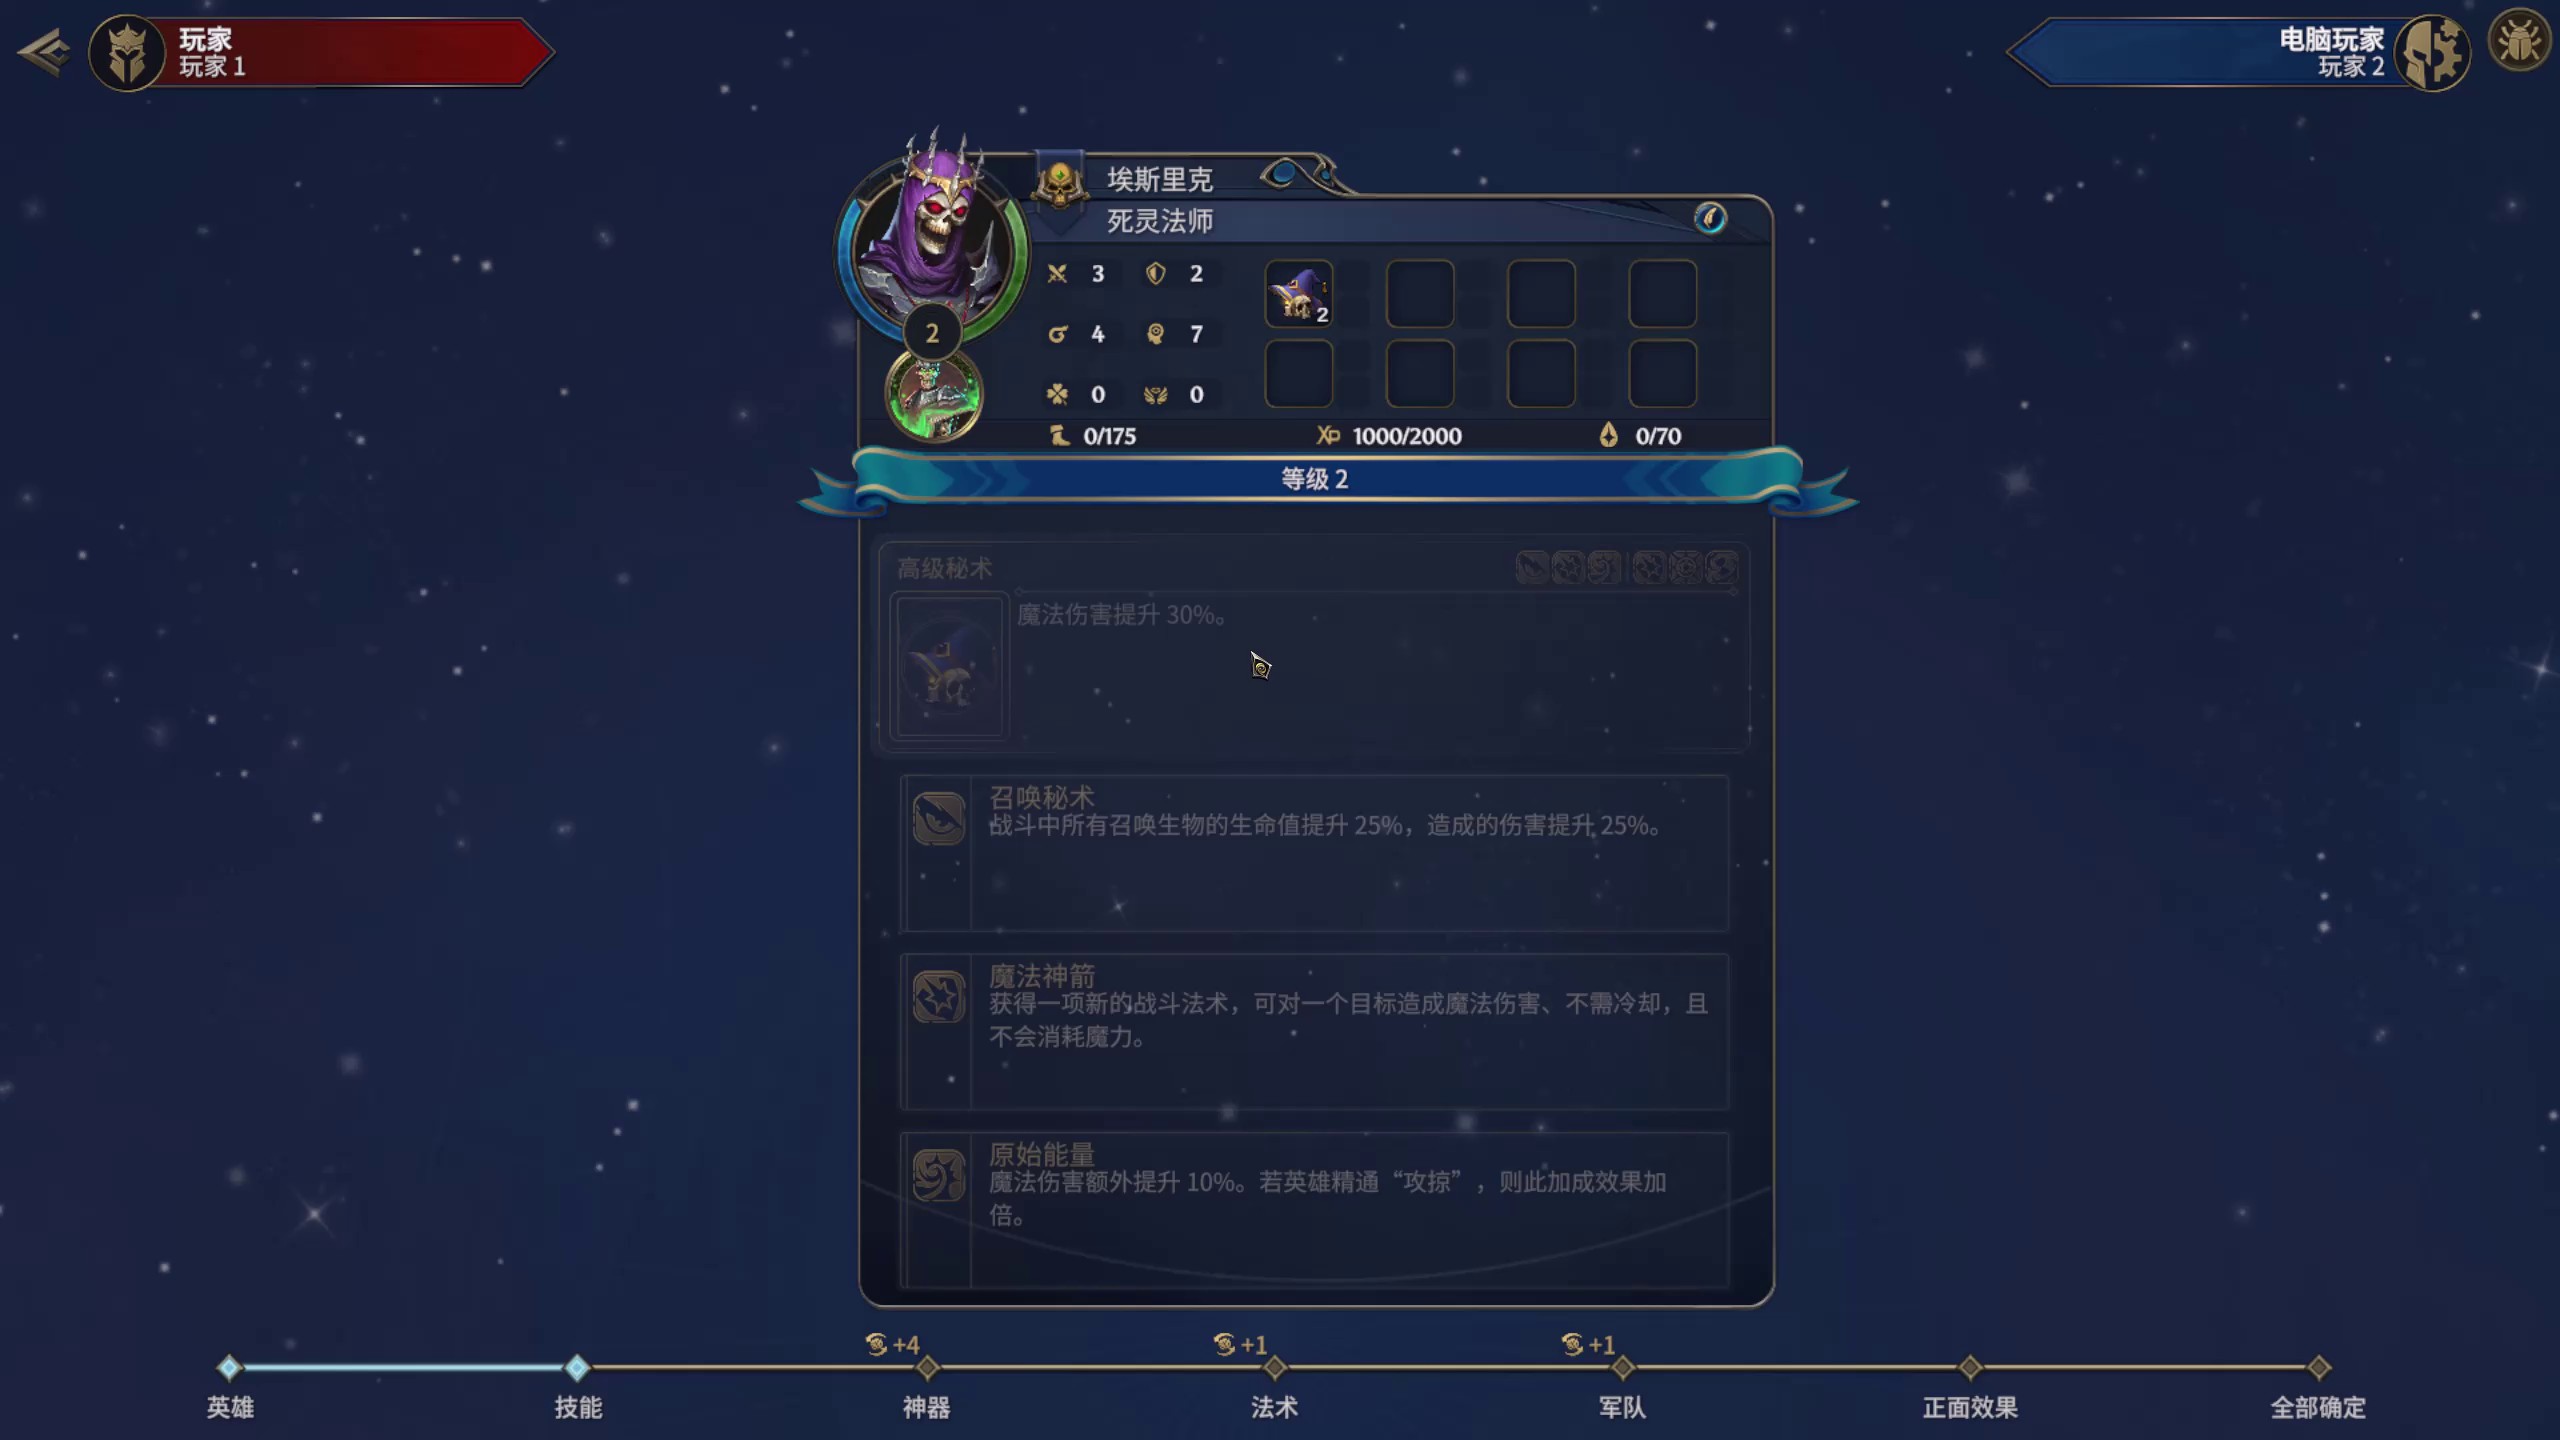
这张图标有“过渡 / 翻页”。以下框和连线仅供检查历史程序行为,不能直接当作可用训练标注。
- parent-skill:高级秘术 → 巫术 / Sorcery (skill:Sorcery)
- subskill-1:召唤秘术 → 召唤巫术 / Summoning Sorcery (subskill:SummoningSorcery)
- subskill-2:魔法神箭 → 魔法神箭 / Magic Arrow (subskill:MagicArrow)
- subskill-3:原始能量 → 原始能量 / Raw Energy (subskill:RawEnergy)
查看历史预测与旧标签
历史关联程序采用的场景:选择子技能。图标身份与候选框可用性未独立验证;当前分类不会重写这些输出。
选择宝物 · ARTIFACT_SELECTION 2 张示例
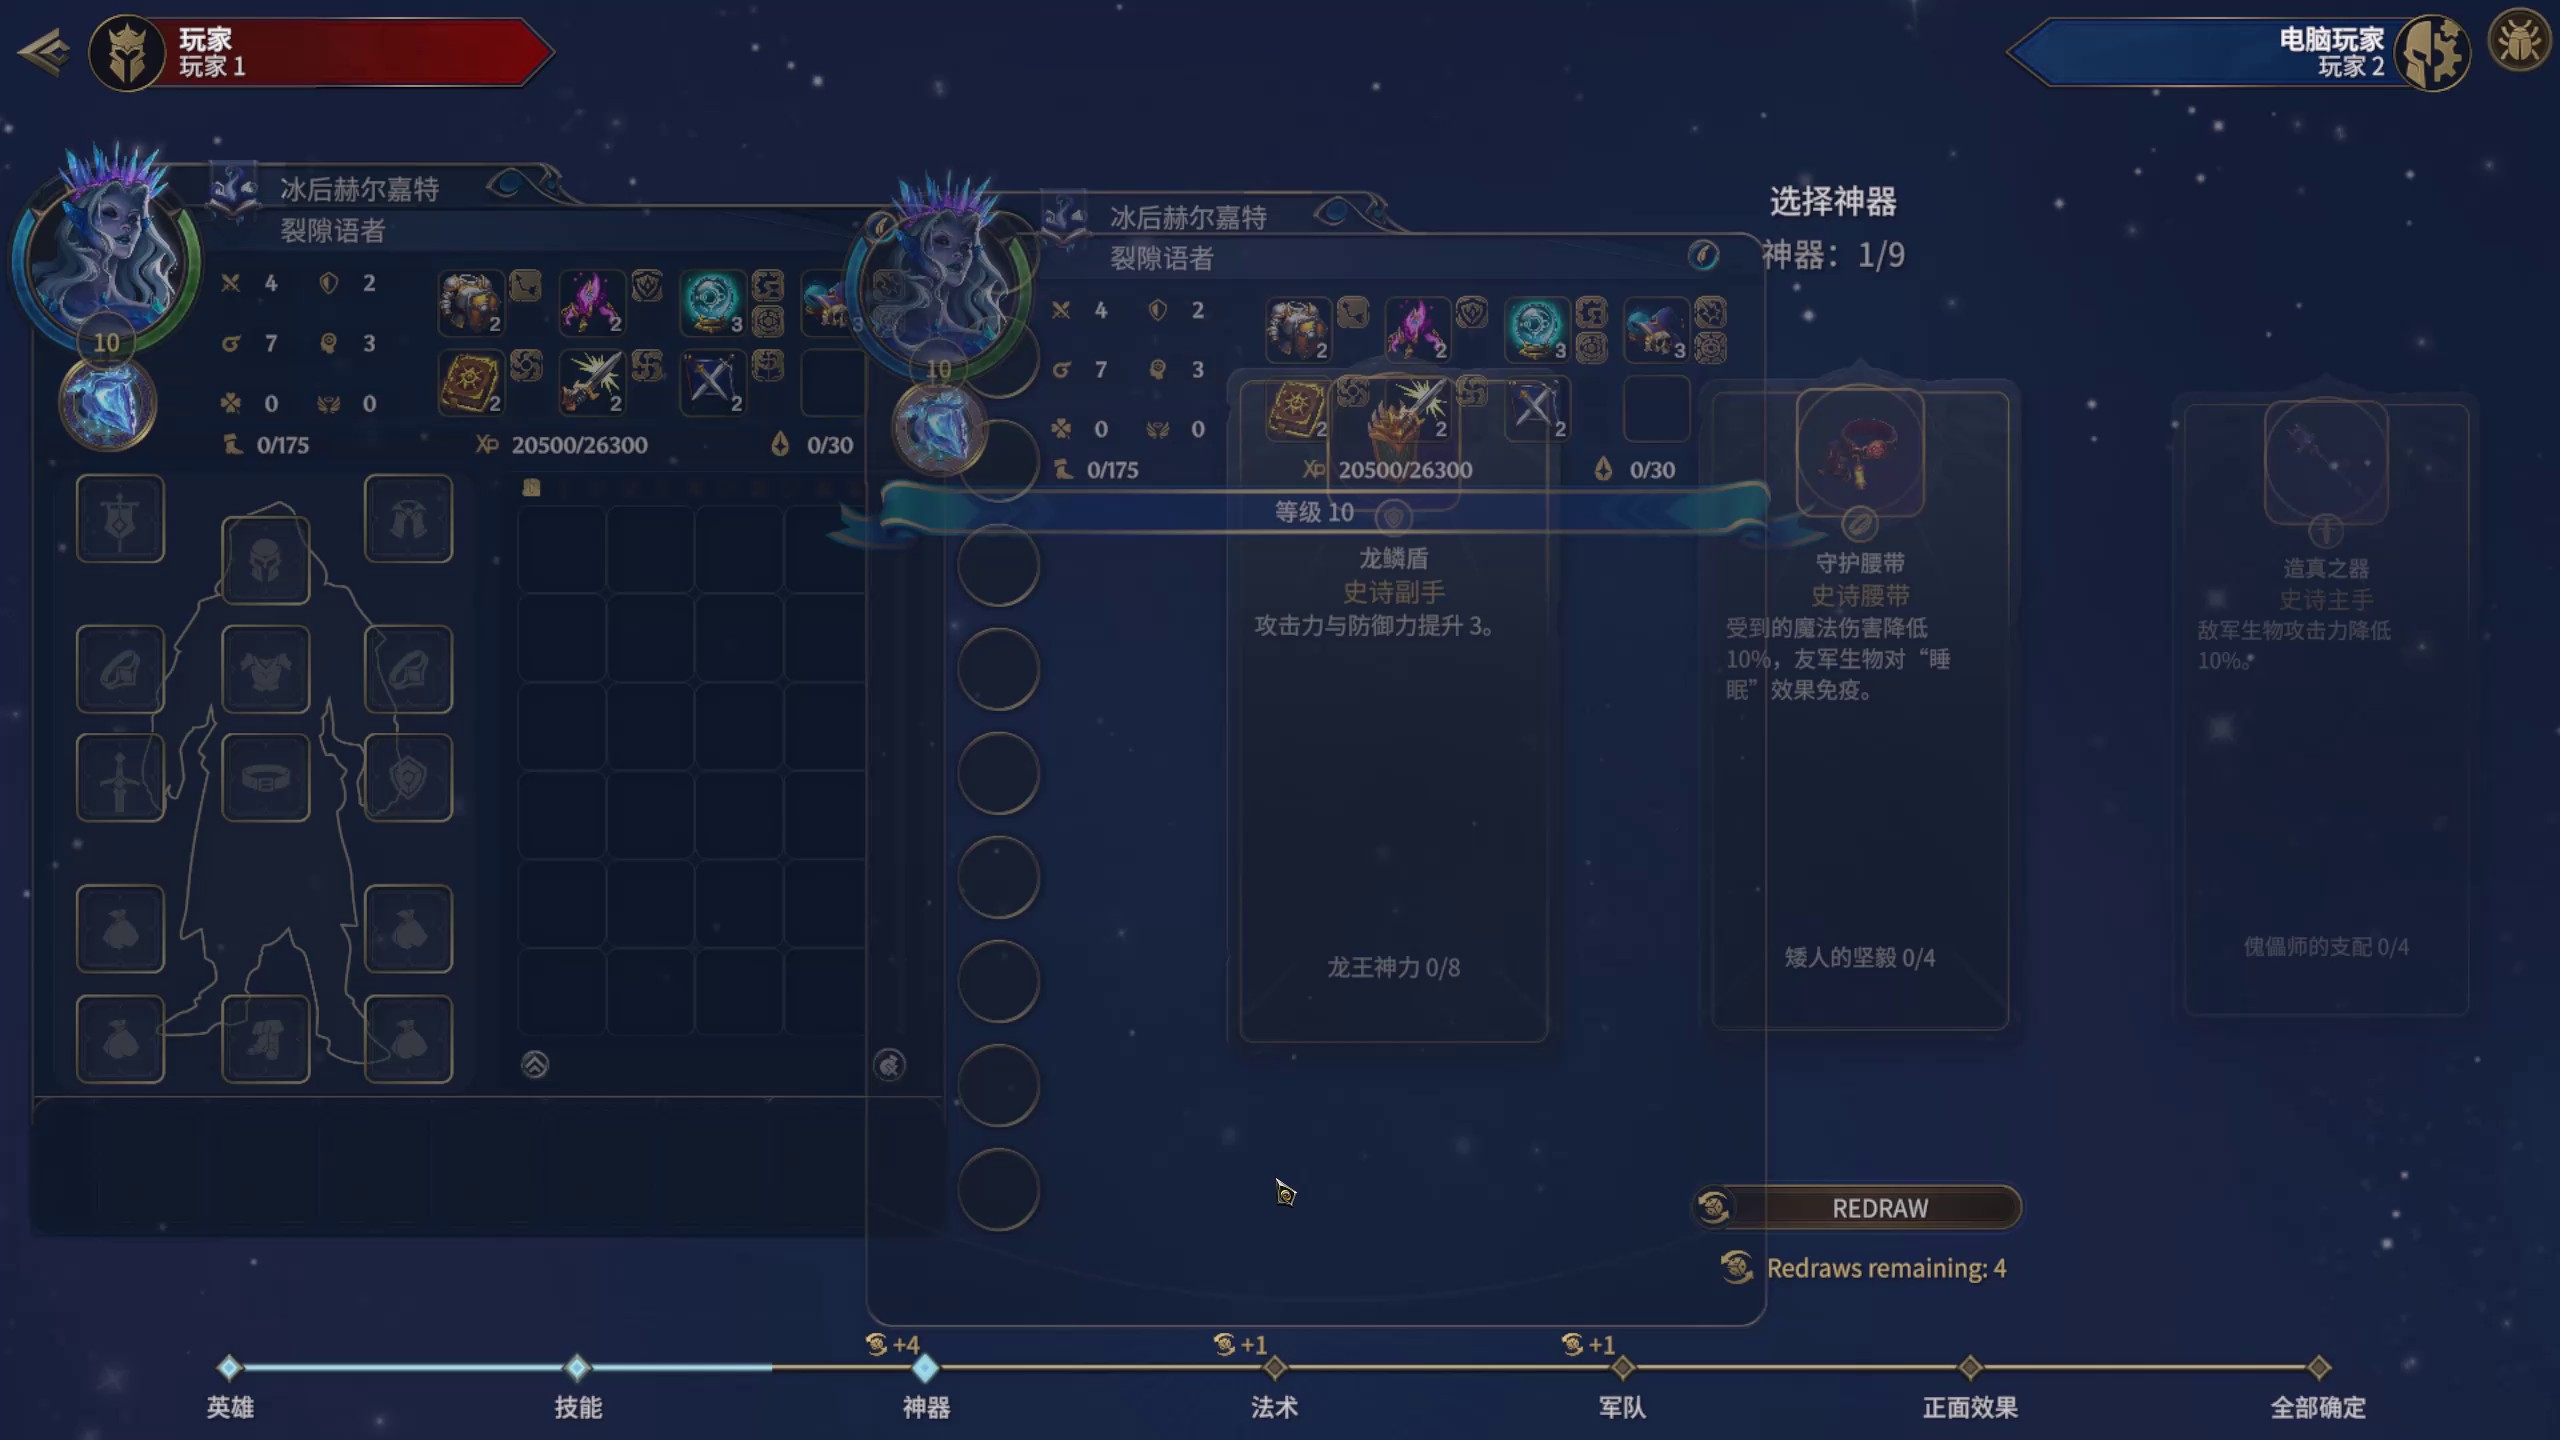
这张图标有“过渡 / 翻页”。以下框和连线仅供检查历史程序行为,不能直接当作可用训练标注。
- artifact-1:龙鳞盾 → 龙鳞盾 / Dragon Scale Shield (artifact:power_of_the_dragon_father_dragon_scale_shield_artifact)
- artifact-2:守护腰带 → 防护腰带 / Protective Belt (artifact:gifts_of_dwarven_lords_protective_belt_artifact)
- artifact-3:造真之器 → 真理制造者 / Truthmaker (artifact:rule_of_shadow_the_truthmaker_artifact)
查看历史预测与旧标签
历史关联程序采用的场景:选择宝物。图标身份与候选框可用性未独立验证;当前分类不会重写这些输出。
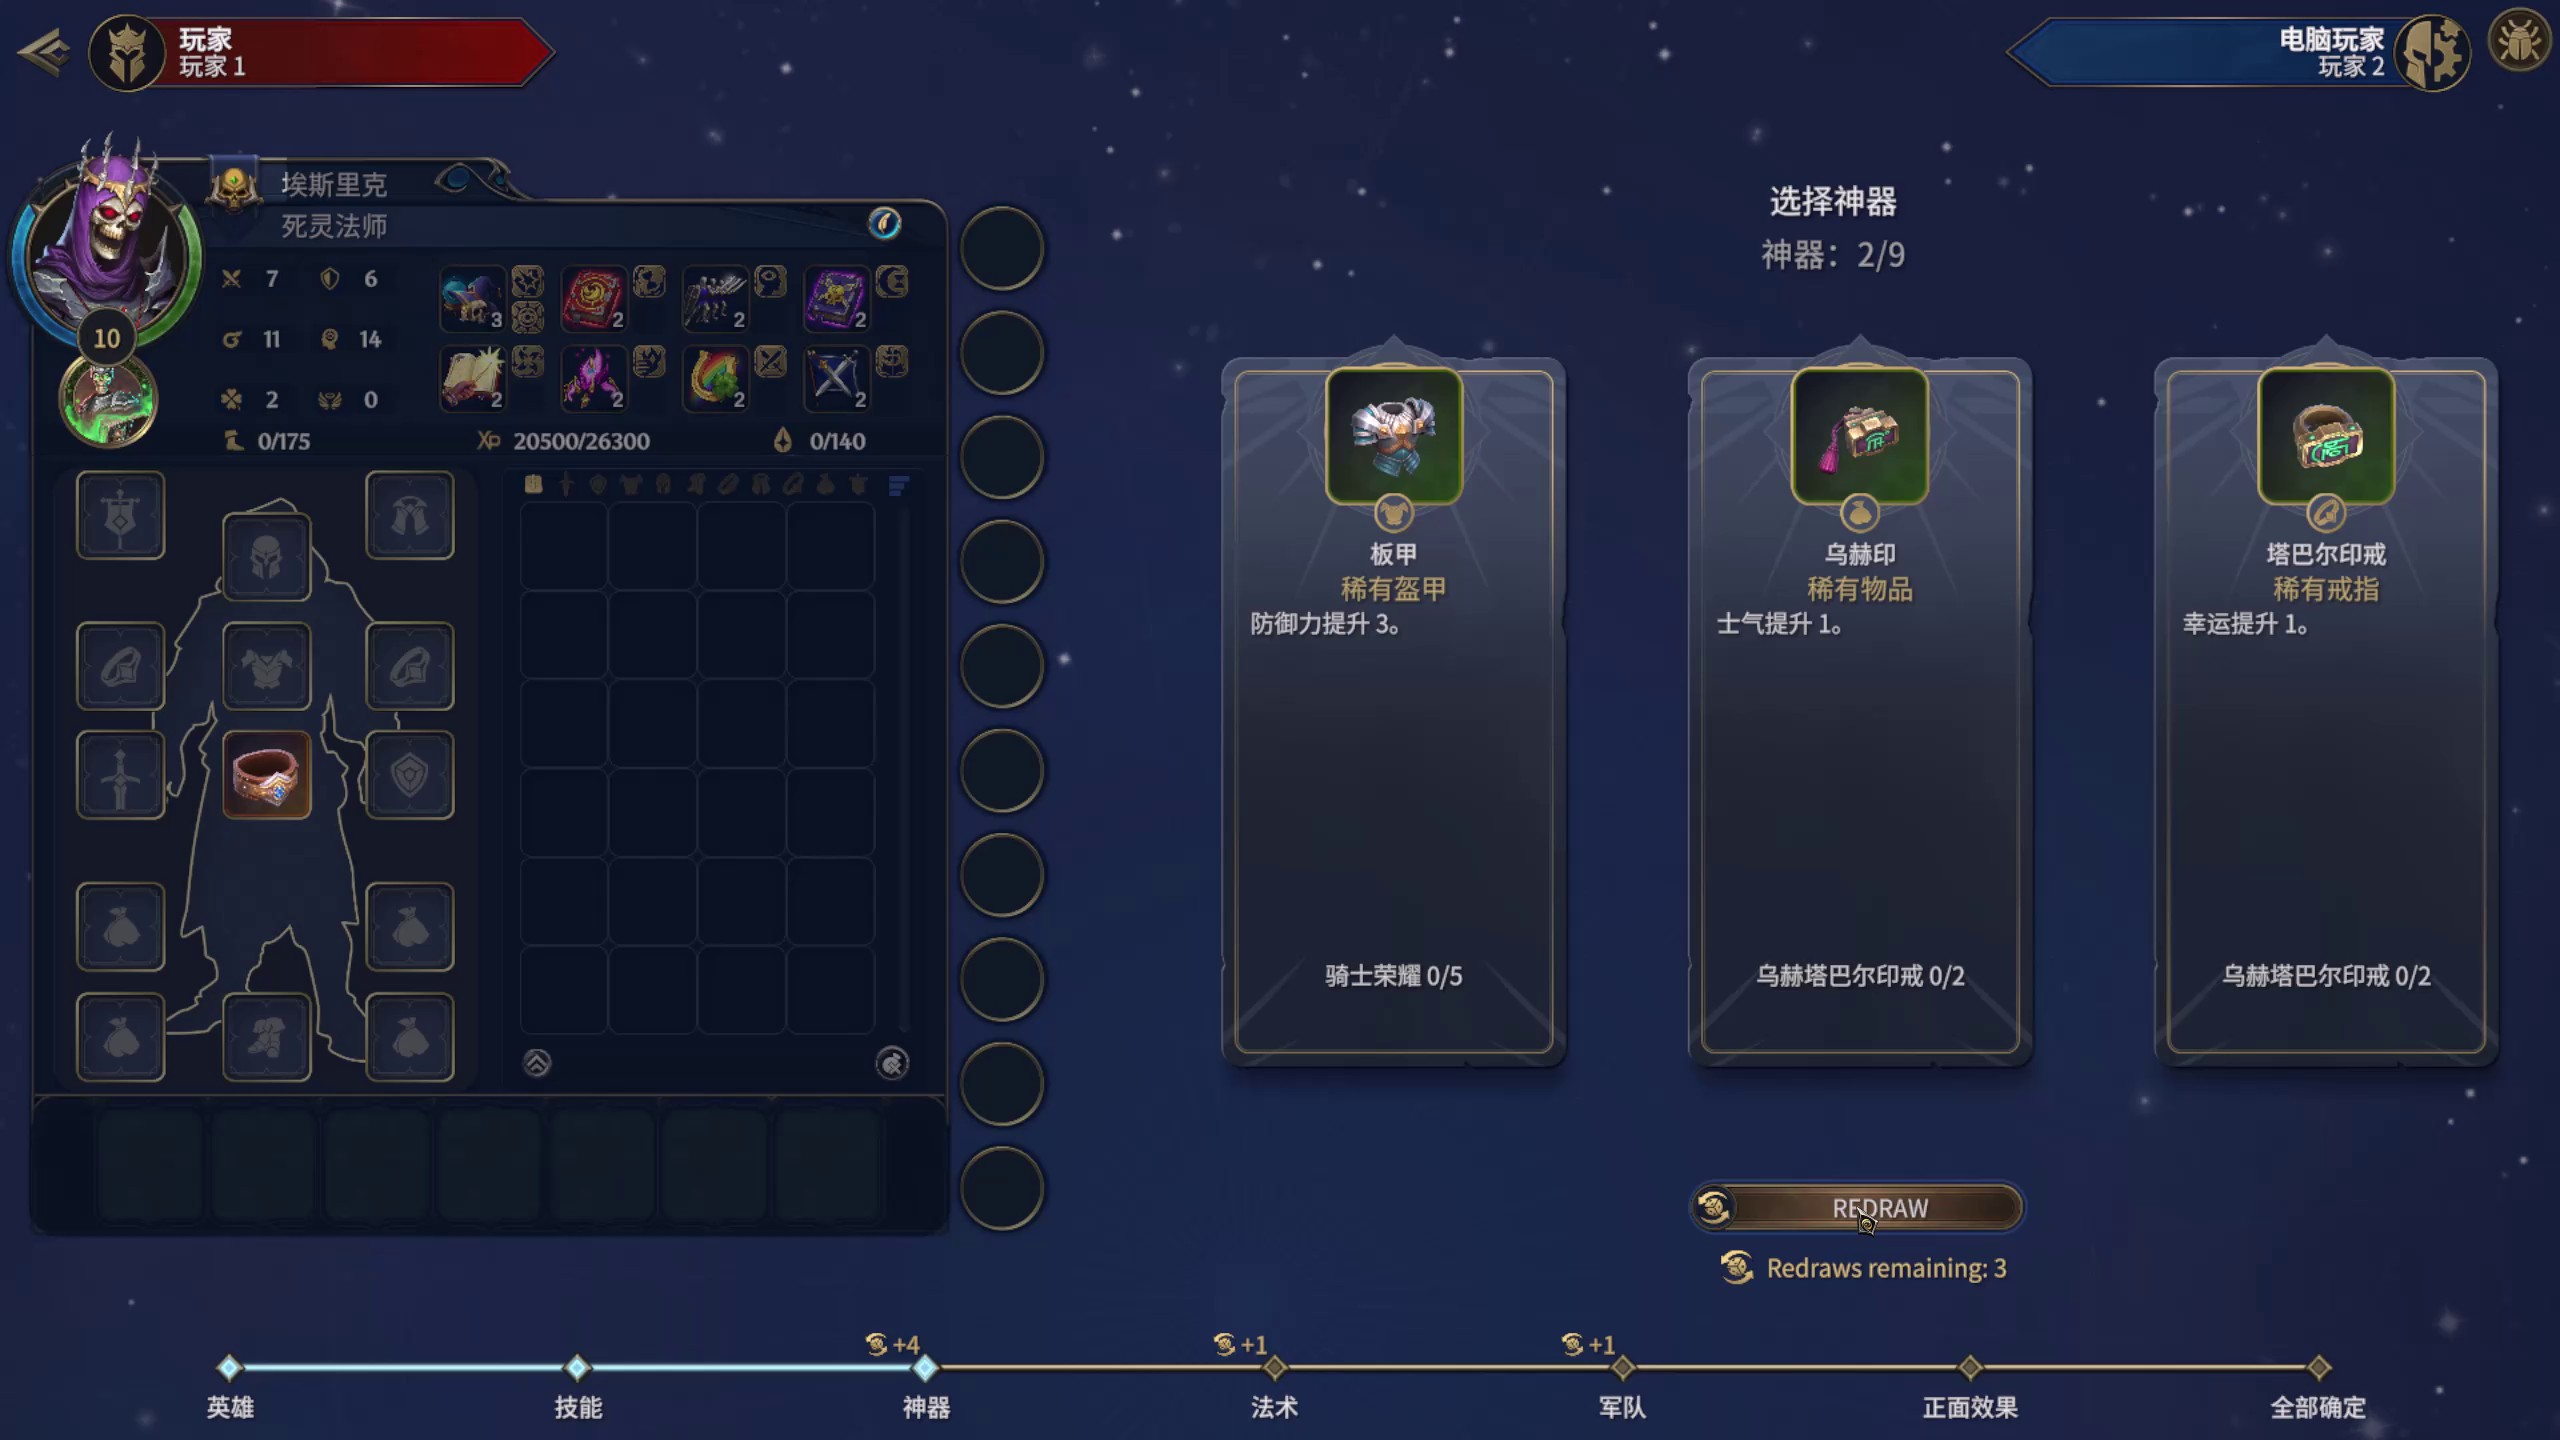
- artifact-1:板甲 → 板甲 / Plate Armor (artifact:knights_honor_plate_armor_artifact)
- artifact-2:乌赫印 → 乌赫印章 / Ukh Signet (artifact:ukhtabar_seal_ukh_seal_artifact)
- artifact-3:塔巴尔印戒 → 塔巴印戒 / Tabar Signet‑Ring (artifact:ukhtabar_seal_tabar_seal_artifact)
查看历史预测与旧标签
历史关联程序采用的场景:选择宝物。图标身份与候选框可用性未独立验证;当前分类不会重写这些输出。
选择生物 · CREATURE_SELECTION 2 张示例
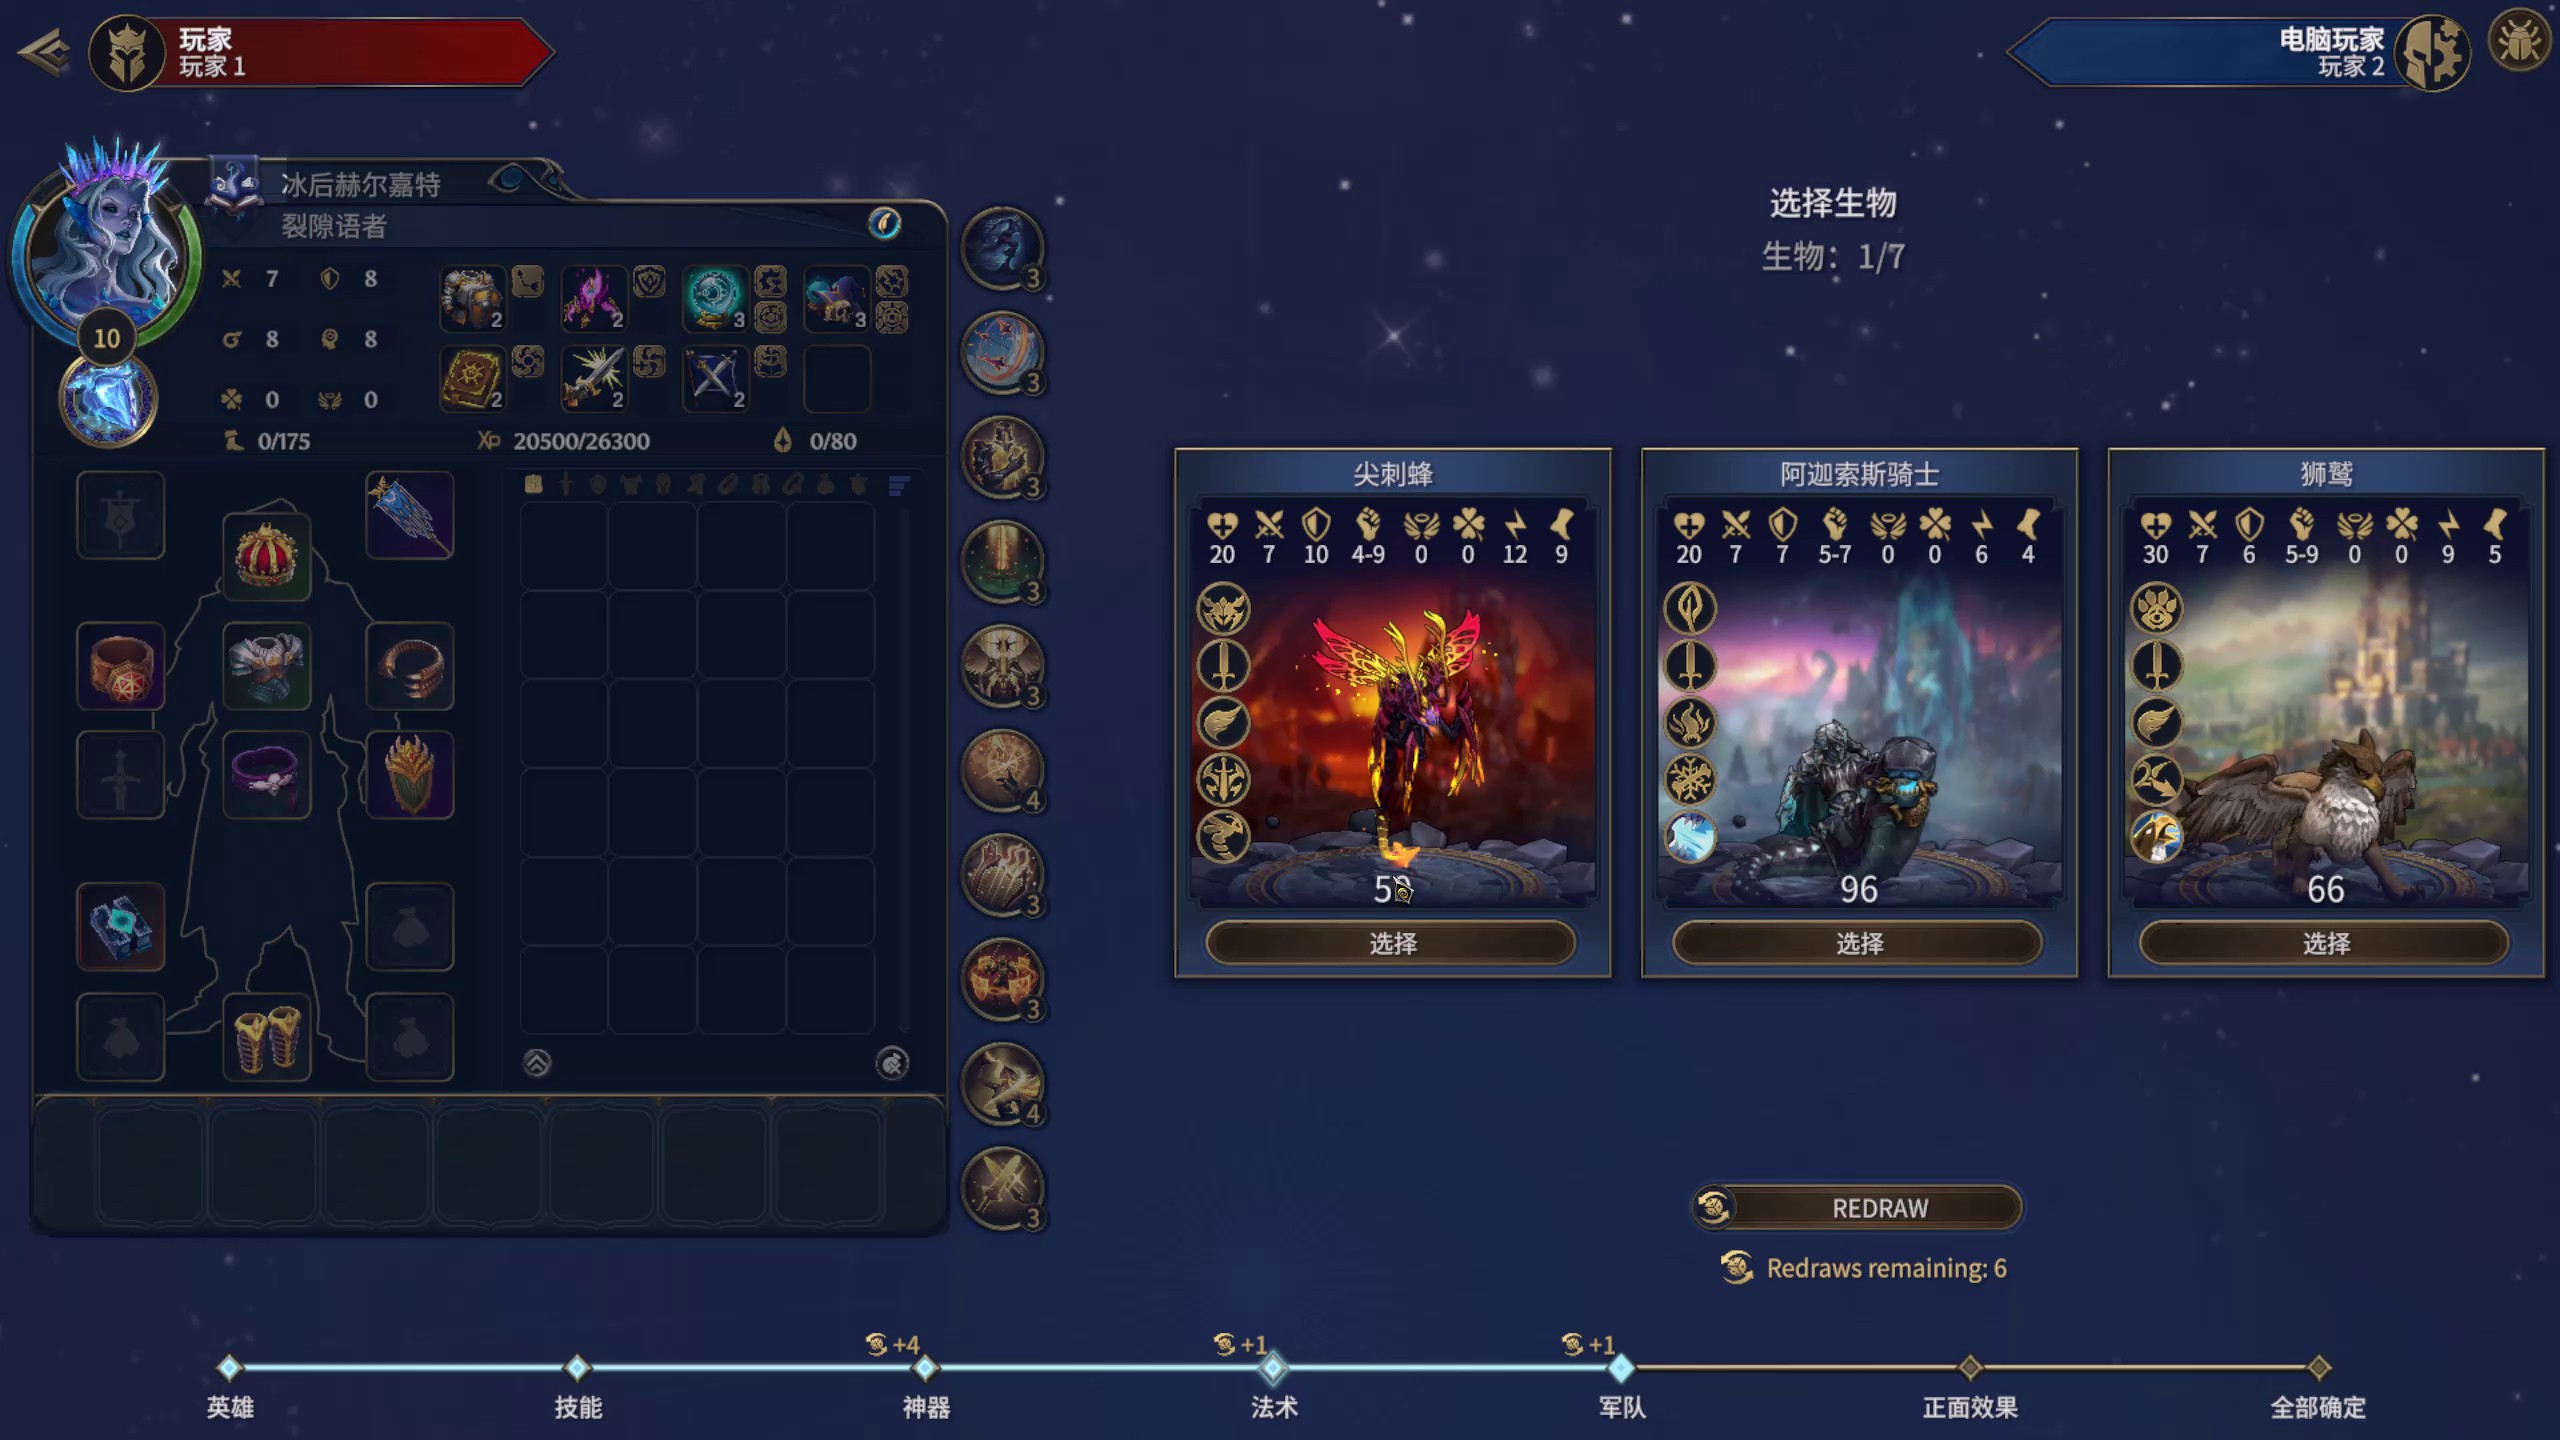
- creature-1:尖刺蜂 → 尖刺蜂 / Stinger (creature:wasp_upg_alt)
- creature-2:阿迦索斯骑士 → 阿迦绍斯骑手 / Aga'Shoth Rider (creature:frostworm_rider)
- creature-3:狮鹫 → 狮鹫 / Griffin (creature:griffin)
查看历史预测与旧标签
历史关联程序采用的场景:选择生物。图标身份与候选框可用性未独立验证;当前分类不会重写这些输出。
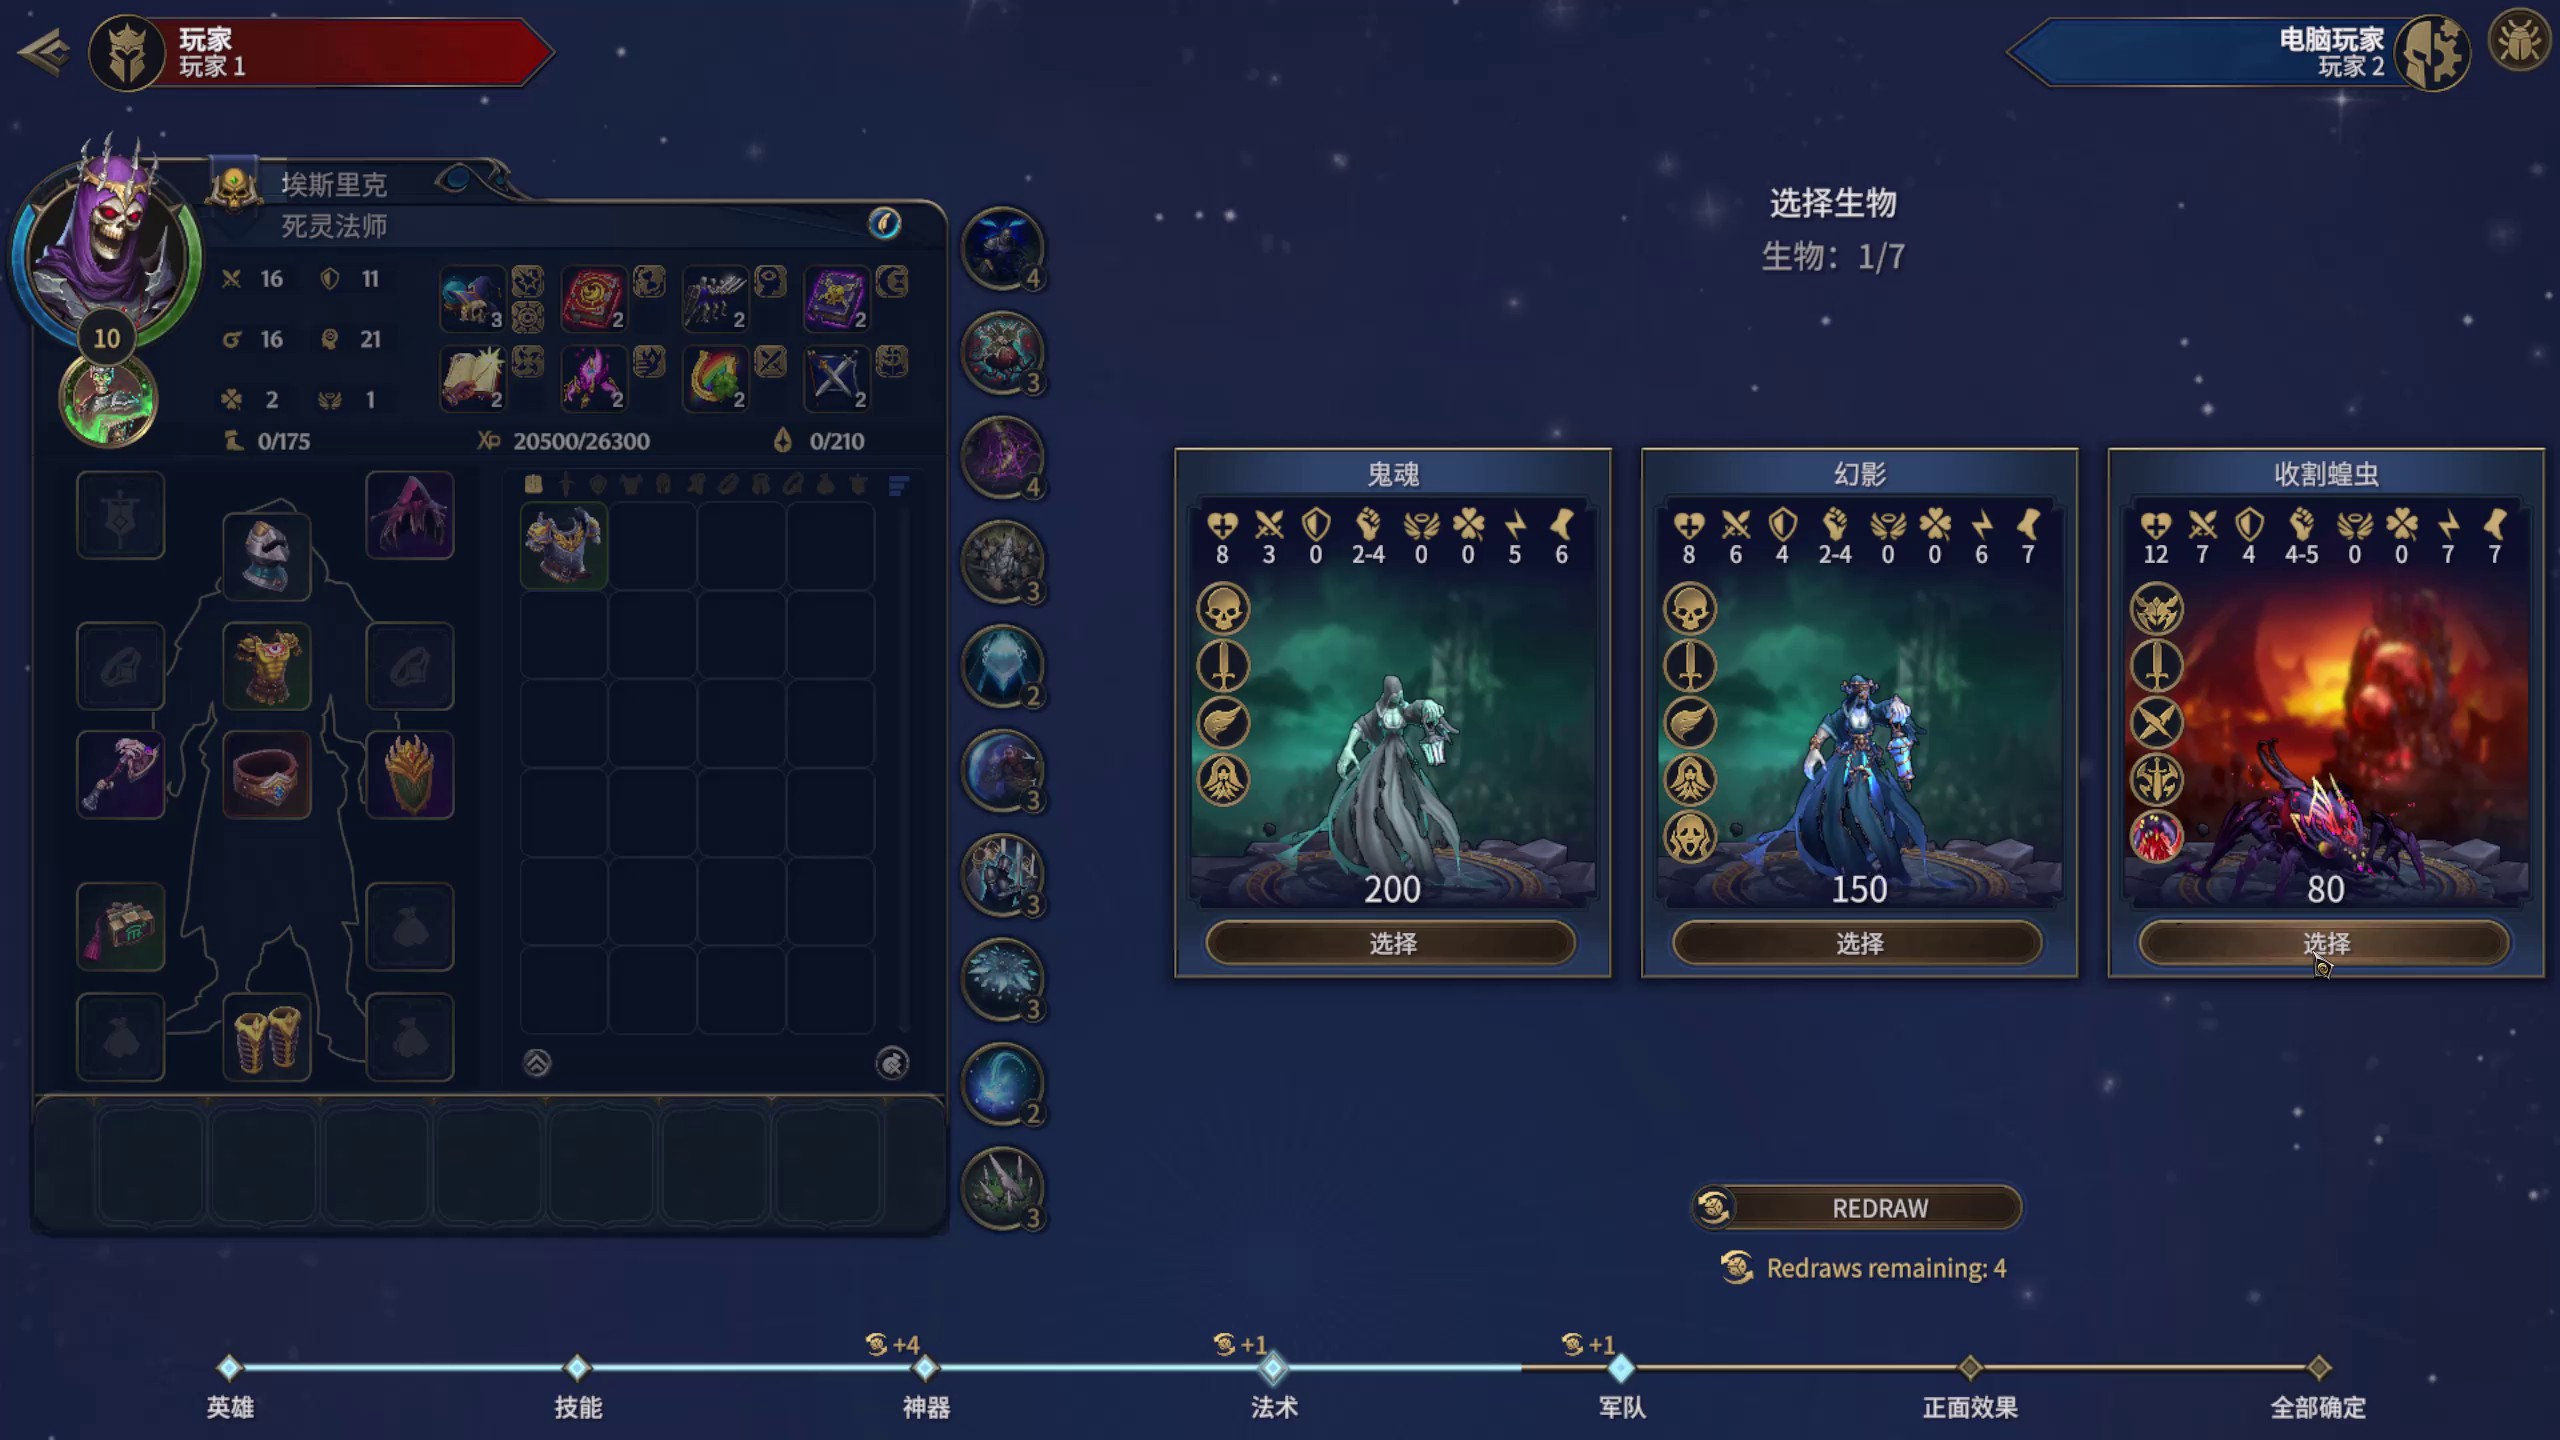
- creature-1:鬼魂 → 阴魂 / Wight (creature:flicker)
- creature-2:幻影 → 幻鬼 / Phantasm (creature:flicker_upg_alt)
- creature-3:收割蝗虫 → 掠恶蝗 / Harvester Locust (creature:locust_upg_alt)
查看历史预测与旧标签
历史关联程序采用的场景:选择生物。图标身份与候选框可用性未独立验证;当前分类不会重写这些输出。
青框是 OCR 文字;橙框是固定布局给出的图标候选区域,并不意味着模型检测了图标外轮廓。连线把标题指向候选槽位。即使文字解析成功,图像身份与遮挡仍未独立确认。全屏未关联文字没有消失,它们只是尚未建立语义关系。
2. 从标题读数到稳定身份
初期流程用已知 16:9 布局裁标题,三倍放大送 Windows 中文 OCR;未匹配时尝试增强。新流程的小标题首选依据来自 B024 的 PP-OCRv6 比较。这里展示的关系结果是历史缓存,不能因为修改了默认引擎就宣称全部由新引擎重新生成。
匹配会规范化空格、标点、全半角与繁简形式,主技能只删除合法的等级前缀。随后只在预期对象类型中查询唯一精确名称或别名:主技能、子技能、英雄、生物各有命名空间。模糊候选可以帮人检索,不能自动创造别名。法术标题被送到生物槽位时,应拒绝错误路由,而不是硬找一个相似生物名。
布局同样会出错。宝物页面有不同版本,标题可读不代表裁框仍然适配。主菜单的展开位置变化则应由本帧文字定位处理。对于既有 crop,标注适配器要求类型一致、唯一空间对应且 IoU 至少 0.70,才允许名称建议占据首位;IoU 是两框交集面积除以并集面积。
3. 有哪些覆盖,哪里还没有做好?
| 保存的关系预标注类别 | 帧 | 图标槽位 | 文字→目录解析成功 | 未解析 |
|---|---|---|---|---|
| ARTIFACT_SELECTION | 35 | 105 | 30 | 75 |
| CREATURE_SELECTION | 17 | 51 | 51 | 0 |
| HERO_SELECTION | 10 | 30 | 30 | 0 |
| MAIN_SKILL_SELECTION | 65 | 195 | 195 | 0 |
| SUBSKILL_SELECTION | 59 | 236 | 224 | 12 |
总计 186 帧、617 个槽位,530 个有目录身份,87 个未解析。宝物有 105 个槽位但只有 30 个解析,不能只展示成功截图而掩盖这个缺口。需要检查布局、标题文字与目录匹配分别贡献了多少失败。
这份缓存与早期的两个实验不是同一批数据:Creature-only 原实验是 407 帧、1,221 个标题,其中 1,218 个匹配;五场景小试验是 20 帧、64 个标题,其中 61 个匹配。它们都测量了映射覆盖,不是完整人工审核后的正确率。旧五场景结果:英雄 10/12、主技能 12/12、子技能 15/16、宝物 12/12、生物 12/12。
旧小试验暴露过 拉·迭沃克 与 拉·达沃克 的 OCR 差异,也有 时间扭曲 缺少已确认别名的问题。一个可读标题被拒识,不一定是 OCR 错,也可能是字典或场景路由问题。
法术选择、战前属性奖励、英雄攻防数值以及战场双方属性尚未纳入这五类关系结果。生物在战场上通常没有固定标题条,仍需要视觉定位与身份识别。本文不能据此声称“每个 UI 元素”已经完整识别。
4. 让审核逐步产生更好的训练数据
实际路线是迭代的:先人工确认少量身份和可用性,训练/更新图像模型,用模型建议加速更多标注,再加入 OCR 名称作为另一条建议来源。最终训练只能消费明确审核过的记录;模型或 OCR 建议不能自动成为自己的测试答案。
旧适配器两次辅助运行分别改了 849 和 433 个首选建议,回执记录保护了当时已有的 3,239 个审核对象。新语料那次还有 678 个布局不匹配被拒绝,没有因为标题可读就覆盖原框。这些都是当时的操作计数,不代表现在的待审核数量。
审核时分别检查实际图标、名称与原始标题条:身份对但被挡住的图像,可保留标题证据并标记图像不可用;错误名字需要改身份;空白/非目标不能当作正常身份训练样本。准确 OCR 不会自动认证旁边的图片。
接下来用确认结果补齐关系评估,并区分文字准确率、目录解析准确率、关联准确率和 crop 可用性。英雄数值与时间更新另见 B025,它扩展到字段级理解,避免把本篇的“身份”能力误当作完整状态跟踪。
复现:perception/experiments/b023_scene-conditioned-ui-elements/ 保留原实验、五场景布局和离线建议适配器;本次连线直接读取 relationship-prelabels-v1/prelabels.jsonl,没有重跑推理或修改人工标签。
Comments