P61 · 离线 OCR 选型 · 实验记录与相关篇目
新增 24 张原图的开发对照;保留历史 11 个标题裁图实验。参考标注待用户复核,不是独立测试准确率。
想从几十段游戏录像里找到“某个法术的说明出现过的画面”,可以先用 OCR(文字识别)读出关键帧里的文字,再用文字找图。但如果只读到了大段说明,漏掉战场生物脚下的数量,后面的数据采集仍会留下很大的空白。
阅读时先分清两种问题:整屏OCR要自己找字,局部OCR先得到一块裁图,再读其中的字。裁框可能来自人工,也可能来自算法,下面会分别注明。 本文保留24张整屏实验;9月24日另做的30图数量牌对照中,VL四倍读对200/202,仍有2错、假框出数和不可读位置出数。它比同批PP更好,但不是本文939项的更新成绩,也没有替换默认扫描器。
所以在全量扫描前,我们先做一轮不按耗时淘汰方案的准确性实验。输入改为完整截图,既要找到文字的位置,也要读出内容;不再提前告诉算法正确裁框在哪里。输出暂时只是带位置的文字候选,不直接成为已确认的游戏状态。
本文把 PP-OCRv6 medium 简称 PP,把 PaddleOCR-VL-1.6 简称 VL。它们是两种本地文字识别模型,不是同一模型的快慢档。
已有扫描使用 PP-OCRv6 medium 的“整图双遍+有保护的切块补缺”。 在 24 张开发图上,939 个纯数字字段读对 898 个(95.6%),79 个文字字段完整读对 74 个(93.7%)。下面先解释这套方法,再介绍 9 月 12 日补做的小字实验:更小切块与 PaddleOCR-VL-1.6 重读,把同一批数字提高到 910/939(96.9%)。新配方仍是开发候选,没有覆盖已有扫描结果,也不是所有 OCR 模型中的绝对最优。
flowchart LR
 A[24 full screenshots] --> B[Whole-image OCR: native and contrast-enhanced]
 A --> C[Overlapping tiles: enlarged and enhanced]
 B --> D[Keep primary readings and reserve nearby space]
 C --> E[High-confidence gap candidates]
 D --> F[Text, boxes, alternatives and per-image status]
 E --> F
 F --> G[Score against separate human-readable references]
图 1:先用完整图片读出主要文字,再放大小块补找遗漏;参考答案只用于评分,不参与选择读数。
1. 原图:不只挑说明文字好读的图
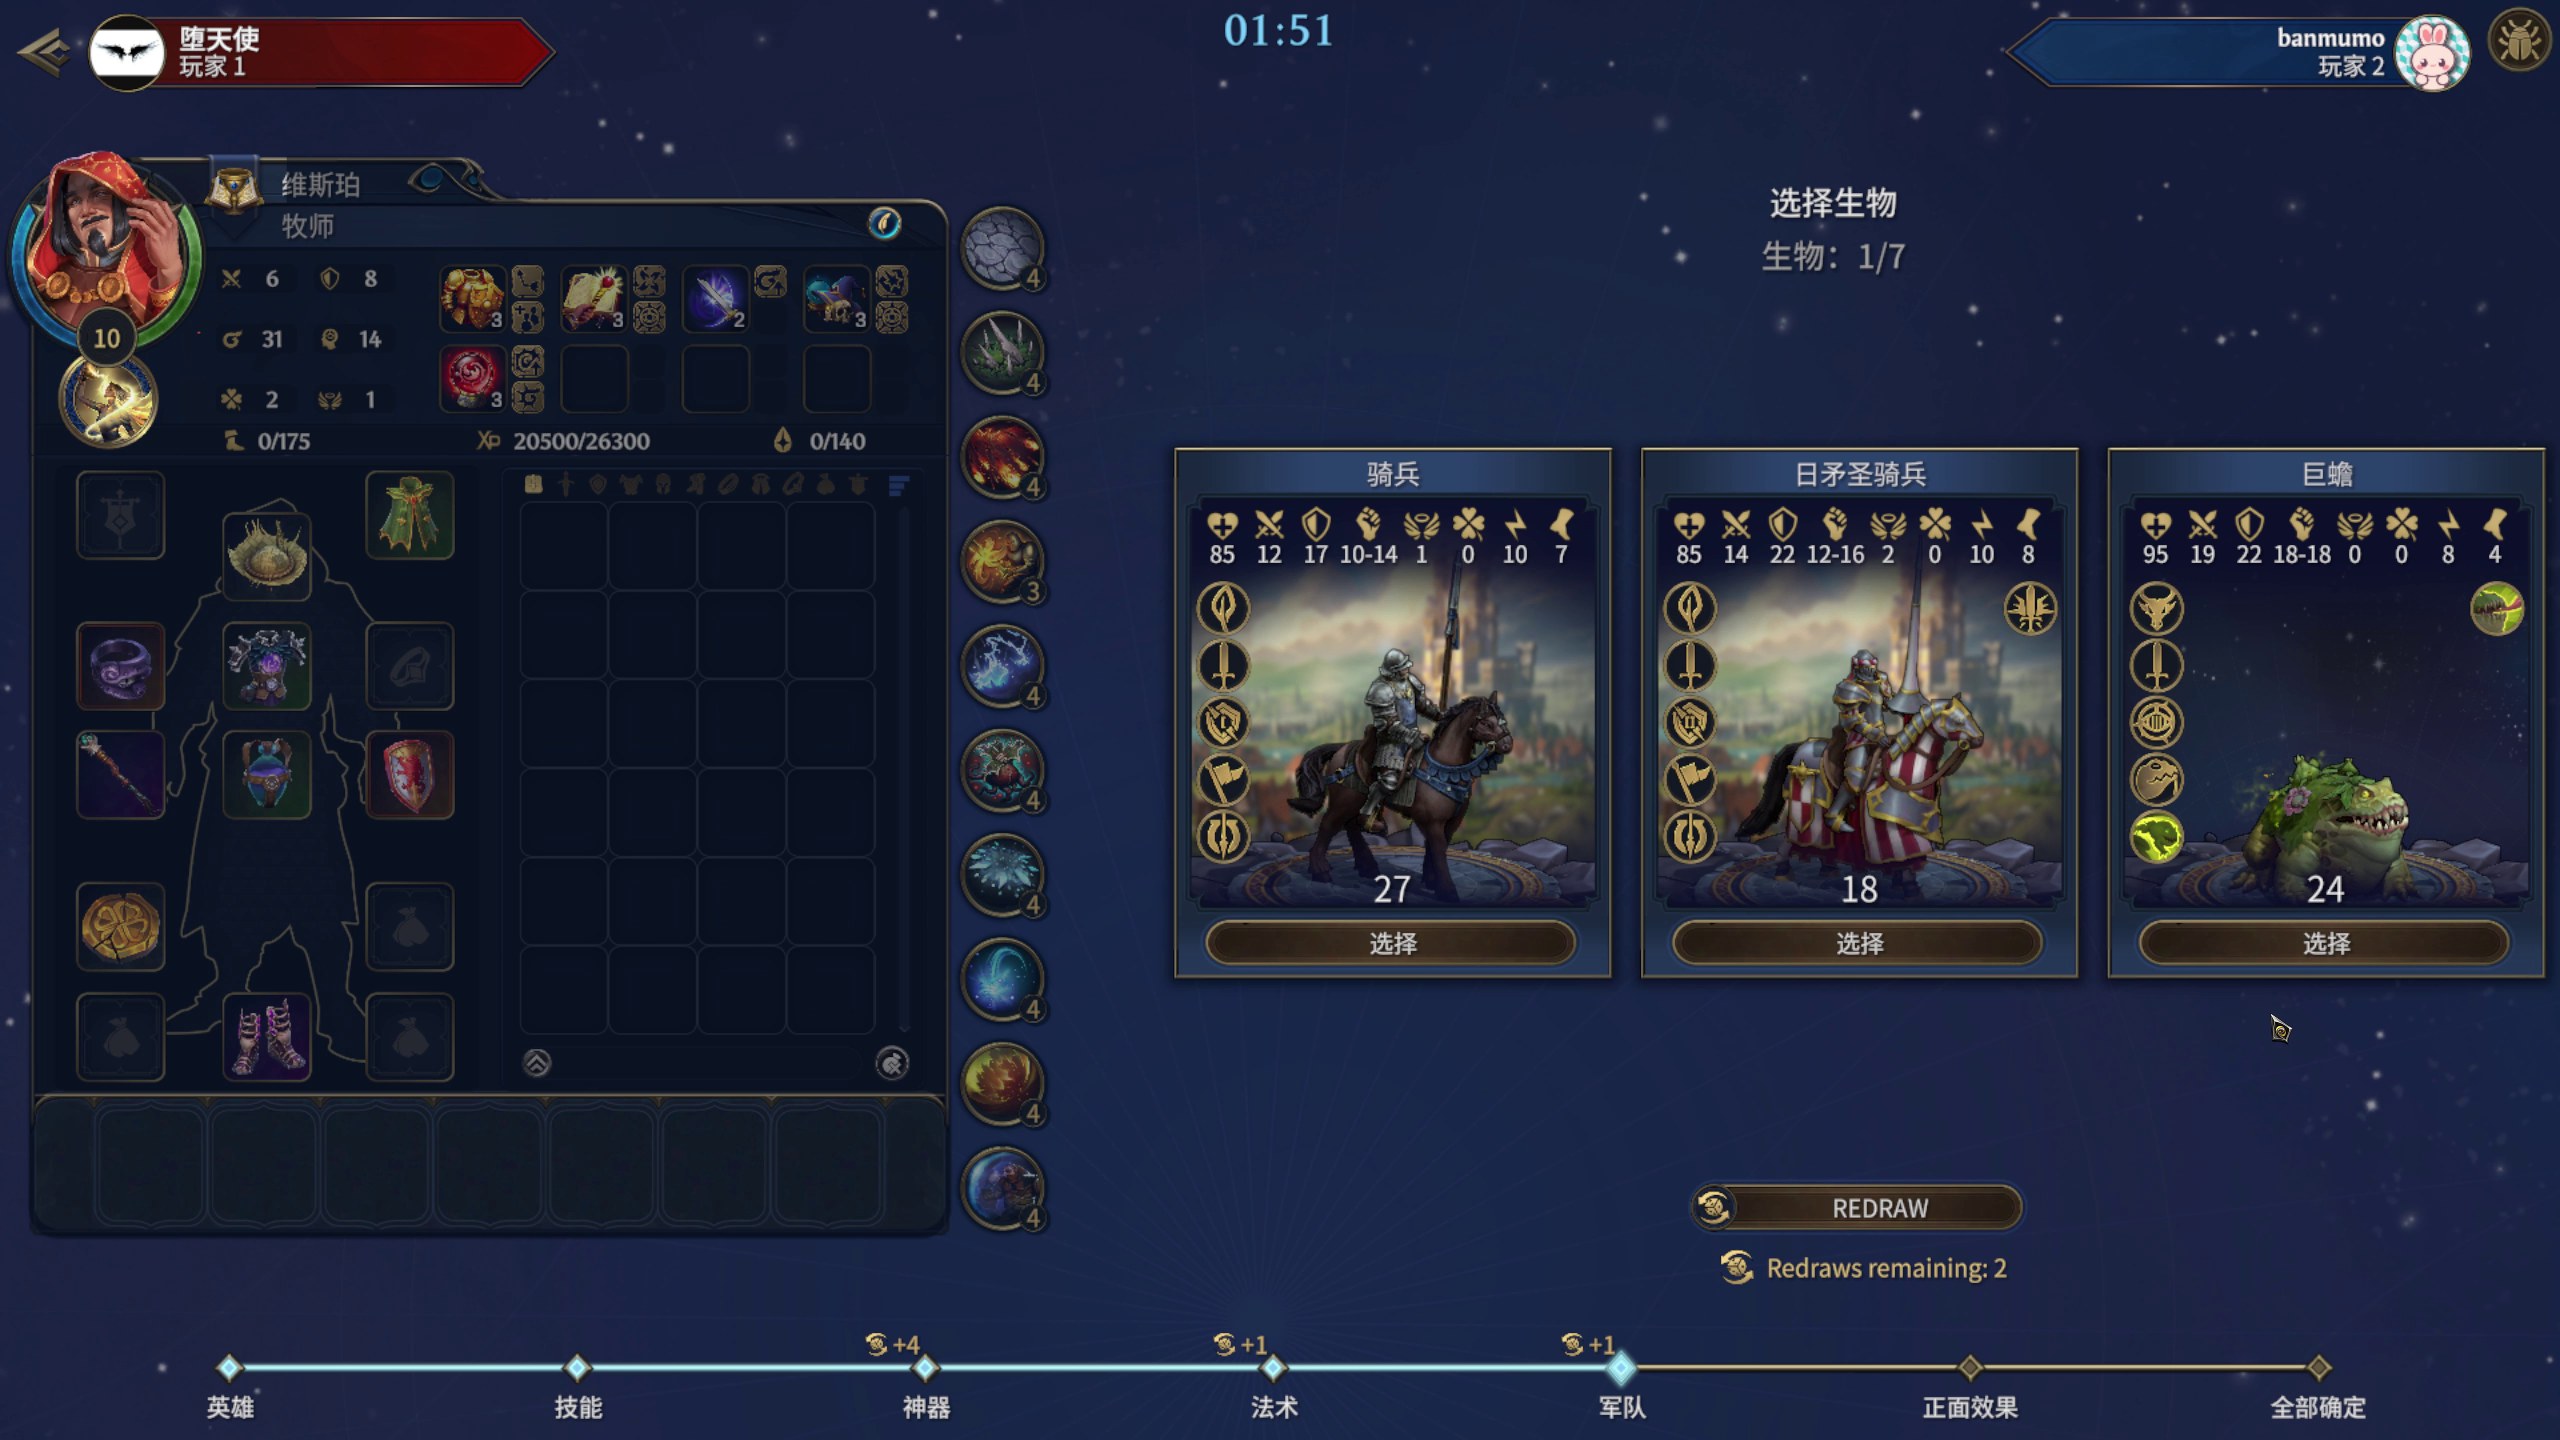
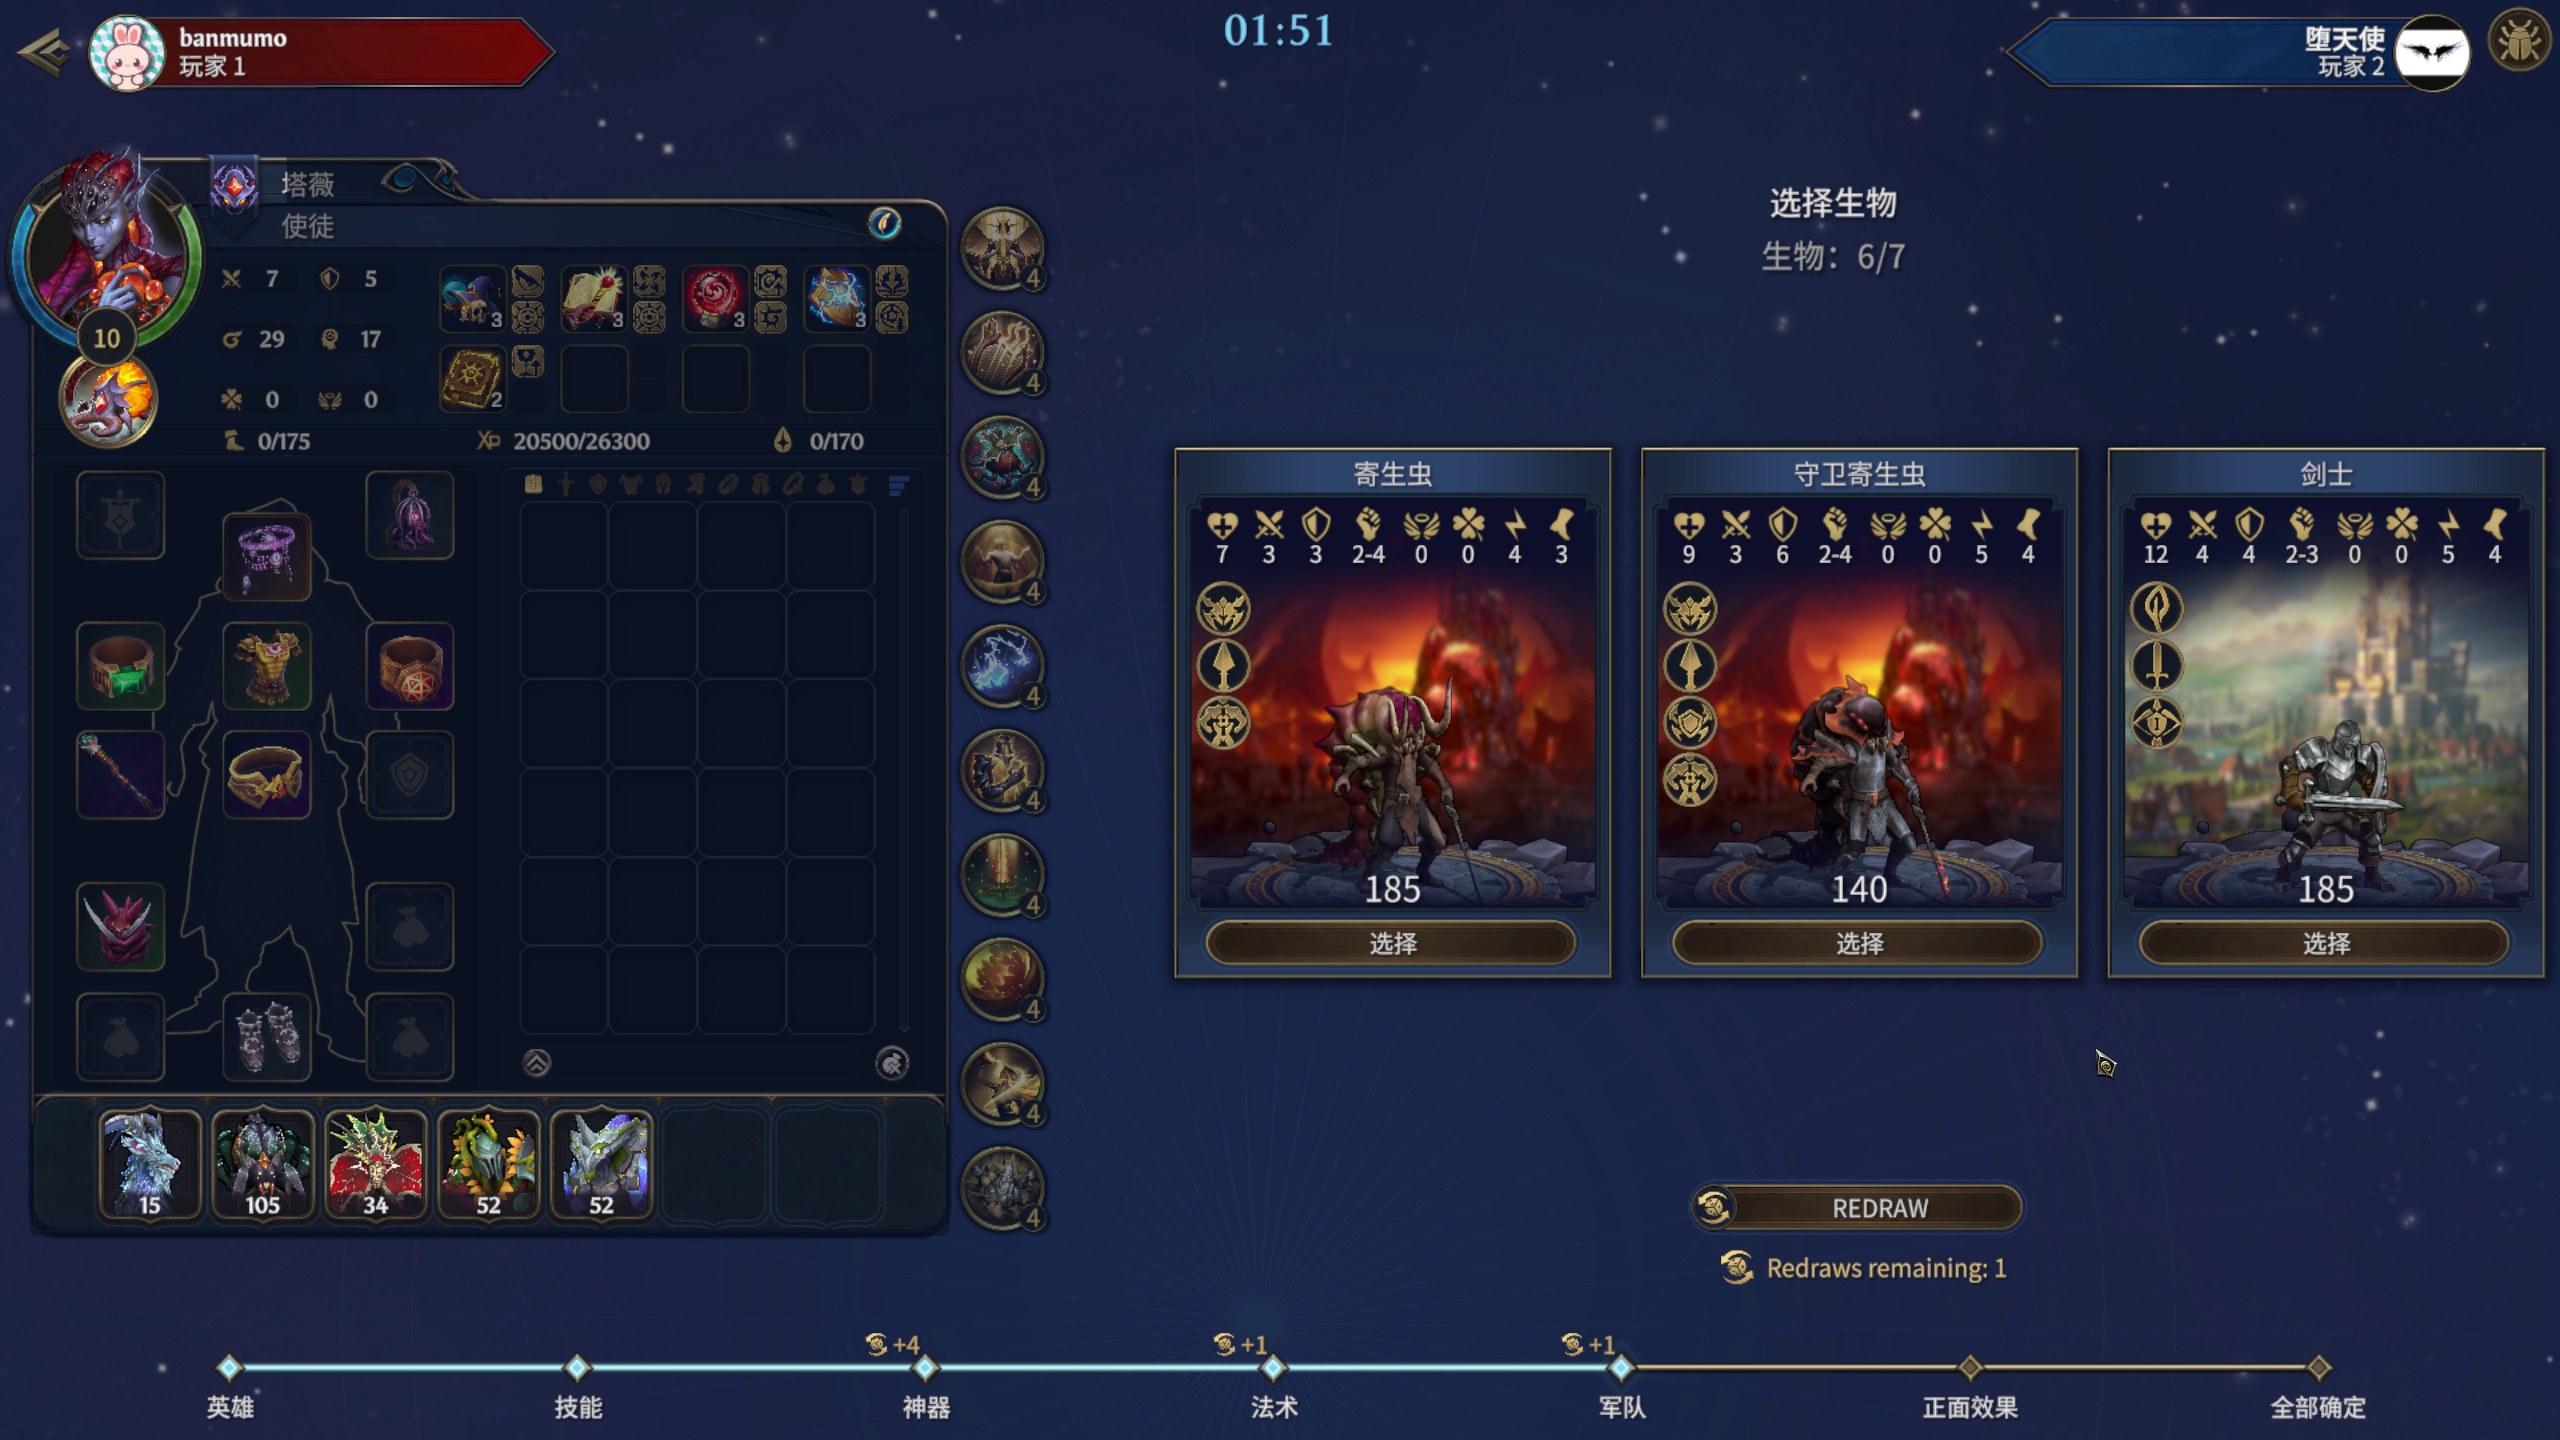
这次选择 24 张 2560×1440 原图,来自 15 段录像。包含普通战斗、部署、左右 HUD、英雄面板、生物面板、行动条、目标预览、魔法书、悬浮说明和日志。其中保留两张魔法书翻页画面,专门暴露变形小字的困难;没有把它们偷偷从分母里删掉。
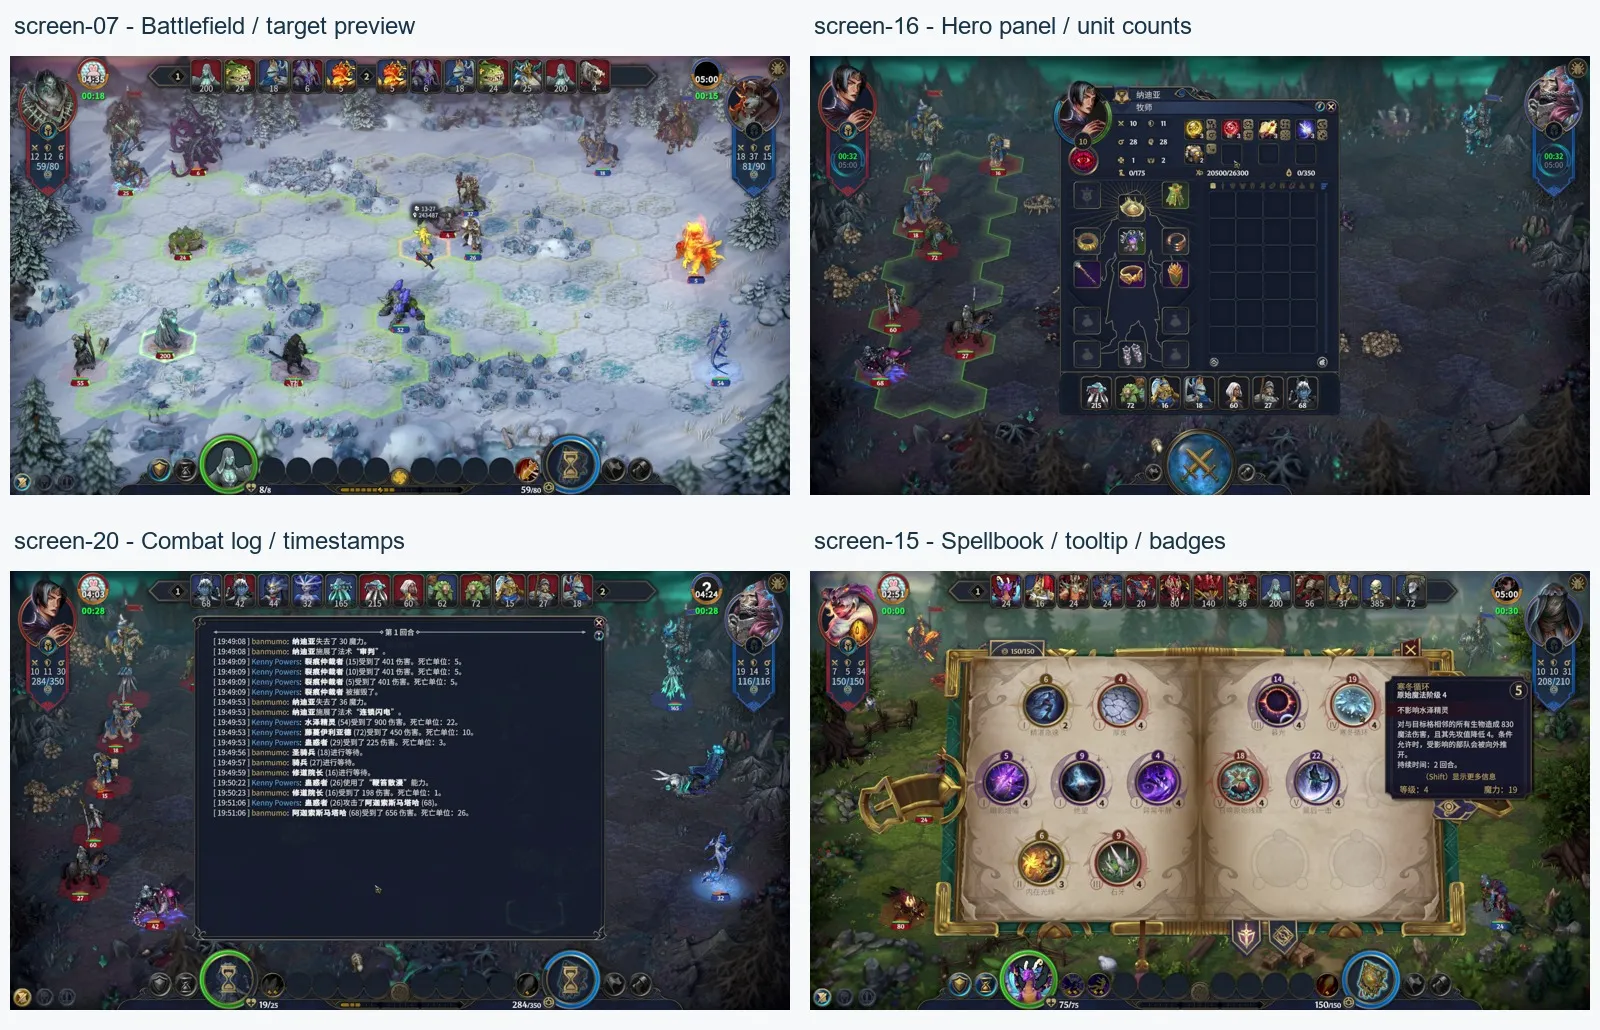
图中的小数字分布在完全不同的背景上。顶部行动条的数量不能代填到战场数量牌里;即使两者看上去相同,也必须分别从各自像素读出来。
参考标注复用 B029 的手工 HUD 字段和 B025 的面板字段,再逐张看原图补齐可见阿拉伯数字。先看没有 OCR 答案的裁图,转写完成后才查看本轮模型读数;之后用整图回查候选生成器漏掉的位置。因此测试不局限于“候选生成器已经找到的数量牌”。
最终有 1,018 个可评分字段:939 个纯数字字段、79 个文字字段。数字字段包括时间、当前值/上限、区间和独立数字;文字字段还包含两张日志的 44 行正文及两个回合标题。另保留 8 个遮挡不确定区域,不猜答案;14 个没有数字的装饰误框作为小规模负例。
这些是助手复核、等待用户确认的开发参考,不是绝对真值。24 张都做了整图数字回看,但罗马数字、被面板遮住的底层内容和全部正文没有穷尽转写,更没有宣称所有图标已完成语义标注。初次评分还发现两张日志的首行参考框过宽,包含了背后的回合提示;回看原图后收窄了框,没有改答案文字。
2. 方法:先比较引擎,再比较怎样看图
Windows 简体中文 OCR、EasyOCR 1.7.2(中文/英文、beam search 宽度 10)和 PP-OCRv6 medium 处理同一批原图。PaddleOCR 3.7.0 使用本地 GPU,EasyOCR 使用 CPU。时间不参与选择,因此这里不是硬件速度排行榜;没有训练或微调模型,也没有用名称目录挑“最像答案”的读数。
整图基线复用既有方案:原尺寸彩色一次,加 1.5 倍局部对比度增强一次。切块将原图分成 9 个 960×640 的重叠区域,常规相邻块重叠 160 像素,末端块贴齐边缘;识别框换算回原图坐标。普通切块放大 2 倍;密集方案再增加 3 倍对比度增强,并降低检测阈值以找回小字。参数含义见 Paddle OCR 官方文档和 EasyOCR 官方文档。
直接把多遍结果按识别分数合并,会出现一个问题:切块截断的半句也可能分数很高,覆盖或混入原本完整的长句。随后补测两个不看答案的组合:
- 保留整图、只补空缺:已有整图文字不被切块覆盖,但仍可能把附近的血条或装饰识别成一个多余字符。
- 给整图文字留保护区域:在已有框左右各扩展一倍字高、上下各扩展半倍字高;切块只补这些保护区域之外、识别分数至少 0.8 的候选。0.8 是本轮配方阈值,不是“80% 正确概率”。所有未采用读数仍保留,便于复查。
两种组合是在观察初轮错误后补测的,所以这批数据明确属于算法选择开发集。最终选择的第二种组合又从原图完整重跑了一遍,分数与复用已有推理结果的组合相同。
3. 结果:多看几遍有用,合并方式也重要
下表数字分母均为 939,文字分母均为 79。“漏检”指评分框内没有匹配读数;“读错”指有读数但与参考不符。先按空间关系选择输出,再比答案,不用正确文字反过来挑模型结果。字符规范化统一全半角、空白及等价引号/横线,保留 /、:、- 等结构,不能把 1/2 当作 12。
| 配方 | 数字完整读对 | 文字完整读对 | 数字漏检 | 数字读错 |
|---|---|---|---|---|
| Windows 整图 | 212/939 | 35/79 | 611 | 116 |
| Windows 整图+切块 | 232/939 | 31/79 | 537 | 170 |
| EasyOCR 整图 | 656/939 | 59/79 | 223 | 60 |
| EasyOCR 整图+切块 | 736/939 | 39/79 | 125 | 78 |
| Paddle 整图双遍 | 876/939 | 74/79 | 57 | 6 |
| Paddle 整图双遍,显式提高检测边长上限 | 876/939 | 74/79 | 57 | 6 |
| Paddle 整图+2 倍切块 | 880/939 | 55/79 | 49 | 10 |
| Paddle 密集切块、直接合并 | 874/939 | 50/79 | 25 | 40 |
| Paddle 保留整图、切块补缺 | 881/939 | 74/79 | 28 | 30 |
| Paddle 带保护区域的切块补缺 | 898/939 | 74/79 | 32 | 9 |
这说明“检测出更多东西”不等于“读对更多东西”。密集切块把数字漏检降到 25,却出现 40 个错误读数;保护区域接受稍多的漏检,换来更少错误,最终精确读回最高。与整图基线相比,多读对 22 个数字字段,文字成绩没有下降。
最终方案的文字字符错误率为 0.26%。它与 74/79 的整字段成绩不矛盾:一行日志只漏一个右方括号,整行就不算完全正确,字符层面的损失却很小。该指标包含错字、漏字和多字,不是只挑识别成功的行。
| 用户关心的内容 | 最终方案完整读对 | 尚缺什么 |
|---|---|---|
| 战场红/蓝数量牌 | 215/225 | 5 个无读数,5 个错读 |
| 顶部行动条数量 | 231/240 | 9 个无读数 |
| 左右时钟 | 79/82 | 3 个读数漏了末位字符 |
| 左右英雄 HUD 数字 | 152/152 | 仅覆盖这批参考,不代表新视频全对 |
| 魔法数字徽章 | 95/111 | 16 个无读数,主要在翻页变形图 |
| 日志行/回合标题 | 41/46 | 5 行标点不完整 |
| 悬浮说明字段 | 23/23 | 样本很少,不能推广到所有提示框 |
这里测的是已标注字段的端到端读回,不是全图目标检测 precision。只有 14 个装饰负例且都没有额外数字,不能据此宣称全图无误检。数字 HUD 若被引擎合成一行,会按空格和字符跨度近似分开;这适合比较字段读数,不是字符级精密检测框成绩。
4. 哪些数字仍会漏掉或读错?
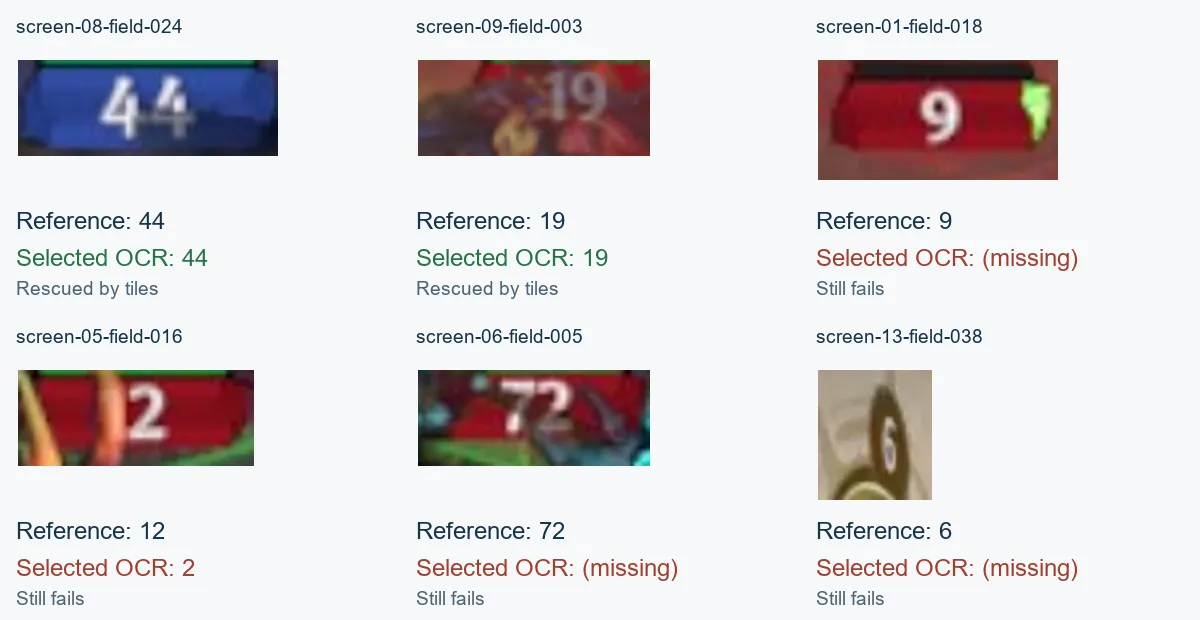
前两格是整图漏掉、切块找回的数量牌。后面有清楚的单字符仍被漏掉,也有数量 12 被读成 2、翻页数字没有输出。放大只能放大已有像素,不能恢复被挡住的笔画;重复同样的增强也不保证能解决透视变形。
因此最终保存的是候选证据:文字、原图框、分数、哪一次尝试产生、是否采用、有哪些冲突。不能因为 OCR 说数量是 2 就覆盖用户确认的 12。本节没有评价身体与数量的关联。后续 B032 新视频流程已输出独立数量牌候选和可能的身体关联,不等于本节的整屏 OCR 输出已经完成关联验收。跨帧模板匹配、目标跟踪及召唤单位处理仍只记为后续想法。
5. 换更强的模型,放大小字,就能全部读对吗?
有些数字,人看局部裁图就能认出来。算法仍然漏掉它,值得继续追查:是没找到位置,还是已经找到、却把字读错?这两种失败需要不同的修复。
2026 年 9 月 12 日核对代码与实际运行记录,现有模型确实是 PP-OCRv6 medium。它不是旧版,但先前没有比较所有先进模型。本轮新增本地 PaddleOCR-VL-1.6:它把图像转换为视觉特征,再逐个生成文字;与“先检测文字框、再用专门识别网络读字”的 v6 流程不同。官方文档解析成绩支持把它列入候选,不能直接当作游戏截图准确率。PP-OCRv6 模型说明、PaddleOCR-VL-1.6 模型说明。
先把正确位置告诉模型,只测它会不会读
复用前面的 24 张图,再加入两张状态悬浮图。固定挑出旧流程的全部错误、各图各类的代表字段和装饰负例,共 217 个区域:203 个有字、14 个无数字装饰。这一小组专门诊断问题,不是随机抽样的总体准确率测试。模型得到人工框,但得不到正确文字;所有分支处理相同裁图。
| 只比较读字能力 | 原裁图完整读对 | 四倍放大+补边完整读对 |
|---|---|---|
| PP-OCRv6 medium,跳过文字检测 | 188/203 | 173/203 |
| PaddleOCR-VL-1.6 | 195/203 | 190/203 |
新模型在这组裁图上更好,但放大并不保证更好。这里的四倍方案还补了边框,不能把差异全部归因于倍率。检查本机 v6 配置还发现,识别网络会把输入重新缩放到 48 像素高;提前把图片放大四倍,不等于网络最终看到四倍高的字。两套识别器也都会把部分装饰硬读成文字:原裁图分支分别在 14 个负例中的 7 个、3 个输出了数字。因此不能把“任意小块送入识别器”当成文字检测。
再回到整屏,让程序自己找框
原先每图 9 个大块,改为 42 个 480×320 小块,分别做 3 倍彩色和 4 倍对比度增强。已有整图读数与保护规则不变。随后让 VL 重读它自动找到的 901 个数字区域,框向外多留两像素;这次不再提供人工框。
| 自动整屏流程 | 完整读对 / 1,018 | 补回旧错误 | 损坏旧正确 |
|---|---|---|---|
| 原有整屏融合 | 972 | — | — |
| 改用更小切块 | 983 | 12 | 1 |
| 小块+VL 重读数字 | 983 | 13 | 2 |
| 再要求新旧数字格式一致 | 984 | 13 | 1 |
VL 把时钟 03:4 补成了正确的 03:47,却也把数量 215 改成 2.15。最后一行因此加了一个观察错误后制定的开发规则:整数、时间、比例等读数中的分隔符序列必须保持一致,否则保留旧读数。代价是原流程若连分隔符都漏掉,也可能拒绝正确的新读数。它没有查参考答案,但也不是预先冻结后的独立测试成绩。
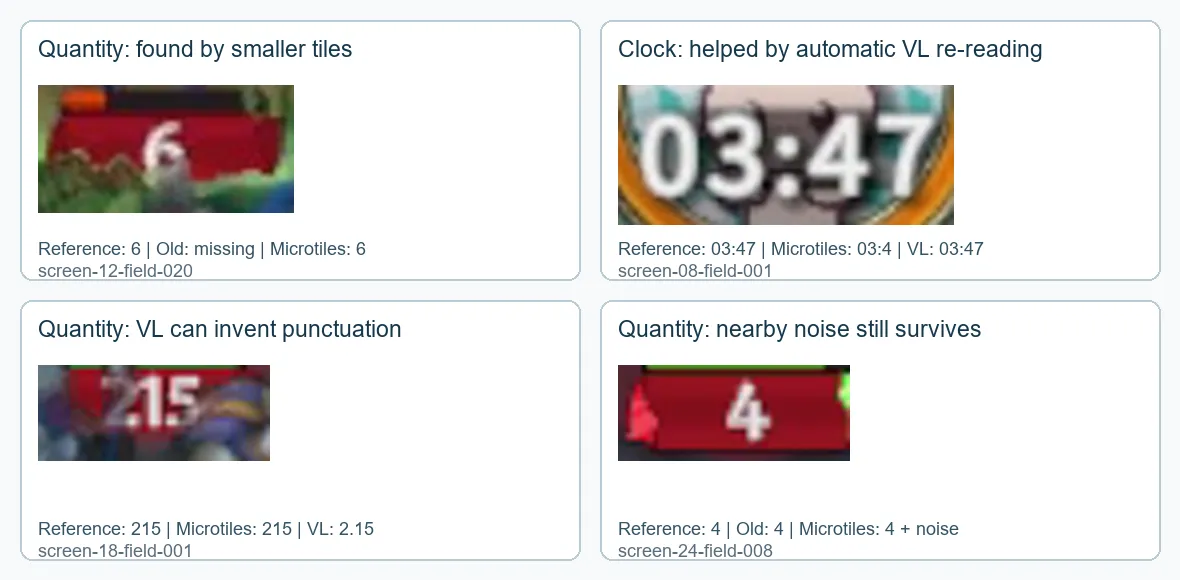
图 2:同样是“再看清一点”,结果可能是补回漏字,也可能多出标点或附近噪声。这里展示原像素的插值放大,没有生成新的笔画。
组合候选的数字是 910/939,文字仍为 74/79。其中行动条数量从 231/240 提高到 238/240,战场数量从 215/225 提高到 217/225。有提升,但远没有达到“图里所有数字都读对”:人工框下的新模型优势,大部分尚未转化成自动整屏优势。
下一步重点因此很明确:提高小数字框的覆盖与完整性,处理合并时混入的邻近噪声,再用未参与本轮调参的录像验证组合。继续加大倍率或无条件换成新模型,都不是这组实验支持的结论。所有输入、分支原文和失败项已放入标注网站的“B024 · 小字 OCR”对照页,既能看原图,也能看实际裁图;运行只使用本机 GPU。
6. 已有扫描:原配方处理了 513 张关键帧
选型完成后,首轮扫描固定使用 paddle-fused-guarded。输入是已有的 159 张跨任务精选图,加上稳定帧实验保存的 386 张候选;其中 32 张属于同一原图,合并后得到 513 张图片。清单含 31 个视频标识,但已核实其中两个是同一录像的旧名和日期名,不能把它说成 31 段独立视频。不复制原图,也没有重新采样视频或缩短稳定窗口。321 张来自这段录像,因此这不是均匀抽样的准确率测试,更不意味着所有录像的每一帧都已扫描。
先用 12 张图验证整条流程,全部成功,得到 272 条配方选中读数;随后从同一目录继续其余图片。最终 513 张全部完成、0 失败,得到 22,761 条选中读数;连同未采用的备选共保留 53,063 条候选。原始记录确认试跑的 12 张没有被重复计算。程序按来源标识轮转处理,批量输出不需要参考转写或正确框,只沿用前面已经选定的算法。
原图元数据、逐图状态和 513 个可视化文件已逐一核对,候选框均在各自原图范围内。这证明结果可追溯,不代表这些读数都正确。原来 159 张精选图虽然全部 OCR 完成,整帧语义标注完成数仍是 0;需要人工复核的内容没有因为程序跑完就被升级。
扫描器已经逐图记录 PENDING、PROCESSING、COMPLETE、FAILED,原文件变化时不静默复用旧结果。每张图片对应可读路径、视频与时刻、尺寸、模型版本、参数和所有读数;运行完成与参考标注审核是两种状态。COMPLETE 只表示这套算法跑完,绝不表示全部 UI 元素已找齐。 断点续跑只跳过同来源、同配方的完整结果。
标注网站现在有两种用途不同的查看方式:“B024 · 整屏 OCR 准确性复核”对照前面的 24 张开发参考;“战场关键帧 · 语义时间线”里的整屏 OCR 批次查看这轮 513 张图。后者支持左右键、按钮和滑条,显示每帧的扫描状态、文字框和读数,也能查看没有被选中的备选。人工参考和算法候选可以分别显示。
例如一张打开战斗日志的截图,得到 70 条选中读数,连同备选共保留 189 条候选。这样既能查到日志正文,也能回看同一画面里的时间和小数字;但文字尚未自动归属于某个生物或英雄字段。网页只在切到该帧时读取它的结果,图片载入后再显示框,避免把新框暂时画在旧图上。
本轮首先解决“哪些图已经处理、结果在哪里、怎样逐帧审查”。文字到图片的倒排索引可以在这些文字、框和来源路径上另做,不必重新 OCR。若审查后发现某类提示或数字数据不足,再明确补充对应图片,而不是先修改稳定帧规则。
本轮代码、冻结参考与测量摘要位于 perception/experiments/b024_bounded-title-ocr-benchmark/。可部署扫描实现位于 perception/src/olden_era_perception/offline_ocr/;原始输出与网站报告保存在忽略的本地数据目录,不复制成第二套媒体库。
本章主线到这里结束:先读完整图片,再谨慎补找小字,最后保存可检索、可复查的读数。接下来可以继续读英雄数字与计时。下面的小标题实验留到需要比较历史方法时再读。
实验记录:小标题 OCR 比较
展开 2026 年 9 月 6 日的 11 裁图实验
历史实验只比较预先给定的标题裁图,与上面的整屏检测分开计分;旧测量没有被新测量替换。
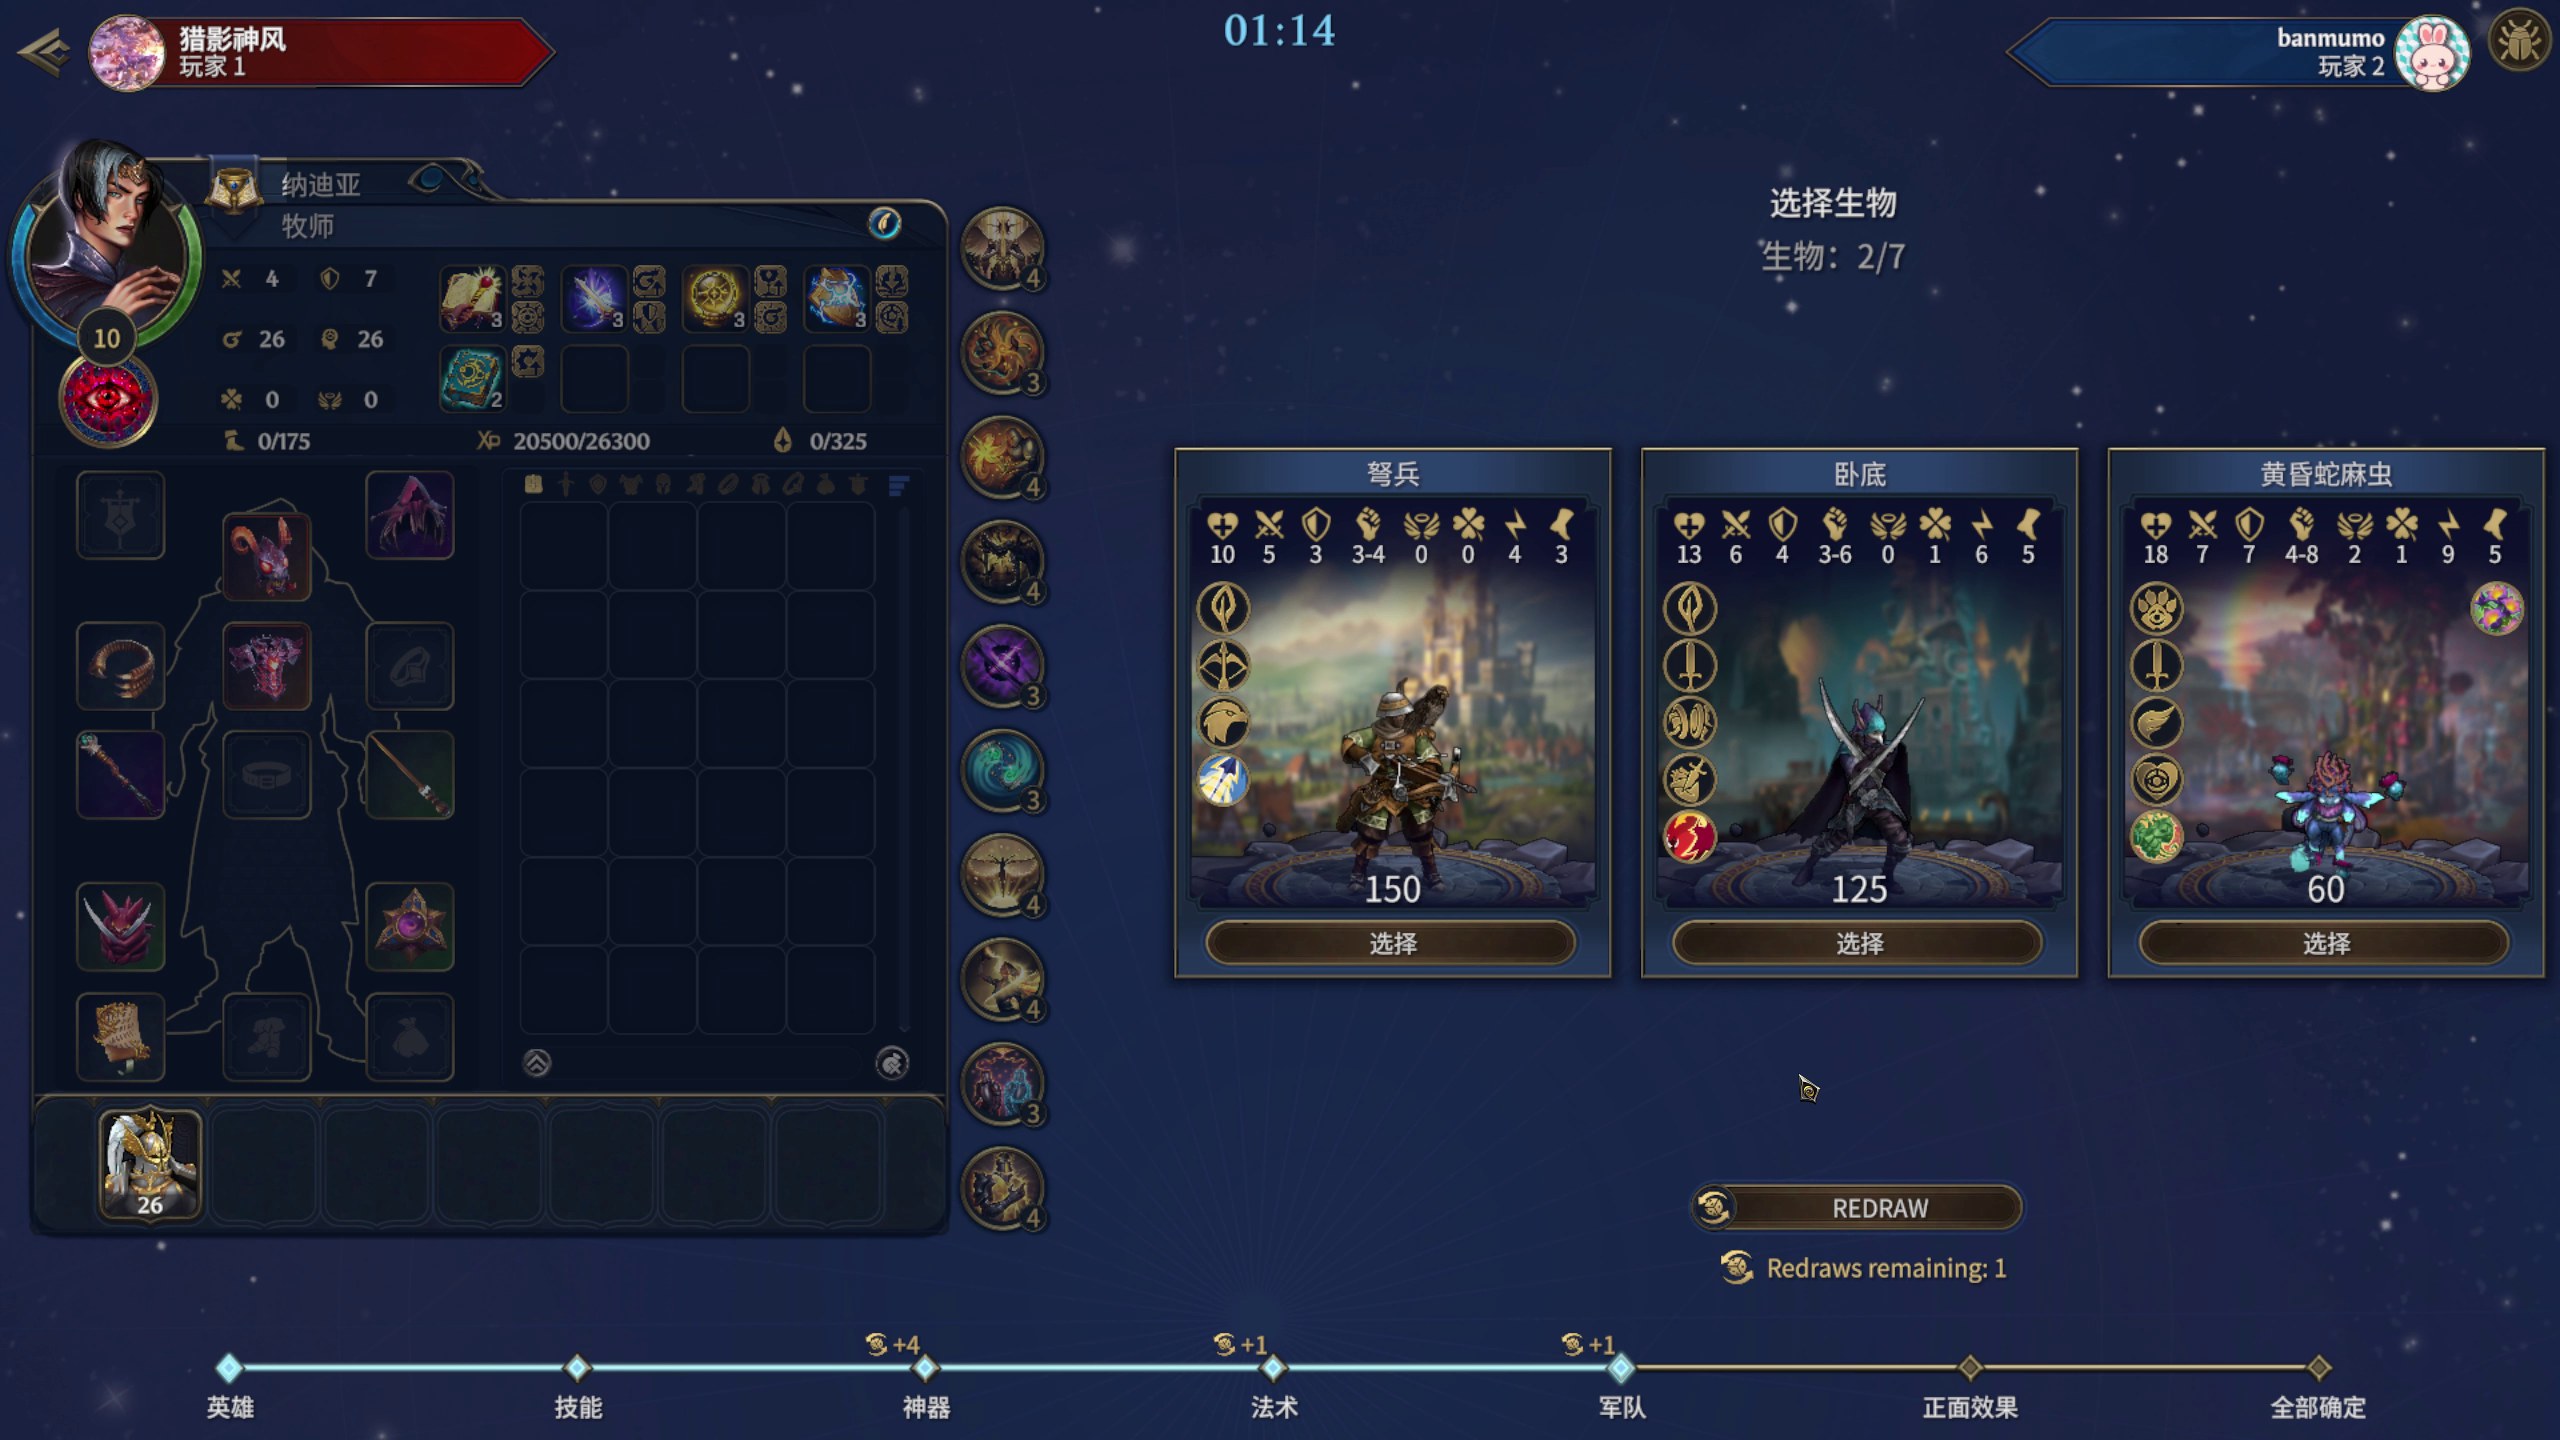
选生物的卡片在图标附近印着小标题。OCR 读错名字,可能使系统退回较弱的图像建议;标题读对,也可能错误地认证旁边一张被遮挡或不合适的图片。因此本实验分别检查文字转写和输入有效性。
本实验的输入是预先裁好的小标题条。场景、布局和裁框由实验准备提供,不是被比较的 OCR 算法预测出来的。 原始截图用于解释标题来自哪里;算法没有读取原图里的其他区域。目标是在这一有边界的工作负载上比较读字准确性与速度,再为场景内细读选默认配方。
在六个可读失败裁图上,PP-OCRv6 medium 原图识别得到 6/6 精确匹配;Windows 与 EasyOCR 的完整配方各得到 5/6。 在当前机器与配方下,Paddle 的常驻配方速度为 15.24 个源裁图/秒。六个样本只有四种不同字符串,不能据此估计总体准确率。
flowchart LR
 A[Full screenshot and supplied layout] --> B[Title strips cropped in advance]
 subgraph T[Timed OCR workload]
 C[Read title files and apply recipe transforms]
 C --> D[Text detection and recognition]
 D --> E[Raw text and scores]
 end
 B --> C
 E --> F[Outside timing: catalog selection and independent scoring]
图 3:历史实验先裁好标题条,只比较这些小图的读取方法。它不测从全图找到标题的能力。
历史输入:七个问题与十一张裁图
用户指出的七个标题/质量问题是六个可读的历史 OCR 失败,加一个被悬浮说明覆盖的标题。再加入三个被错误送入生物识别路径的法术区域,以及一个用户确认无效的标题—图像组合,共 11 个裁图、9 张完整源图。它们不是 11 个独立的生物名称。
九个标题条是 412×47,两个是 309×35;普通标题一行、规范化后 2–5 字,遮挡说明片段为 11 字。完整源帧七张 2560×1440、两张 1920×1078。这部分历史实验的 OCR 只接收标题条。 下方同时展示原图与实际输入。
| 实验条件 | 本文怎么处理 |
|---|---|
| 场景与坐标 | 预先给定;包含故意保留的错误路由,不假定全部有效 |
| OCR 接收什么 | 11 个原始标题条及各自增强变体;仍运行引擎的文字检测与识别 |
| 完整源图 | 展示和核对上下文;全图裁出标题的成本不在计时内 |
| 准确性评分 | 推理结束后,用六个可读标题的参考转写评分;另算五个负例的错误接受 |
| 目录是否参与 | 原图转写可单独评分;完整配方会用既有目录择优,须与纯 OCR 分开 |
| 速度比较 | 比较当前部署配方,Paddle 用 GPU、EasyOCR 用 CPU;不是同硬件模型排名 |
负例没有在 OCR 前被质量检查删除,否则无法观察“字读对但输入不该接受”。场景、遮挡和图像质量检查属于组合系统要补的能力,本文的负例评估没有证明这些检查已实现。全图场景识别与本实验的区别见 B021。
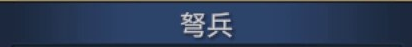
可读 1 · 弩兵
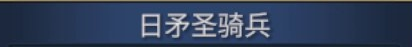
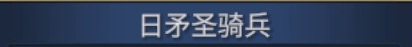
可读 2 · 日矛圣骑兵
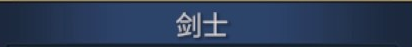
可读 3 · 剑士
可读 4 · 日矛圣骑兵
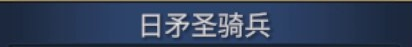
可读 5 · 日矛圣骑兵
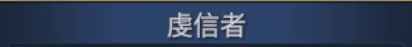
可读 6 · 虔信者
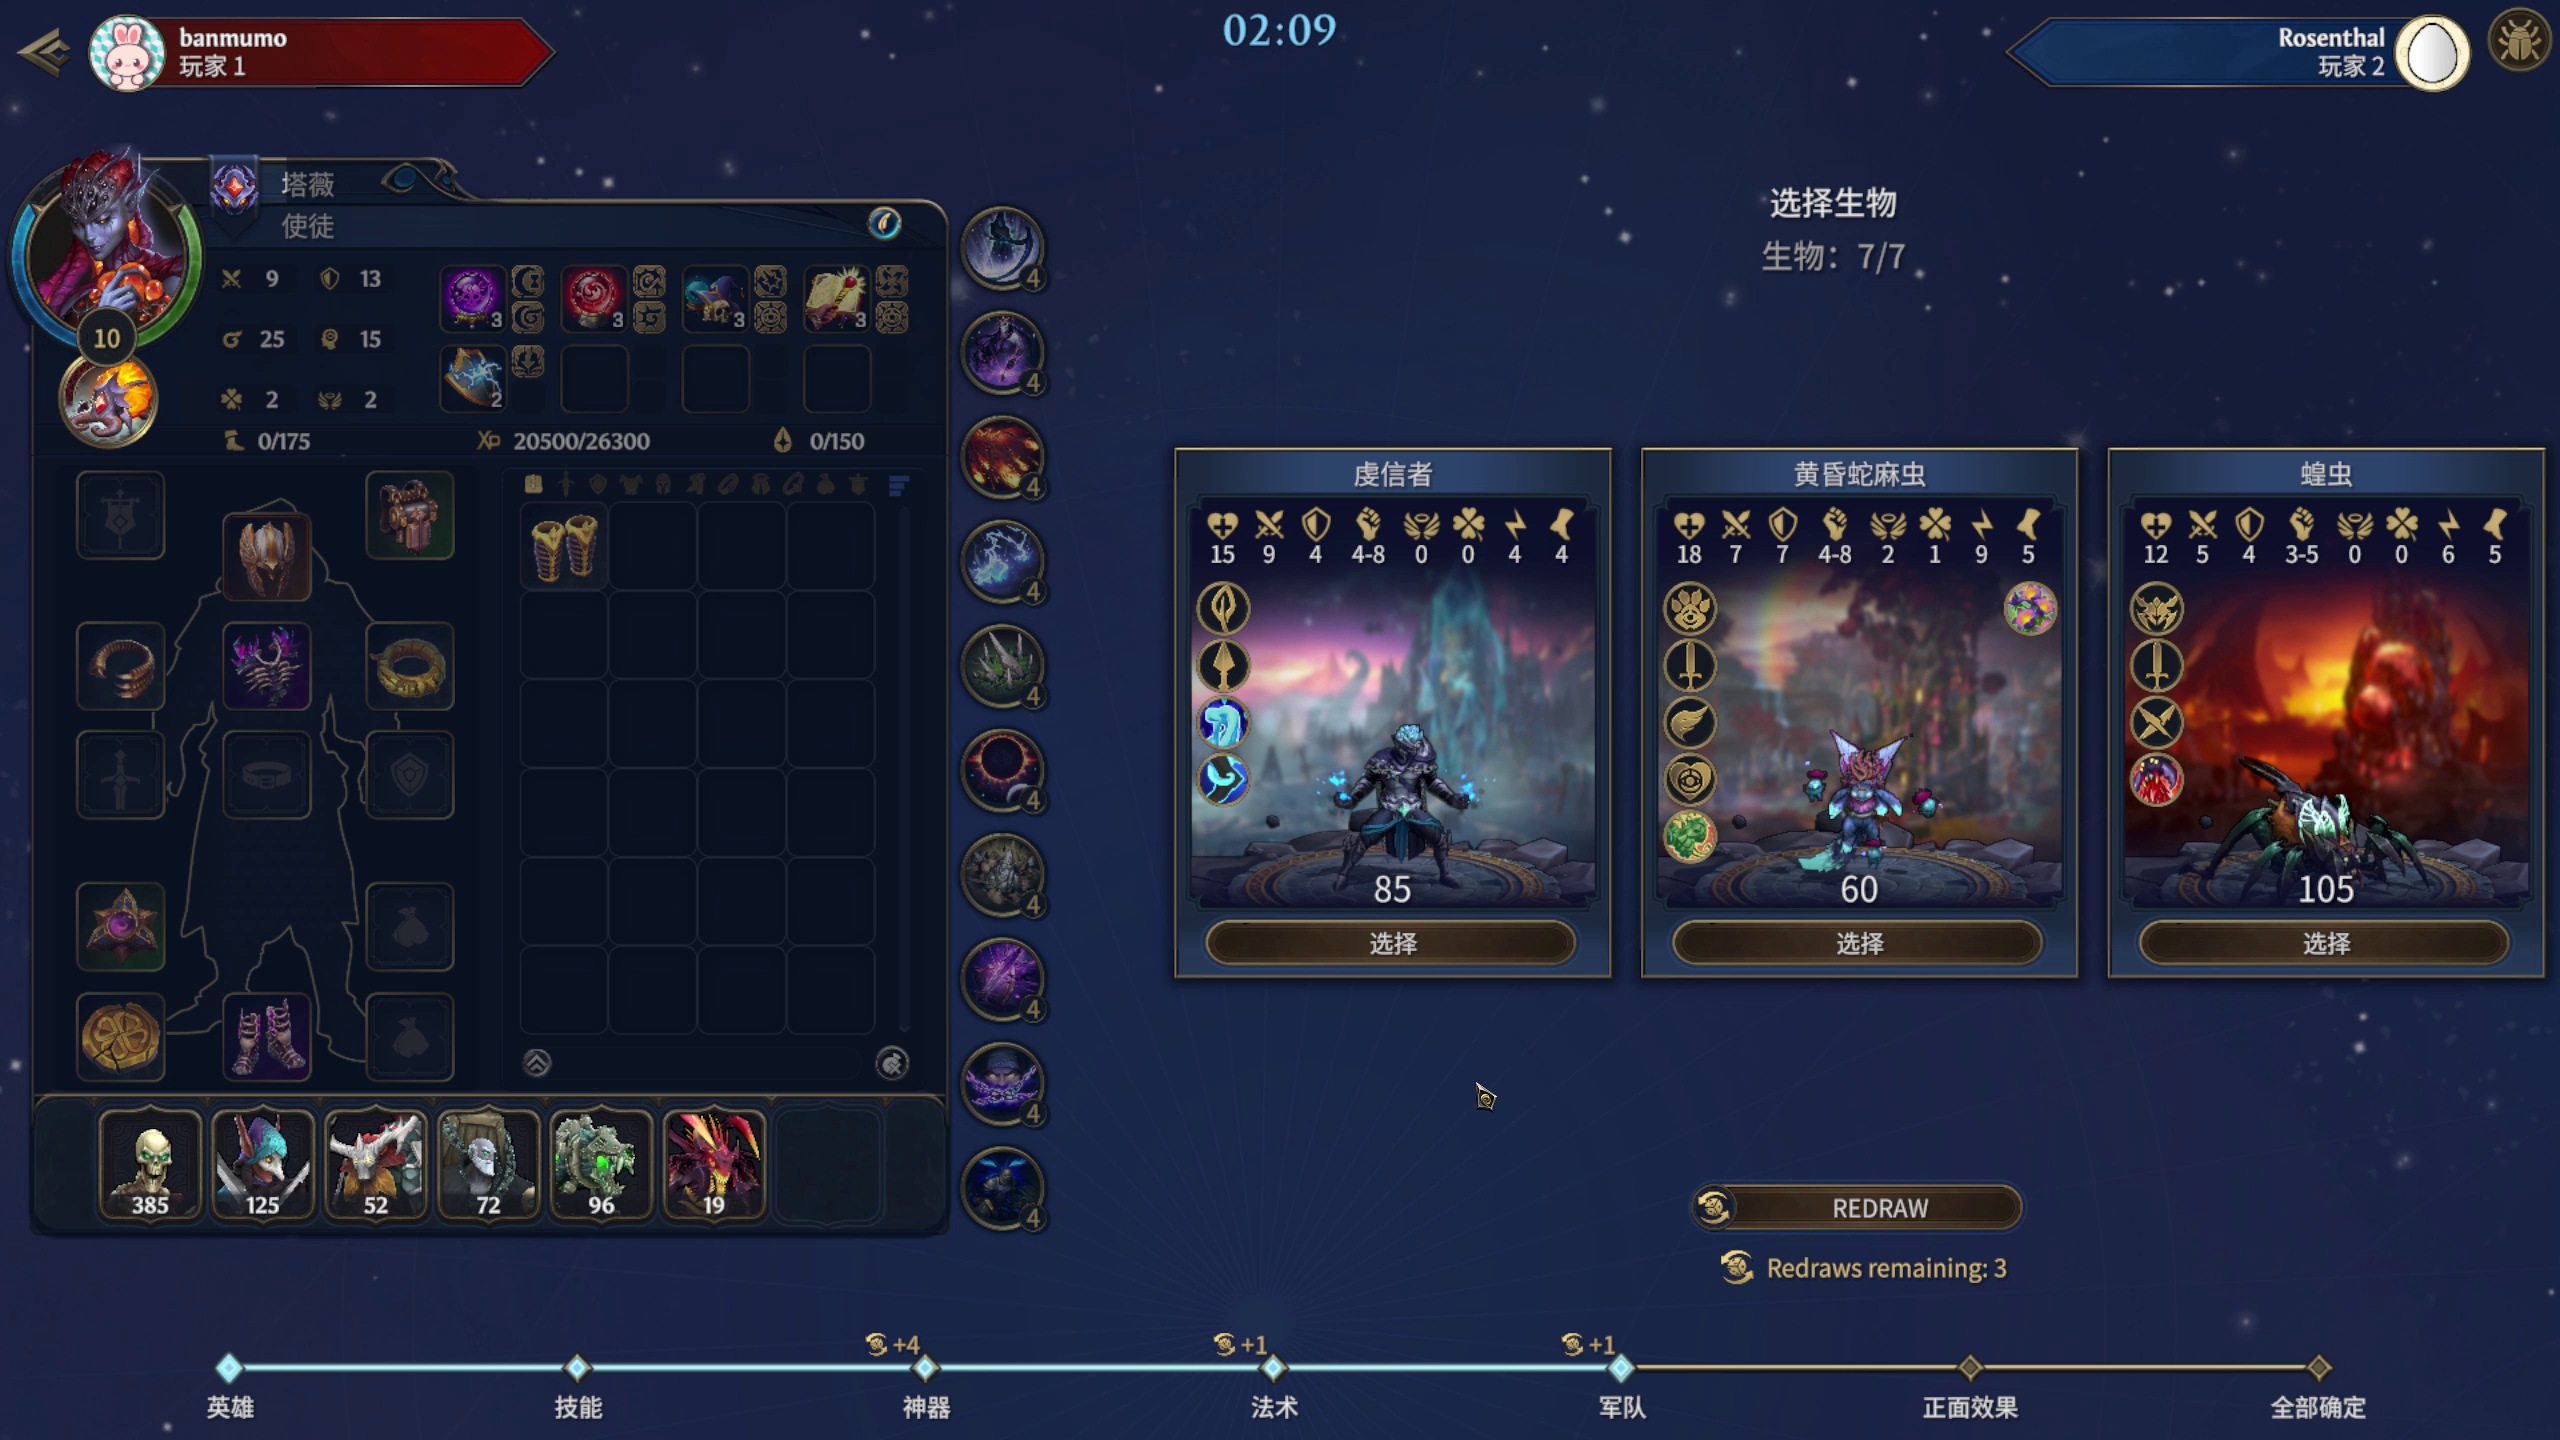
问题 7 · 标题被遮挡
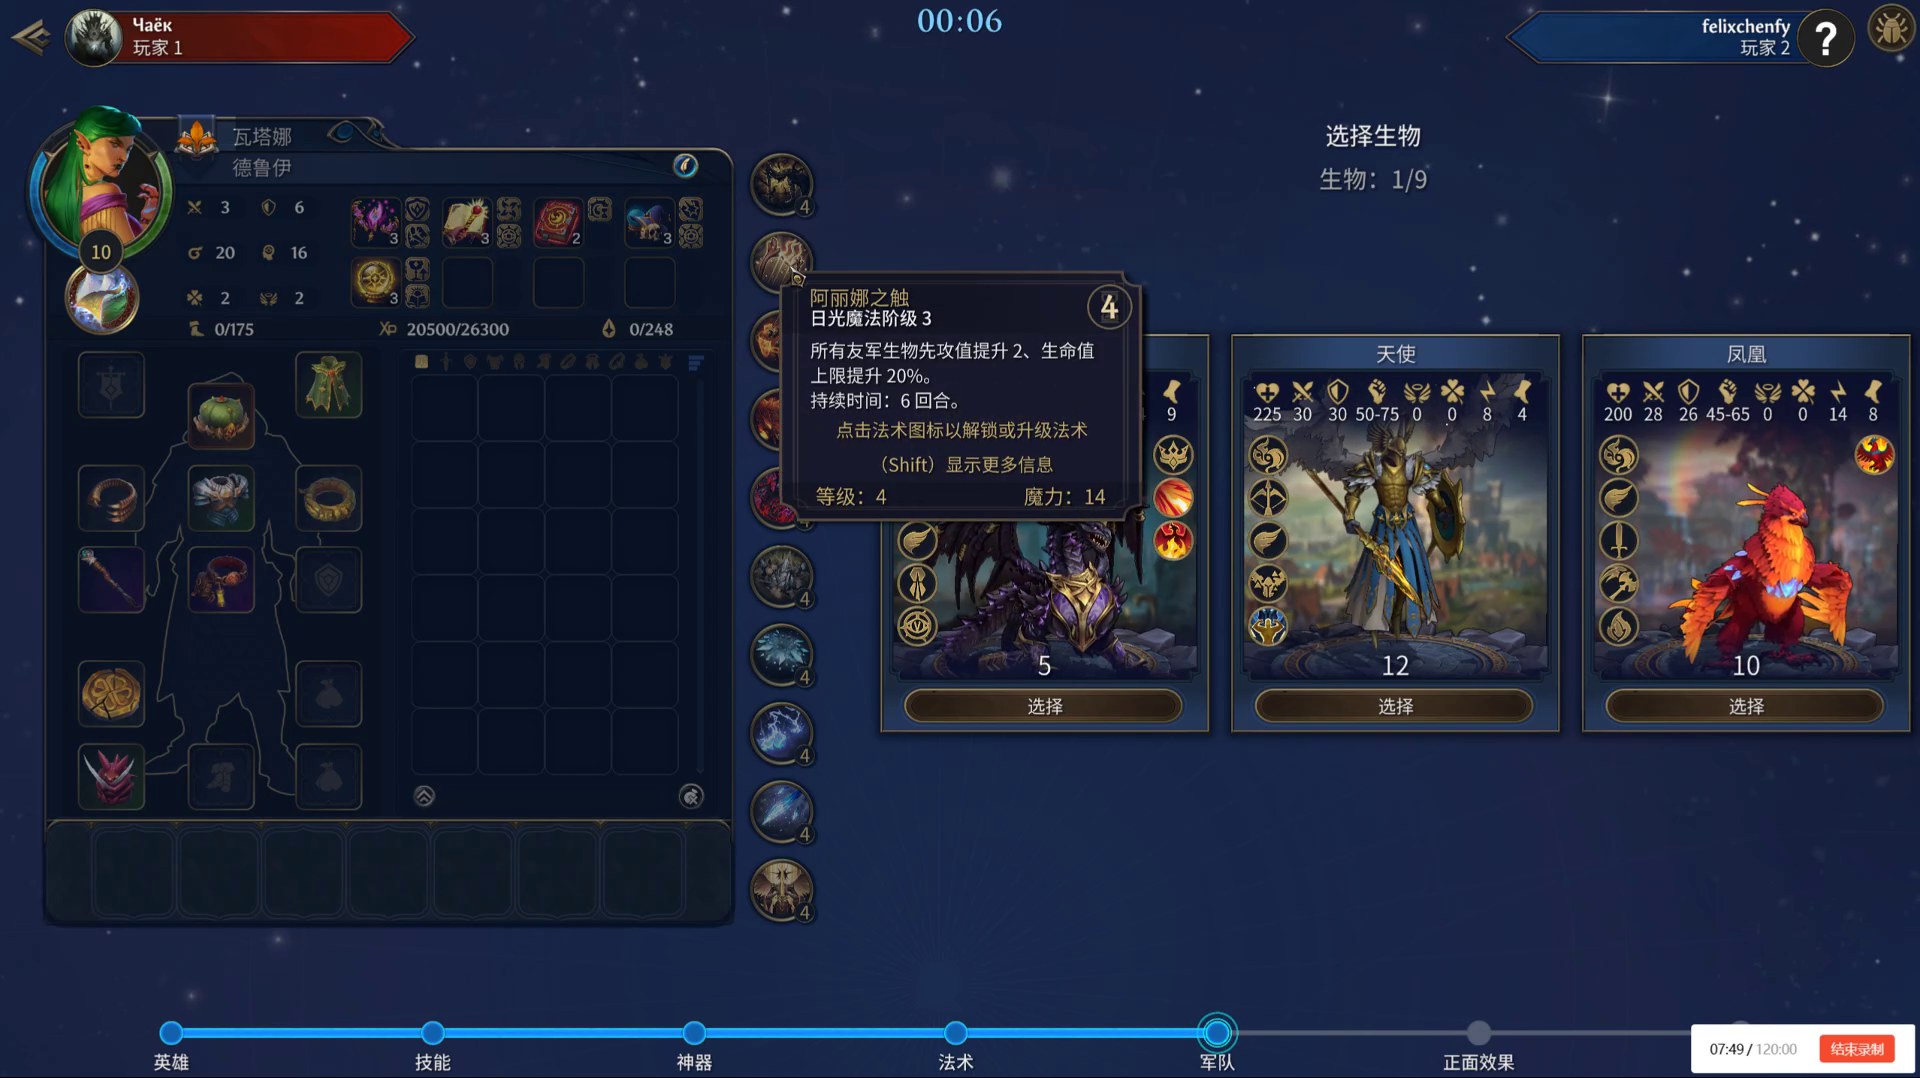
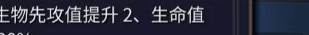
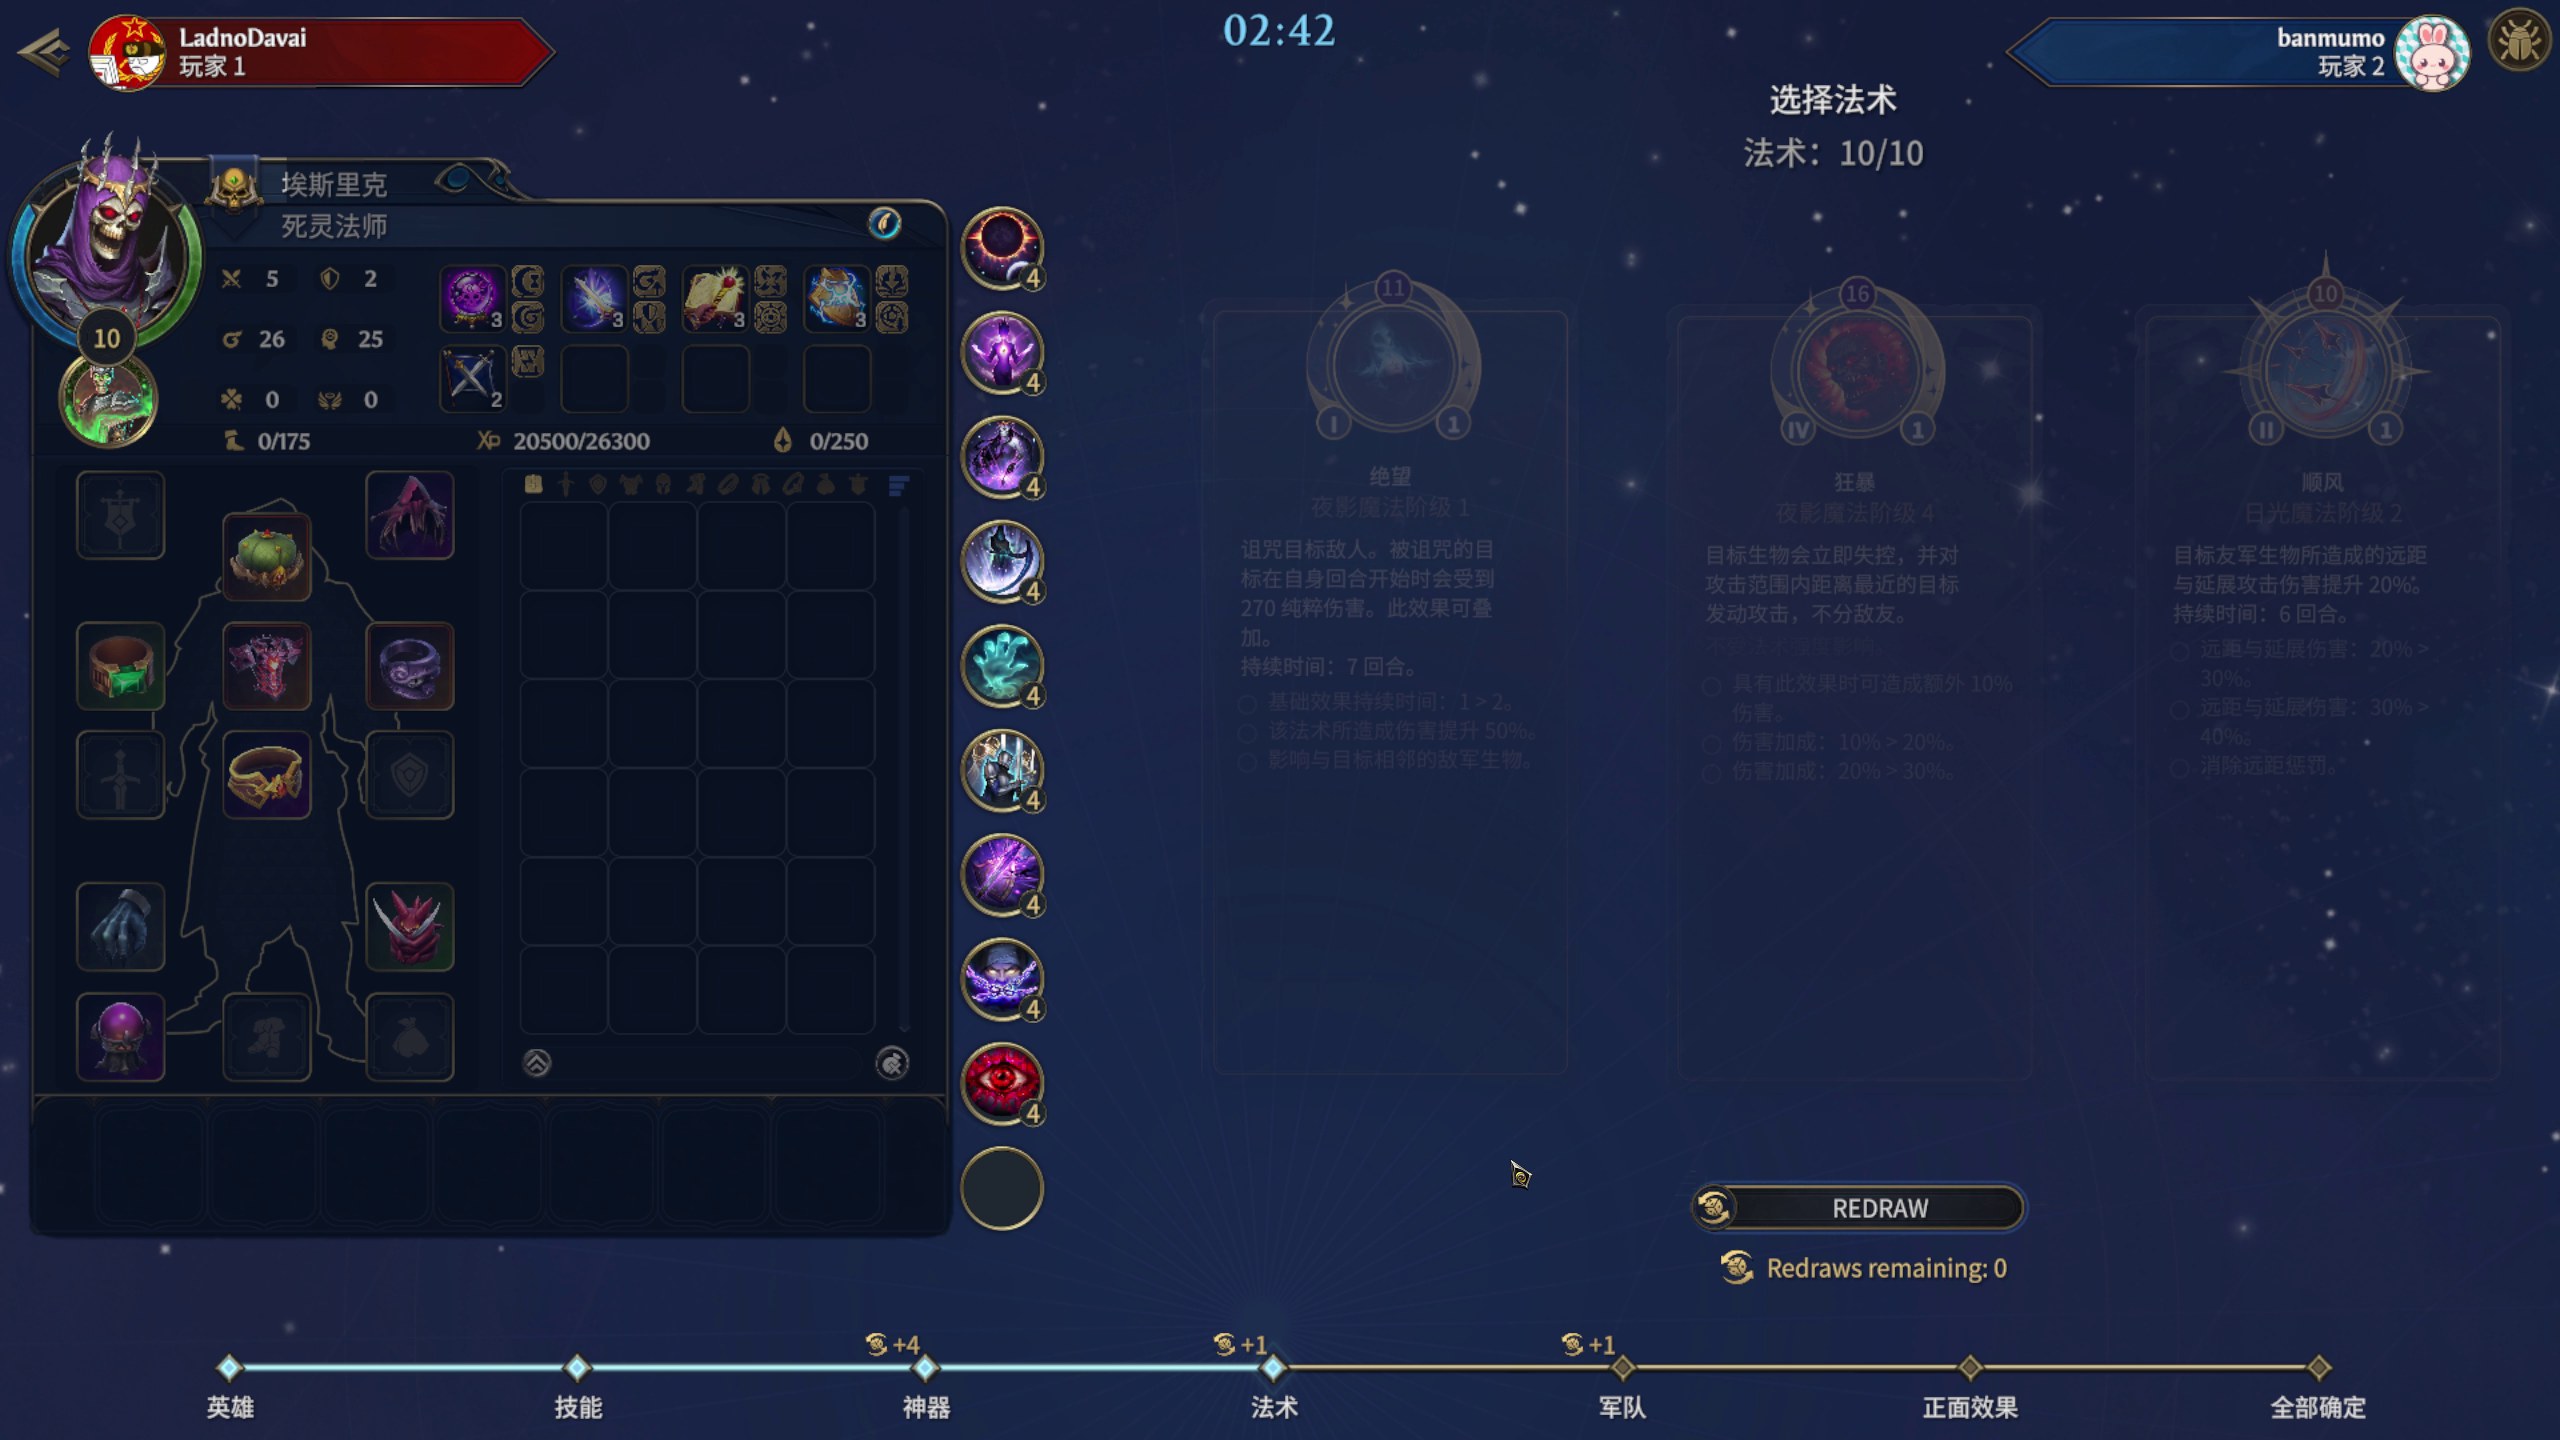
负例 · 三个法术槽
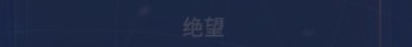
负例 · 图像目标无效
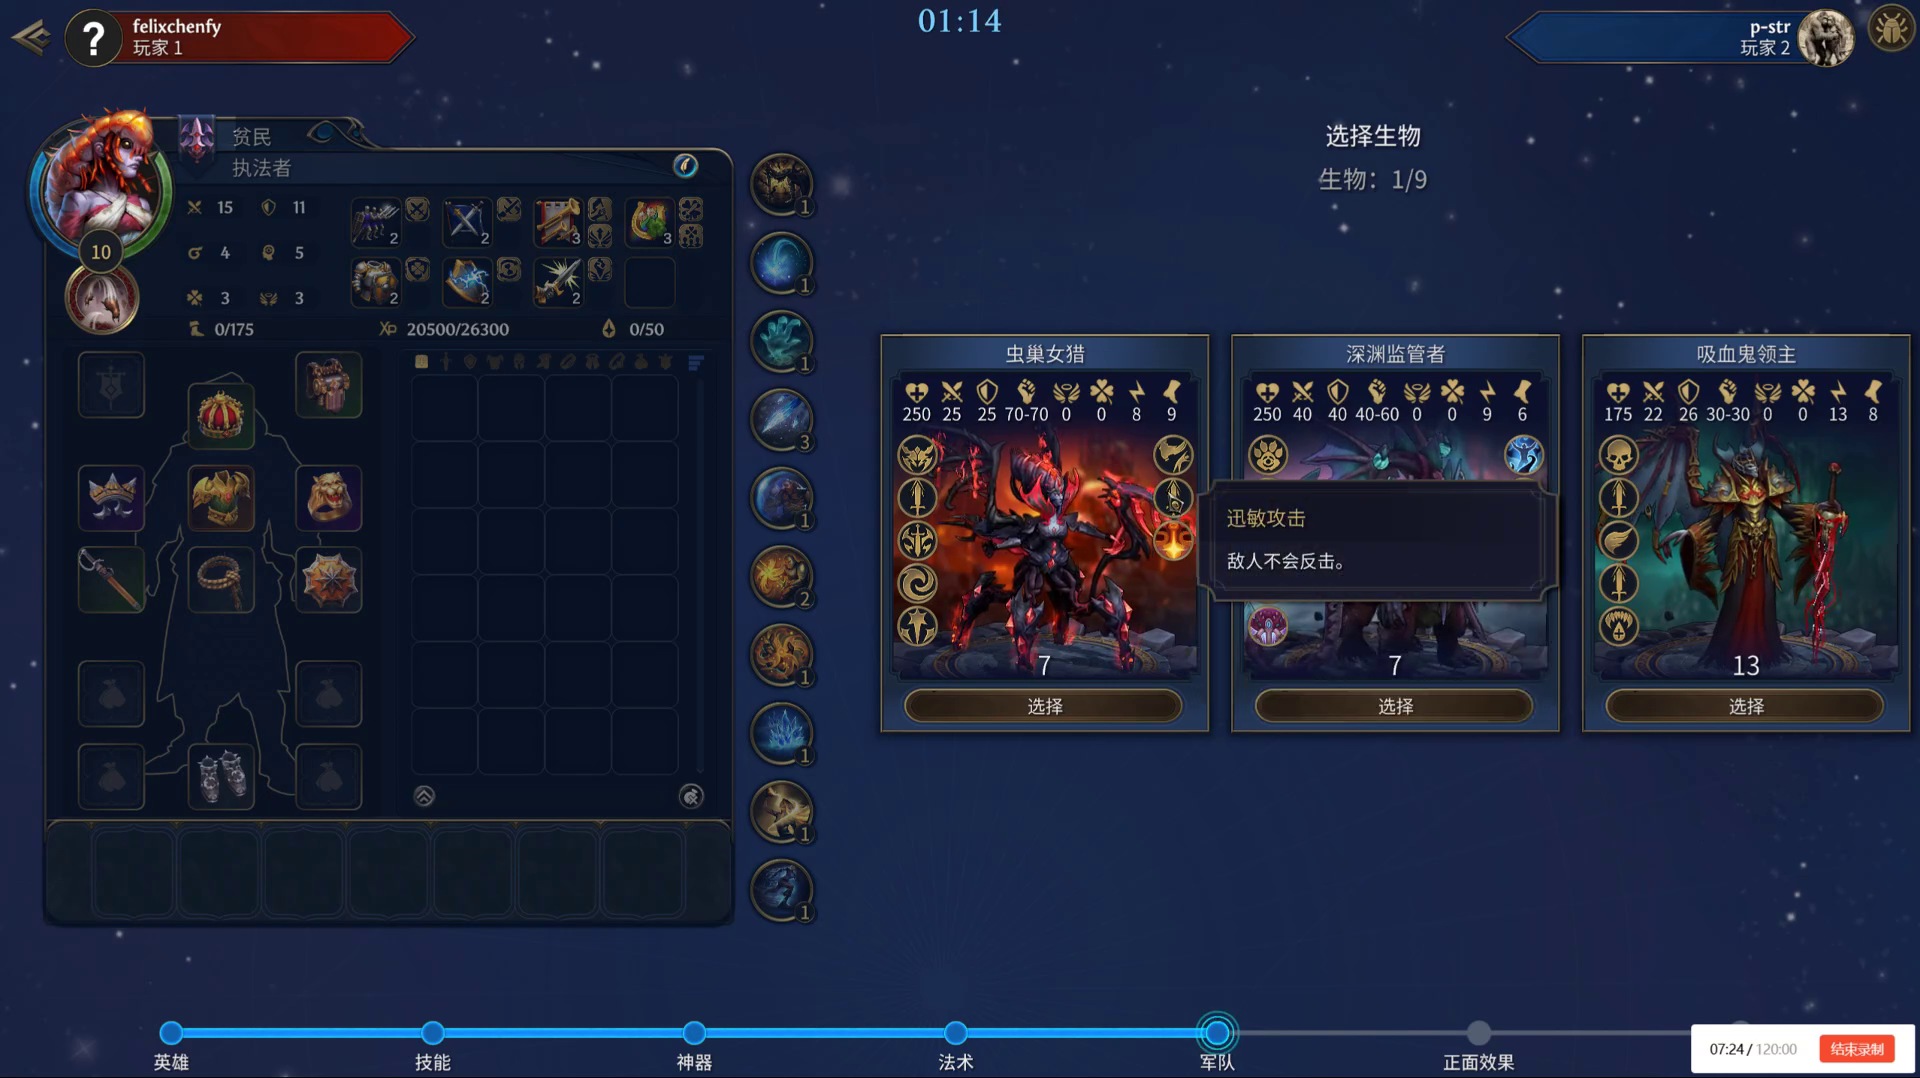
这些已知失败参与了配方选择,属于开发诊断。所有引擎处理同一组输入;没有在这组图上训练或微调 OCR。规范化采用 NFKC、大小写折叠、移除非字母数字字符及 Windows 简繁转换。期望文字只在推理完成后用于评分,选择变体则优先唯一精确目录匹配,否则按引擎分数/固定顺序保留。
历史方法:四条处理流程,三种引擎
旧标题算法是当时的 B08/旧 B021、现归 B023 的 Windows OCR 路径:固定裁图、三倍 cubic 放大、按图像中位颜色补 24 像素边,再送系统简体中文 OCR;未匹配时重试灰度 CLAHE,之后查双语目录。B024 Windows 仍用同一系统引擎,但增加了原图与多种增强对照。
| 路径 | 检测与识别 | 输入变体 | 本次运行 |
|---|---|---|---|
| 历史 Windows 路径 | 不公开内部网络的系统 OCR | 3× 彩色,必要时灰度 CLAHE | 保存的历史结果 |
| B024 Windows | 相同系统引擎 | 原图、4× Lanczos、4× CLAHE、4× Otsu | 本地 Windows |
| PP-OCRv6 medium | PPLCNetV4/RepLKFPN 检测,PPLCNetV4/LightSVTR 识别,CTC/NRTR 多头 | 原图、3× CLAHE | PaddleOCR 3.7.0,GPU |
| EasyOCR 1.7.2 | CRAFT 检测、中文 generation-2 CRNN,beam width 10 | 原图、4× CLAHE | PyTorch CPU |
CLAHE 增强局部对比度;Otsu 把灰度分为两类;放大改变字形采样。这些预处理本身有成本,不能只报模型 forward 的时间。四条路径登记在 perception/configs/ocr-pipelines-v1.json,并非四个不同的神经网络。
历史耗时:启动与识别分别多快?
机器为 Ryzen 9 9900X / RTX 5080。三个当前引擎各运行三次,每次从原始标题文件开始、启动新进程;模型文件已缓存,不是清空操作系统/磁盘缓存。启动端到端包括解码、增强、文件 I/O、进程、导入、模型创建、预热、推理和 JSON 输出,排除后续目录选择与评估。
常驻配方 = 父进程预处理 + worker 预热后的批次计时,是逐次测量后重建的和;不是直接计时的常驻服务请求,不含最终目录选择、响应序列化及服务分发/IPC。下表每个批次均为 11 个源裁图,p50/p95 则是单次 OCR 尝试,不能混为每个源裁图的延迟。
| 引擎 | 每批尝试数/输入像素数 | 父进程预处理 | 启动端到端 | 常驻 worker | 常驻配方 | 完整配方处理的源标题条/秒 | 单次 OCR p50 / p95 |
|---|---|---|---|---|---|---|---|
| Windows | 44 / 9,599,394 | 0.198 s | 1.397 s | 0.771 s | 0.968 s | 11.36 | 5.17 / 9.55 ms,n=132 |
| PP-OCRv6 GPU | 22 / 1,959,060 | 在 worker 内 | 6.214 s | 0.722 s | 0.722 s | 15.24 | 23.16 / 54.02 ms,n=66 |
| EasyOCR CPU | 22 / 3,330,402 | 0.115 s | 9.876 s | 4.225 s | 4.341 s | 2.53 | 144.85 / 358.22 ms,n=66 |
分位数合并三次测量的全部变体尝试,排除预热;Windows 是 11×4×3 次,其余是 11×2×3 次。Windows 单次最快,但每源图做四次尝试;Paddle 做两次,常驻整配方吞吐更高。EasyOCR 只用 CPU,不是与 Paddle 的同硬件推理对决。
已测启动阶段中位数:Windows PowerShell 初始化 106.9 ms、引擎创建 7.7 ms、预热 97.7 ms;Paddle 导入 2.589 s、创建 1.209 s、预热 0.468 s;EasyOCR 导入 3.165 s、创建 1.486 s、预热 0.108 s。各阶段中位数不能直接相加等于总中位数,剩余还包含进程、I/O、IPC 和序列化。
输入尺寸影响明显:EasyOCR 从 412×47 的 53.78 ms 升至 1648×188 的 330.58 ms;Windows 从 1.03 升至 6.12 ms;Paddle 从 412×47 的 21.74 升至 1236×141 的 24.96 ms。这些是按尺寸分组的单次调用中位数。
文字数量也可能影响后续识别和解码,但这里主要是单行短标题,不能独立估算“每个字多少毫秒”。按识别到的 2/3/5/11 字分组,Paddle p50 为 23.11/24.09/22.59/42.00 ms;EasyOCR 为 190.17/191.93/144.85/153.58 ms,并不单调。严格实验应固定像素、字体、预处理,再改变行数和字数。
B021 的全图双通道 PP-OCRv6 历史批次为每 320 帧 210.494/191.235 秒,约 657.8/597.6 ms 每源帧;Windows 旧全图批次约 135.5/136.0 ms。旧 v1 因几何投影失败标为 partial,v2 复用 OCR 的投影时间不能当作新识别耗时。固定标题旧大批次 877 帧、2,782 个标题及 318 次增强重试用了 97.55 秒,未分冷暖,也不是本次相同工作量。这些记录说明必须同时看输入大小、调用次数和计时边界。
历史结果:字读对了,图片也可用吗?
| 标题 | 历史 Windows | B024 Windows | PP-OCRv6 | EasyOCR |
|---|---|---|---|---|
| 弩兵 | 无文字 | 弩兵 ✓ | 弩兵 ✓ | 弩兵 ✓ |
| 日矛圣骑兵 | 日矛圣马奇兵 | 正确 ✓ | 正确 ✓ | 正确 ✓ |
| 剑士 | 无文字 | 剑士 ✓ | 剑士 ✓ | 剑 ✗ |
| 日矛圣骑兵(后续帧) | 日矛圣马奇兵 | 正确 ✓ | 正确 ✓ | 正确 ✓ |
| 日矛圣骑兵(另录屏) | 日矛圣马奇兵 | 正确 ✓ | 正确 ✓ | 正确 ✓ |
| 虔信者 | 信者 | 信者 ✗ | 虔信者 ✓ | 虔信者 ✓ |
| 引擎 | 仅原图精确 | 仅增强分支选择精确 | 完整配方选择精确 | 任一变体精确 |
|---|---|---|---|---|
| Windows | 4/6 | 5/6 | 5/6 | 5/6 |
| PP-OCRv6 | 6/6 | 6/6 | 6/6 | 6/6 |
| EasyOCR | 5/6 | 5/6 | 5/6 | 5/6 |
增强分支与完整配方使用目录辅助选择;任一变体精确是事后 oracle 诊断。Paddle 的原图 6/6 不依赖目录在多个变体中择优。EasyOCR 原图把剑士读成剑土,增强后为剑,二者都不精确。历史修复中,日矛圣骑兵应查到阳矛骑兵/Sunspear Cavalry,而不是旧图像回退的贵族骑兵;虔信者对应誓信徒/Votary。
| 错误送入生物路径的区域 | Windows | Paddle 文字/分数 | EasyOCR 文字/分数 | 生物路径 |
|---|---|---|---|---|
| 法术绝望 | 绝望,无分数 | 绝望 / 0.9999 | 绝望 / 0.8931 | 拒绝 |
| 法术狂暴 | 无文字 | 狂暴 / 1.0000 | 狂暴 / 0.6904 | 拒绝 |
| 法术顺风 | 顺风,无分数 | 顺风 / 0.9999 | 顺风 / 0.9732 | 拒绝 |
这些主要是 OCR 成功而场景路由错误,不应笼统叫 OCR 错误。Paddle/EasyOCR 提供识别分数,但它不是校准过的正确概率,不同引擎不可直接比较。Windows 这条桥接接口没有返回置信值。
遮挡正文的 Paddle 分数仍有 0.9830,不能恢复被挡住的标题。另一个无效图像目标旁的深渊监管者被所有引擎正确读出,Paddle/EasyOCR 分别为 0.9998/0.9945,目录也命中,但用户确认配对图像无效。因此五个负例中,纯 OCR+生物目录均拒绝四个、误接受一个。文字准确与配对有效性必须分开计算。
| 负例来自哪里 | 数量 | 本次 OCR+生物目录的决定 | 暴露的问题 |
|---|---|---|---|
| 法术页误走生物路径 | 3 | 全部拒绝生物身份 | 文字可能完全正确,但对象类型不对 |
| 标题被说明文字遮挡 | 1 | 目录不匹配,拒绝 | 读到了可见正文,原本标题仍不可见 |
| 名称正确、配对图像无效 | 1 | 错误接受 | 目录匹配无法认证图像可用性 |
所以“拒绝4/5”是这组混合系统负例的决定统计,不是 OCR 的通用特异度。前三个检验类型路由,后两个检验输入/配对有效性;组合系统需要分别记录失败来源。
历史结论与公开指标的区别
Paddle 官方 OCR 文档公开报告 medium 检测 Hmean 86.2、识别平均准确率 83.2,来源为内部多场景集,是公开披露而非可独立复现的统一公开测试集。官方端到端表在 200 张通用/文档图上报告 medium:A100 0.29 s/图、V100 0.72 s/图、Xeon 8350C 2.05 s/图,含加载与处理,不能直接比较我们的短标题条。
EasyOCR 仓库没有一张统一覆盖本次中文权重、预处理和解码配置的准确率/速度表;CRAFT和 CRNN论文的组件基准也不是完整 EasyOCR 包的成绩。Windows OCR API说明接口与语言模型选择,没有本机中文引擎的统一准确率/延迟基准。
当时选择 PP-OCRv6 medium 作为小标题主识别路径,Windows 保留为启动快的备选,EasyOCR 保留离线回归比较。这个集合没有 Windows 挽救 Paddle 错误的案例,不能宣称后备已经增加召回。更复杂或更高分数也不能越过场景不匹配、遮挡和无效图像的检查。
当时建议的后续标题实验是:预先冻结其他录屏中 100–300 个标题机会,包含普通正确项、难例、错误路由和无效目标;报告原文精确率、字符错误率、错误接受/拒绝、含全部预处理的常驻服务 p50/p95,以及跨帧重试效果。旧七个问题当时已回到 Needs Review 为修复草稿,那是操作历史,不等于现在都已人工确认。
本节历史代码与紧凑记录同样位于 B024 目录。旧标题部分沿用既有回执与原图,没有重新计时;2026-09-10 新做的整屏实验见本文前半部分。
Comments