P43 · 自动面板区域 · 实验记录与相关篇目
开发原型:已加入法术、能力说明和生物列表。局部原图重读明显改善小数字;最新4源24图对照中,VL读对20个字面,但强制读取错误上下文也产生24个不该绑定的值。当轮仍有半透明误放行;后续已修复一个已知反例,泛化未验收,默认未切换。
在《英雄无敌:上古纪元》的战斗中,打开一个生物的资料,会出现数量、生命、攻击、防御等数字。整张截图里还有英雄、其他部队和技能栏的数字。AI 要读懂这些信息,首先必须找到正确的面板和字段,不能看到一个 25 就把它当成攻击力。
前一篇实现了“给定正确区域后读取字段”。这一篇让程序从整张截图已有的文字识别结果中自动找区域:先确认几处名称和布局线索,再把区域交给同一个严格读取器。定位与读字分别评分:先问有没有找到正确区域,再问区域里的字读对了没有。
本章较长,可以沿三个问题读:先看如何自动找区域,再看小格重读为什么有用也会错,最后看缺少数量时为什么不该丢掉整个面板。书页与悬浮说明是后续扩展,各轮分母分开保留。当前生产接线与已知半透明反例修复看P40,不必从历史实验猜当前状态。
截至9月24日,后续接线已补回两张稀疏书页的已知漏槽,同批字段相符由35/48到43/48;另外三张开发图也补出了中央字,39个无中央字位置未多报。书顶的163/270等重复资源按CTO要求不再单独优化,由英雄面板负责。 下文20/22等是当时的实验分母,保留不重算;不能把旧文里的“尚未接通”误读成今天仍全部没做。当前状态见P60。
前面三轮实验反复暴露同一个问题:字读对了,不代表这一刻适合采用它。局部重读可以减少邻格和图标的干扰,但统一放大和要求四遍全都一致,效果都没有更好。下面先解释怎样找区域,再看改进和失败。
悬浮说明实验补上了自动找法术提示框这一步,也发现一些“不同读法”只是切块截断文字造成的。能力说明扩展沿用这个经验;最后的生物列表则暴露另一类错误:字读对了,也可能放错了字段。
三轮结果速览:每轮都更换了检查录像
首轮在另外 4 段录像的 26 张原图上测试:42 个允许读取的数字字段中,21 个精确读对、21 个没有输出,没有接受错误数字。但也发现一个关键问题:淡出面板上的文字可以完全读对,面板却还不应该放行。 固定坐标与锚点平移的成绩相同,当前证据尚未显示平移方案更好。
随后冻结 V2,在另外4段录像的24张图上检查:数值精确匹配为26/46,同一批图上的冻结 V1 为19/46。新版本改善了部分区域和字段接口,但仍漏放行同一张翻页魔法书上的两个字段。本文保留首轮结果,在第二轮说明修改、独立检查和失败,避免把开发回归误当新测试。
最新的第三轮加入合并文字的布局线索和魔法书排列检查。在再次更换的4个视频、24张图中,V3数值精确32/41,同组V2为31/41;仍有一张半透明生物面板的5个字段不该提交却被放行。它们文字都读对了,说明下一步不能只靠OCR精度或背景颜色判断可用性。
flowchart TB
 A[Existing full-frame text] --> C[Panel text and layout cues]
 B[Battle and transition checks] --> C
 C --> D[Locate field regions]
 D --> E[Read valid fields]
 E --> F[Reading or abstention]
 F --> G[Keep identity and source]
图 1:子场景名称和人工字段框不进入这条推理链。上游仍提供“当前属于战场”以及过渡、断线等画面条件。
1. 全图 OCR 已经读了文字,还缺什么?
OCR 输出每段文字、它在原图中的矩形位置和引擎分数。它可以读出 42/68、19/25、24、25,但不会自动知道第一项是部队数量显示、第二项是单体生命、后两项是攻击和防御。也不能因为两处都写着同一个生物名称,就认定它们是同一支部队。
这里的输入是 2560 × 1440 原图对应的缓存全图 PP-OCRv6 结果,包括原始图与放大增强两个预处理分支。实验没有再次解码视频或运行 OCR,也没有把人工选定的小裁图交给识别器。程序只在这些既有文字上做位置分析和字段解析。
以上是 V1 的输入范围。V2 另读取同一张原图的 RGB 像素,检查生物面板内部的背景外观;文字仍来自原有全图 OCR,没有对小框重新识字。
上游提供大场景与画面条件;具体打开的是英雄资料、生物资料、魔法书还是日志,由本实验查找。名称目录只提供已有英雄、生物、法术与能力的名字和别名,不能提供这张图应有的攻击力或生命值。期待值只在推理结束后用于评分。
2. 用多个线索确认面板,再放置字段区域
一个名称不够可靠:它也可能出现在战斗日志或悬浮说明里。我们要求几个线索的位置相互符合,才产生面板候选。
| 面板 | 共同出现的线索 |
|---|---|
| 生物资料 | 阶级文字、上方名称、左侧数量分数及下一行生命分数 |
| 英雄资料 | 目录里唯一的英雄名称、其下职业名称、下方两处资源分数 |
| 魔法书 | 多个法术名称沿水平行排列,并有书内资源分数 |
| 战斗日志 | 多条带时钟的长文字,左边缘基本对齐 |
找到线索之后,两种方法使用相同的读取器。固定坐标保留开发图中的英雄、生物数值区域;锚点平移根据当前标题的位置整体移动这些区域。比如生物面板下移时,生命、攻击和防御的小框应随它一起下移,而不是继续读原来的战场位置。
这是一项局部对照:两种方法共用面板存在判断,以及魔法书、日志和侧栏分支。它们不是两种训练好的目标检测器,也没有学习所有可能的窗口缩放。当前模板假定完整的 16:9 游戏画面;其他宽高比会明确拒绝。
返回的面板大框用于圈定布局范围,不能作为面板边缘分割结果。读取器实际使用内部的小字段框。它保留两个 OCR 分支的原始读法,冲突或缺字时输出拒识,不从知识库补一个看似合理的数值。
3. 从生物资料读到一个有来源的值
下面是开发录像第 502.061 秒的原图。名称下面有“阶级:3”,左侧有数量和生命两处分数;这些共同建立生物面板候选。
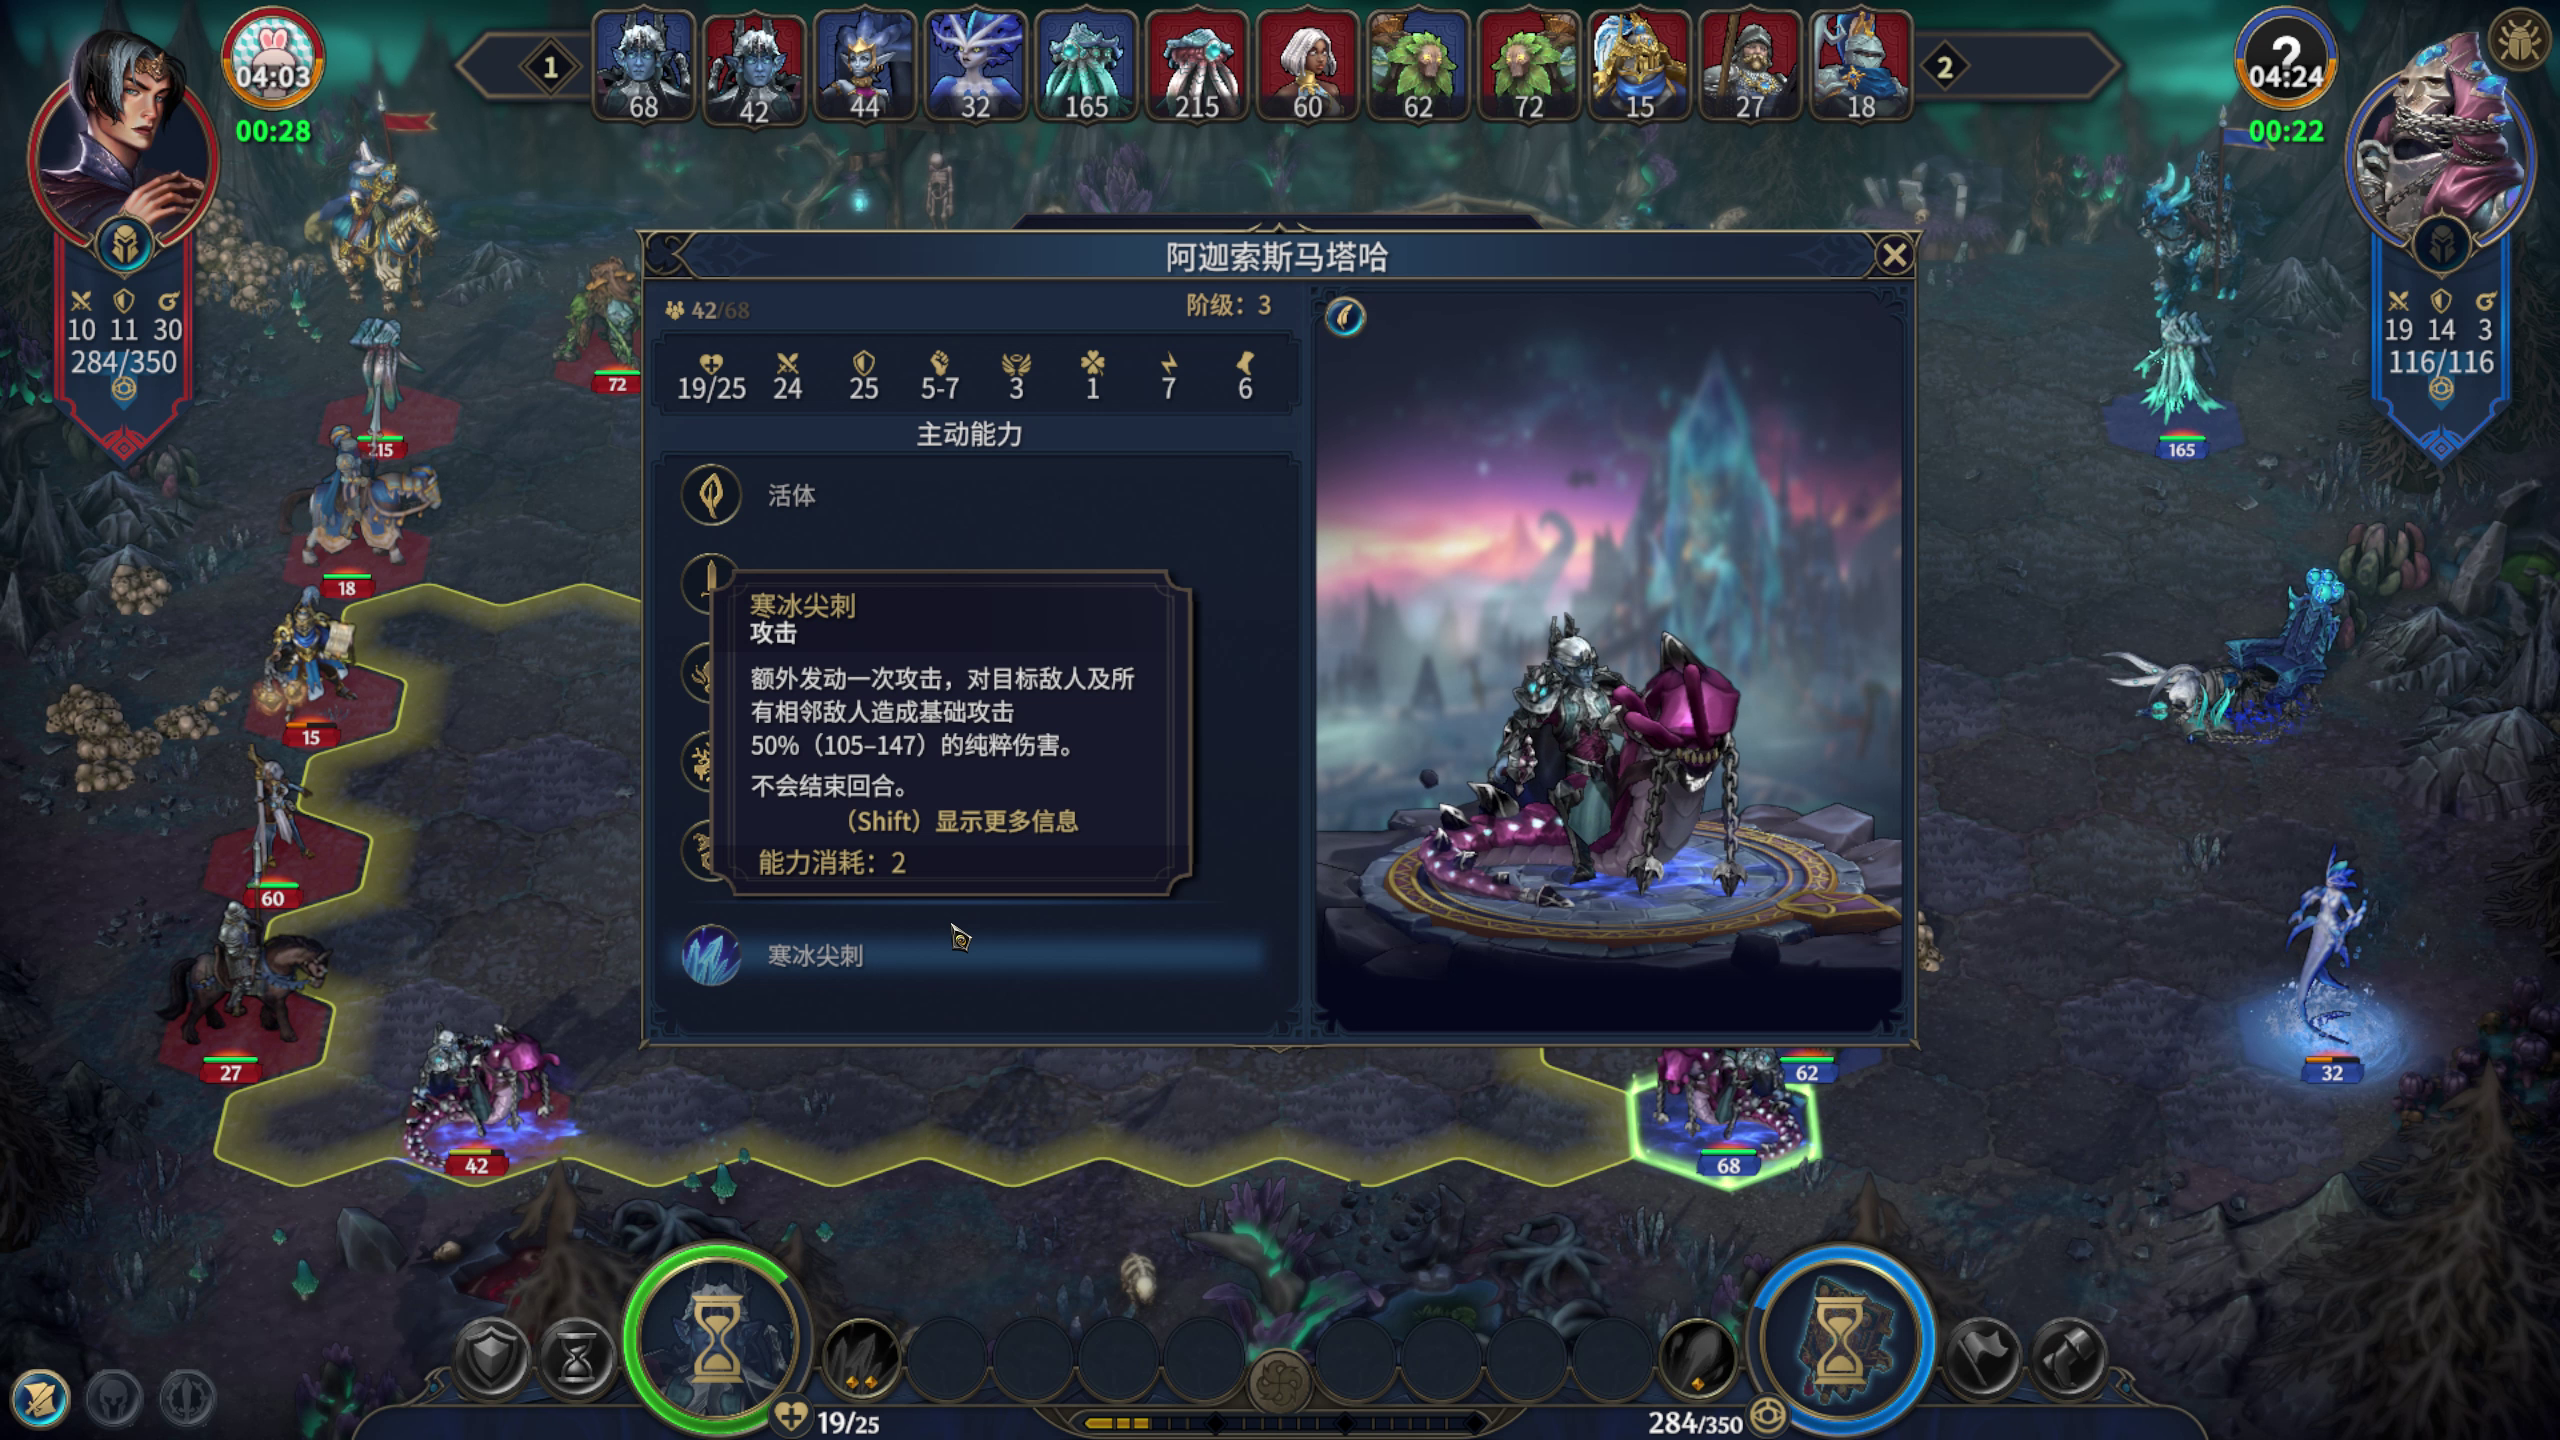
读出“阿迦索斯马塔哈”后,名称组件到既有知识库中做按类型限定的精确名称或别名匹配。成功后得到一个生物种类ID;画面时间、原图路径、OCR行和字段区域也一起保留。因此以后可以沿着结果返回这张原图,核查 24 读自哪里。
这里仍不能确定打开的是我方还是敌方同种生物,也没有建立它与战场上某个框的唯一对应。这些字段先属于“当前打开的生物资料面板”,与底部当前行动单位的生命值分别保存。
4. 在未参与调参的视频上检查
开发使用一个录像中的9张原图。另一位助手先从其他4段录像的缓存交集中固定26张候选图,再逐张看原图写参考;实现者在冻结算法之前没有读取这些图的字段答案。候选中有普通面板,也保留动画、没有详情的战场与非战斗控制图。冻结版本的本地提交为 3ad2d495。
这种隔离可以检查是否只记住了开发录像的位置,但26张主动选择的图不代表所有游戏视频。参考字段也是稀疏的:没有人工核对的生成字段不自动算对。面板是否出现、字段是否读对、错误值是否被接受,需要分别计数。
先检查面板有没有被找到
参考里共有22次详情面板出现。下表的“找到”指算法生成了该类面板的可读候选;它没有另一个只判断“面板正出现在动画中”的输出。因此,本来应该等待的翻页面板,也会在“物理存在”这一指标下成为漏检。
| 面板 | 参考中出现 | 找到 | 漏检 | 无中生有 |
|---|---|---|---|---|
| 英雄资料 | 4 | 4 | 0 | 0 |
| 生物资料 | 8 | 3 | 5 | 0 |
| 魔法书 | 7 | 3 | 4 | 0 |
| 战斗日志 | 3 | 3 | 0 | 0 |
两种方法结果相同。4张没有这些详情面板的控制图均未生成虚假的详情候选。以上样本数很小,尤其不能把英雄和日志的命中解释为已解决全部版本或布局。
如果改问“现在应不应该提交这块面板的读数”,结果会不同:生物资料有4次被参考允许提交,程序找到其中2次,漏掉2次,另外错误放行1次淡出面板;魔法书只有3次稳定出现,3次都找到,另4次动画没有放行。看到了面板,与面板现在可用,必须分别判断。
再检查字段和值
参考一共标了83次字段机会:42个应读取的数字、35段应读取的文字,以及6个应等待或没有目标读数的负控。评分首先要求面板类型、字段语义与数据类型相同,再按位置做一对一关联,最后比较值。关联使用字段框 IoU ≥ 0.10,目的是容纳紧贴文字的参考框与算法搜索框;这不是精确定位的合格线,也没有测面板边缘的检测AP。
| 检查对象 | 固定坐标 | 锚点平移 |
|---|---|---|
| 42个数字字段 | 21精确,21未输出,0错误数字被接受 | 相同 |
| 35段文字 | 22逐字精确,3仅空格不同,10未输出,0其他错文 | 相同 |
| 6个应拒绝的字段机会 | 5拒绝,1错误放行 | 相同 |
| 参考未覆盖的生成字段 | 300个未评估 | 300个未评估 |
“未输出”包括根本没找到面板、没有同语义字段、低分和没有合格文字等情况,不等于OCR全部没认出来。数字读取覆盖率只有 21/42 = 50%;即使这一小组被接受的数字都正确,也不能据此宣称完整链路准确率为100%。额外300个字段没有逐项核对,更不能算入正确数。
冻结的预测先保存,之后才载入参考评分。本地逐帧结果报告展示原图、自动区域、实际值和拒识原因;该入口需要本机标注服务。实验目录的 RESULTS.json 与 README.md 保存完整运行路径、协议和命令。
5. 拒识、错误接受与运行耗时
把一张可读图片拒绝,通常还能等下一帧再读。把错误数字接受,则可能让后续AI使用错误状态。所以实验把“错误接受”单独列出,不只给一个总体正确率。
文字正确,面板仍应等待
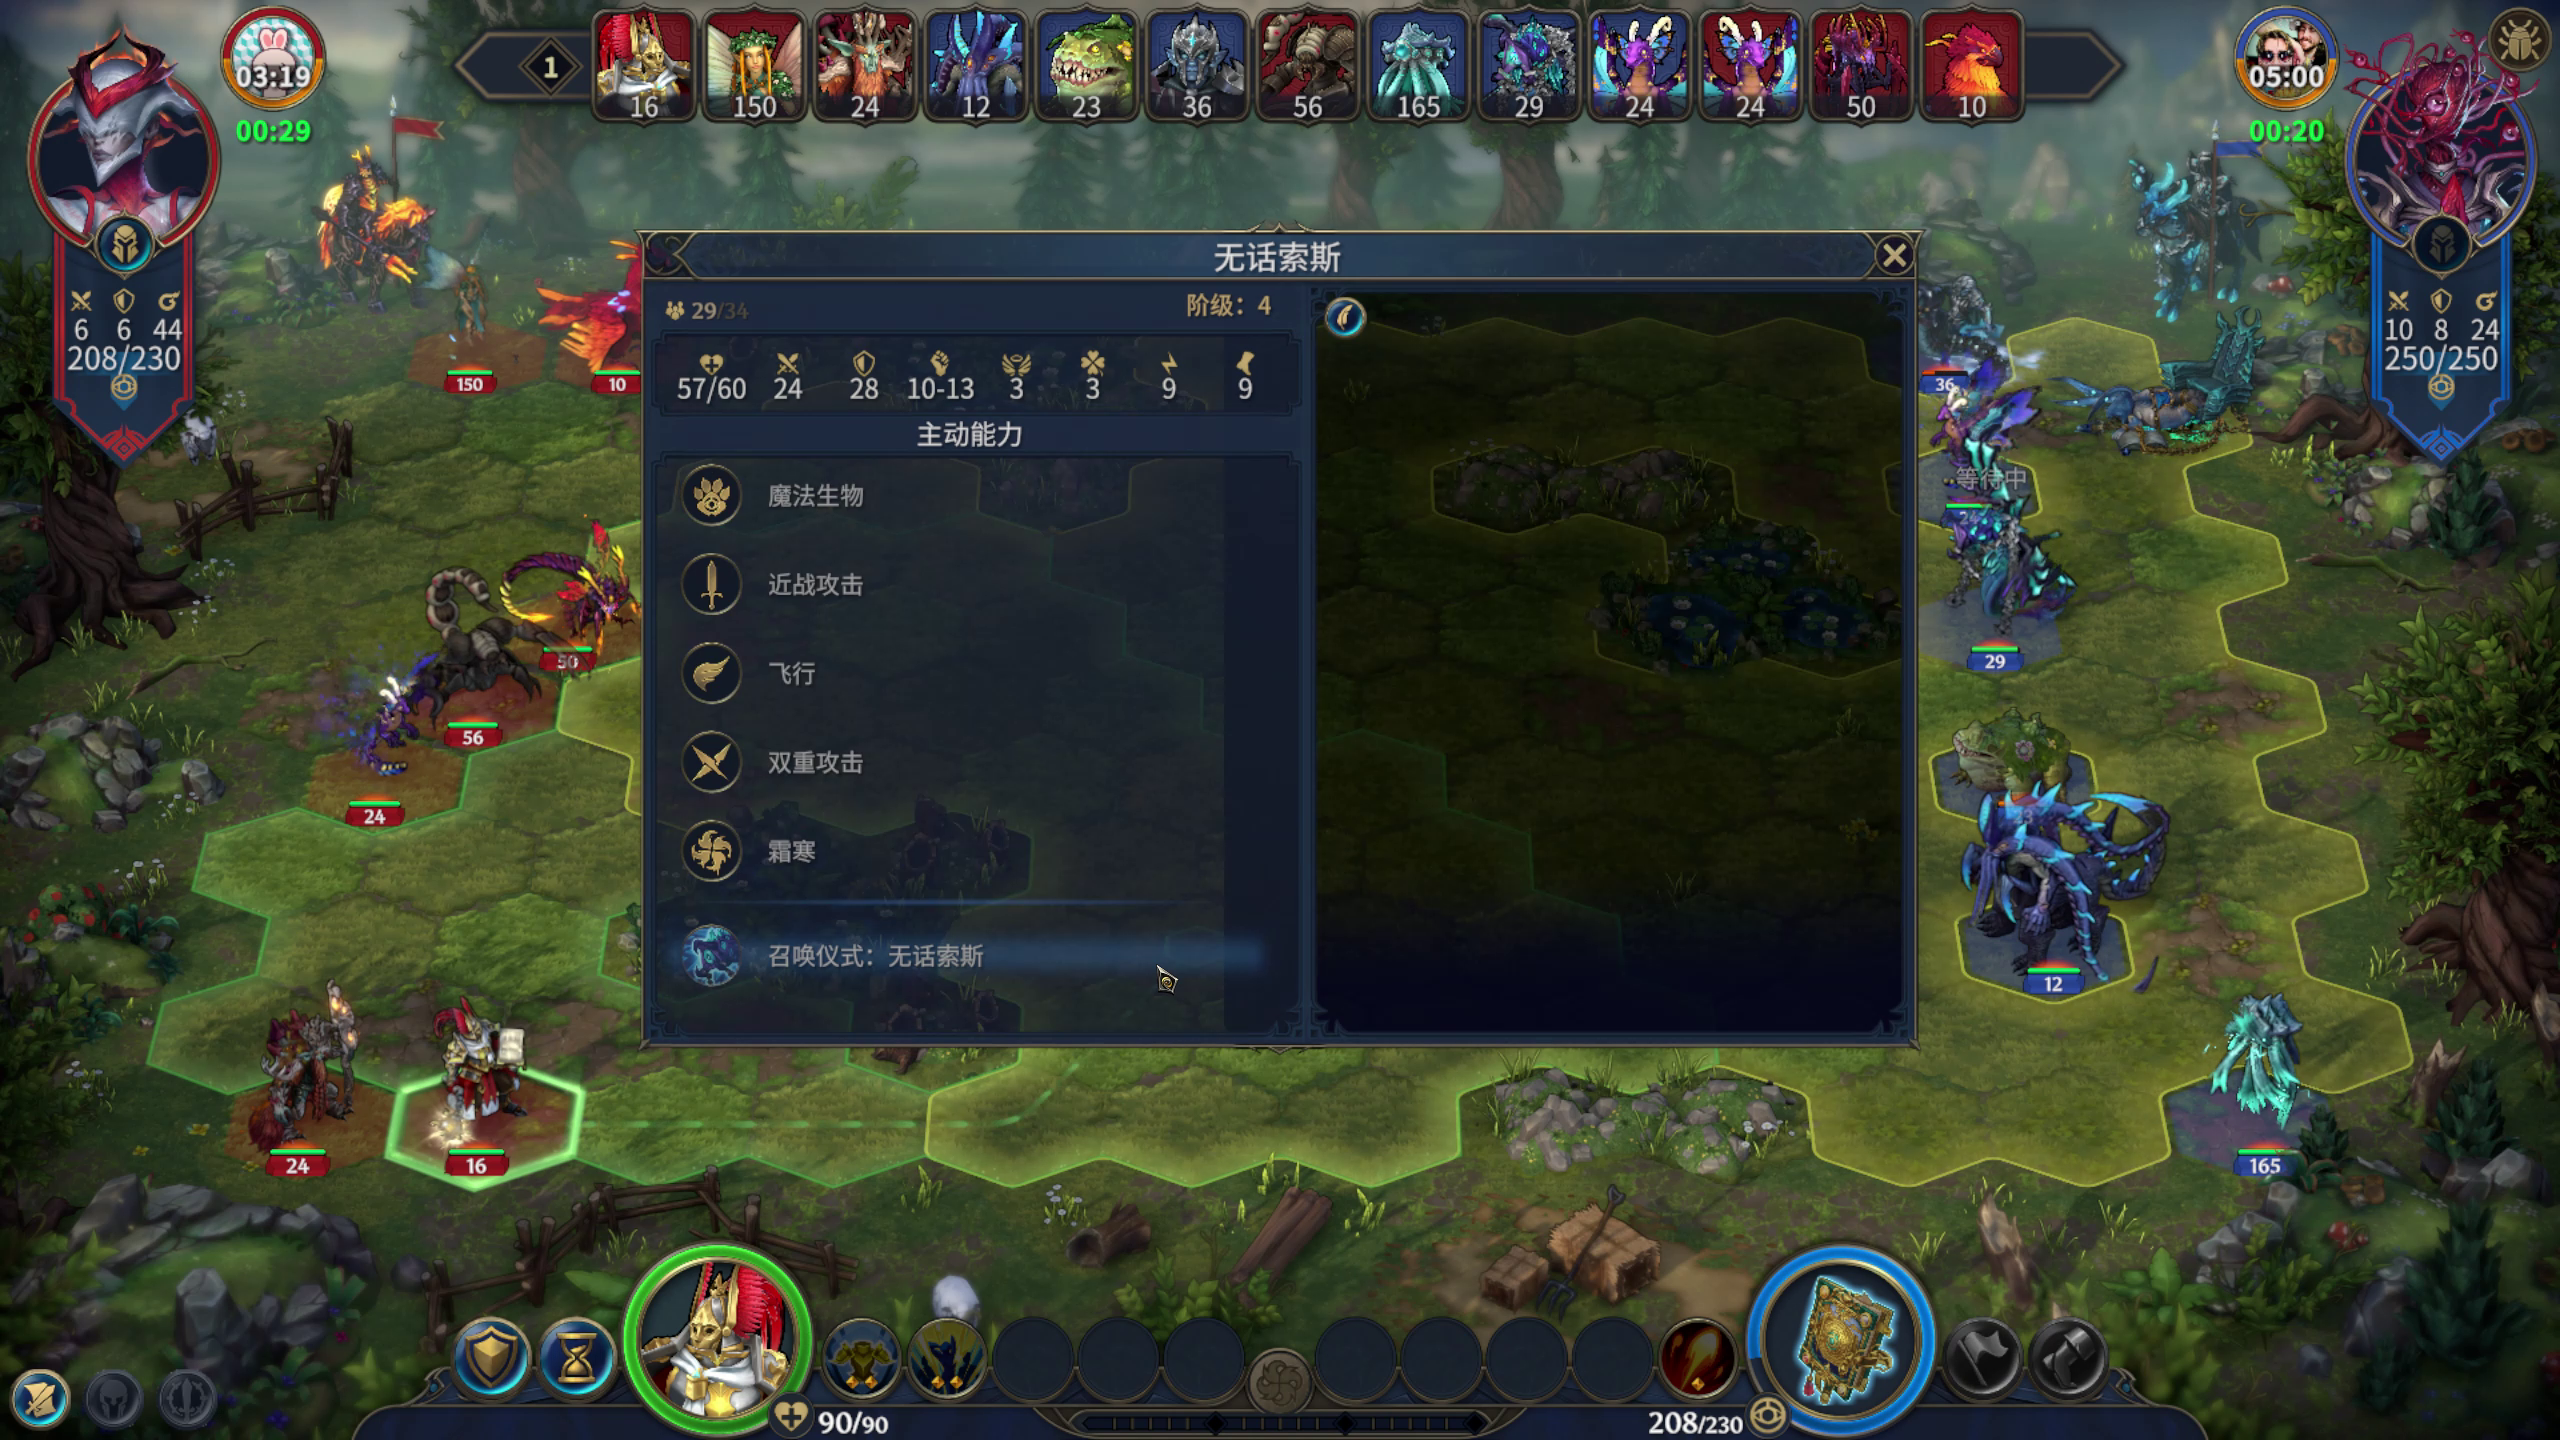
这里OCR读出“无话索斯”,与画面相符,目录也存在这个别名。它成功关联到同一种生物,不是错字或错身份。问题在于,名称、阶级和两个分数同时成立,就足以让当前定位器生成一个可用候选;上游又没有标出这次淡出,于是本该暂停的面板被放行。
评分后又查看了相邻缓存原图:524.013秒的同一面板完整、不透明且有生物模型,527.983秒已关闭。中间这张逐渐透出战场的图与关闭淡出过程相符。邻帧用于解释失败,没有倒灌进冻结版的单帧预测。
这次错误不能靠提高名称OCR分数修好:两次读法已经一致且高分。需要补局部面板质量与时序证据,同时保留另一个区别:没有绘制生物模型,并不总意味着旁边的不透明数值条不可读。下一版必须对照正负例判断,不能用“模型缺失”一条规则拒绝所有面板。
多一个标题,会让整块面板漏掉
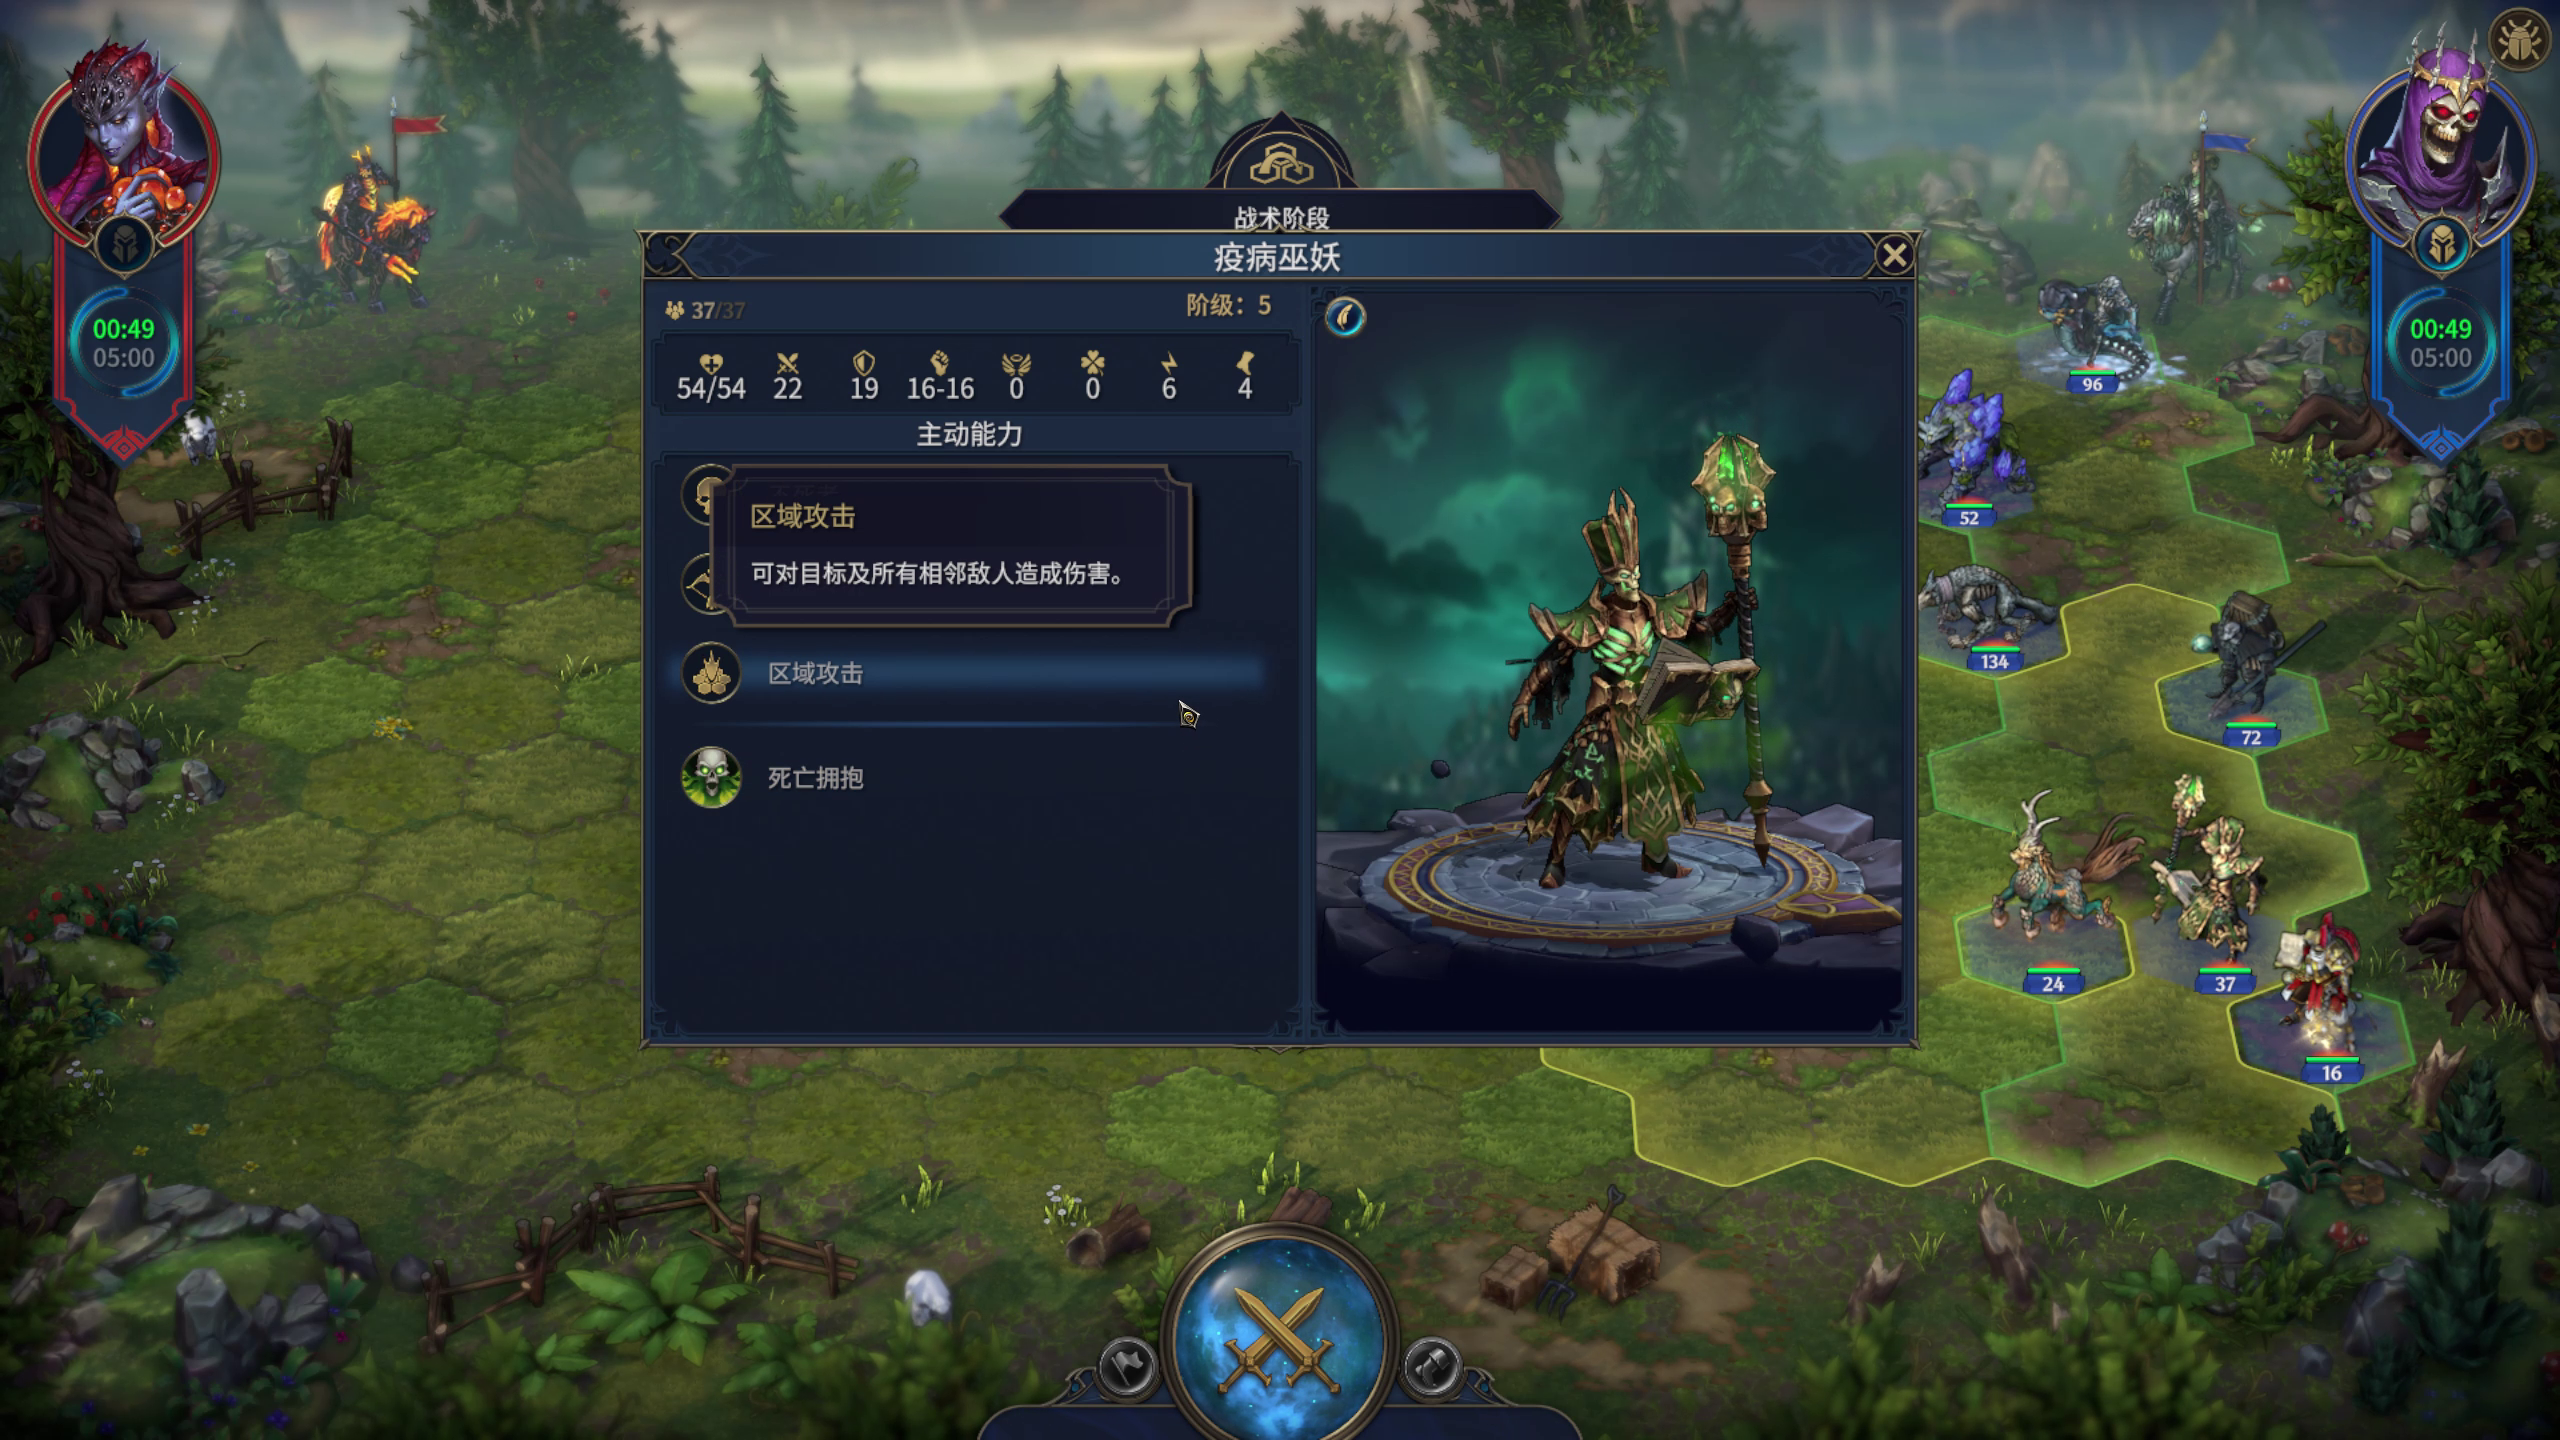
冻结版要求阶级上方恰好只有一个标题候选。这张图出现两个,程序便拒绝整个生物面板,连清楚的37/37、54/54等字段也一起漏掉。拒绝含混定位符合我们的错误成本,但下一版应结合目录名称和布局排除横幅,减少这种本可避免的等待。
另一张“太阳圣盾”面板有同样的问题。两次面板漏检合计丢失10个数字机会;此外7个数字已被读对,却因输出叫“右侧资源”或没有字段名,无法与参考要求的语义字段对应。这7项仍按原合同记为未输出,不在看过答案后改名补分。余下4个数字机会涉及2个攻击值的低分/缺字,以及2个伤害范围的文字框没有完整落入读取区域。扩大框也要谨慎:其中一条增强OCR把防御和伤害合成了同一行,放宽后可能从漏读变成混读。
当前系统还会整帧拒绝已经标为过渡的图片,可能连仍清楚的侧栏一起挡住。法术图标不同位置的数字也仍分开保存,未显示的中央数字不补成冷却0。
本轮究竟测了哪一段速度?
测量对象是CPU上的位置分析和严格解析,输入为已存在的2560×1440全图OCR;没有新载入OCR模型,也没有裁图重读。26张图共包含2587个OCR行条目,单图1~146个,包含两个预处理分支的重复读法,不能当作2587段不同文字。
| 测量范围 | 实测 |
|---|---|
| 新进程中导入本实验Python模块 | 138.90 ms |
| 载入并建立639个规范身份的名称索引 | 84.63 ms |
| 固定坐标:每帧定位+字段解析,中位数 / P95 | 2.81 / 6.47 ms |
| 锚点平移:每帧定位+字段解析,中位数 / P95 | 2.62 / 6.30 ms |
这是一次新进程、每张图每种方法执行一次的观察结果,不是稳定微基准;不到0.2毫秒的中位数差距不能证明哪个方案更快。名称查询包含在定位中,读出字段之后的身份关联另行计时;空标题较多,使其全帧中位数非常小。源文件验证与读取也单独记录。
表中初始化两项不包含Python解释器启动,因此也不是完整冷启动耗时。视频解码、PNG读取与验证、历史全图OCR耗时,都不在每帧定位+解析的毫秒数里。OCR行越多,位置筛选通常需要处理更多候选;但本轮没有控制文字量或重复测量,不能据此给出“每增加一行多花多少时间”,更不能换算整张截图OCR的FPS。
6. 第二轮:修标题歧义,再用新视频检查
第一轮结束后,原9张开发图和已看过答案的26张图一起成为开发集。V2 将生物标题候选与已有生物目录做精确名称检查:横幅和生物名称并存时,只有唯一的目录名称可以消解歧义;多个名称仍拒绝。伤害区域可以随当前文字框扩展,但两个 OCR 分支中只要有跨入邻列的合并文字,就保留 UNLOCATED,不删掉坏分支凑答案。
字段命名也做了整理。法术槽位的数字统一叫 positional_counter,继续保留上方、中央或右下角的位置,不叫“冷却”。英雄面板的 resource_right 仍保留通用名称:复核发现,早期资源审核里的“魔法量”角色来自一个尚未证实语义的既有字段,不能拿这个循环引用当独立依据。该读数即使正确,也不为补分而强行改名。
局部外观检查能做什么
V2 在自动定位的生物面板内,检查左侧内部区域:面板宽度的7%~47%、高度的35%~92%。开发版不透明面板的背景偏暗蓝;过渡时露出褐色地形,会降低这类像素的比例。规则为 B-G > 5、B-R > 8、max(R,G,B) < 100,符合的像素至少占85%,且区域每边至少32像素。
这个阈值仅用旧开发数据确定。旧11个参考生物区域里,稳定例的比例约0.852~0.969,淡出例约0.00005~0.741。这是针对当前皮肤的外观筛选,不是不透明度测量,也不是正确概率。 蓝色地形、其他皮肤或遮挡都可能破坏它;右侧有没有生物模型不参与这个判断。
没通过时,只阻断该生物面板的候选字段,保留候选框和拒识原因,不牵连仍可读的 HUD。通过也不能绕过场景、OCR冲突、可见性和字段语义检查。旧26张上的开发回归从21/42提高到33/42,6个负控全部拒绝;这些数值不能再作为独立成绩。
新24张的结果
另一位助手预先固定4个新视频各6张候选图,逐张看原图编写参考,不根据预测挑图。V2 在提交 f26805e6 冻结,先从纯来源元数据生成预测,再读取参考。旧5个开发来源与这4个评估来源不重合。额外跑的 V1 对照使用未改动的旧算法。这是助手审核的小规模主动采样,不是公开基准。
| 同一批24张原图 | 冻结 V1 | 冻结 V2 |
|---|---|---|
| 数值精确 / 46个机会 | 19 | 26 |
| 数值拒识 / 错误接受 | 27 / 0 | 20 / 0 |
| 文本逐字精确 / 38个机会 | 27 | 28 |
| 仅空格不同 / 文本拒识 / 其他错文 | 1 / 10 / 0 | 1 / 9 / 0 |
| 应拒识的4个字段:拒绝 / 放行 | 2 / 2 | 2 / 2 |
| 额外未评估字段,每方法 | 368 | 367 |
每一版的固定坐标与锚点平移成绩仍相同,表中没有把两种方法的重复预测当成更多样本。完整参考有22次面板出现、88个稀疏字段机会。稳定面板中,V2找到全部4个英雄面板、2个日志、5个魔法书,以及4个生物面板中的2个;另误把1次翻页魔法书当成可提交面板。
新增的7个精确数值中,3个来自恢复“缟玛瑙舞者”面板的标题定位,4个来自法术数字的字段键显式化;这4个值在V1已读对,只是无法与参考字段关联,不能称作OCR改进。两个稳定生物面板仍漏检:OCR把生命与攻击合成 125/125 28、130/130 33,整行不再是单独的分数,定位器因缺少生命锚点而拒绝。它们合计占10个数值拒识机会;不能删除尾数后假装原OCR没有歧义。
新集只有2个生物面板实际走进外观检查,二者都是稳定正例并通过;其余生物候选已在定位阶段拒识。因此,这次独立检查没有新增证据证明外观规则能拒绝淡出,不能把总体没有放行淡出生物解释成质量门控已被充分验证。
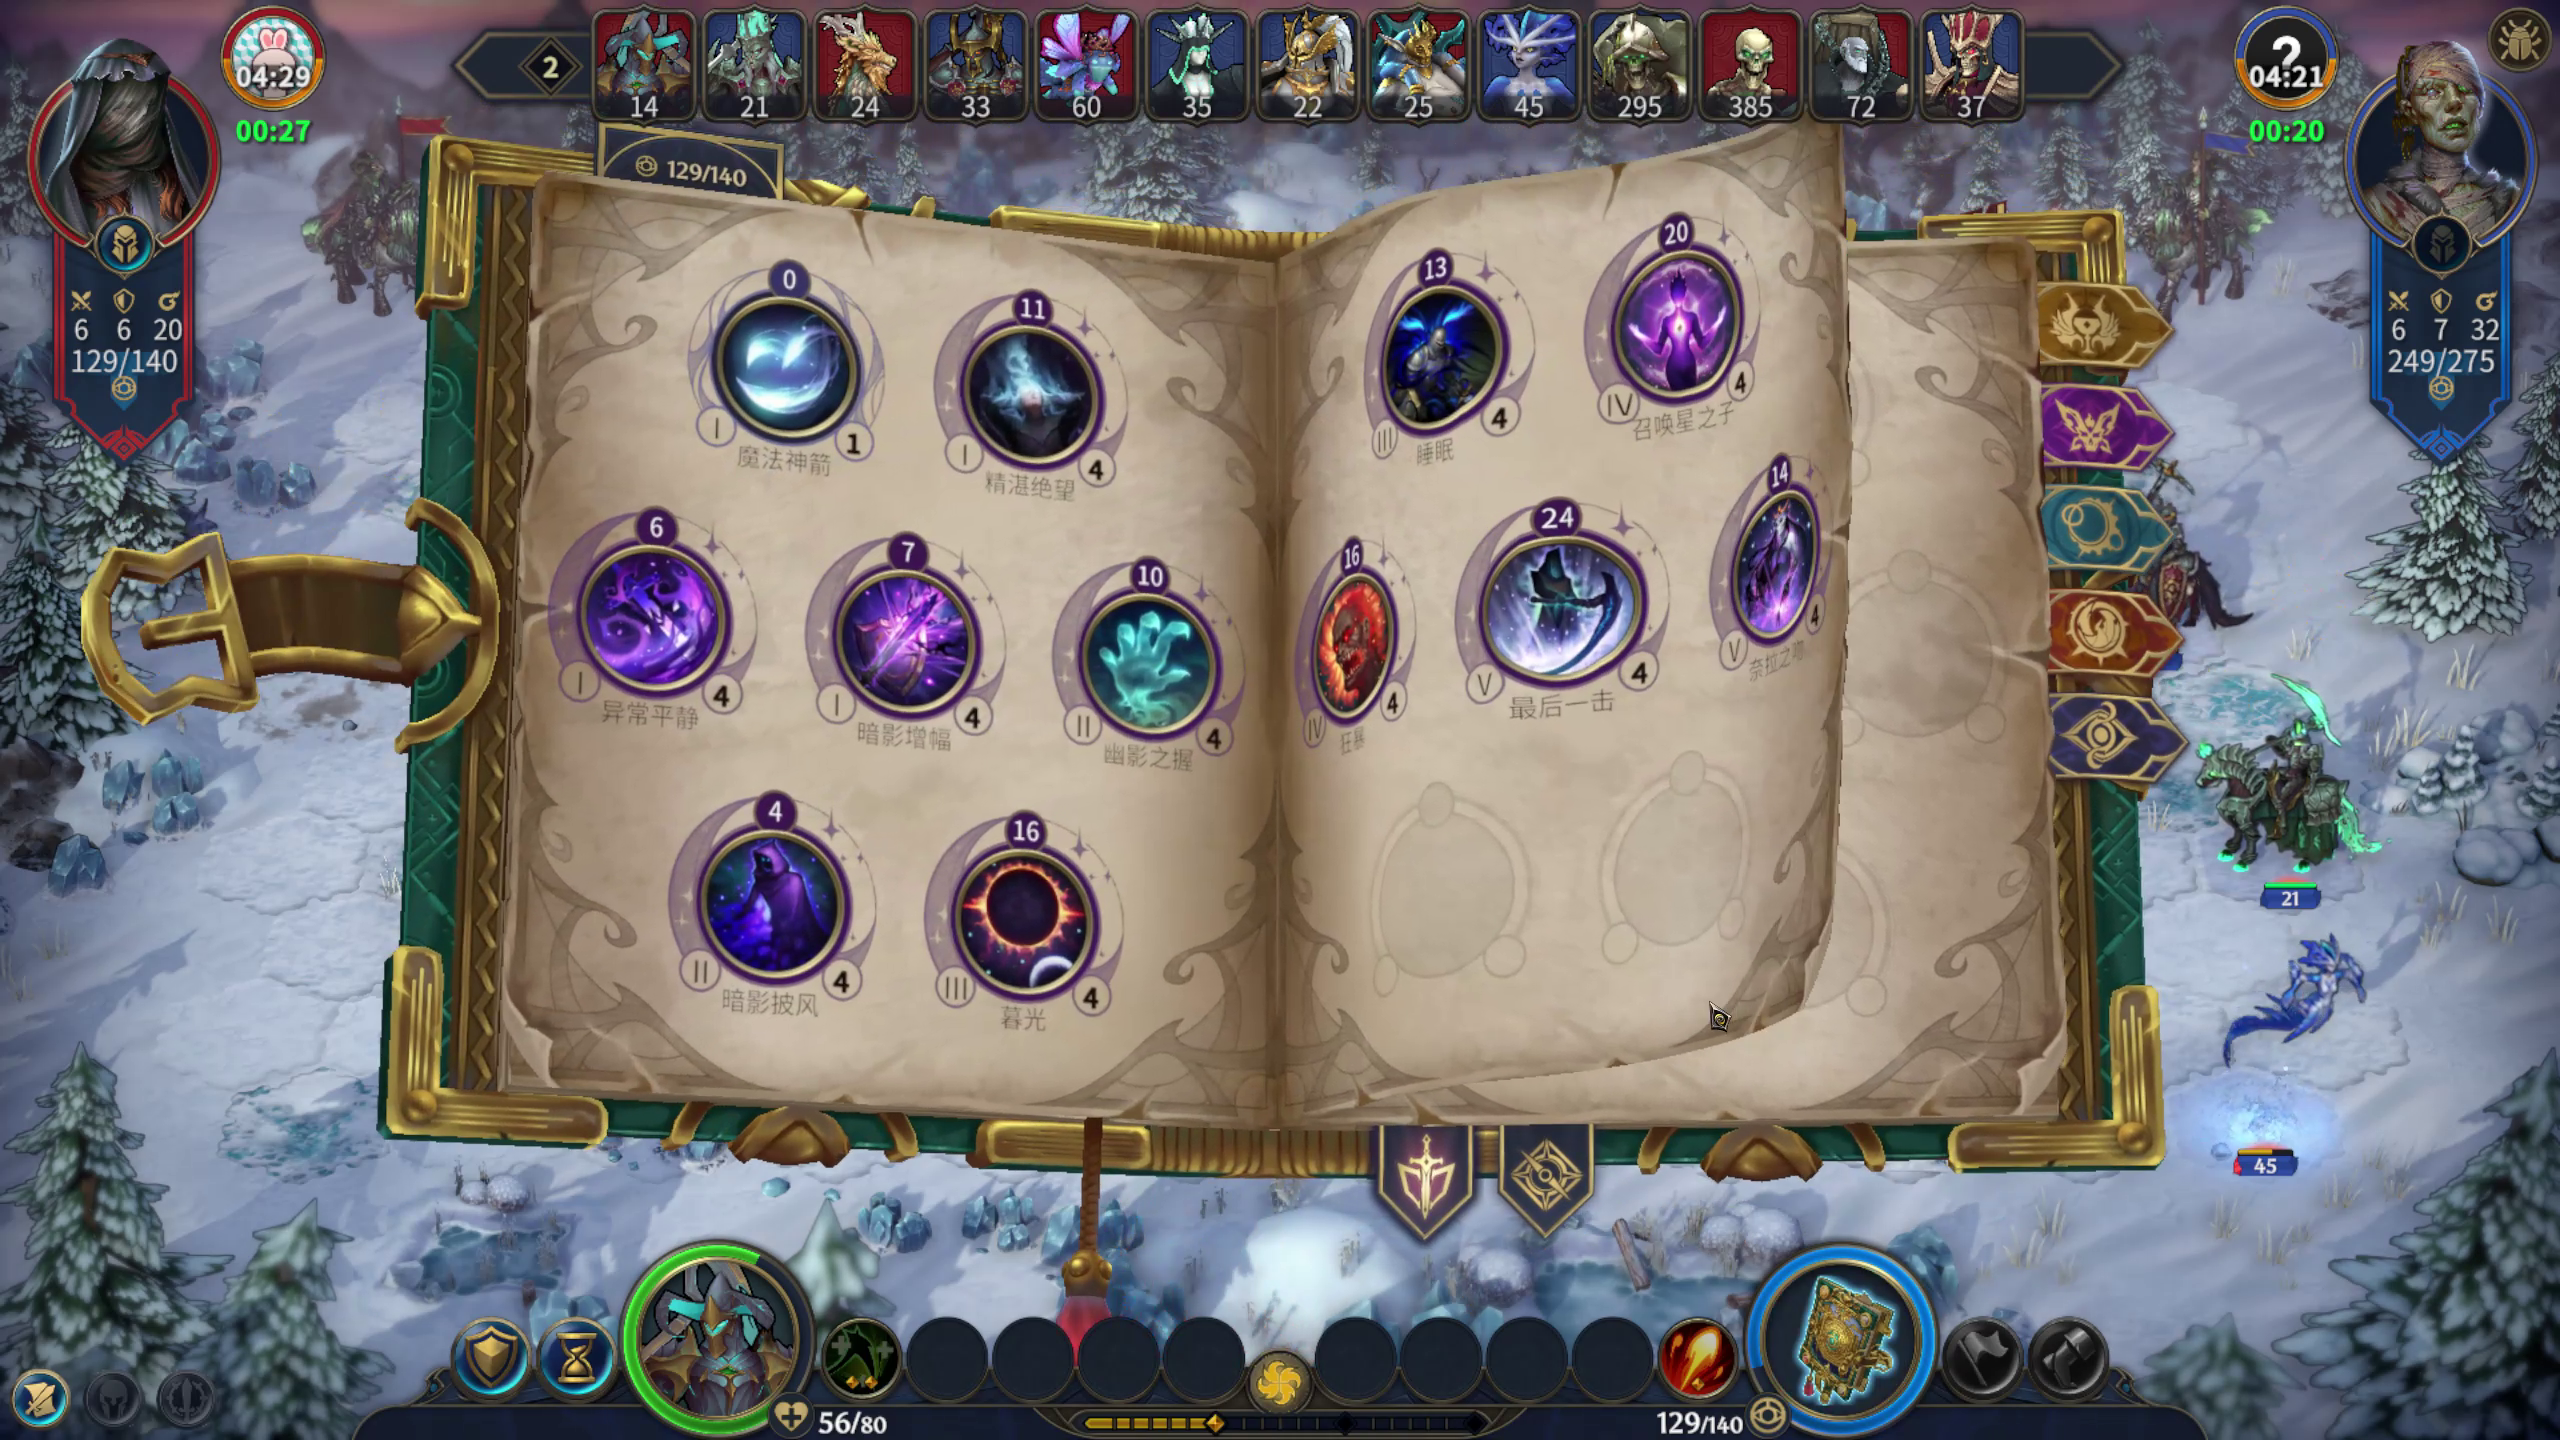
这两项是质量门控漏放行,不是两个OCR错字或两张失败图。生物背景规则不会检查纸色魔法书;多个法术标题依然能满足现有水平排列条件,所以翻页没有被阻断。新参考保持原样,算法也没有在看到失败后偷偷重跑补分。下一版需要单独处理魔法书几何变化,或用有因果顺序的相邻帧证据。
V2复用了2560×1440原图和共2562个全图OCR条目,单图45~150条,含两种预处理的重复。一次新CLI中,基础模块导入138.74ms、额外V2模块导入45.76ms、目录加载81.46ms;不含Python解释器启动。PNG解码中位数/P95为29.48/30.79ms。定位、局部质量检查与严格读数合计中位数/P95:固定4.43/9.55ms,平移3.96/8.97ms。源验证与字段身份链接另外记录。每图每方法只跑一次,包含早期拒识;这些数字不含历史OCR,不能换算成整条视频链路FPS,也不据小差距选速度冠军。
第二轮逐帧原图与结果可检查未输出、负控和原视频时间。代码、协议、完整结果路径见实验目录的 PROTOCOL_V2.md 与 RESULTS_V2.json。
7. 第三轮:保留合并文字,检查书页排列
V3处理上一轮暴露的两个问题。首先,125/125 28仍可以证明这里有一行符合生物详情布局的文字。结合唯一生物名称、阶级、独立数量分数,可以恢复面板的位置;生命与攻击仍为未知,不把整行OCR框切成两个假定小框。即使另一个预处理分支给出清洁分数,只要有任一分支跨越两个字段格,也保守拒识这两个值。
其次,书页上的法术标题必须符合当前UI的两页排列。检查至少3个标题、分布于左右页和至少2行,再核对每个标题距预期行列及同一行的垂直偏差。3行的归一化纵坐标为0.356、0.533、0.718,随自动生成的资源锚点平移;行偏差最多0.012、列偏差最多0.016、同行高差最多0.009。完整列位置与抽样协议在 PROTOCOL_V3.md。这是本帧OCR区域几何检查,不需要再跑文字识别,也不是运动检测器。
开发集的11个书本候选中,10个通过,前文734.007秒的翻页例被拒绝。完整组合在旧9张、旧26张、旧24张上分别读对28/47、31/42、32/46个数字;相应V2为30/47、33/42、26/46。前两组各少读2项,是跨栏分支检查的代价;这三组负控分别4/4、6/6、4/4拒绝。这些都是已经看过答案的开发回归,不能当新准确率。
再换四个来源,结果改善了多少?
V3于提交64e0c113冻结。另一位助手先按旧导航元数据选图,再逐张看原图写参考;主算法先保存预测,之后才打开答案。第三批来自09-04T07-21、09-06T06-20、09-06T22-46、09-07T23-07四段录屏,每段6张。它们没有进入前两轮面板实验,但项目此前已对这些视频做过场景索引;这是本实验的来源隔离,不是全项目从未看过的材料。
候选包含英雄、生物、书页、日志与可能的关闭/遮挡画面,选择错误也保留。这是定向挑战集,不代表正常视频里的类别比例。24张中有17次详情面板出现、14次稳定面板,78个稀疏字段机会。
| 同一批第三轮24张原图 | 冻结 V2 | 冻结 V3 |
|---|---|---|
| 数值精确 / 41个可读机会 | 31 | 32 |
| 数值拒识 / 错误数值接受 | 10 / 0 | 9 / 0 |
| 文本逐字精确 / 25个可读机会 | 21 | 22 |
| 仅空格不同 / 文本拒识 / 其他错文 | 2 / 2 / 0 | 2 / 1 / 0 |
| 应等待的12个字段:拒绝 / 放行 | 7 / 5 | 7 / 5 |
| 额外未评估字段,每方法 | 410 | 415 |
固定坐标与锚点平移仍同分,不把重复预测计为更多数据。V3找到全部14个稳定面板,但额外放行1个半透明生物面板;两个未找到的物理面板均为非稳定书页。额外415个字段没有完整参考,不能据此计算整个输出的precision。
净增1个数值不等于只改进了一处:353.968秒“独角兽”面板恢复后,名称与数量、防御、伤害读数新增正确;624.016秒“绝罚者”的生命、攻击则因跨栏规则从正确读取变为拒识。也就是数值新增3项、少读2项,文字新增1项。两种代价都保留在表里。
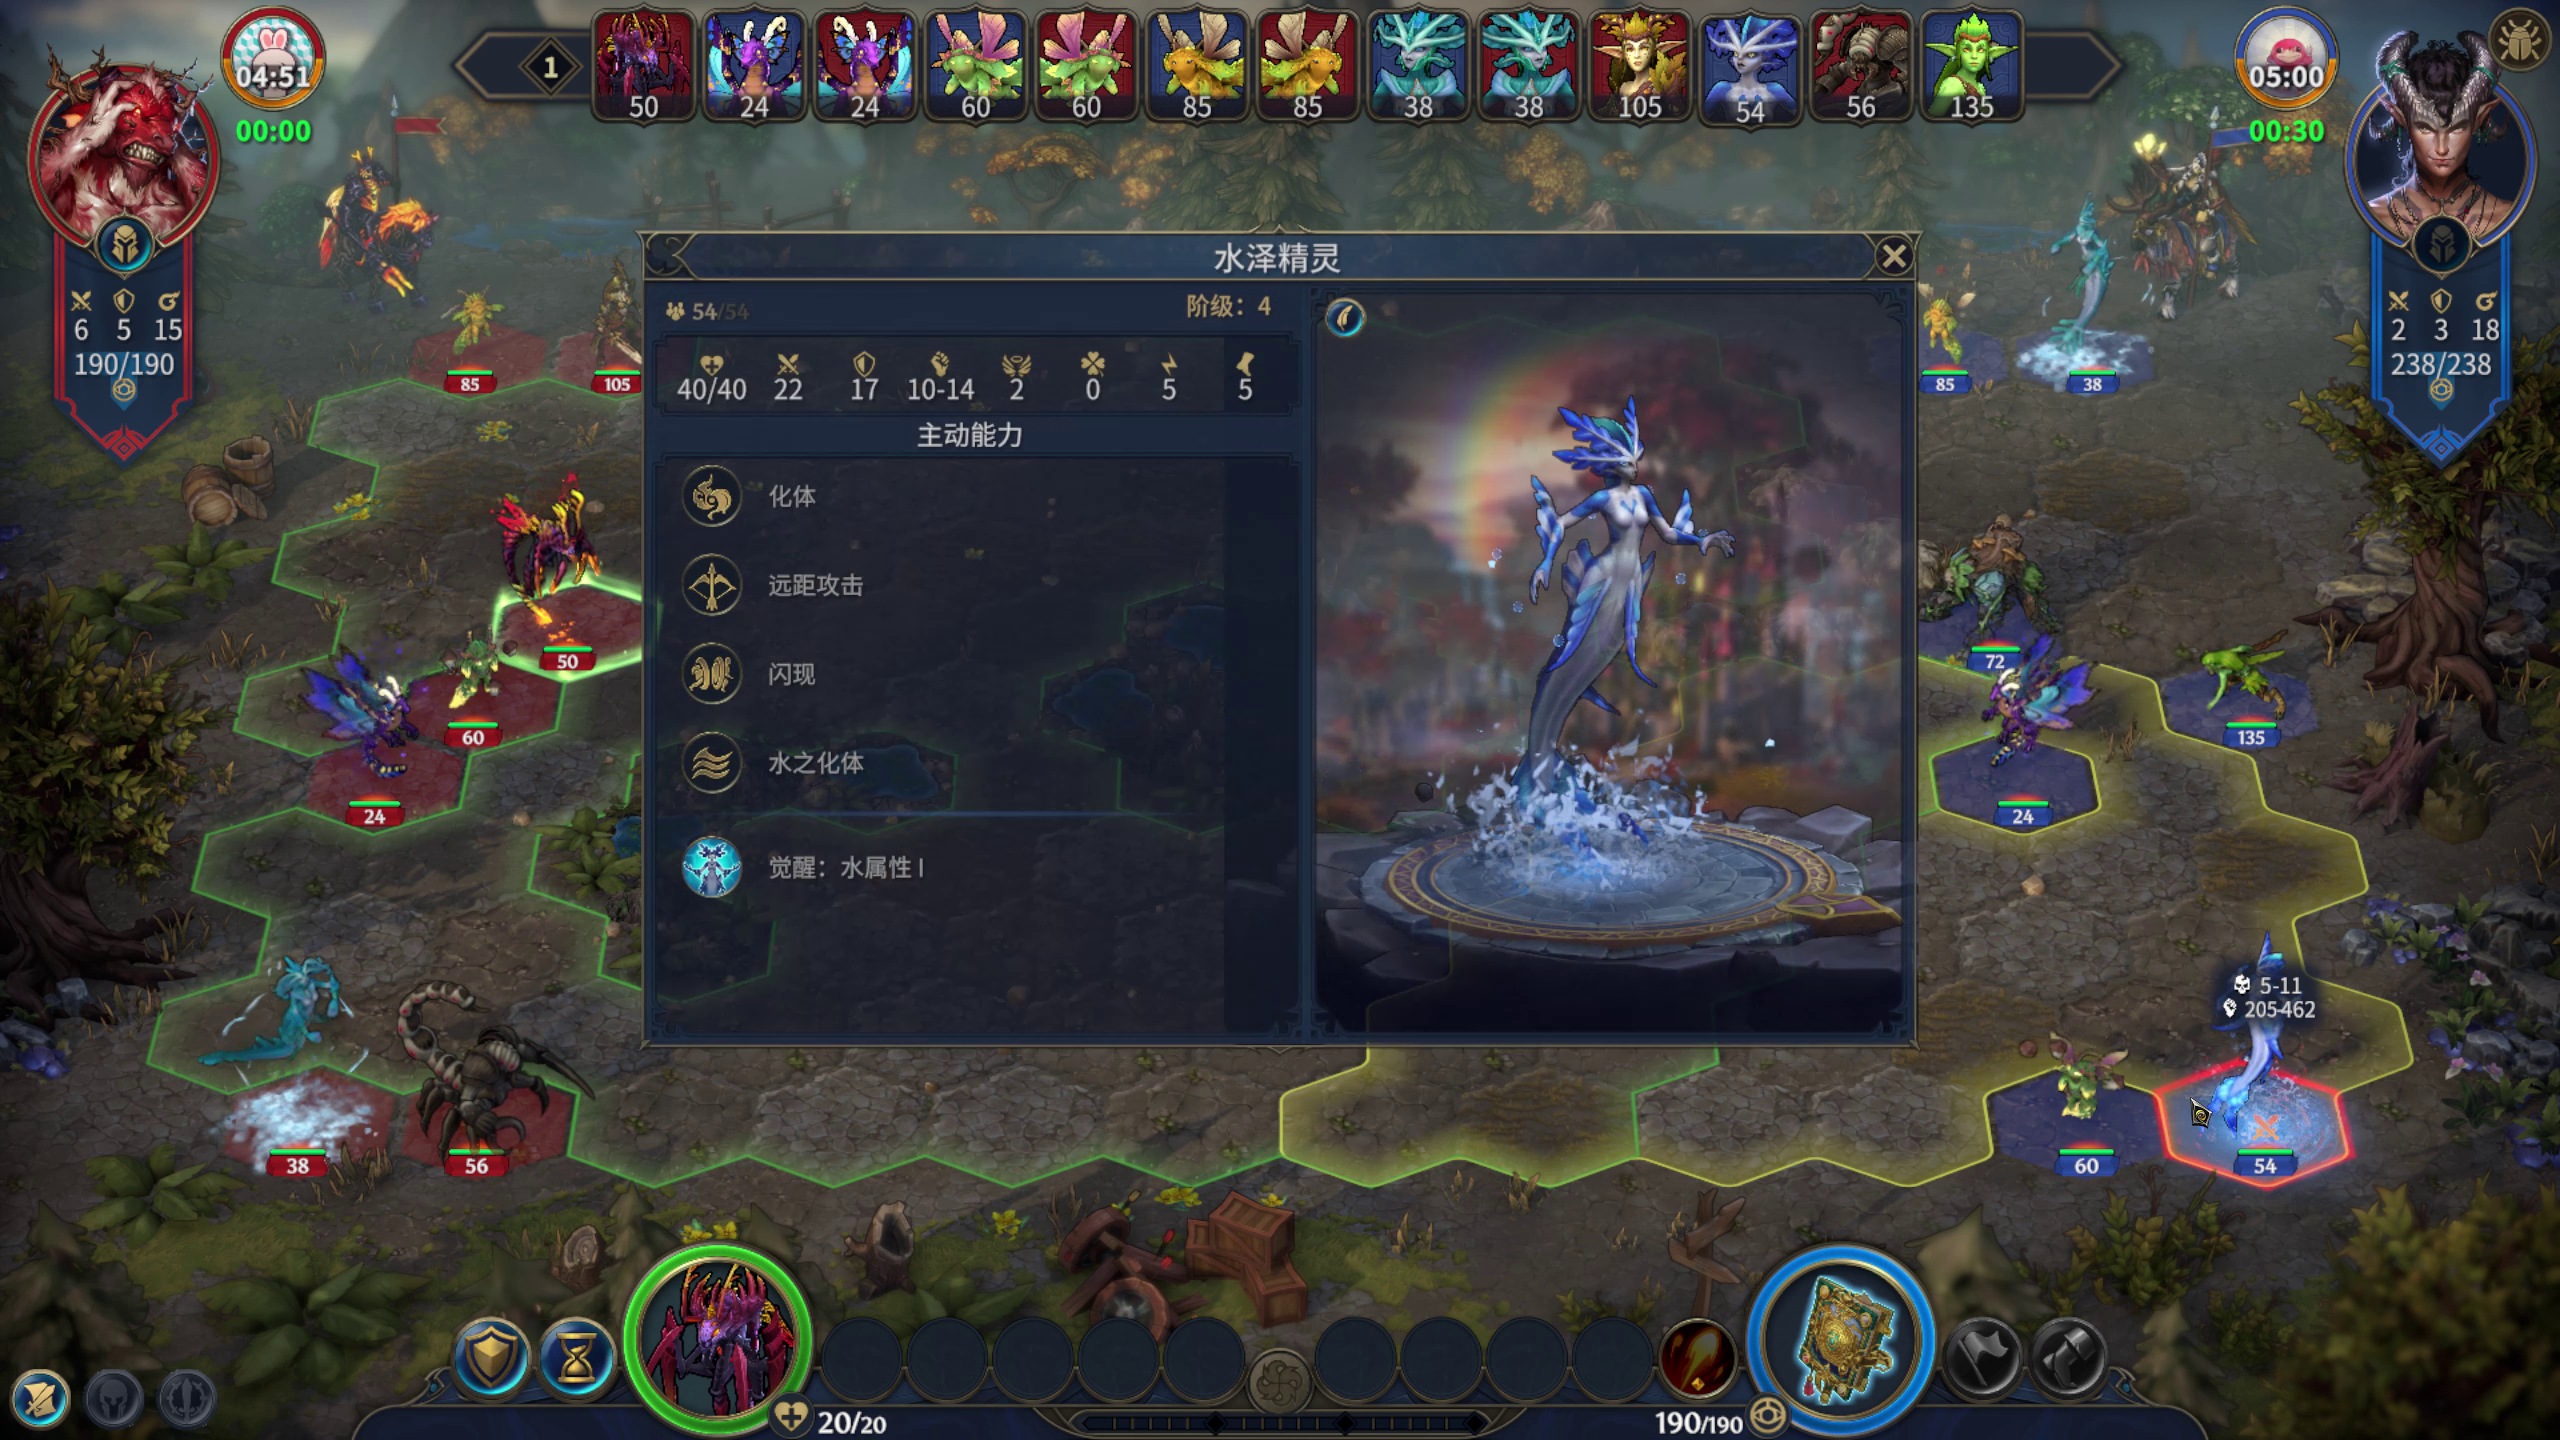
原图能看到战场透过面板。它的暗蓝背景比例仍达0.9006,超过V2沿用的0.85阈值;这个特征不是不透明度。本轮4个生物候选都进入该检查:3个稳定正例和这个负例全部通过。提高阈值也不是现成答案,因为先前稳定图的比例可以更低。单帧的透明外观不单独证明它正处于打开或关闭过程,参考中的等待策略与具体动画原因应分开。
本轮7个书页候选都是稳定正例,都通过新布局检查;两个非稳定书页先在定位阶段拒识。因此,新集验证了这7个正例没有新增拒识,还没有检验新布局门拒绝翻页的能力。已知翻页例的修复仍属于开发证据,不能换一种说法当作独立成绩。
这次仍输入2560×1440原图,复用完整截图OCR:合计2604条、单图24~155条,包含预处理分支的重复。新CLI基础模块导入147.20ms、额外V3导入52.13ms、目录加载86.51ms;不含解释器启动。PNG解码中位数/P95为31.41/33.08ms;驻留定位+局部检查+严格读取,固定方案6.76/13.87ms,平移方案5.91/13.77ms。源验证和身份链接另计,历史OCR和视频解码不在其中。每图每方法只测一次,无法据此宣称速度胜出或端到端FPS。
第三轮逐帧报告保留全部原图、参考、预测和未评估字段。第三轮原结果不在失败分析后重写,后续改动用新版本记录。
8. 找到属性格后,再让 OCR 读一次
此前的读取器主要处理全图 OCR 已经给出的文字。它有一个绕不开的限制:当两格被识别成同一行,或者文字框多包进了旁边的图标,解析规则再谨慎也无法确定该取哪一部分。继续讨论置信度,不能凭空产生一个干净的局部读数。
这次让程序回到原始像素。面板定位器先给出自动位置,裁图器按当前布局取数量、生命、攻击、防御和伤害的单格区域,再由 OCR 重新读。其他已经定位的数值字段沿用其自动区域。这里的框只是“到这块区域找字”,不是已经测出的文字边框;没有把人工标注框传给算法,也没有把一行字符串硬拆成两个值。
例如下面这张图,生命 30/30、攻击 26、防御 25 原来都留空。单格重读后,两种模型、两种预处理都读出了对应的完整数字。它说明这些字段不需要猜游戏规则,也不需要凭另一帧补值,当前像素本身就够用。
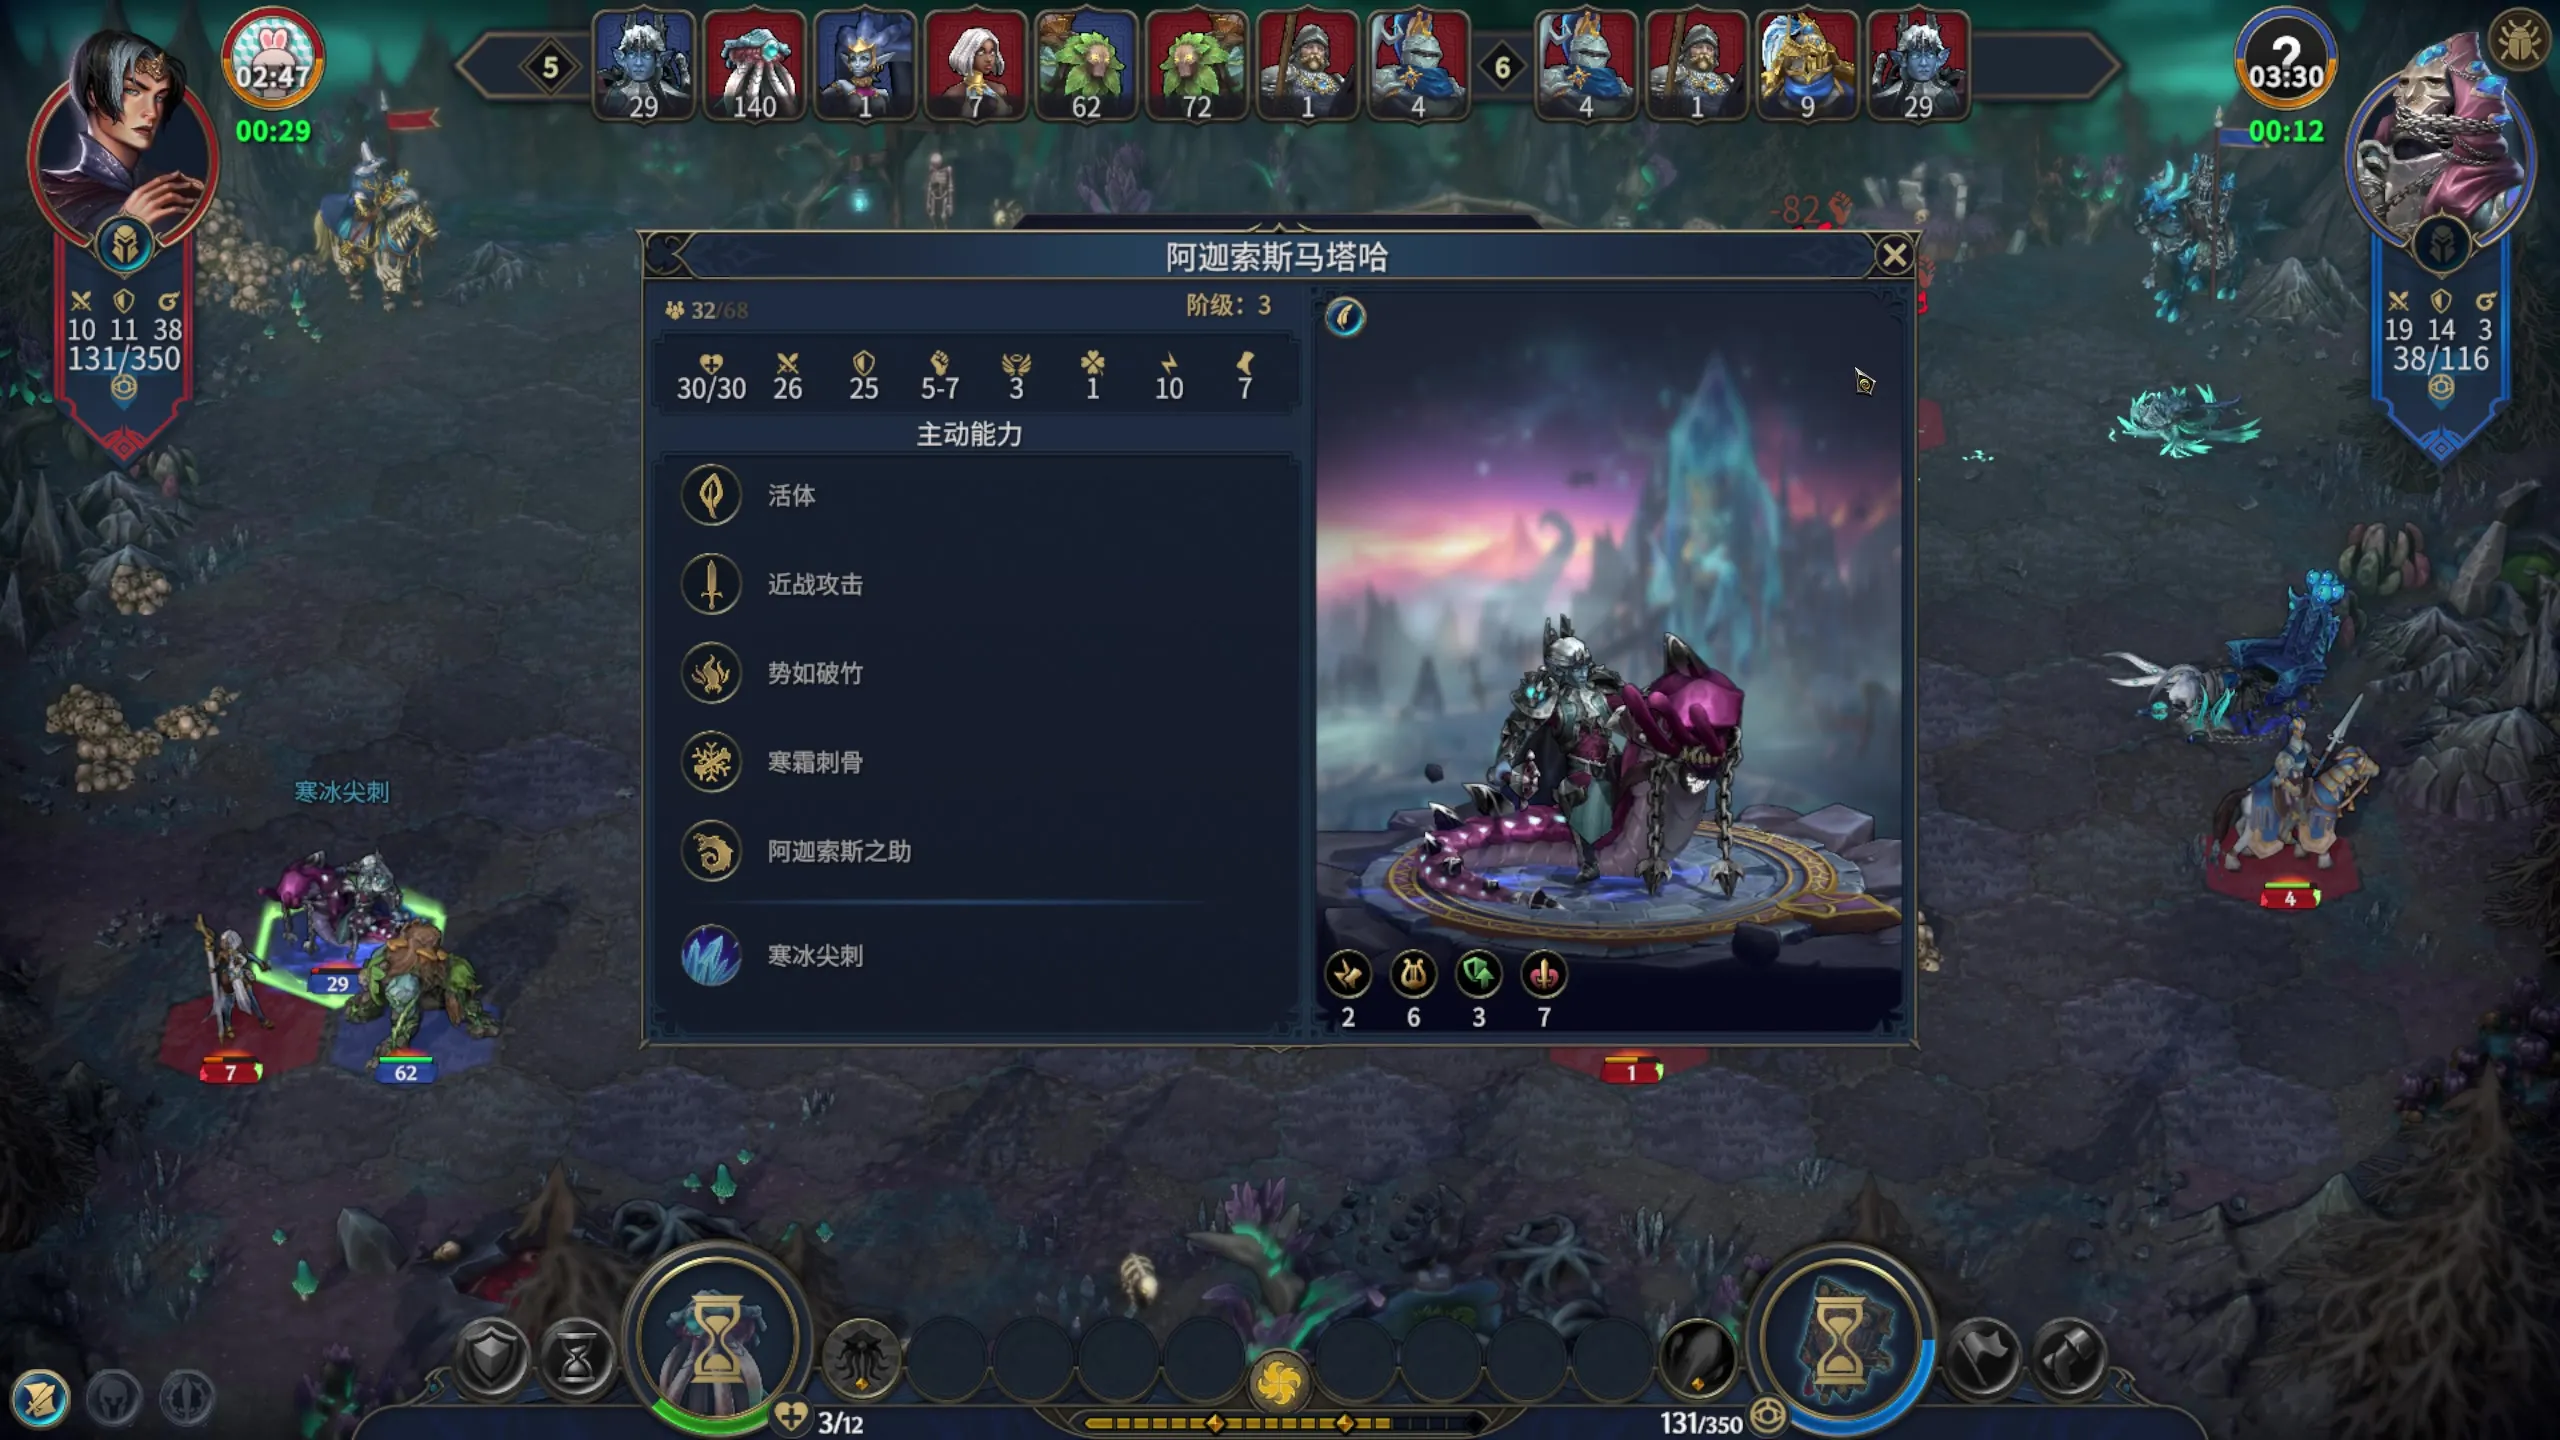
1648.1 秒原图。前三项四遍都读对;伤害 5–7 却在 PP 的放大配方中变成 5÷-7。自动搜索框与每遍原文可在字段对照页展开查看。
放大或换模型,哪一个更有用?
本轮复用 53 张高精度视频候选,以及第三轮已经曝光的四源 24 张图,共 77 张原图、5 段录像。自动产生 469 个数值裁图;20 张图没有数值区域,仍保留在处理清单中。两个本地模型分别读取原尺寸和放大配方,共完成 1,876 次读取,没有重新解码视频。
模型是 PP-OCRv6 medium 的识别器与 PaddleOCR-VL-1.6。放大配方先填充 8 像素边界,再用 Lanczos 放大 4 倍,因此比较的是整个预处理配方,不能把所有差异都归因于倍率。除了分别看四种读法,还测试了“四遍必须完整、相同,且 PP 两遍分数均不低于 0.90”的合并规则;VL 没有同类分数,不给它借用另一个模型的分数。
| 方案 | 视频组 17 个可读参考 | 历史四源组 41 个可读参考 |
|---|---|---|
| 原全图严格字段 | 0 | 32 |
| 单格 PP 原尺寸 | 17 | 37 |
| 单格 PP 放大配方 | 14 | 31 |
| 单格 VL 原尺寸 | 14 | 36 |
| 单格 VL 放大配方 | 13 | 32 |
| 四遍全部一致 | 11 | 28 |
表内是精确读对的数量,余项为拒识;这些已有可读参考里没有错误数值被接受。视频组的 0 是原严格字段输出,不是说全图 OCR 完全没看见字;属性读取中的合并实验已经单独恢复其中 12 项。本轮两组都是开发数据,不是新视频准确率。
PP 原尺寸在这批数据中最好,但不是没有退步。历史组净增 5 项,实际是新增 6 项、失去 1 项:某个法术位置计数原来读成 8,裁图后变成 ≥8,完整数字解析便拒绝了它。VL 在这一处反而仍读成 8。另一类例子是底栏生命旁的加号形图标,被 VL 一起转写为 +17/30。这些失败提示我们要继续检查区域是否带入图标,而不是看到多余符号就直接删除。
读得更多,不等于面板都能放心采用
原历史组还有 8 个数字提交负例:旧规则误放 4 个,四种裁图读法和合并规则都误放 5 个,全部来自前文那张半透明面板。文字本身读对了,失败的是该实验约定的稳定面板提交条件。不能把它写成 5 个 OCR 错字,也不能以读对为由抹掉原负例。
冻结输出后,又逐张查看四段录像的生物面板图,补了 13 个此前没标的阶级和独立 HUD 字段。12 个可读值在所有方法中都正确,另 1 个半透明面板阶级在所有方法中都被放行;这组新增参考单独计分、等待用户复核,不用来给本轮方法排名。审核页共展示 79 项新旧稀疏参考,另有 396 个自动候选没有对应参考,整帧完成标注仍为零。
这轮的实用结论是:自动单格重读值得接着做,但不能无条件覆盖旧读数,也不应要求每个放大版本都同意才留下结果。下一步先保留原读数,研究只对未定位或拒识字段补读的组合,并把图标混入、真正数字冲突与画面提交条件分开验证。
9. 魔法书的小数字:先去掉圆环,再比较模型
魔法书里的一个法术图案周围有三处标记:上方的阿拉伯数字、左下的罗马数字、右下的阿拉伯数字。我们想把它们分别读出来,连到同一格子;不能把图案内部也当成一个必然有数字的位置。
这里首先要更正上一轮视频报告:121 个魔法书补读失败全部来自旧代码假定的“中央数字格”。相应的上方、右下数字都已有读值。下图右上角法术的 17 也早已读对,中央框读成低分 d 不等于漏掉 17。真正没覆盖的包括罗马数字,以及某些标题没被 OCR 找到的格子。
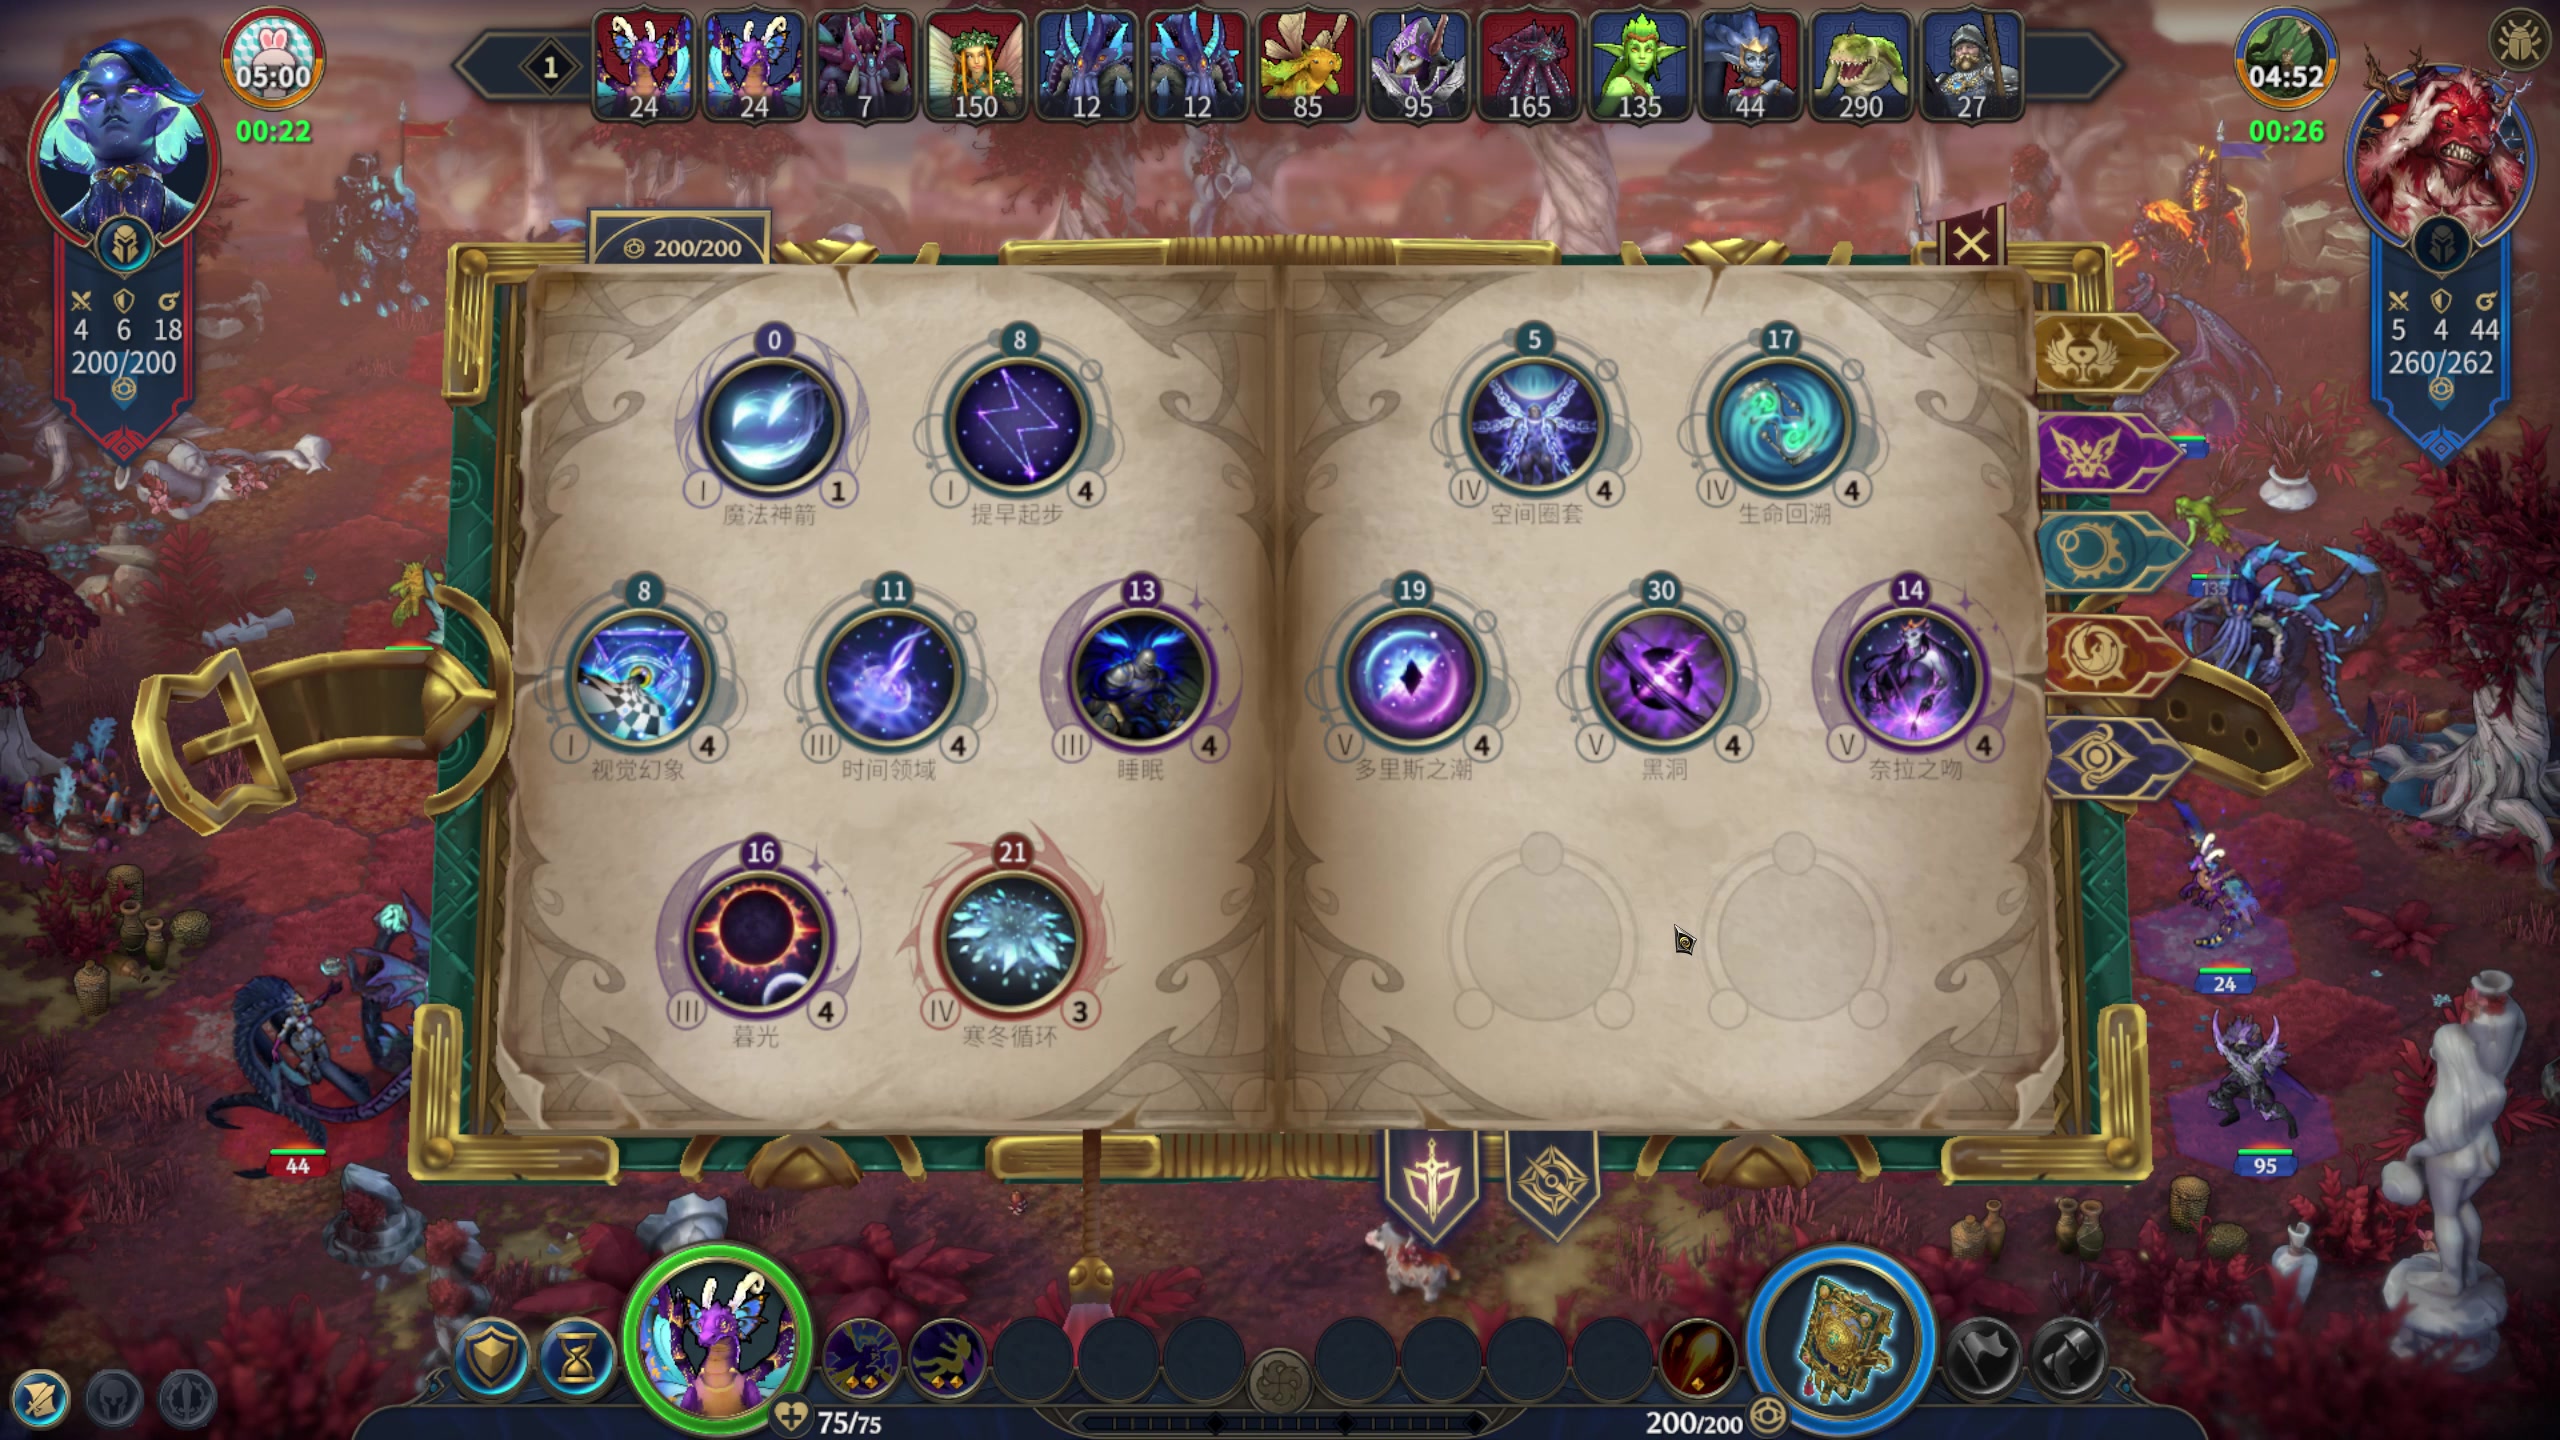
为什么直接裁图和放大还不够?
第一种方法按书页的四格、六格、四格排列放置搜索框。它不再要求每一个法术名称都已识别,所以能找到“图标在、标题没读到”的位置;没有标题的格子保持名称未知。书本自身的布局与可见性检查仍必须通过。
直接裁图会带入数字周围的圆环,识别器可能把 I 看成 0,或把数字和装饰一起转写。第二种方法先在同样的位置附近寻找小圆框,再只裁圆内的区域。程序用像素边缘做圆检测,不读取参考答案;找不到圆时保留原搜索框。这叫 Hough 圆检测,可以理解为让许多边缘像素共同投票,指出哪里像一个圆。
每个位置都保留原尺寸和“填充 8 像素后放大 4 倍”的读法。放大只是重新组织已有像素,不会补出截图本来没有的笔画;模型内部还会调整输入尺寸,因此不能保证外部放得越大就越准。本轮没有用生成式超分辨率造出更清楚的字。
同样的小字,哪个方法读得更全?
这次检查 5 段已曝光录像的 8 张原图,不包含新验收录像。助手逐张看图记录了 171 个可见阿拉伯数字、86 个罗马数字,以及 191 个空槽、遮挡和中央图案负例。参考仅覆盖书页徽标,不是整帧 UI 标注,仍待作者确认;近邻帧也不能当作独立样本。
两种裁框方法各有 448 个位置。PP-OCRv6 medium 都读两遍;PaddleOCR-VL-1.6 再读同一组圆内裁图,共 2,688 次本地读取。模型输出先保存,参考只在之后评分。下表列出主要方案;其余读法及拒识原因在逐项审核页保留。
| 方法 | 阿拉伯数字精确 / 171 | 罗马数字精确 / 86 | 负例错误接受 / 191 |
|---|---|---|---|
| 旧全图字段 | 167 | 0,原来未定义这些字段 | 0 |
| 布局裁图,PP 原尺寸 | 132 | 21 | 0 |
| 圆内裁图,PP 原尺寸 | 171 | 50 | 1 |
| 圆内裁图,PP 放大配方 | 155 | 16 | 2 |
| 圆内裁图,VL 原尺寸 | 171 | 86 | 28 |
| 圆内裁图,VL 放大配方 | 171 | 73 | 32 |
圆内裁图确实改善了识字;同样使用 PP 原尺寸,阿拉伯数字从 132 个读对增至 171 个,罗马数字从 21 个增至 50 个。VL 原尺寸进一步读对全部 86 个罗马数字。但它还从 26 个图案区域、2 个遮挡区域输出了数字。能认清小字,与不会在没字的地方猜出字,是两件事。 表中的单模型结果还没有剔除中央图案,特意保留这个对照。
PP 放大配方在可见罗马数字上另有 2 个错读,其余未命中为拒识;VL 放大配方少读 13 个罗马数字。这里不能宣称“VL 在所有 OCR 任务最好”:前一组属性格实验是 PP 原尺寸最好,这一组罗马数字则是 VL 更好,任务和裁图都会改变结论。
最后怎样组合,而不是逐项挑正确答案?
看过上述结果后,我们另存了一条开发组合规则:不把中央图案当数值字段,没有图案存在迹象的空格先拒绝;阿拉伯数字要求 PP 和 VL 的原尺寸读值一致;罗马数字以 VL 的完整合法字面为主,PP 如果也给出合法罗马数字,两者必须相同。PP 无法解析的罗马数字明确标为“仅 VL 支持”,不是双模型共同确认。
例如被悬浮说明遮住的一格,PP 读成 10,VL 读成 4,两者冲突便不采用。规则不使用“这格正确答案应该是多少”,也没有把 1、l、三 猜成罗马数字。
这条组合在本组得到 257/257 个可见徽标精确、191/191 个负例拒绝。这是根据同组失败选择规则后的开发回归成绩,不是独立准确率。规则没有立刻替换视频默认输出,而是先进入下一组检查;新的画面很快暴露了它的适用范围。
10. 换一批书页:中央也可能有数字
我们保持上述规则不变,取另外7段已有开发录像中的全部11张魔法书候选。10张平铺书页进入局部OCR;1张翻页图被原有布局规则拒绝,仍保留在审核清单。这些来源与上一组不同,但项目早已研究过它们,所以这是扩大开发覆盖,不是独立验收。
灰暗的图案,不等于旁边的字不可读
下图中的法术图案变暗了,上方的16、22、44、32却仍很清楚。“审判”和“连锁闪电”的中央还各有一个2。上一组中央恰好都是图案,不能据此认定所有画面都没有中央数字。
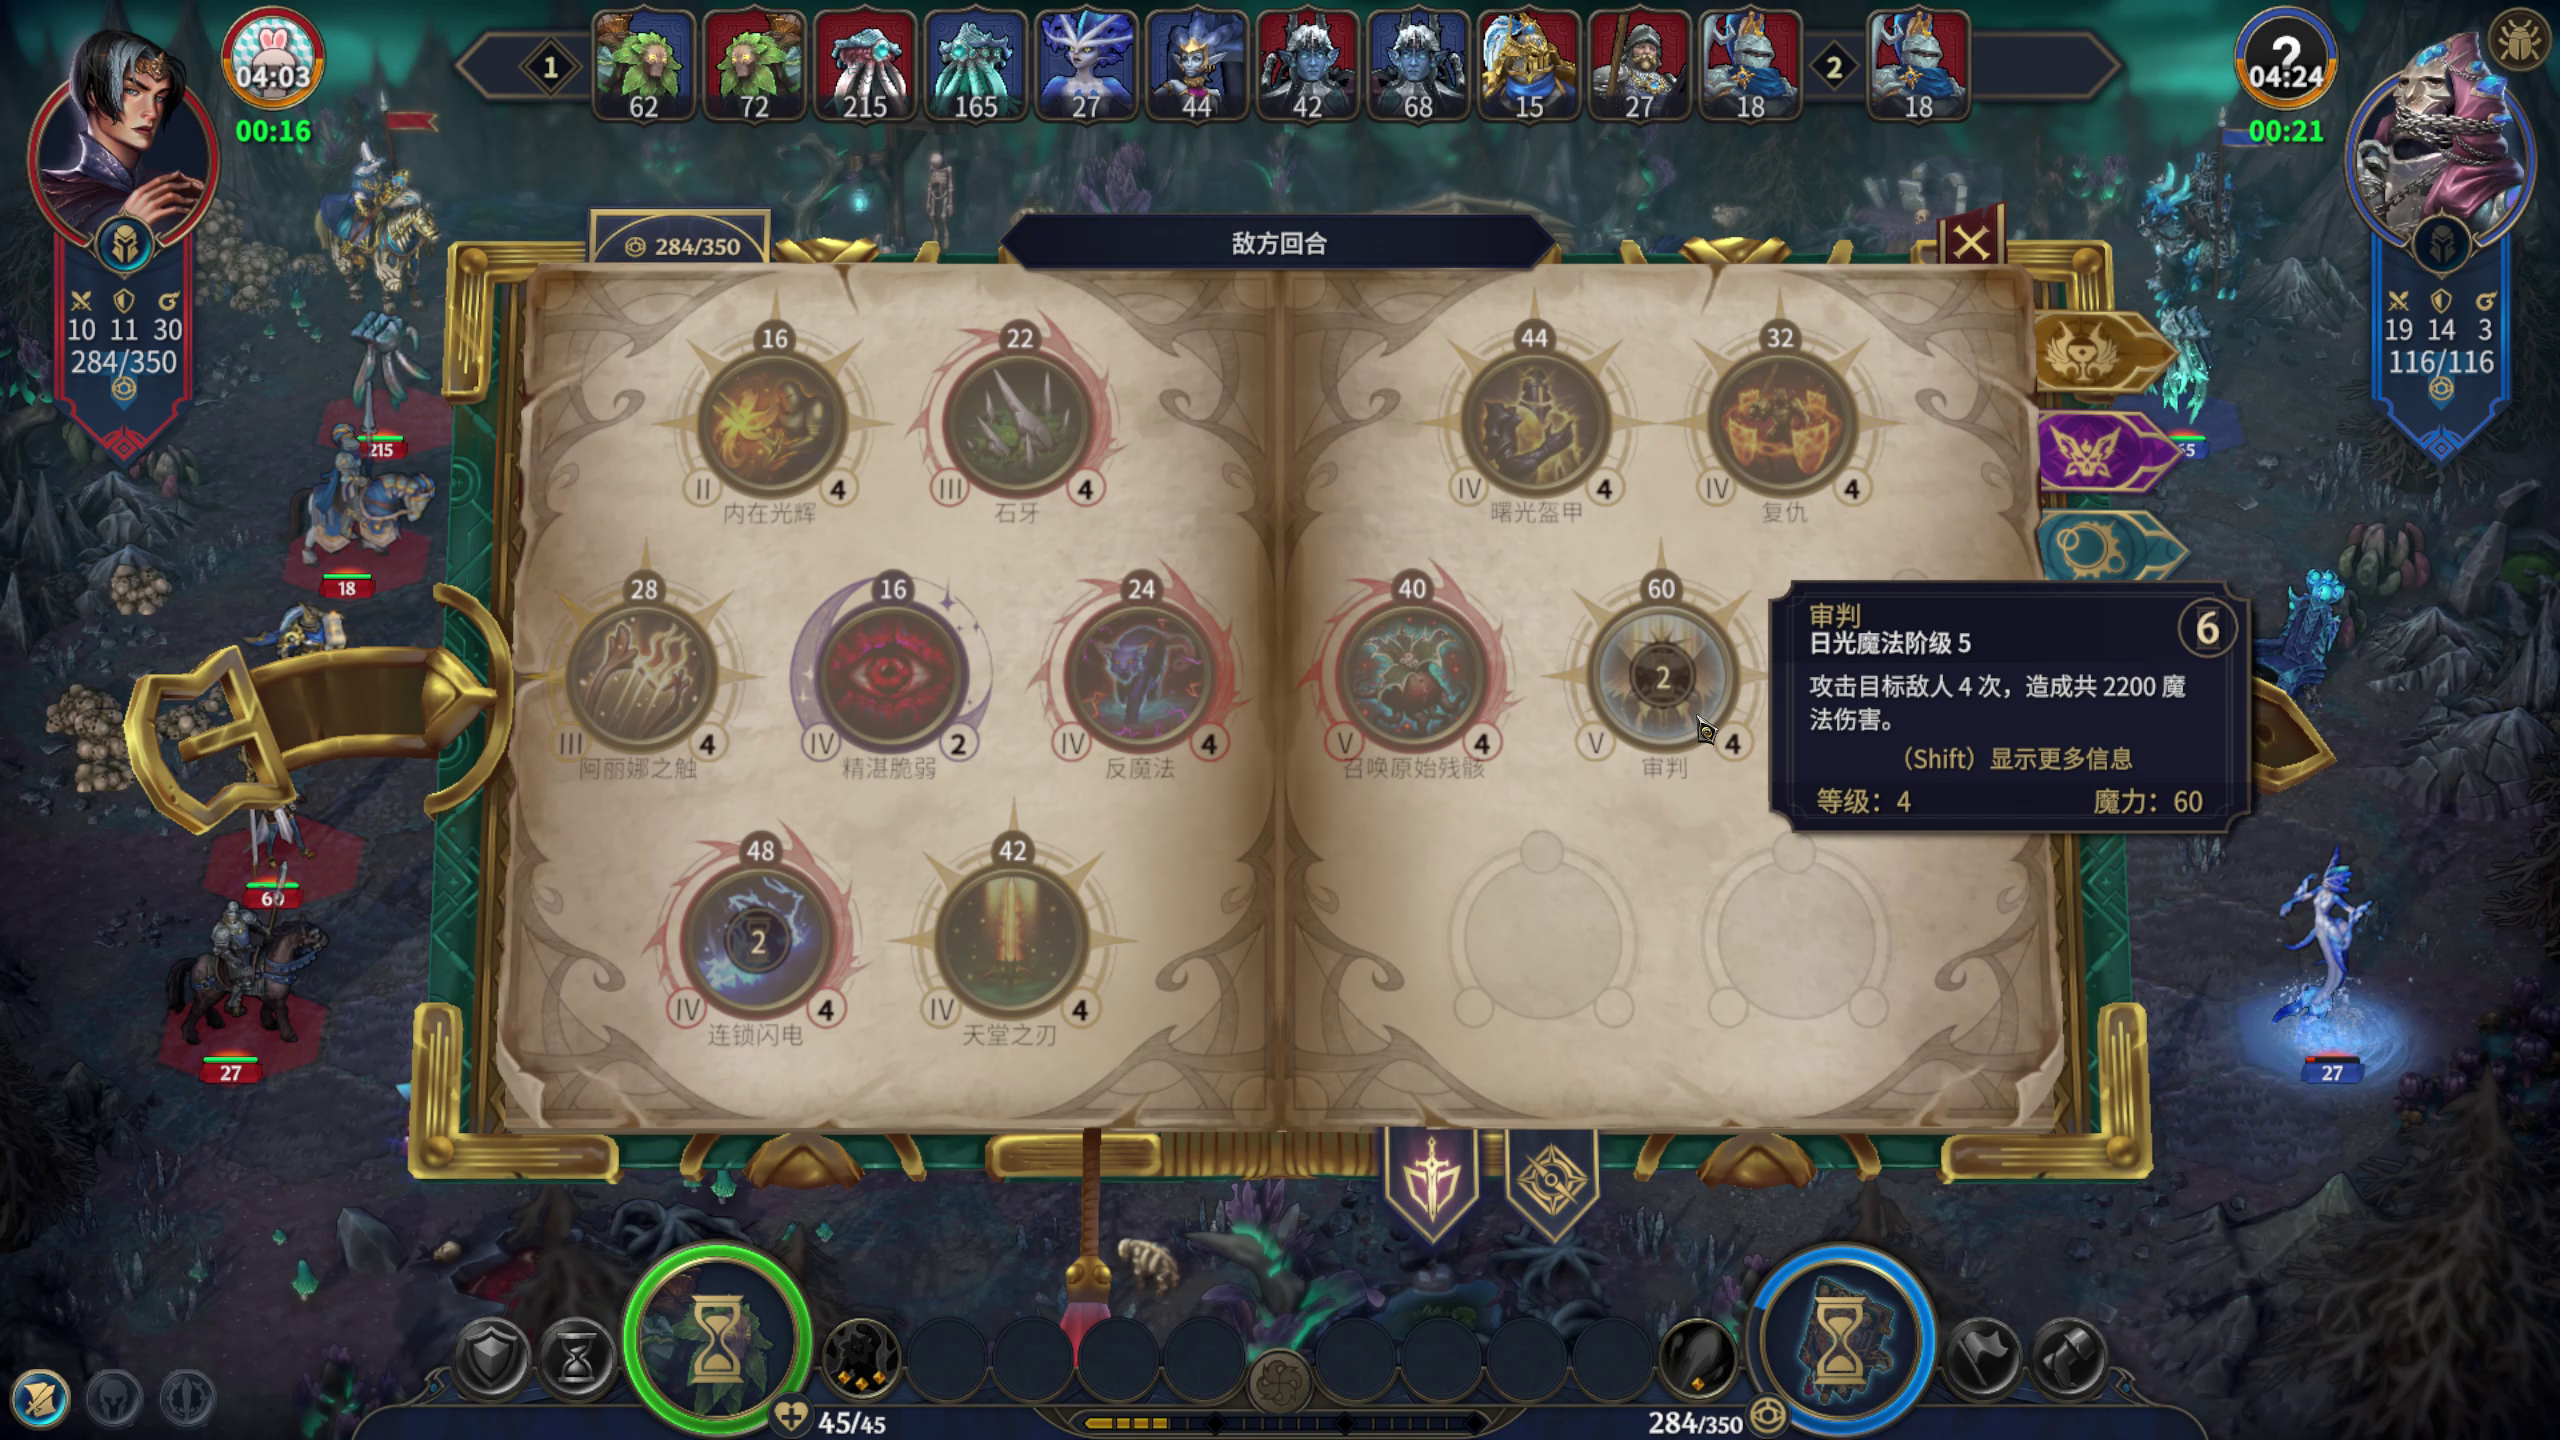
整批原图新增了4个中央数字参考。旧组合把它们全部过滤,还因图标亮度不足丢掉了36个已经被两模型读对的外圈阿拉伯数字。因此,新开发分支把“图标是什么外观”和“文字是否可读”分开:亮度记录继续保留,但不再仅凭图标灰暗丢弃旁边清楚的字。中央数字也允许参与识别,仍须两模型原尺寸字面一致,且PP分数至少0.90。
遮住一部分,也不能整格拒绝
下面的悬浮说明遮住了右页的一部分,但靠近说明框右下边缘的徽标4仍然可读。这里也发生了一次参考标注错误:最初看整图时把它标成了遮挡,放大原始裁图后才确认,浅色纸面上的黑色4仍露在外面。它不是悬浮说明里的金色等级4,两模型也没有读错。
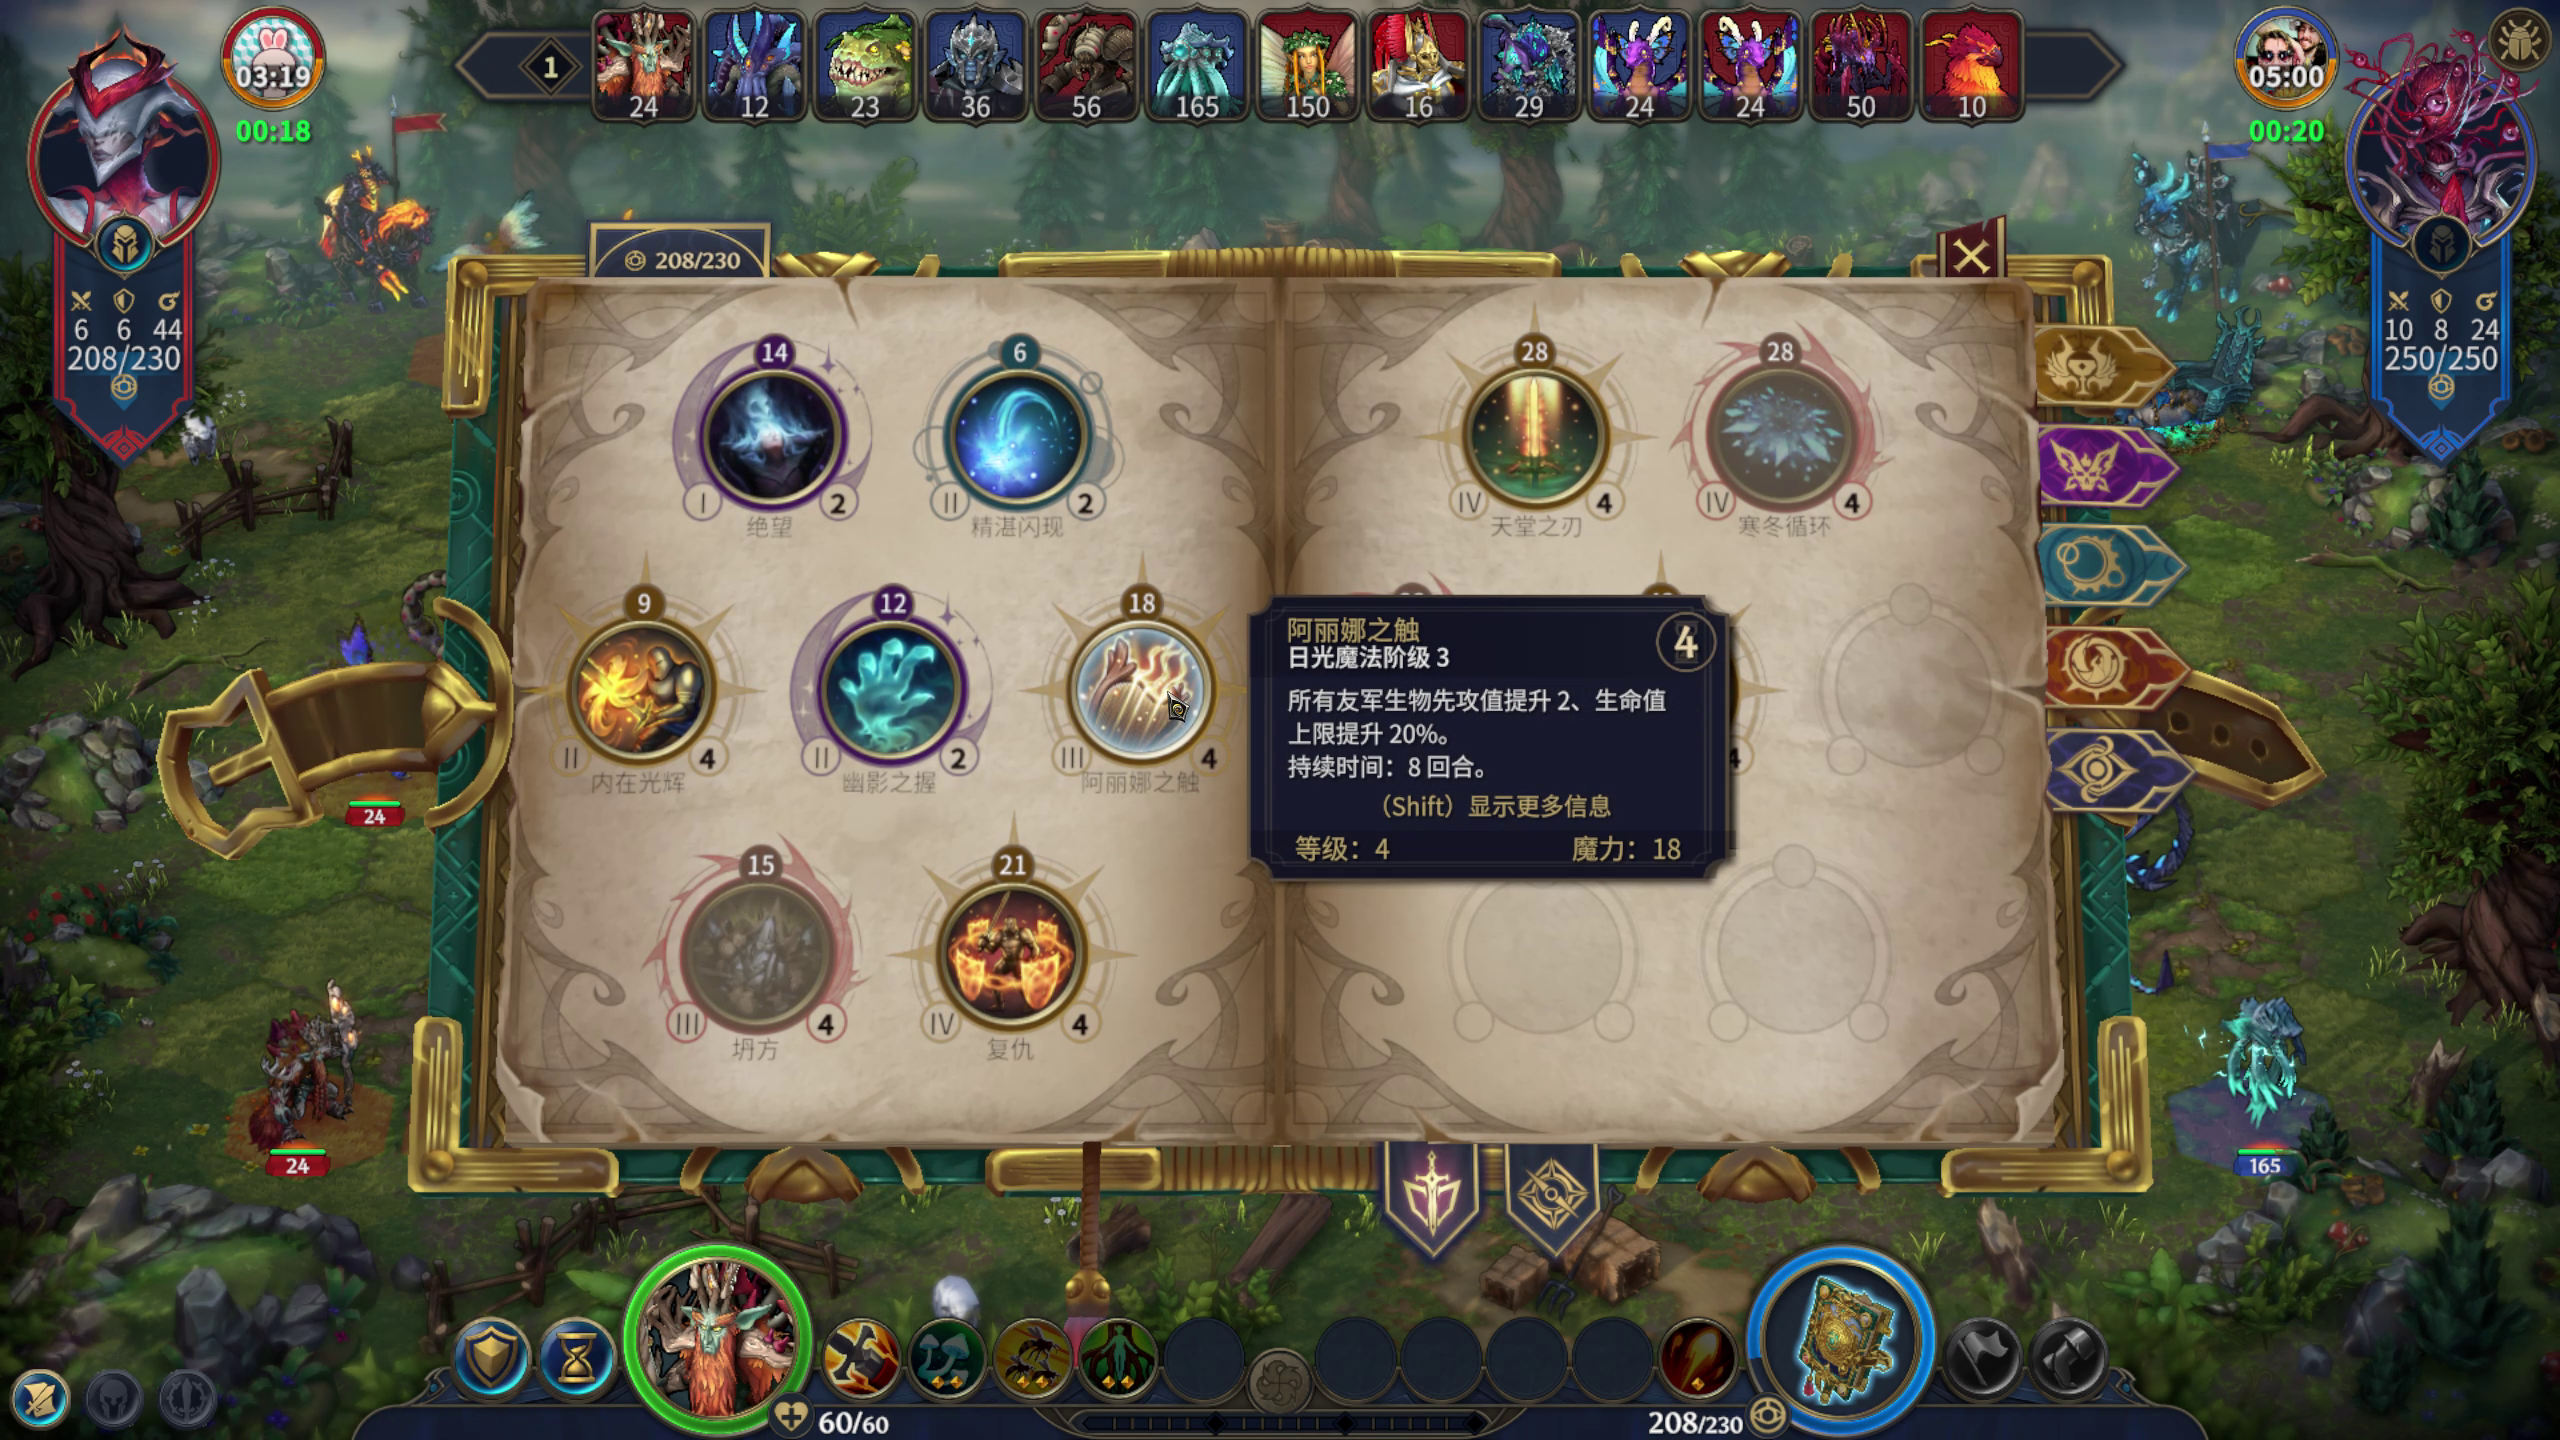
我们也试过按下方裁图的背景亮度过滤:蓝底比例高就拒绝。它恰好丢掉了这个仍能读清的4,所以最终组合没有采用这条规则。试验输出保留在对照页,参考已更正;不能用错误参考证明一个过滤器有效。
修正后,多读到了什么?
参考包含211个外圈阿拉伯数字、106个罗马数字、4个中央数字,以及239个空槽、遮挡和图案负例,均逐张看原图记录,待作者确认。翻页图另作一次整页门控检查,不把它的56个未运行格位算成56次OCR成功。三个裁图/模型组合共完成3,360次本地读取,新分支复用这些原始读数。
| 方法 | 外圈 / 211 | 罗马 / 106 | 中央 / 4 | 负例误收 / 239 |
|---|---|---|---|---|
| 原全图字段 | 197 | 0 | 3 | 0 |
| 上一组冻结的组合 | 175 | 82 | 0 | 0 |
| VL原尺寸,尚未过滤 | 211 | 99 | 4 | 25 |
| 独立判断文字可读性的组合 | 211 | 99 | 3 | 0 |
表中前三列为字面精确数。新组合共 313/321精确,8项拒识,没有接受错误值;回到旧8图,仍保留257个正确读值、拒绝191个负例。它在看到扩展组失败后才修改,所以313/321是开发回归成绩,不能写成新视频准确率。
剩下7个罗马I,被模型写成了小写l、带圈的1或感叹号;另一个中央2虽被VL读对,PP却只有0.554的分数。我们没有降低单例阈值、替换参考或靠游戏知识补值,原图与失败读法都留在扩展审核页。接着只做一轮有边界的裁图对照,再把已验证配方接入视频。
裁得更集中,和把图片放大,是两回事
中央框原来把数字左右的图案一起交给识别器。现在保持它的中心不动,只取48×40像素;罗马数字继续使用原来的圆内框。两组书页的所有左下与中央位置都重读,包括空槽、遮挡和图案,共504个裁图,而不是只挑那8个失败。另试一份灰度化、填充8像素后放大2倍的配方,两个模型共完成2,016次读取。
收紧中央框后,前面那个2终于被PP高分读出,也与VL相同。本组4个中央数字全部读对,170个本轮覆盖的负例没有误收。 7个I仍然拒识,没有自动把小写l改成I。回到旧8图,也保留全部86个罗马字面,138个相应负例全部拒绝。这里的负例分母只含左下与中央;没有重跑上方和右下,不能与前表239直接混用。
灰度放大并没有帮助:扩展组罗马字面从99/106降到70/106,中央从4/4降到3/4,还错误接受4个空槽位置;旧组也从86/86降到72/86,并把1个图案接受成数字。因此不采用这份配方。它同时改变颜色、填充与倍率,结果不能归因于其中某一项。
在局部裁图对照页选择“查看裁图”,可以比较同一张原图上的大框和小框,旁边保留每遍原文。这个例子支持继续优化区域,而不是“只要放大就一定识别正确”。小裁框修正仍单独保存,不在各字段之间按答案挑选最好结果。
让已经读出的字,出现在真正的视频时间线上
首次接线时,我们把前表的独立读字组合接入一个明确开启的离线步骤,暂不混入刚做完的裁图试验。它处理已有18分46秒开发录像的全部248张候选:11张书页完成616个裁图的双模型读取,另7张书页被质量规则跳过。可读候选389项,包括132个上方数字、125个罗马字面和132个右下数字;227项留空。其余图片也保留“没有找到书页”或“场景未确认”的处理状态。
这些值已经能在实际视频时间线按原图检查。原字段、其他模块和已有冲突全部保留;389不是389条全新信息,更不是准确率。当时只有450.2秒这一张可复用既有参考,36个字面一致、20个负例拒绝;其余353个候选的核对结果见本节末尾。我们先查看被跳过的7张原图,发现它们并不是不能读。
字很清楚,但根本没有送给 OCR
下图的左页有7个法术图标,右页是空白。字牌上的8、11、17和罗马数字都能辨认,程序却没有尝试读取。原因在识字之前:原来的质量规则为了拦住翻页画面,要求两页都能找到排布整齐的标题。只有左页有内容的正常书籍,也被这个条件拦住了。
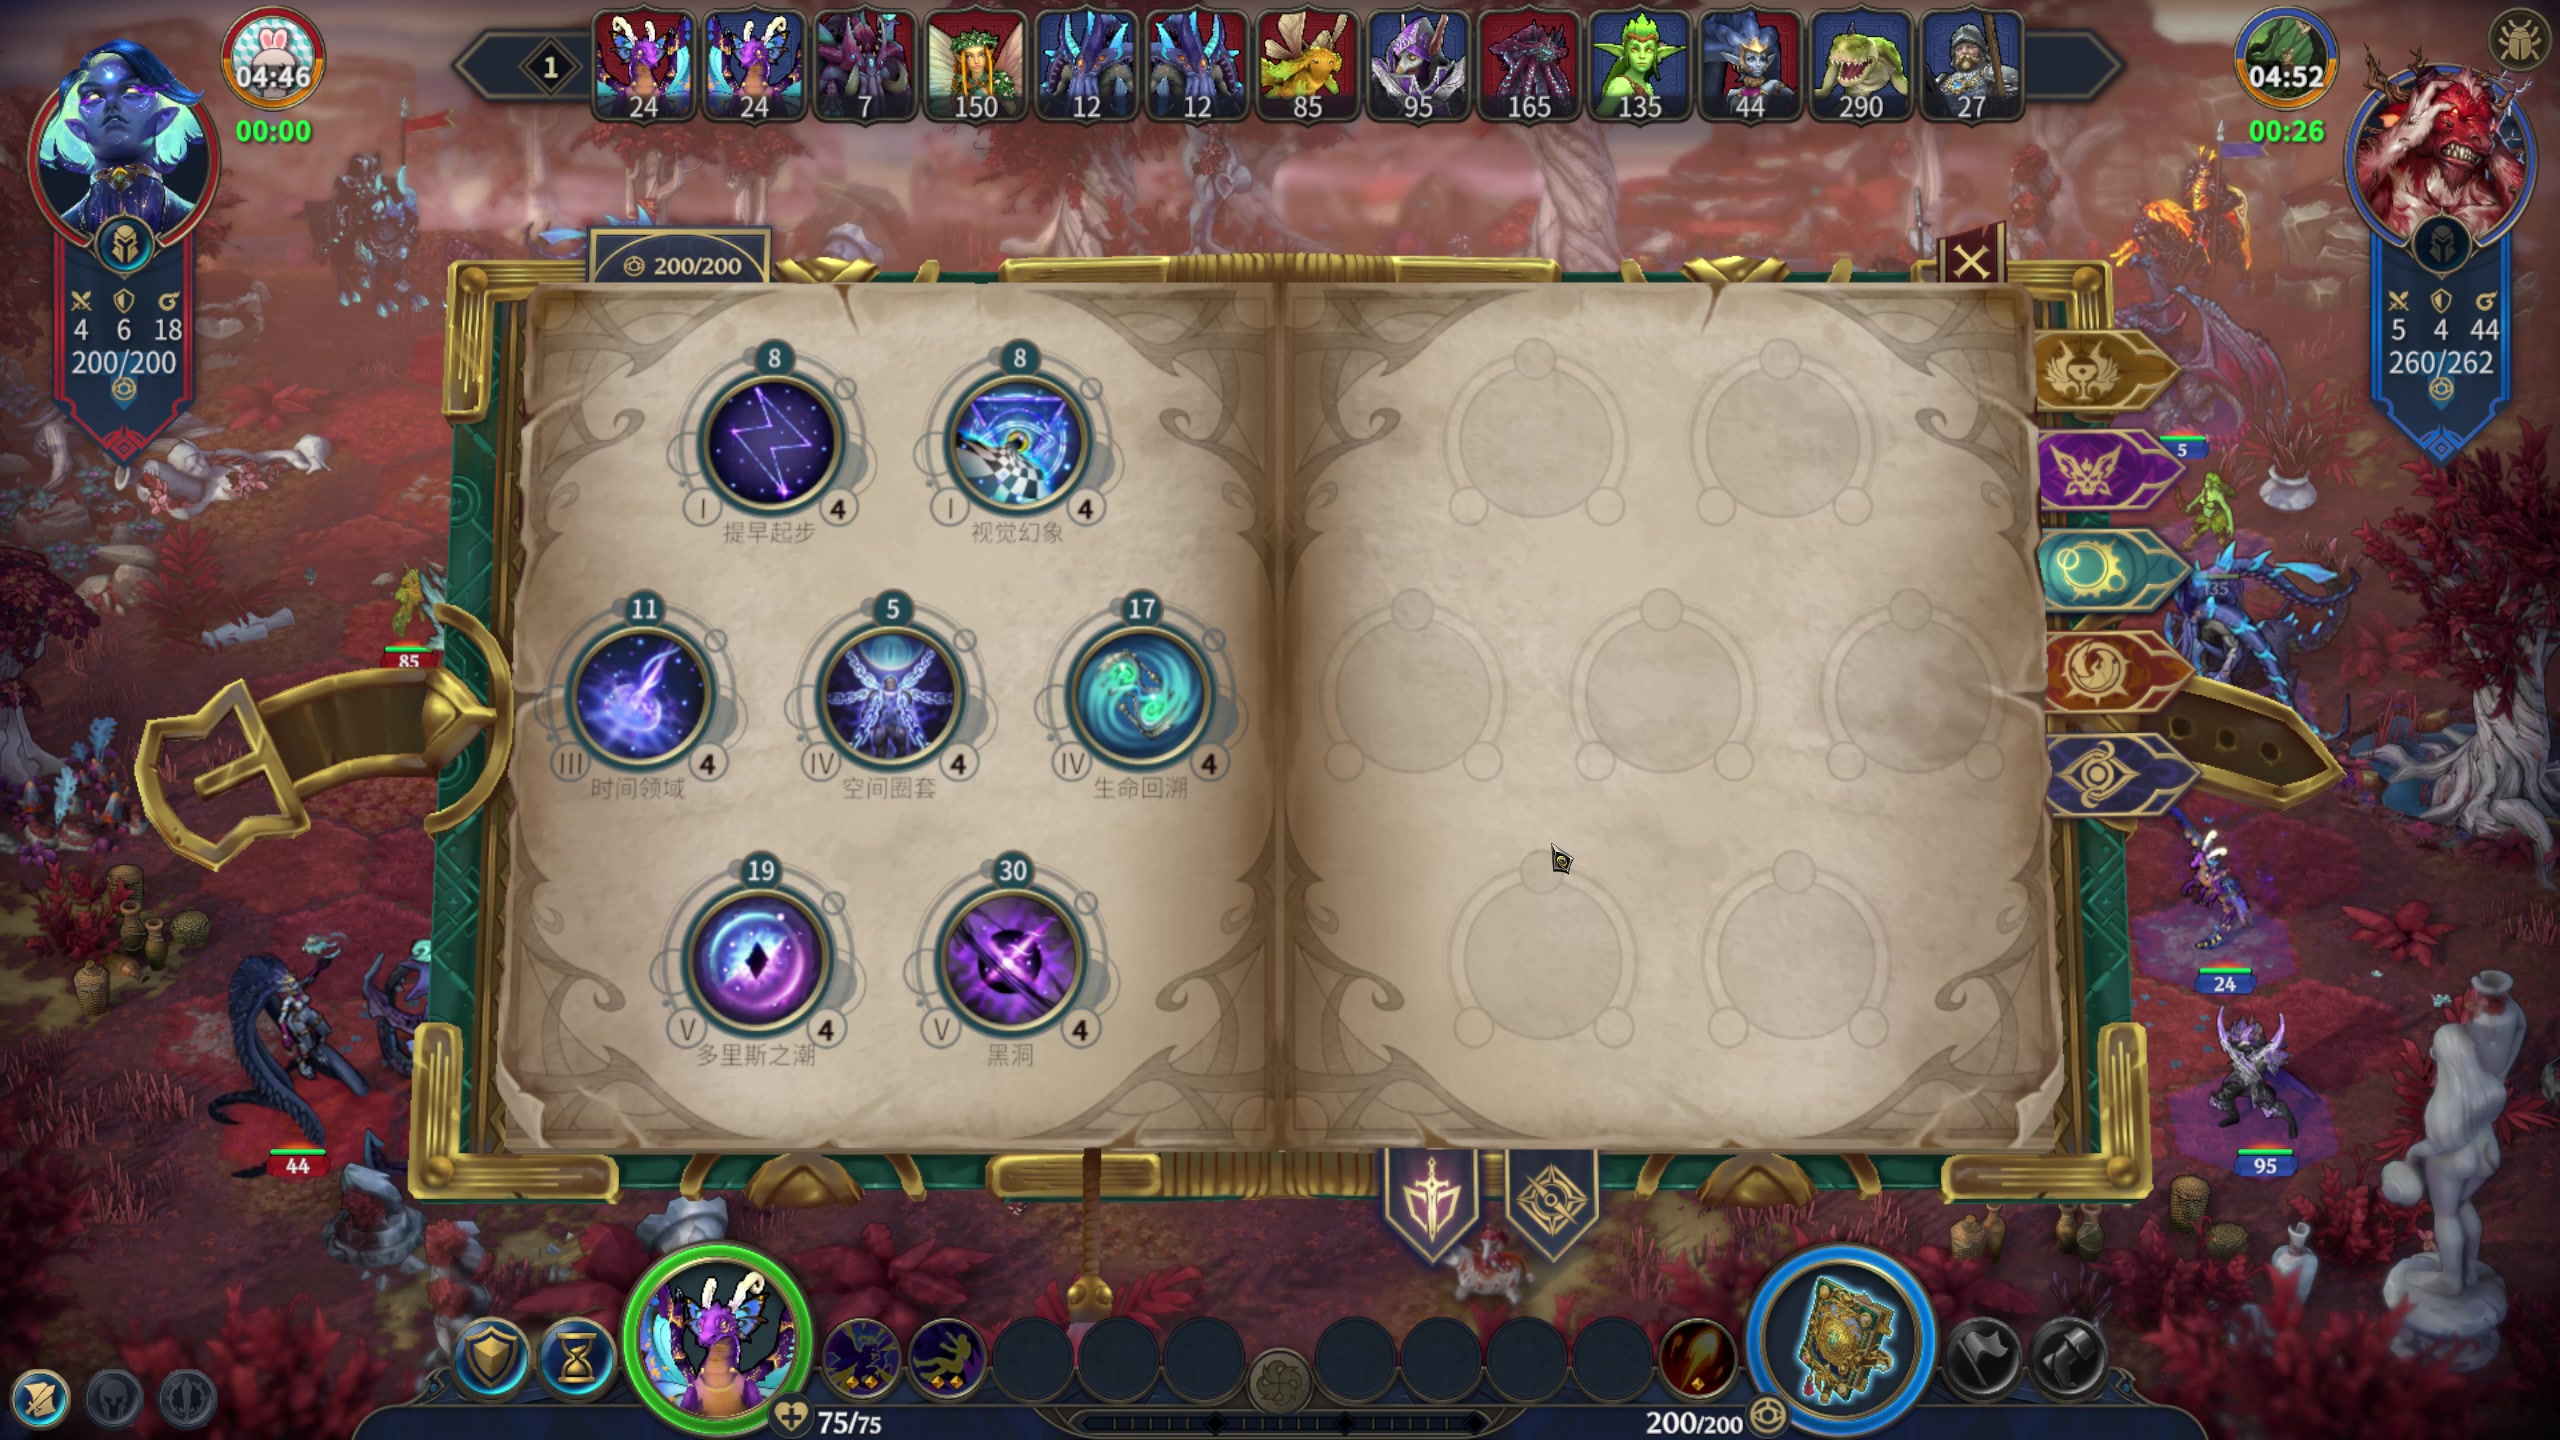
逐张查看后,7张被跳过的图都是这种情况。新实验保留行列偏移、倾斜和越界检查,只给一种情况增加读取机会:同一侧至少6个不同标题位置,三行各有至少2个,且没有其他可见性拒绝原因。程序扫描既有248张候选后自动找出这7张,并非按人工名单强制放行。回到以前19张书页,18张原通过不变,原来的翻页图仍被拒绝。
我们为这7张图逐项记录147个可见字面和245个空槽、中央图案位置,再让两个本地模型各读原尺寸和填充放大4倍的裁图,共1,568次读取。结果如下;表中的“读对”同时检查位置与完整字面。
| 组合配方 | 可见字面读对 /147 | 拒识 | 负位置误收 /245 |
|---|---|---|---|
| 原尺寸裁图 | 146 | 1 | 0 |
| 填充后放大4倍 | 118 | 29 | 4 |
这次收益来自让清楚的字真正进入识别器,而不是放大。4倍配方反而丢掉一些读数,并把4个空槽当成了罗马数字,因此不采用。剩下的一个I被模型读成l或1,继续留空;不会因为参考写着I,就自动纠正成I。
单页书籍实验页保留全部读法;视频时间线现在也能直接查看这7张原图。选择“参考与本地候选对照”,同一位置的两张卡片会相邻显示;青色框是逐图核对的位置范围,黄色框是程序的搜索区域。也可以只看参考或只看预测。
接入视频后,两模型又对新增392个位置完成784次原尺寸读取,文字和分数与实验记录逐项一致;原11张的616个位置直接复用来源、裁框和模型配置完全相同的记录。全部248帧的其他模块结果也逐项保留。
这7张来自同一段视频、书页内容相似,结果不能代表所有书籍或所有游戏数字。新流程单独保存,旧输出不覆盖;参考只在读取完成后参与评价与展示。
其余书页的候选,到底读对了多少?
随后逐张查看剩余10张双页原图,补齐360个可见字面和200个空槽、图案位置参考,再与已冻结的输出比较:353项精确、7项拒识,没有错收,200个负位置也没有误报。 新漏读全部是左下细小的罗马I;参考写着I,模型仍留空。
连同前面的7张单页和原450.2秒图,这段录像18张书页的543个可见字面中,535个读对、8个拒识,465个负位置没有误收。原来列表里的“473个拒识”因此不是漏掉473个数字:465处本来就没有目标字面。
新增10张参考对照已经进入同一时间线。它们是同一录像中的相似书页,参考仍待作者确认,也只覆盖这些位置,不包括所有标题、说明和战场元素。现在更值得做的是换视频、补短悬停与遮挡案例,而不是一直围绕这几个I调参。
这也回答了“是不是已经用了最先进OCR”:我们确实运行了较新的PaddleOCR-VL-1.6;其官方模型说明报告了领先的文档基准成绩,但那不等于它在游戏小数字上必然最好。这里真正提高结果的,是合适的裁图、不同模型的实测互补,以及不把读对的字连到错误位置。
展开书页接线检查:名称与数字为什么没有一起输出
后续接线:数字读到了,为什么结果还是空的?
9月22日检查一张夜影法术书时,人能看到“暮光”旁边写着20,旧结果里的数字字段却是空的。原因不全在OCR:程序原先要求左右两页都有足够的名称,右页为空的正常书本也被拦住了。此前已有允许密集单页继续读取的小模块,这次把它与现存OCR、名称和角标位置真正组合起来。
做法很直接:先确认书页的名称排列合理,再按每个图标的位置分别找上方、左下、右下的文字,把它们连到同一格的名称。图标中央偶尔出现的1、2、3另有位置,不能混入这三个角标。程序不从资料库填数字,也不由20反推对方技能。
这里还有一个不显眼的错误:长名称的文字框可能稍微碰到旁边的角标框。原先“沾到一点就算冲突”的方法会连正确读数一起丢掉。现在先看文字中心在哪个区域、是否主要覆盖这个区域;真正跨栏或互相矛盾的读法仍不采用。
| 在6张书页上检查什么 | 小重叠就拒绝 | 按文字所属区域配对 |
|---|---|---|
| 名称读对 | 36/42 | 42/42 |
| 上方数字读对 | 41/42 | 41/42 |
| 左下罗马数字读对 | 12/42 | 19/42 |
| 右下数字读对 | 36/42 | 42/42 |
| 名称与角标同时正确 | 84/126 | 102/126 |
126个空白角标位置均没有输出数字;剩余24个可见角标是没读出,没有在这组里接受错字。这6张来自同一局、同一法系的重复书页,助手参考仍待用户审核。 数字不能解释成全游戏准确率;本轮也没有训练新OCR。改善的是如何使用已有识别结果。
没读出的小角标,再单独读一次
9月23日的改动是:只对已有图标、书页检查允许、但还没读出的角标,沿用现有裁图算法和两个本地模型,在原尺寸的小区域上重新识字。阿拉伯数字要求两个模型一致;罗马数字允许一个模型给出合法的罗马字母,而另一个没认出,但会单独注明这种较弱支持。已有高分读数与补读冲突时仍留空,不查游戏资料补答案。
同一批六张图的配对从 102/126 提高到 122/126,126个空白位置仍无输出。剩余四项中,模型把 I 读成小写 l;我们没有根据参考答案把它改回来。另取五段其他录像的八张旧实验图,角标内容与位置从211/257提高到257/257,79个空白或遮挡位置没有输出;这些图没有名称参考,所以不能声称257组名称配对都正确。
两组都已用于开发,参考也都待用户审核。结果说明复用局部识别可以恢复不少漏字,不说明新录像一定同样可靠。实际只补读了24和59个区域,各由两个已有模型读取;没有训练新模型,也没有复制截图或生成视频。
打开逐图对照:先切换数据组,再点名称,查看原搜索框和黄色虚线补读框;下面保留程序值、参考和原始读法。其他26张没有完整参考的候选仍明确写着“未审”。
新配对尚未替换默认视频输出,但已经接入可选补读流程。原视频的 7 帧检查中,一张书页由 15 个角标候选增加到 20 个,另有 1 个仍读不清;名称只接受了 5 个候选,还有两格未知。这不是准确率结果,而是提醒我们:局部字读得更全,名称关联仍可能缺失。接下来用未参与调试的录像检查,不继续围着这四个已知答案改规则。下面从头解释面板定位,并保留前几轮为什么逐步走到这里的实验依据。
法术少,也不应该整页跳过
随后在新录像抽检中发现一张五法术、两行的书页。旧单页方法要求至少六个名称、三行各两个,所以这些清楚的字又被挡住;几个变暗图标还被纹理检查当成空格。这次只允许有独立支持的格子读取:名称位置合理、没有倾斜或移位等其他拒绝原因,三个角标圆环也在原图上找到。它不改变原整页提交许可,也不因一格通过就放开空白格。
程序复用整屏的五个名称和十一个角标,再让已有两个本地模型补读四个角标。五个名称、十五个角标均与原图参考相符,九个空槽的二十七个角标位置没有输出。 但中央的“5”和书页资源“163/270”仍未接通,因此本张定义的参考是20/22,而不是整页已经读全。
原图对照报告与实际视频时间线均已更新。此图已用于诊断,助手参考待CTO审核;固定26张历史原图的新旧逐格输出不变,翻页仍拒识,但还缺其他来源的稀疏页与稀疏翻页反例。这条读法仅可选开启,默认不切换,下面的历史测量也不重算。
11. 悬浮说明:先确认切块里有没有完整的字
鼠标停在法术图标上时,游戏会显示名称、效果说明,以及下方的“等级”和“魔力”。此前我们已经给一些这样的图片画框并转录文字,但那只能检查“给定正确区域之后能否读出内容”。现在要去掉人工框,让程序自己找。
程序先找同一行的“等级”和“魔力”,再检查上方的标题、魔法阶级和帮助文字,彼此的位置是否符合提示框布局。只有位置关系组成唯一的一组,才生成各字段的搜索区域。名称可以是此前没见过的字符串,不需要从目录猜出是哪一个法术。
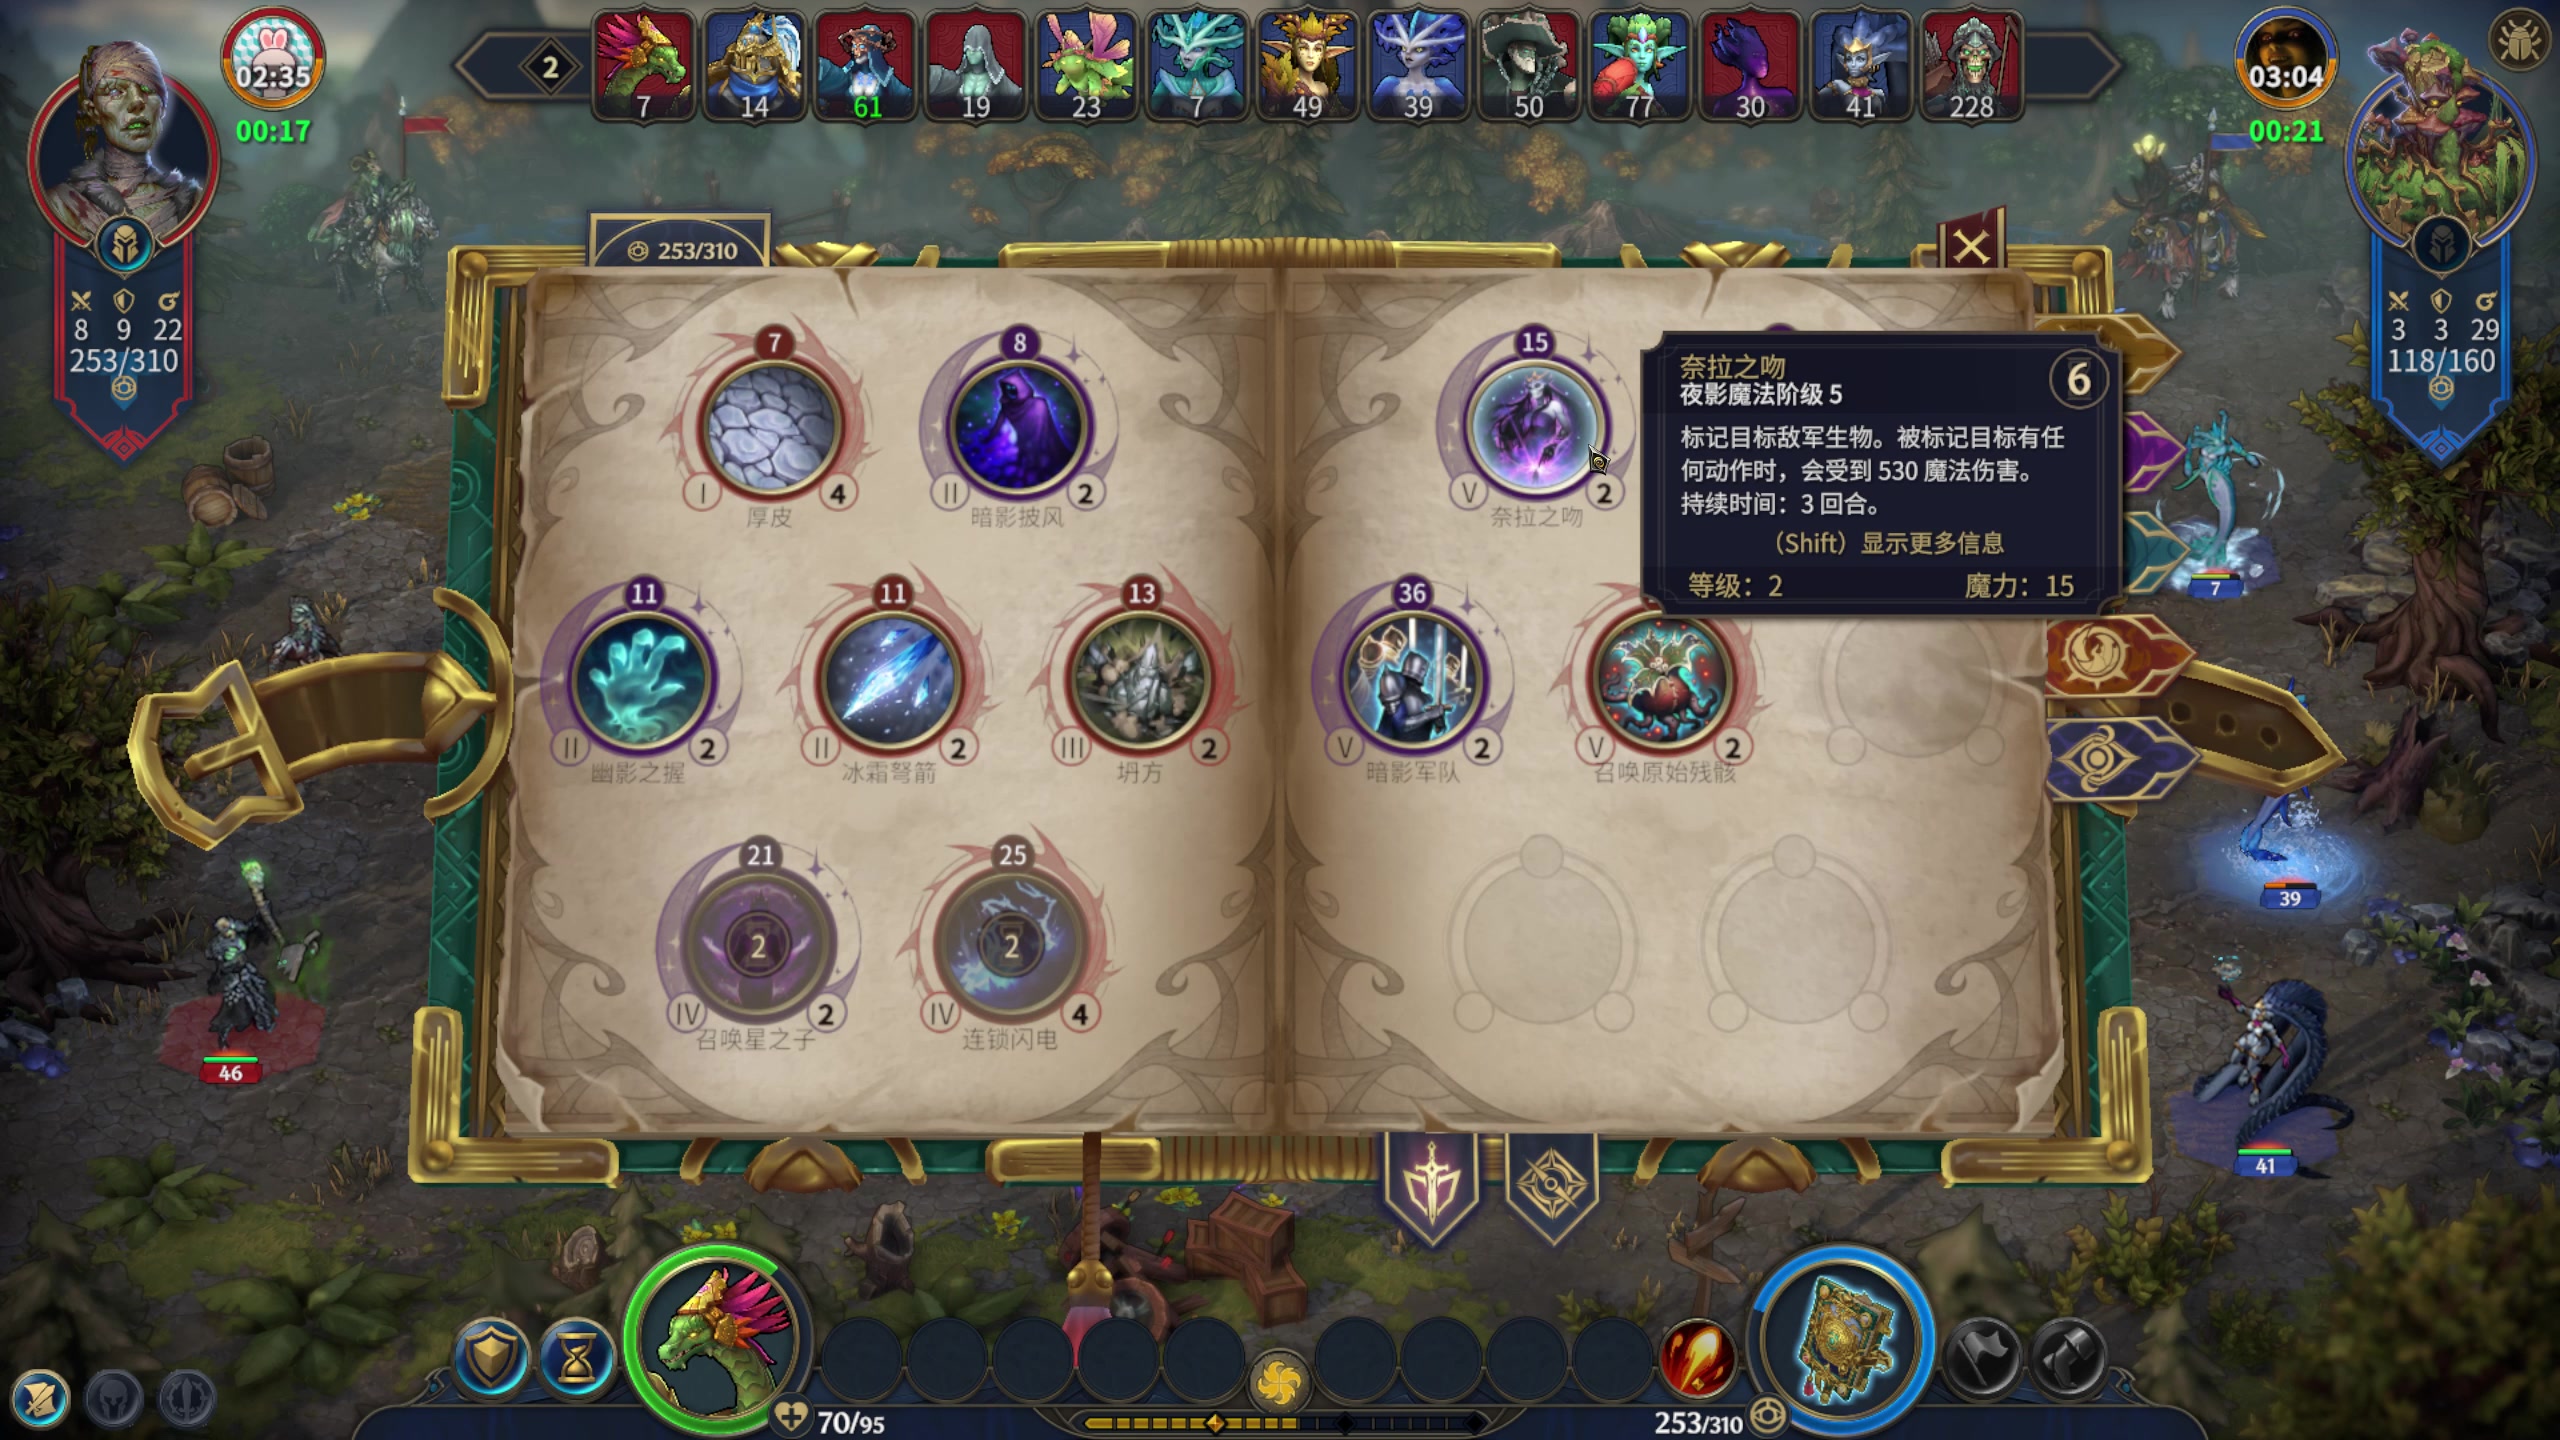
为什么完整名称和缺半截名称不该直接投票?
离线 OCR 会把整图分成相互重叠的切块,也会读取整图和放大版本。上图的一块恰好在标题中间结束,读出“奈拉之”;旁边包含完整标题的切块则读出“奈拉之吻”。原读取器看到两个字符串不同,就拒绝整个标题。它没有猜错字,却把本可使用的信息挡住了。
新对照先检查切块的实际像素范围:只有完整包含自动字段区域的切块,才参与这个字段的完整读数比较。 被排除的原文与坐标仍然保存,不是在几个答案中挑一个顺眼的。完整切块如果漏字、低分或读出不同数字,依然拒绝。
另一个小问题是阅读顺序:同一行的“(Shift)”和“显示更多信息”有时被拆开,两个框的上沿又略有高低。新规则先按竖直重叠把同一行放在一起,再从左向右连接。比较时只规范全半角和空白,不更正字符或数字。这些仍是同一个 OCR 模型的不同读法,不是多个模型独立确认。
到底多读到了多少?
这轮复用短悬停采集的403张已扫描图片,没有再跑OCR。自动场景判断允许206张进入面板流程,另197张被跳过。在允许的图片中找到16个法术提示框、124个字段:所有切块版接受70个,完整覆盖版接受115个;后者仍有7个冲突、2个缺字。这些是候选数量,不是正确数量。
随后用此前逐图核对的13张图片、158个稀疏字段检查位置和值。参考没有进入推理,但已用于开发分析,所以这不是独立测试。
| 同一组158个参考字段 | 原自动面板 | 加法术提示框 | 再筛完整切块 |
|---|---|---|---|
| 逐字段精确匹配 | 6 | 32 | 46 |
| 找到但拒读 | 0 | 17 | 3 |
| 没有匹配字段或尚未定位 | 44 | 1 | 1 |
| 字段角色尚未支持 | 10 | 10 | 10 |
| 限制和说明合成一段,单项不评分 | 6 | 6 | 6 |
| 被上游场景判断挡住 | 92 | 92 | 92 |
最后一版相对前一版新增15个正确字段,也少读了1个原来可读的角落4,因为有一遍完整切块没有检测到它;净增14。另有3段包含限制条件的完整说明读对,单独记录,不把每段拆成两个“正确字段”来加分。奈拉之吻与暮光的说明仍有真正冲突,保持留空。
这次冻结结果中,已匹配参考没有发现错误值被接受,但参考稀疏,也没有逐图标完16个候选的全部内容,不能据此宣称没有误报。更大的缺口是6张参考图被场景门挡住,合计92个字段根本没有进入后续读取。随后我们先处理了这个入口问题,再补能力说明。
自动提示候选可以左右翻帧,在“显示内容”中切换两种读法、原面板或人工参考;每项都能展开原始读数与裁剪取舍。全部1868张登记帧也保留1465张待OCR、197张场景跳过和206张流程完成。流程完成不表示整帧标完;新分支也尚未验证提示框何时足够稳定,可以交给在线系统。
后续场景入口对照区分了“不是战场”和“战场里打开了另一种面板”。同样403张扫描图,进入面板流程的图片从206增至369张;上述6张参考也全部进入。原158个参考字段中,精确数从46增至69,另4段合并描述单计。它还多放进一些过渡画面,因此这是增加离线读取机会,不是证明面板已稳定。下面的能力实验以这份保存结果为基础。
12. 能力说明:少一行,也可以是完整的提示框
生物的能力不是魔法书里的法术。它的说明底部通常写“能力消耗”,上方是“攻击”“正面效果”或“特殊”等类型,未必有法术的等级和魔力。继续套用法术布局,会整块漏掉这些字。
新定位器从“能力消耗”向上找:同一列要有类型、紧邻的标题和非空正文;位置关系唯一时,才生成读字区域。标题不限定为已知名字,也允许“冲锋!”这样的结尾标点。随后仍比较完整覆盖该字段的OCR切块,保留被排除的原文和冲突,不根据参考答案补字。这一步没有重新运行OCR模型。
为什么“是否结束回合”只能是可选项?
下图的“圣洗礼”有标题、类型、效果和能力消耗,却没有“不会结束回合”这一行。我们还在另一张图的“低语之森的回音”中看到了同样布局。初版把回合提示当作必备线索,因此两块说明都漏掉了。
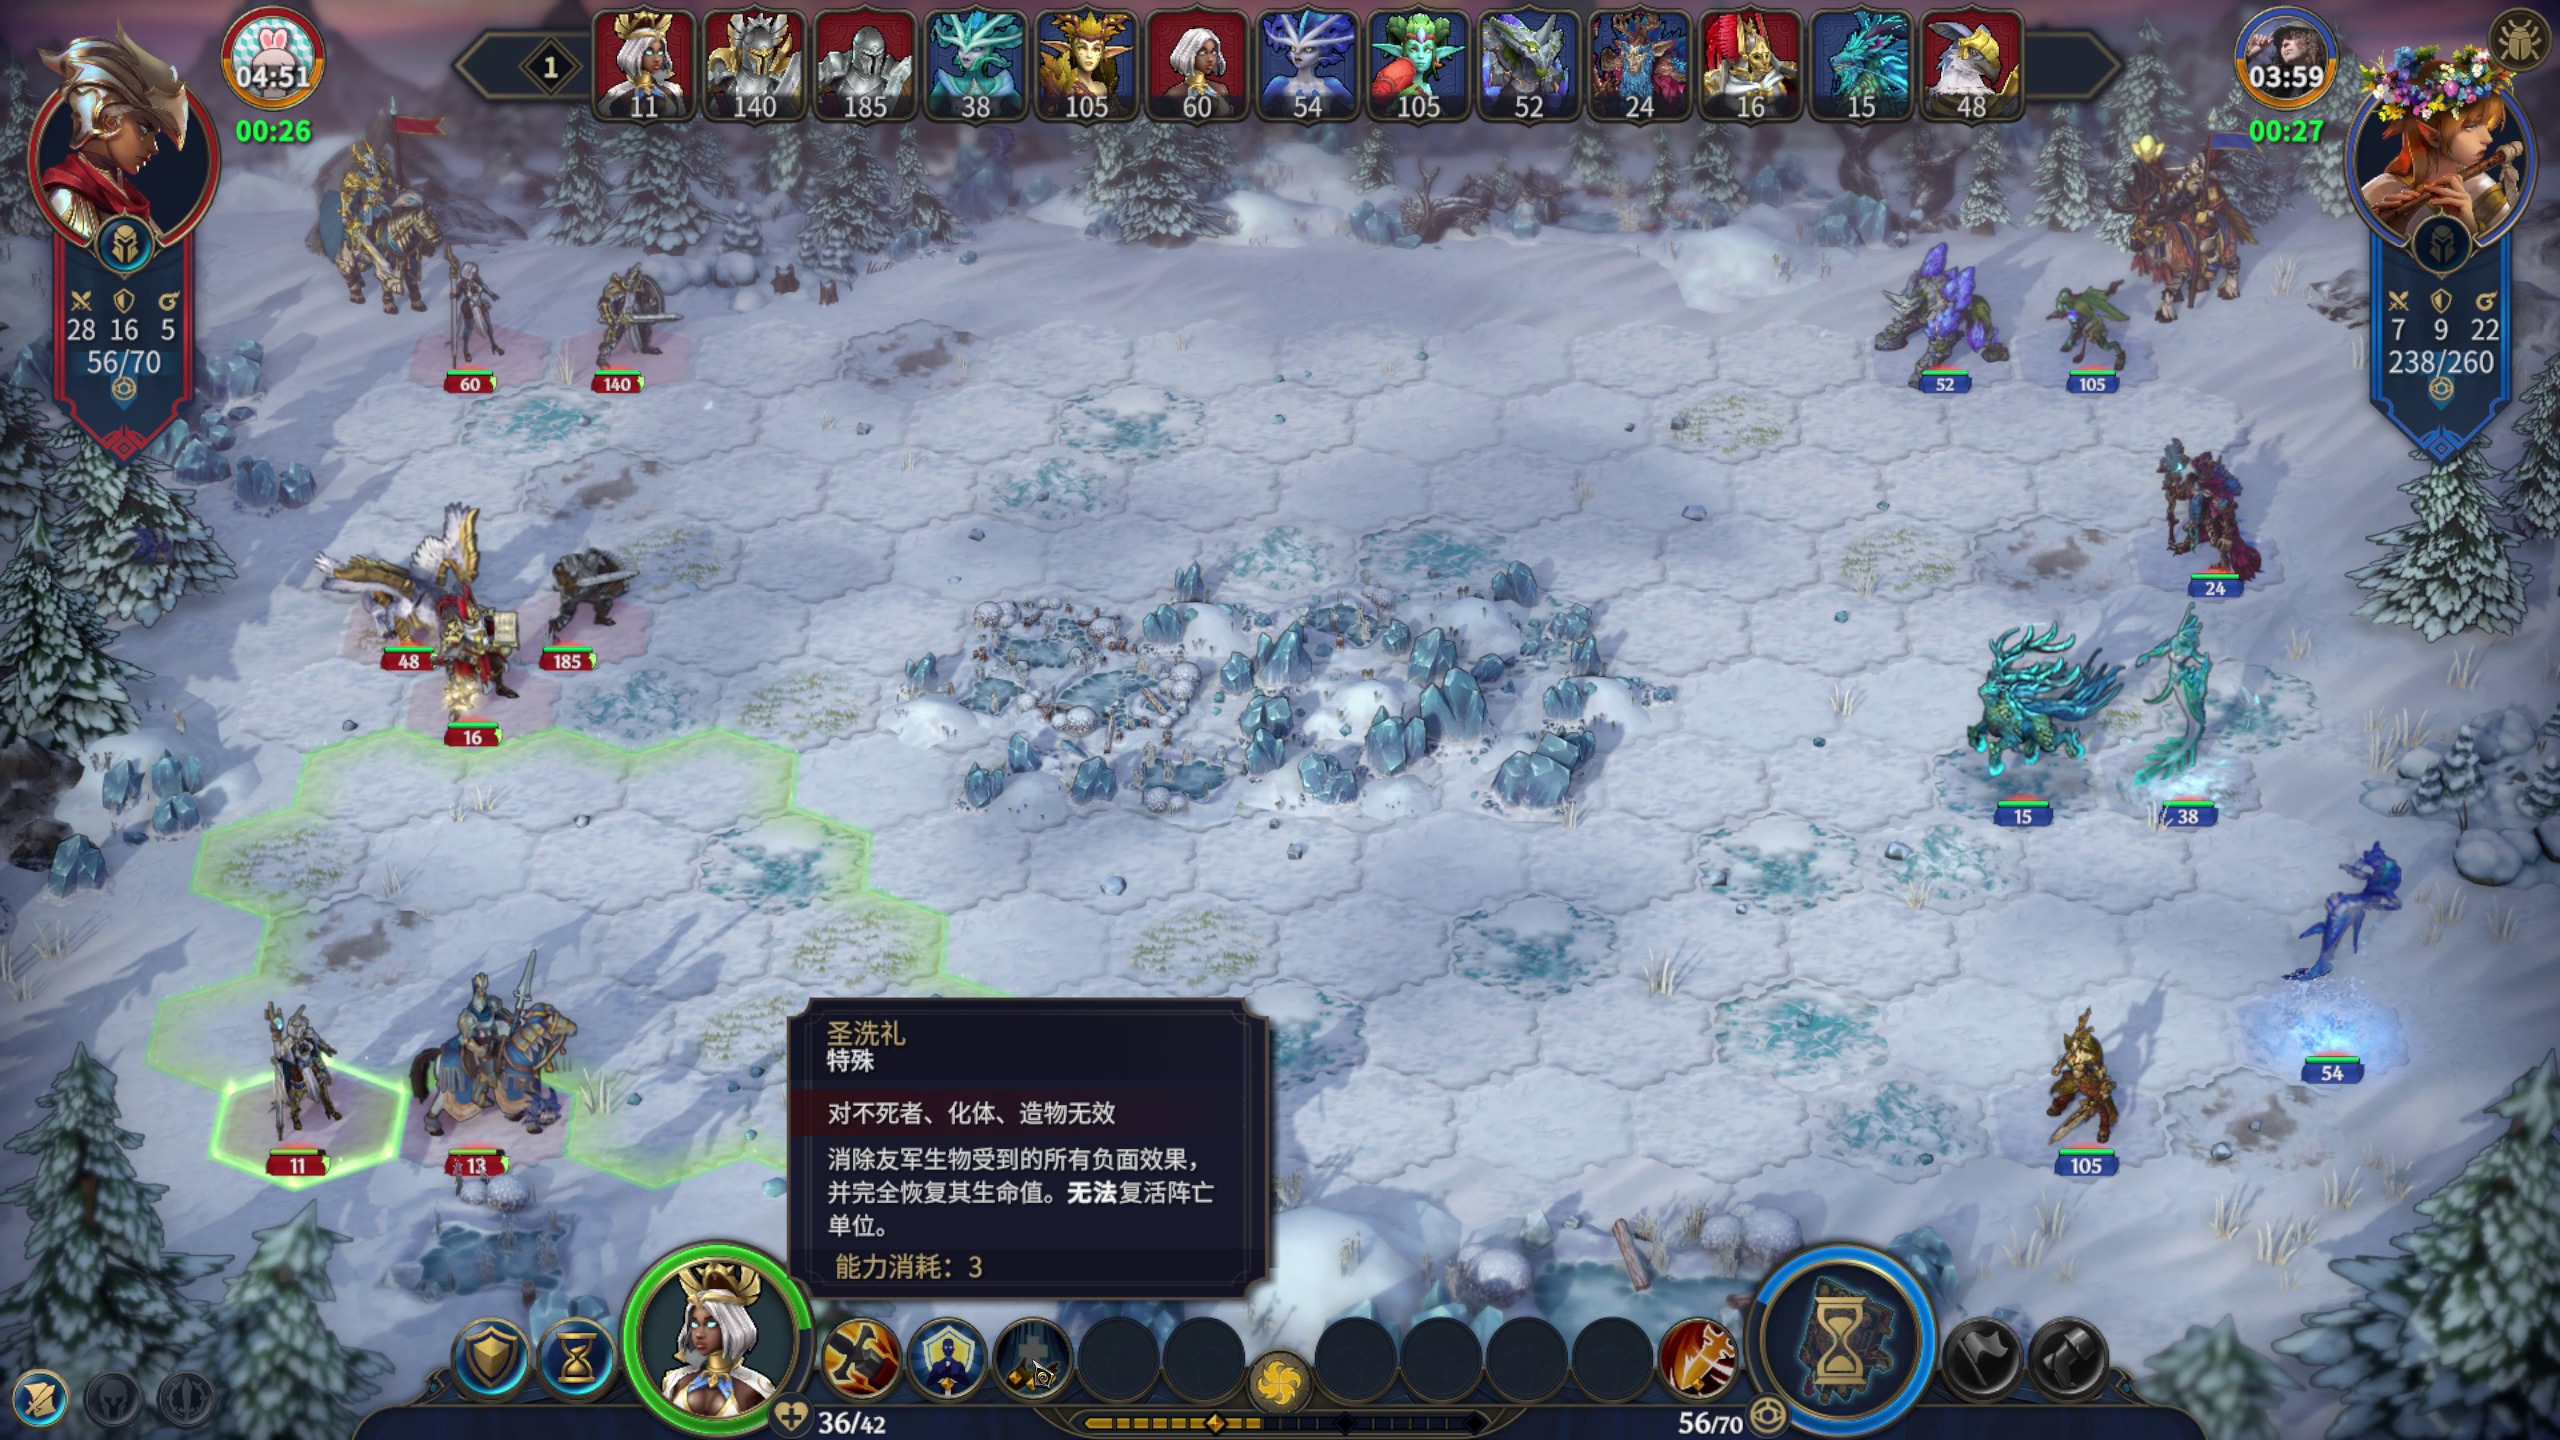
因此新版本允许结束回合提示、持续时间、帮助行分别缺失;缺哪一项就记哪一项未找到。仍要求标题、类型、正文和消耗共同成立。能力说明中的“持续时间:2”也只是一句说明,不能直接变成某个生物“当前还剩2回合”。单位归属、是否已经施放和局部稳定性仍没有被确认。
增加覆盖后,实际读到了什么?
我们复用403张短悬停扫描图,以及更早缓存的513张图片。共916张已有OCR,639张通过各自保存的场景判断;277张跳过,原采集清单另外1465张仍待OCR。没有把跳过或未扫描的图算作识别成功。
两个批次共自动找到 12张能力说明、71个字段候选,涉及注能盔甲、冲锋、寒冰尖刺、圣洗礼、低语之森的回音和英勇长啸。它们只来自3段录像,而且包括相邻重复帧;12张不是12种独立能力,71也不是已核对的正确数。
评估使用原有2张参考和新补的5张,共39个字段。新参考逐张查看原始像素,仍待作者确认;其中两张参与了可选字段的修正,因此整组都是开发检查。比较时先匹配字段类型和位置,再比较字面,只规范空白与全半角。
| 同一组39个能力字段 | 所有切块都参与 | 只比较完整覆盖切块 |
|---|---|---|
| 字面精确 | 9 | 37 |
| 拒绝输出 | 30 | 0 |
| 已输出,但字面有差异 | 0 | 2 |
两处差异都在“寒冰尖刺”的伤害区间:参考分别写作72–101和105–147,OCR输出短横线-。数字一致,但字面评分仍保留差异,不在看过答案后改参考来凑满分。这个小组支持继续使用完整切块判断,并不能证明所有能力都能找到。
我们还看了6张固定选取的反例:普通战场、战术部署、攻击预览,以及有法术提示或没有悬浮的魔法书。新定位器没有在这6张里报出能力说明。它们不是随机抽样,也没有穷尽所有其他UI;误报率仍需更广的数据才能估计。
回到原13张、158字段的大组,加入能力后精确数从69增至80,另1项是上述横线差异;11项拒读、4项未定位、54项角色尚未支持,8项组成4段单独评分的完整描述。原来69项精确全部保留。这比只报37/39更能看出进度:能力布局补上了一块,但生物属性、其他提示和状态关联还没全接好。
能力参考与预测对照展示7张正例和6张反例。也可查看全部12张候选,切换所有切块与完整切块,展开原文和拒识原因。画框表示程序到哪里找字,不是精确面板边缘;参考与预测保持分开。
13. 字读对了,为什么仍不是一个能力名称?
生物面板上方有一排属性,左下还有能力列表。此前的读取器只输出名称、阶级、数量和前四个属性;后四个数字与列表中的文字,即使已经被OCR扫到,也没有对应字段。新实验先把这些位置接上:属性格随已找到的面板平移,列表则从“主动能力”标题往下找左对齐的文字行。
后四个数字暂时只叫“属性槽5至8”,不在没有独立依据时替它们确定游戏含义。列表也只记录这一帧看得见的名称:滚动条下面、被悬浮窗挡住的项目不补全。“主动能力”是画面原文,并不证明列表里的每一项都是主动技能。
提示窗的文字,恰好也在列表那一列
初版在下面这张图中正确读出了“能力消耗:2”,却把它加进了能力名称列表。原因很直接:这行字位于同一列,置信分数也足够高。它在讲什么,不能只靠文字位置决定。
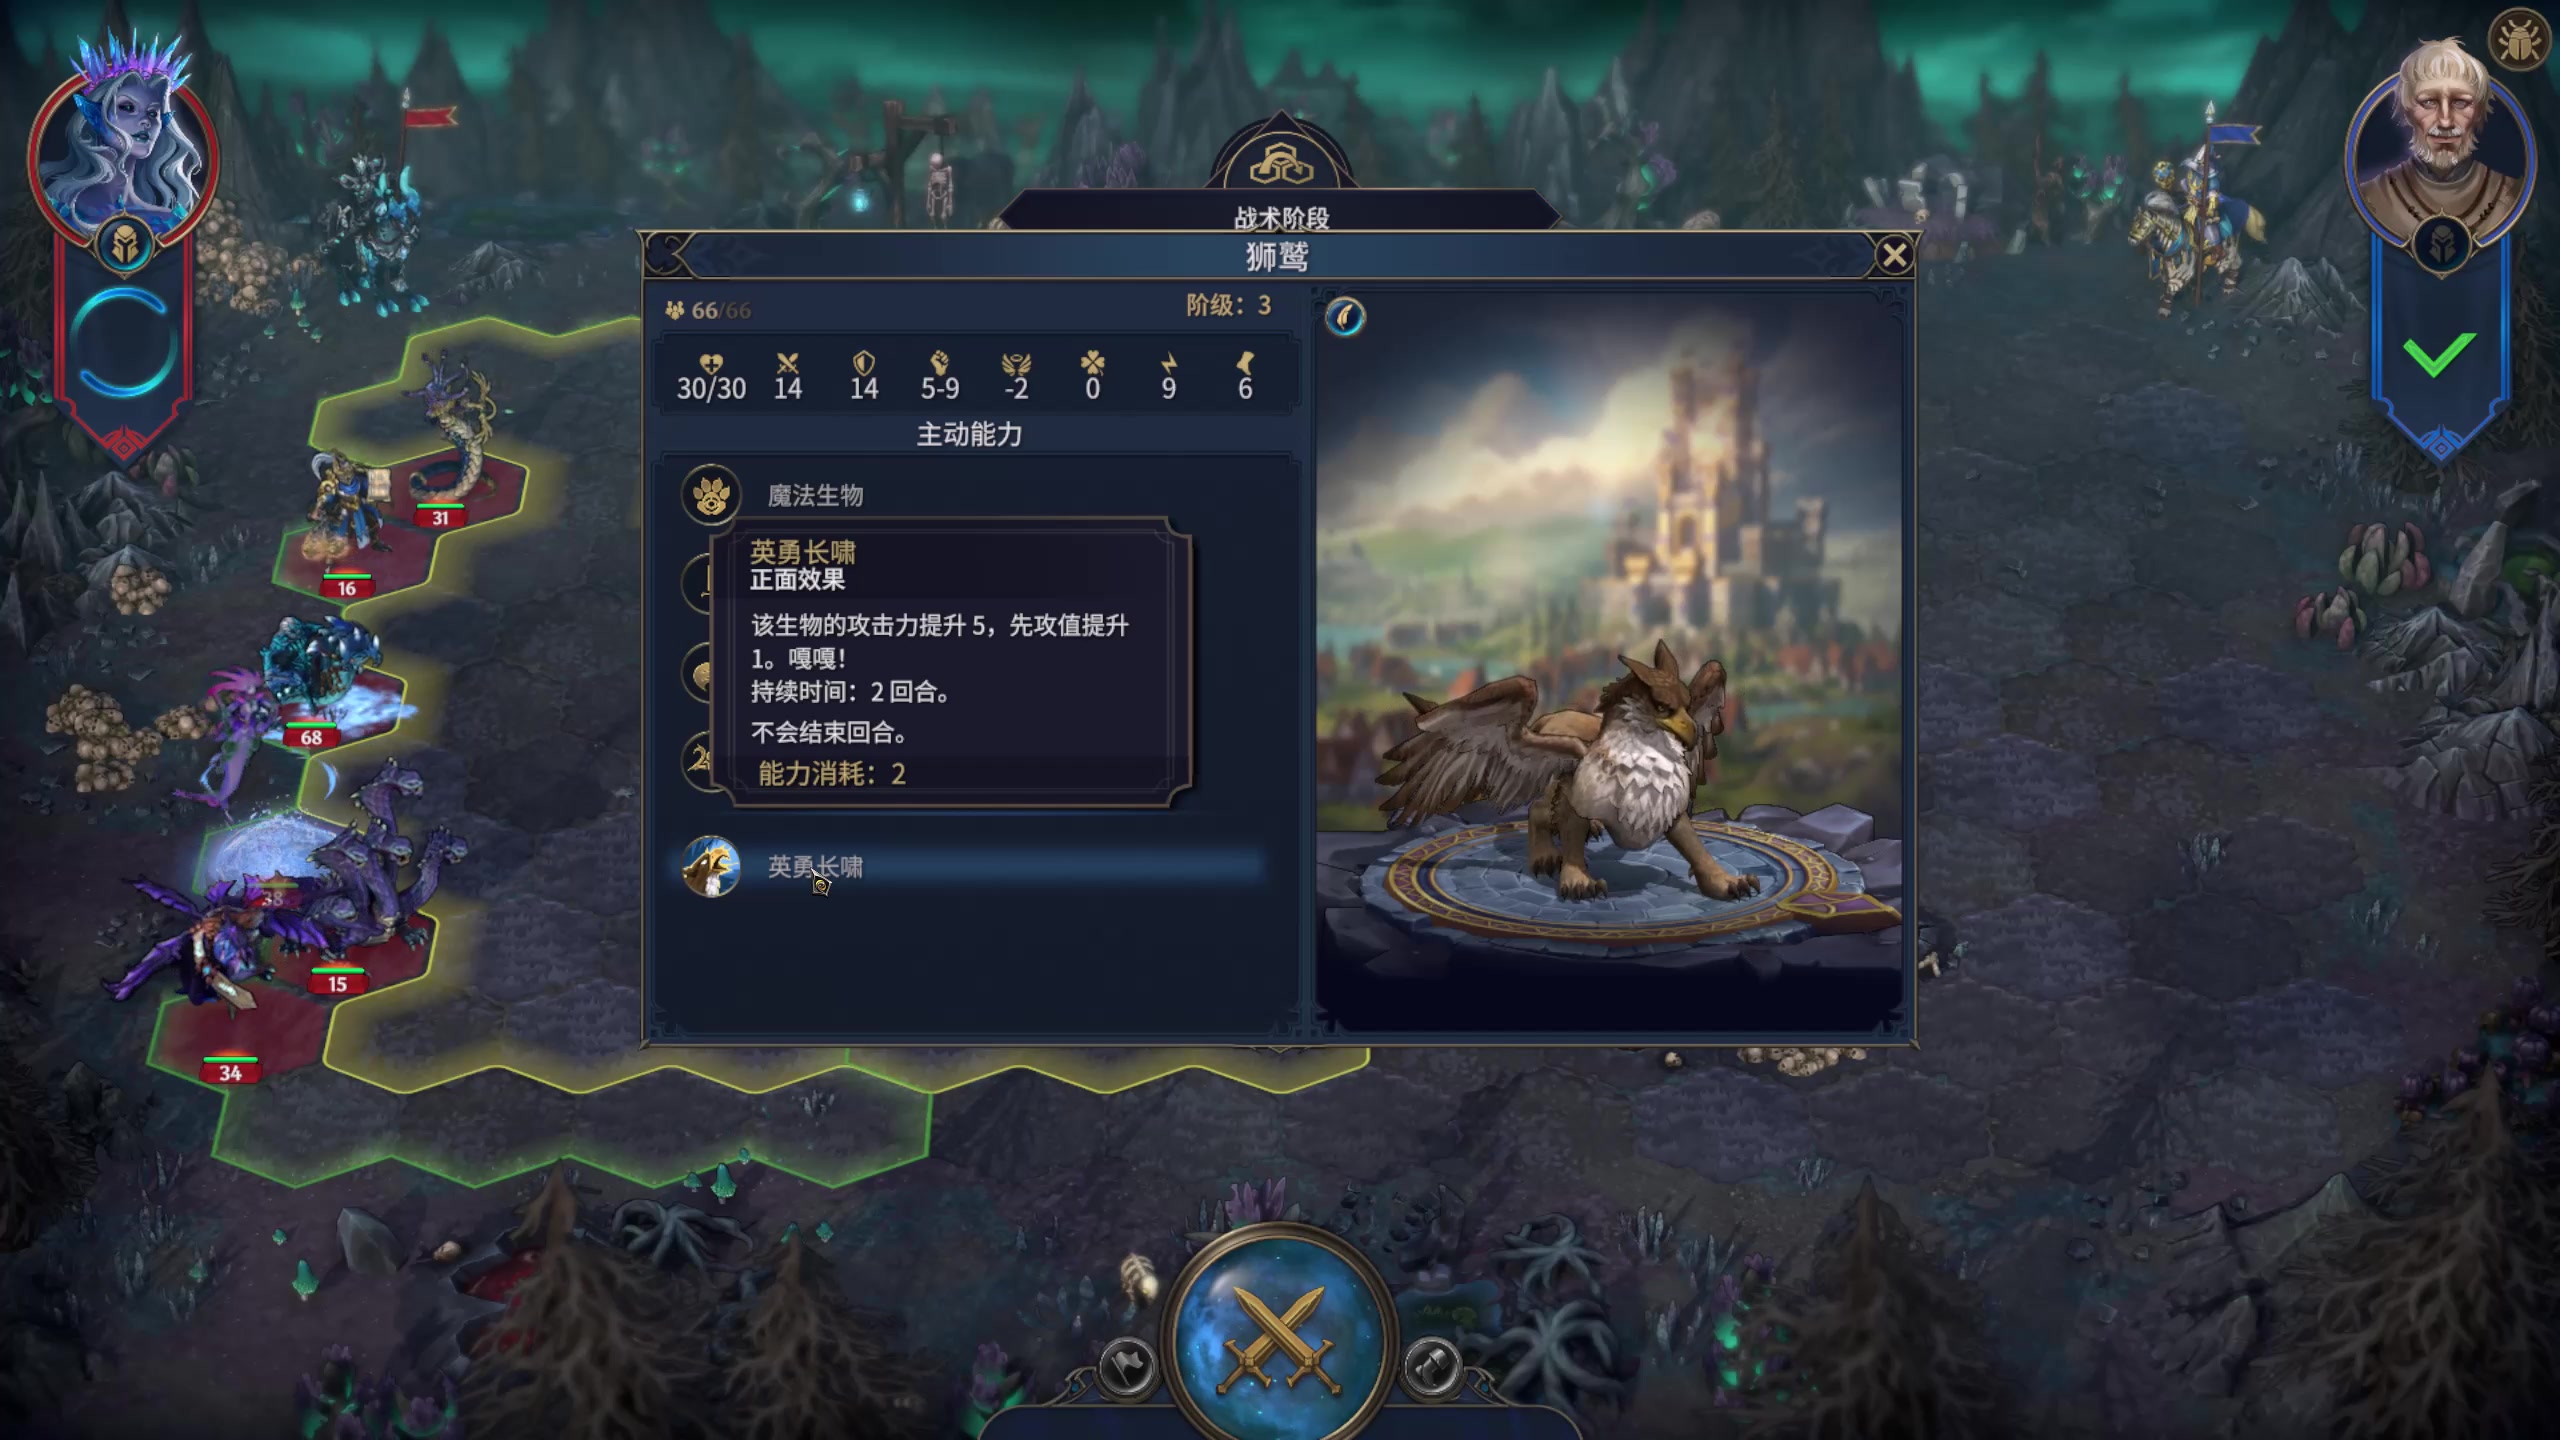
修正版复用前两节的自动法术/能力提示框定位:与这些框相交的行,不作为列表项。程序没有读取人工排除框;被排除的行和原因仍保存在结果中。这只覆盖已有提示框布局,无页脚的新式说明仍可能漏掉。
哪些字段接上了,哪些仍读不到?
两批缓存里自动找到37张生物面板,产生359个新增字段候选;233个得到读值,其余拒识。我们另看了5张不同生物的原图,加上原5张,共核对90个此前未接入的属性和列表字段。参考由助手查看原始像素后转写,待作者确认;这10张都是开发数据,含同来源图片,不是独立视频测试。
| 同一组90个新增参考字段 | 全部切块参与 | 只比较完整覆盖切块 |
|---|---|---|
| 字面精确 | 32 | 50 |
| 拒绝输出 | 58 | 40 |
拆开看,40个小属性数字只读对7个;10个列表标题读对9个,40个可见能力名称读对34个。因此这轮主要补上了列表文字,小数字仍明显不足,不能只看合计50项就认为属性识别已经做好。
新参考还明确圈出3处“有文字,但不是列表项”的悬浮区域。初版在其中错收1项,修正版为0;90个正例字段的结果不变。这个错误说明,只有正例上的高分还不够,还要检查多报了什么。 3个区域仍不足以估计全图误报率。
这一步的增益主要来自能力名称。小数字的难点是某些完整切块也没有检测到字;其它切块读出同一个数,并不能抹掉这次漏检。因此我们接着回到原图,只读实际小格,比较收益与错收。旧字段和原来的质量拒识仍保留。
网页复核还暴露了一个旧问题:上面狮鹫图的名称候选竟然是画面顶部的“战术阶段”。那几个字本身读对了,位置却不属于生物名称;按位置匹配的评分将真正名称记为未找到,也没有单独统计这处额外错接。新实验把它另外记录为一处标题越界,再从面板内的标题栏重新识字;网站保留旧错误,不用参考“狮鹫”替换它。
10张参考与本地结果可以逐帧核对,也可查看全部37张候选。青色为参考,黄色为预测;未读出的值保留原因,不冒充零。
只读小格之后,为什么不再要求四遍都同意?
程序先随自动面板放置标题栏和四个数字格,再把原始像素交给两个本地识别器:PP-OCRv6 medium和PaddleOCR-VL-1.6。每个模型分别读原尺寸,以及填充边缘后放大4倍的版本。没有人工框,也没有告诉模型“这里应该是什么”。37张面板中,一张未通过原来的质量检查;其余36张共180个裁图全部处理,不只挑原先读错的地方。
评分仍用同10张开发参考,单独比较10个标题和40个数字。以下只看数字;“拒识”包括原质量门不允许读取的4项。
| 同40个数字 | 读对 | 读错仍输出 | 拒识 |
|---|---|---|---|
| 旧完整切块 | 7 | 0 | 33 |
| PP读原尺寸裁图 | 10 | 0 | 30 |
| PP读放大裁图 | 8 | 0 | 32 |
| VL读原尺寸裁图 | 36 | 0 | 4 |
| VL读放大裁图 | 35 | 1 | 4 |
| 四遍一致,且PP分数合格 | 6 | 0 | 34 |
在这批小格上,VL原尺寸读得最好;增加放大或增加否决条件,没有更好。 一处原本是8的数字,VL原尺寸读对,放大版却读成81。四遍合并又被较弱的PP读法拖住:16项分数不足、11项至少一遍不能解析、3项冲突,另4项保留质量拒识。这个结果说明,合并规则也要实测,不能把“读更多遍”当作精度保证。
标题方面,VL两种尺寸都读对9/10,余下一项同样被质量门挡住。狮鹫这张图的四遍原文都是“狮鹫”,没有再混入上方横幅;但PP两遍分数约为0.827和0.689,四遍合并仍然拒绝。我们把正确原文与拒识原因一起展示,不为了让这一例通过而调低门槛。
原图裁图逐项对照能翻看旧读法、四遍原文和参考,也能查看全部处理状态。此次没有新增参考;另135个候选位置尚未评分。37张生物面板实际来自5段录像,其中23张来自同一段。因此36/40只是开发数据成绩,不能据此更换在线默认;我们接着换来源,并检查没有生物面板的画面。
如果那块区域根本不是生物属性呢?
这一轮复用前文第三轮的全部24张图:4张有自动找到的生物面板,另20张是战场、英雄资料、魔法书或日志。四个录像来源中,三个不在上一组生物面板样本里,但都已参与过项目开发,不是盲测。
在4张面板上,程序仍按原规则读标题和四个数字格。另20张不应进入这条读取流程;我们仅为诊断,强制裁出同样的位置交给OCR,看看如果跳过面板判断会发生什么。参考由原图核对后另存,未输入模型。两条路径、四遍原文和完整处理清单在新对照页分开展示。
| 读法 | 标题读对 /4 | 数字读对 /16 | 错误上下文仍给出值 /100 |
|---|---|---|---|
| PP原尺寸 | 4 | 9 | 1 |
| PP放大配方 | 3 | 7 | 2 |
| VL原尺寸 | 4 | 16 | 24 |
| VL放大配方 | 4 | 16 | 31 |
| 四遍严格一致 | 3 | 7 | 0 |
可见字面的其余项均拒识,没有错字被接受。可是字面全对,不等于字段就可以提交:4张面板包含第7节那张半透明的水泽精灵。它的标题与四个小数字都可读,历史策略却要求等待;原质量门仍把这5项放行。本次只增加字面参考,没有把这个旧失败改成成功。
错误上下文中的输出也有两种来源:有些是别的真实UI文字,例如日志句子或“敌方回合”,只是不能当作生物标题;有些则来自背景或图案。表中24/100是故意跳过面板判断的诊断结果,不是当前系统的在线误报率。原自动入口在这20张里没有生成生物面板,也不会发送这些强制裁图。
这次支持继续用VL原尺寸补离线候选,但也说明不能把它当成“有字就可信”的全图扫描器。读数必须和面板、原有质量判断一起查看。
把读数放回原图,而不是只留在实验表里
现在,这37张面板的局部读数已经进入语义时间线。左右切换时,每个字段旁都能看到原结果、VL原尺寸字面,以及四遍读法为何一致或为何拒识。例如前面的狮鹫图,旧名称仍显示“战术阶段”,新裁图读出“狮鹫”;网站把两者放在一起,让读者直接看原图判断,没有偷偷替换旧错误。
这层共显示180个可解析字面,另5项保留原质量拒识。选择“加上已有参考”后,还能核对之前的稀疏标注;没有参考的位置依然只是候选。它们不确认是哪一方、哪一支部队,也不自动进入在线状态。这个页面保留的是实验批次;下面再把同一读法接进视频处理入口。
处理下一段视频时,也会自动读这些小格吗?
现在可以显式开启这一步:视频流程自动找到生物面板、通过原有质量检查后,裁出标题与四个小属性格,再调用本地VL模型读原尺寸图片。旧字段留在原处,新候选另存;没有旧字段的位置明确显示“此前未提取”,不从参考答案补一个基线。续跑时只继续最后的读取阶段,原图或上游结果变了,就拒绝复用旧裁图。
我们把它续接到四个已有开发运行,检查了328张关键帧。5张生物面板产生25个裁图,全部完成读取并得到可解析字面;其余182张在场景检查时跳过,141张没有找到生物面板。没有候选与读取失败是不同状态,网站可以分别查看。
例如阿迦索斯马塔哈的一个面板,程序读出标题和3、1、10、7四个小数字。它们现在能在视频流水线时间线随原图切换,并展开原字段、裁图位置和模型原文。这不是新模型训练,也不是25项新增人工标注:5张正例来自同一录像且有相邻重复,本轮验证的是自动调用和结果传递,没有重新测量准确率。半透明面板的已知质量问题仍在,所以这层只提供离线字面候选,不提交游戏状态。
另一个实际进展来自继续扫描已有候选:8个短片段各补扫8张,新增64张整屏OCR和3210条选中文字。当时短悬停库467/1868张已扫,1401张待处理,文字反查索引同步更新。这增加了寻找训练图片的机会,不是增加了3210个正确标注;以前实验的冻结输入和成绩保持不变。
补扫的图片,是否真的增加了可用字段?
这64张现在也跑过面板和说明读取:59张进入流程,5张被场景入口跳过。新找到一张能力说明、两张生物面板;没有面板的普通战场并不因此算漏检,进入流程也不等于全图已经识别完成。
看过64张联系表后,我们进一步核对三张原图,新增42个文字/数字参考。采用完整覆盖切块时,能力说明的6项全部精确;两块生物面板的36项中23项精确、7项拒识、6项未定位。参考仍待用户确认,这几张来自旧片段、包含相邻画面,不能当成新增独立测试集。
补扫后的面板与参考已接在同一时间线,可以与整屏OCR切换查看。其中一张还有状态悬浮说明,我们在B035的自动读回实验单独处理,避免把状态文字混进生物能力列表。旧读法、未定位和拒识都保留,没有拿参考或局部VL结果替换这次基线。
在换录像之前,还从同一八段素材里各取十六张未扫候选,补扫了128张。旧库累计595张已扫、1273张待扫;这次新增3张能力说明、4张生物细节与1张状态提示候选,尚无新增参考评分。状态提示仍是已知悬停的近邻,这促使我们换来源,而不只增加相邻图。
换三个录像来源,小数字还能读对吗?
前几轮状态提示仍集中在同一段录像、两个效果。继续收集它们的相邻帧,会让图片变多,却不一定让识别更可靠。因此这次换到另外三个已有开发录像,各取一分钟,用10 fps五帧稳定采样选出97张原图,全部做整屏OCR。它们不在前一组四视频悬停批次里,但以前参与过其他开发实验,不是独立测试集。
程序在其中找到12张生物面板、8张法术说明候选。我们先看全部原图联系表,再逐原像素核对7块不同生物面板,增加121个文字和数字参考:包括名称、数量、阶级、八个属性位置,以及屏幕上可见的能力列表。列表没有向下滚动,因此这不是完整能力目录,也不是整张图片已经标完。
原整屏读取在这121项中匹配90项,25项拒识,6项未定位。接着让两套本地OCR读取全部12个自动面板的标题和后四个属性格,不给模型参考文字或参考框。在7张有参考的图上,结果是:
| 读法 | 标题读对 /7 | 小数字读对 /28 | 小数字读错 | 小数字拒识 |
|---|---|---|---|---|
| 原整屏完整切块 | 7 | 5 | 0 | 23 |
| PP原尺寸 | 7 | 6 | 0 | 22 |
| VL原尺寸 | 7 | 28 | 0 | 0 |
| VL放大 | 7 | 27 | 1 | 0 |
| 四遍严格一致 | 7 | 6 | 0 | 22 |
放大版把一处8读成了81,原尺寸却读对。这再次说明:能多读几遍当然有帮助,但不能预先认为放大或全票一致就是最好的答案。 我们继续把VL原尺寸作为离线候选,保留其他读法供对照;不会把35项小样本全对称为整套系统准确率。
97张时间线同时展示原图、旧字段、局部读数和待确认参考,裁图对照页可以逐个检查四遍原文。本批有4592条可检索文字,和前面的1868张库分开计数。
这次也有一个没有达成的目标:没有找到新的状态效果悬浮说明。所选窗口主要是部署和开局资料窗,下一轮应转向交战中后段。另一个实际缺口是生物面板前四个属性:生命、攻击、防御和伤害,共有8项未定位或冲突。
生命和攻防也可以直接读小格子
这四格已有自动裁图代码,因此不需要换检测器。我们按原规则裁出全部12个面板的48个位置,让两套模型各读原尺寸和放大版,共192次读取;没有只挑那8个失败项。7张参考图的28项中,旧整屏读法匹配20项,原尺寸PP和VL都匹配28项,原来8项缺口全部读回。放大版PP却有4项拒识,要求四遍都同意也会丢掉这4项。
结果说明,这些格子的问题可以先靠局部重读解决,不必一开始就更换模型。另20个没有参考的裁图仍是待审候选。生命、攻防与伤害对照页保留每个裁图、四遍原文和旧结果,标注首页也有入口。这一步尚未覆盖时间线里的旧字段。
这里要区分实验与已有功能:视频入口已经有可选的“缺失数值格补读”,使用PP原尺寸,保留旧读数和真实冲突。这一轮新增的是四遍对照,不是从零实现补读。它读回了旧冲突,不代表可以自动消除冲突;扩大来源、检查错框与遮挡后,再决定是否改组合规则。
交战后的面板,补充了不同的数字
新一轮从三个录像的较晚窗口采到158张候选,其中包括选秀、结算和菜单,全部跑过整屏OCR。只有“时间更晚”还不够,后续需要先确认战斗区间。不过,其中这张生物面板提供了开局图较少出现的读数。
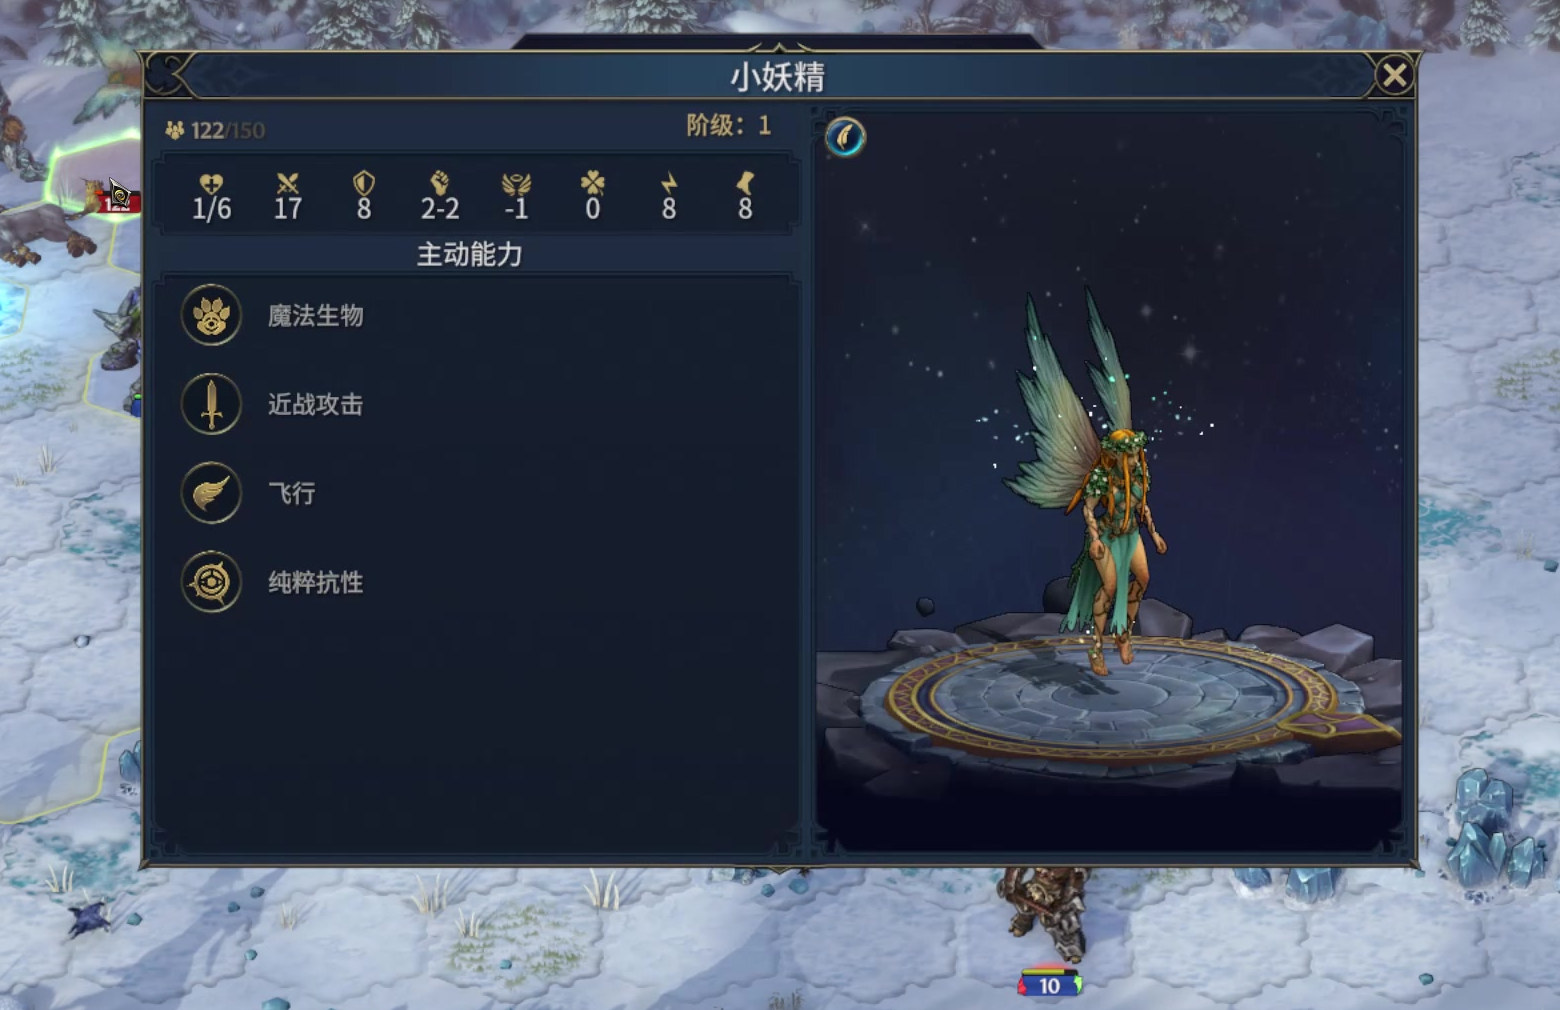
先看原图,再转录名称、数量、阶级、八个属性位置和可见能力文字,共16项参考。参考仍待用户确认,不是整图完成;中段批次的候选与参考与旧批次分开,方便直接检查这类读数。
冻结的完整切块读法匹配14项,另外两格0和8因缺字拒识。随后沿用自动面板裁图,对标题和后四格各跑四种读法:VL原尺寸匹配这五项,恢复了两处缺口;放大版却又把8读成81。PP两种尺寸对四个小数字都拒识,标题正确。四遍裁图对照保留全部20次真实读取,时间线新增原尺寸候选,旧拒识不覆盖。这是一张不同内容的开发图,不是新的准确率结论。
14. 数量没读全,不该丢掉整个面板
更密的短悬停采样找回了几块先前遗漏的面板,却也暴露了下一道障碍:火凤凰的标题和属性都在,程序仍说没找到生物面板。原因不是图片还在运动,而是旧定位器要求数量和生命两处分数都被高分读出;数量那一格太暗,只留下一个可靠的2,整个面板便被拒绝。
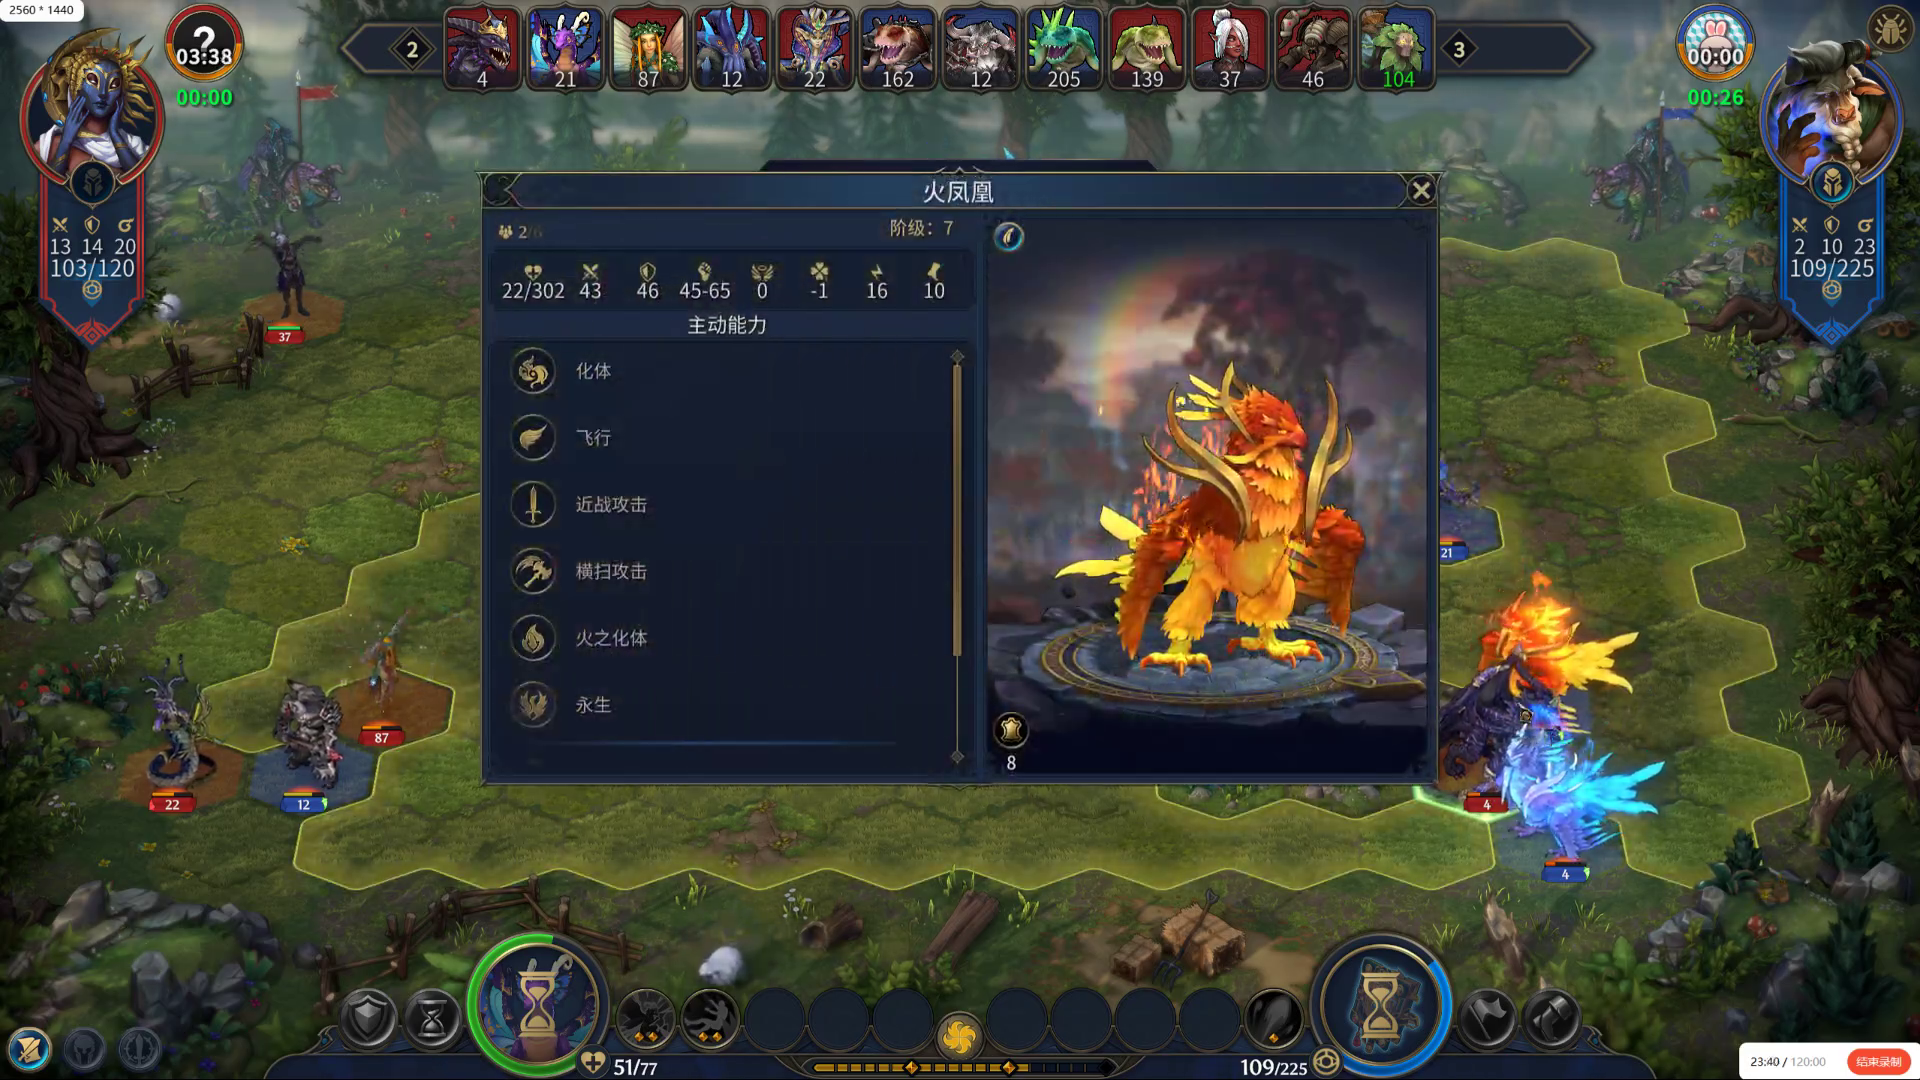
新增的可选定位方法不猜数量,而是找另一组共同成立的线索:唯一的精确生物名称与阶级,以及在对应列出现的生命分数、攻击整数、防御整数和伤害范围。四列都能独立找到,才补出面板的位置。缺列、多个候选、错误位置或原场景不属于战场,仍然跳过;找到以后也继续经过原来的外观检查和严格读字规则。
我们先固定五批已有开发数据,共434个图片文件,再复用其原OCR和场景结果做对照。337张进入定位,97张保持场景跳过。只新增了这1张面板;原有76张生物面板以及所有已生成字段、裁图均未改变。 新框回到原图检查,位置相符。这是针对一个已知失败的修复,不是434张全图都已经标完,也不是新的准确率。
找到之后,仍要检查到底读出了什么
新面板的7个基础字段中,严格读取只接受阶级、防御和伤害。标题仍低分,数量仍不完整;生命和攻击在一遍OCR里合成同一行,也保留未知。随后让程序自动裁出6个数字位置,用PP-OCRv6和PaddleOCR-VL各读原尺寸与填充放大4倍的版本,共24次实际读取,没有把参考框或答案交给模型。
生命22/302、攻击43这次在四种局部读法中都一致。但数量没有解决:
| 同一数量裁图 | 模型实际原文 |
|---|---|
| PP原尺寸 | 26,分数0.892 |
| PP填充放大 | 2,分数0.994 |
| VL原尺寸 | 2/8 |
| VL填充放大 | 2/6 |
放大VL在这个例子里与参考相同,却不能据此只挑这一遍作为答案。原尺寸VL还给出了格式完全合法的错误分数2/8,说明“能解析”和“读得对”并不是一回事。数量继续保留冲突,四遍原文一起展示;标题本轮没有局部重读,也不补成已解决。
434张新旧定位审阅页可以切换新增面板、旧面板和场景跳过,用左右键或滑条翻图。它是本机标注网站下的独立实验页,尚未并入主语义时间线。下一步应扩大暗色数量、缺字与错误布局的对照,并把局部候选接回视频流程,而不是围着这一个6调整规则。
15. 从字段区域走向完整战斗观察
这条路线已经把人工给框改成程序根据文字和位置生成框;三轮检查也把问题分清了:面板可能没找到,字段可能没读到,读对的字段仍可能暂时不该提交。下一步需要更可靠的局部可用性证据,并建立字段与战场单位的对应,连接日志和地图占位。固定坐标和平移方案暂时没有准确性差异,不会据此选出所谓优胜算法。
三轮的26、24、24张图现在都已用于失败分析,今后可作为开发回归集;下一版需要明确新的验证方案,不能反复修到已看过答案的样本全对后,仍把它称为独立测试。
资源与技能的语义也要靠原图核对:同一个法术提示框明确显示的“等级”和“魔力”可以帮助解释旁边的数字;无标签的徽标、条形填充和按钮变暗仍需额外证据。不会因为数字识别成功,就宣称已经理解冷却、可用性或某次行动。
Comments