P41 · 场景识别 · 实验记录与相关篇目
保留早期缓存 OCR 的 v4 规则结果;示例分类已同步标注网站的后续审核。用户确认、助手检查与算法候选分别显示,本轮未重跑模型。
《英雄无敌:上古纪元》的竞技场会经过菜单、英雄、技能、宝物、法术和生物选择,再进入战场。许多界面已经把身份写在屏幕上:我们先用 OCR 把文字和位置读出来,再判断这些文字支持哪一种页面。
程序返回页面标签,以及支持这个判断的文字和位置。线索不足时保留未知;它要解释这一帧实际看到了什么,而不是沿用上一帧的答案。
flowchart LR
 A[Source screenshot] --> B[OCR text and boxes]
 B --> C[Text and position rules]
 C --> D[Current view and evidence]
 D --> E[Independent review]
 D --> F[Phase context with timestamps]
图 1:当前像素产生当前观测;时间上下文另列。上一次看到战场,不代表这一次也看到了战场。
1. 文字相同,还要看它在哪里
OCR 输出的是文字区域,而不是按钮检测结果。标题、说明、计时数字与按钮标签都可能被读到。我们保留原始字符串和矩形,另用规范化后的字符串匹配规则,不把 OCR 框自动扩大成可点击区域。
先走一个例子:全图 OCR 同时读到“快速开始”和“自定义游戏”,位置都在“新游戏”下方。文字组合说明出现了两个具体选项,位置关系又支持它们属于展开的新游戏菜单。因此规则提出“新游戏菜单已展开”,并保留这几处文字作为依据。展开菜单会推移下面的按钮,所以采用本帧读到的位置,不沿用未展开时的坐标。
反过来,英雄名字、等级和底部流程条会出现在多个选择页。即使这些字全部读对,仍不足以区分当前是哪种选项页面。没有明显标题的战场更难只靠文字判断;下一章会接着处理这种情况。
不知道场景,怎么先做 OCR?
第一遍 OCR 读取整张截图,不需要预先知道场景。 OCR 的文字检测网络先在图像里找文字,再由识别网络读出检测到的行。引擎内部裁出文字行,不等于我们先按“英雄页”或“技能页”裁固定区域:前者从当前像素自动定位,后者需要已经成立的场景和布局假设。
| 步骤 | 输入与已知条件 | 输出 |
|---|---|---|
| P41 整屏第一遍 | 完整截图;没有场景标签或游戏标题框 | 全图文字、坐标及场景规则候选 |
| P41 视觉补充 | 同一截图;OCR 证据不足或冲突 | 已有颜色/边缘近邻、SVM 与 OCR 的离线交叉核对;任意新视频的在线完整路由仍待验收 |
| P101 场景内细读 | 已确认或预测的场景、兼容布局、可见区域 | 标题—图标关联与目录身份建议 |
| P61 历史标题小图实验 | 实验已提供的标题条;不负责识别场景或选择区域 | 小裁图上的文字与耗时;后来的整屏比较见 p61,输入与分母不同 |
图 2:A 是原始输入,B 是 OCR 自己定位的文字行,C 才是具有游戏语义的固定区域。B 不需要场景标签,C 需要。图示为整合流程合同,下面的截图才是实际开发预测。
这条依赖是“全图文字 → 场景 → 局部细读”,没有用局部裁图的答案来证明它自己的前提。比如先在全图检测到“快速开始”和“自定义游戏”,再判断新游戏菜单展开;不必先假设展开菜单的坐标。技能页中通用的英雄卡和流程条不足以确定主技能或子技能时,就应保留不确定性,不能凭某个预设槽位读到一个合法技能名便接受整个场景。
当前 B021 的全图识别和 B023 的离线关联原型分别存在;上述自动路由与拒识策略是整合合同,尚未完成端到端评估。实际系统应优先复用已有全图文字,只有小字漏读或低质量时才精读局部。上一帧标签可帮助安排计算,但切出游戏、换页或断线后不能直接沿用旧标签认证新裁图。
固定区域只是位置提示;归一化坐标能处理同布局分辨率变化,不能保证应对任意宽高比或改版。
主技能和子技能属于同一顶层阶段。前者的三个选项标题与后者的父技能标题加三个子技能位置不同;规则用文字组合和布局区分它们。英雄名字、等级和底部流程条则会出现在多个选择页,单独命中它们不能决定当前子场景。
规则可以要求多个锚点、排除矛盾文字,并用显式优先级处理匹配。冲突或证据不足时拒绝分类。优先级是程序规则,不是概率。英雄信息、战斗日志和悬浮提示还需要保留基础场景;浮层名称不能取代完整的状态描述。
下面的历史实验使用已保存的高精度 OCR 结果:PP-OCRv6 全帧原图与 1.5 倍增强结果融合,再运行 ocr-scene-understanding.v4。初期 Windows OCR 与 v1 规则是另一轮记录;后来视觉交叉核对和标注修正见下一章。本文保留各轮自己的计数,不把后来的修正算成旧规则的成绩。
2. 打开类别,对照原图、文字和后续分类
下面的原图最初按每种规则输出、每段录屏各取一张时间中位帧;现在按标注网站的分类分组,方便先认清图片。青框仍是历史规则采用的文字,旧预测可在每张图下展开查看。分类旁明确写出用户确认、助手检查或算法候选,不能把三者都当成人工真值。
按标注网站的分类分组,更新于 2026-09-12。每张图分别注明用户确认、助手检查或算法候选;旧草稿不再用于分组。青框仍是历史 OCR 规则当时使用的文字;没有框不代表这张图现在仍未分类。点击图片放大。
菜单 · MENU 2 张示例
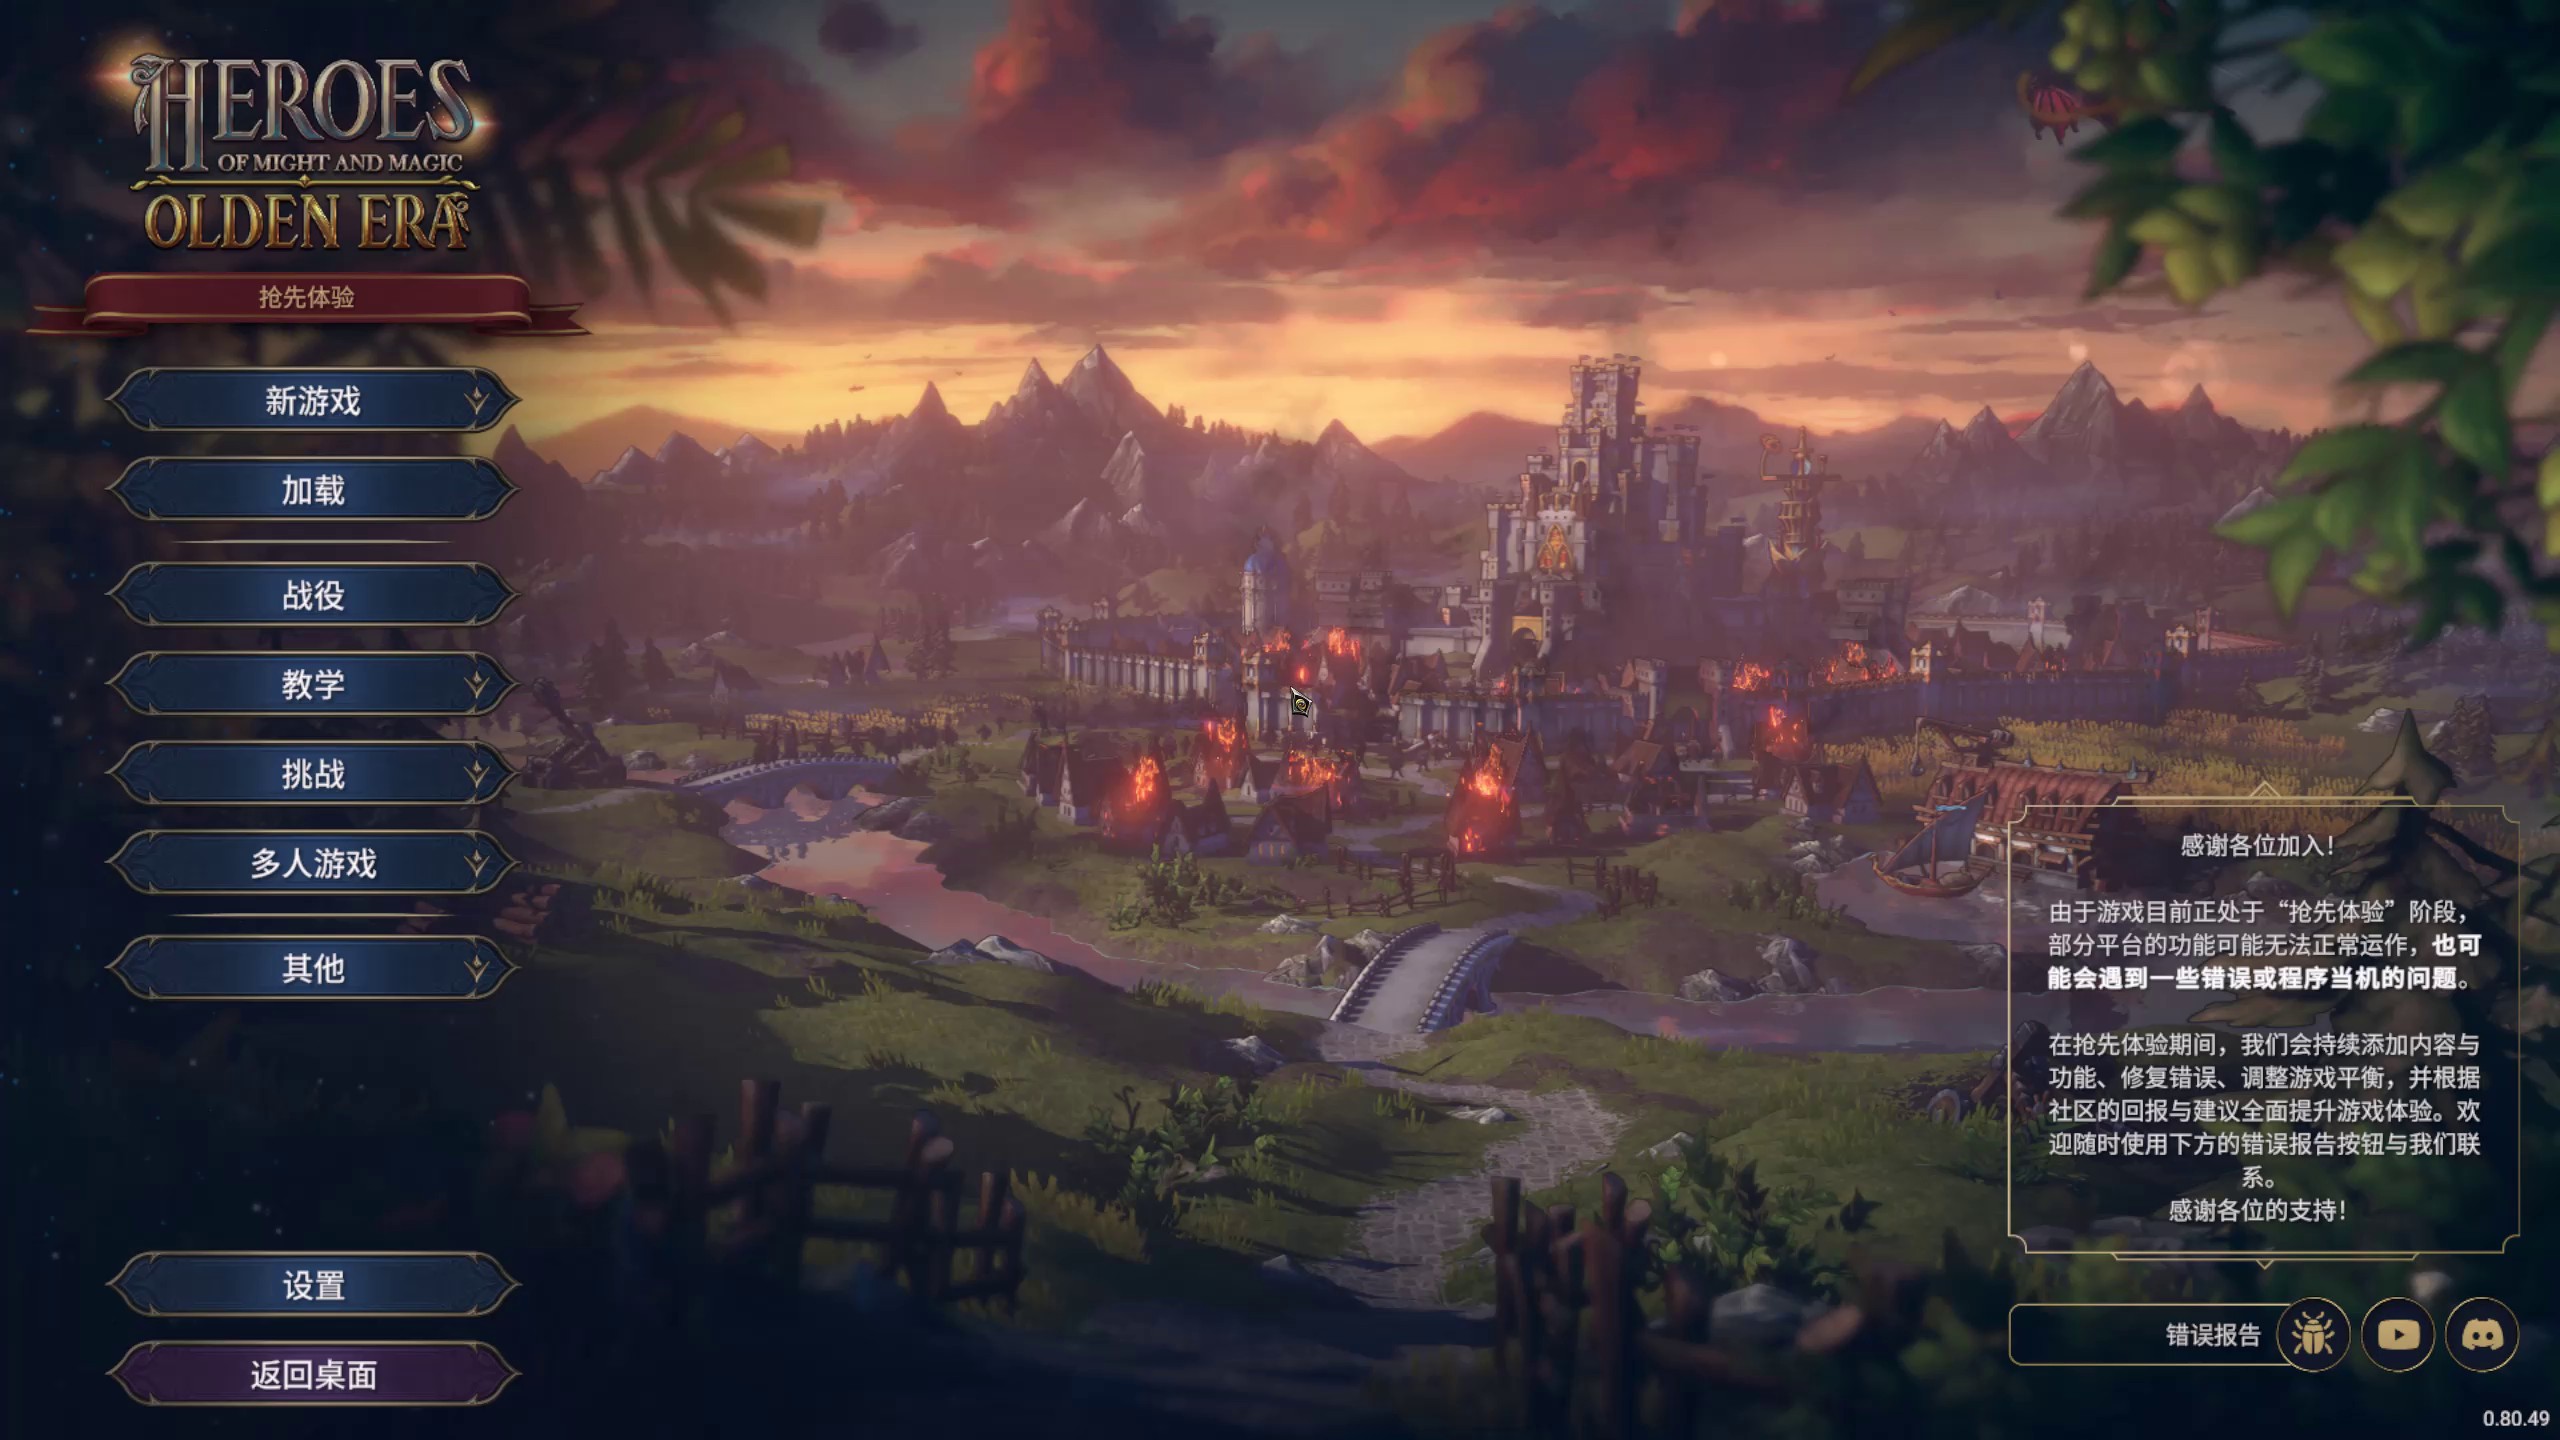
历史规则匹配文字:新游戏 · 加载 · 返回桌面
查看历史预测与旧标签
历史 OCR 预测:主菜单。当时参考标签:主菜单(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 27 个 OCR 文本区域
HEROES | EROES | OFMIGHTANDMAGIC | OLDEN ERA | 抢先体验 | 新游戏 | 加载 | 战役 | 教学 | 挑战 | 感谢各位加入! | 多人游戏 | 由于游戏目前正处于“抢先体验”阶段 | 部分平台的功能可能无法正常运作,也可 | 其他 | 能会遇到一些错误或程序当机的问题。 | 在抢先体验期间,我们会持续添加内容与 | 功能、修复错误、调整游戏平衡,并根据 | 社区的回报与建议全面提升游戏体验。欢 | 迎随时使用下方的错误报告按钮与我们联 | 系。 | 感谢各位的支持! | 设置 | 错误报告 | 0 | 返回桌面 | 0.80.49
历史规则匹配文字:新游戏 · 加载 · 返回桌面
查看历史预测与旧标签
历史 OCR 预测:主菜单。当时参考标签:主菜单(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 27 个 OCR 文本区域
HEROES | EROES | OF MIGHT AND MAGIC | OLDEN ERA | 抢先体验 | 新游戏 | 加载 | 战役 | 教学 | 挑战 | 感谢各位加入! | 多人游戏 | 由于游戏目前正处于“抢先体验”阶段, | 部分平台的功能可能无法正常运作,也可 | 其他 | 能会遇到一些错误或程序当机的问题。 | 在抢先体验期间,我们会持续添加内容与 | 功能、修复错误、调整游戏平衡,并根据 | 社区的回报与建议全面提升游戏体验。欢 | 迎随时使用下方的错误报告按钮与我们联 | 系。 | 感谢各位的支持! | 设置 | 错误报告 | 0 | 返回桌面 | 0.80.49
新游戏展开菜单 · NEW_GAME_MENU 2 张示例
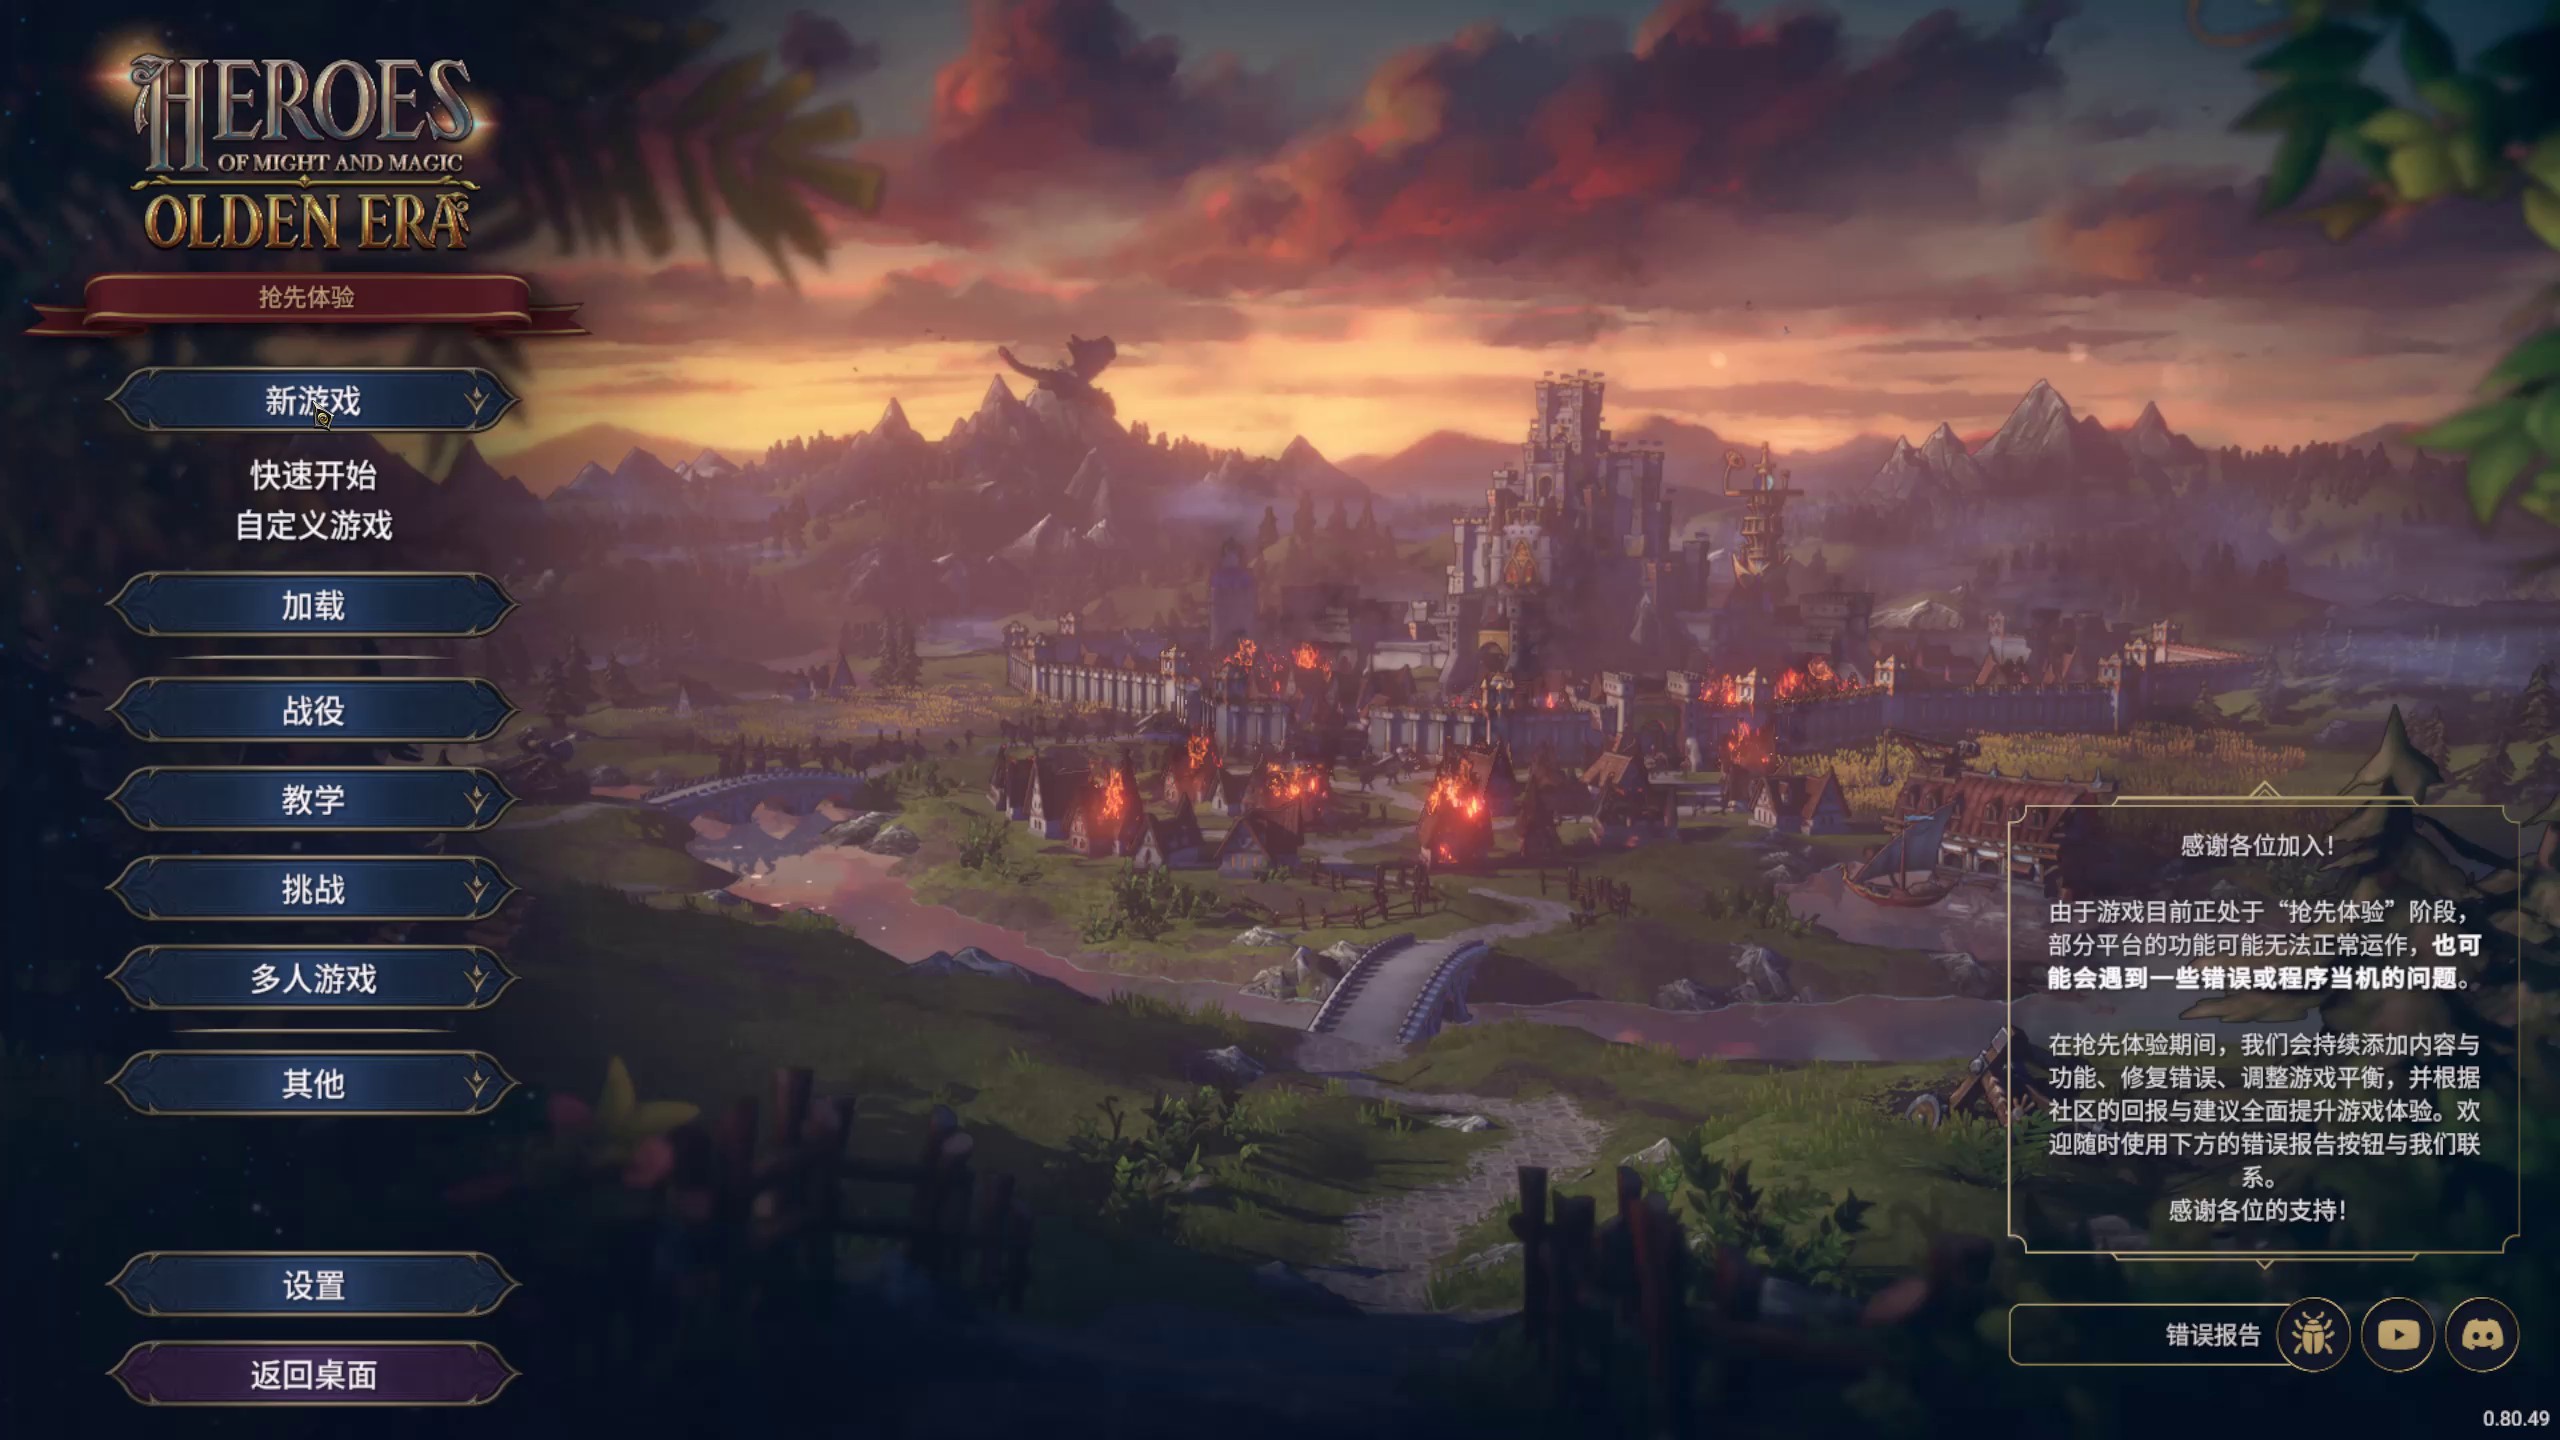
历史规则匹配文字:新游戏 · 加载 · 返回桌面 · 快速开始 · 自定义游戏
查看历史预测与旧标签
历史 OCR 预测:新游戏展开菜单。当时参考标签:主菜单(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 28 个 OCR 文本区域
EROES | OFMIGHTANDMAGIC | OLDEN ERA | 抢先体验 | 新游戏 | 快速开始 | 自定义游戏 | 加载 | 战役 | 教学 | 感谢各位加入! | 挑战 | 由于游戏目前正处于“抢先体验”阶段, | 部分平台的功能可能无法正常运作,也可 | 多人游戏 | 能会遇到一些错误或程序当机的问题。 | 在抢先体验期间,我们会持续添加内容与 | 其他 | 功能、修复错误、调整游戏平衡,并根据 | 社区的回报与建议全面提升游戏体验。欢 | 迎随时使用下方的错误报告按钮与我们联 | 系。 | 感谢各位的支持! | 设置 | 错误报告 | 0 | 返回桌面 | 0.80.49
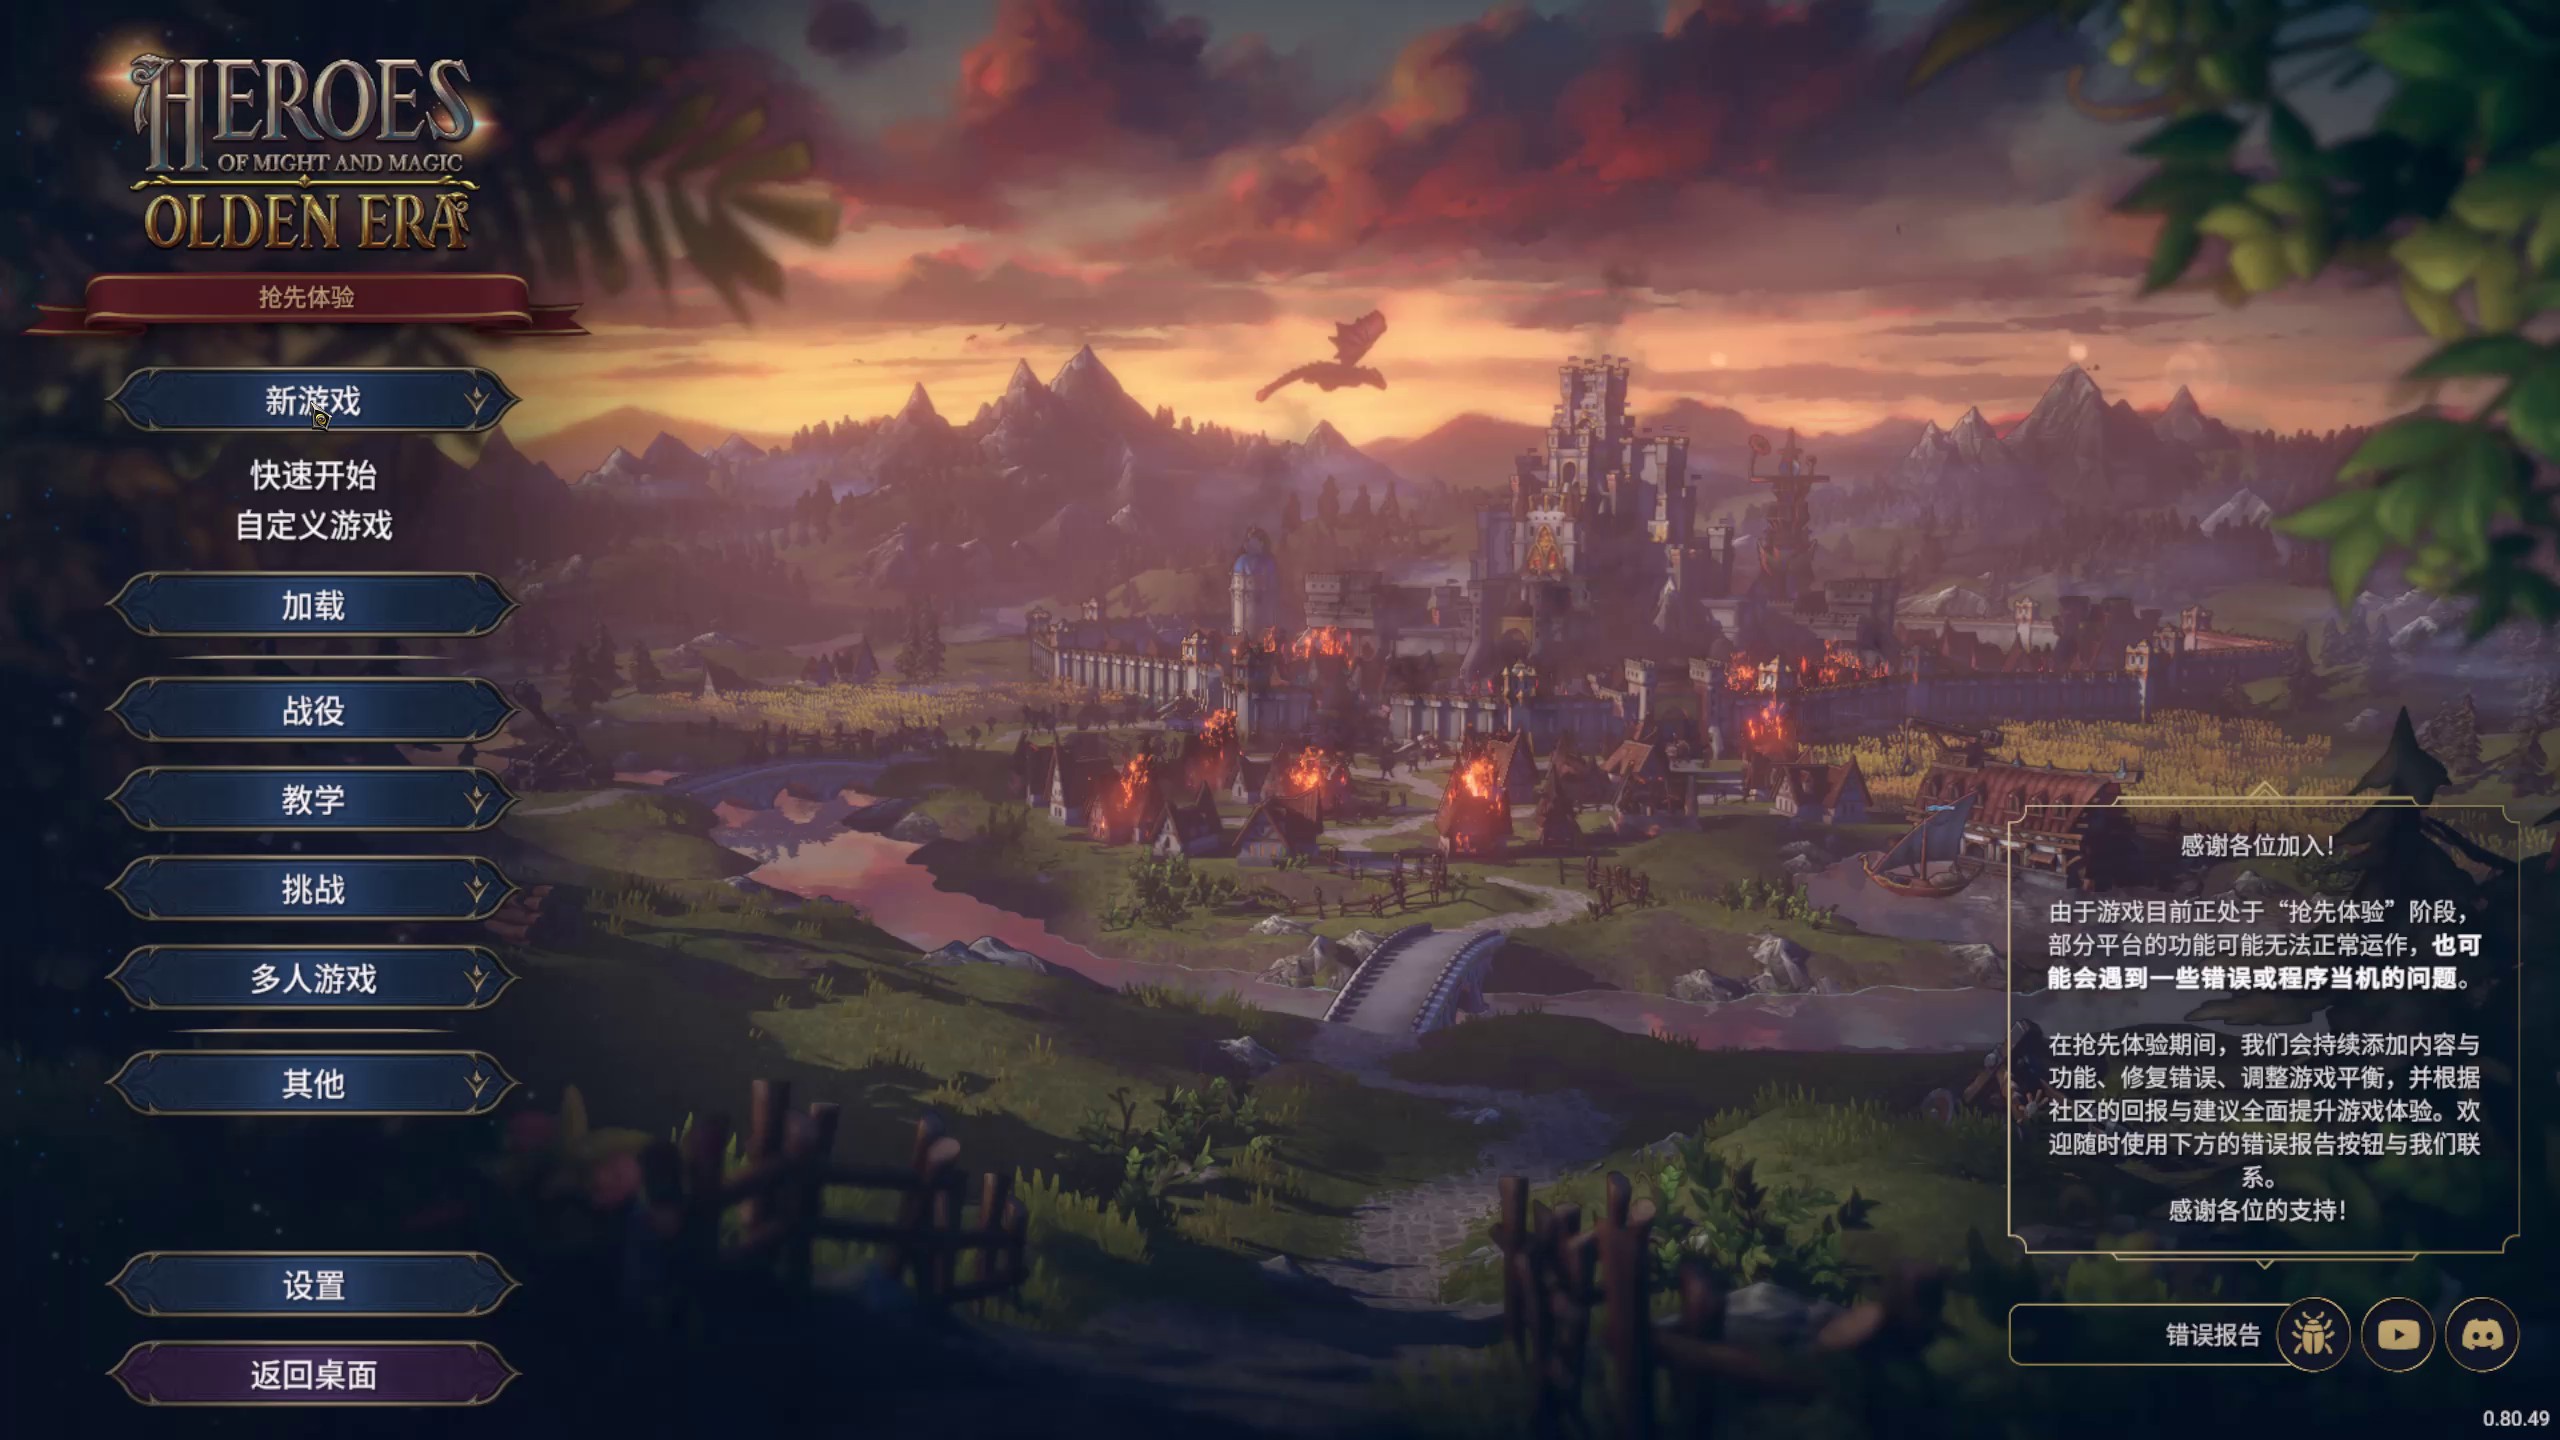
历史规则匹配文字:新游戏 · 加载 · 返回桌面 · 快速开始 · 自定义游戏
查看历史预测与旧标签
历史 OCR 预测:新游戏展开菜单。当时参考标签:主菜单(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 28 个 OCR 文本区域
EROES | OFMIGHTANDMAGIC | OLDEN ERA | 抢先体验 | 新游戏 | 快速开始 | 自定义游戏 | 加载 | 战役 | 教学 | 感谢各位加入! | 挑战 | 由于游戏目前正处于“抢先体验”阶段, | 部分平台的功能可能无法正常运作,也可 | 多人游戏 | 能会遇到一些错误或程序当机的问题。 | 在抢先体验期间,我们会持续添加内容与 | 其他 | 功能、修复错误、调整游戏平衡,并根据 | 社区的回报与建议全面提升游戏体验。欢 | 迎随时使用下方的错误报告按钮与我们联 | 系。 | 感谢各位的支持! | 设置 | 错误报告 | 0 | 返回桌面 | 0.80.49
多人游戏展开菜单 · MULTIPLAYER_MENU 1 张示例
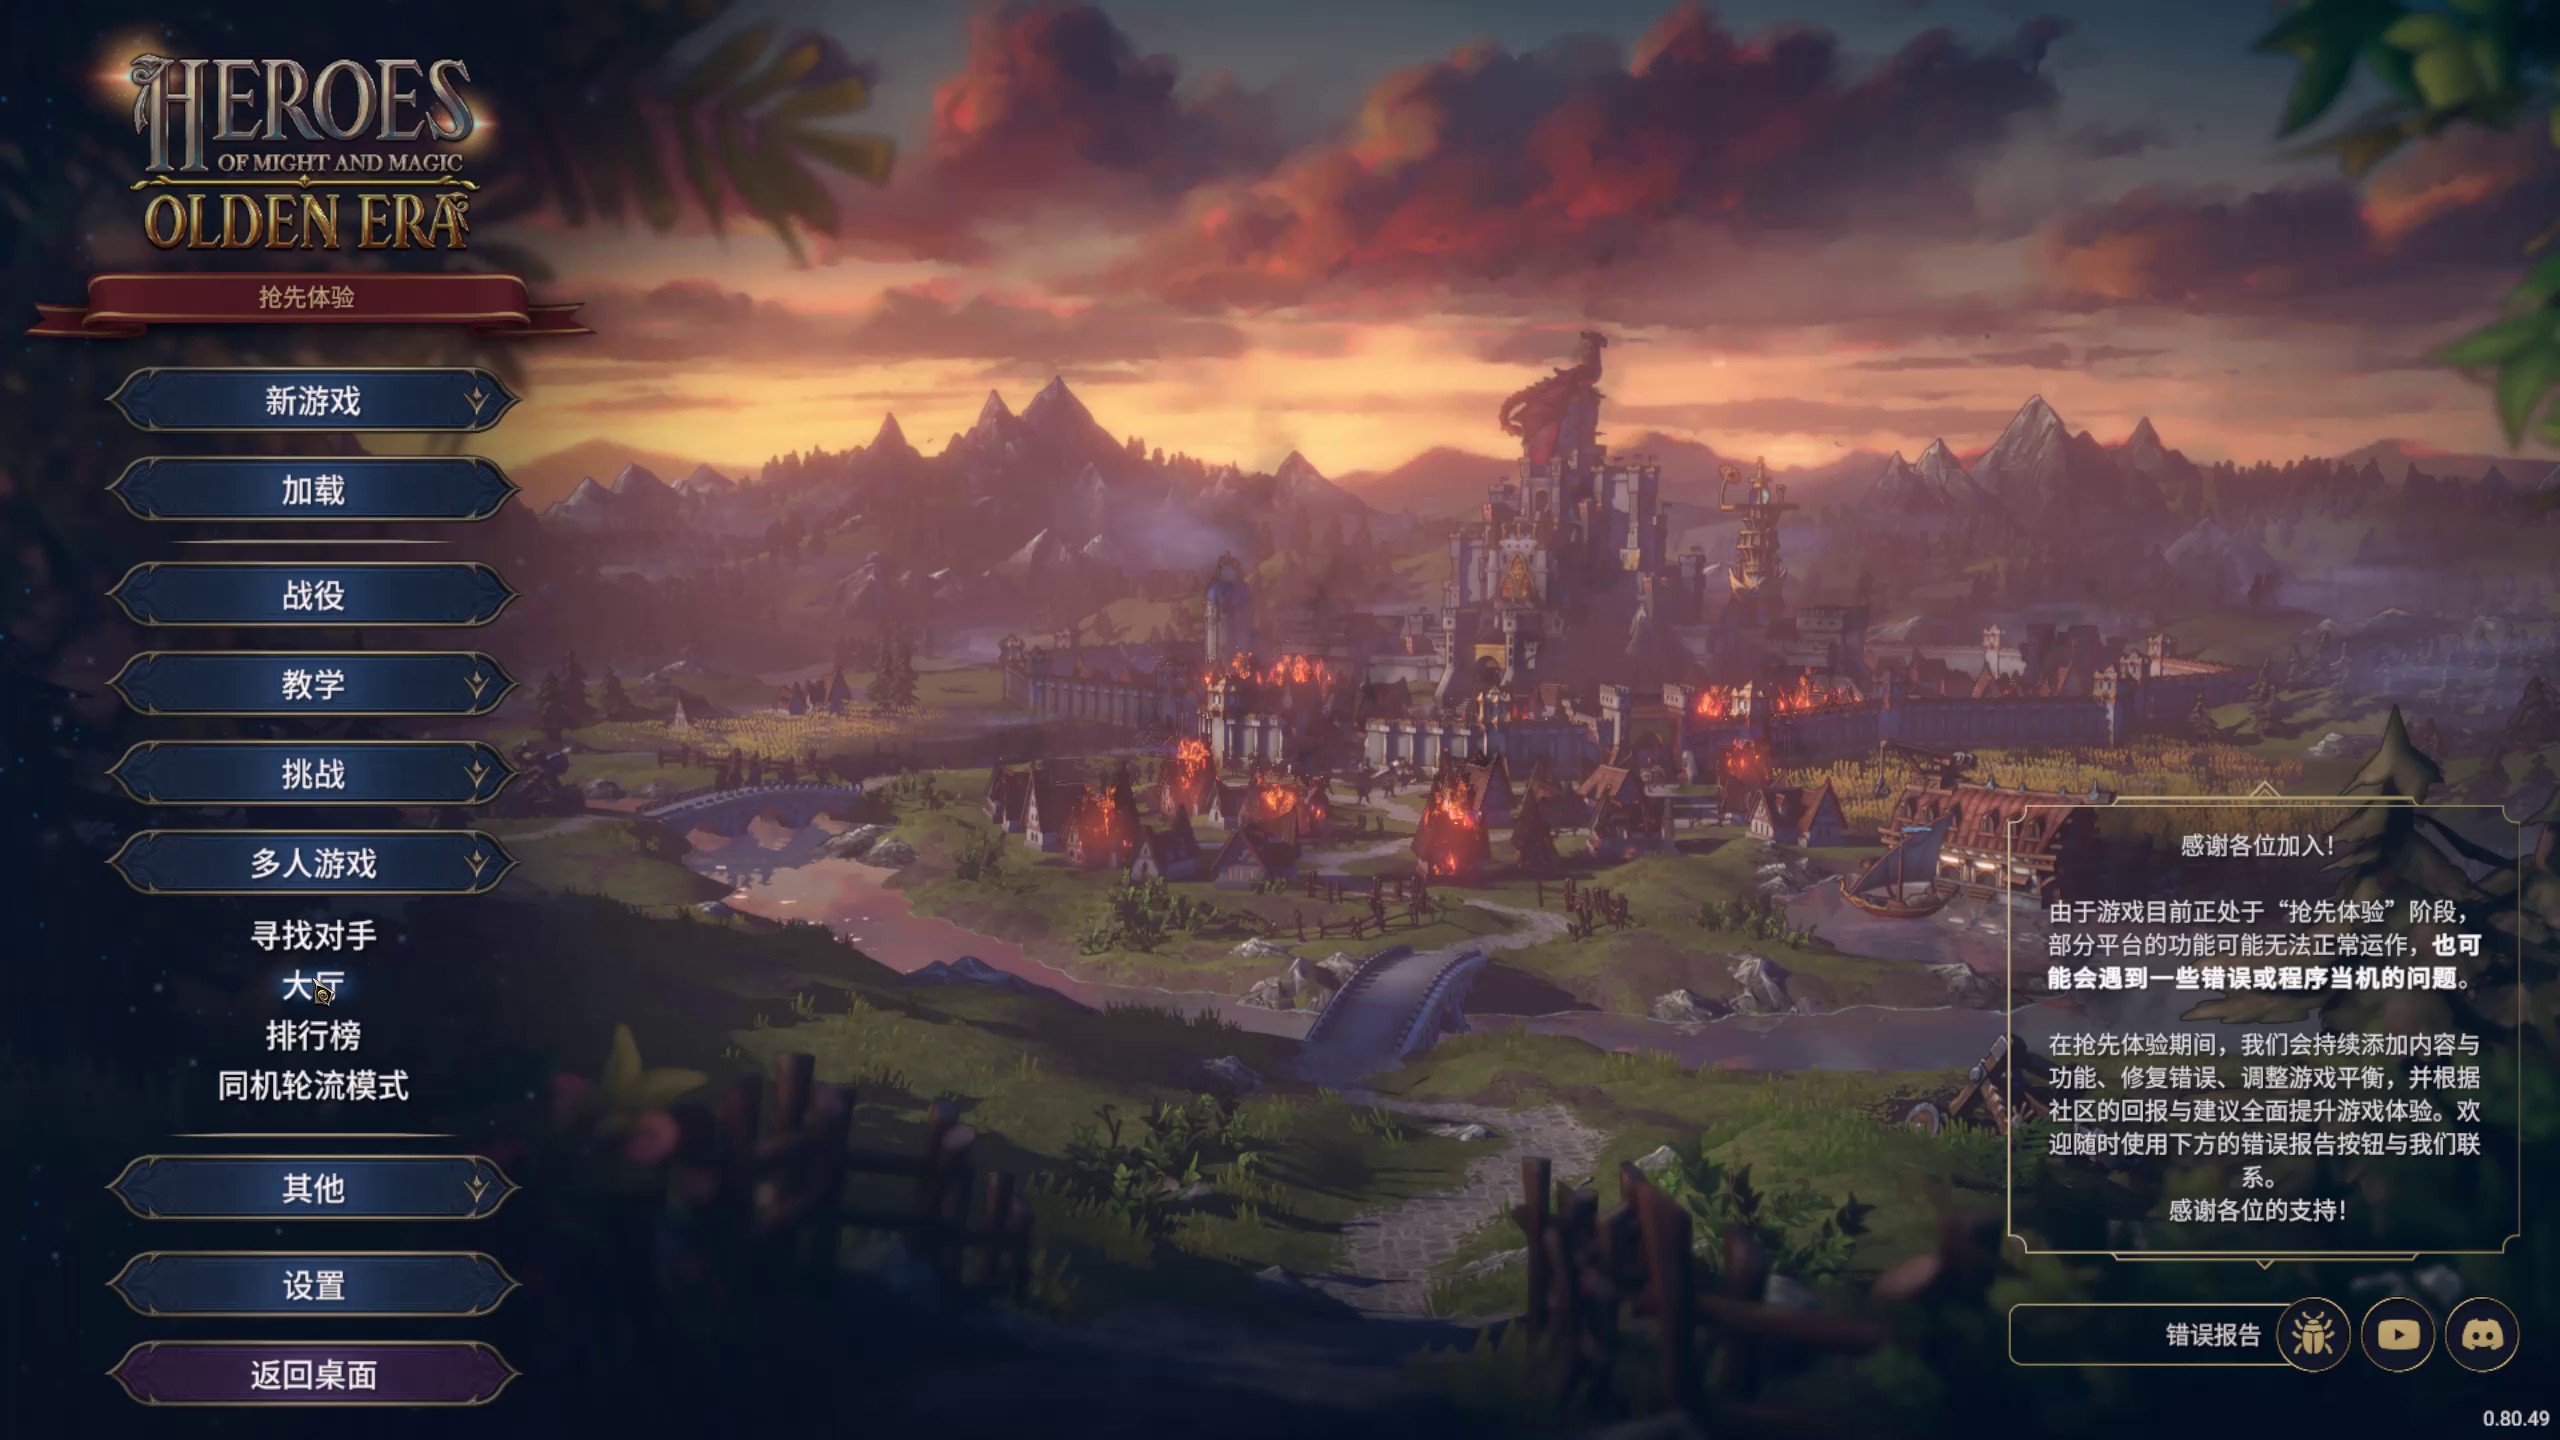
历史规则匹配文字:新游戏 · 加载 · 返回桌面 · 寻找对手 · 同机轮流模式
查看历史预测与旧标签
历史 OCR 预测:多人游戏展开菜单。当时参考标签:主菜单(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 31 个 OCR 文本区域
EROES | OFMIGHTANDMAGIC | OLDEN ERA | 抢先体验 | 新游戏 | 加载 | 战役 | 教学 | 挑战 | 感谢各位加入! | 多人游戏 | 由于游戏目前正处于“抢先体验”阶段, | 寻找对手 | 部分平台的功能可能无法正常运作,也可 | 大 | 大厅 | 能会遇到一些错误或程序当机的问题。 | 排行榜 | 在抢先体验期间,我们会持续添加内容与 | 功能、修复错误、调整游戏平衡,并根据 | 同机轮流模式 | 社区的回报与建议全面提升游戏体验。欢 | 迎随时使用下方的错误报告按钮与我们联 | 系。 | 其他 | 感谢各位的支持! | 设置 | 错误报告 | 0 | 返回桌面 | 0.80.49
对局设置 · MATCH_SETUP 2 张示例
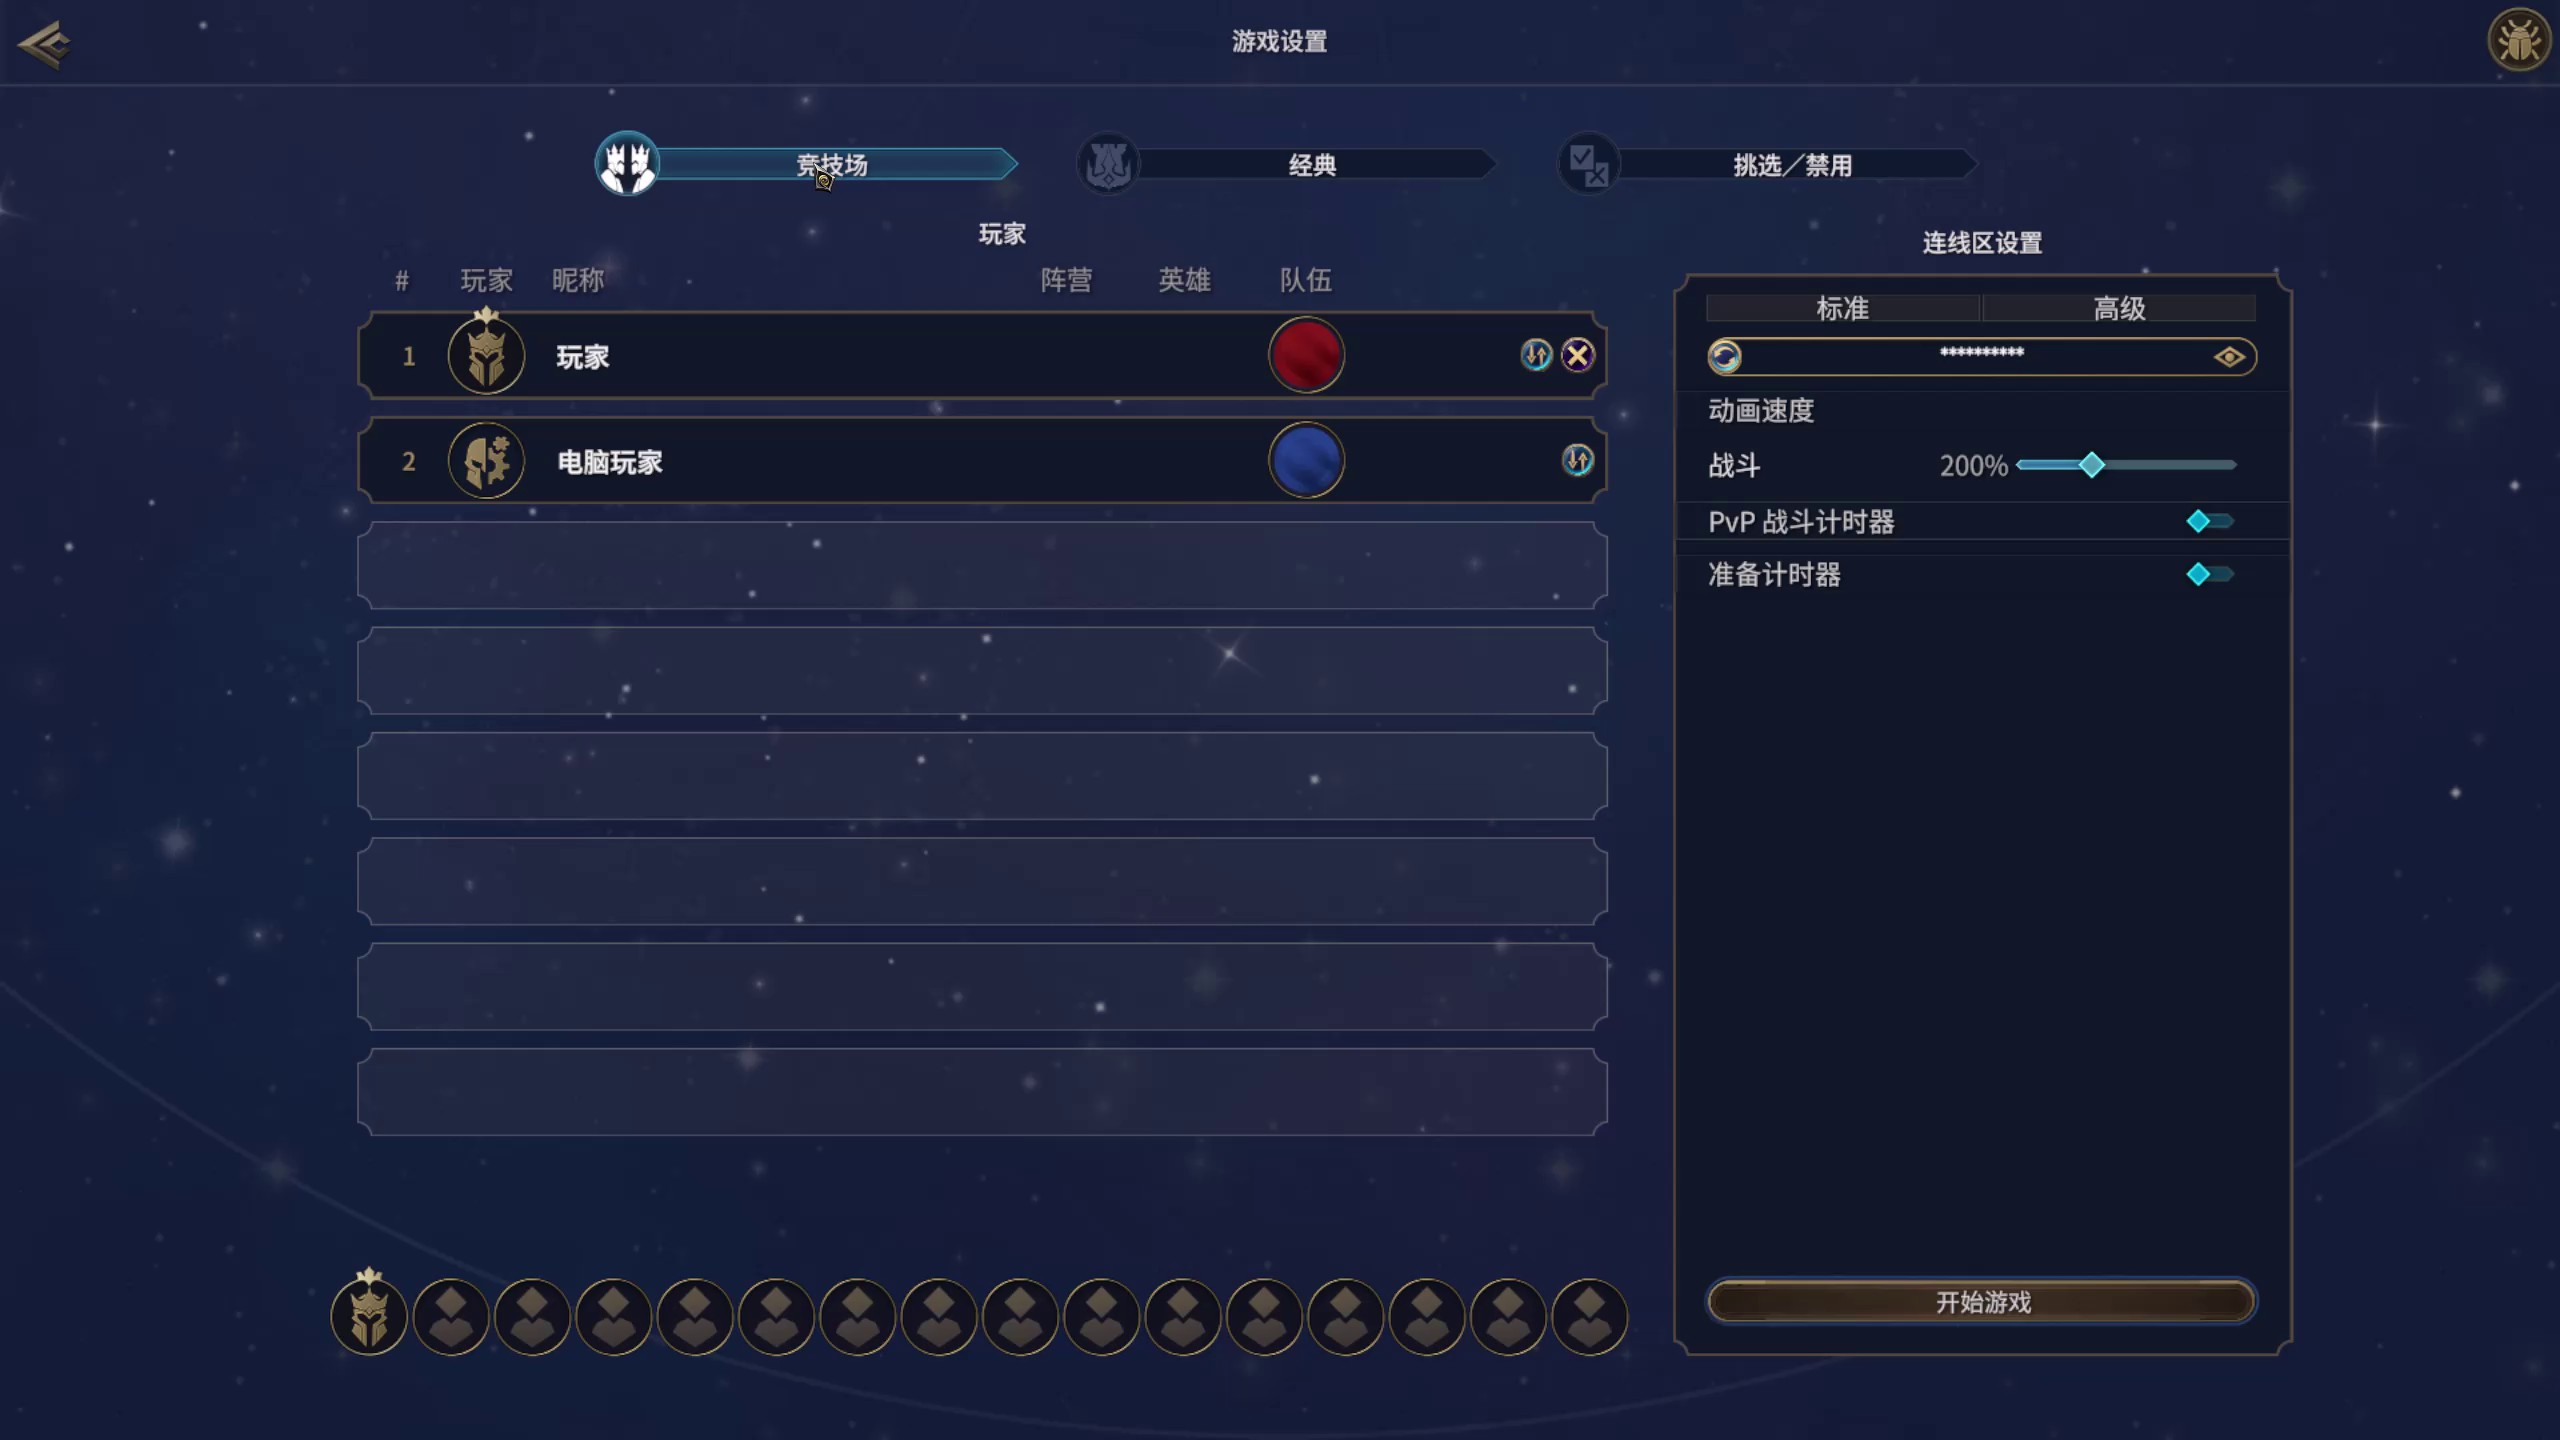
历史规则匹配文字:游戏设置 · 开始游戏
查看历史预测与旧标签
历史 OCR 预测:对局设置。当时参考标签:对局设置(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 28 个 OCR 文本区域
游戏设置 | 经典 | 竞技场 | 挑选/禁用 | 玩家 | 连线区设置 | #玩家昵称 | 英雄 | 队伍 | 昵称 | 阵营 | # 玩家 | 高级 | 标准 | 玩家 | 1 | **水***水*** | 动画速度 | 电脑玩家 | 战斗 | 2 | 200% | PvP战斗计时器 | 0 | 准备计时器 | 0 | 0 | 开始游戏
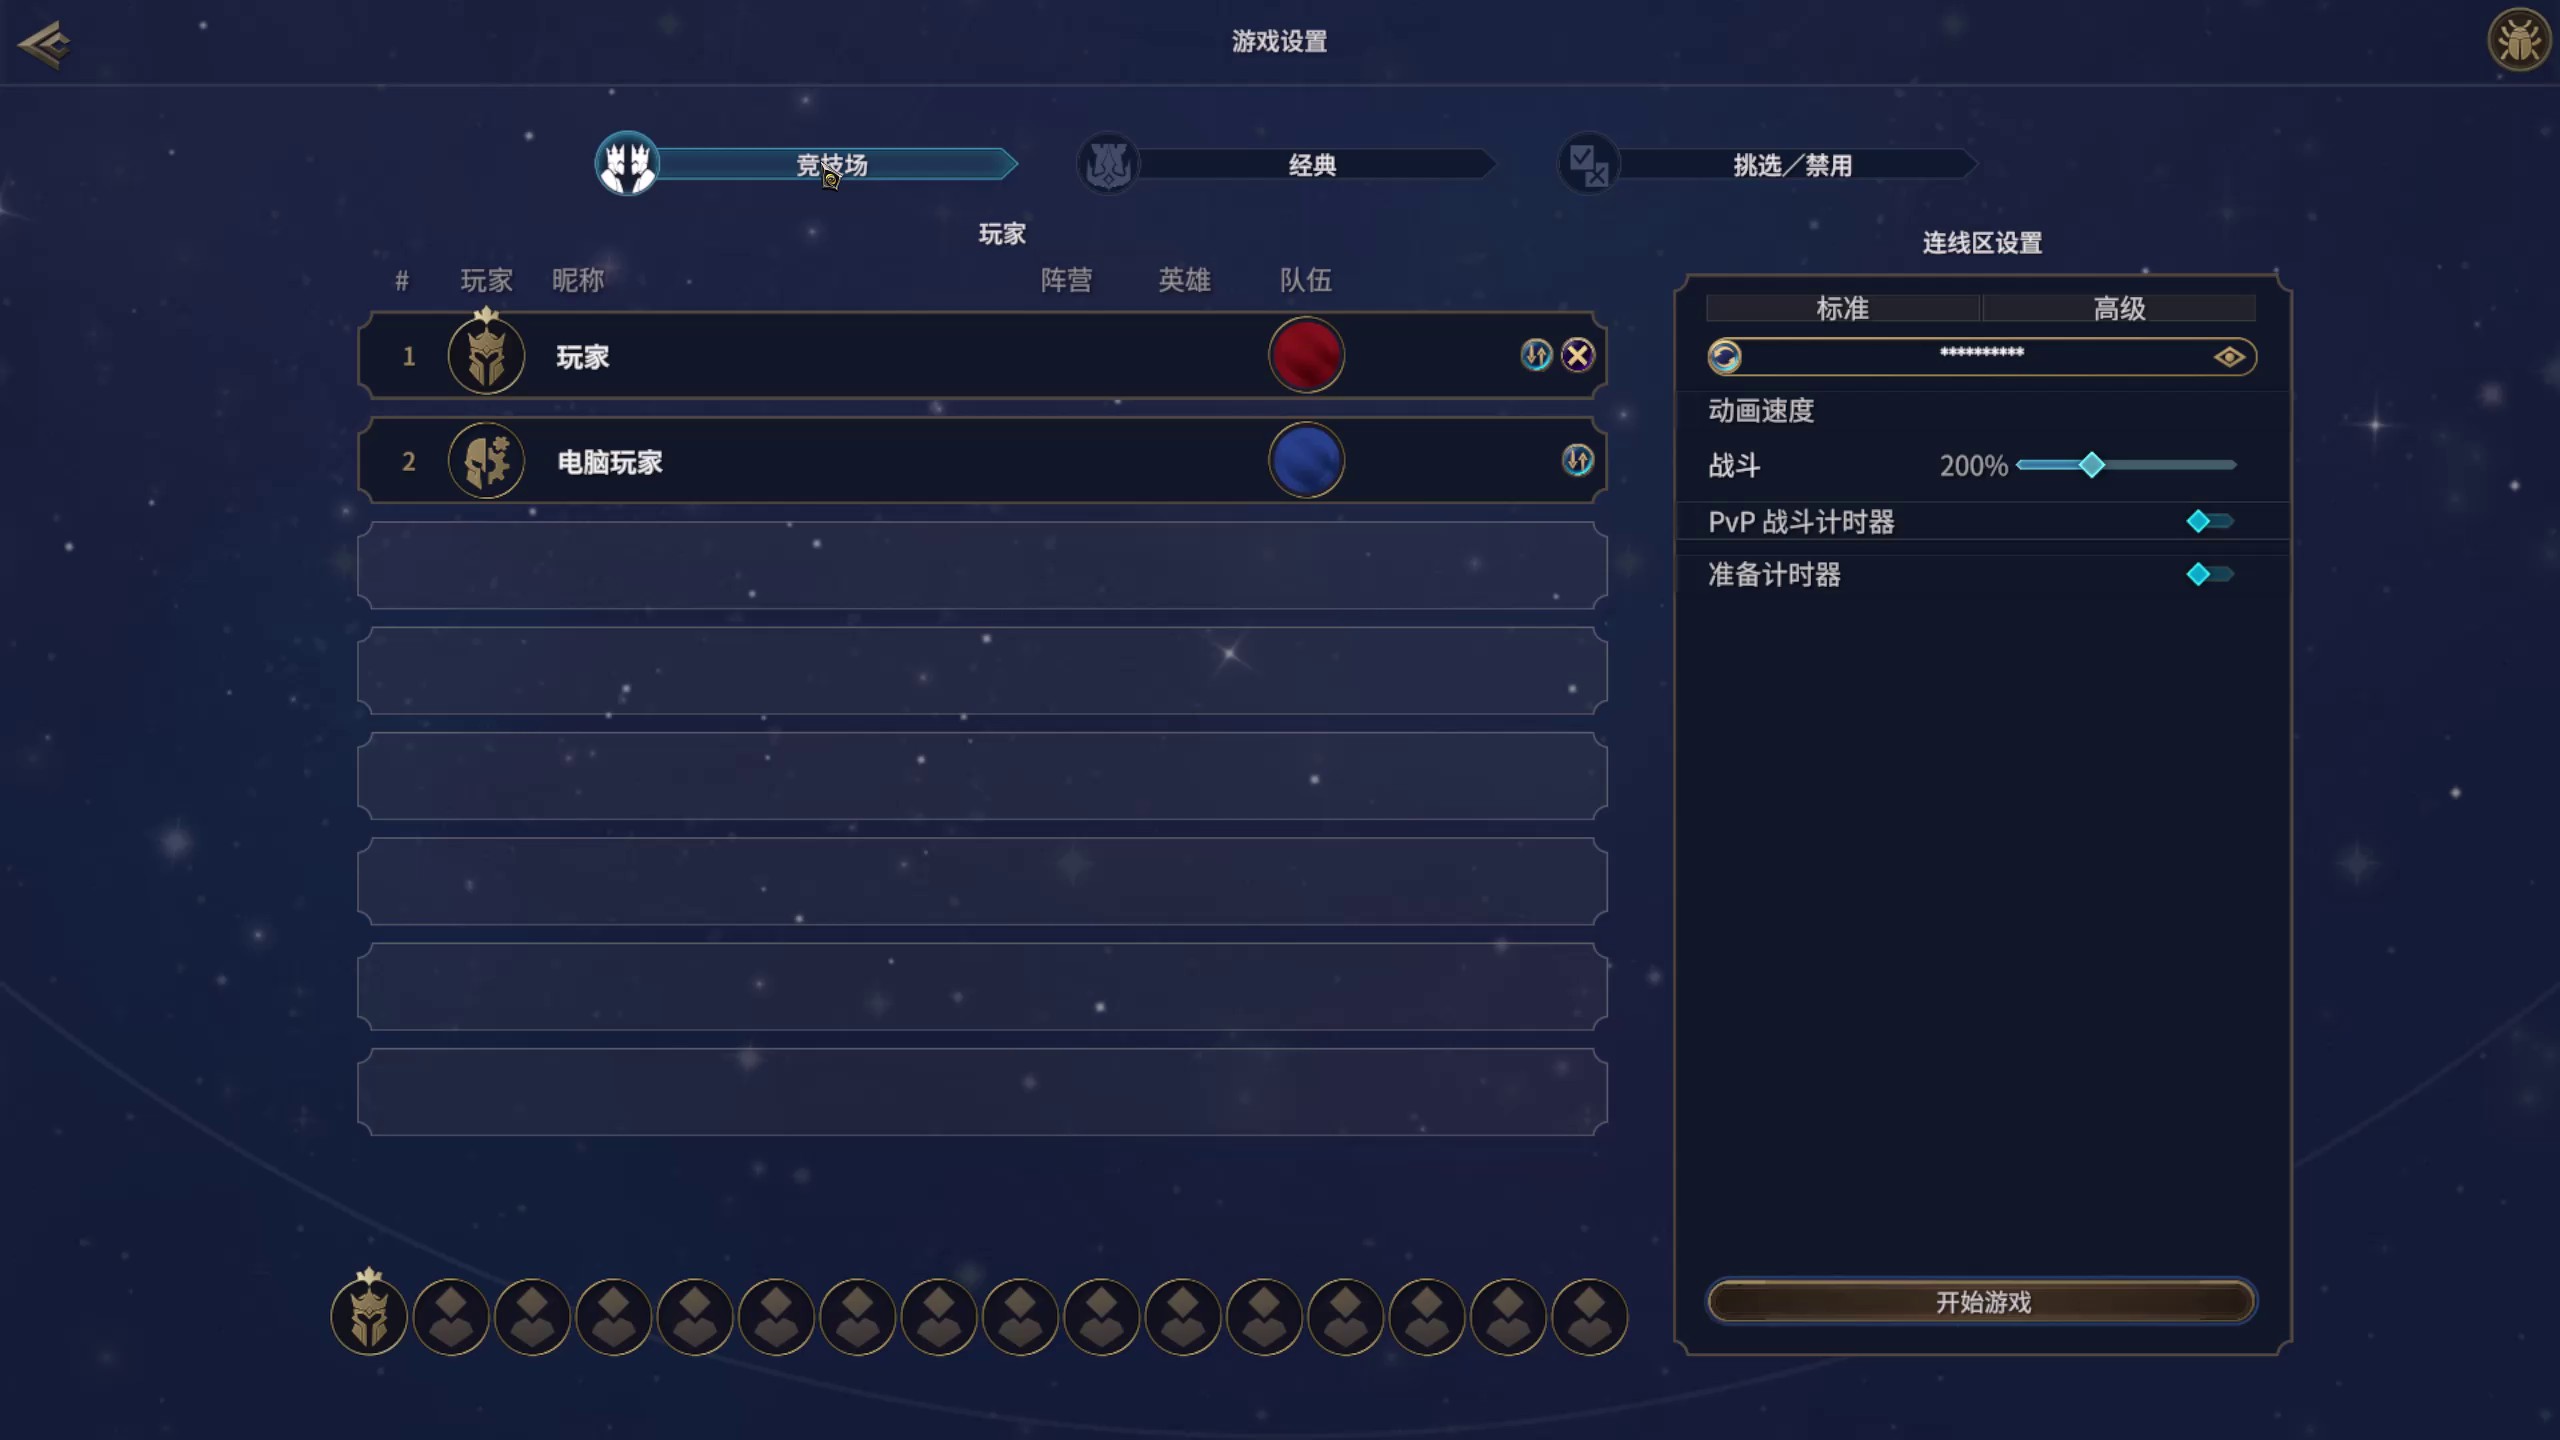
历史规则匹配文字:游戏设置 · 开始游戏
查看历史预测与旧标签
历史 OCR 预测:对局设置。当时参考标签:对局设置(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 28 个 OCR 文本区域
游戏设置 | 经典 | 竞技场 | 挑选/禁用 | 玩家 | 连线区设置 | #玩家昵称 | 英雄 | 队伍 | 昵称 | 阵营 | # 玩家 | 标准 | 高级 | 玩家 | 1 | **水***水*** | 动画速度 | 电脑玩家 | 战斗 | 2 | 200% | PvP战斗计时器 | 0 | 准备计时器 | 0 | 0 | 开始游戏
选择英雄 · HERO_SELECTION 2 张示例
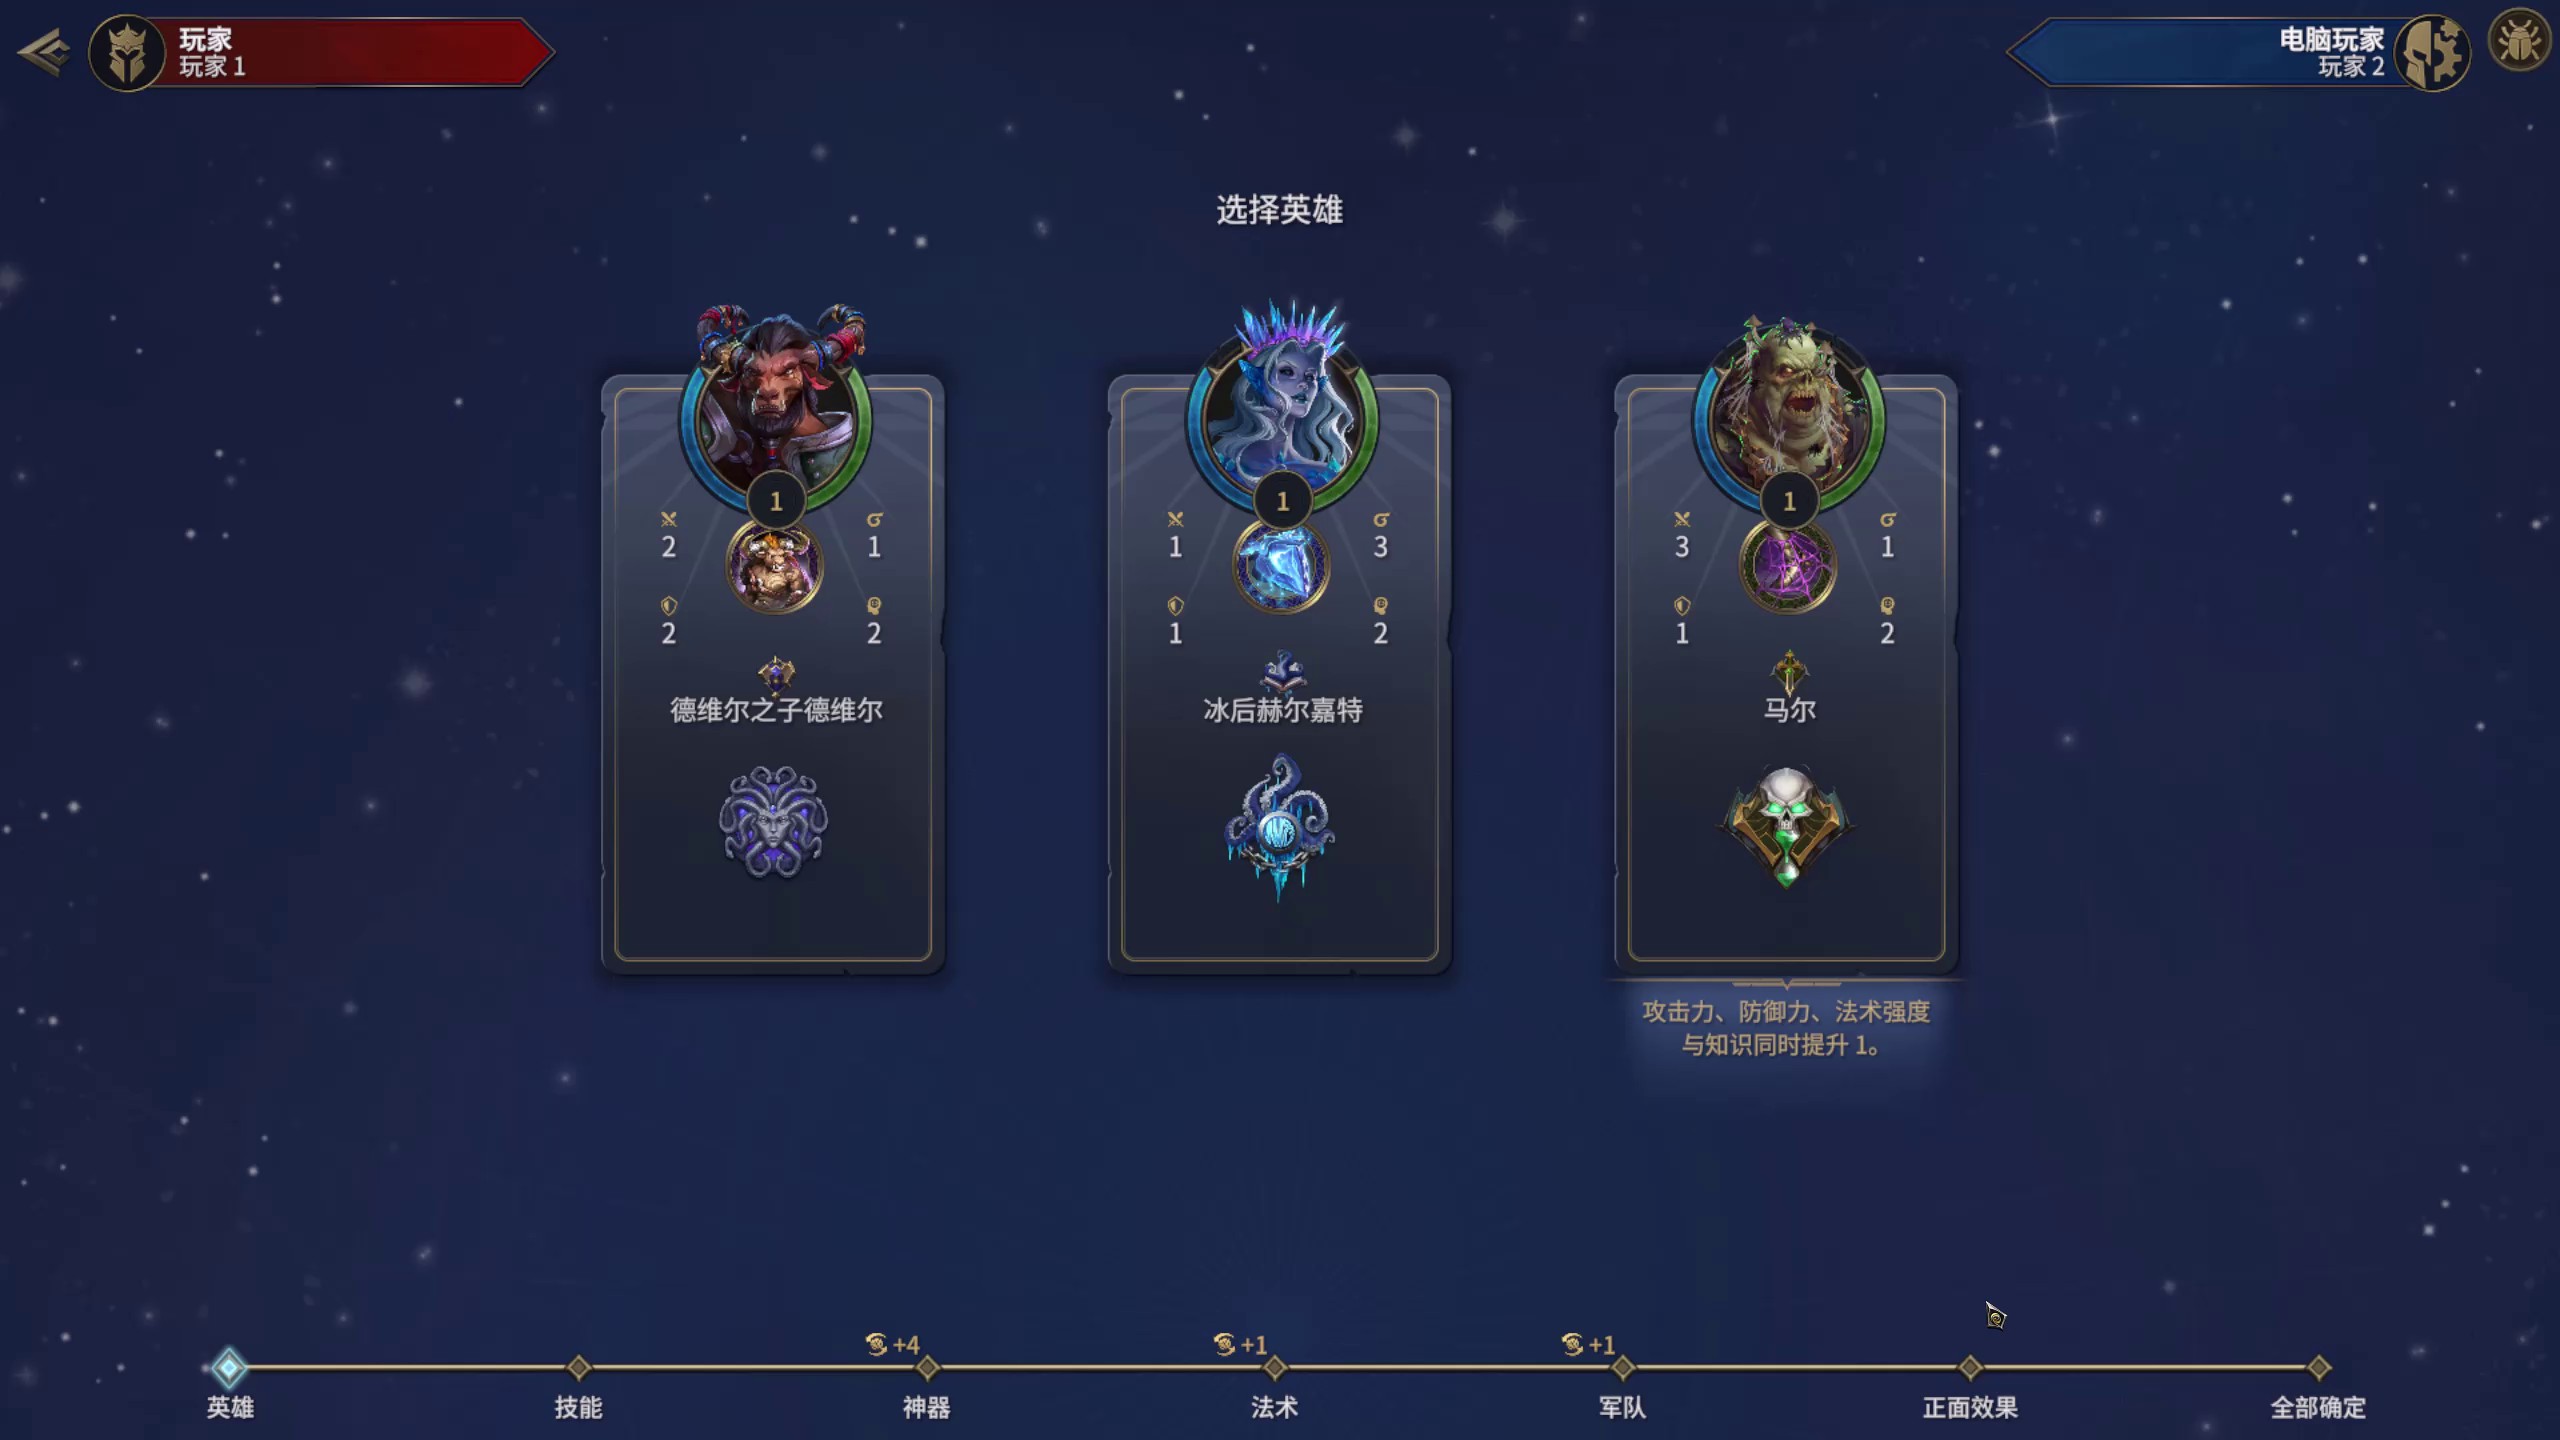
历史规则匹配文字:选择英雄
查看历史预测与旧标签
历史 OCR 预测:选择英雄。当时参考标签:选择英雄(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 37 个 OCR 文本区域
玩家 | 电脑玩家 | 玩家2 | 玩家1 | 选择英雄 | 1 | 1 | 2 2 | b3 | X3 | 3 | x2 | x1 | bi | b1 | b1 | 2 | 1 | 2 | 2 | 1 | 2 | 冰后赫尔嘉特 | 马尔 | 德维尔之子德维尔 | 攻击力、防御力、法术强度 | 与知识同时提升1。 | +1 | +4 | +1 | 技能 | 军队 | 英雄 | 法术 | 神器 | 正面效果 | 全部确定
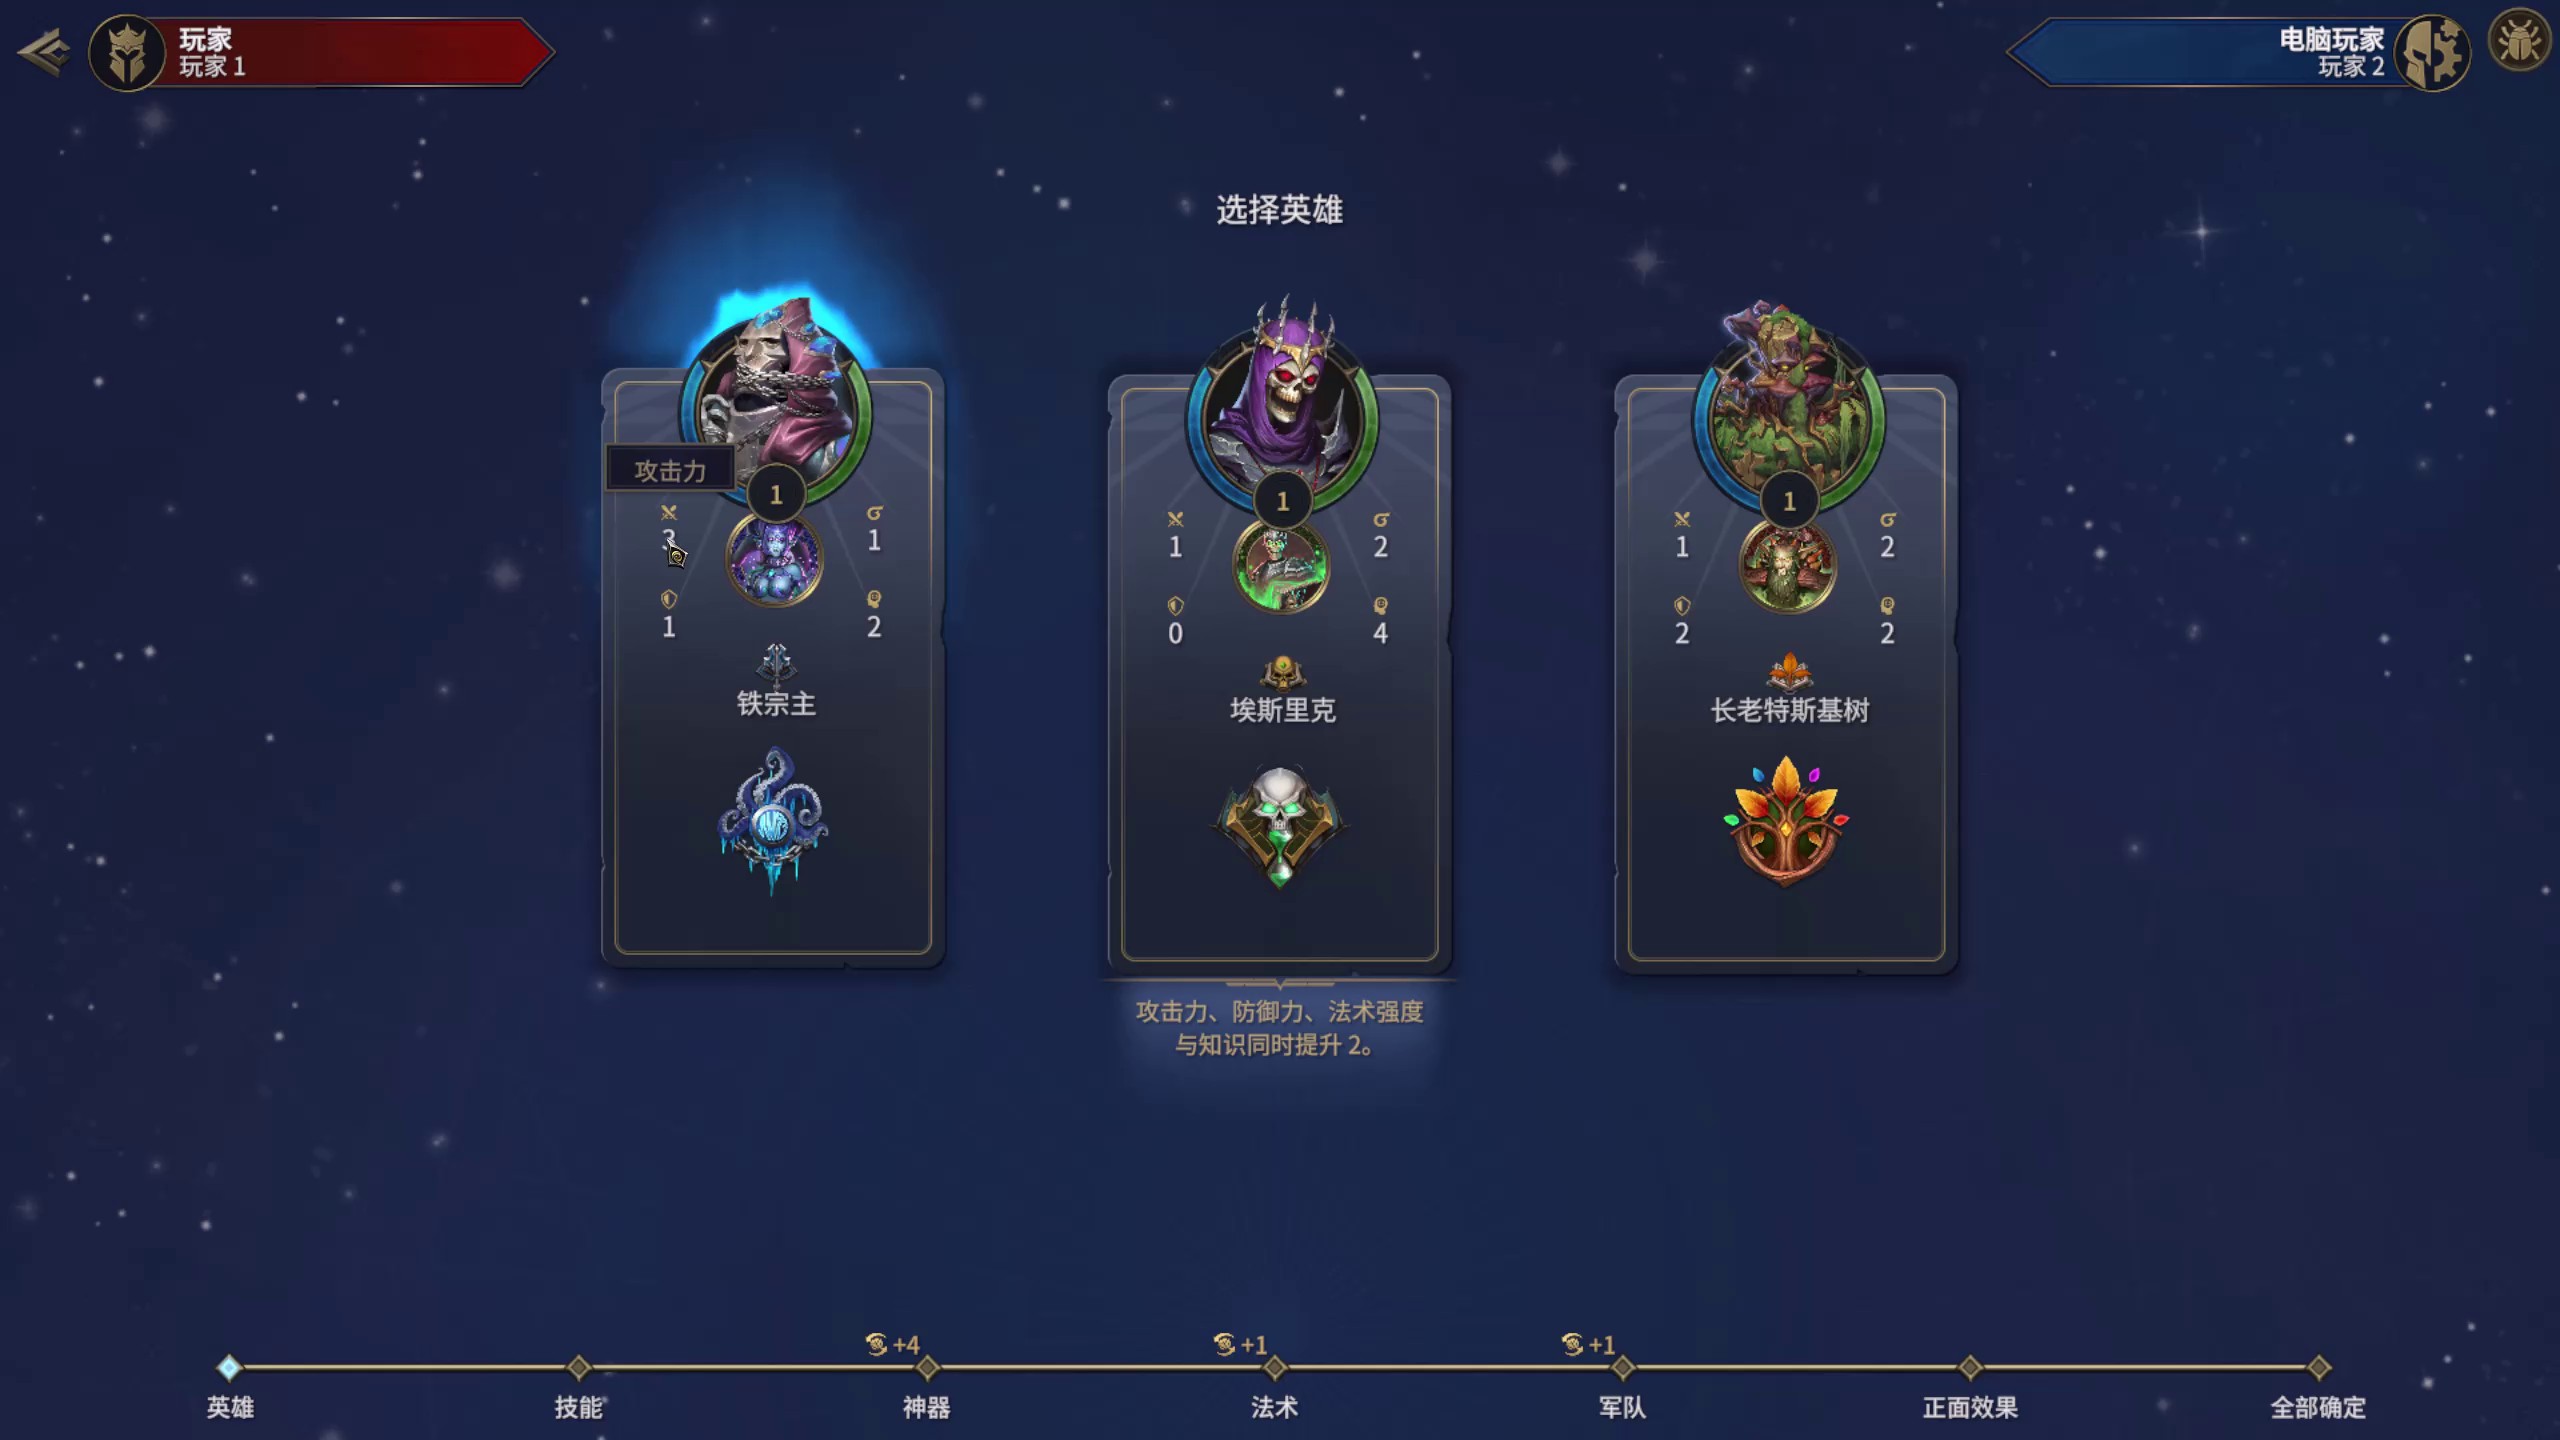
历史规则匹配文字:选择英雄
查看历史预测与旧标签
历史 OCR 预测:选择英雄。当时参考标签:选择英雄(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 34 个 OCR 文本区域
玩家 | 电脑玩家 | 玩家2 | 玩家1 | 选择英雄 | 攻击力 | 1 | X3. | b1 | b2 | b2 | x1 | x1 | 2 | 2 | 4 | 1 | 0 | 2 | 铁宗主 | 埃斯里克 | 长老特斯基树 | 攻击力、防御力、法术强度 | 与知识同时提升2。 | +1 | +1 | +4 | 技能 | 英雄 | 军队 | 神器 | 法术 | 全部确定 | 正面效果
选择技能 · SKILL_SELECTION 2 张示例
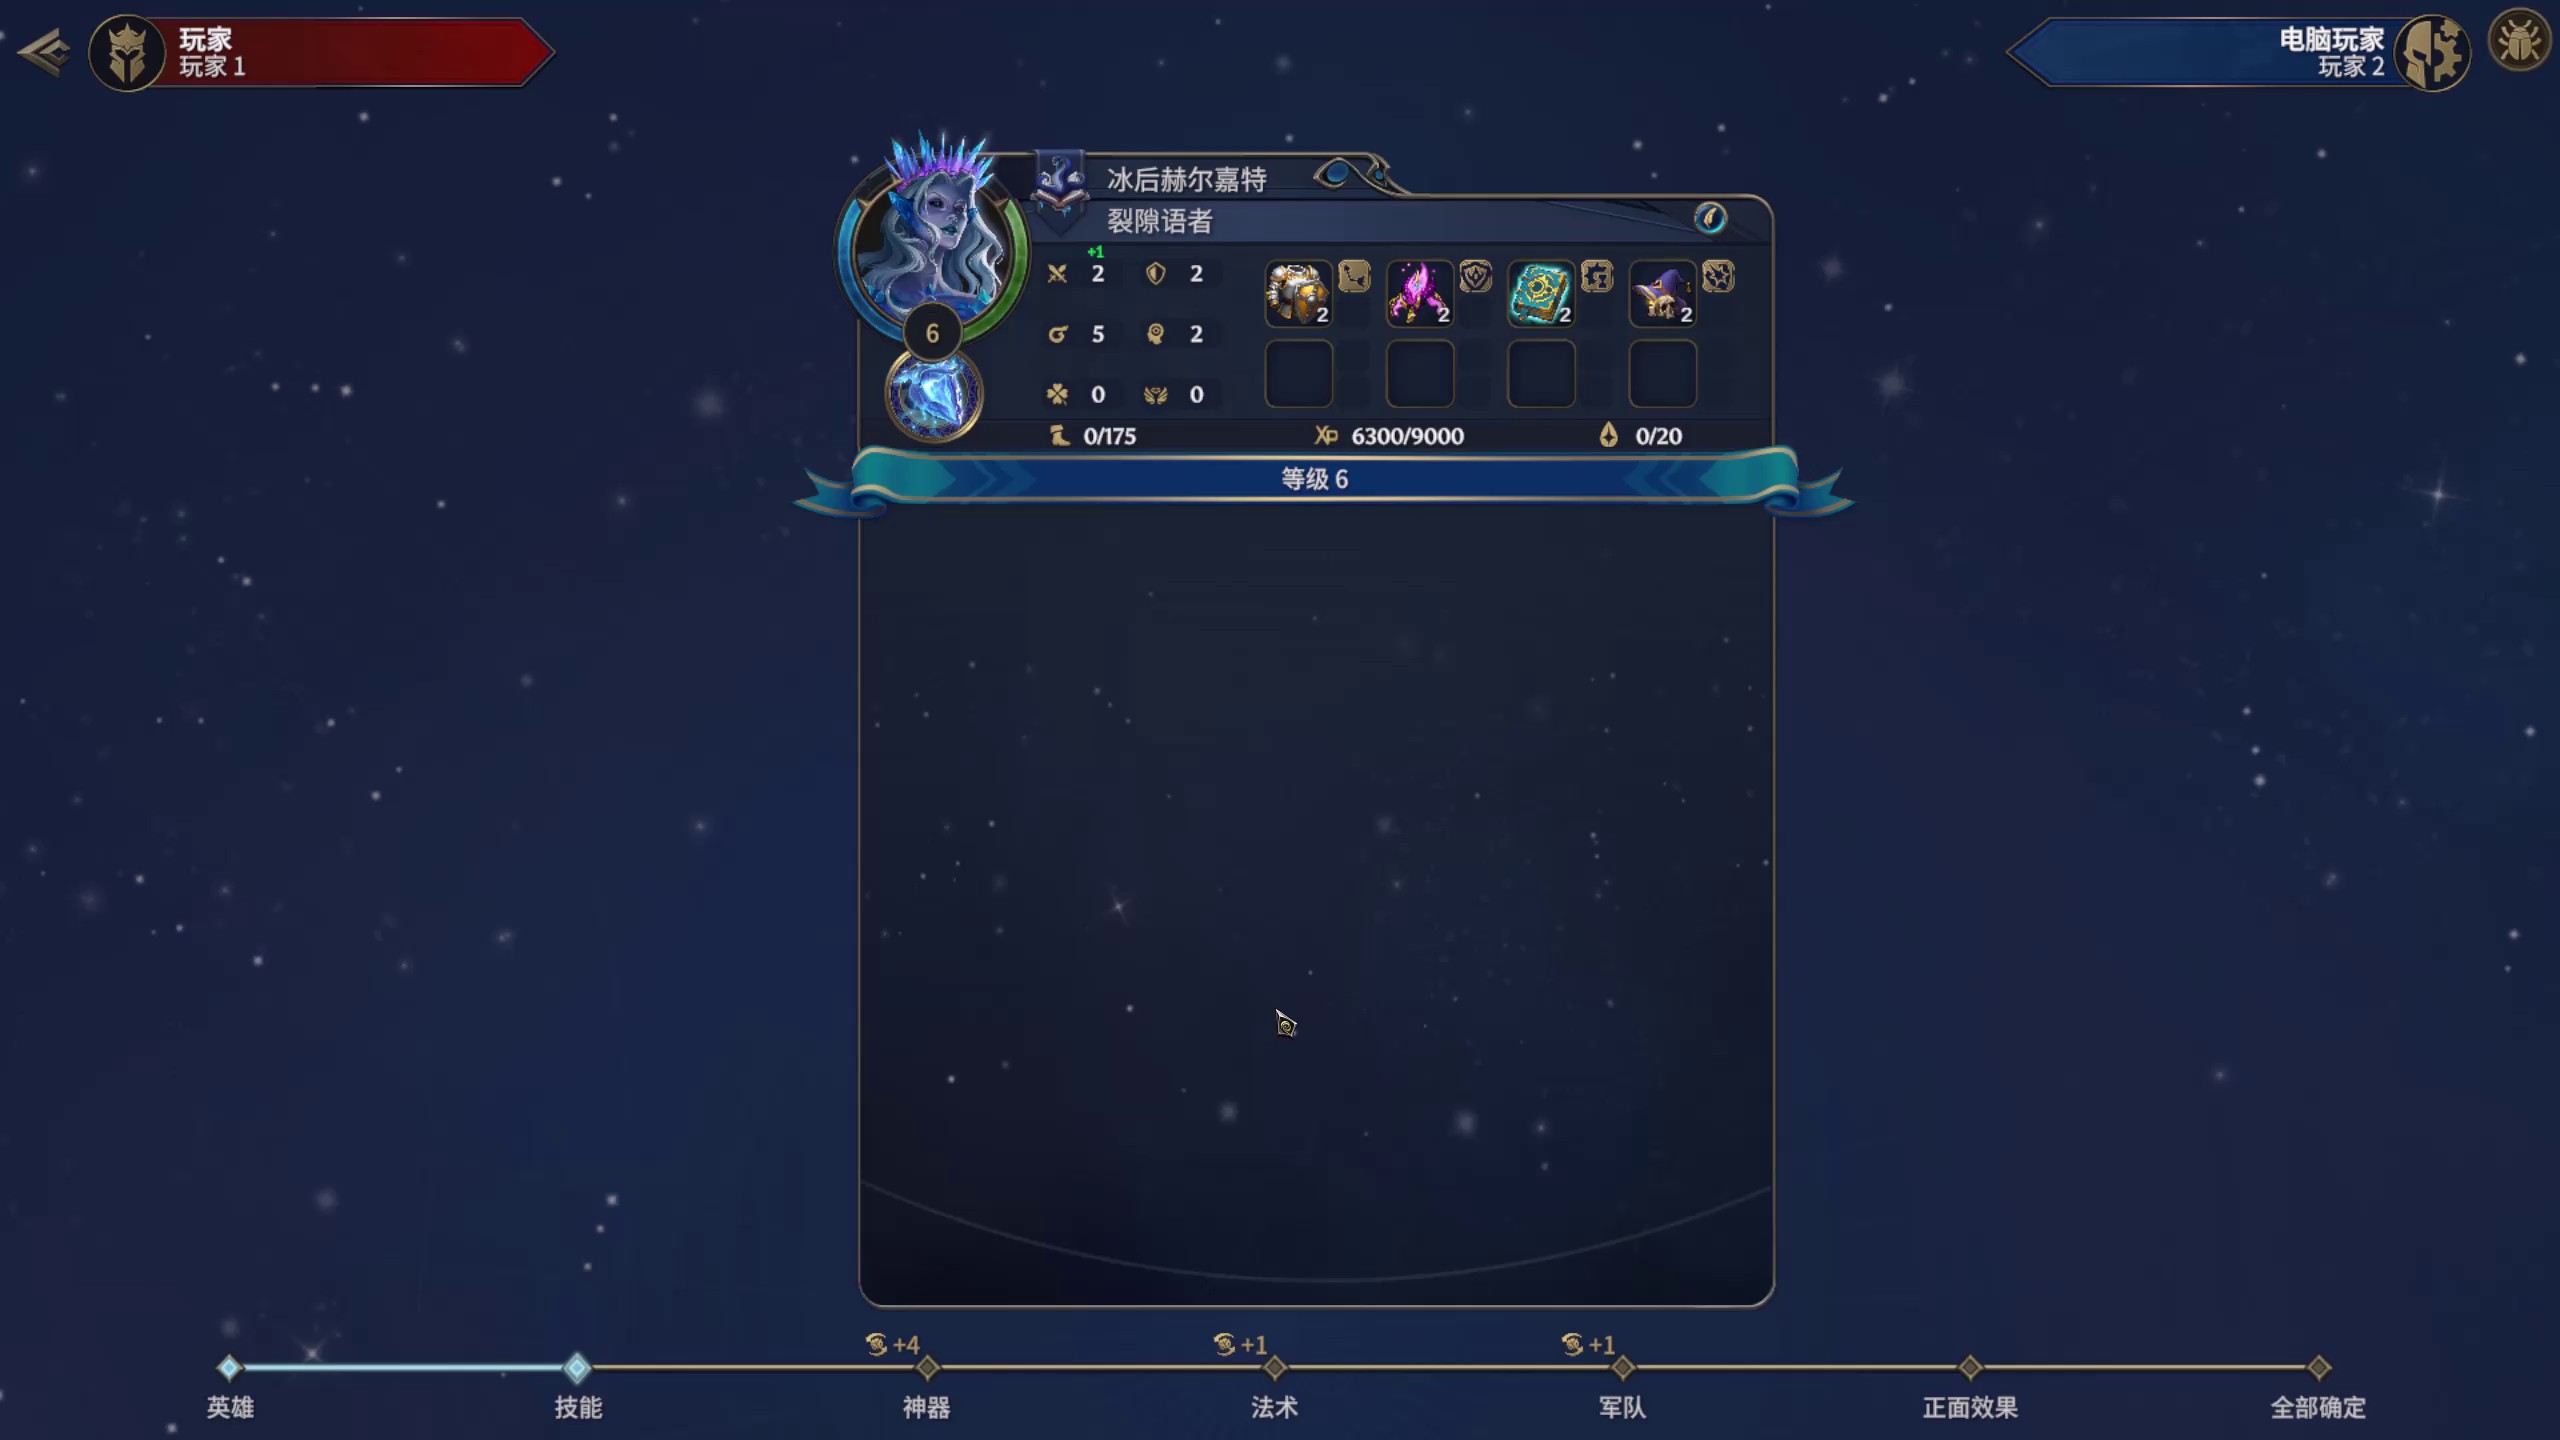
历史规则匹配文字:等级6 · 全部确定
查看历史预测与旧标签
历史 OCR 预测:界面过渡。当时参考标签:界面过渡(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 36 个 OCR 文本区域
电脑玩家 | 玩家 | 玩家2 | 玩家1 | 冰后赫尔嘉特 | 裂隙语者 | +1 | X | 2 | . 2 | 2 | 2 | 2 | 5 | 2 | 0 | 丞 | 0 | 0 | 0/175 | Xp 6300/9000 | X 6300/9000 | 0/175 | 0/20 | 0 | 等级6 | +1 | +4 | +1 | 英雄 | 技能 | 神器 | 法术 | 军队 | 正面效果 | 全部确定
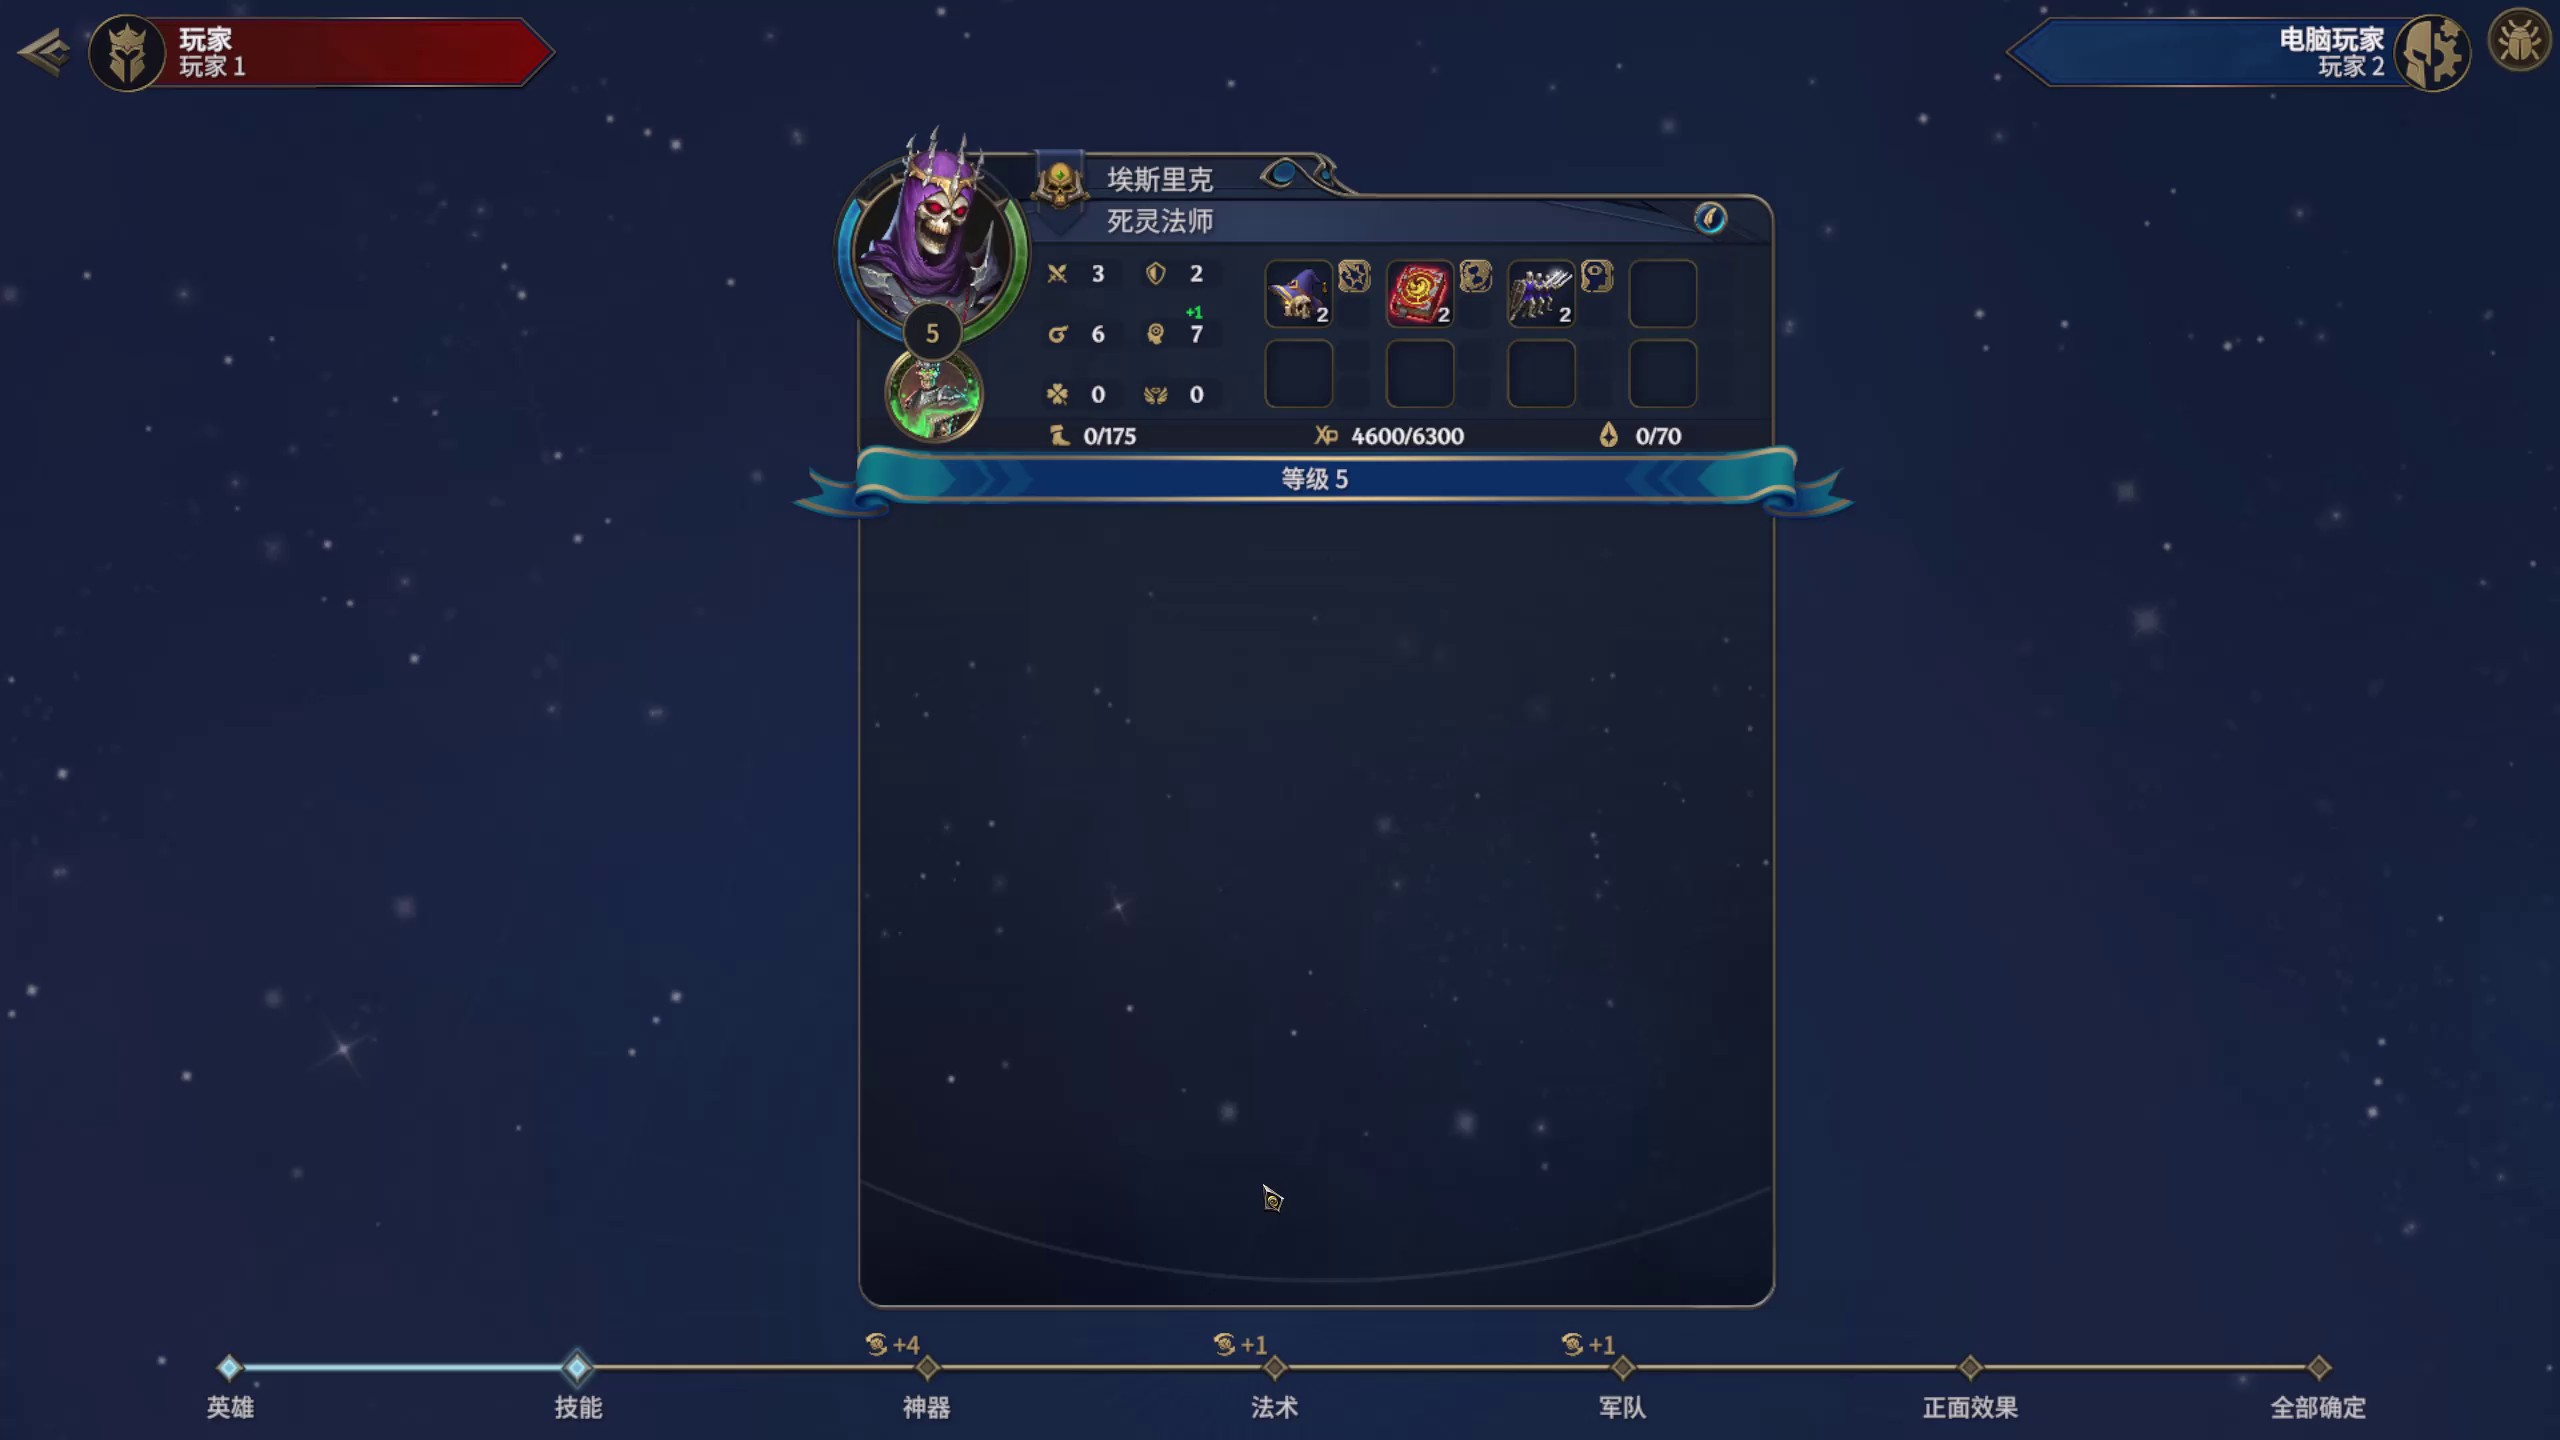
历史规则匹配文字:等级5 · 全部确定
查看历史预测与旧标签
历史 OCR 预测:界面过渡。当时参考标签:界面过渡(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 35 个 OCR 文本区域
电脑玩家 | 玩家 | 玩家2 | 玩家1 | 埃斯里克 | 死灵法师 | 2 | 3 | +1 | 2 | 2 | 5 | 6 | 7 | Q 7 | 0 | 丞 | 0 | 0 | 0/175 | X4600/6300 | 0/175 | 0/70 | 0 | 等级5 | +1 | +1 | +4 | 英雄 | 技能 | 神器 | 法术 | 军队 | 全部确定 | 正面效果
选择主技能 · MAIN_SKILL_SELECTION 2 张示例
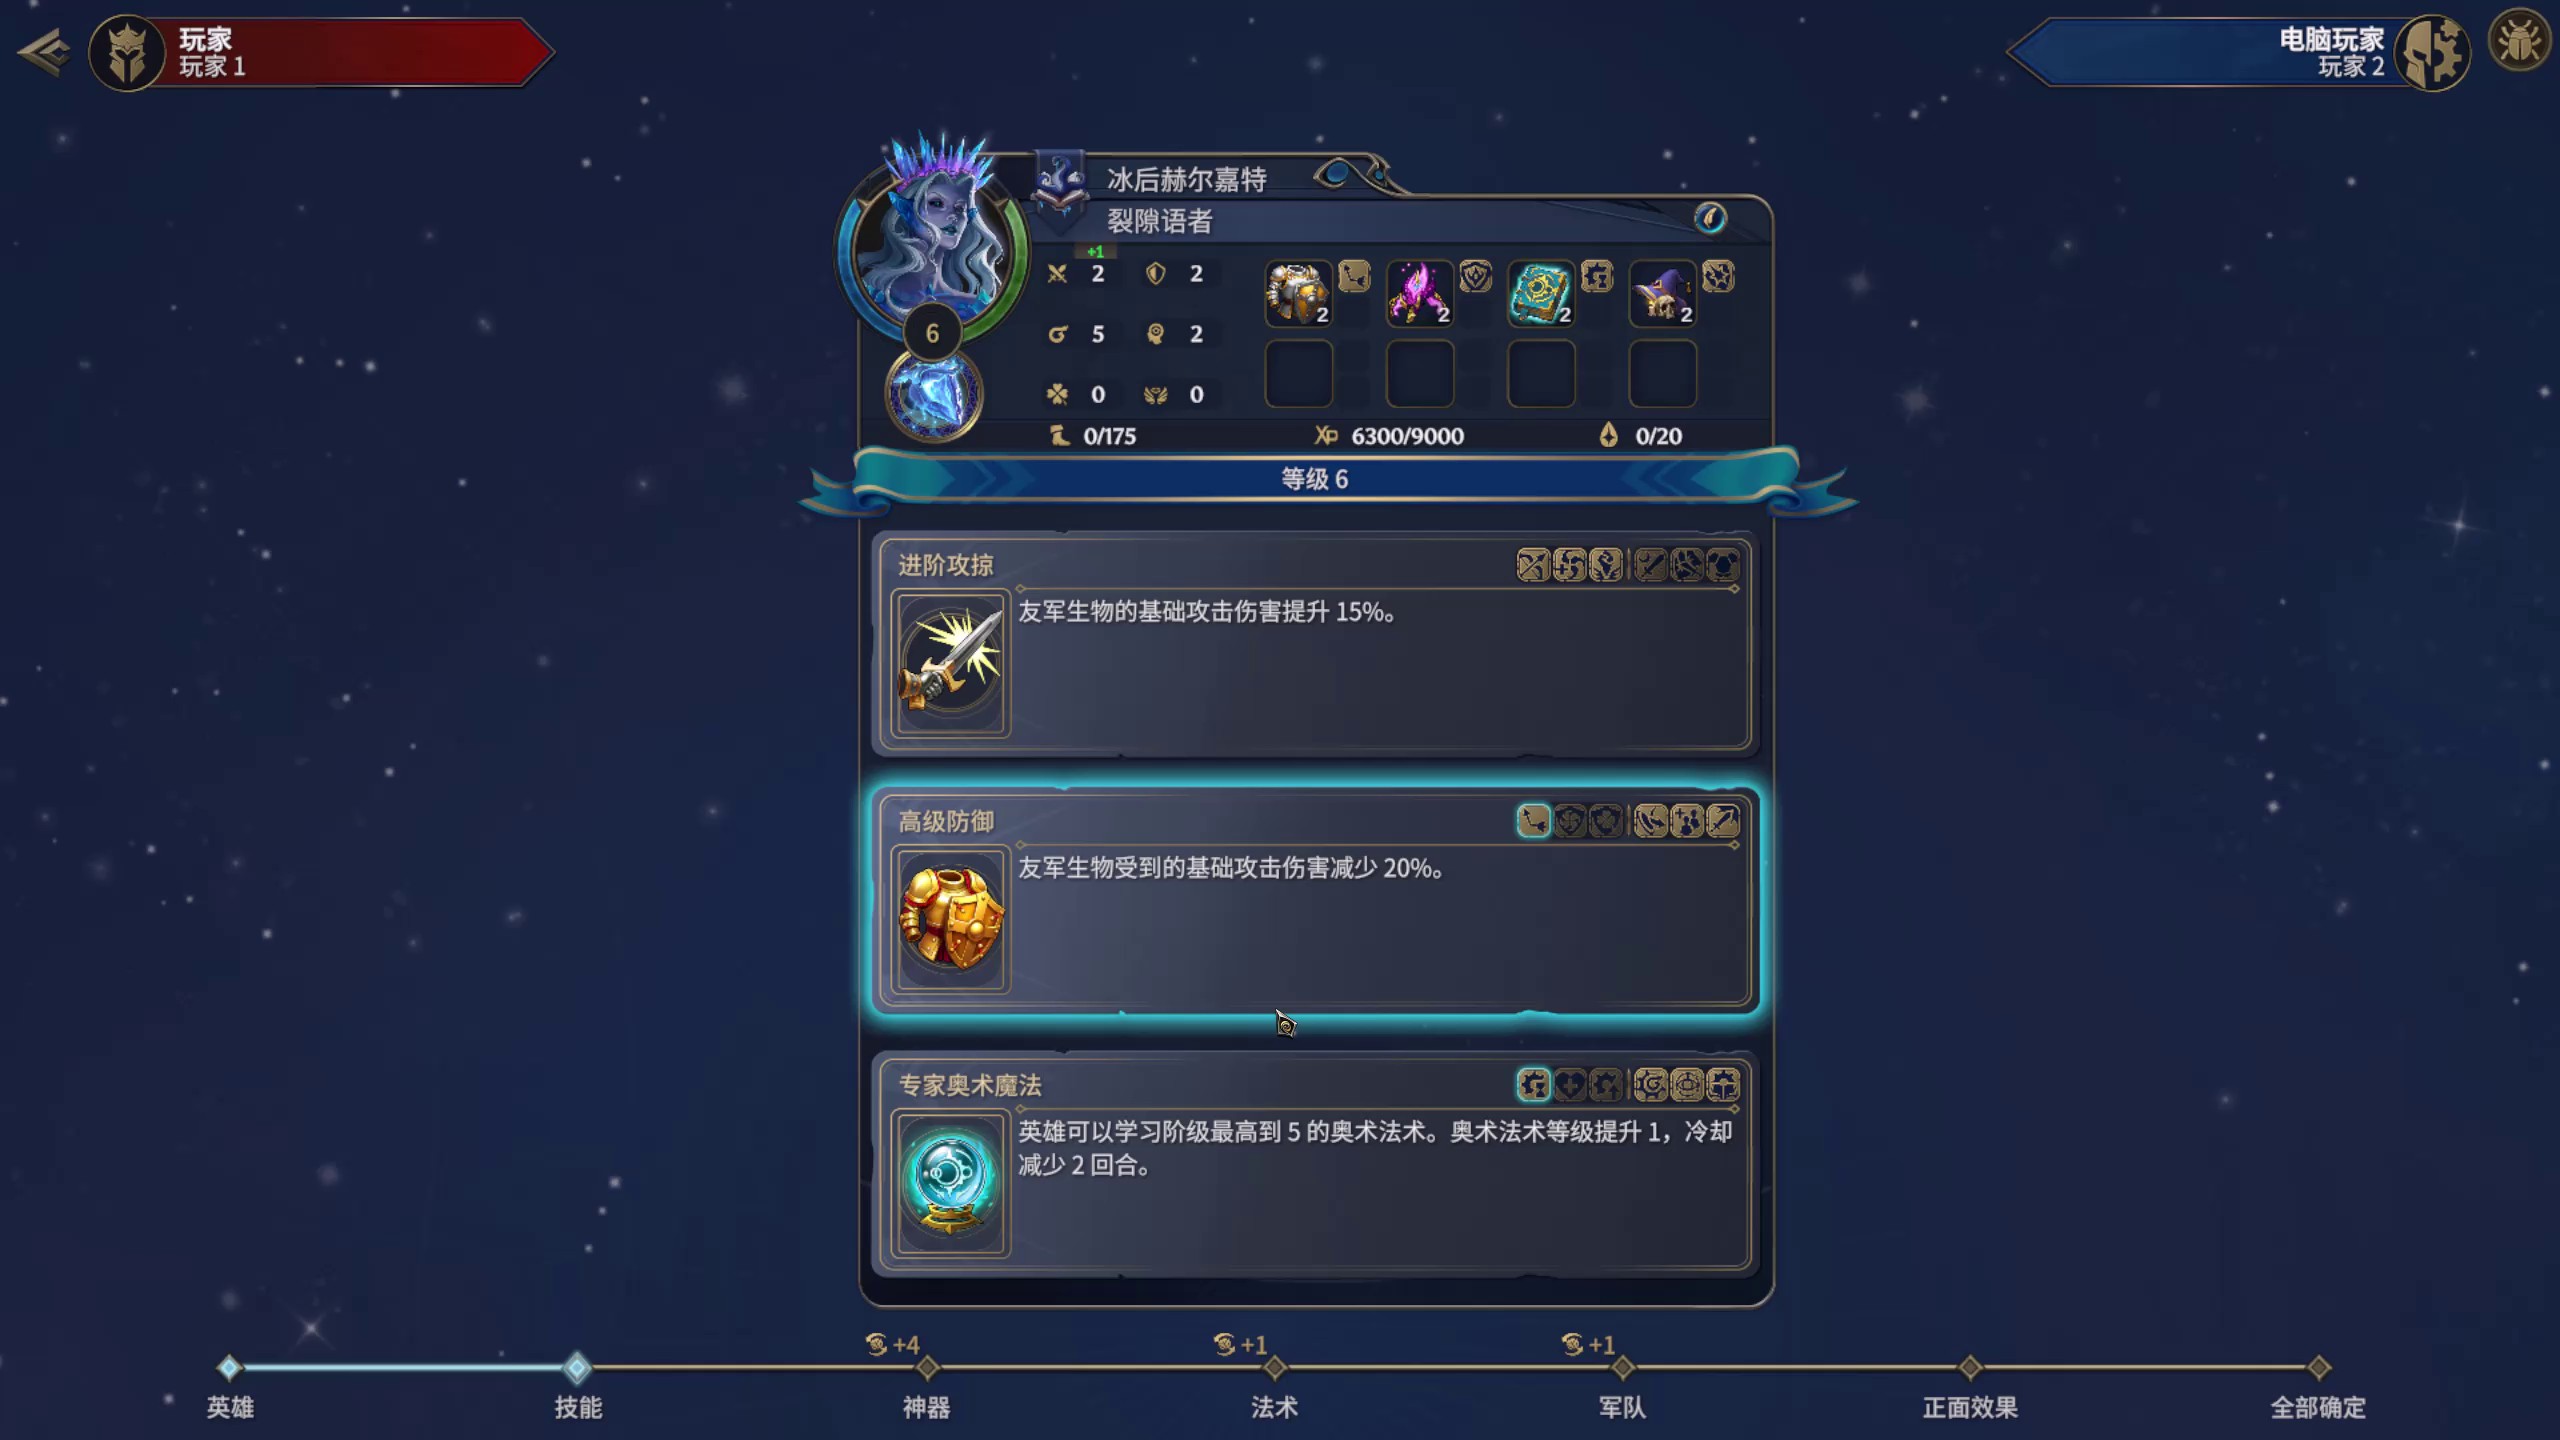
历史规则匹配文字:全部确定 · 进阶攻掠 · 高级防御 · 专家奥术魔法
查看历史预测与旧标签
历史 OCR 预测:选择主技能。当时参考标签:选择主技能(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 48 个 OCR 文本区域
电脑玩家 | 玩家 | 玩家2 | 玩家1 | 冰后赫尔嘉特 | 裂隙语者 | +1 | 2 | 2 . | 2 | X | 2 | 2 | 5 | Q | 2 | 0 | 丞 | 0 | 0 | Xp 6300/9000 | 0/20 | X 6300/9000 | 0/175 | 0 | 等级6 | 0601000 | 的 | 进阶攻掠 | 友军生物的基础攻击伤害提升15%。 | 0 一 0 的 | 高级防御 | 友军生物受到的基础攻击伤害减少20%。 | 1+01C0L | 专家奥术魔法 | 英雄可以学习阶级最高到5的奥术法术。奥术法术等级提升1,冷却 | 减少2回合。 | +1 | +4 | +1 | 0 | 英雄 | 技能 | 神器 | 军队 | 法术 | 正面效果 | 全部确定
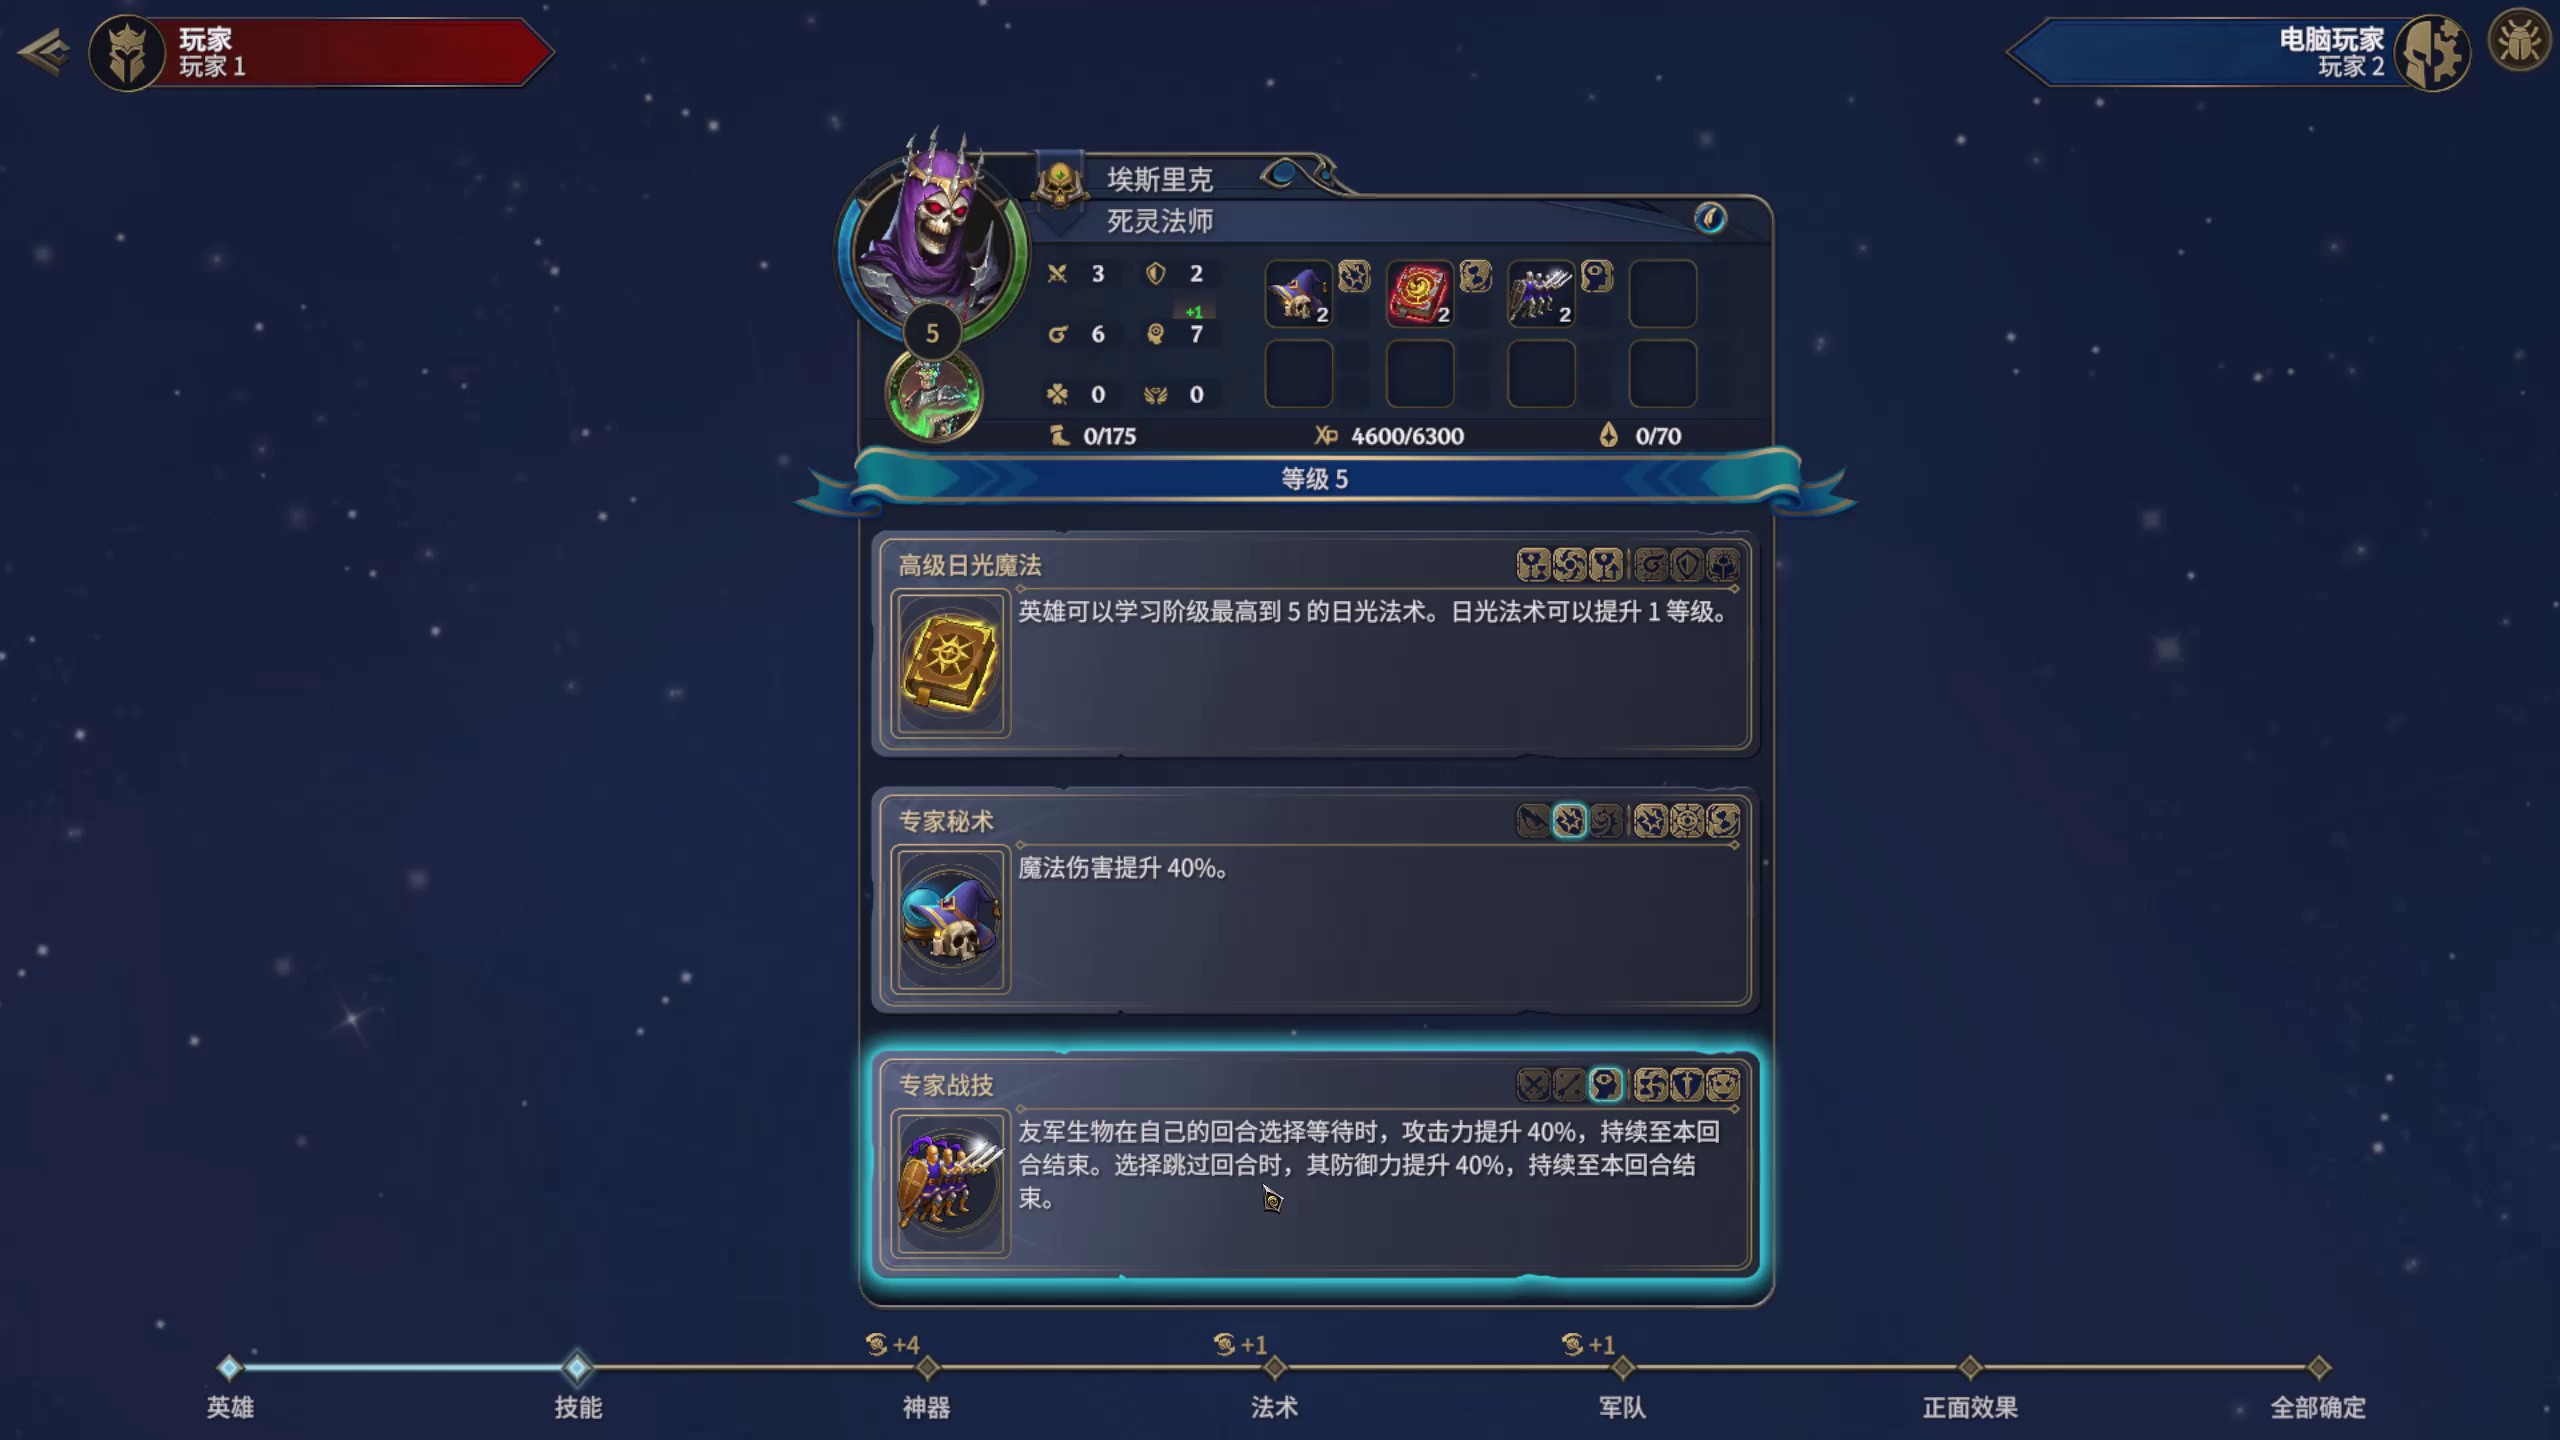
历史规则匹配文字:全部确定 · 高级日光魔法 · 专家秘术 · 专家战技
查看历史预测与旧标签
历史 OCR 预测:选择主技能。当时参考标签:选择主技能(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 41 个 OCR 文本区域
电脑玩家 | 玩家 | 玩家2 | 玩家1 | 埃斯里克 | 死灵法师 | 3 . 2 | 2 | 3 | +1 | 2 | 5 | 6 | 7 | 0 | 0 | 0 | X4600/6300 | 0/175 | 0/70 | 0 | 等级5 | BOLCOL | 高级日光魔法 | 英雄可以学习阶级最高到5的日光法术。日光法术可以提升1等级。 | 专家秘术 | 魔法伤害提升40%。 | 专家战技 | 友军生物在自己的回合选择等待时,攻击力提升40%,持续至本回 | 合结束。选择跳过回合时,其防御力提升40%,持续至本回合结 | 束。 | +1 | +1 | +4 | 英雄 | 技能 | 军队 | 法术 | 神器 | 正面效果 | 全部确定
选择子技能 · SUBSKILL_SELECTION 2 张示例
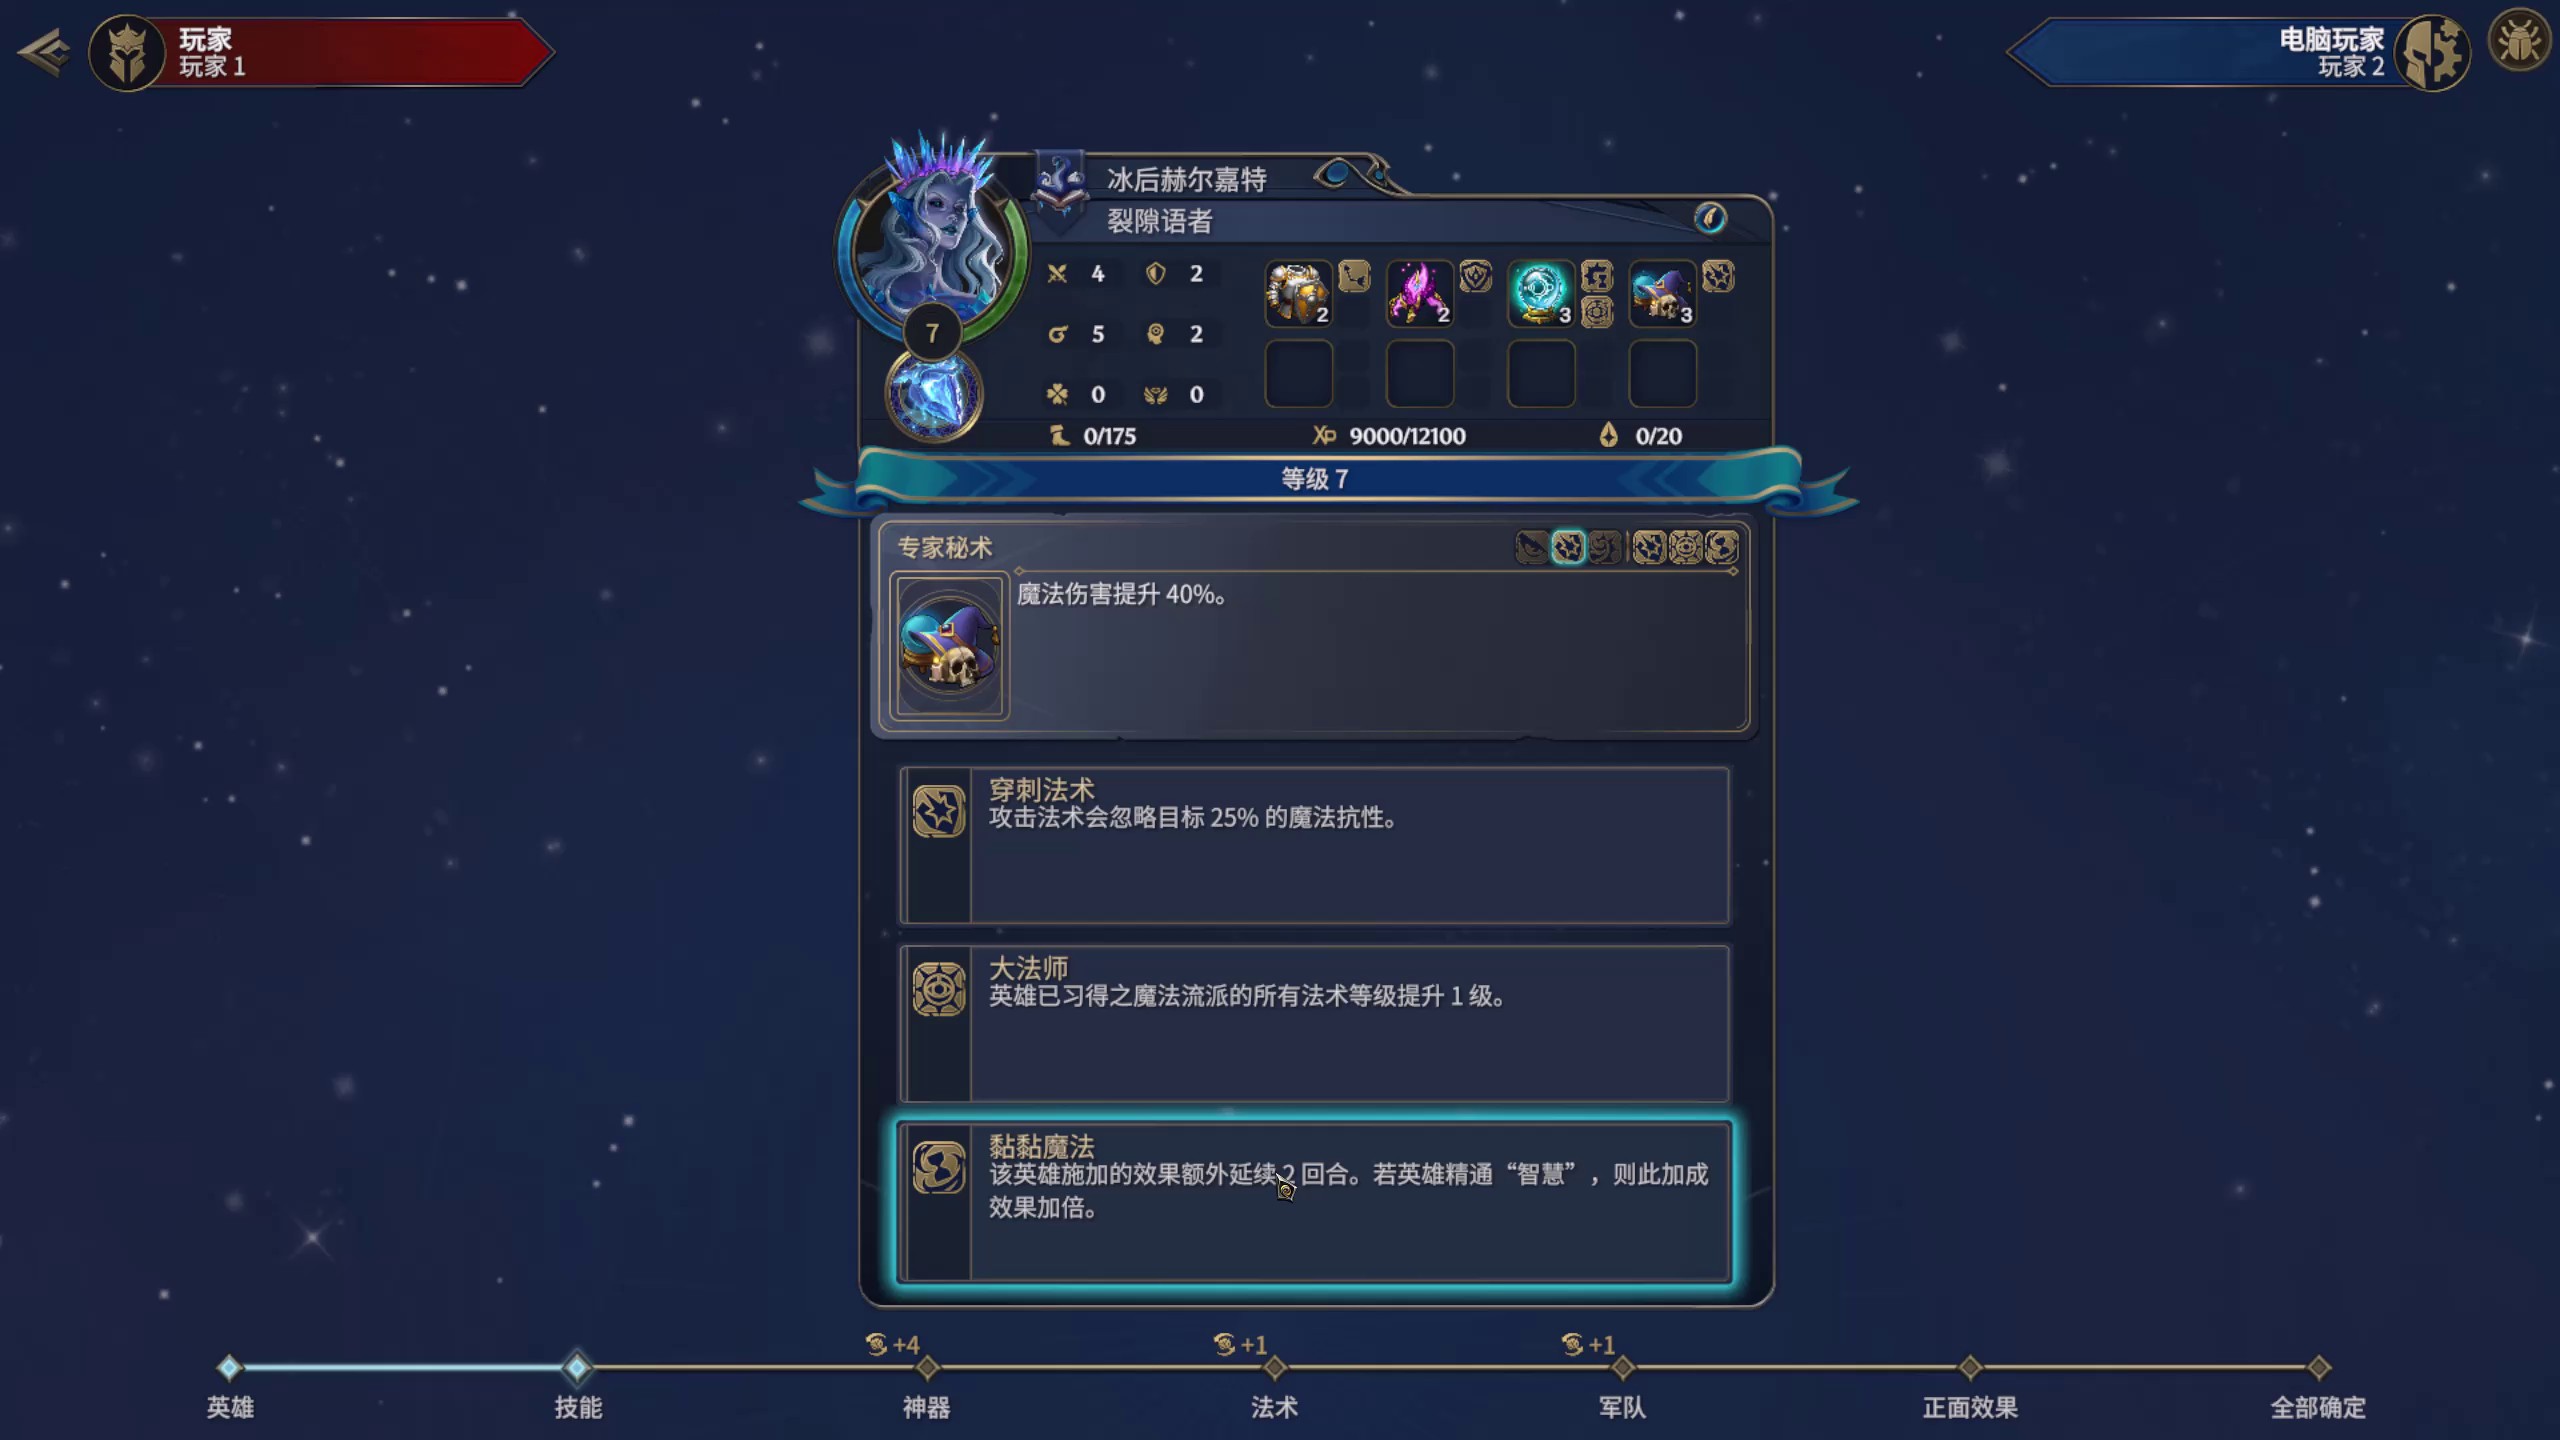
历史规则匹配文字:全部确定 · 专家秘术 · 穿刺法术 · 大法师 · 黏黏魔法
查看历史预测与旧标签
历史 OCR 预测:选择子技能。当时参考标签:选择子技能(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 45 个 OCR 文本区域
玩家 | 电脑玩家 | 玩家1 | 玩家2 | 冰后赫尔嘉特 | 裂隙语者 | 4 . | 2 | 2 | 3 | 5 | O | 2 | 0 | 丞 | 0 | 0 | 0/20 | XP 9000/12100 | 0/175 | 0 | 等级7 | 专家秘术 | 魔法伤害提升40%。 | 穿刺法术 | 攻击法术会忽略目标25%的魔法抗性。 | 大法师 | 0 | 英雄已习得之魔法流派的所有法术等级提升1级。 | 黏黏魔法 | “智慧”,则此加成 | 该英雄施加的效果额外延续2回合。若英雄精通 | 该英雄施加的效果额外延续2回合。若英雄精通“智慧”,则此加成 | 丿 | 效果加倍。 | +1 | +1 | +4 | 英雄 | 技能 | 法术 | 军队 | 神器 | 正面效果 | 全部确定
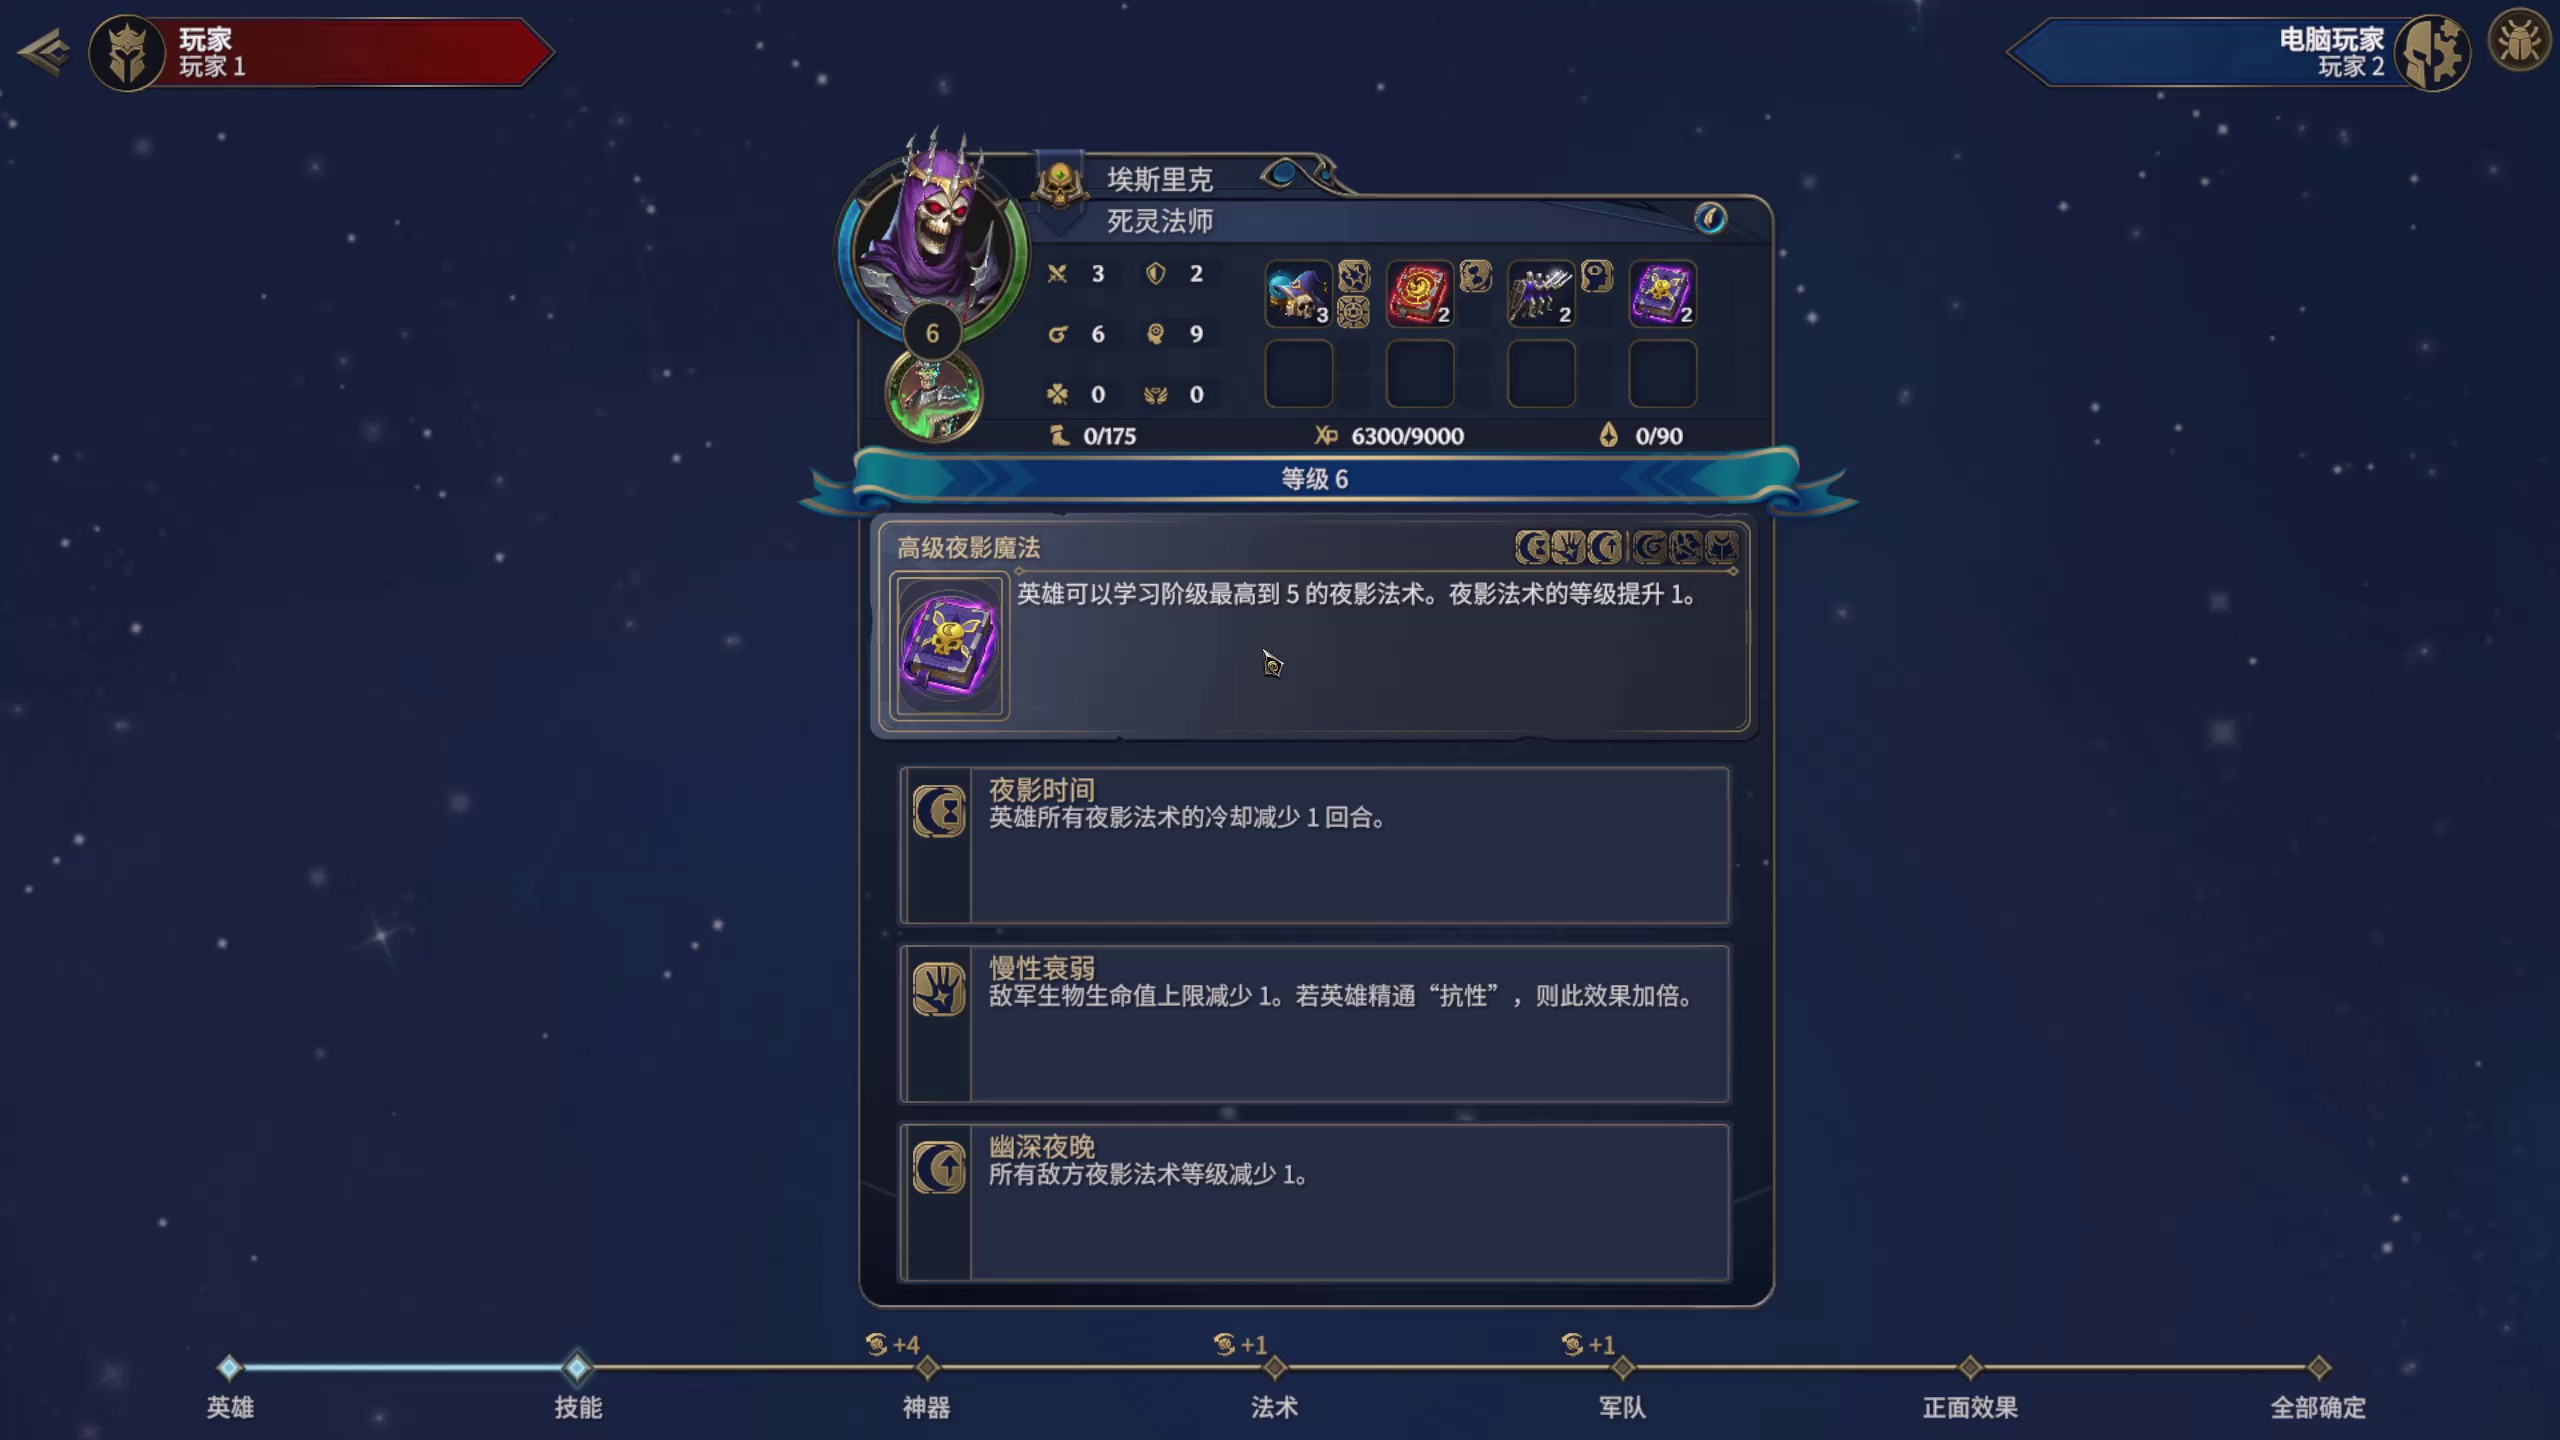
历史规则匹配文字:全部确定 · 高级夜影魔法 · 夜影时间 · 慢性衰弱 · 幽深夜晚
查看历史预测与旧标签
历史 OCR 预测:选择子技能。当时参考标签:选择子技能(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 48 个 OCR 文本区域
电脑玩家 | 玩家 | 玩家2 | 玩家1 | 埃斯里克 | 死灵法师 | 3 | 3 . | 2 | 2 | 3 | 6 | 6 | O | 9 | 0 | 丞 | 0 | 0 | XP 6300/9000 | X 6300/9000 | 6 | 0/175 | 0/90 | 等级6 | COCCEL | 00 | 高级夜影魔法 | 英雄可以学习阶级最高到5的夜影法术。夜影法术的等级提升1。 | 夜影时间 | 英雄所有夜影法术的冷却减少1回合。 | 慢性衰弱 | “抗性”,则此效果加倍。 | 敌军生物生命值上限减少1。若英雄精通 | 敌军生物生命值上限减少1。若英雄精通“抗性”,则此效果加倍。 | 々 | 幽深夜晚 | 所有敌方夜影法术等级减少1。 | +1 | +1 | +4 | 英雄 | 技能 | 神器 | 法术 | 军队 | 正面效果 | 全部确定
选择宝物 · ARTIFACT_SELECTION 2 张示例
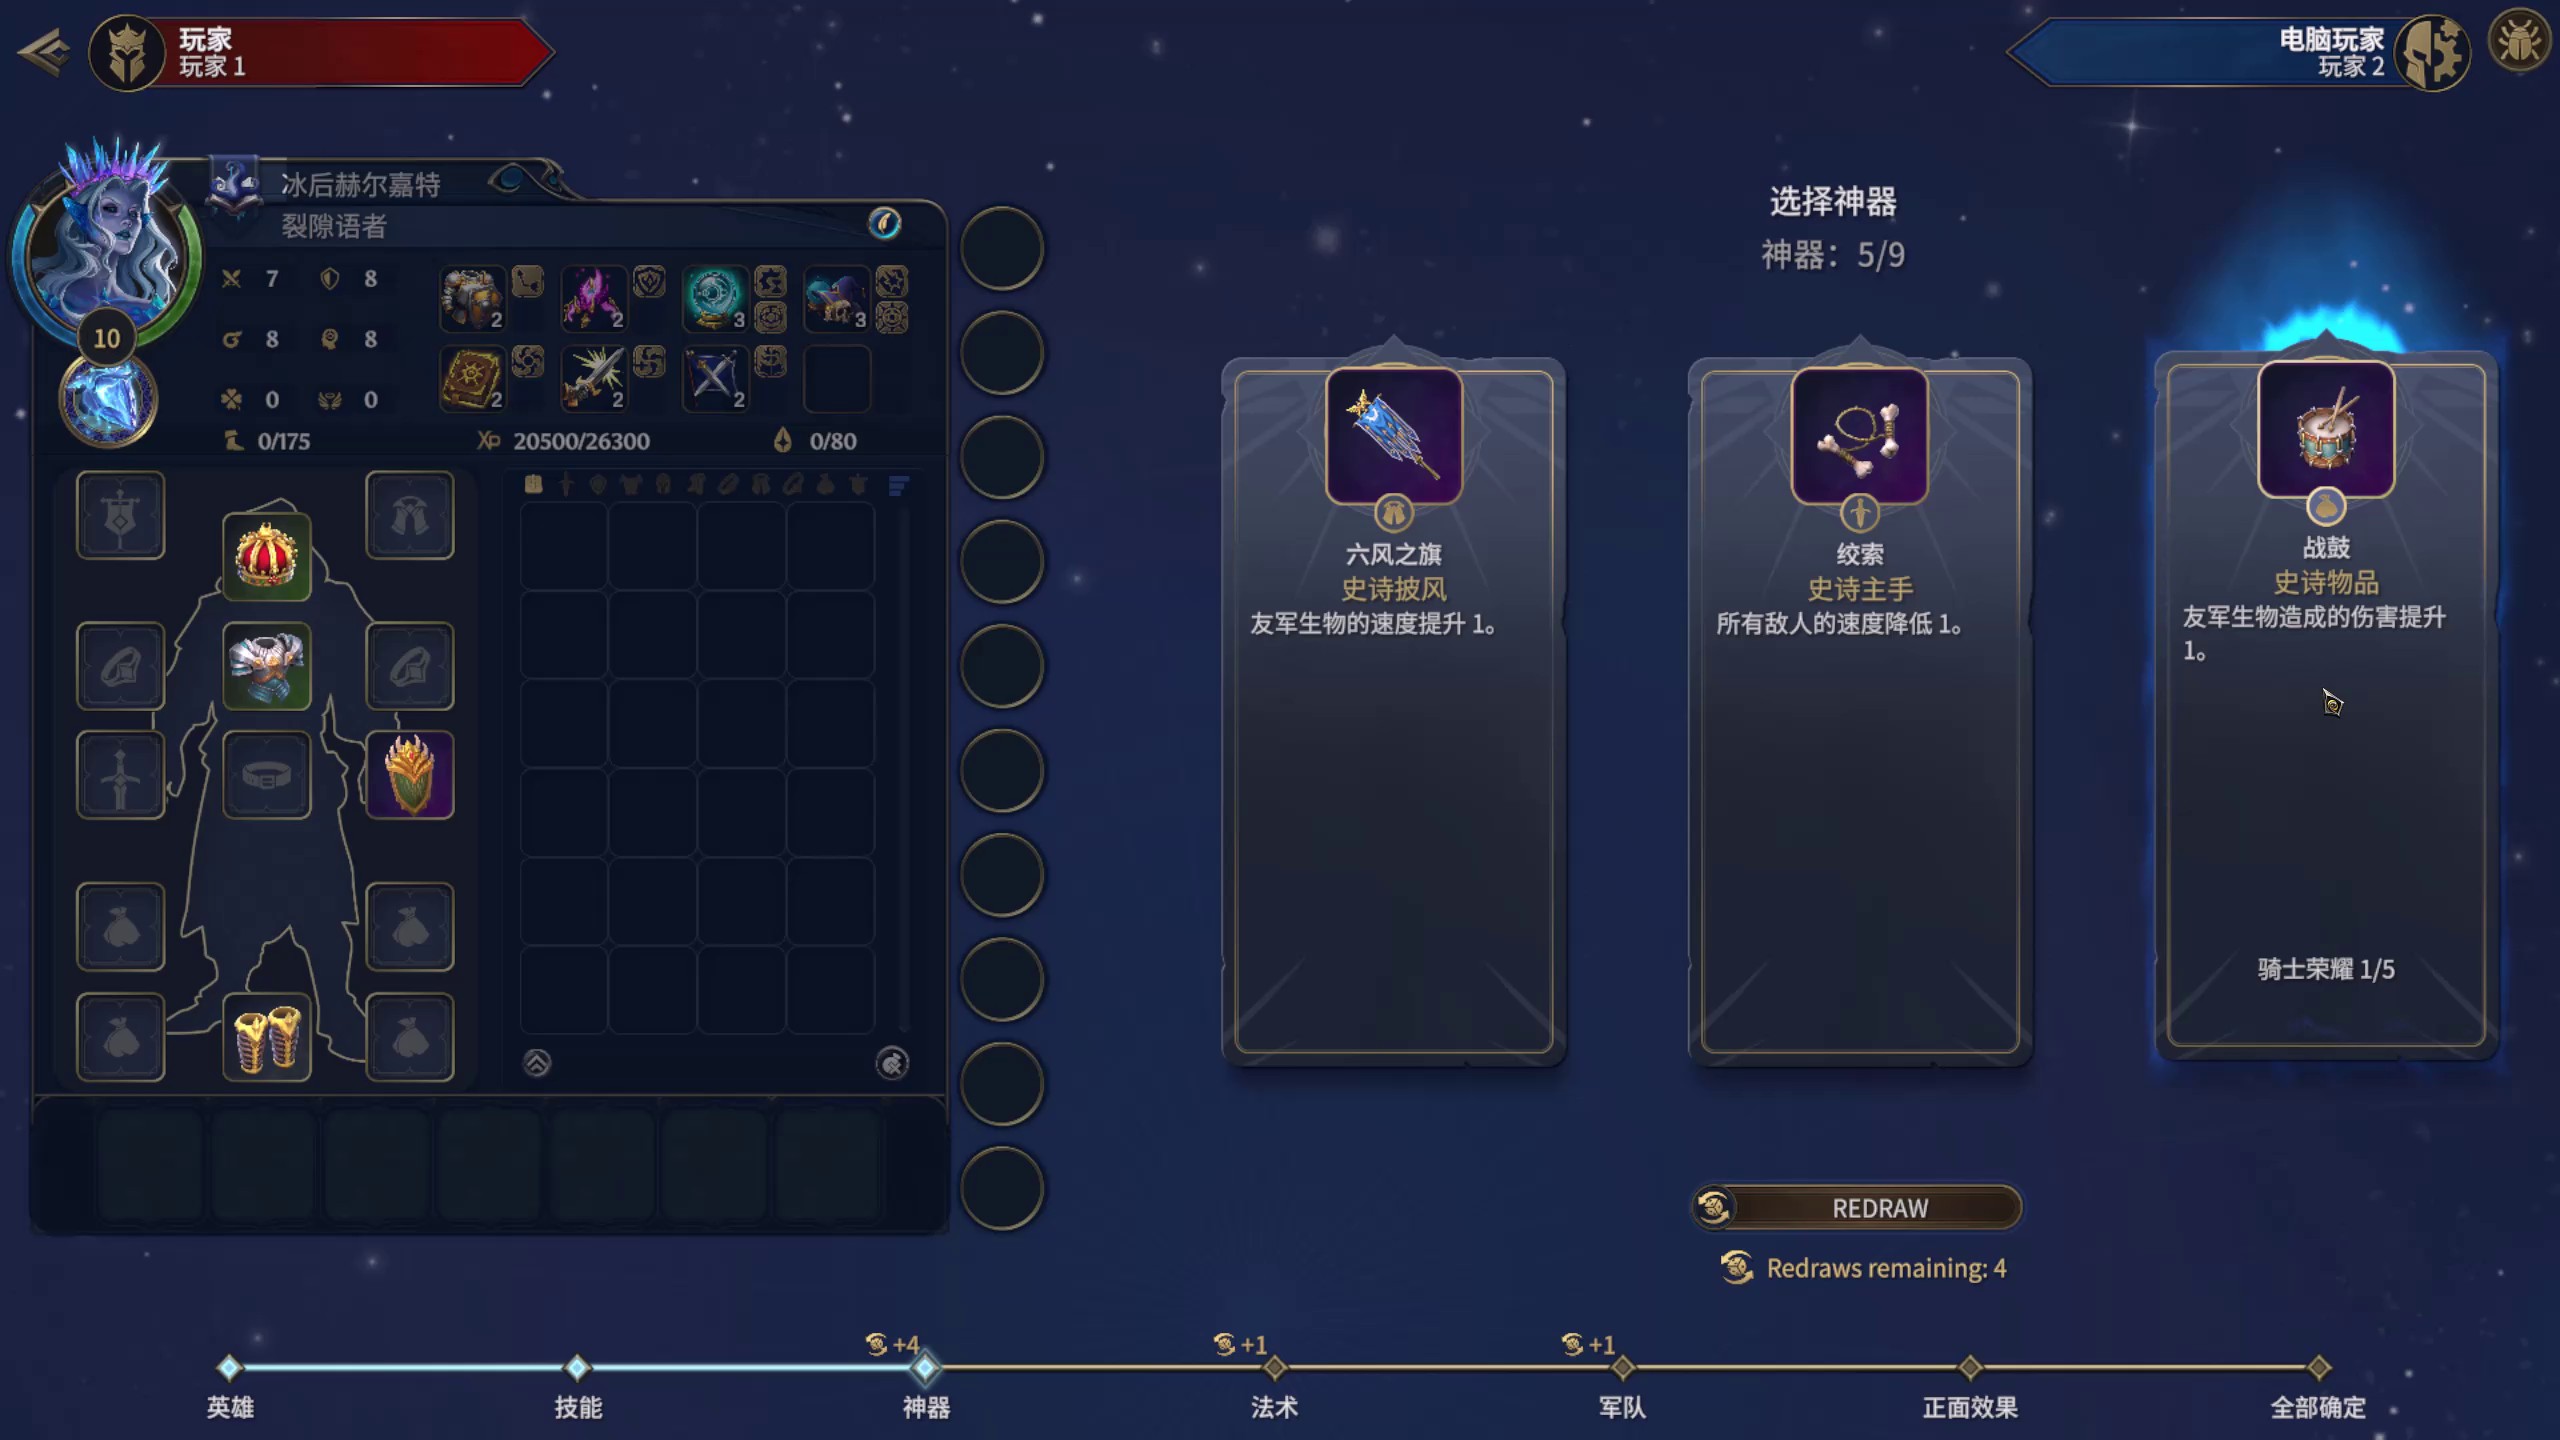
历史规则匹配文字:选择神器
查看历史预测与旧标签
历史 OCR 预测:选择宝物。当时参考标签:选择宝物(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 48 个 OCR 文本区域
电脑玩家 | 玩家 | 玩家1 | 玩家2 | 冰后赫尔嘉特 | 、 | 选择神器 | 、 | 、一 | 裂隙语者 | 神器:5/9 | 0 | . 8 | 8 | 7 | 3 | 10 | 8 | 8 | 0 | 2 | X 20500/26300 | 0/175 | 0/80 | 战鼓 | 绞索 | 六风之旗 | 史诗物品 | 史诗披风 | 史诗主手 | 友军生物造成的伤害提升 | 友军生物的速度提升1。 | 所有敌人的速度降低1。 | 1。 | 骑士荣耀1/5 | 0 | REDRAW | Redraws remaining: 4 | +1 | +1 | +4 | 技能 | 英雄 | 神器 | 法术 | 军队 | 正面效果 | 全部确定
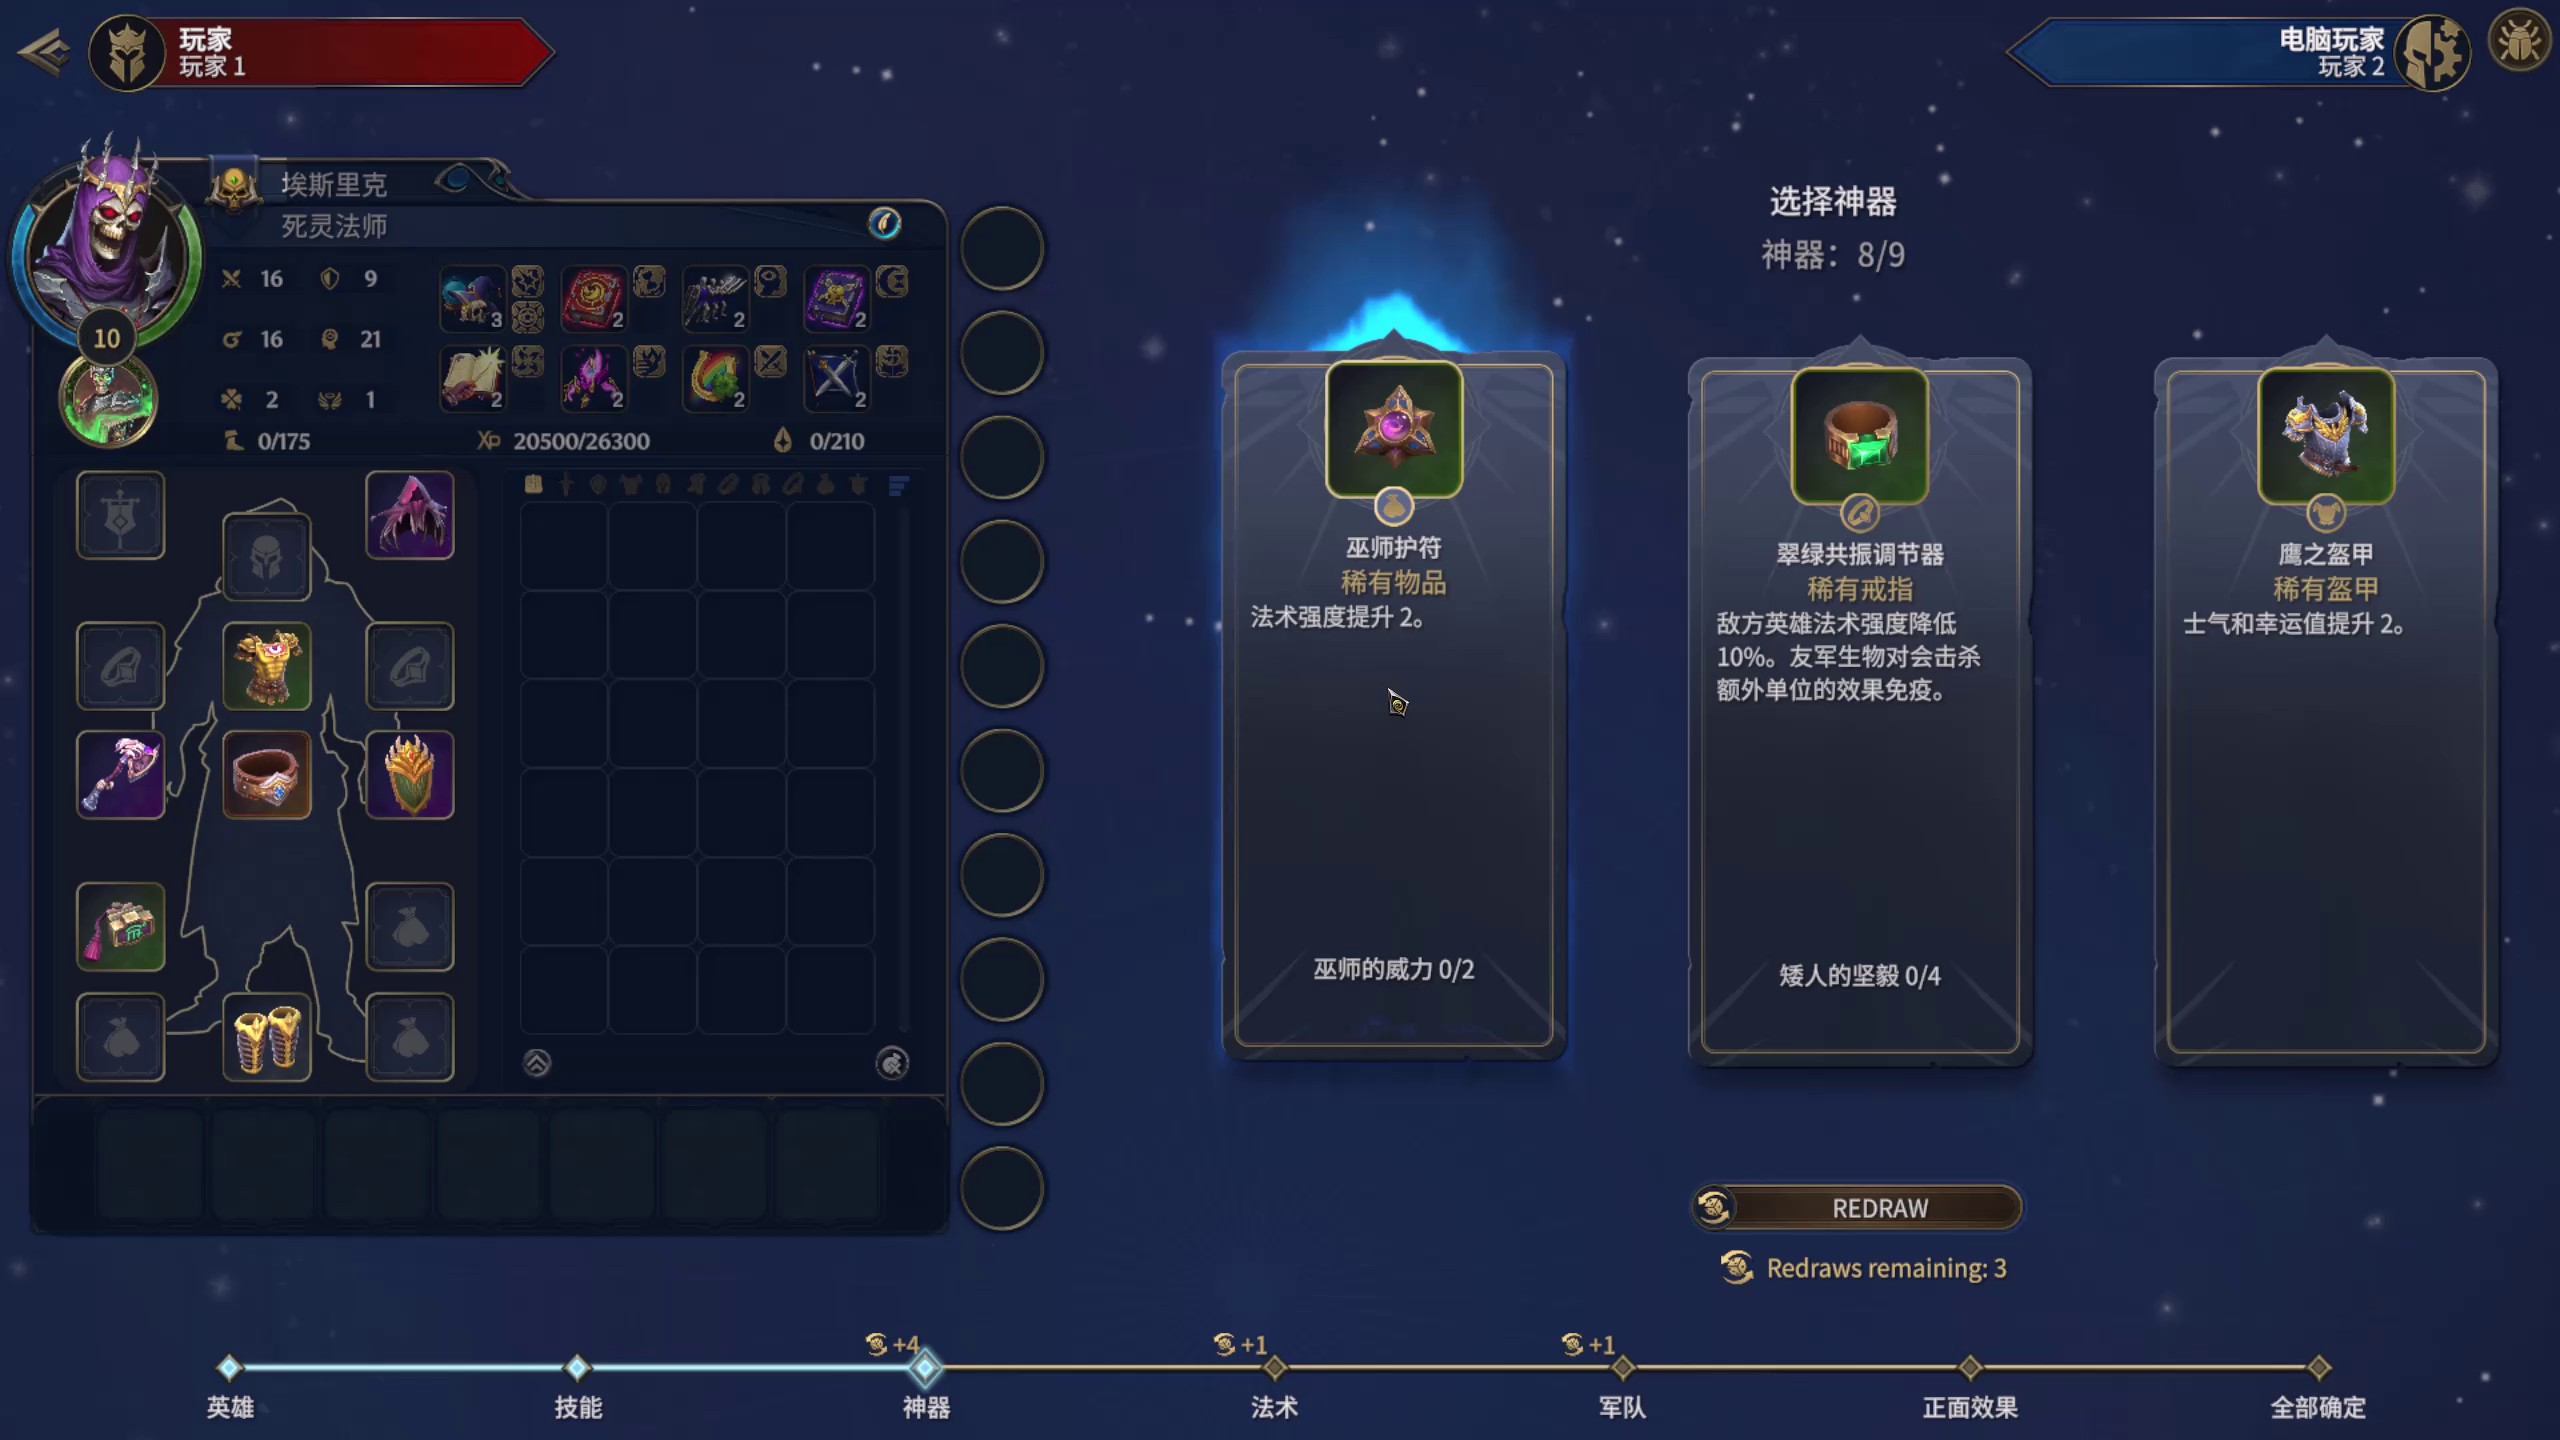
历史规则匹配文字:选择神器
查看历史预测与旧标签
历史 OCR 预测:选择宝物。当时参考标签:选择宝物(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 49 个 OCR 文本区域
玩家 | 电脑玩家 | 玩家1 | 玩家2 | 埃斯里克 | 选择神器 | 死灵法师 | 神器:8/9 | 16 | 16 . 9 | 9 | 2 | 10 | 16 | 21 | 0 | 2 | 2 | Xp 20500/26300 | 0/175 | X 20500/26300 | 0 | 0/210 | 巫师护符 | 鹰之盔甲 | 翠绿共振调节器 | 稀有物品 | 稀有戒指 | 稀有盔甲 | 法术强度提升2。 | 敌方英雄法术强度降低 | 士气和幸运值提升2。 | 10%。友军生物对会击杀 | 额外单位的效果免疫。 | 命 | 巫师的威力0/2 | 矮人的坚毅0/4 | 0 | REDRAW | Redraws remaining: 3 | +1 | +1 | 英雄 | 技能 | 法术 | 军队 | 全部确定 | 神器 | 正面效果
选择法术 · SPELL_SELECTION 2 张示例
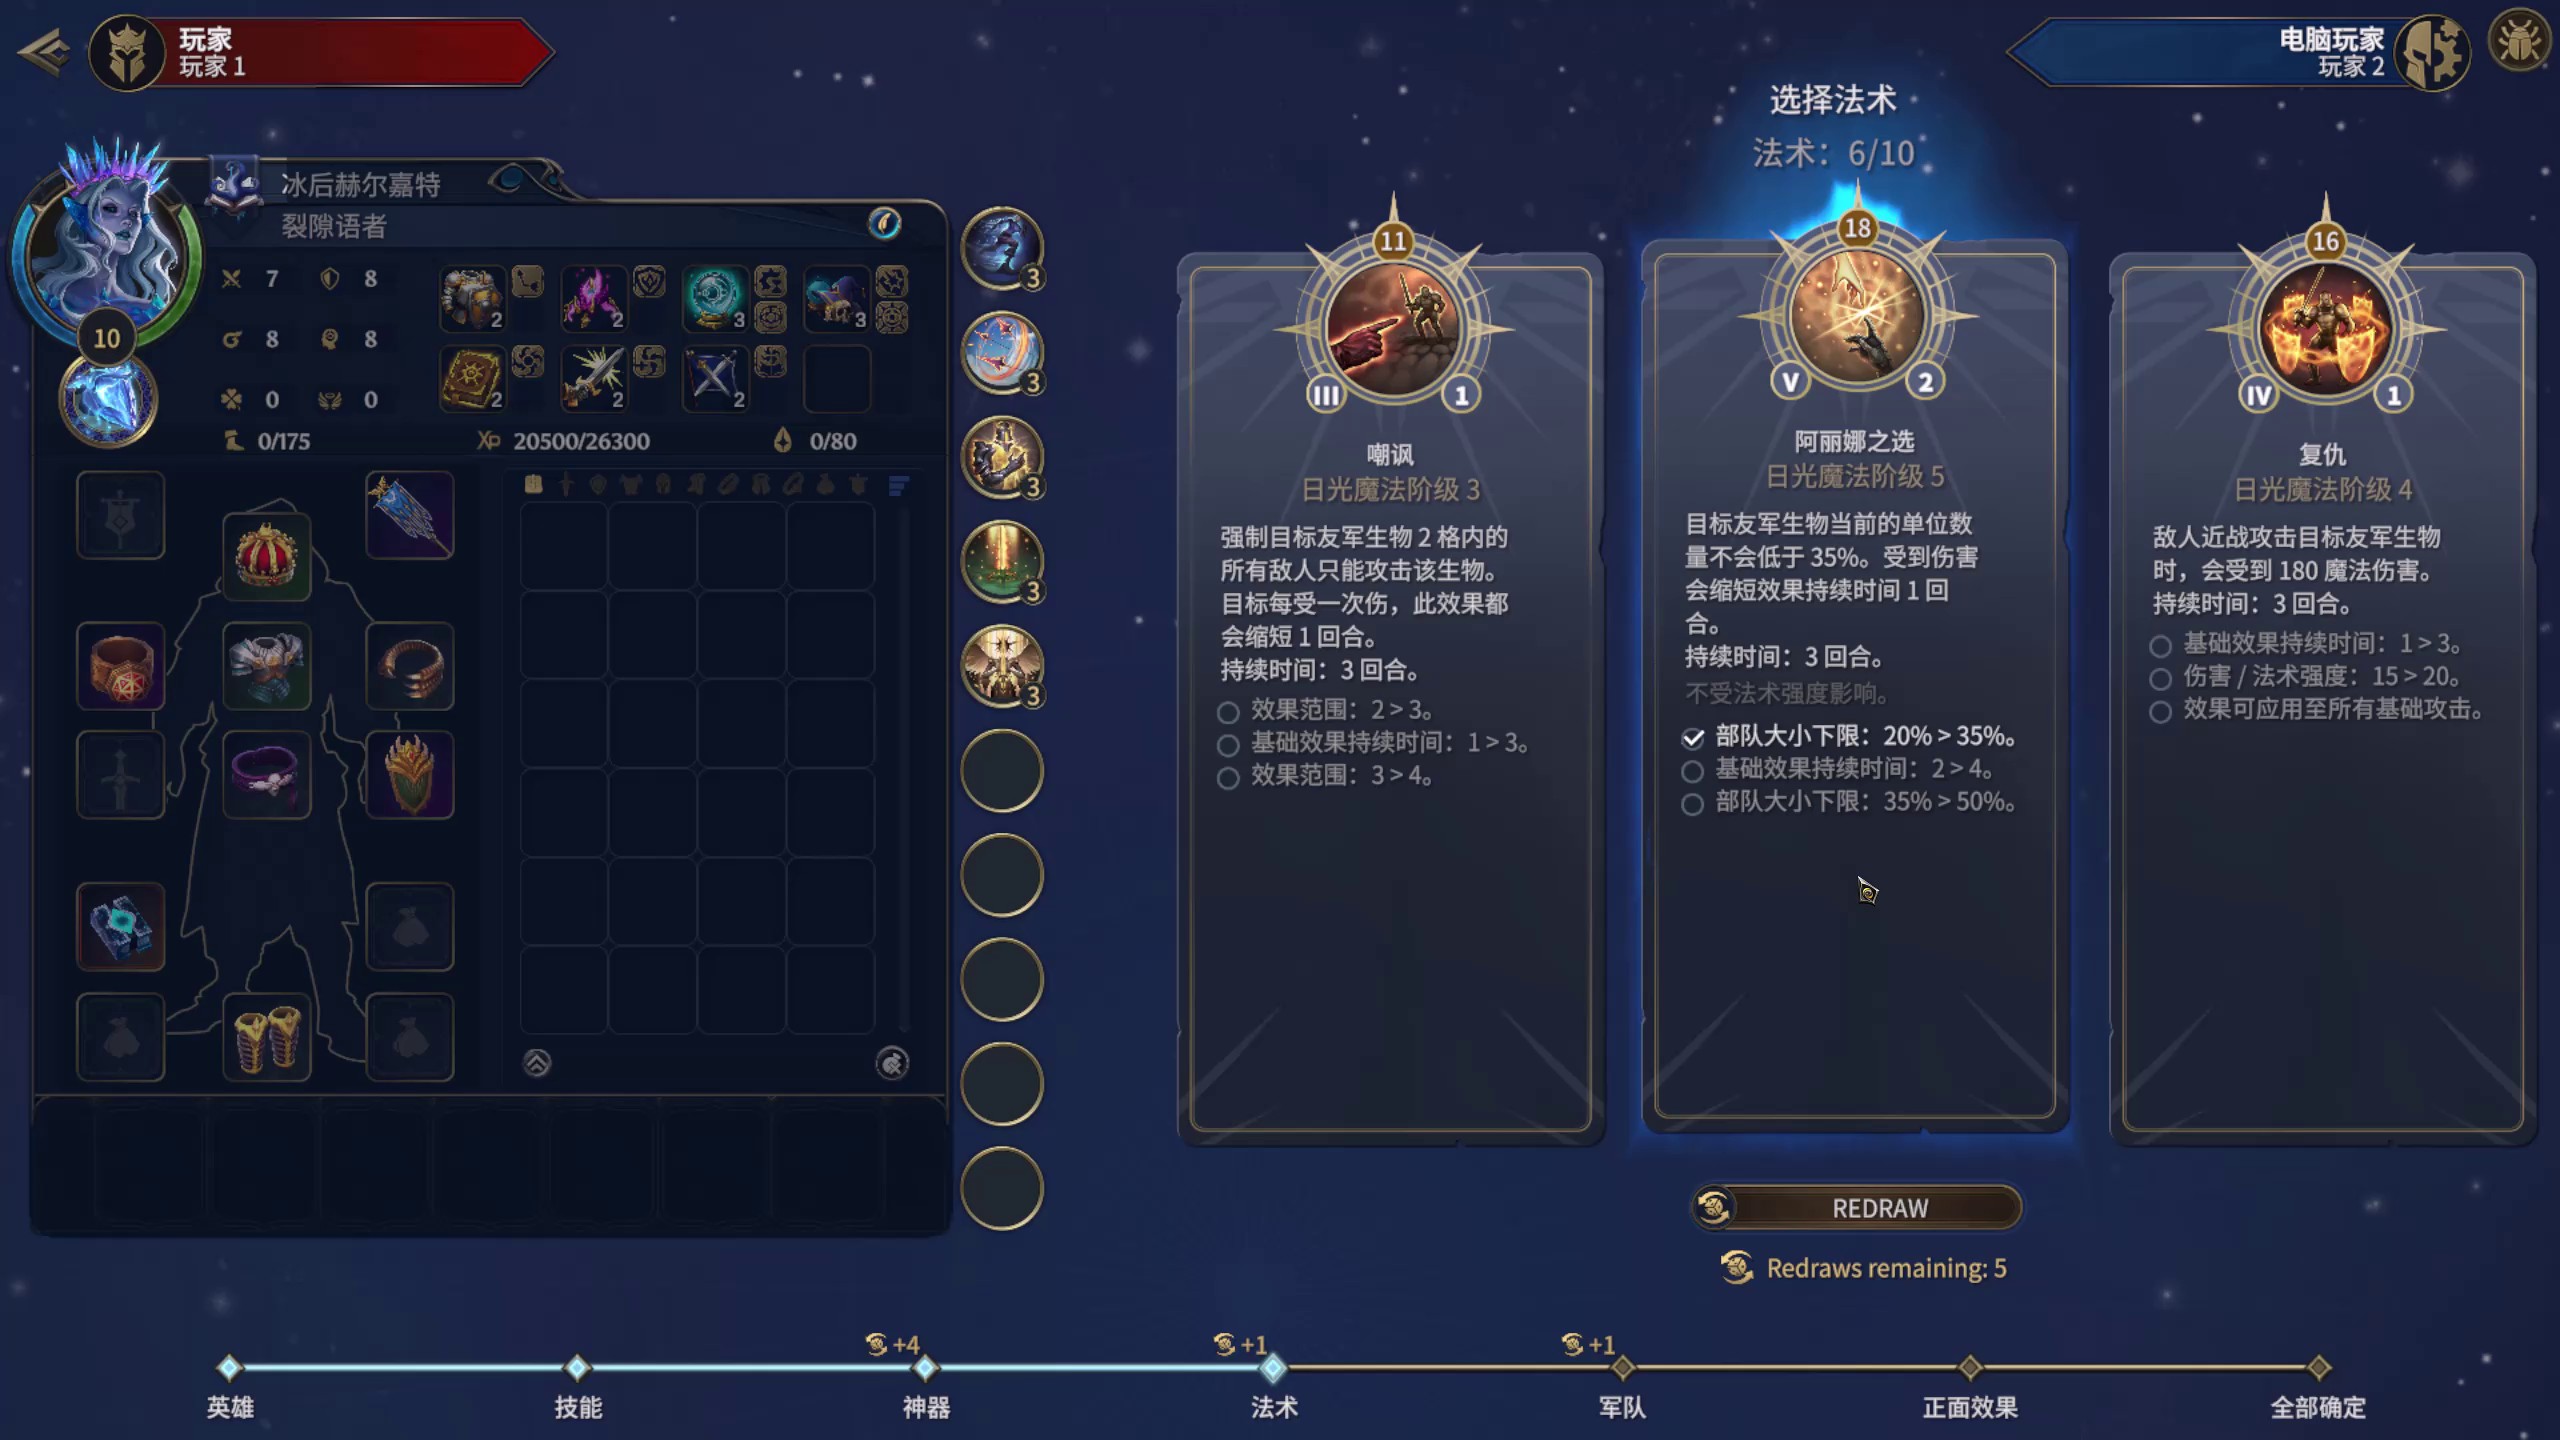
历史规则匹配文字:选择法术
查看历史预测与旧标签
历史 OCR 预测:选择法术。当时参考标签:选择法术(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 78 个 OCR 文本区域
玩家 | 电脑玩家 | 玩家1 | 玩家2 | 选择法术 | 法术:6/10 | 冰后赫尔嘉特 | 裂隙语者 | 18 | 11 | 16 | 3 | 0 | 8 | 7 | 0 | 3 | 3 | 10 | 8 | 8 | 3 | 2 | IV | 1 | 1 | 0 | 2 | 2 | 阿丽娜之选 | Xp 20500/26300 | X 20500/26300 | 0/80 | 0/175 | 复仇 | 嘲讽 | 日光魔法阶级5 | 3 | 日光魔法阶级3 | 日光魔法阶级4 | 目标友军生物当前的单位数 | 强制目标友军生物2格内的 | 敌人近战攻击目标友军生物 | 量不会低于35%。受到伤害 | 时,会受到180魔法伤害。 | 所有敌人只能攻击该生物。 | 会缩短效果持续时间1回 | 3 | 目标每受一次伤,此效果都 | 持续时间:3回合。 | 合。 | 会缩短1回合。 | 基础效果持续时间:1>3。 | 持续时间:3回合。 | 持续时间:3回合。 | 伤害/法术强度:15>20。 | 不受法术强度影响。 | 3 | 效果范围:2>3。 | 效果可应用至所有基础攻击。 | 部队大小下限:20%>35%。 | 基础效果持续时间:1>3。 | 基础效果持续时间:2>4。 | 效果范围:3>4。 | 部队大小下限:35%>50%。 | 0 | REDRAW | Redraws remaining: 5 | +1 | +1 | +4 | 技能 | 英雄 | 神器 | 法术 | 军队 | 全部确定 | 正面效果
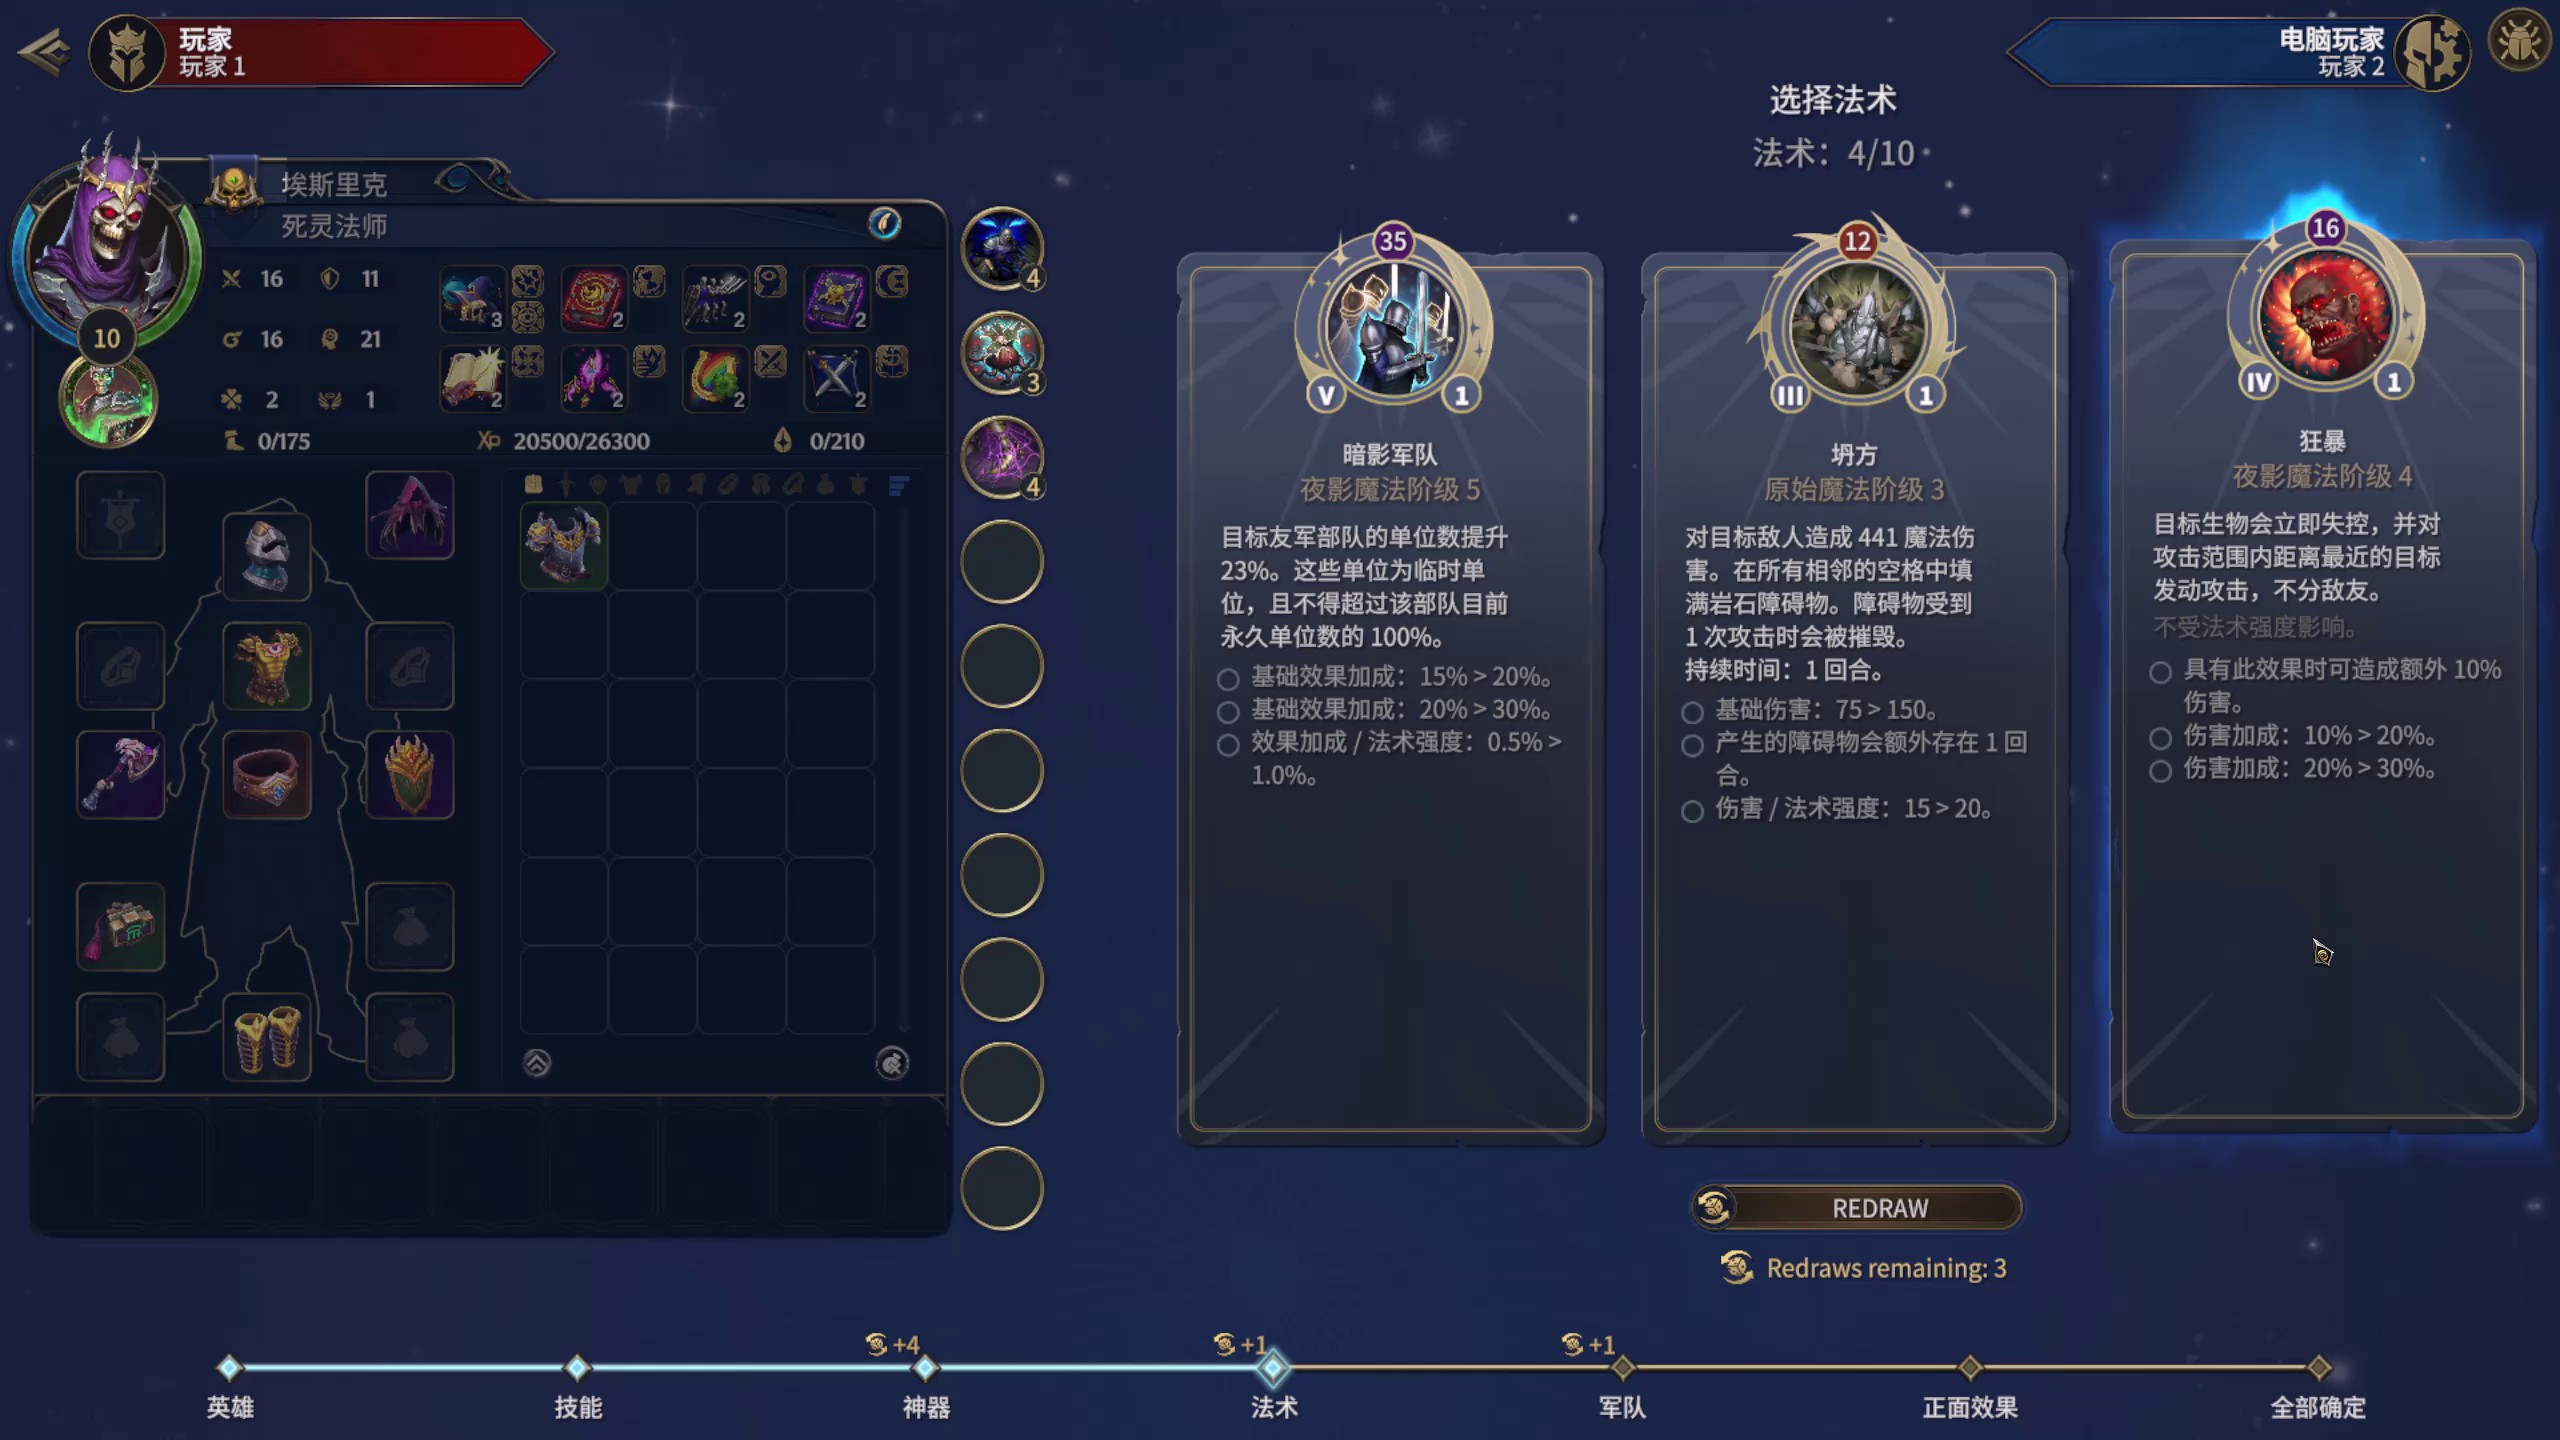
历史规则匹配文字:选择法术
查看历史预测与旧标签
历史 OCR 预测:选择法术。当时参考标签:选择法术(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 82 个 OCR 文本区域
玩家 | 电脑玩家 | 玩家1 | 玩家2 | 选择法术 | 法术:4/10 | 埃斯里克 | 死灵法师 | 16 | 35 | 12 | 0 | 16 | 11 | 16 | 4 | 143 | 3 | 2 | 10 | G 16 | 16 | 21 | 0 | 3 | IV | 1 | 1 | 1 | 2 | 2 | 2 | 狂暴 | X 20500/26300 | 0 | 0/210 | 0/175 | 坍方 | 暗影军队 | 夜影魔法阶级4 | 夜影魔法阶级5 | 0 | 原始魔法阶级3 | 0 | 目标生物会立即失控,并对 | 目标友军部队的单位数提升 | 对目标敌人造成441魔法伤 | 攻击范围内距离最近的目标 | 23%。这些单位为临时单 | 害。在所有相邻的空格中填 | 发动攻击,不分敌友。 | 位,且不得超过该部队目前 | 满岩石障碍物。障碍物受到 | 不受法术强度影响。 | 永久单位数的100%。 | 1 次攻击时会被摧毁。 | 具有此效果时可造成额外10% | 持续时间:1回合。 | 基础效果加成:15%>20%。 | 伤害。 | 基础效果加成:20%>30%。 | 基础伤害:75>150。 | 伤害加成:10%>20%。 | 效果加成/法术强度:0.5%> | 产生的障碍物会额外存在1回 | 伤害加成:20%>30%。 | 合。 | 1.0%。 | 伤害/法术强度:15>20。 | 0 | REDRAW | Redraws remaining: 3 | +1 | +1 | +4 | 技能 | 英雄 | 神器 | 法术 | 军队 | 正面效果 | 全部确定
选择生物 · CREATURE_SELECTION 2 张示例
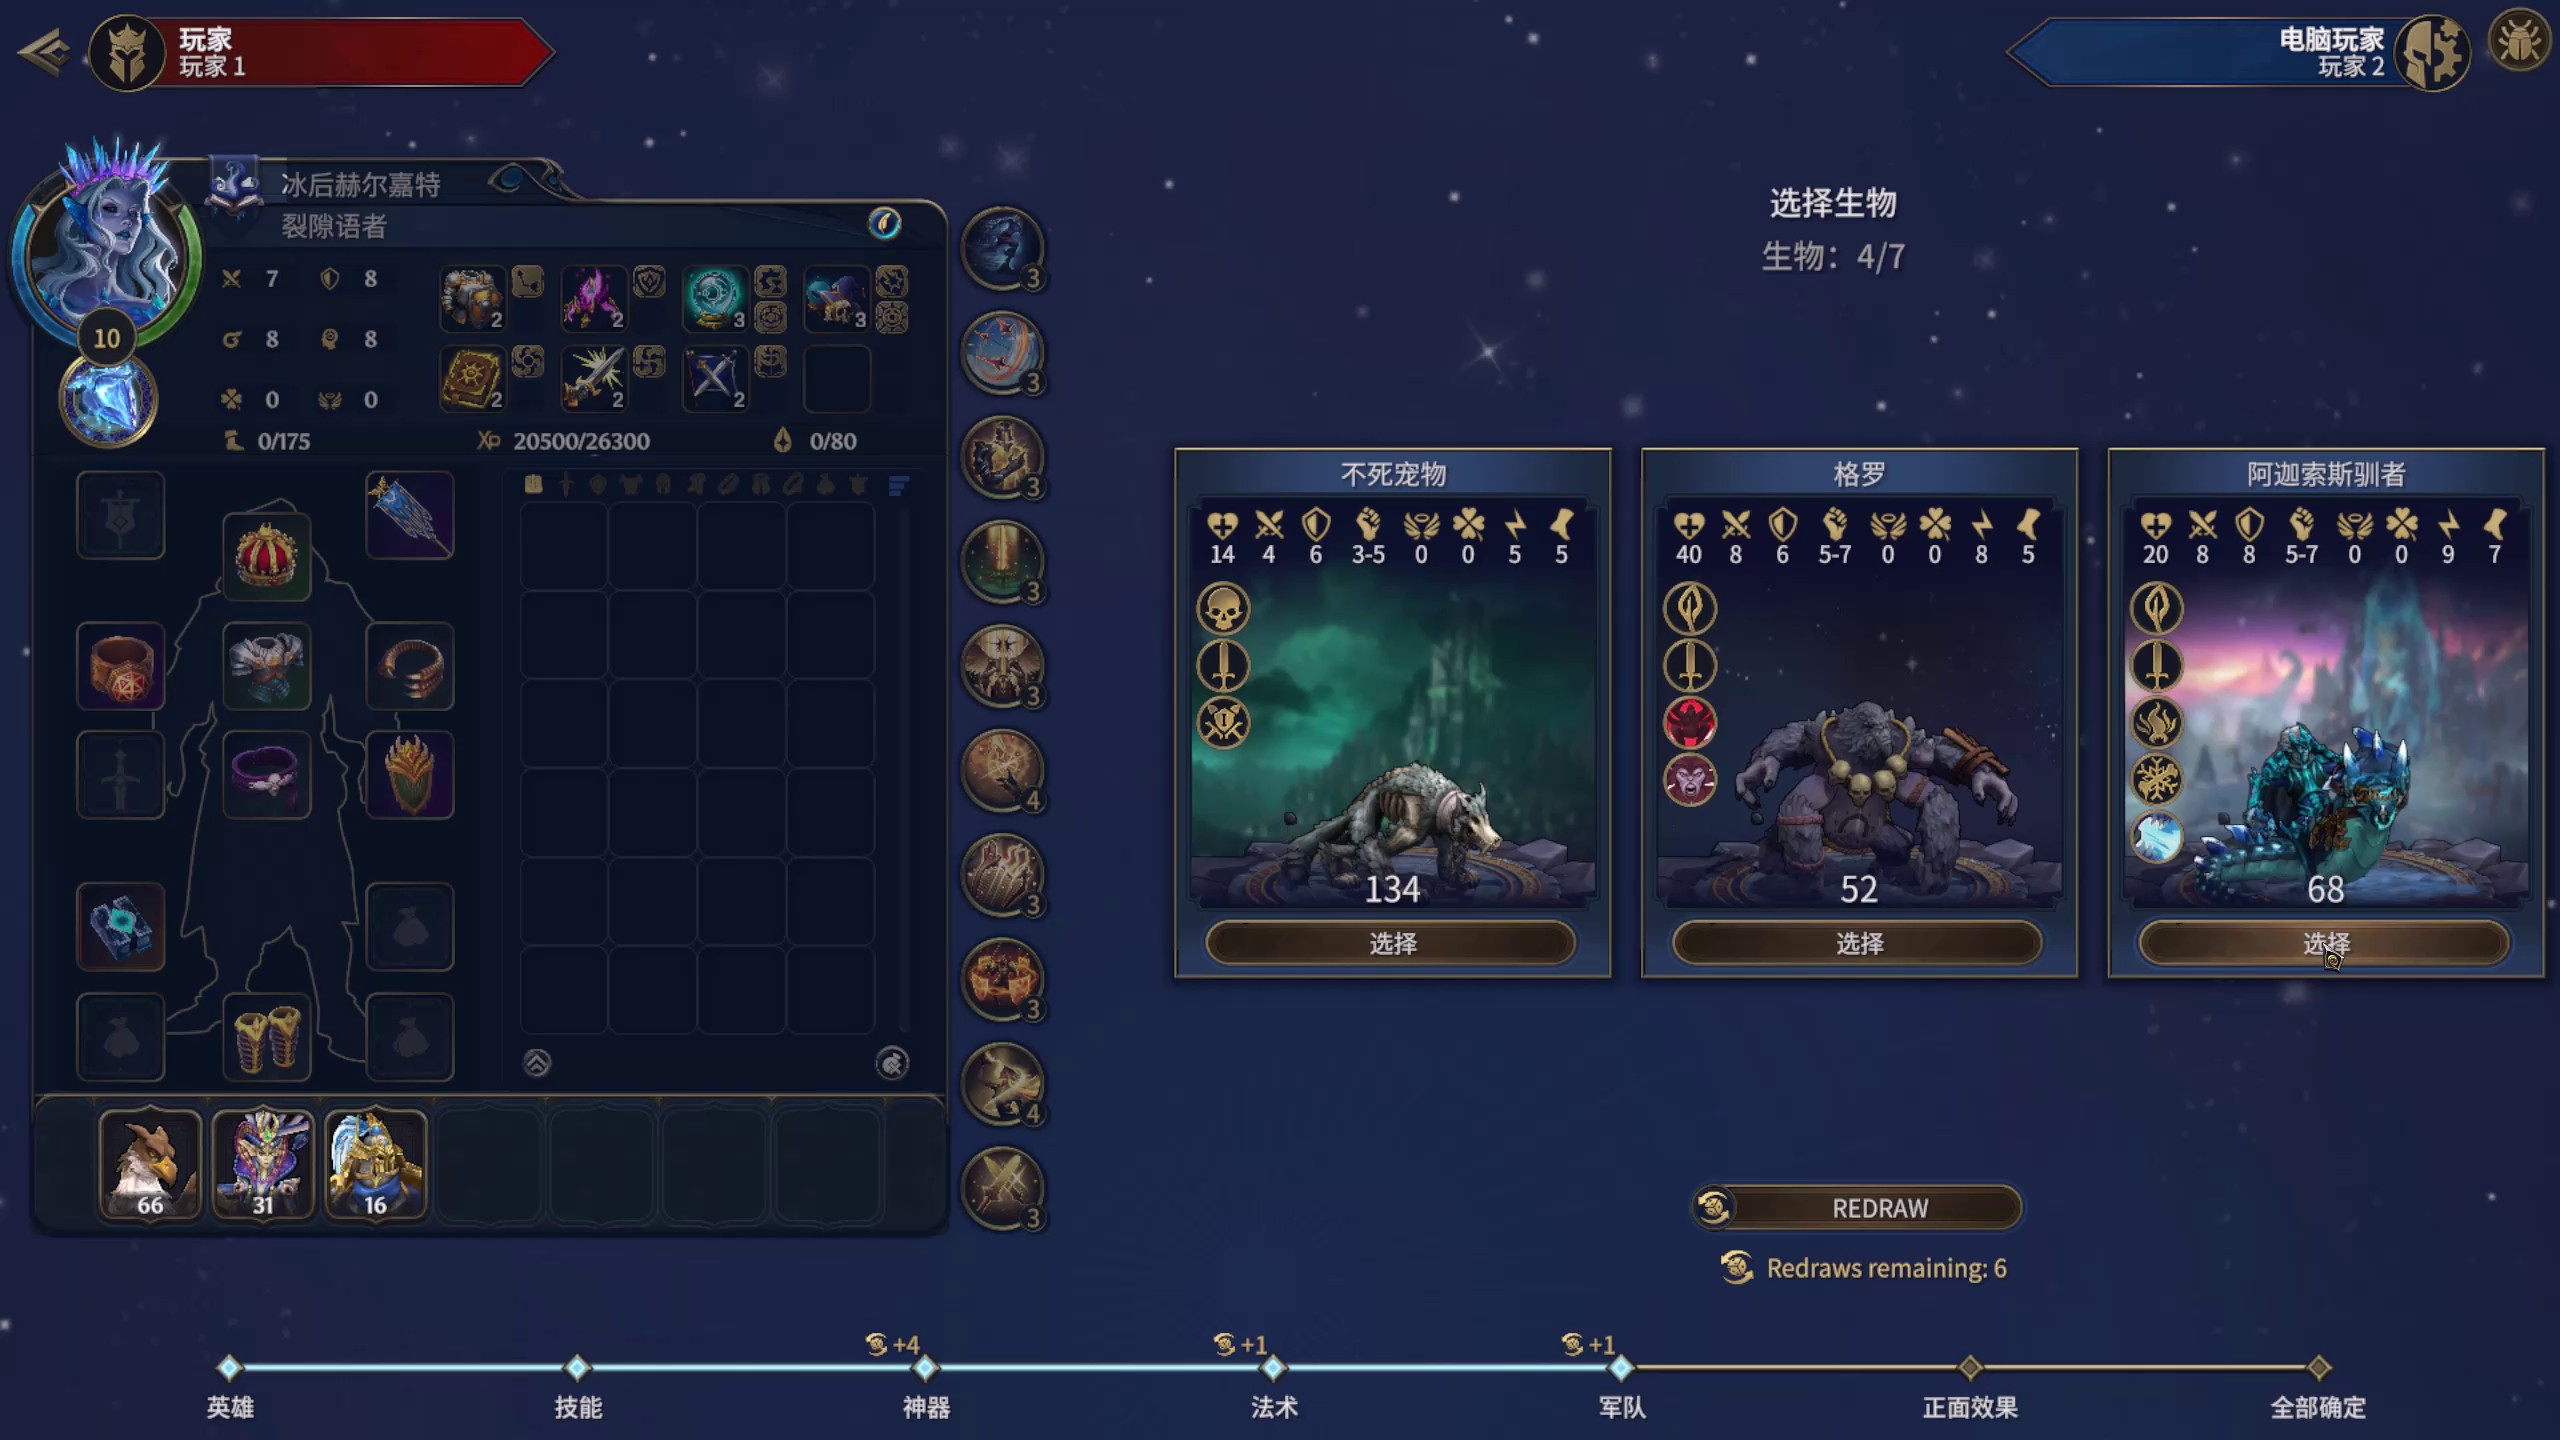
历史规则匹配文字:选择生物
查看历史预测与旧标签
历史 OCR 预测:选择生物。当时参考标签:选择生物(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 77 个 OCR 文本区域
电脑玩家 | 玩家 | 玩家1 | 玩家2 | 冰后赫尔嘉特 | 选择生物 | 裂隙语者 | 生物:4/7 | 0 | 3 | 8 | 7 | 2 | 3 | 3 | 10 | 8 | 8 | 0 | 3 | 2 | 0 | 2 | X 20500/26300 | 0/175 | Xp 20500/26300 | 0/80 | 格罗 | 不死宠物 | 阿迦索斯驯者 | 3 | 5 | 14 4 6 3-5 0 0 5 5 | 40 8 6 5-7 0 0' | 20 8 | 5 | 5-7 | 20 8 8 5-7 0 0' | 5-7 0 0 | 14 4 | 6 | 3-5 | 40 | 8 | 9 | 6 | 8 | 5 | 8 | 7 | 3 | 3 | TO | 52 | 68 | 134 | 选择 | 选择 | 选择 | 3 | 16 | 0 | 66 | 31 | REDRAW | 3 | Redraws remaining: 6 | +4 | +1 | +1 | 英雄 | 技能 | 神器 | 法术 | 军队 | 正面效果 | 全部确定
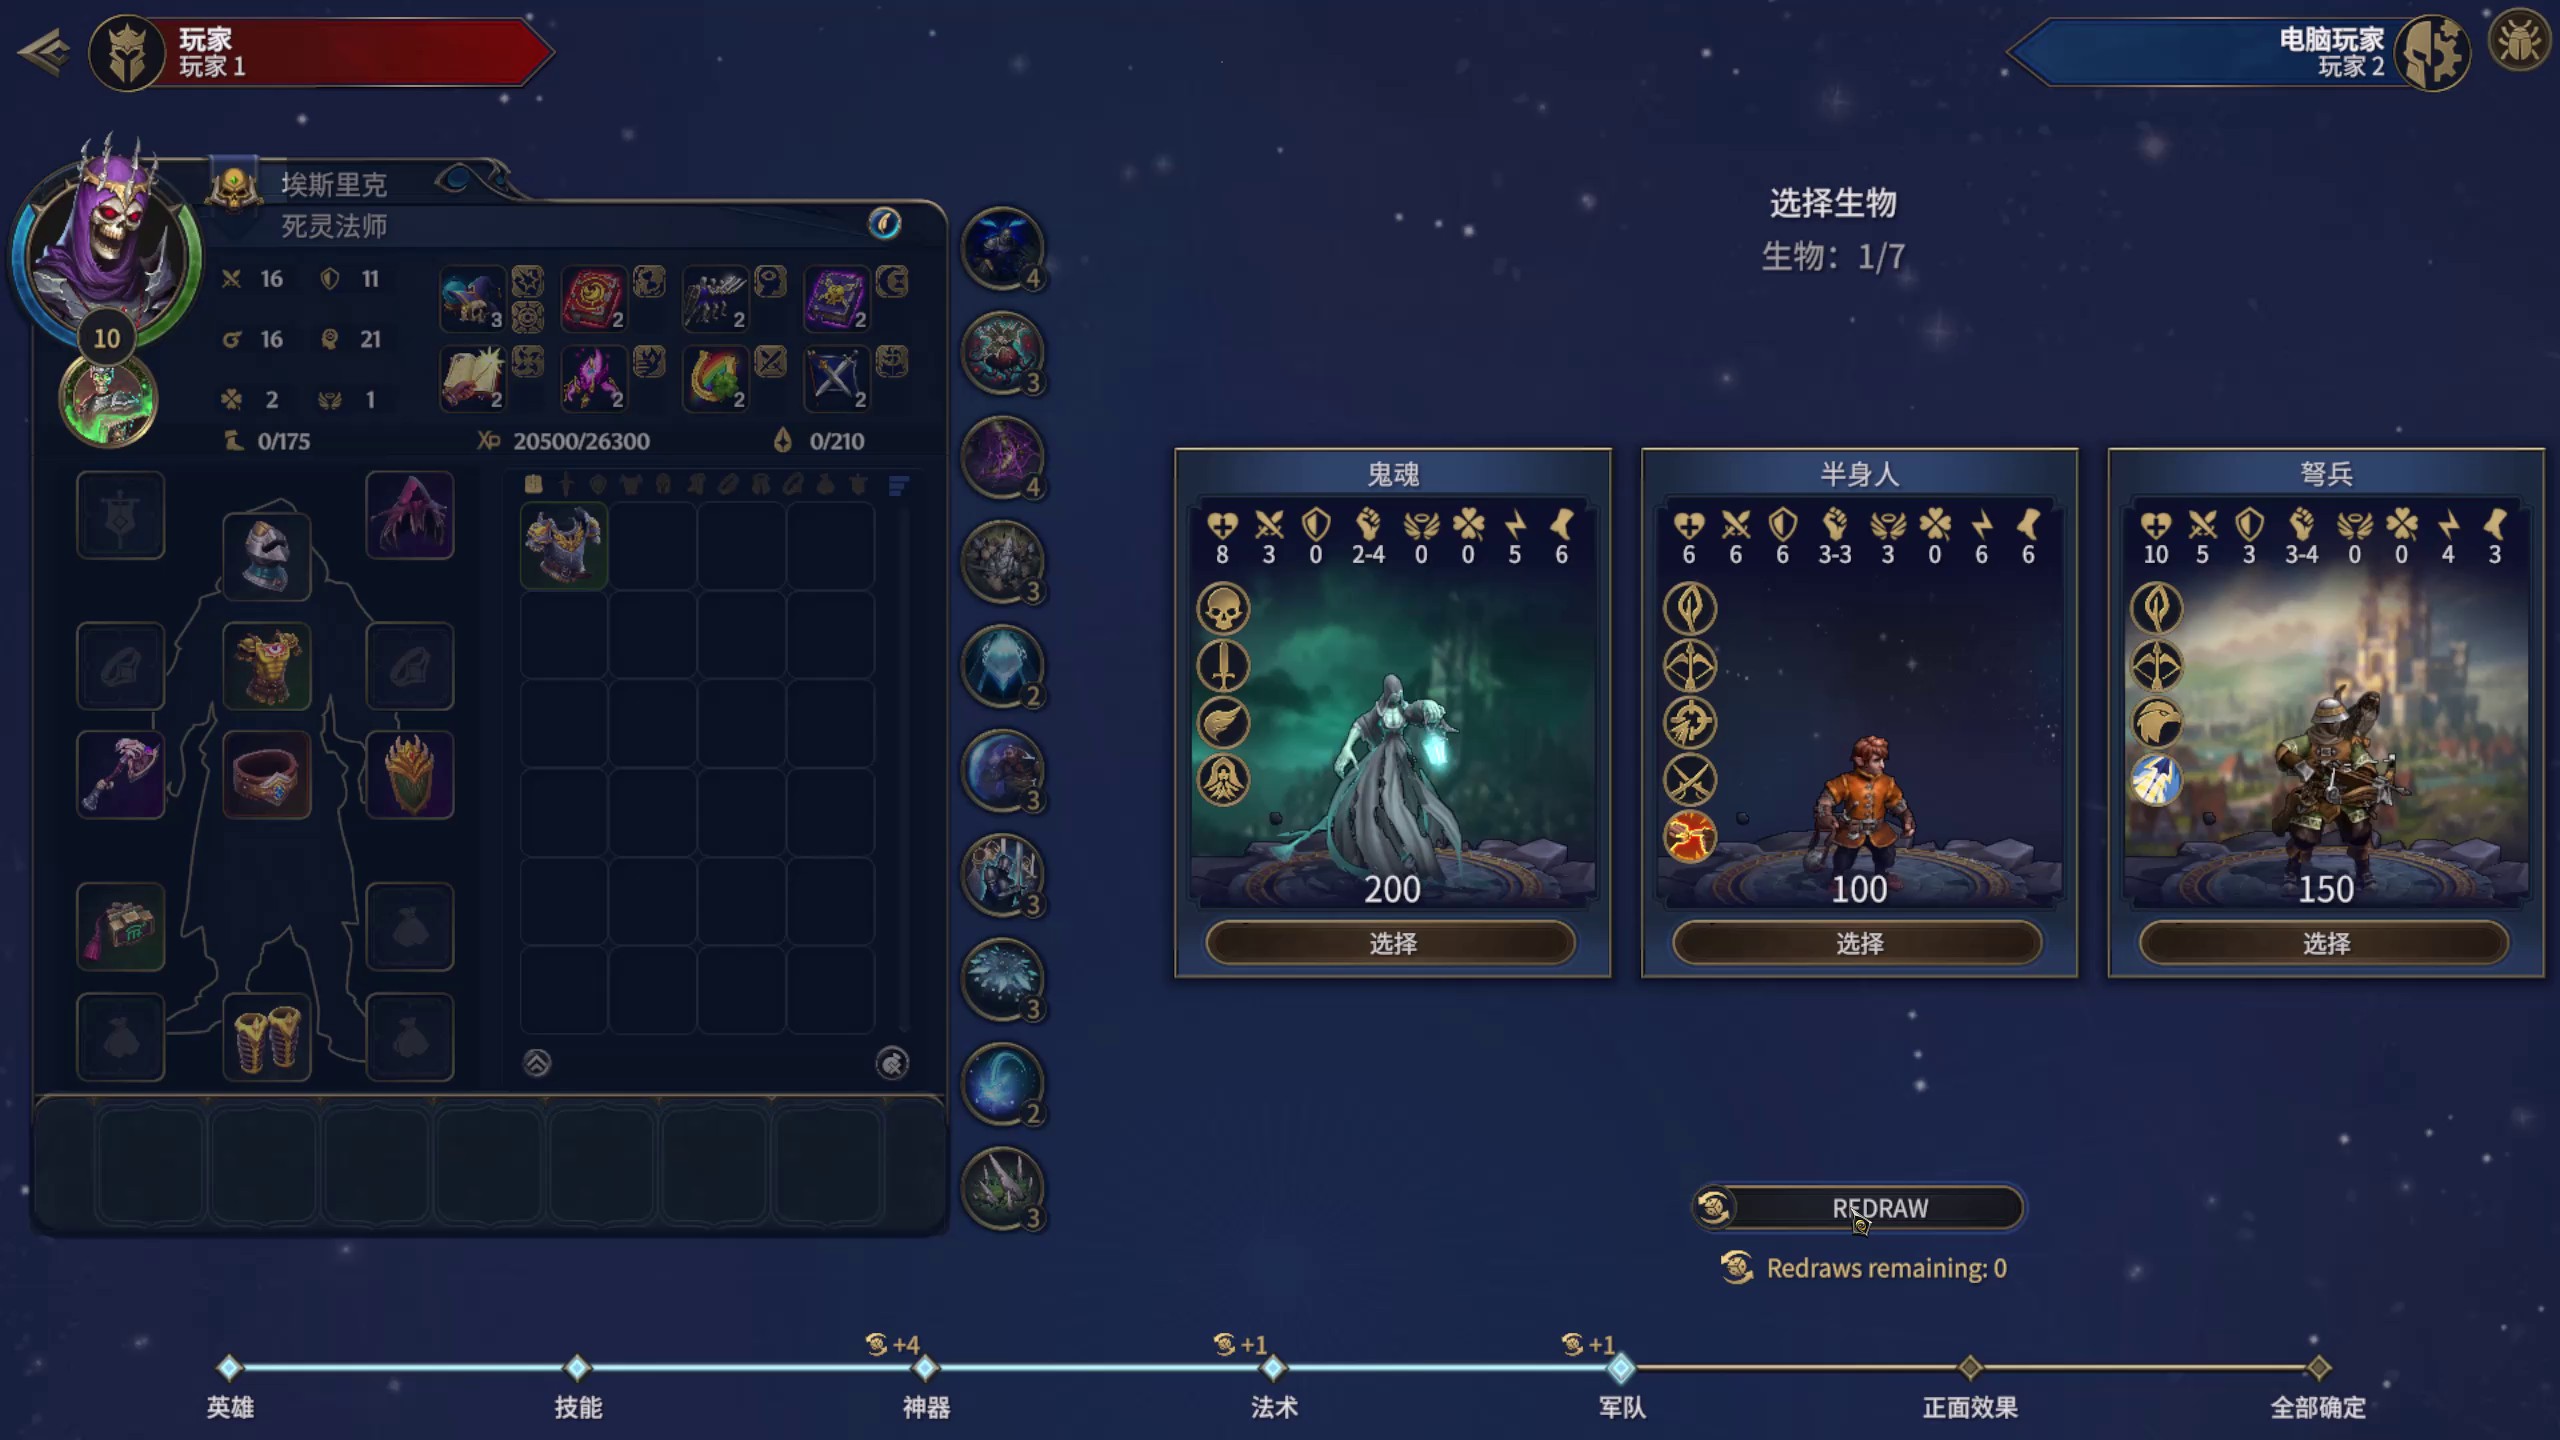
历史规则匹配文字:选择生物
查看历史预测与旧标签
历史 OCR 预测:选择生物。当时参考标签:选择生物(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 71 个 OCR 文本区域
电脑玩家 | 玩家 | 玩家2 | 玩家1 | 埃斯里克 | 选择生物 | 死灵法师 | 生物:1/7 | 16 | 16 | 11 | 3 | 2 | 10 | 16 | 21 | G | 3 | 2 | 2 | X 20500/26300 | Xp 20500/26300 | 0 | 0/175 | 0/210 | 半身人 | 鬼魂 | 弩兵 | 8 3 0 2-4 0 0 5 6 | 5 | 6 6 6 3-3 3 0' | 10 5 3 3-4 0 0 4 3 | 10 5 | 3 | 8 | 2-4 0 | 6 | 3 | 6 | 0 | 6 | 6 | 6 | 3-3 | 6 | 3-4 | 0 | 3 | 3 | 150 | 100 | 200 | 帘 | 选择 | 选择 | 选择 | 3 | 2 | REDRAW | 3 | Redraws remaining: 0 | +1 | +1 | 0 + 4 | 英雄 | 技能 | 神器 | 军队 | 法术 | 正面效果 | 全部确定
战前最终确认 · BATTLE_FINAL_CONFIRMATION 2 张示例
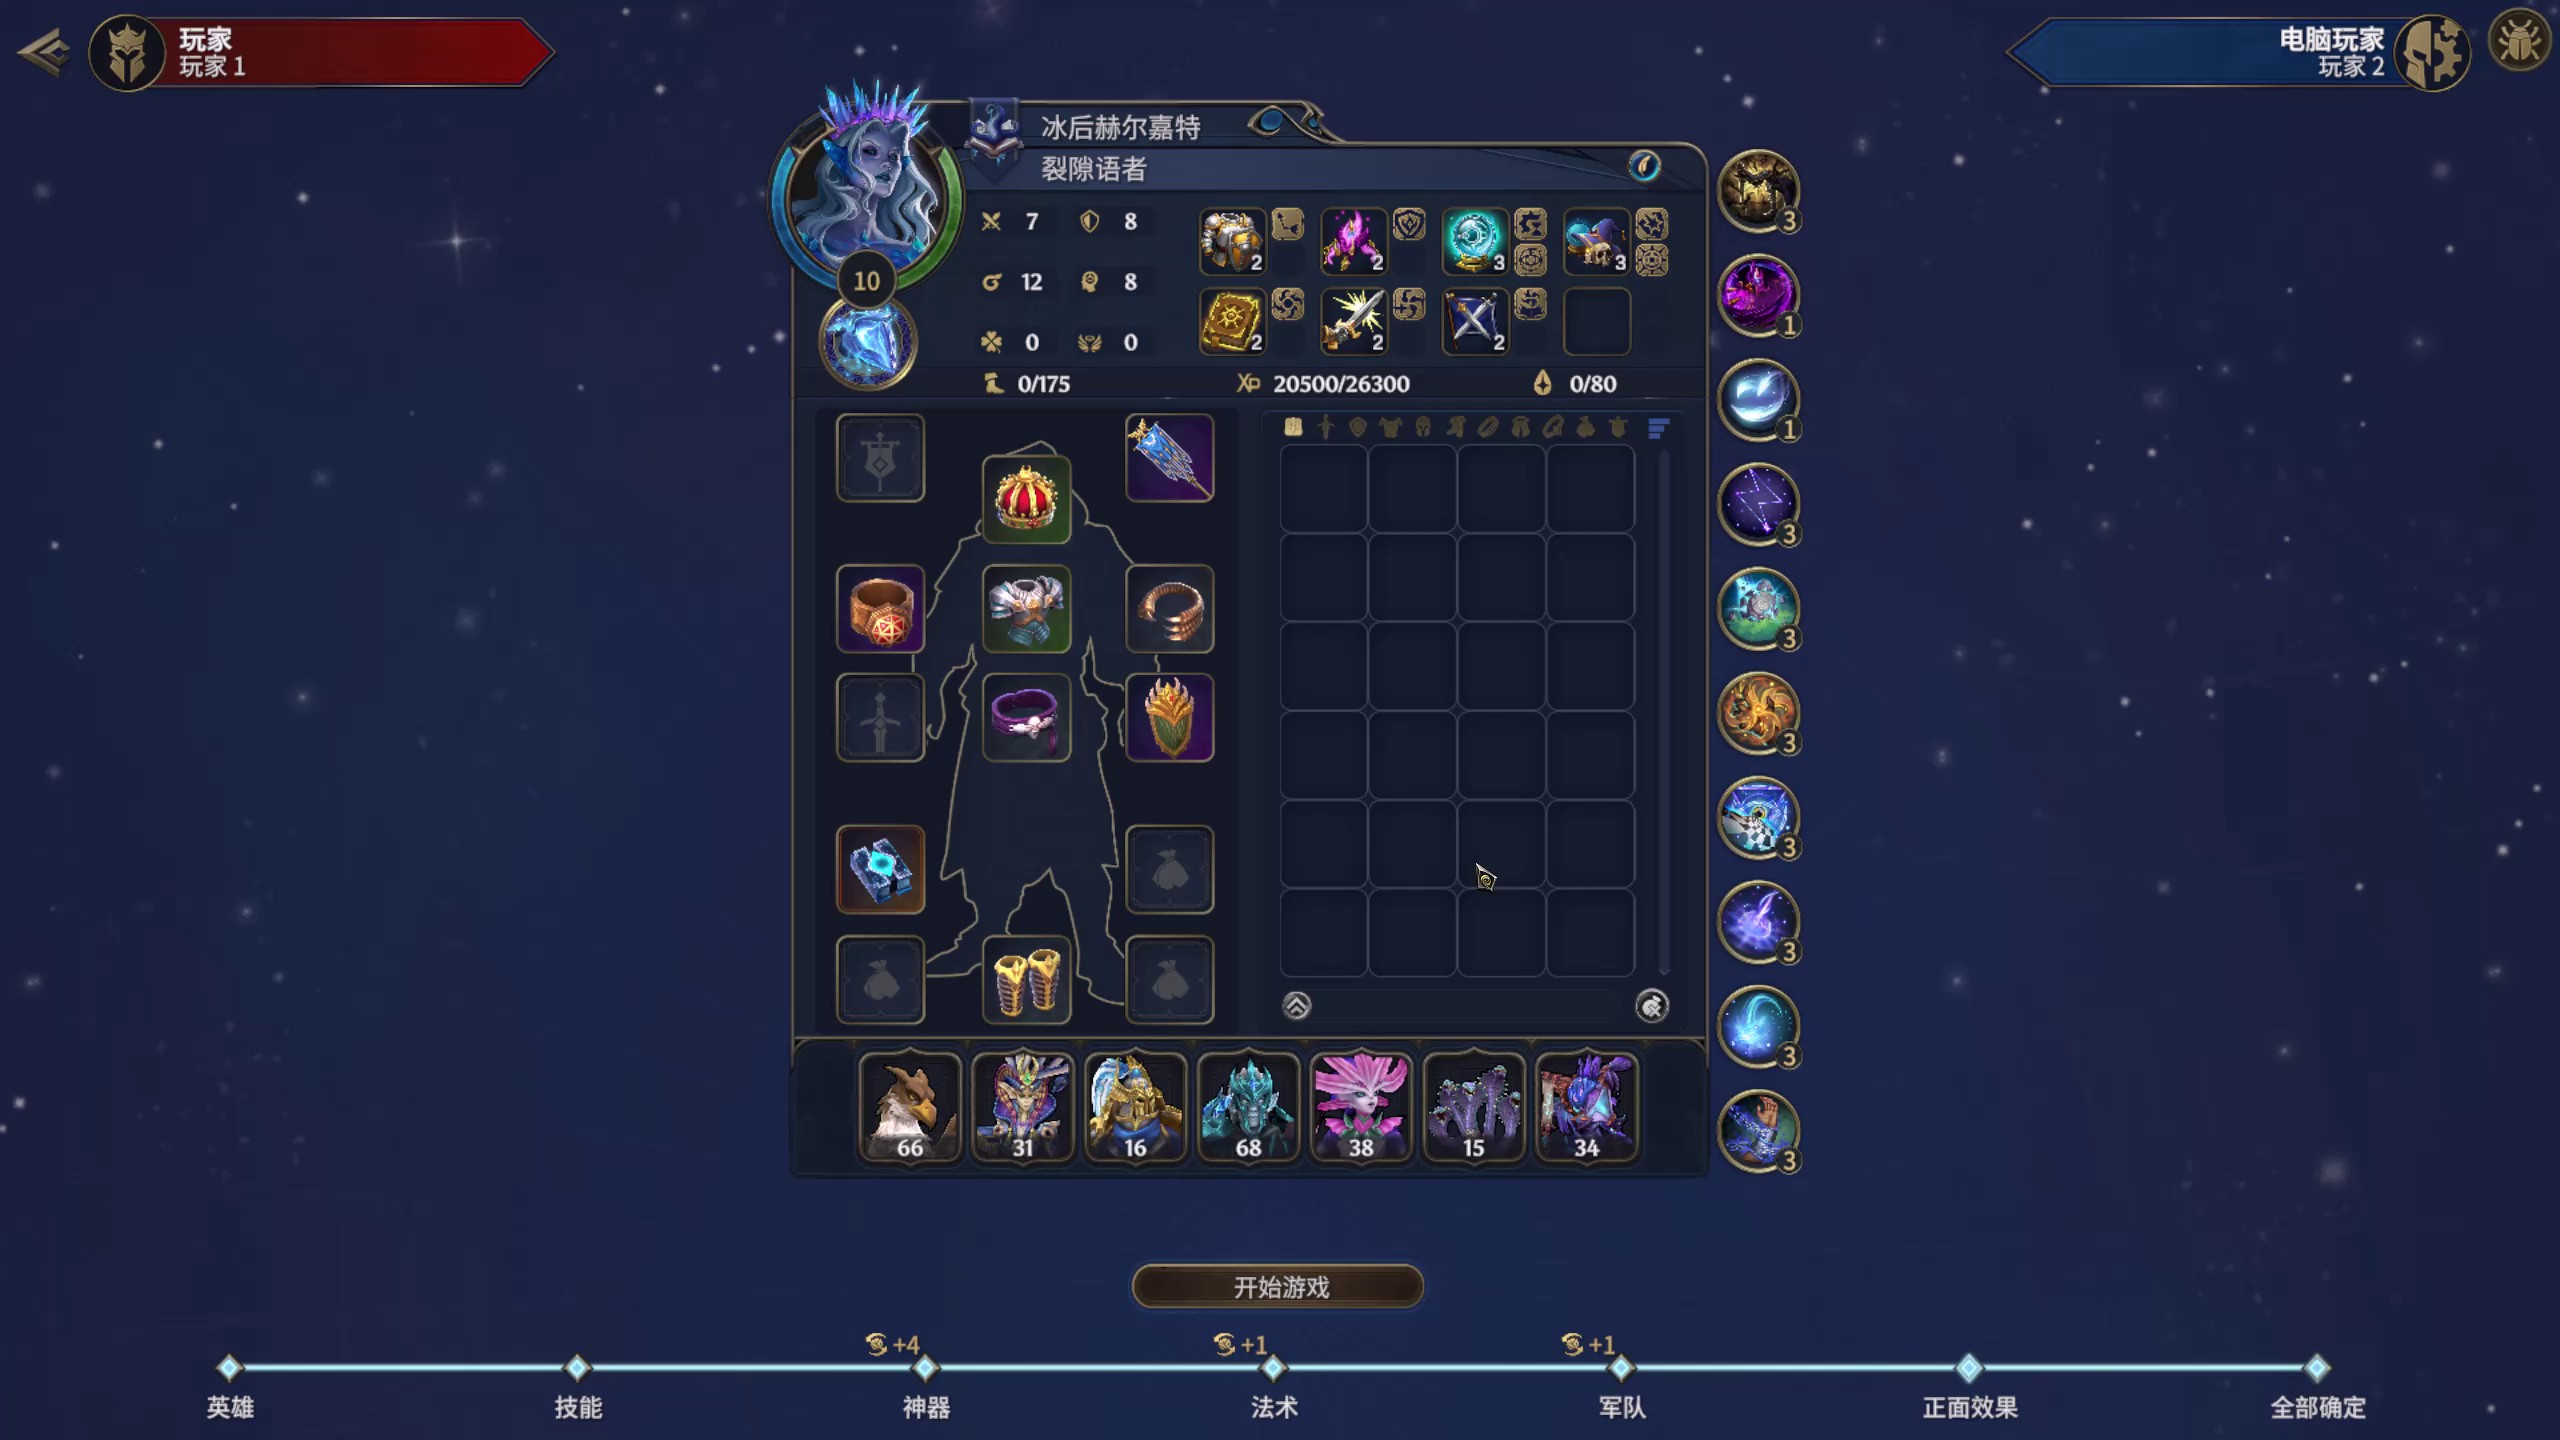
历史规则匹配文字:全部确定 · 开始游戏
查看历史预测与旧标签
历史 OCR 预测:战前最终确认。当时参考标签:战前最终确认(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 54 个 OCR 文本区域
玩家 | 电脑玩家 | 玩家2 | 玩家1 | 冰后赫尔嘉特 | 裂隙语者 | 7 | 8 | 3 | 3 | 2 | 3 | 10 | 12 | 8 | G | 12 | 5 | 0 | 0 | 2 | 0/80 | X20500/26300 | 0/175 | 0 | 0 一《 0 | 0 以 0 | 1 | 3 | 3 | 3 | 3 | 3 | 3 | 3 | 66 | 31 | 16 | 68 | 38 | 15 | 34 | 3 | 开始游戏 | +4 | +1 | +1 | 全部确定 | 英雄 | 技能 | 法术 | 军队 | 正面效果 | 神器
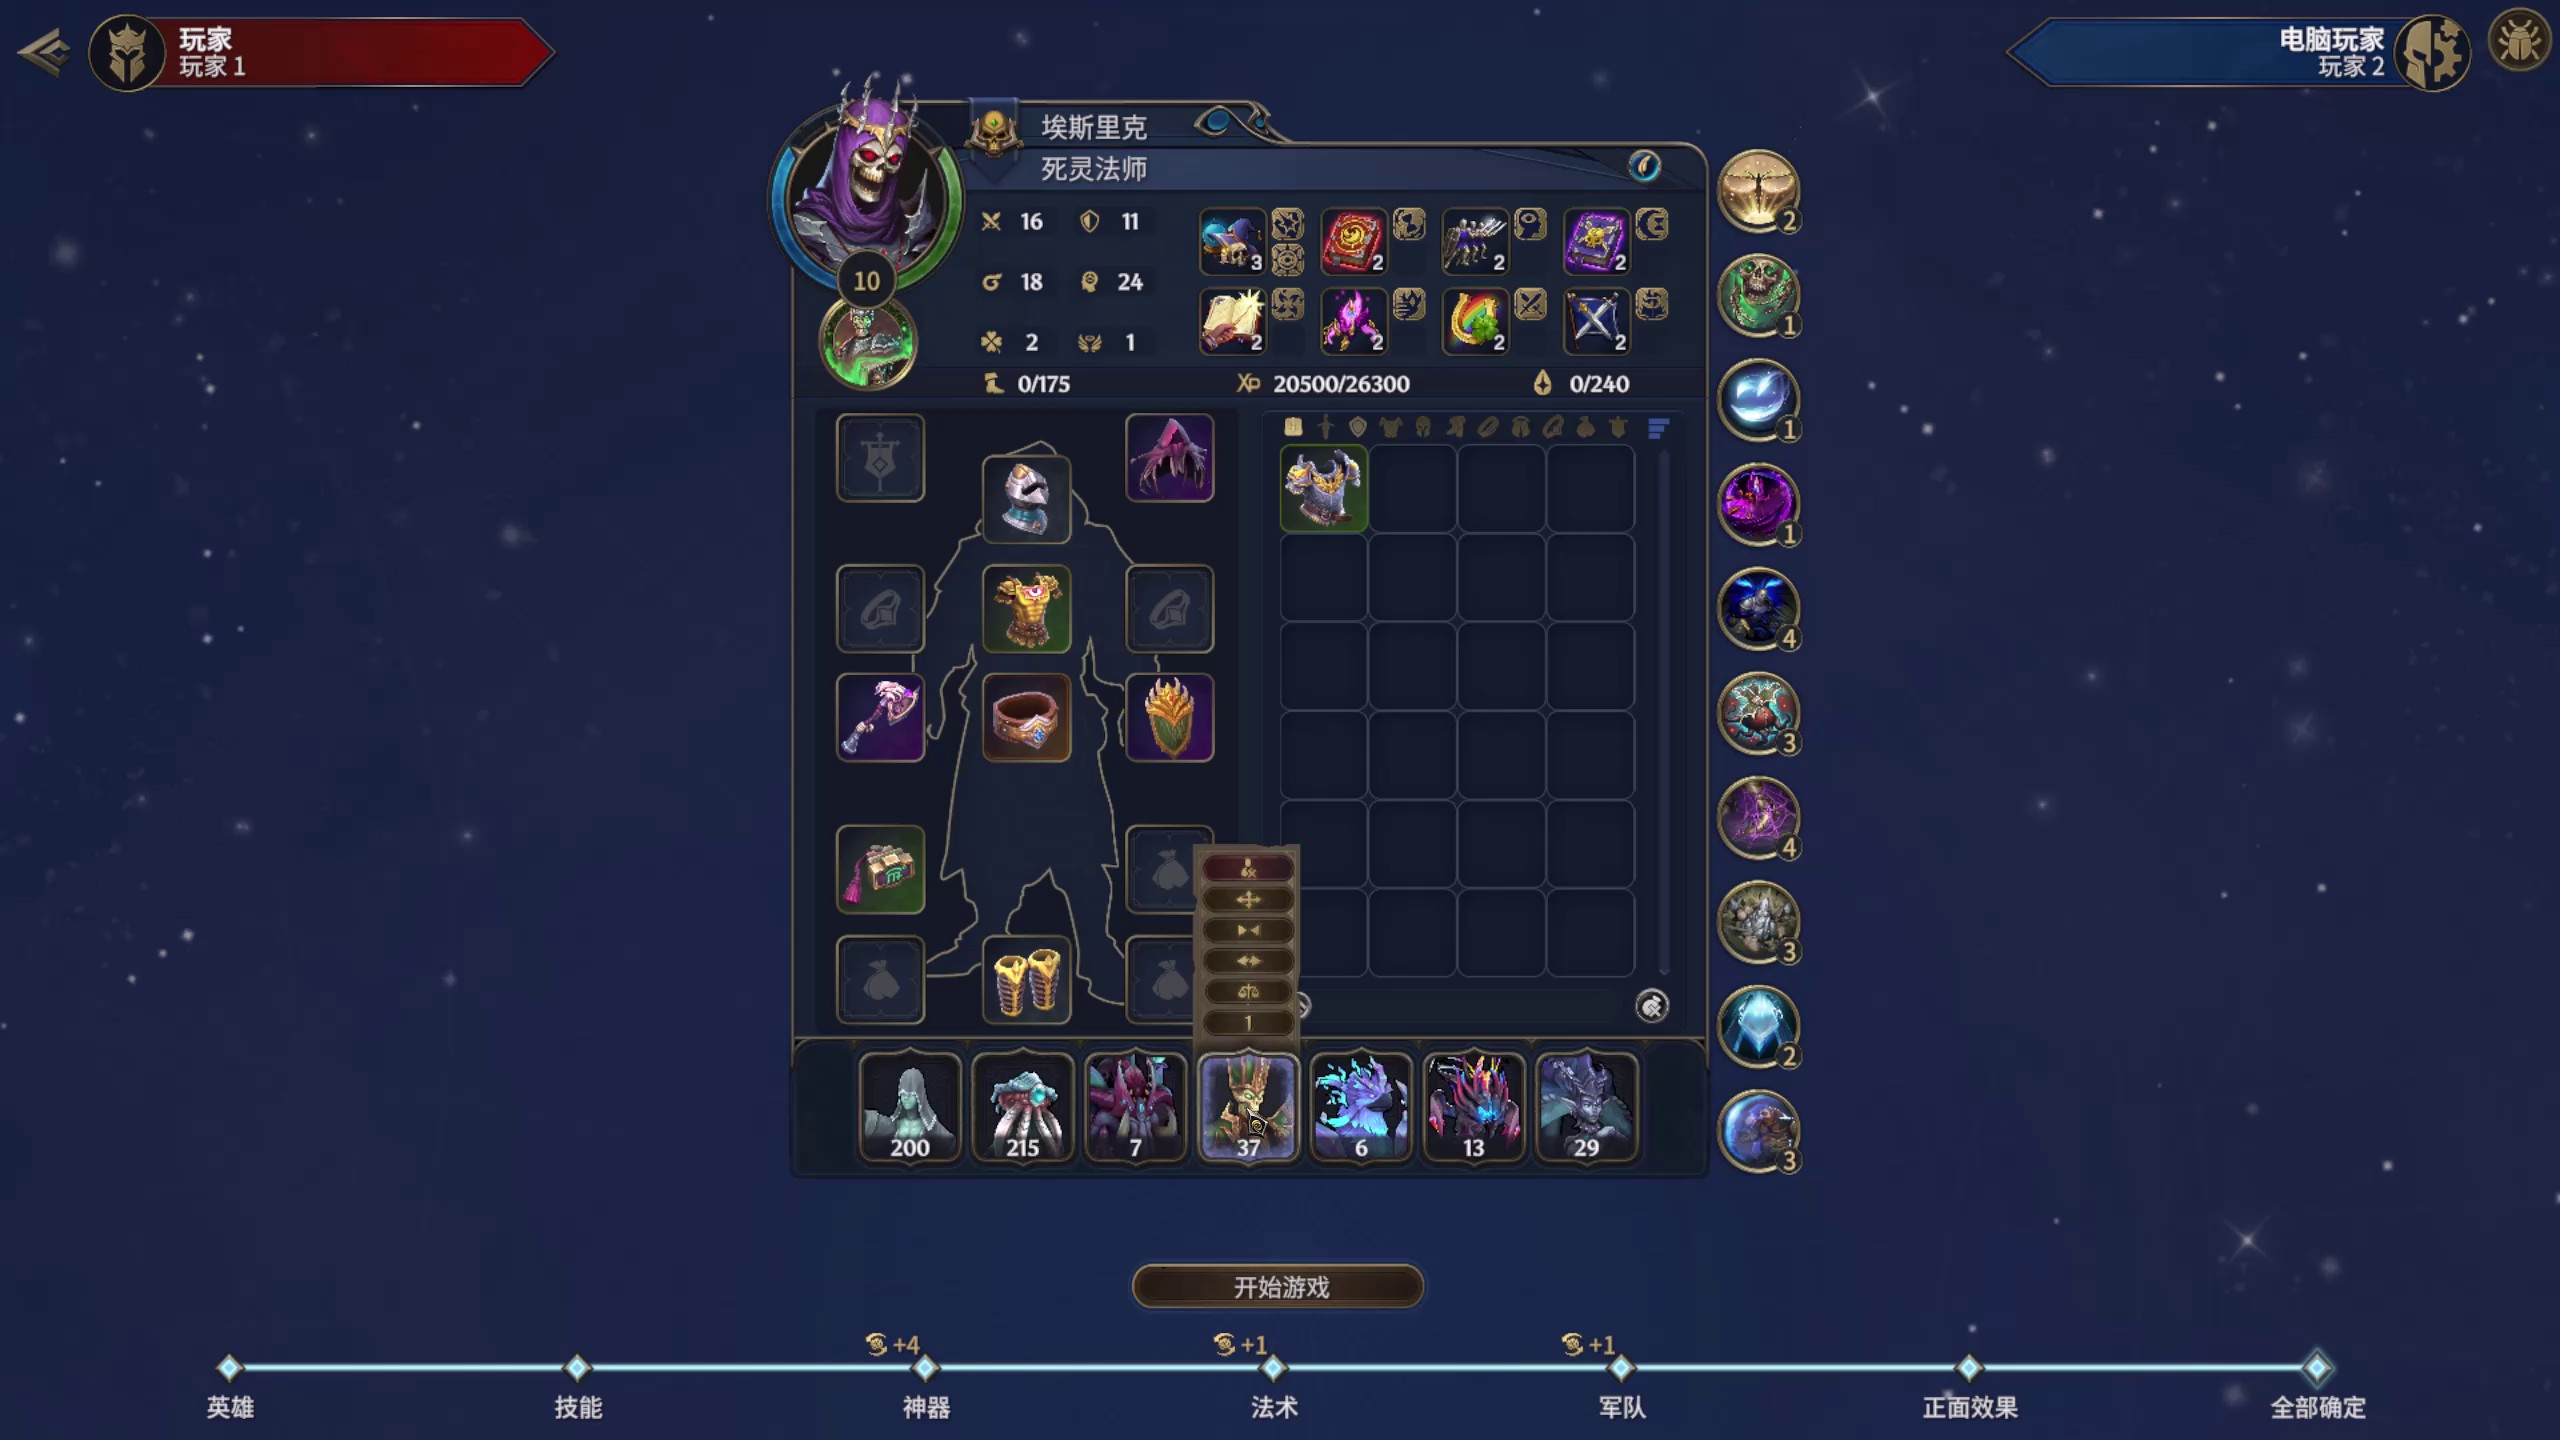
历史规则匹配文字:全部确定 · 开始游戏
查看历史预测与旧标签
历史 OCR 预测:战前最终确认。当时参考标签:战前最终确认(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 44 个 OCR 文本区域
电脑玩家 | 玩家 | 玩家2 | 玩家1 | 埃斯里克 | 死灵法师 | 16 | 11 | X | 2 | 3 | 10 | G 18 | 18 | 24 | G | 2 | 2 | 2 | 0/175 | X20500/26300 | 0/240 | 1 | 3 | 4 | 命 | 3 | 29 | 13 | 200 | 215 | 37 | 3 | 开始游戏 | +1 | +1 | +4 | 技能 | 军队 | 正面效果 | 英雄 | 神器 | 法术 | 全部确定
排兵布阵 · BATTLE_PREPARATION 2 张示例
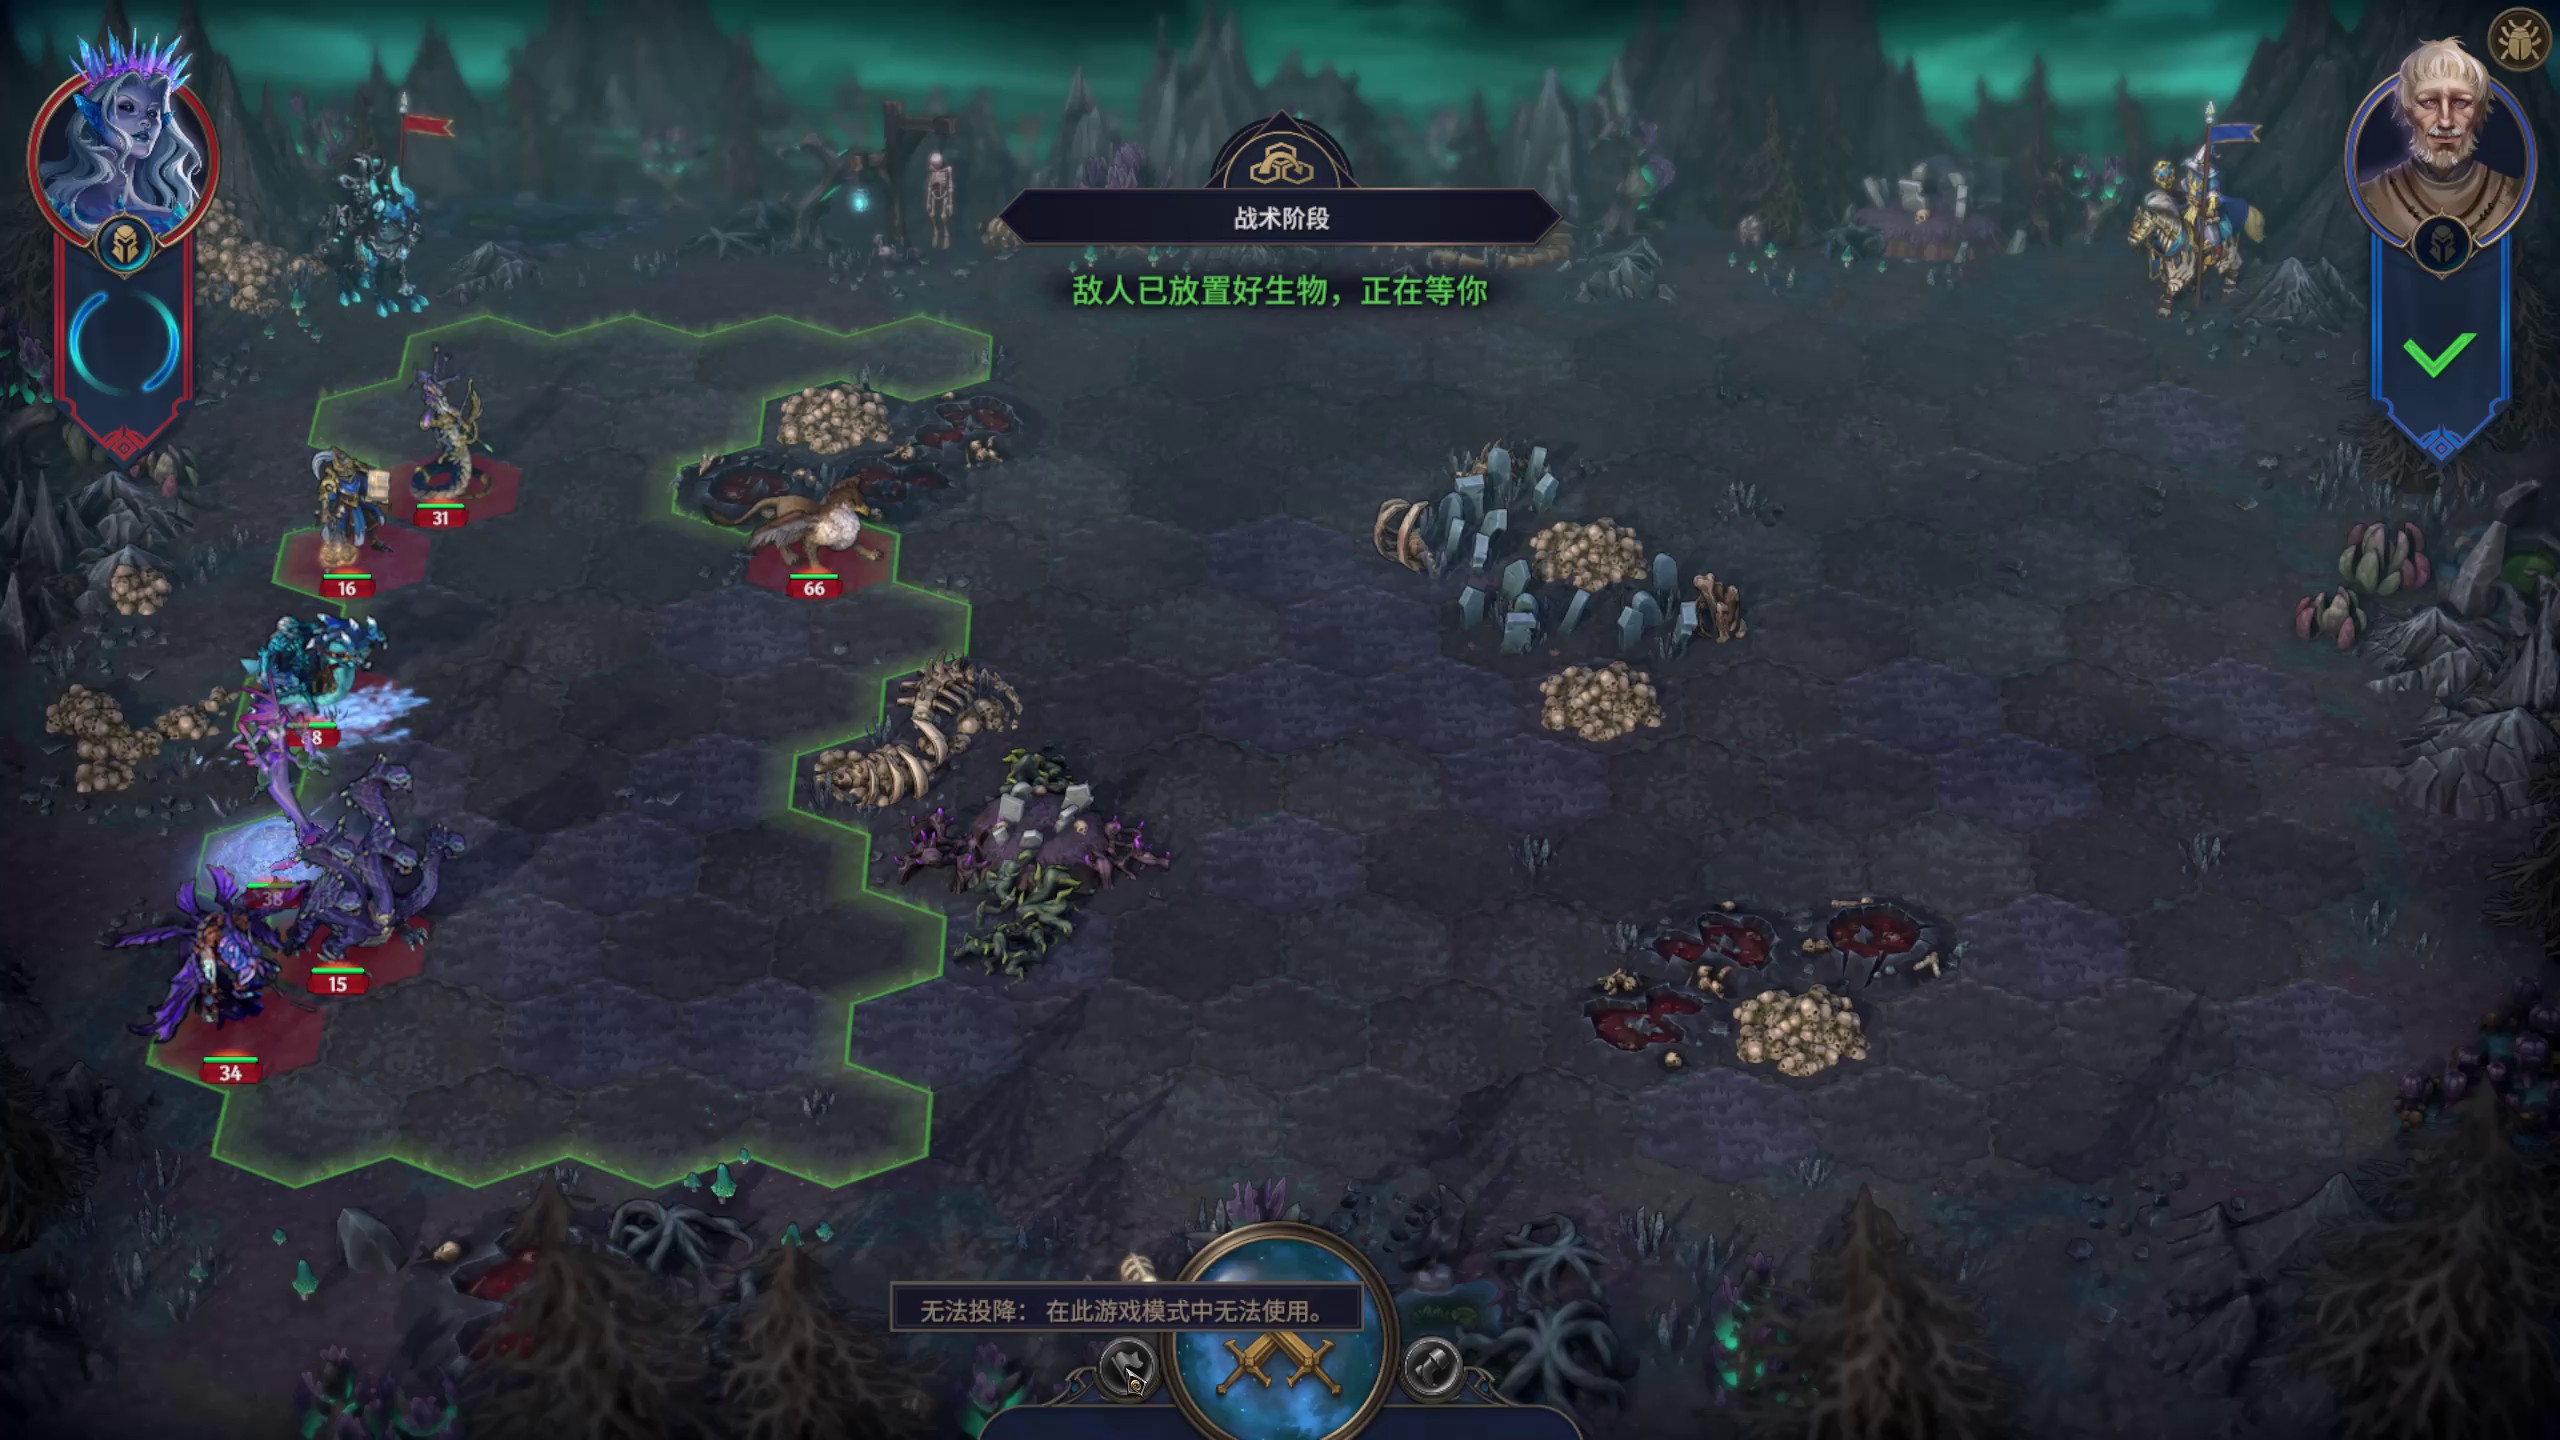
历史规则匹配文字:战术阶段
查看历史预测与旧标签
历史 OCR 预测:排兵布阵。当时参考标签:排兵布阵(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 11 个 OCR 文本区域
战术阶段 | 敌人已放置好生物,正在等你 | 31 | 66 | 16 | 8 | 38 | 15 | 34 | 无法投降:在此游戏模式中无法使用。 | XX
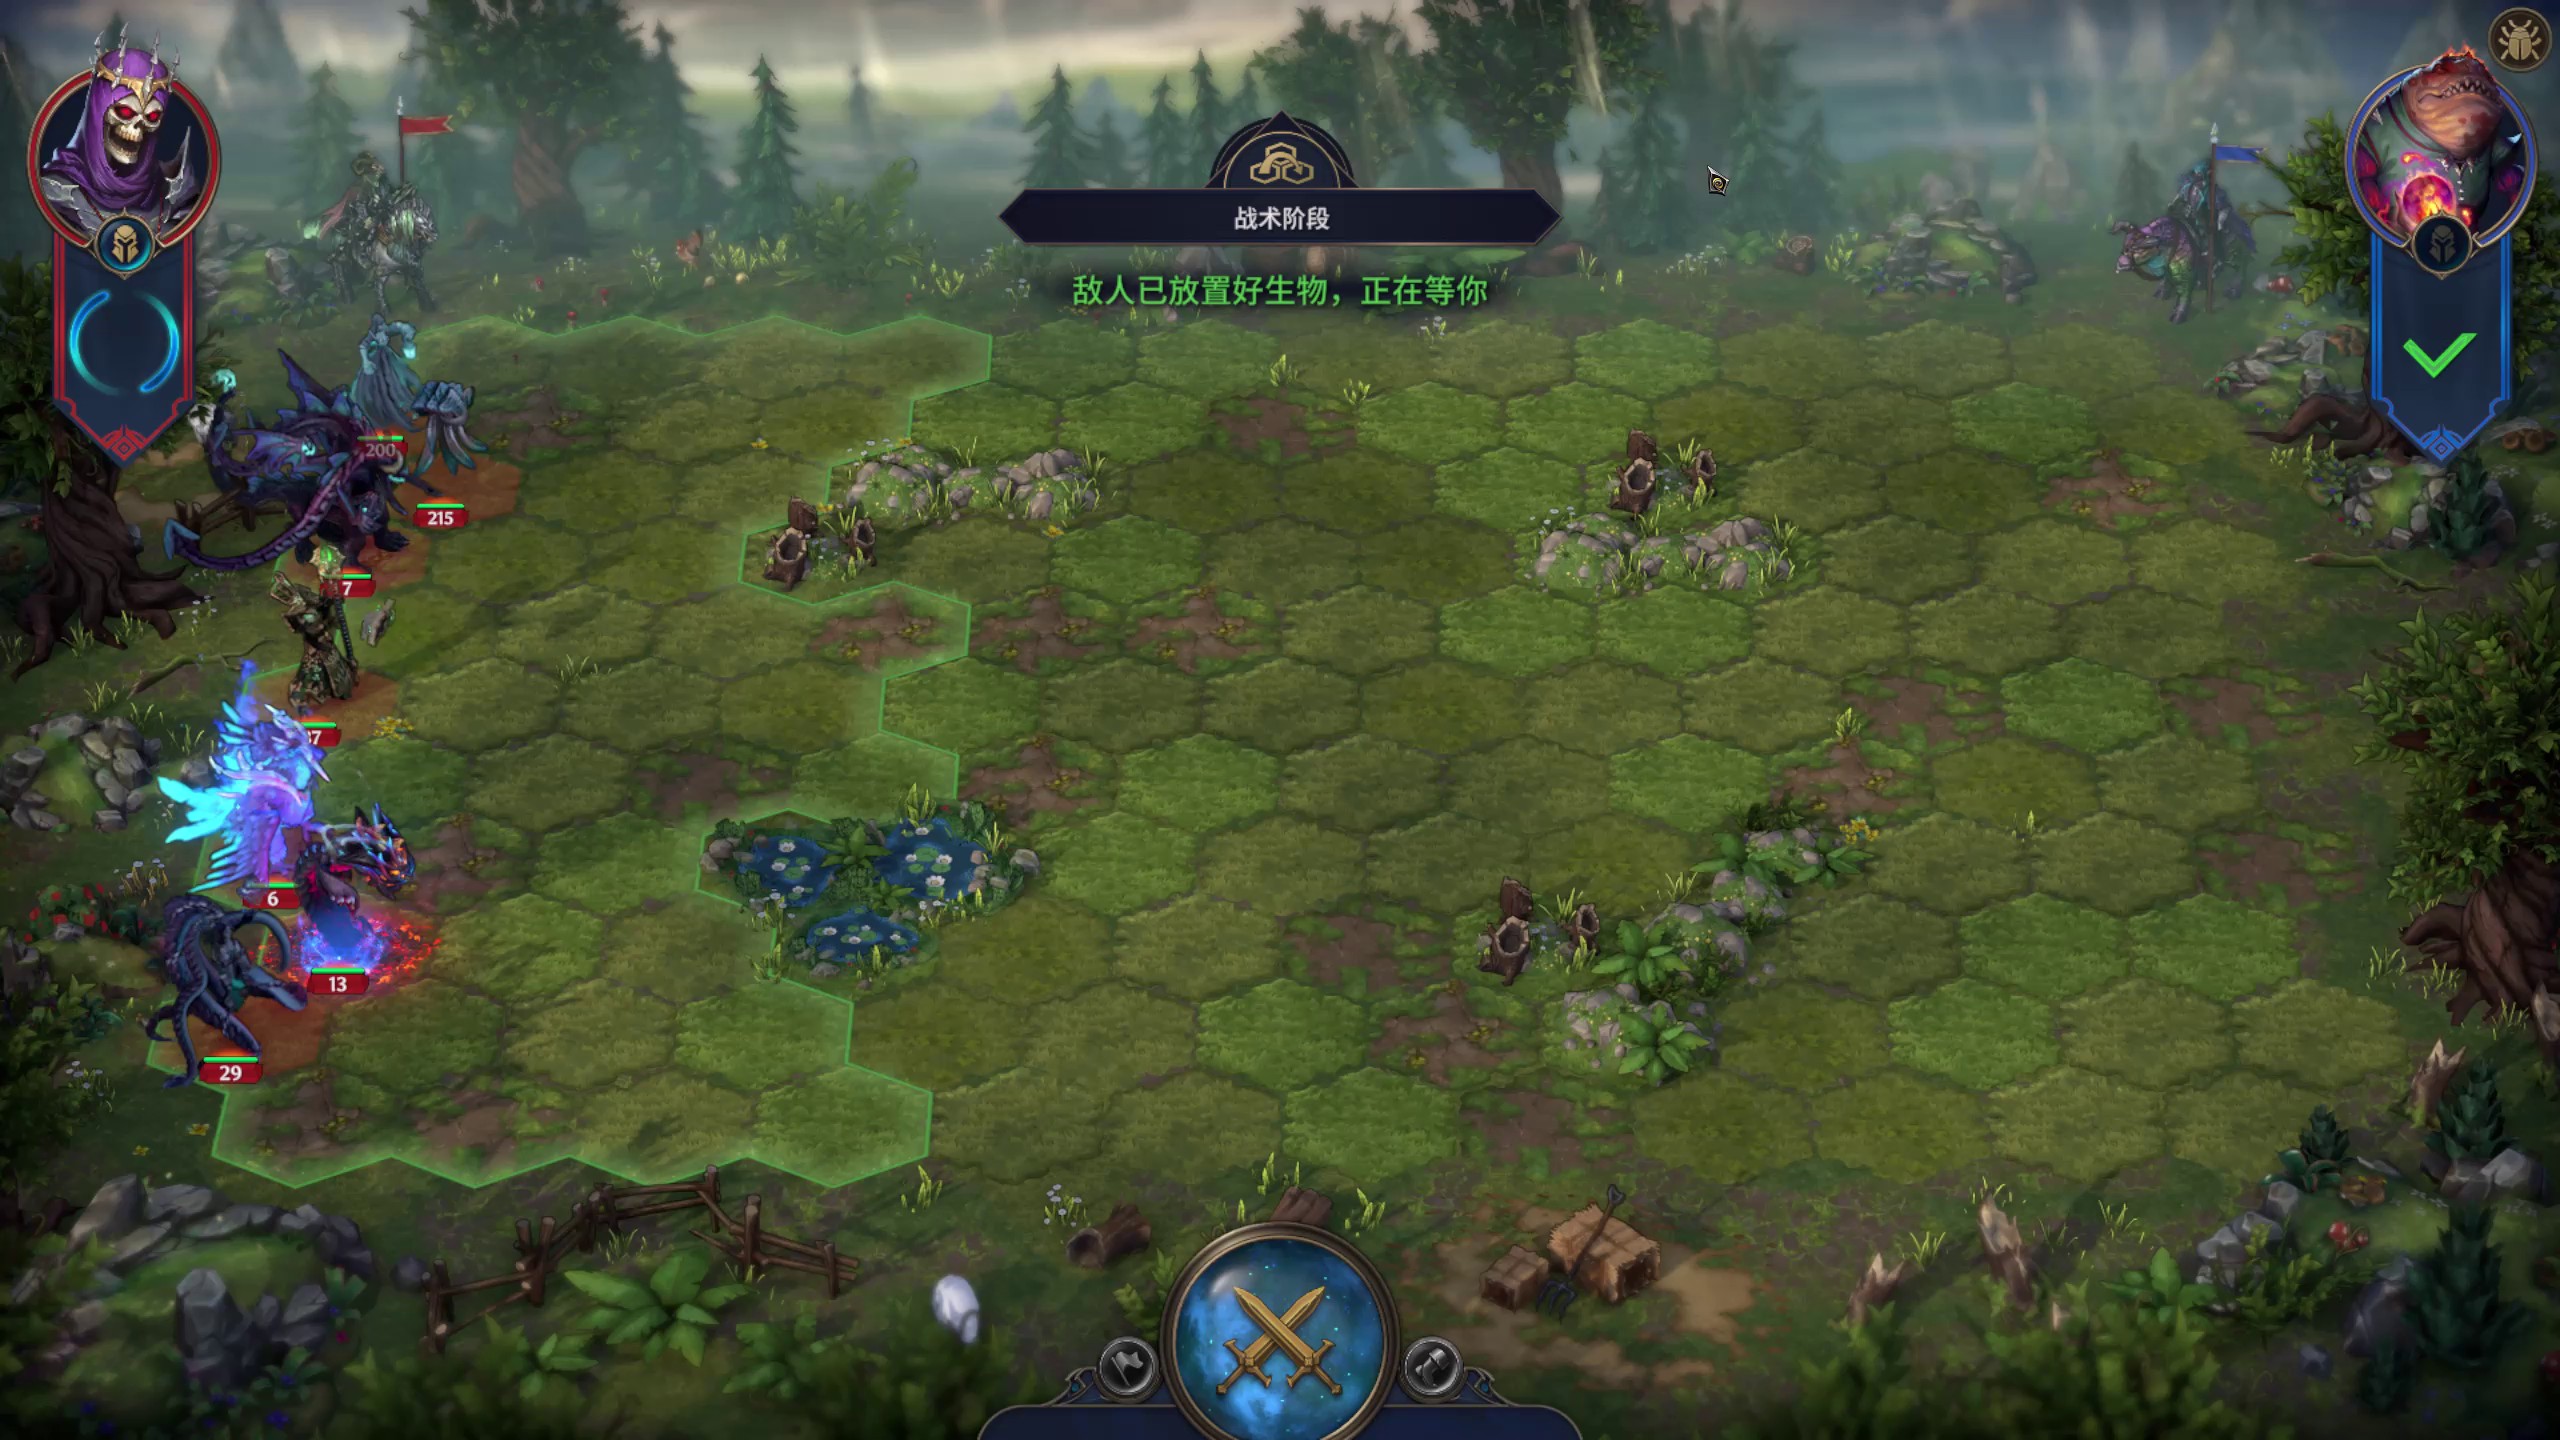
历史规则匹配文字:战术阶段
查看历史预测与旧标签
历史 OCR 预测:排兵布阵。当时参考标签:排兵布阵(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 7 个 OCR 文本区域
战术阶段 | 敌人已放置好生物,正在等你 | 200 | 215 | 6 | 13 | 29
战斗进行中 · BATTLE_ACTIVE 3 张示例
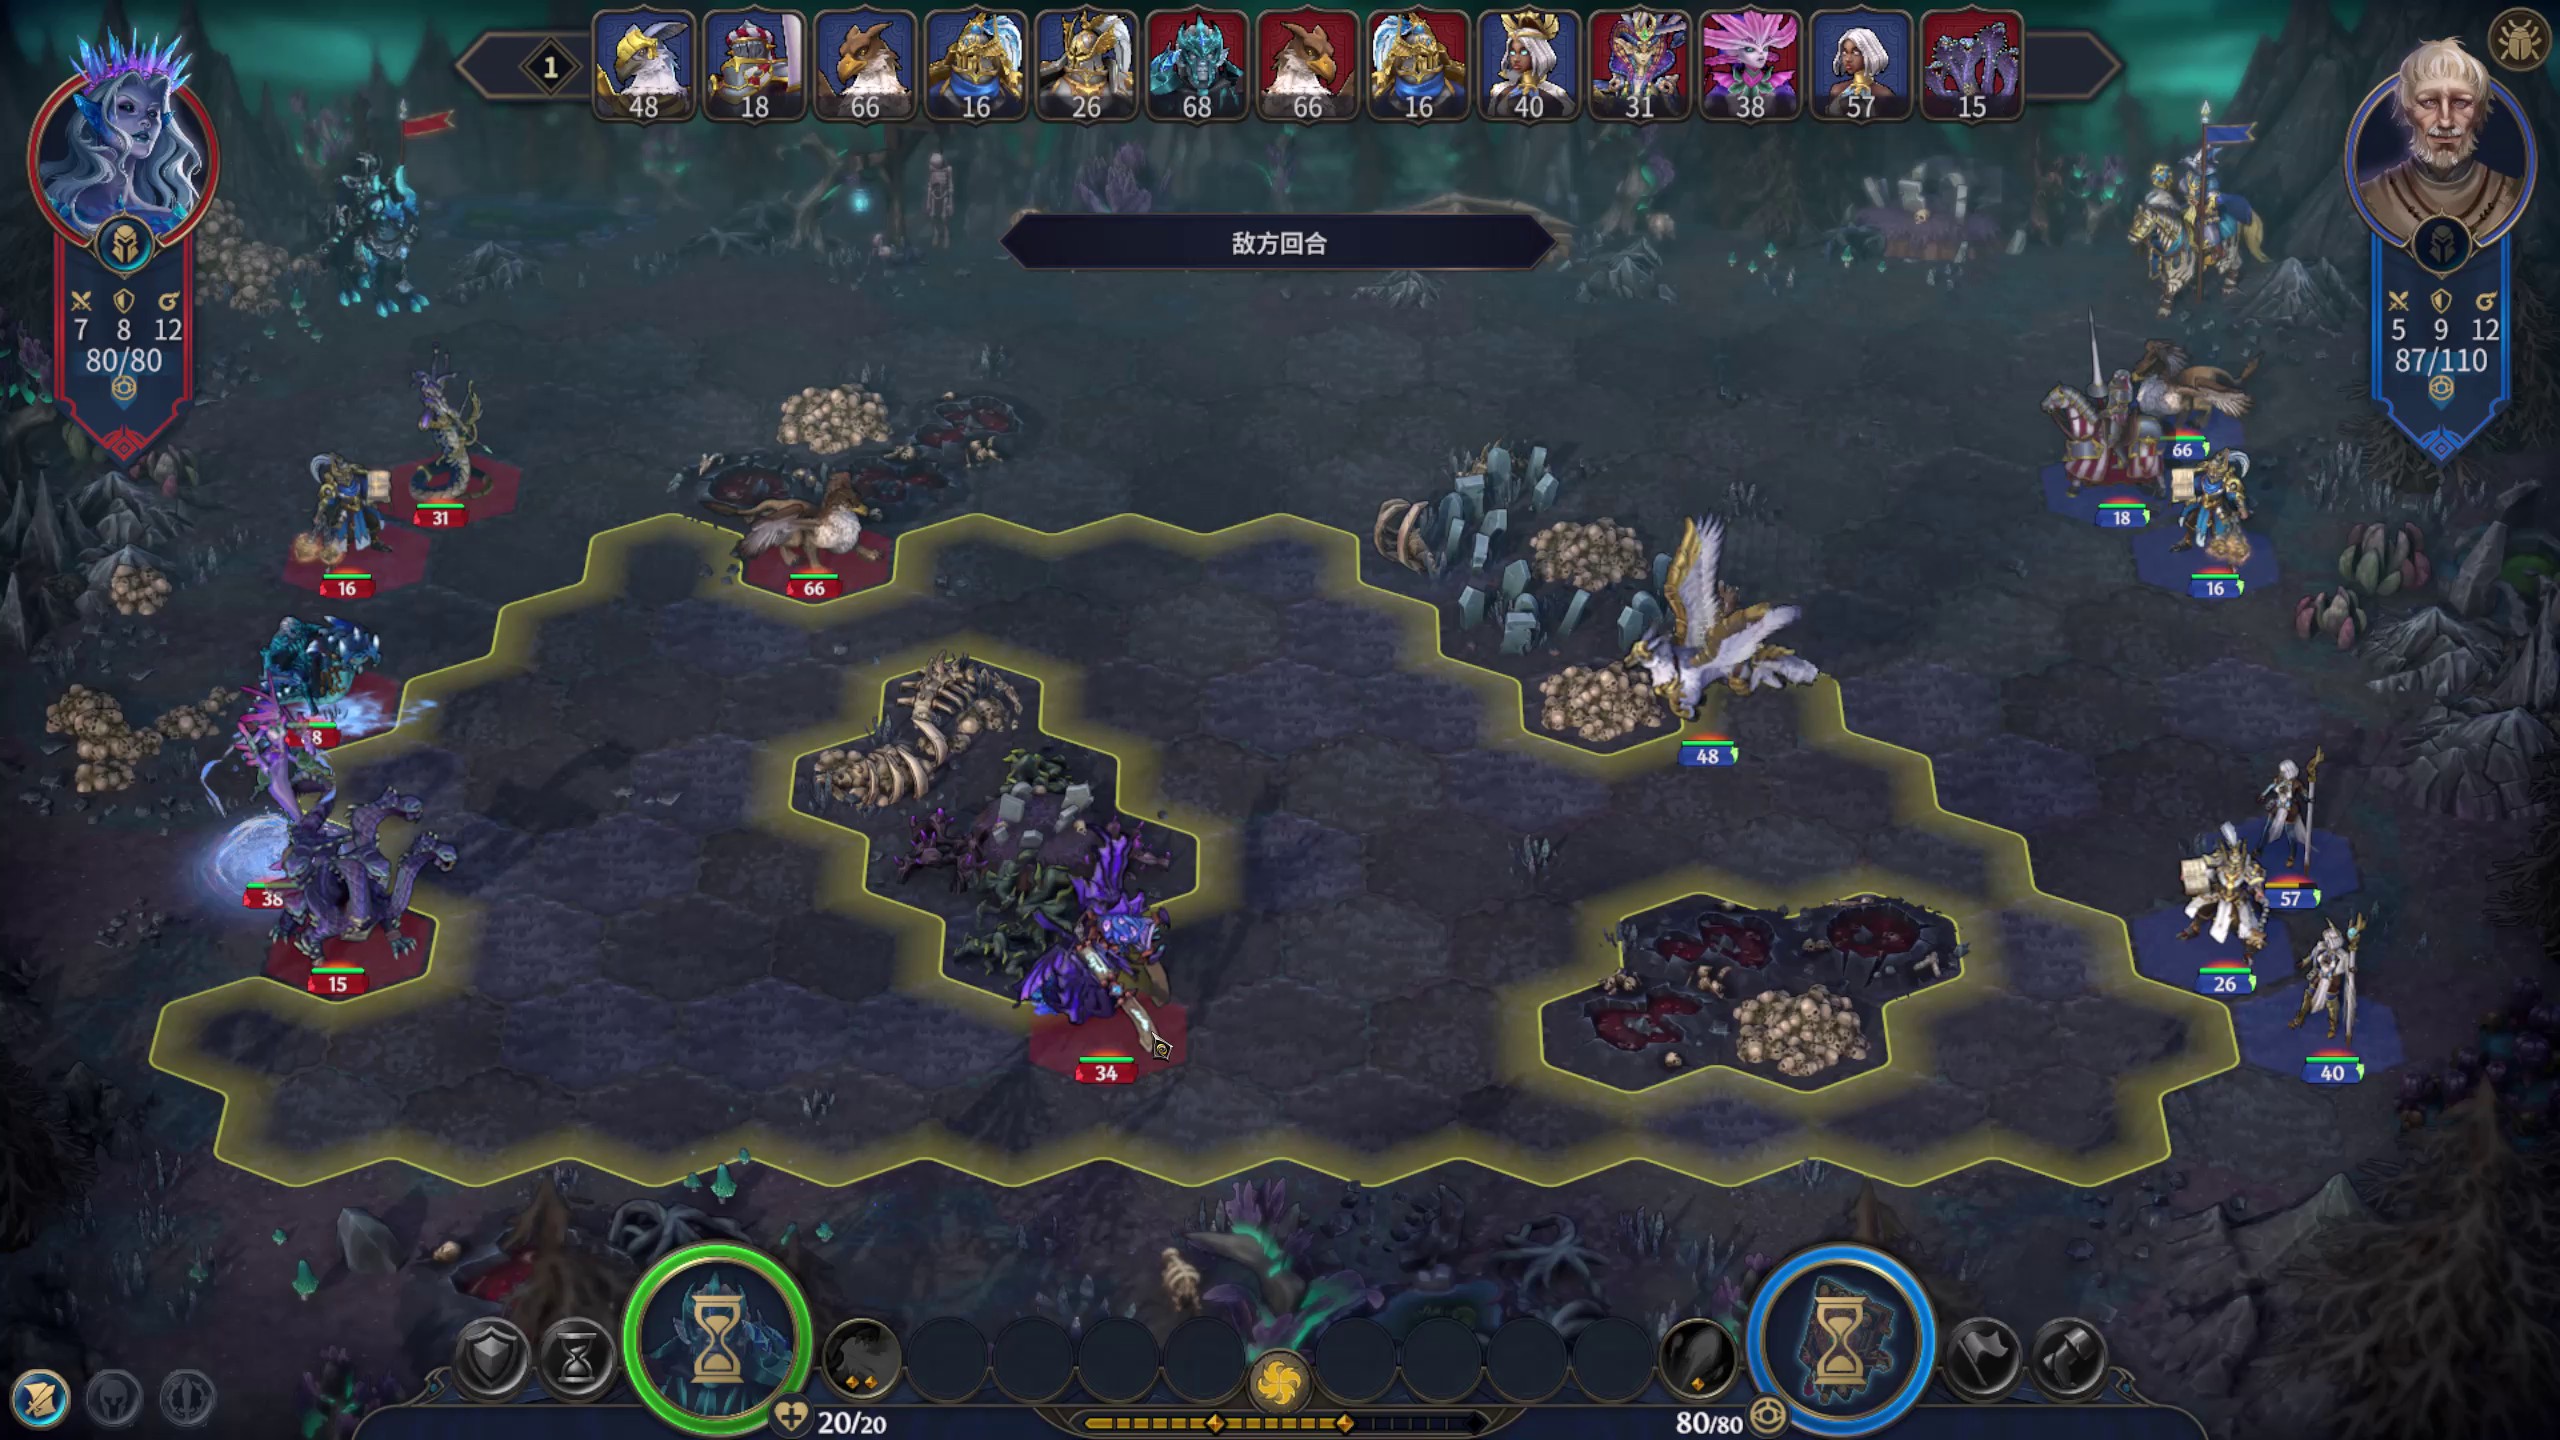
历史规则匹配文字:敌方回合
查看历史预测与旧标签
历史 OCR 预测:战斗进行中。当时参考标签:战斗进行中(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 39 个 OCR 文本区域
1 | 48 | 16 | 26 | 15 | 18 | 68 | 31 | 57 | 16 | 40 | 38 | 66 | 66 | 敌方回合 | X I a | X① a | XIa | 5 9 12 | 7 8 12 | 80/80 | 87/110 | 66 | 31 | 18 | 16 | 66 | 16 | 8 | 48 | 0 一 | 38 | 57 | 15 | 26 | 34 | 40 | 80/80 | 20/20
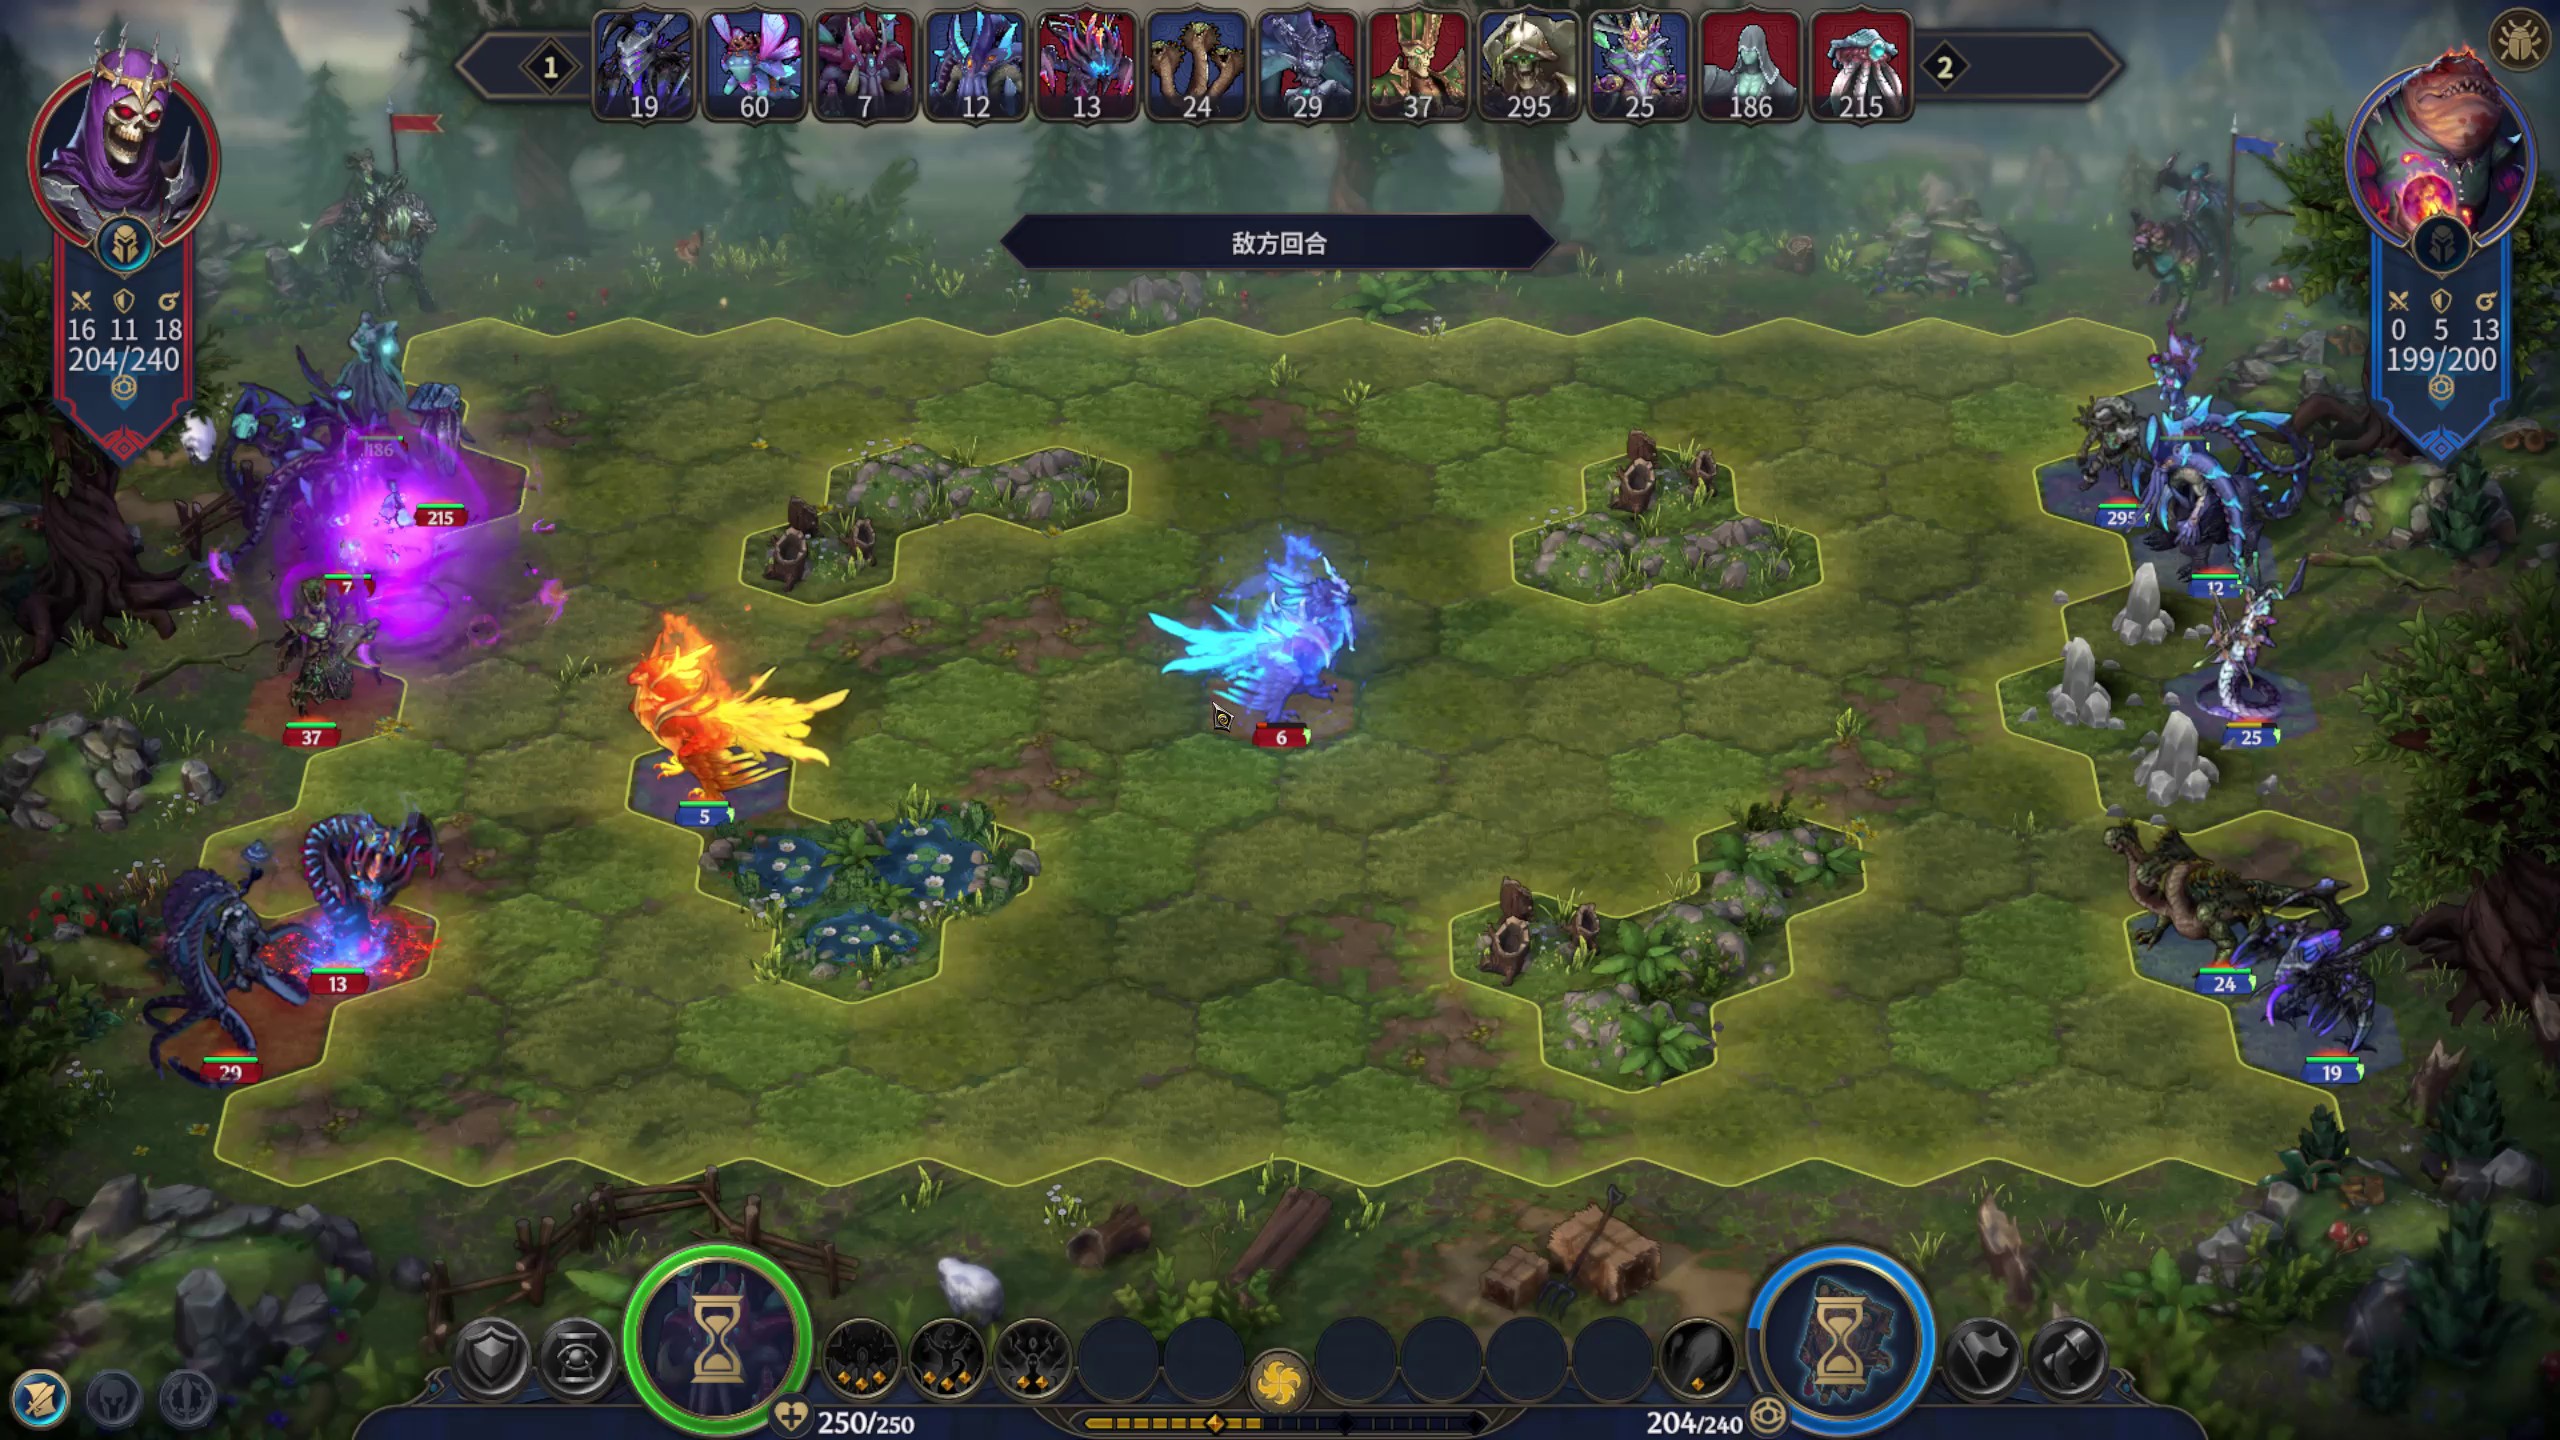
历史规则匹配文字:敌方回合
查看历史预测与旧标签
历史 OCR 预测:战斗进行中。当时参考标签:战斗进行中(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 33 个 OCR 文本区域
2 | 1 | 19 | 24 | 295 | 186 | 215 | 60 | 13 | 29 | 37 | 25 | 12 | 敌方回合 | X ① a | XIa | X I a | 0 5 13 | 16 11 18 | 204/240 | 199/200 | 186 | 215 | 295 | 37 | 25 | 6 | 5 | 13 | 24 | 19 | 250/250 | 204/240
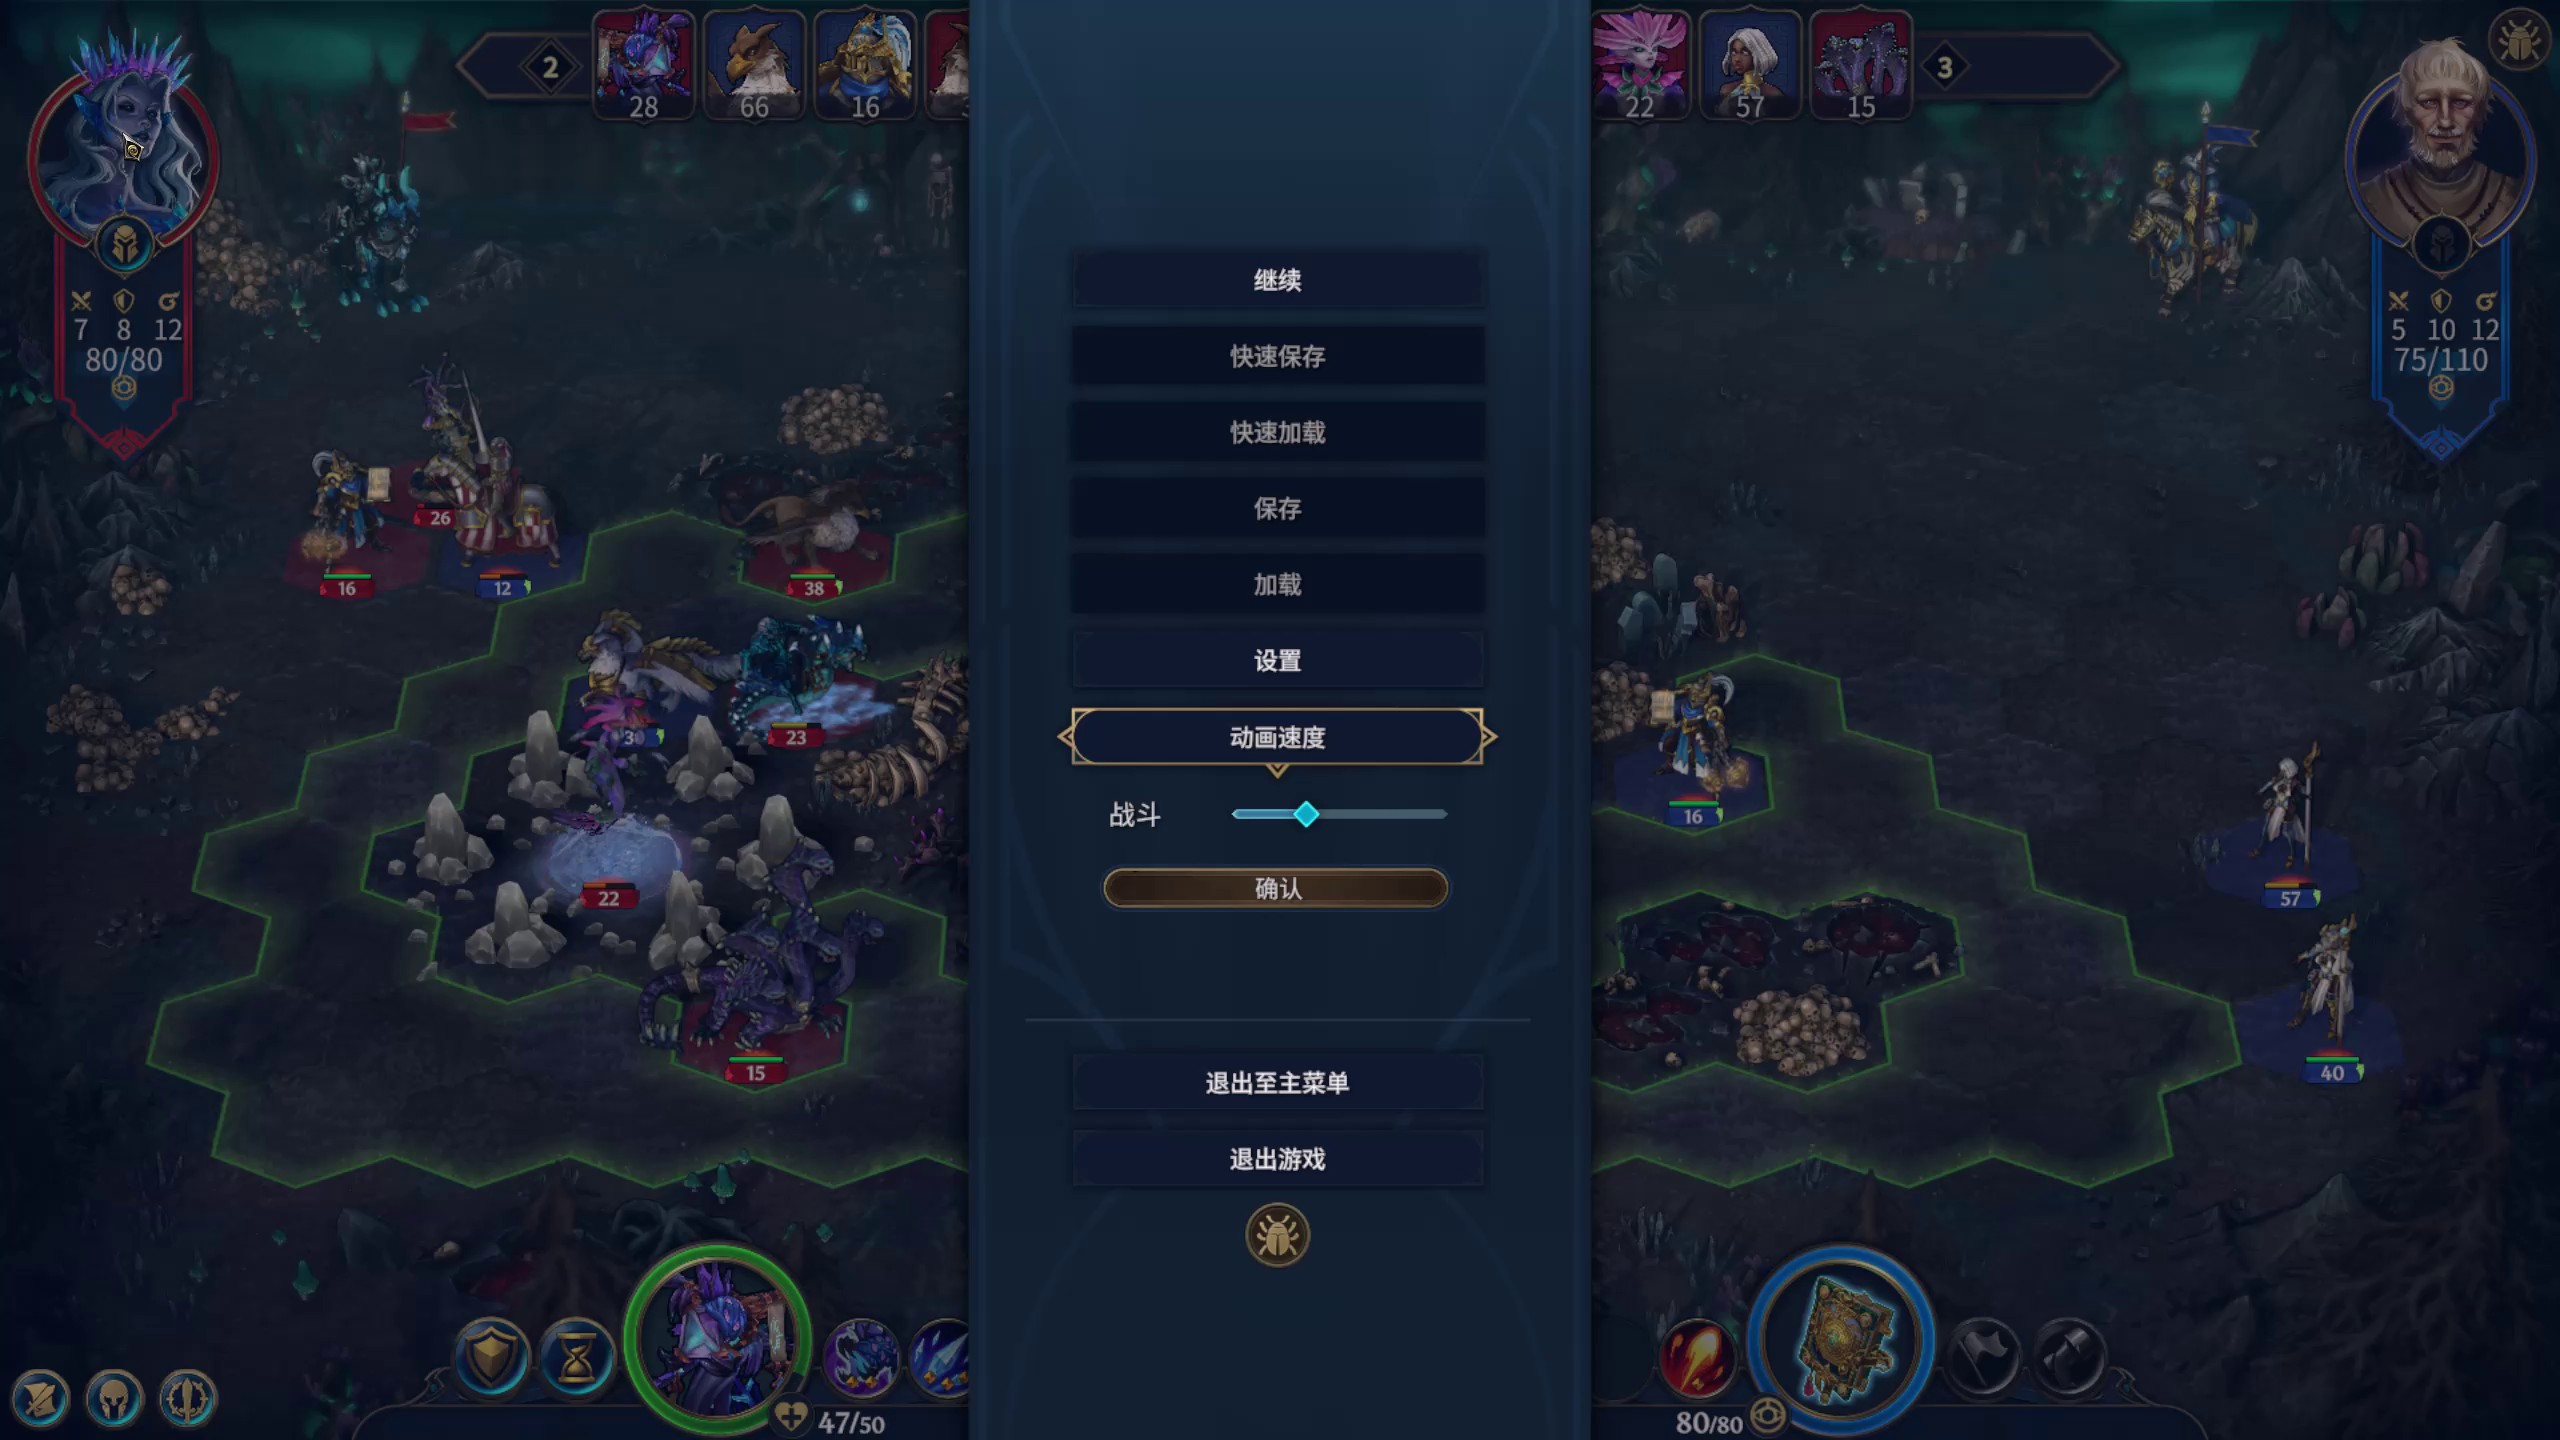
历史规则匹配文字:快速保存 · 退出至主菜单 · 退出游戏
查看历史预测与旧标签
历史 OCR 预测:暂停菜单。当时参考标签:战斗进行中(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 40 个 OCR 文本区域
3 | 2 | 28 | 15 | 57 | 16 | 66 | 22 | 继续 | XIa | XOa | a | X | G | 7 8 12 | 5 10 12 | 快速保存 | 80/80 | 75/110 | 快速加载 | 保存 | 26 | 加载 | 16 | 38 | 12 | 设置 | 动画速度 | 23 | 战斗 | 16 | 确认 | 22 | 57 | 40 | 15 | 退出至主菜单 | 退出游戏 | 47/50 | 80/80
魔法书浮层 · SPELLBOOK_OVERLAY 2 张示例
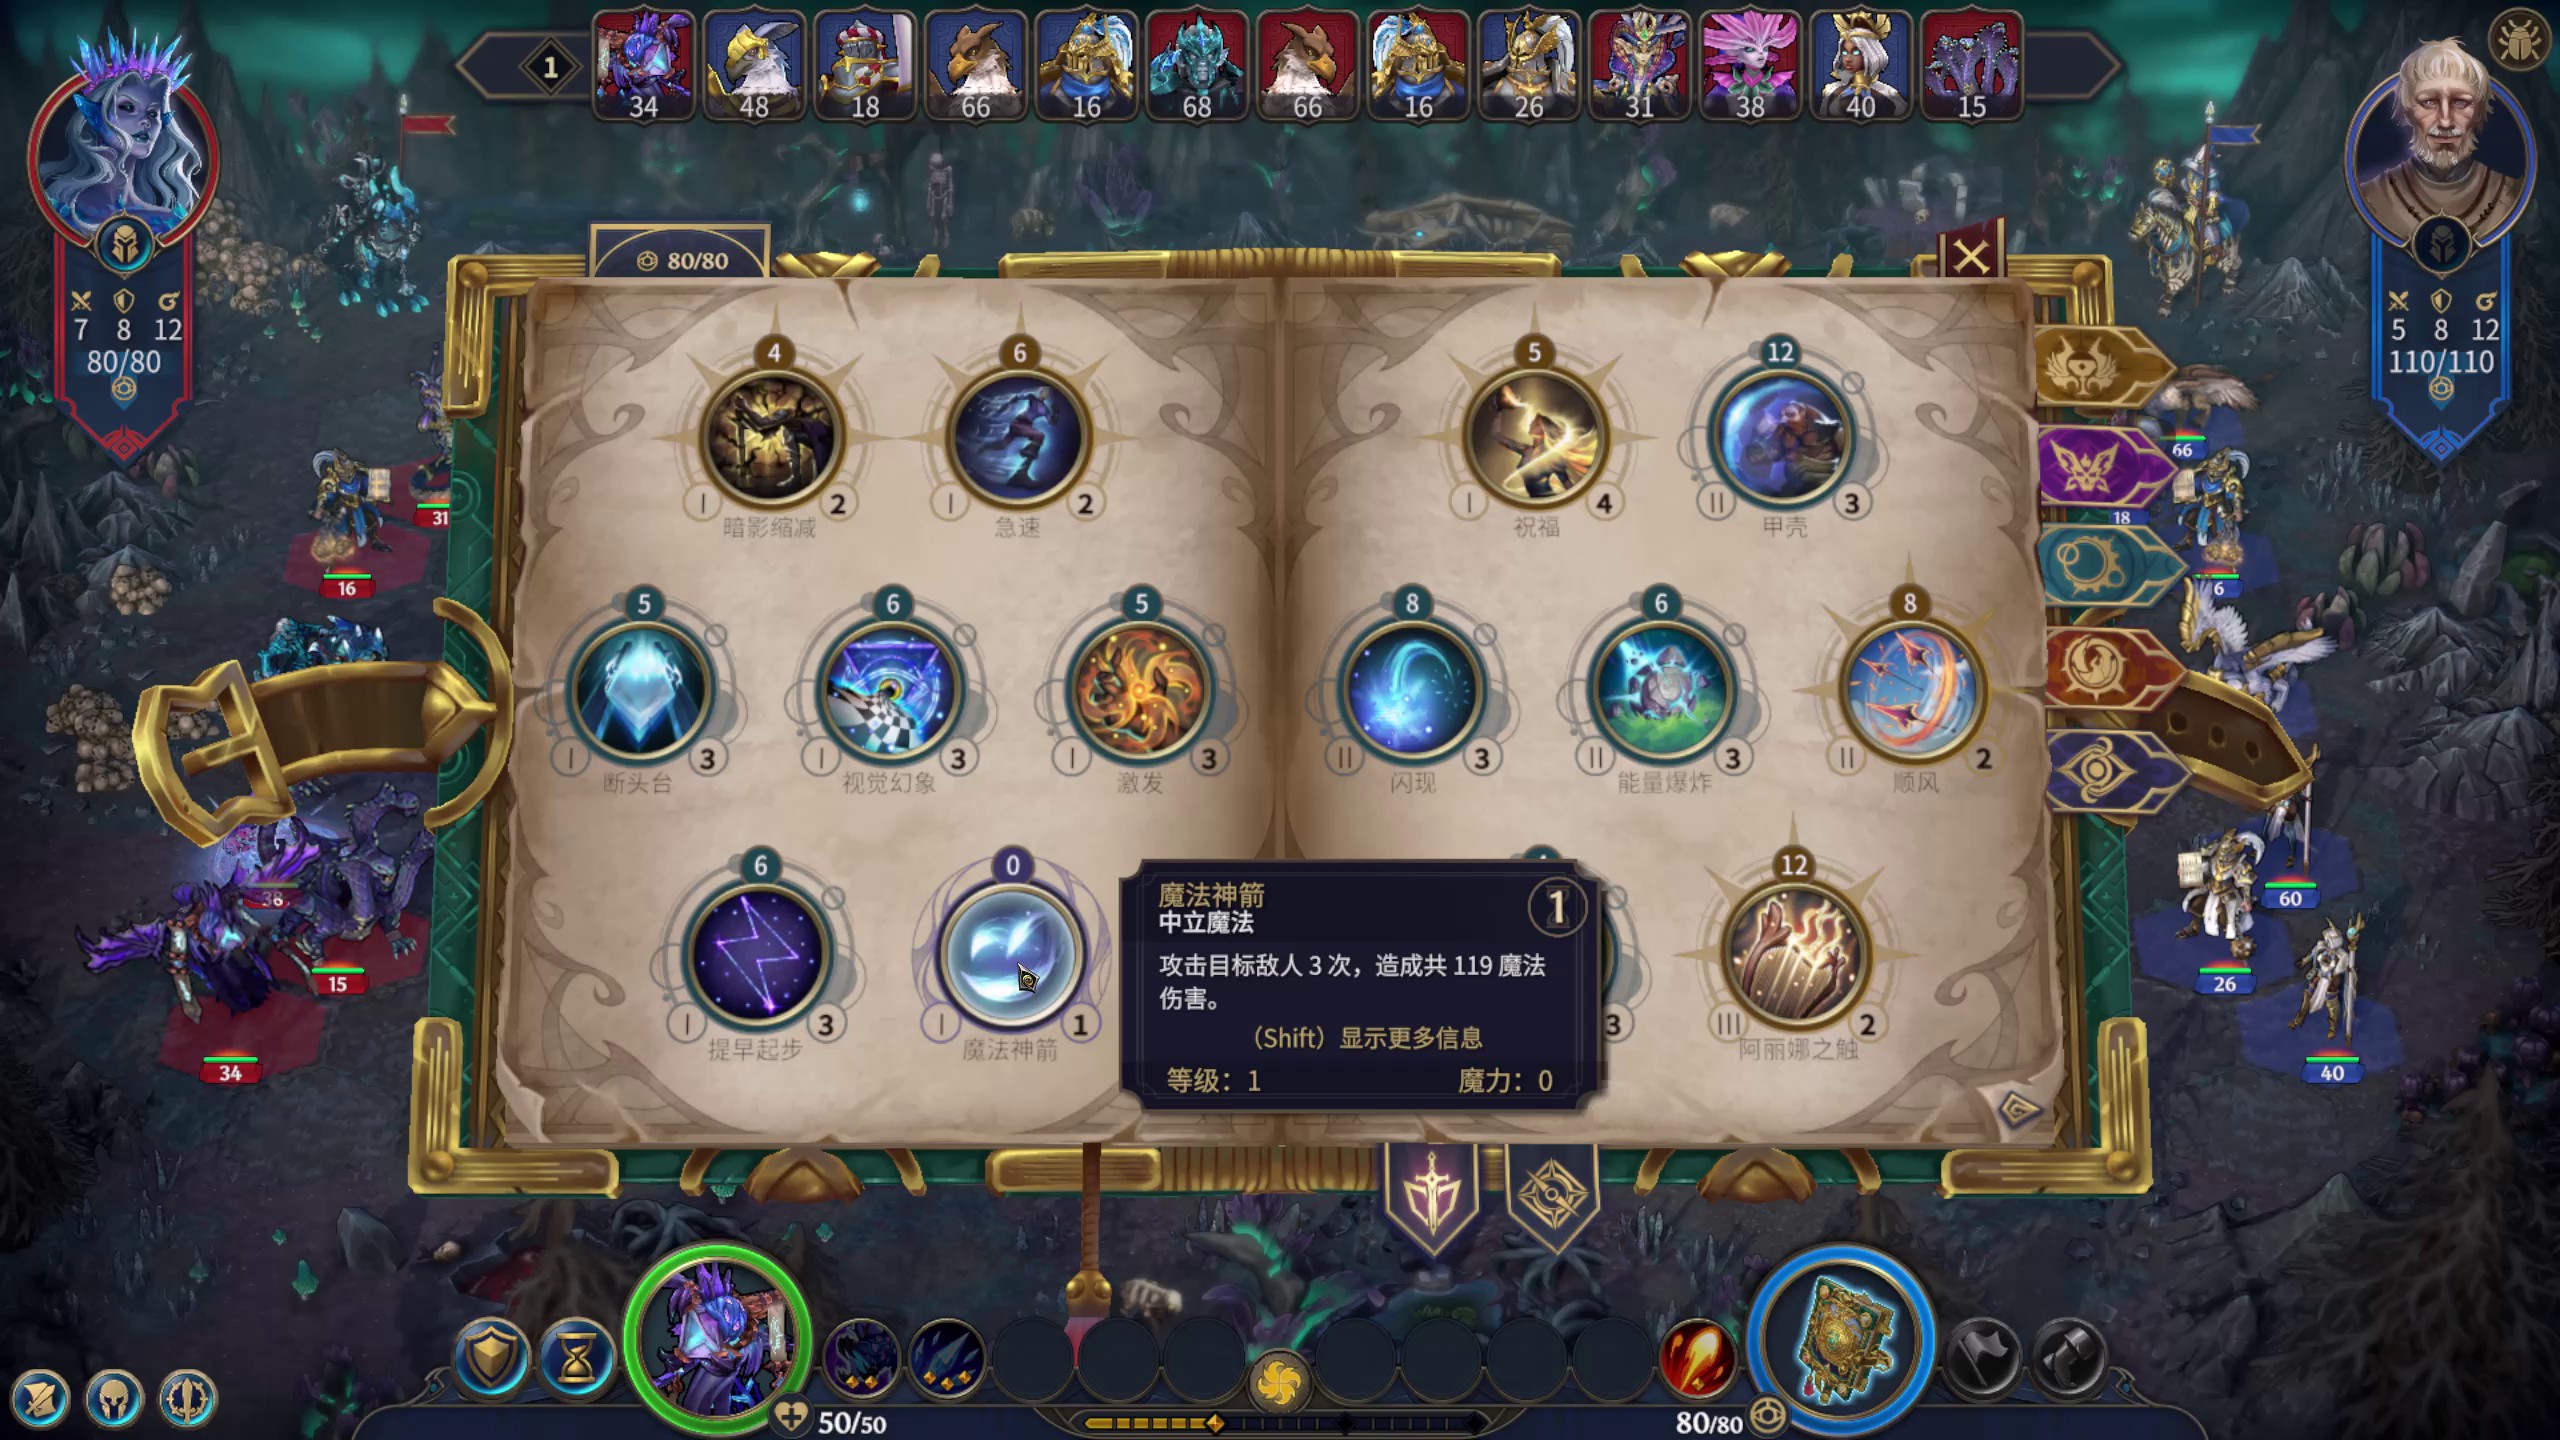
历史规则匹配文字:(Shift) 显示更多信息 · 等级:1
查看历史预测与旧标签
历史 OCR 预测:悬浮提示。当时参考标签:战斗进行中(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 95 个 OCR 文本区域
这产 00 、 | 1 | 34 | 16 | 16 | 26 | 15 | 48 | 18 | 68 | 31 | 38 | 40 | 66 | 66 | X | 80/80 | a | a | X | G | X | 5 8 12 | 7 8 12 | 12 | 5 | 6 | 4 | 80/80 | 110/110 | 66 | 11 | 4 | 3 | 2 | 2 | 31 | 18 | 祝福 | 甲壳 | 急速 | 暗影缩减 | 16 | 6 | 8 | 5 | 5 | 8 | 6 | 6 | 3 | 3 | 3 | II | 11 | 3 | 3 | 2 | II | 闪现 | 断头台 | 能量爆炸 | 激发 | 顺风 | 视觉幻象 | 12 | 0 | 6 | 魔法神箭 | 1 | 60 | 38 | 中立魔法 | 攻击目标敌人3次,造成共119魔法 | 丶一 | 15 | 26 | 伤害。 | 1 | 2 | 3 | 3 | (Shift) 显示更多信息 | (Shift) | 显示更多信息 | 提早起步 | 阿丽娜之触 | 魔法神箭 | 34 | 等级:1 | 40 | 魔力:0 | 彎 00 | 50/50 | 80/80
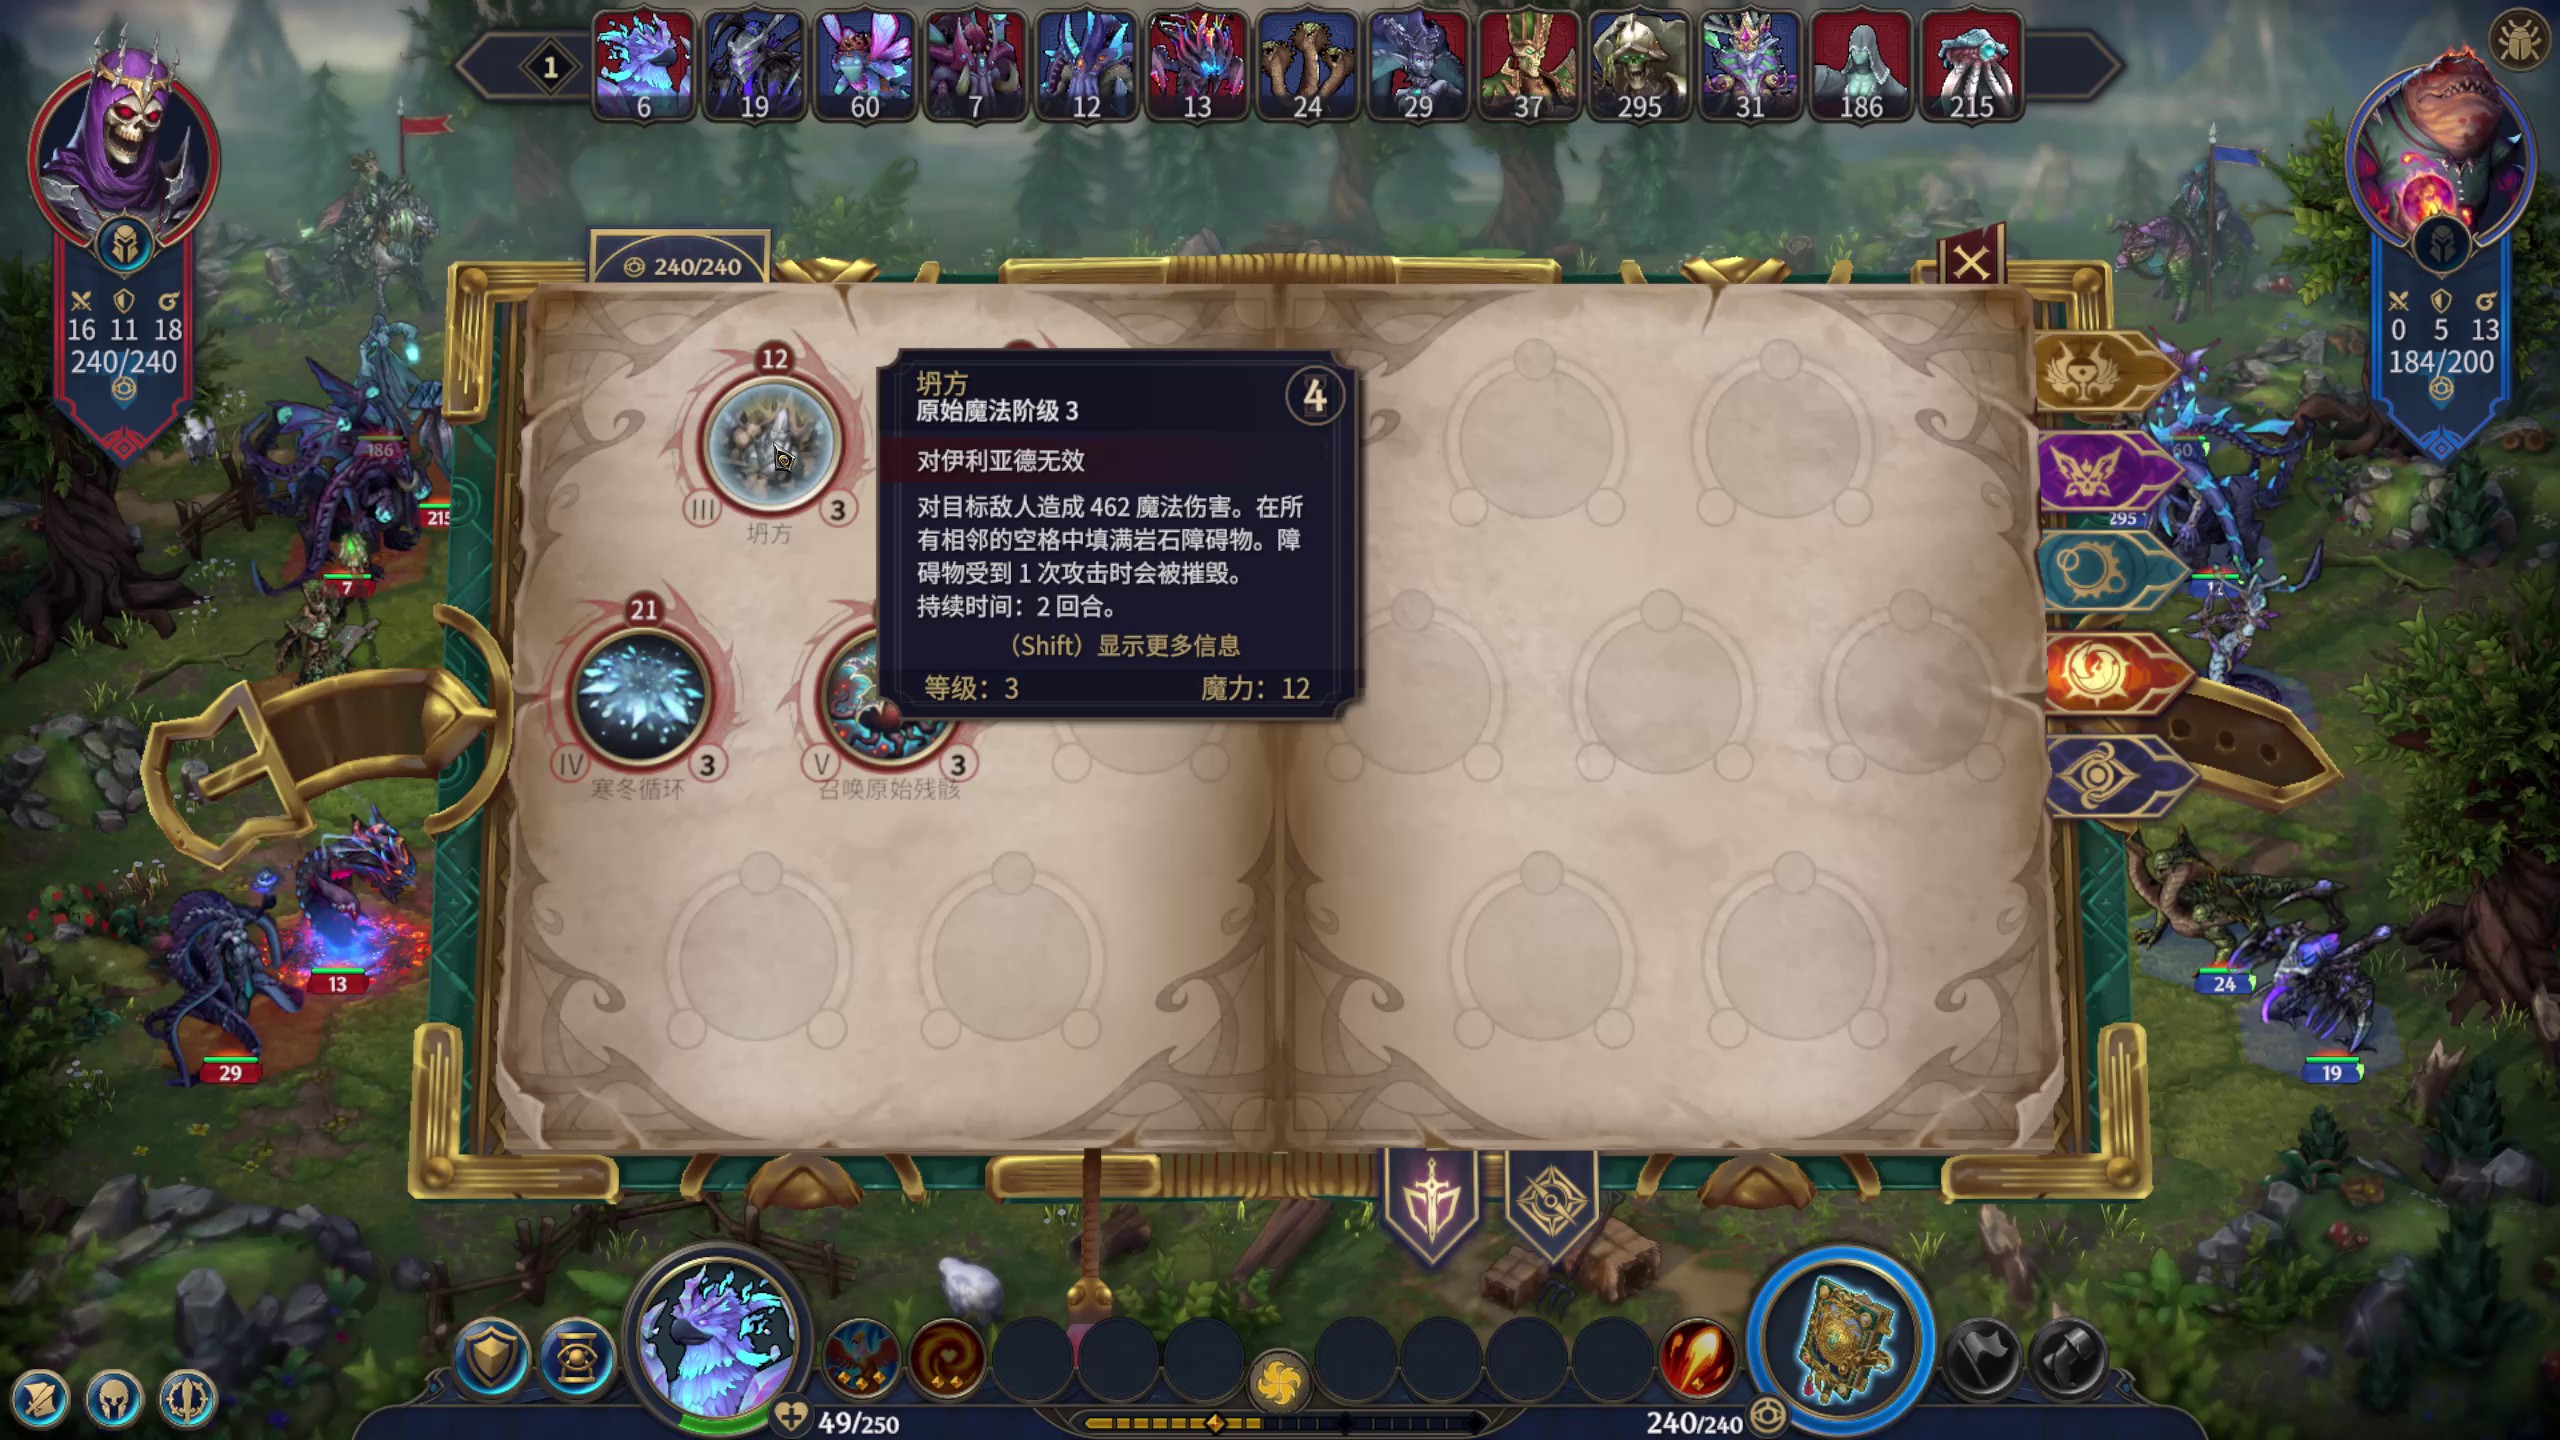
历史规则匹配文字:(Shift) 显示更多信息 · 等级:3
查看历史预测与旧标签
历史 OCR 预测:悬浮提示。当时参考标签:战斗进行中(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 60 个 OCR 文本区域
“ 0 冲小 | 1 | 19 | 60 | 13 | 24 | 37 | 295 | 186 | 215 | 12 | 29 | 31 | 6 | X | 240/240 | ' 然 ` . | X① a | Xa | XIa | 0 5 13 | 16 11 18 | 12 | 240/240 | 184/200 | 坍方 | 4 | 原始魔法阶级3 | 186 | 60 | 对伊利亚德无效 | 对目标敌人造成462魔法伤害。在所 | 3 | 215 | 295 | 坍方 | 有相邻的空格中填满岩石障碍物。障 | 碍物受到1次攻击时会被摧毁。 | 持续时间:2回合。 | . 0 | 21 | (Shift) | (Shift) 显示更多信息 | 显示更多信息 | 等级:3 | 魔力:12 | V | 3 | 3 | IV | 寒冬循环 | 召唤原始残骸 | 13 | 24 | 29 | 19 | 丿、 | ,亠 49 / | 49/250 | 240/240
英雄信息浮层 · HERO_INFO 2 张示例
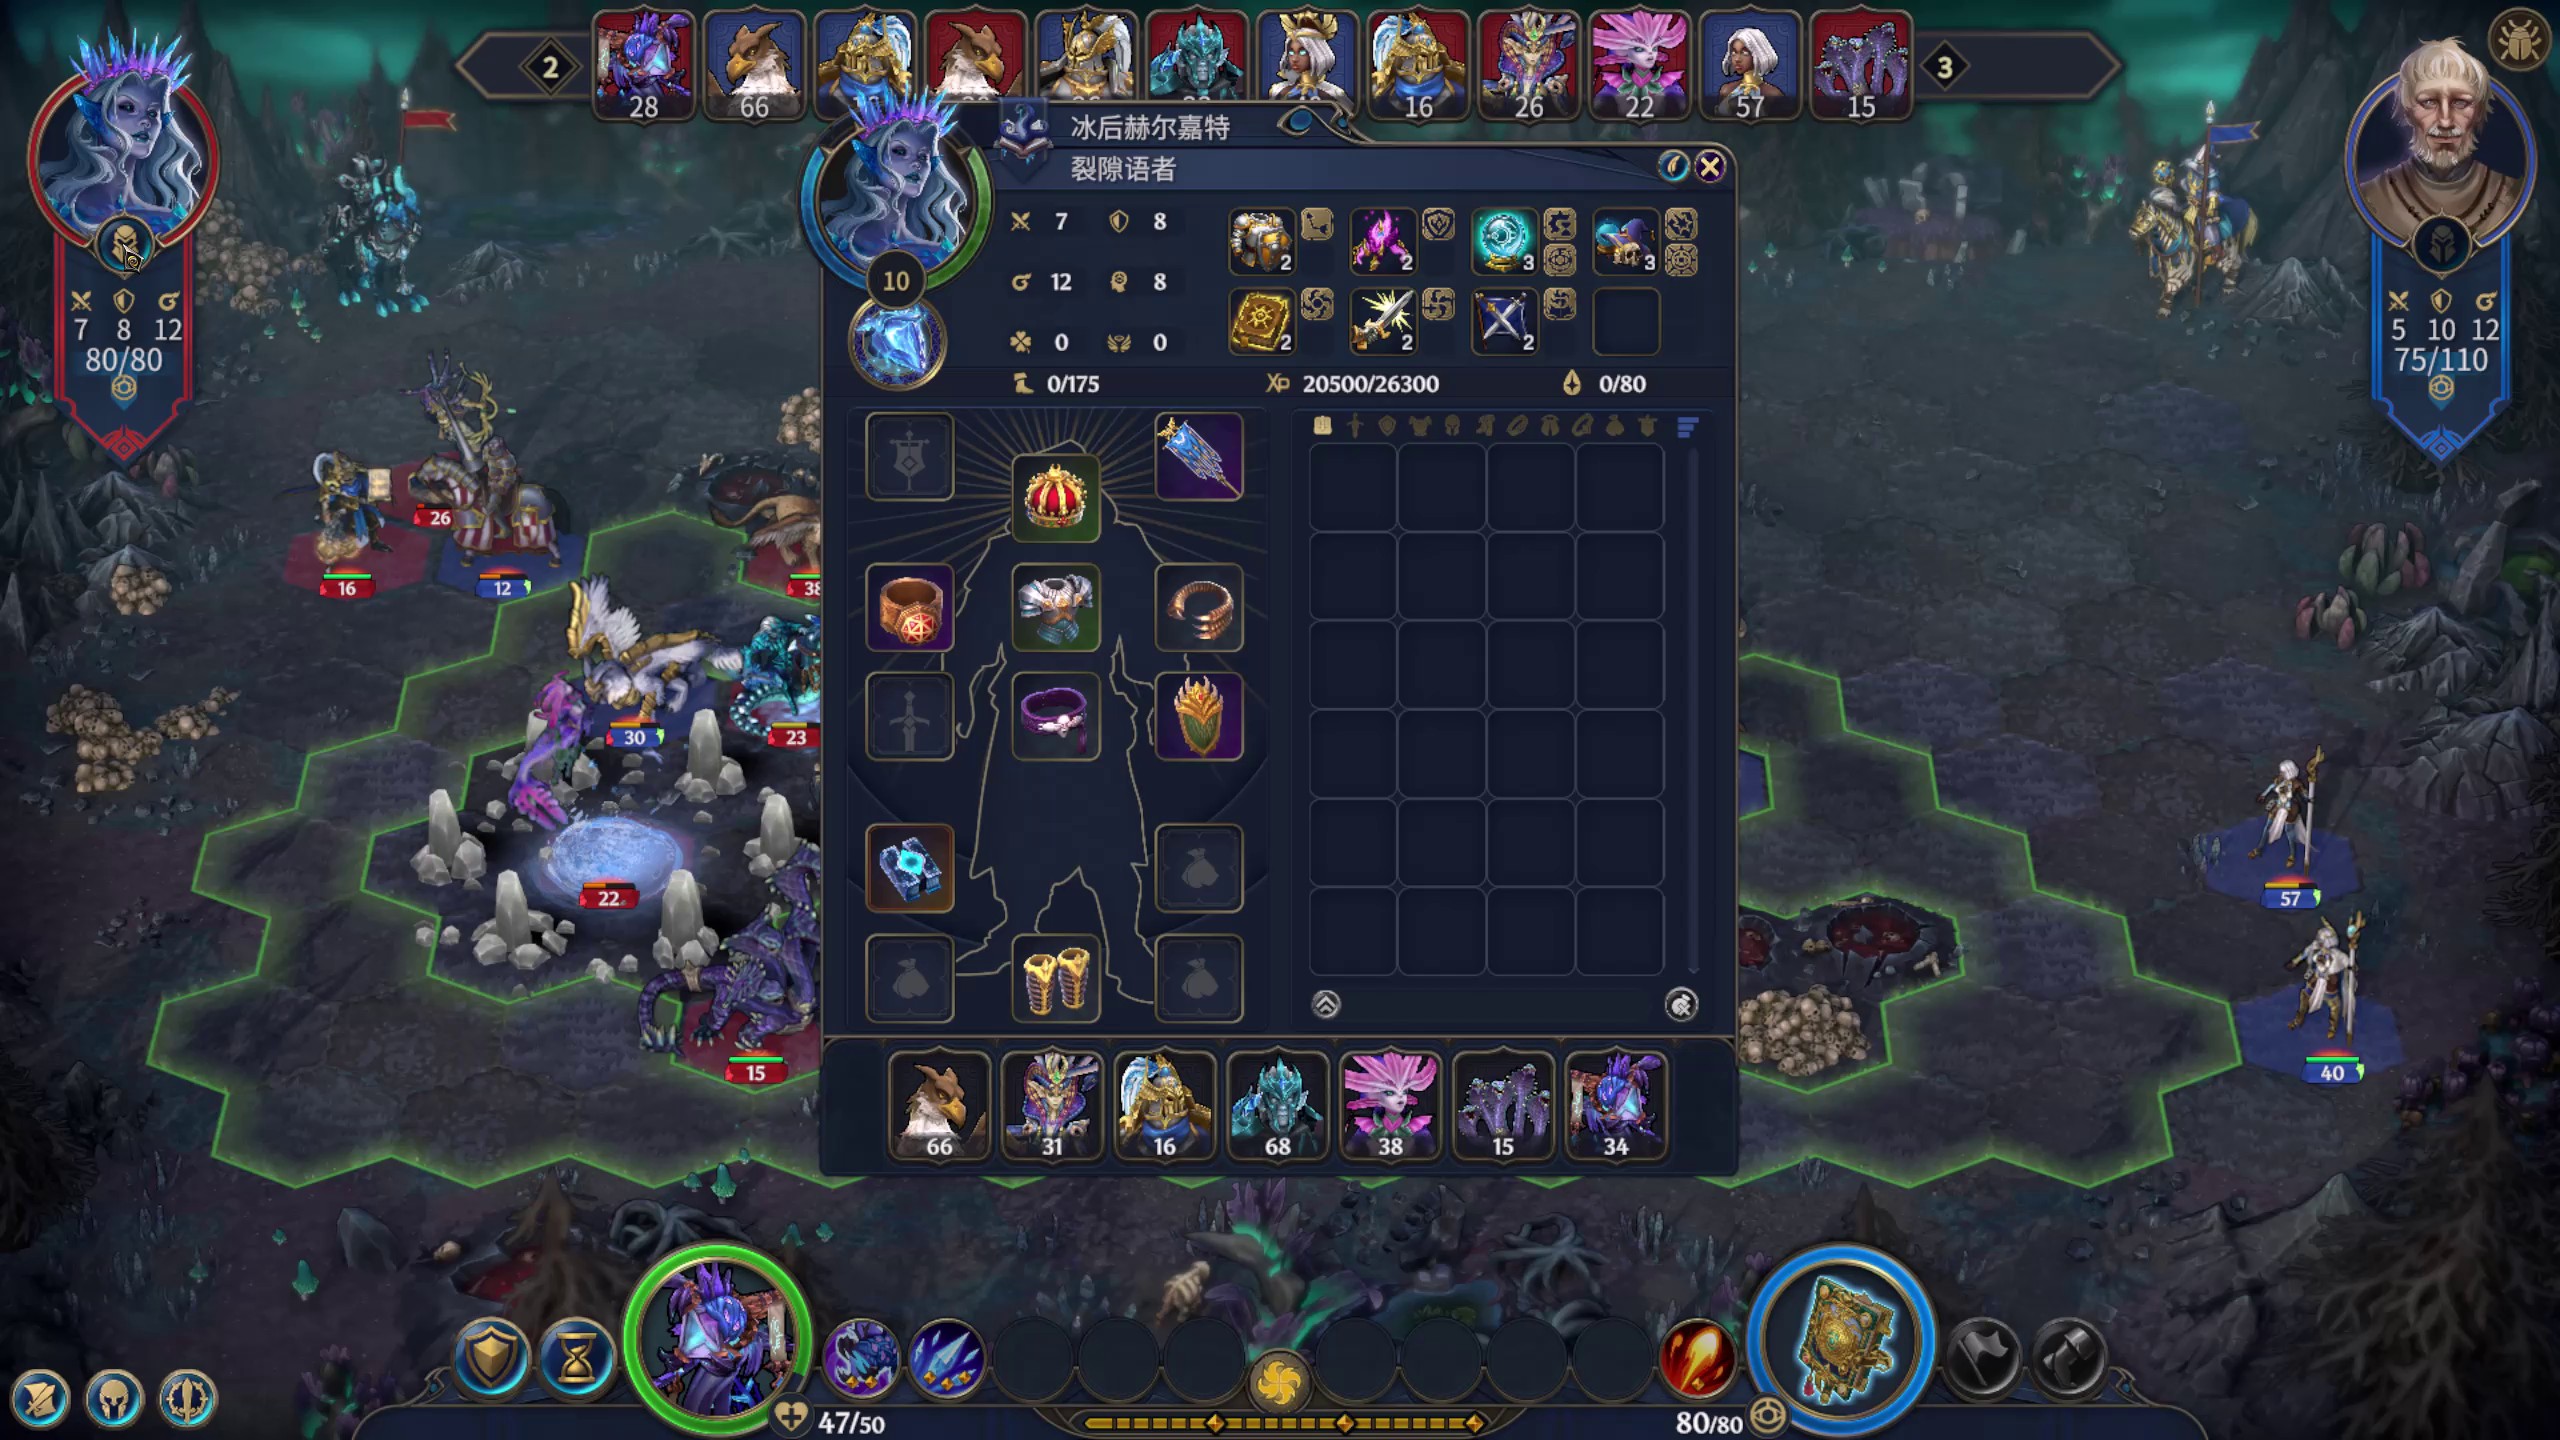
历史规则匹配文字:冰后赫尔嘉特 · 裂隙语者
查看历史预测与旧标签
历史 OCR 预测:英雄信息浮层。当时参考标签:战斗进行中(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 64 个 OCR 文本区域
2 | 3 | 28 | 16 | 57 | 15 | 26 | 22 | 66 | 5 | 冰后赫尔嘉特 | 裂隙语者 | X | × 7 . 8 | 8 | 7 | X | 5 | 2 | 3 | 3 | 10 | G12 | 12 | G | 8 | 3 | XI a | X | Xa | XI a | 5 | 7 8 12 | 5 10 12 | 0 | 2 | 0 | 2 | 2 | 80/80 | 75/110 | X 20500/26300 | 0/175 | 0/80 | 26 | 38 | 16 | 12 | 30 | 23 | 22 | 57 | C | 40 | 15 | 16 | 15 | 66 | 31 | 68 | 38 | 34 | 80/80 | 47/50
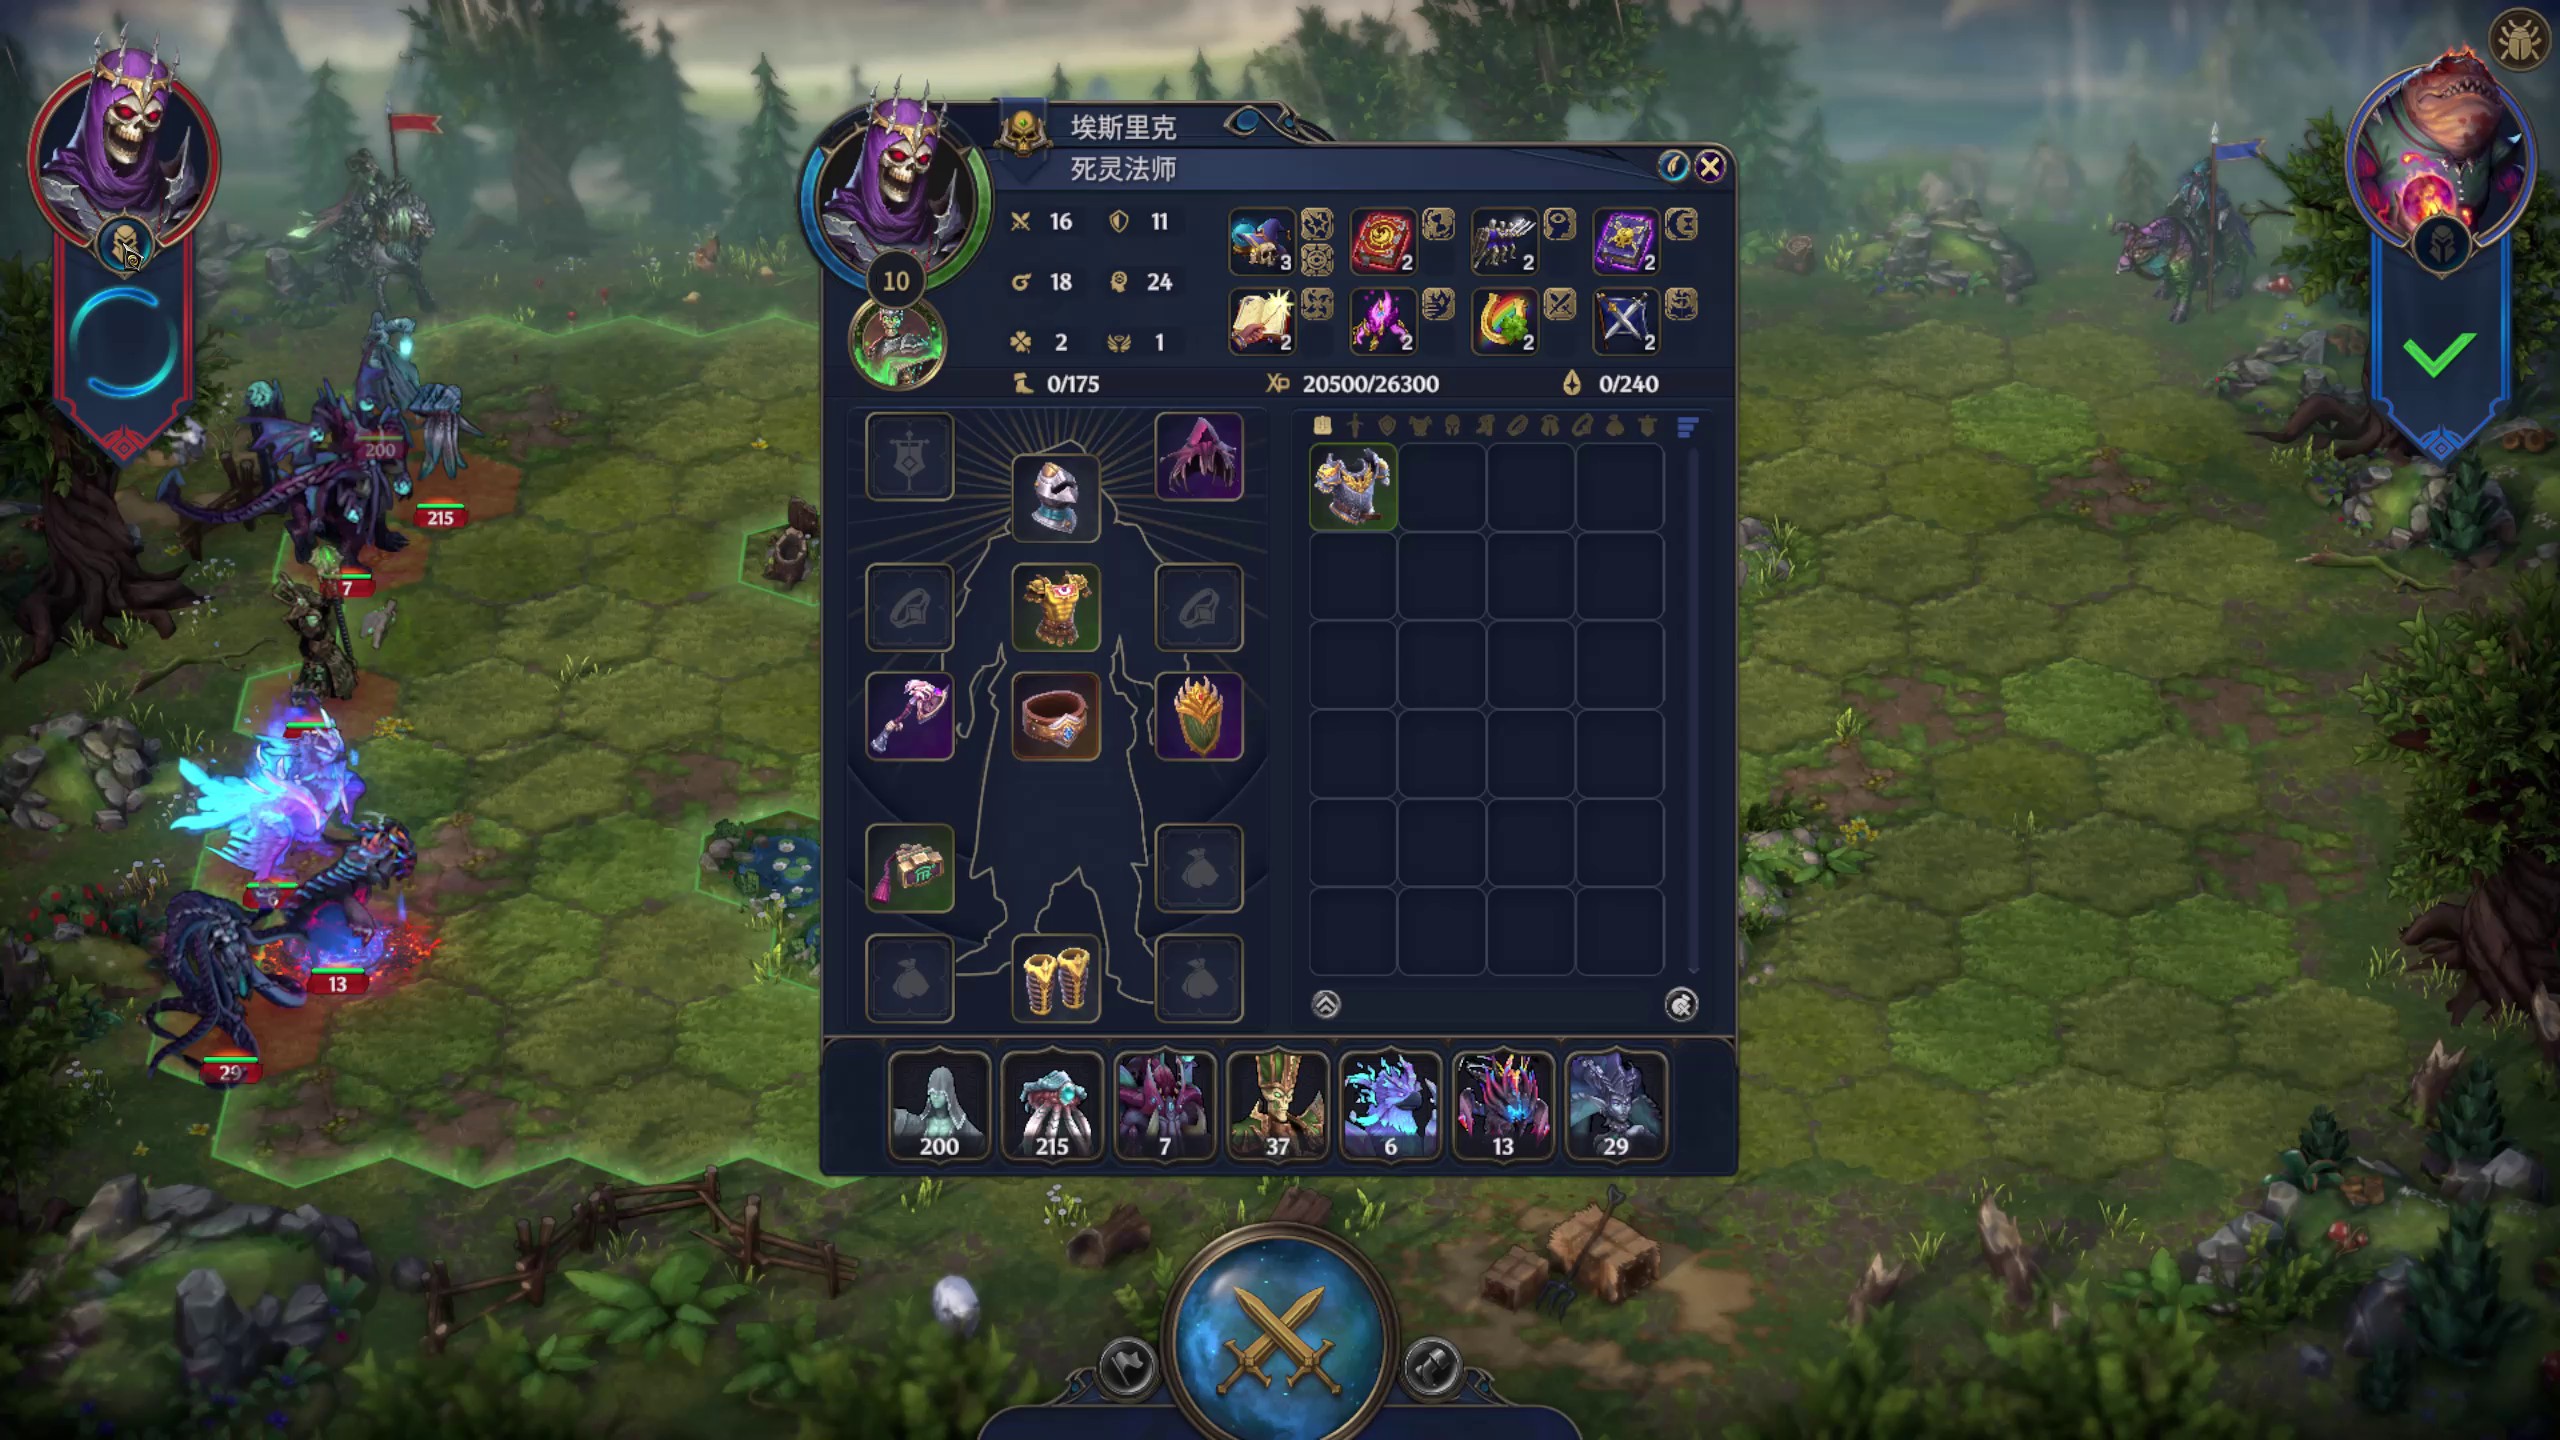
历史规则匹配文字:埃斯里克 · 死灵法师
查看历史预测与旧标签
历史 OCR 预测:英雄信息浮层。当时参考标签:排兵布阵(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 32 个 OCR 文本区域
埃斯里克 | 死灵法师 | X | 16 | 16 | 11 | 3 | 2 | 10 | G 18 | 24 | 18 24 | 24 | 2 | 2 | 2 | X 20500/26300 | 0/175 | 0/240 | 200 | 215 | 0 同/ 0 | 7 | 13 | C | 29 | 215 | 13 | 200 | 29 | 37 | 2
生物信息浮层 · CREATURE_INFO 2 张示例
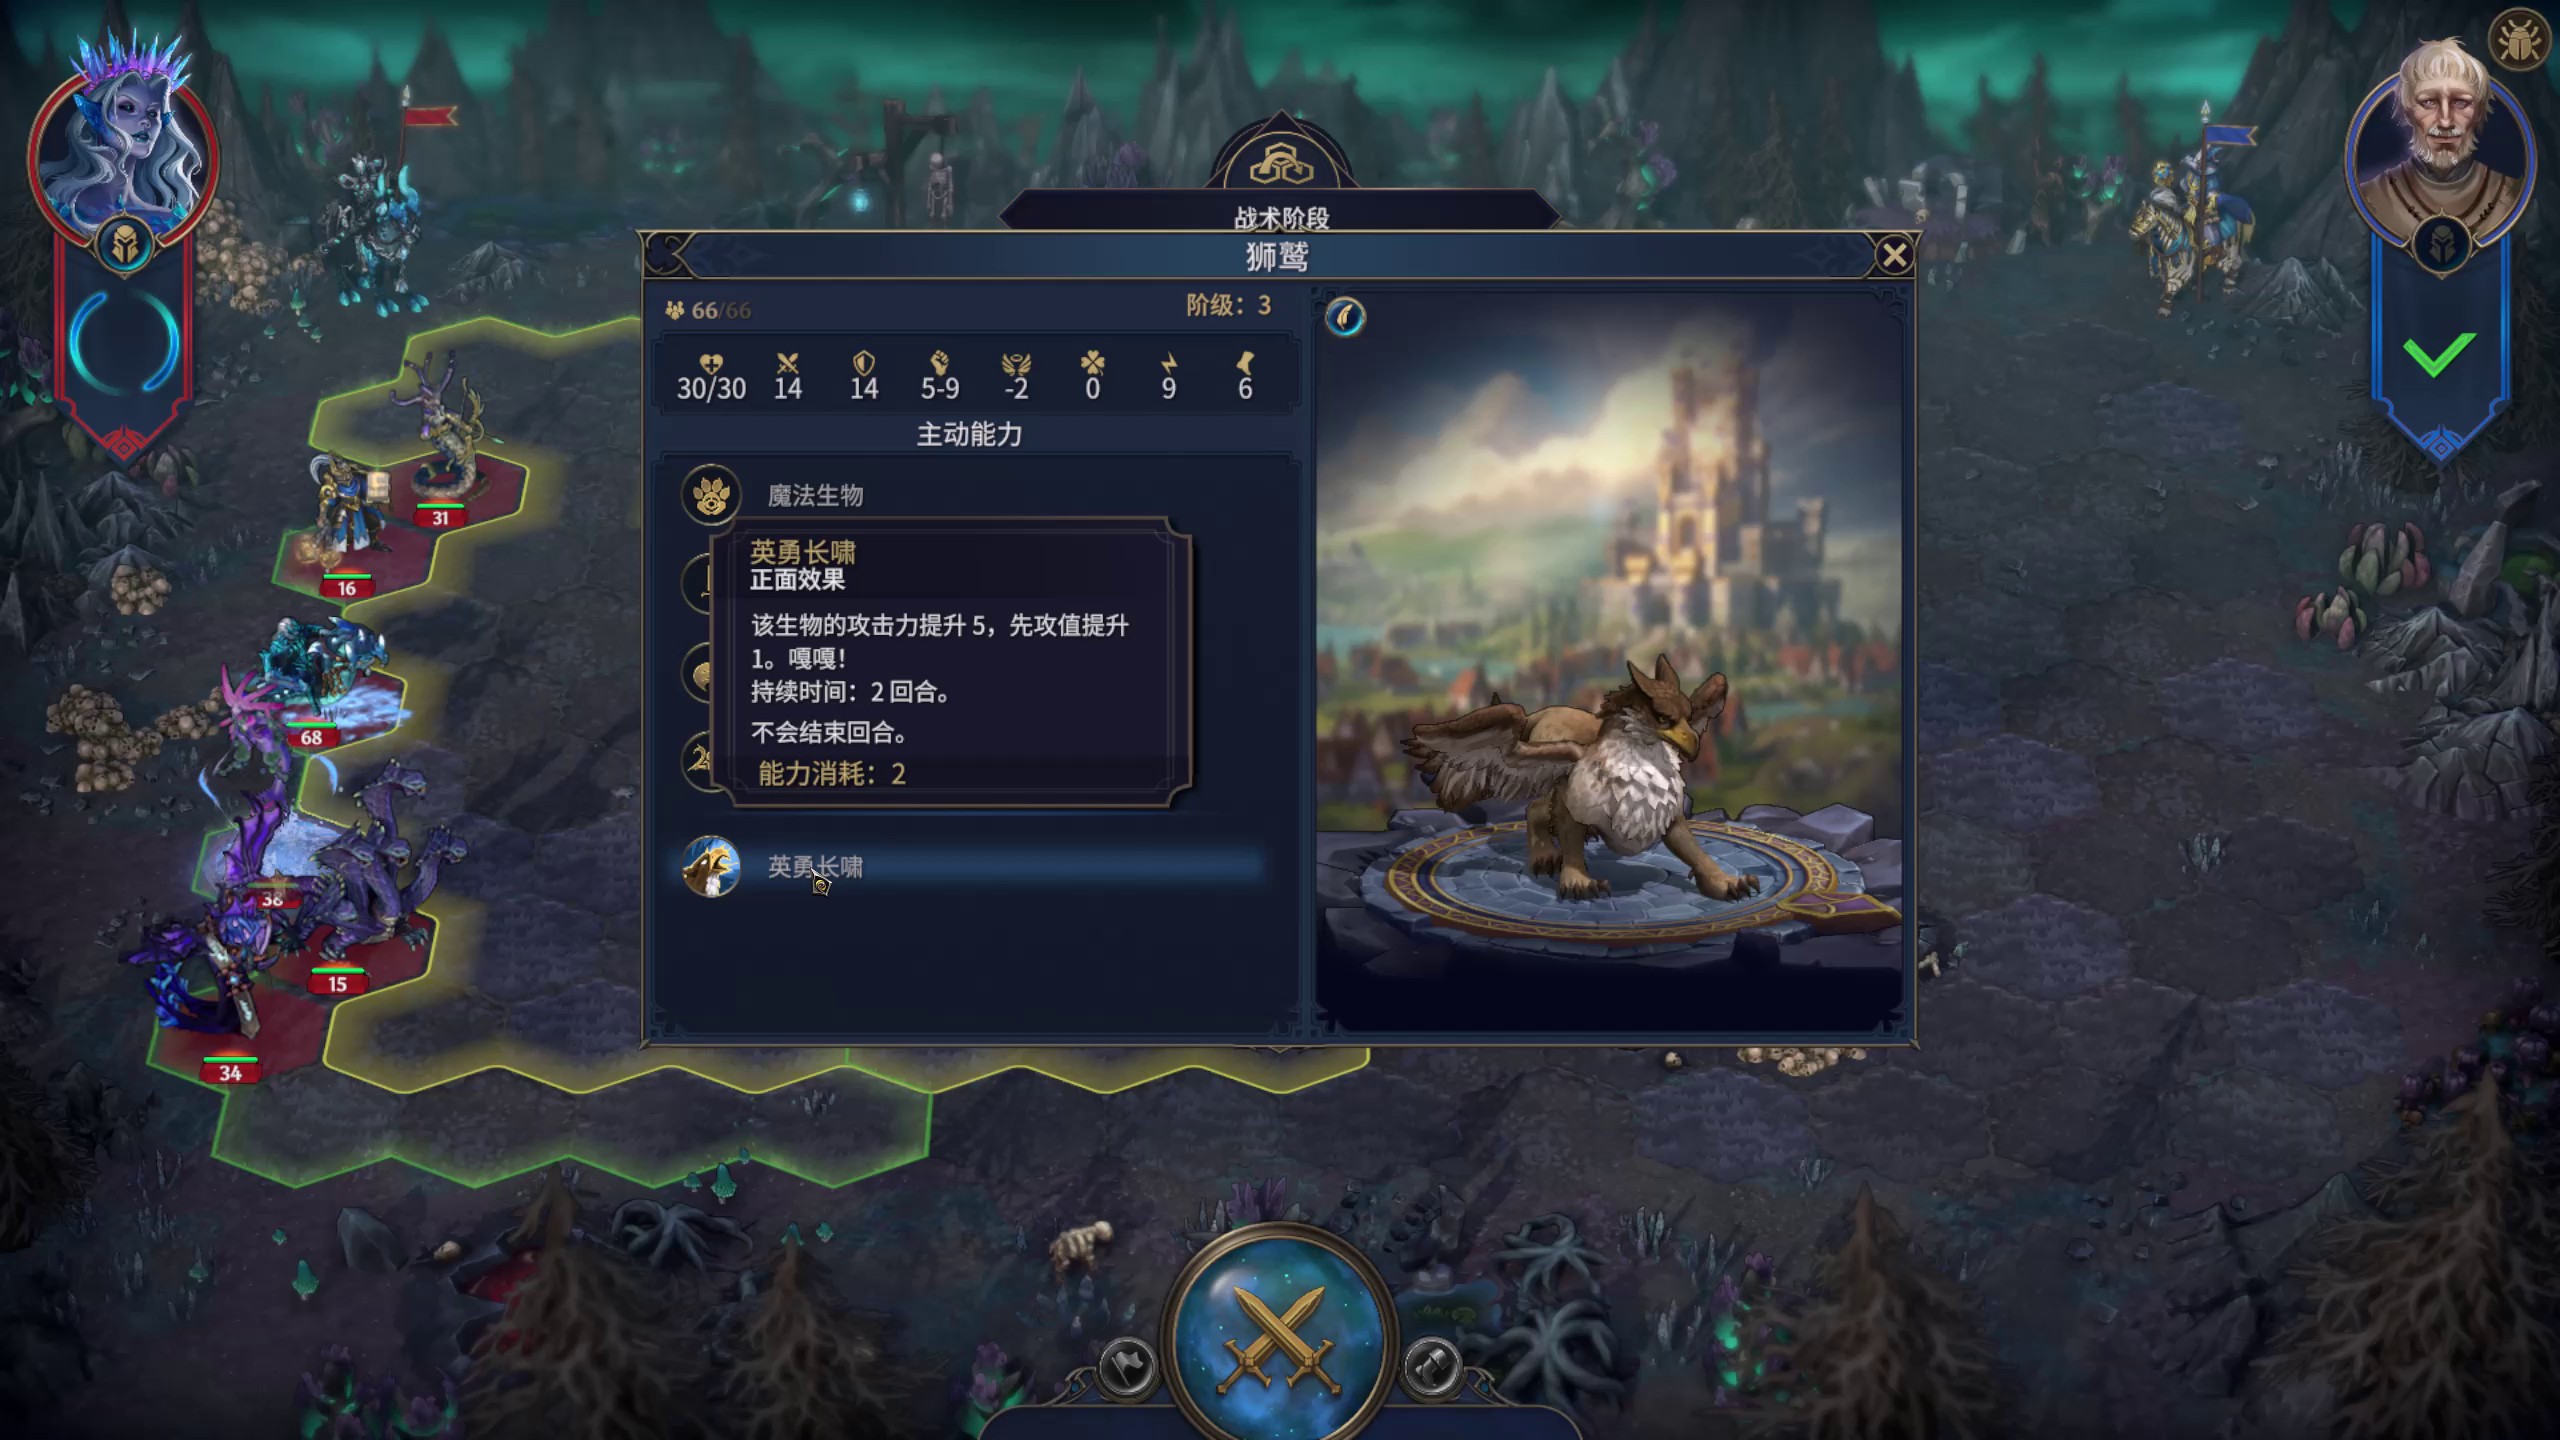
历史规则匹配文字:战术阶段 · 阶级:3 · 主动能力
查看历史预测与旧标签
历史 OCR 预测:生物信息浮层。当时参考标签:排兵布阵(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 31 个 OCR 文本区域
战术阶段 | 狮鹭 | 狮鹫 | 阶级:3 | 66/66 | 30/30 | 14 | 5-9 | 0 | 14 | 9 | 6 | 主动能力 | 魔法生物 | 、 | 31 | 、 | 、一 | 英勇长啸 | 正面效果 | 16 | 该生物的攻击力提升5,先攻值提升 | 1。嘎嘎! | 持续时间:2回合。 | 不会结束回合。 | 68 | 能力消耗:2 | 英勇长啸 | 38 | 15 | 34
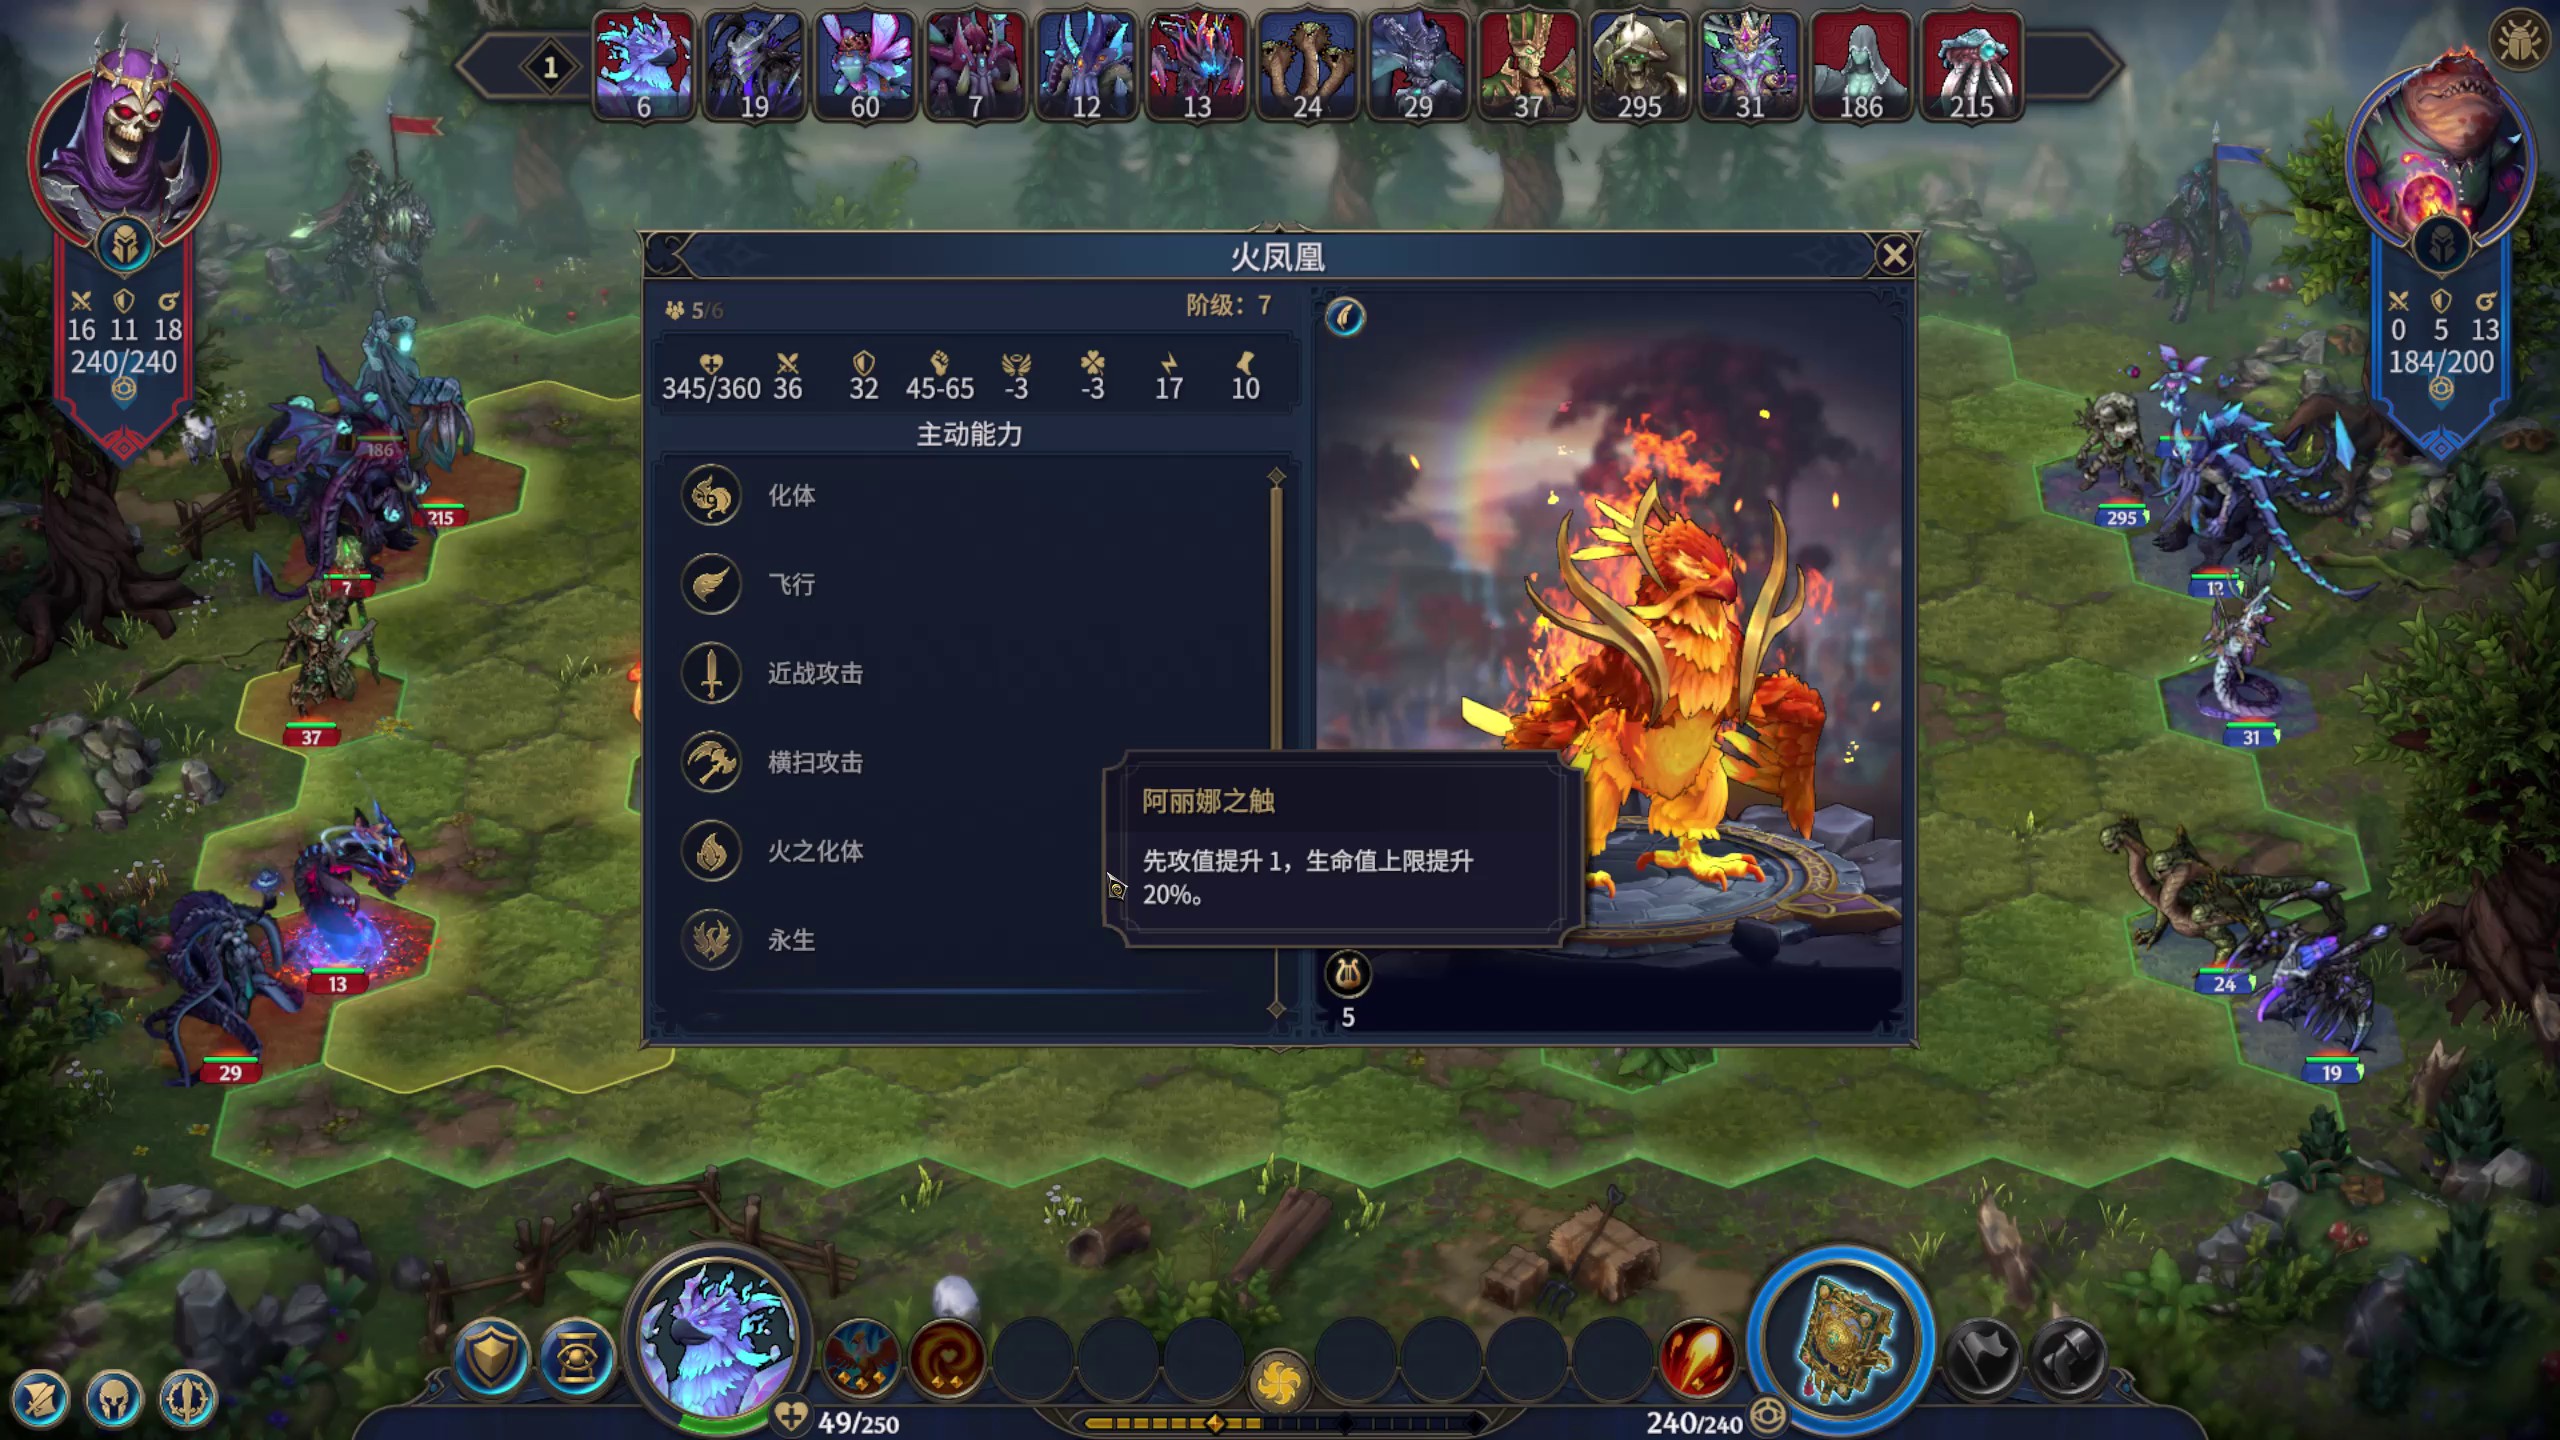
历史规则匹配文字:阶级:7 · 主动能力
查看历史预测与旧标签
历史 OCR 预测:生物信息浮层。当时参考标签:战斗进行中(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 57 个 OCR 文本区域
1 | 19 | 13 | 24 | 295 | 186 | 215 | 60 | 29 | 37 | 31 | 12 | 火凤凰 | X a | XIa | XI a | 阶级:7 | 5/6 | 0 5 13 | 16 11 18 | 184/200 | 240/240 | X | X3 | 345/360 36 | 32 | 17 | 10 | 45-65 | -3 | -3 | 主动能力 | 186 | 化体 | 215 | 295 | 飞行 | 12 \ , | 近战攻击 | 37 | 31 | 横扫攻击 | 阿丽娜之触 | 今 | 火之化体 | 先攻值提升1,生命值上限提升 | 20%。 | 永生 | US | 13 | 24 | 5 | 29 | 19 | 亠 49 / | 49/250 | 240/240
战斗日志浮层 · BATTLE_LOG 2 张示例
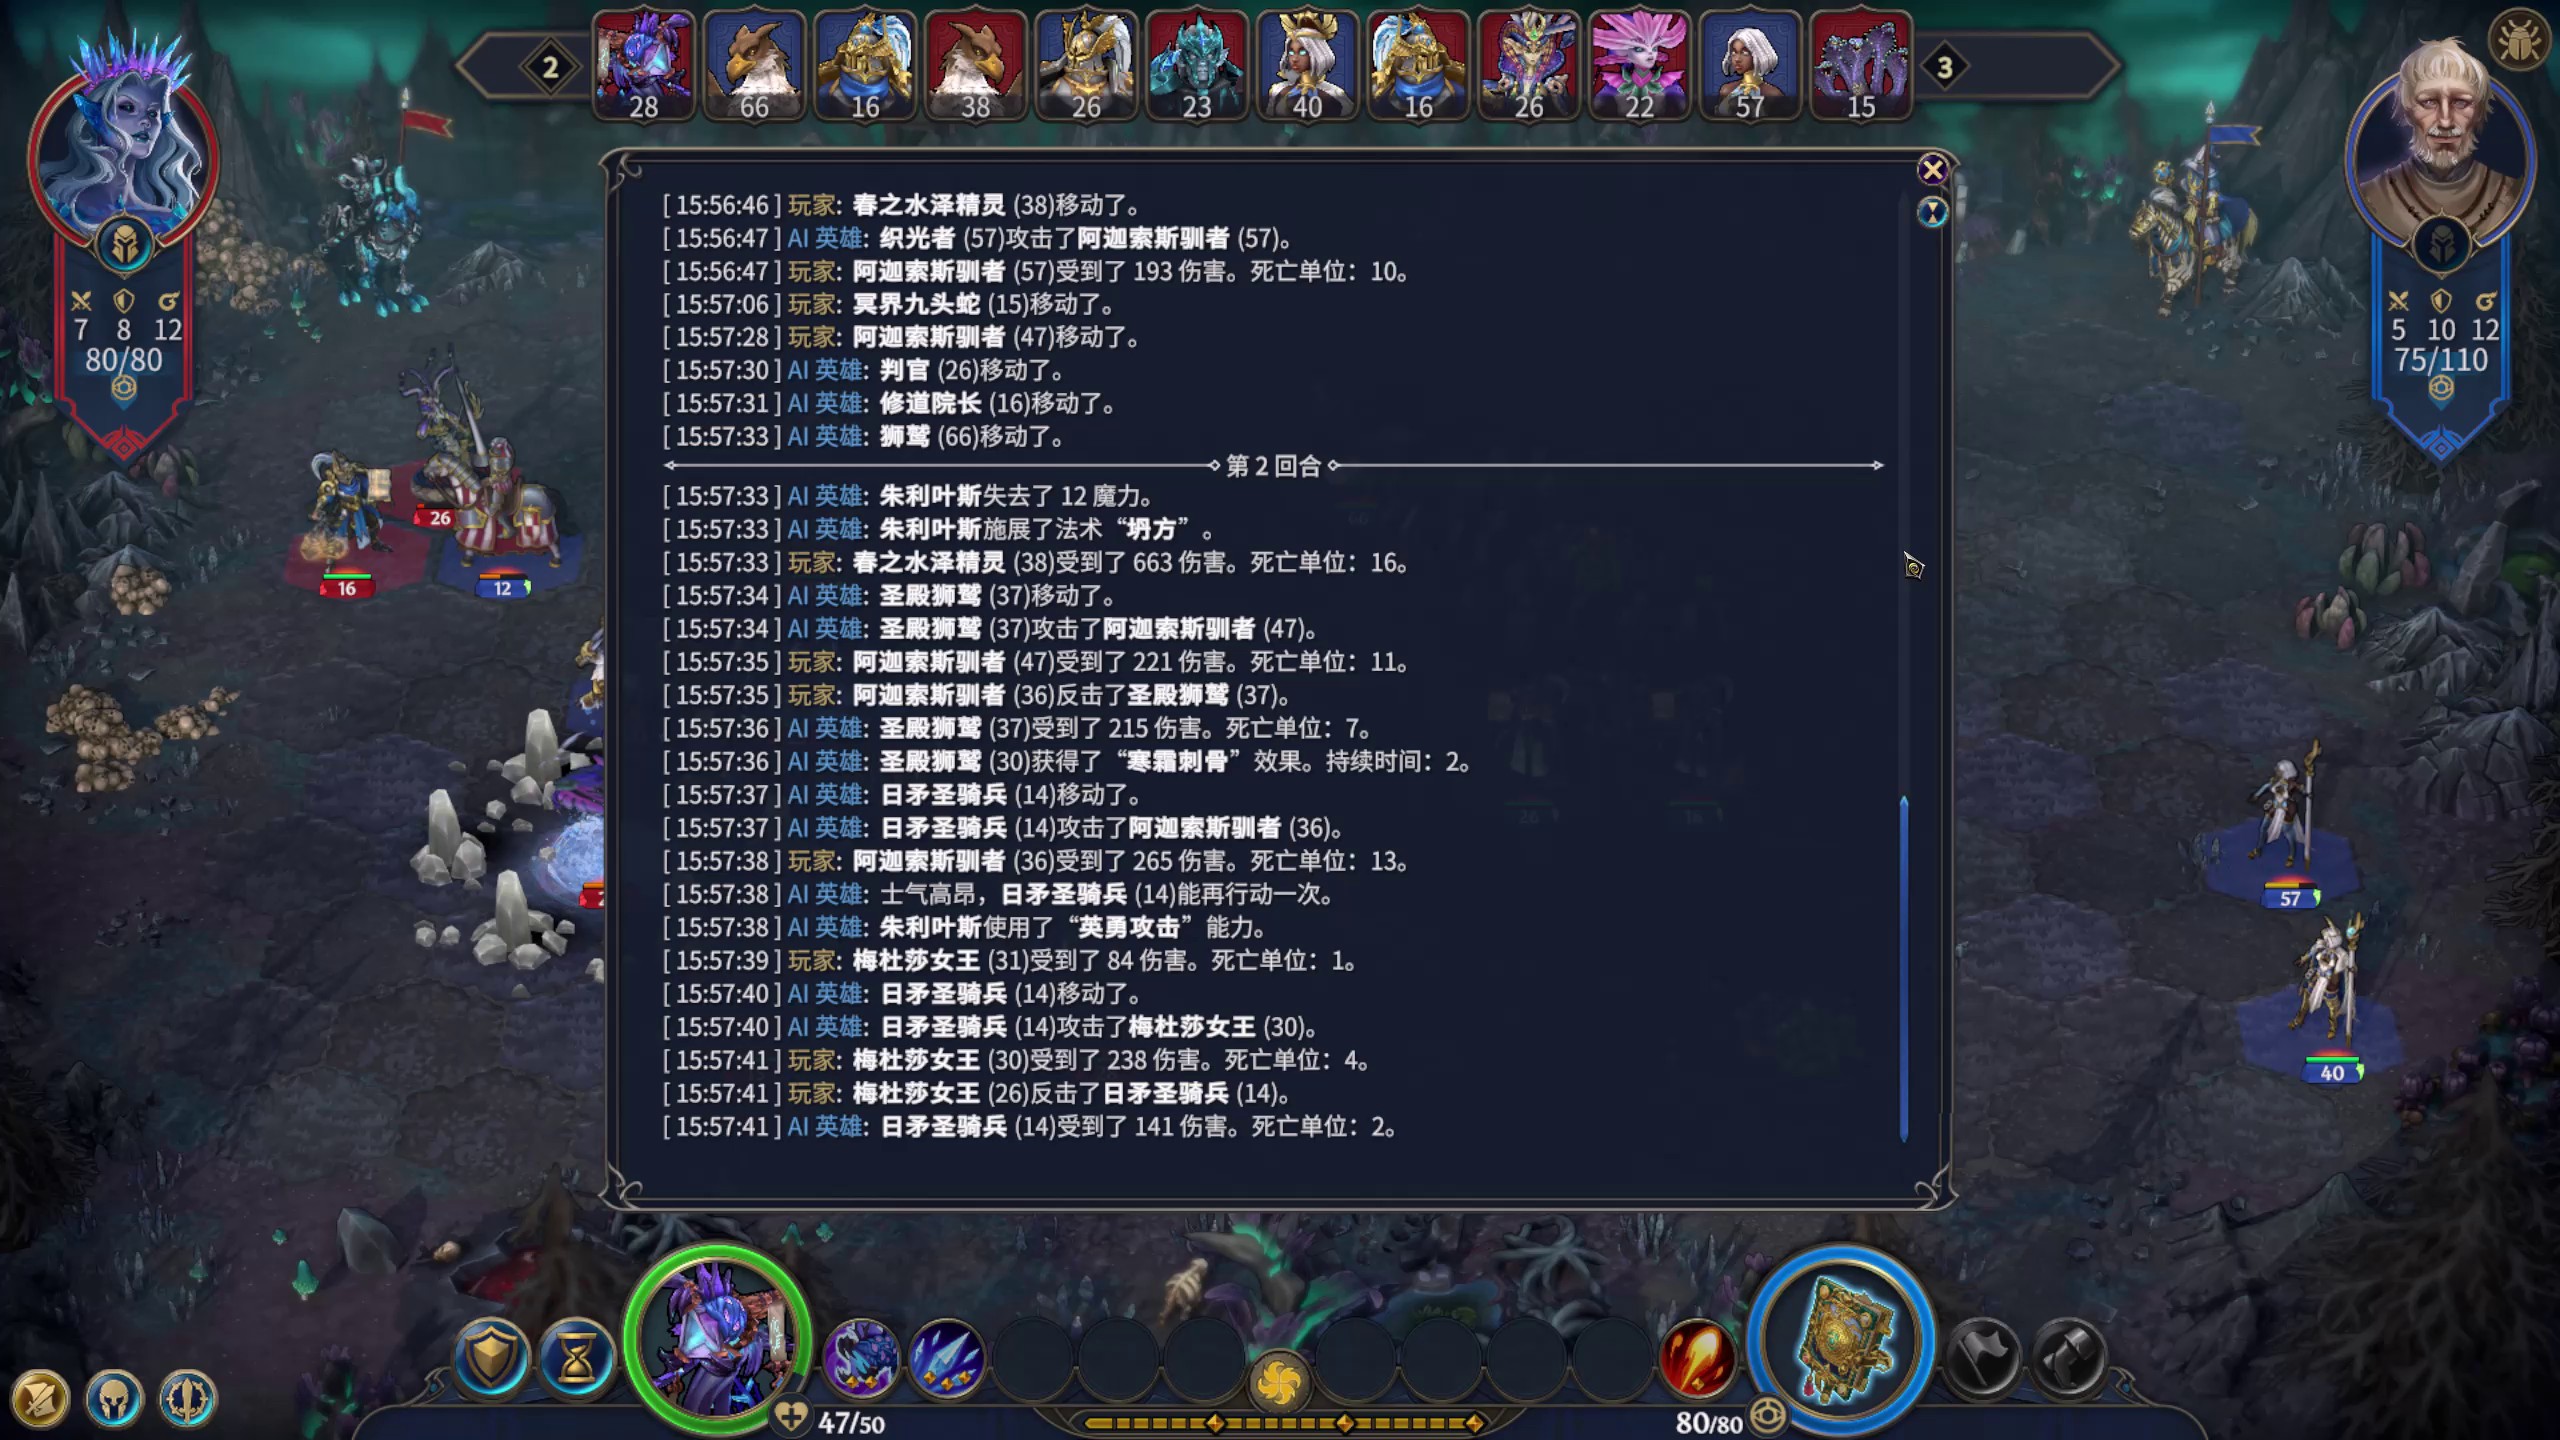
历史规则匹配文字:[15:56:46]玩家:春之水泽精灵(38)移动了。 · [15:56:46]玩家:春之水泽精灵(38)移动了。 · [15:56:47]玩家:阿迦索斯驯者(57)受到了193伤害。死亡单位:10。 · [15:56:46]玩家:春之水泽精灵(38)移动了。
查看历史预测与旧标签
历史 OCR 预测:战斗日志浮层。当时参考标签:战斗进行中(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 70 个 OCR 文本区域
未 0 00 是 0 〕 | 16 半 0 | 0 | 2 | 3 | 28 | 15 | 16 | 38 | 26 | 23 | 40 | 16 | 26 | 66 | 57 | 22 | 0 | X | [15:56:46]玩家:春之水泽精灵(38)移动了。 | [15:56:47]AI英雄:织光者(57)攻击了阿迦索斯驯者(57)。 | [15:56:47]玩家:阿迦索斯驯者(57)受到了193伤害。死亡单位:10。 | a | X | X | a | G | [15:57:06]玩家:冥界九头蛇(15)移动了。 | G | 7 8 12 | 5 10 12 | [15:57:28]玩家:阿迦索斯驯者(47)移动了。 | 80/80 | 75/110 | [15:57:30]AI英雄:判官(26)移动了。 | [15:57:31]AI英雄:修道院长(16)移动了。 | [15:57:33]AI英雄:狮鹫(66)移动了。 | 第2回合 | [15:57:33]AI英雄:朱利叶斯失去了 12 魔力。 | 26 | [15:57:33]AI英雄:朱利叶斯施展了法术“坍方”。 | [15:57:33]玩家:春之水泽精灵(38)受到了663伤害。死亡单位:16。 | 12 | 16 | [15:57:34]AI英雄:圣殿狮鹫(37)移动了。 | [15:57:34]AI英雄:圣殿狮鹫(37)攻击了阿迦索斯驯者(47)。 | [15:57:35]玩家:阿迦索斯驯者(47)受到了221伤害。死亡单位:11。 | [15:57:35]玩家:阿迦索斯驯者(36)反击了圣殿狮鹫(37)。 | 0 | [15:57:36]AI英雄:圣殿狮鹫(37)受到了215伤害。死亡单位:7。 | [15:57:36]AI英雄:圣殿狮鹫(30)获得了“寒霜刺骨”效果。持续时间:2。 | [15:57:37]AI英雄:日矛圣骑兵(14)移动了。 | [15:57:37]AI英雄:日矛圣骑兵(14)攻击了阿迦索斯驯者(36)。 | [15:57:38]玩家:阿迦索斯驯者(36)受到了265伤害。死亡单位:13。 | [15:57:38]AI英雄:士气高昂,日矛圣骑兵(14)能再行动一次。 | 57 | [15:57:38]AI英雄:朱利叶斯使用了“英勇攻击”能力。 | [15:57:39]玩家:梅杜莎女王(31)受到了84伤害。死亡单位:1。 | 0 | [15:57:40]AI英雄:日矛圣骑兵(14)移动了。 | [15:57:40]AI英雄:日矛圣骑兵(14)攻击了梅杜莎女王(30)。 | [15:57:41]玩家:梅杜莎女王(30)受到了238伤害。死亡单位:4。 | 40 | [15:57:41]玩家:梅杜莎女王(26)反击了日矛圣骑兵(14)。 | [15:57:41]AI英雄:日矛圣骑兵(14)受到了141伤害。死亡单位:2。 | 0 | 4 | 00 @ | 47/50 | 80/80
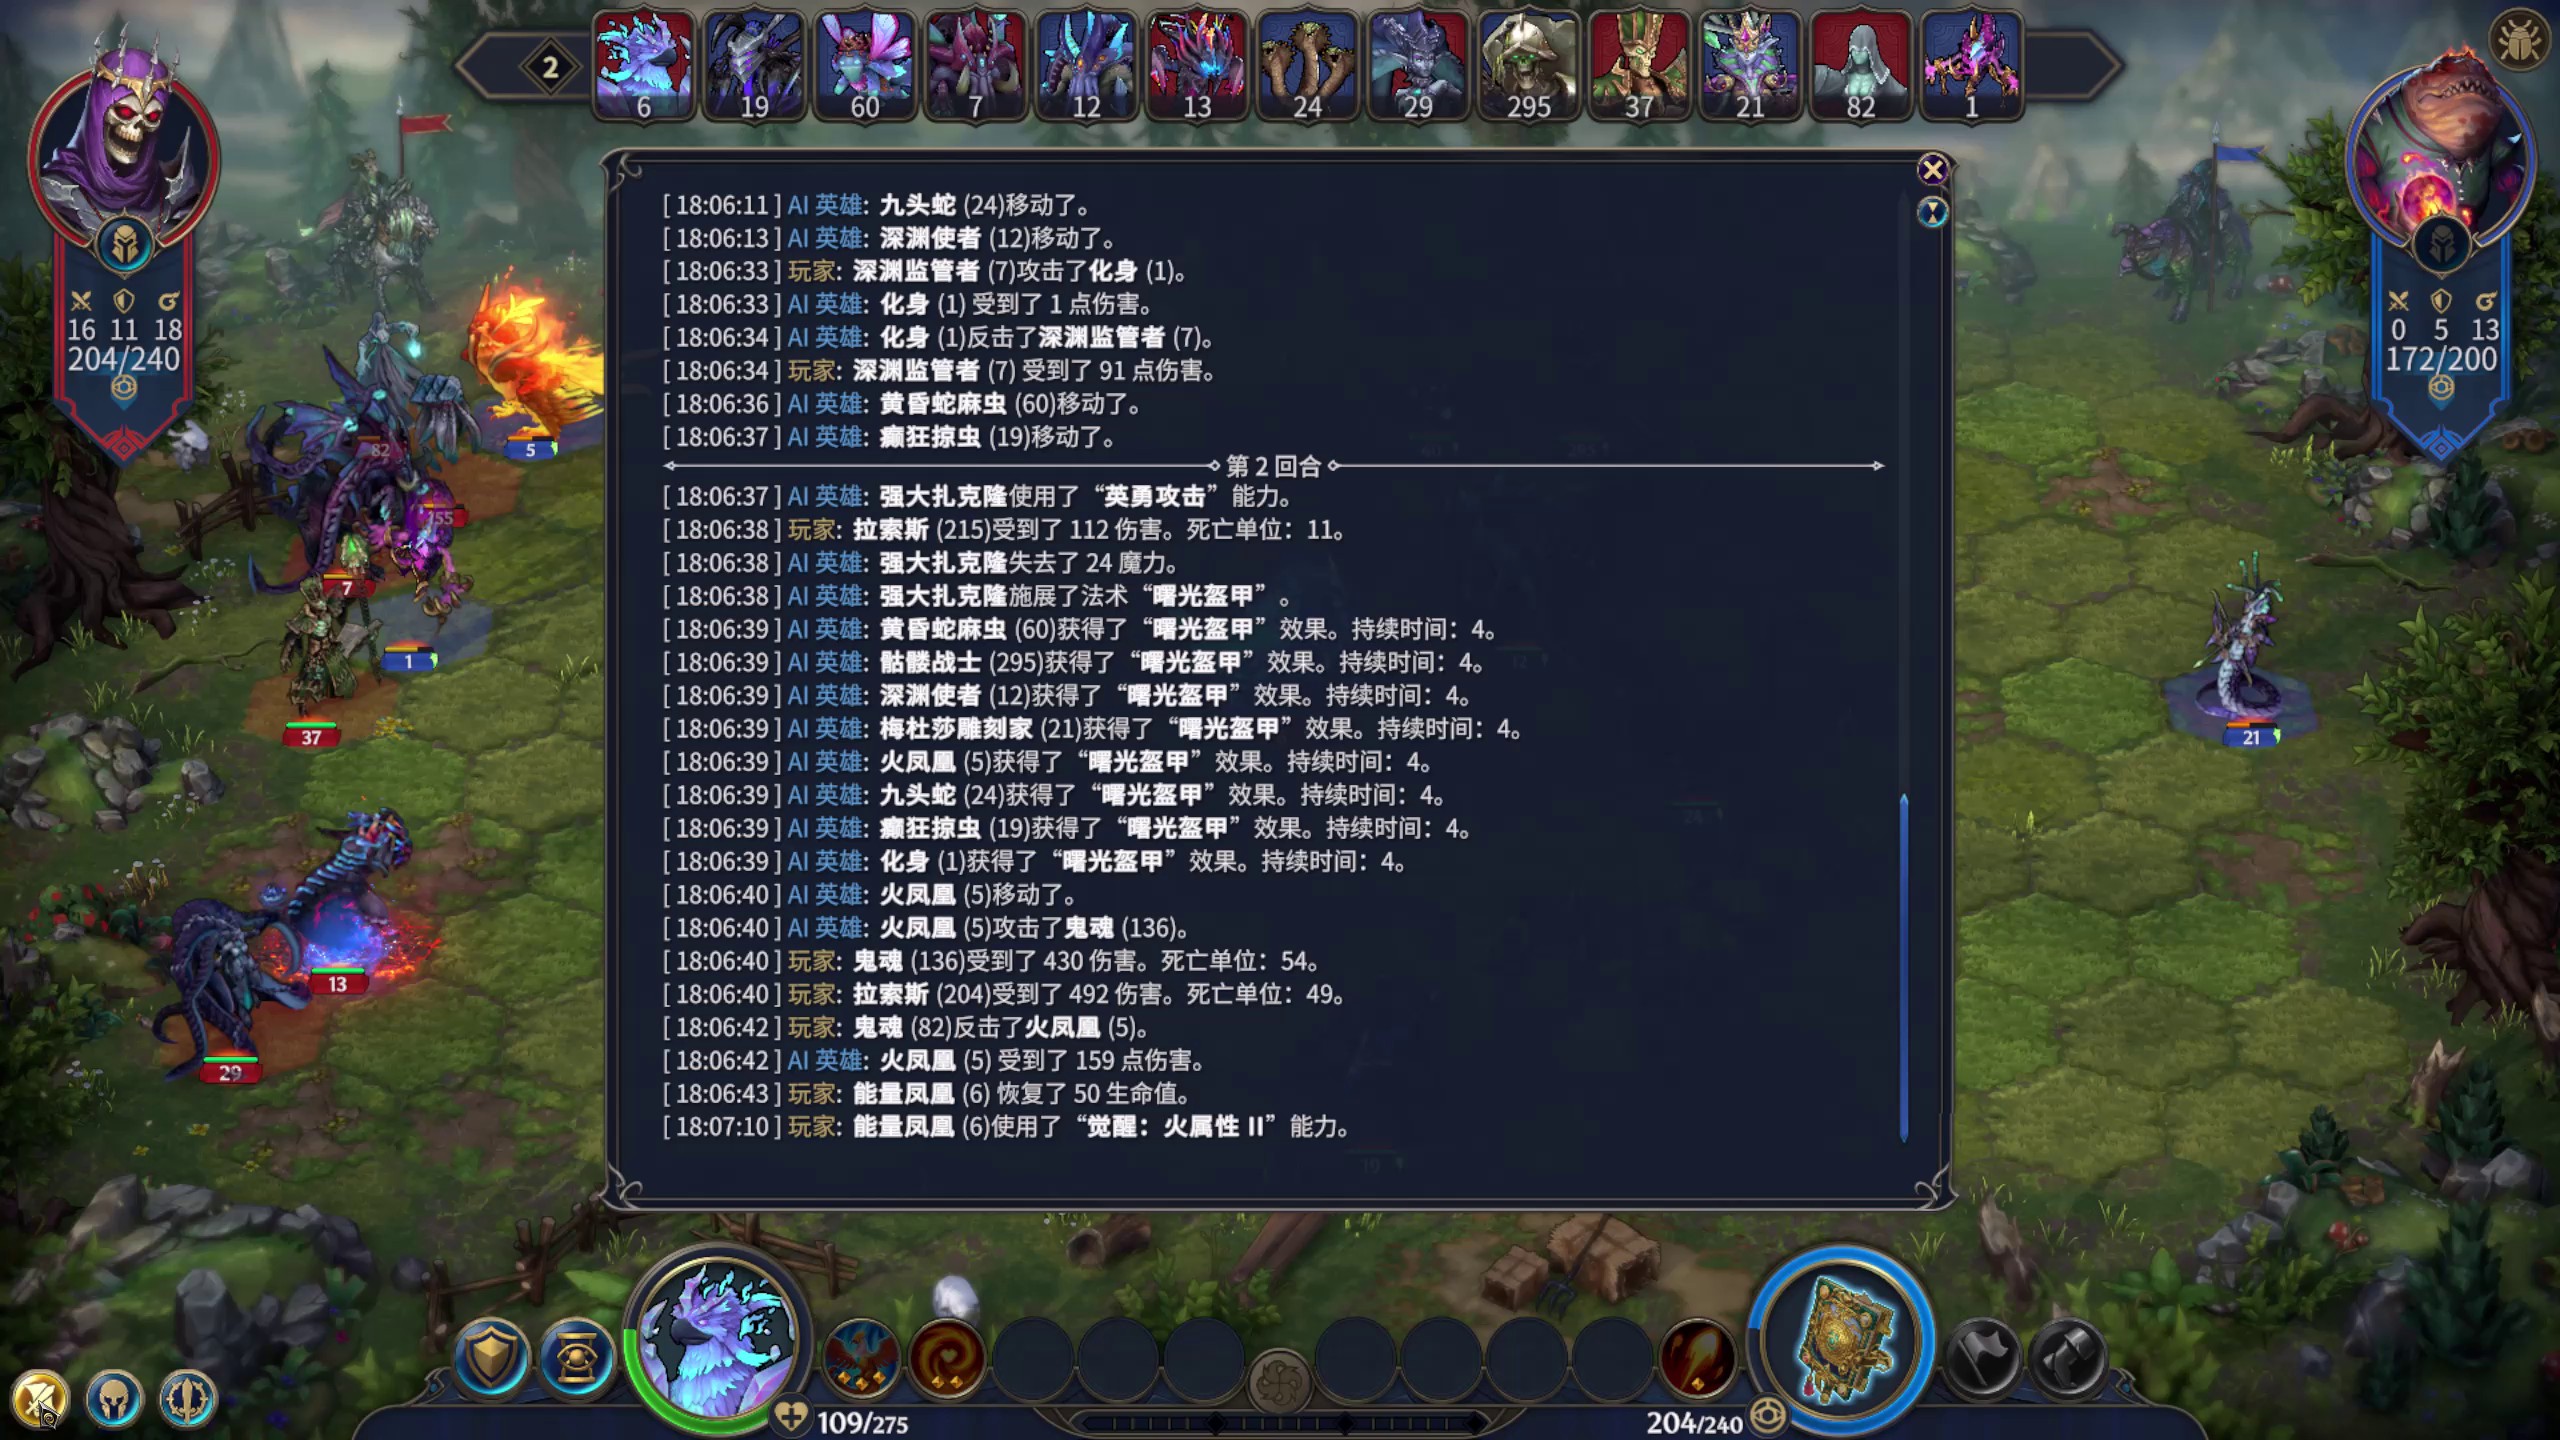
历史规则匹配文字:[18:06:11]AI英雄:九头蛇(24)移动了。 · [18:06:11]AI英雄:九头蛇(24)移动了。 · [18:06:33]AI英雄:化身(1) 受到了1点伤害。 · [18:06:11]AI英雄:九头蛇(24)移动了。
查看历史预测与旧标签
历史 OCR 预测:战斗日志浮层。当时参考标签:战斗进行中(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 61 个 OCR 文本区域
2 | 295 | 60 | 13 | 19 | 24 | 29 | 37 | 82 | 21 | 12 | X | [18:06:11]AI英雄:九头蛇(24)移动了。 | [18:06:13]AI英雄:深渊使者(12)移动了。 | [18:06:33]玩家:深渊监管者(7)攻击了化身(1)。 | X①a | a | G | G | [18:06:33]AI英雄:化身(1) 受到了1点伤害。 | X | X | 16 11 18 | 0 5 13 | [18:06:34]AI英雄:化身(1)反击了深渊监管者(7)。 | 204/240 | 172/200 | [18:06:34]玩家:深渊监管者(7)受到了91 点伤害。 | [18:06:36AI英雄:黄昏蛇麻虫(60)移动了。 | [18:06:37]AI英雄:癫狂掠虫(19)移动了。 | 5 | 第2回合 | [18:06:37]AI英雄:强大扎克隆使用了“英勇攻击”能力。 | 155 | [18:06:38]玩家:拉索斯(215)受到了112伤害。死亡单位:11。 | [18:06:38]AI英雄:强大扎克隆失去了 24 魔力。 | [18:06:38]AI英雄:强大扎克隆施展了法术“曙光盔甲”。 | [18:06:39]AI英雄:黄昏蛇麻虫(60)获得了“曙光盔甲”效果。持续时间:4。 | [18:06:39]AI英雄:骷髅战士(295)获得了“曙光盔甲”效果。持续时间:4。 | [18:06:39]AI英雄:深渊使者(12)获得了“曙光盔甲”效果。持续时间:4。 | [18:06:39]AI英雄:梅杜莎雕刻家(21)获得了“曙光盔甲”效果。持续时间:4。 | 37 | 21 | [18:06:39]AI英雄:火凤凰(5)获得了“曙光盔甲”效果。持续时间:4。 | [18:06:39]AI英雄:九头蛇(24)获得了“曙光盔甲”效果。持续时间:4。 | [18:06:39]AI英雄:癫狂掠虫(19)获得了“曙光盔甲”效果。持续时间:4。 | [18:06:39]AI英雄:化身(1)获得了“曙光盔甲”效果。持续时间:4。 | [18:06:40]AI英雄:火凤凰(5)移动了。 | [18:06:40]AI英雄:火凤凰(5)攻击了鬼魂(136)。 | [18:06:40]玩家:鬼魂(136)受到了430伤害。死亡单位:54。 | 13 | [18:06:40]玩家:拉索斯(204)受到了492伤害。死亡单位:49。 | [18:06:42]玩家:鬼魂(82)反击了火凤凰(5)。 | [18:06:42]AI英雄:火凤凰(5)受到了159点伤害。 | 29 | [18:06:43]玩家:能量凤凰(6)恢复了50生命值。 | [18:07:10]玩家:能量凤凰(6)使用了“觉醒:火属性IⅡ”能力。 | [18:07:10]玩家:能量凤凰(6)使用了“觉醒:火属性Ⅱ”能力。 | 一一 2 一 | 109/275 | 204/240
3. 有多少数据,能报告什么指标?
这轮历史实验覆盖了 19 种规则命中的画面标签。它们包含基础页面、浮层和过渡,并不是 19 个顶层阶段。两段录屏各有 320 张关键帧;当时的规则给 467 张提供标签,173 张保持 UNKNOWN。467/640 = 73.0% 是当时的覆盖率,不能读作准确率,也不是今天仍待处理的数量。这批场景实验与 p61 的整屏 OCR 选型分别计分。
历史 v1 规则在同一关键帧集合上得到 431 个标签、209 个未知;这轮 v4 重算为 467 和 173。版本、OCR 路径与规则都发生过变化,因此差额不能归因于单个算法改进,也没有证明增加的标签都正确。
| 历史 v4 规则输出 | 帧数 |
|---|---|
| ARTIFACT_SELECTION | 35 |
| BATTLE_ACTIVE | 24 |
| BATTLE_FINAL_CONFIRMATION | 12 |
| BATTLE_LOG | 44 |
| BATTLE_PREPARATION | 35 |
| CREATURE_INFO | 22 |
| CREATURE_SELECTION | 17 |
| GAME_SETUP | 13 |
| HERO_INFO | 10 |
| HERO_SELECTION | 10 |
| MAIN_MENU | 10 |
| MAIN_SKILL_SELECTION | 65 |
| MULTIPLAYER_MENU | 40 |
| NEW_GAME_MENU | 12 |
| PAUSE_MENU | 4 |
| SPELL_SELECTION | 35 |
| SUBSKILL_SELECTION | 59 |
| TOOLTIP | 15 |
| TRANSITION | 5 |
| UNKNOWN | 173 |
| 当时的审核集合(历史快照) | 数量 | 可以支持的结论 |
|---|---|---|
| 两段开发录屏的关键帧 | 640 | 观察规则覆盖与失败形态 |
| 人工确认 | 1 | 不能估计各类准确率 |
| 当时尚待确认 | 639 | 旧草稿状态,不代表现在的待办 |
| 按录屏、预测、参考草稿和画面条件选出的代表帧 | 45 | 首轮定位标签与规则问题;不是随机测试集 |
项目另有 562 条较早的场景参考记录:456 条来自已审核可用目标的布局,102 条是旧阶段参考,4 条明确是助手草稿。它们可帮助构建训练/开发资料,但目标图标被审核过,不等于同一帧的场景、浮层和就绪程度也经过独立审核。还需检查旧类名、来源与开发数据重叠。
不同方法应在同一份、按完整视频划分的冻结参考集上比较:文字规则、文字加位置、图像模板、组合路由。分别报告顶层/子类/浮层准确率、每类召回率、拒识率、错误接受率。当前没有满足这些条件的完整对照结果;此处不填一个看似精确的数字。
全图速度也不同于标题条速度。历史 Windows 全图批次约 135.5/136.0 ms 每帧,包含启动与布局处理;该 v1 回执因后续旋转框投影失败被标记为 partial。修正投影后的数值不是新一次 OCR 速度。PP-OCRv6 双通道全图批次约 657.8/597.6 ms 每源帧。它们均不是常驻服务 p50/p95;小标题的独立速度对照见 B024。
4. 在标注网站抽查,再用新录像验证
早期审核从 45 张代表帧和 173 张 OCR 未识别帧开始。后续已经做了 B022 的全库交叉核对,不需要按旧数字重新审核一遍。现在打开本机场景分类网站,可按场景或录屏抽查;每张博客示例也能直接跳到对应记录。此链接只在运行了本地标注服务的电脑上可用。
检查时先回答当前看到了什么,再判断是否有浮层、过渡、遮挡或非游戏画面。加载页应标为加载;OCR 没读出字不等于 UNKNOWN。空技能页如果处于翻页,标为过渡或内容未就绪,不再使用已撤销的“英雄技能总览”。
两个演示录屏已经影响过规则设计,确认后仍属于开发评估数据。下一份真正的测试集要从其他完整录屏中冻结,并且在调参前确定参考。连续窗口另用于检查错误前进、重置、延迟和过期上下文;一张帧的分类准确,并不能认证 state tracking。
复现入口:项目 B020 的 prepare_evidence_review.py 重用缓存和原图;其 --refresh-reviews-only 只同步博客分类,--check-reviews 检查是否落后于标注网站。历史计数仍保存在 evidence-inventory.json。浏览器标注仍写入原有带修订版本的审核存储,本文没有将预测提升为训练真值。
Comments