把一段游戏录像交给程序,我们希望它能指出画面里有什么,并让人随时回到原图检查。逐帧识别会重复处理漫长的等待;隔很久才截一张,又可能错过一条短暂出现的技能说明。
因此先不急着解释整场战斗,而是留下一条条观察:看见了什么、在画面什么位置、来自录像哪个时刻。 文字没有读全,或还不知道数字属于谁,就把不确定的部分留下,不替它补答案。
当前最重要的缺口不是“再猜一种技能”,而是同一张图还没读全:有的元素没有框,有的有框但没读到字,还有的字对了却配错对象。接下来按这三类错误补数据与算法,暂缓隐藏构筑推断和视频分析条。整体进度页列出每项还差什么;各章开头的通俗说明用于快速验收,后面的历史实验按需阅读。
这组文章沿着这个目标往前走:先挑帧,再读字、判断页面、找生物和字段,最后比较前后变化。你不需要玩过游戏,先用下面这张截图认识我们要读的东西。本章解释整体设计;截至9月24日的成果和缺口集中看P00收尾报告。后面带日期的运行记录用于追溯过程,不代表所有改动都已成为默认功能。
flowchart LR
 A[Video frame] --> B[Text and visual evidence]
 B --> C[Scene and content readiness]
 C --> D[Icon identities and attribute fields]
 D --> E[Changes over time]
 E --> F[Keyframe review with source links]
图 1:这是完整目标流程。场景标签、当前可见字段与历史记忆分别记录,不能互相冒充。
1. 从一张图到一条记录
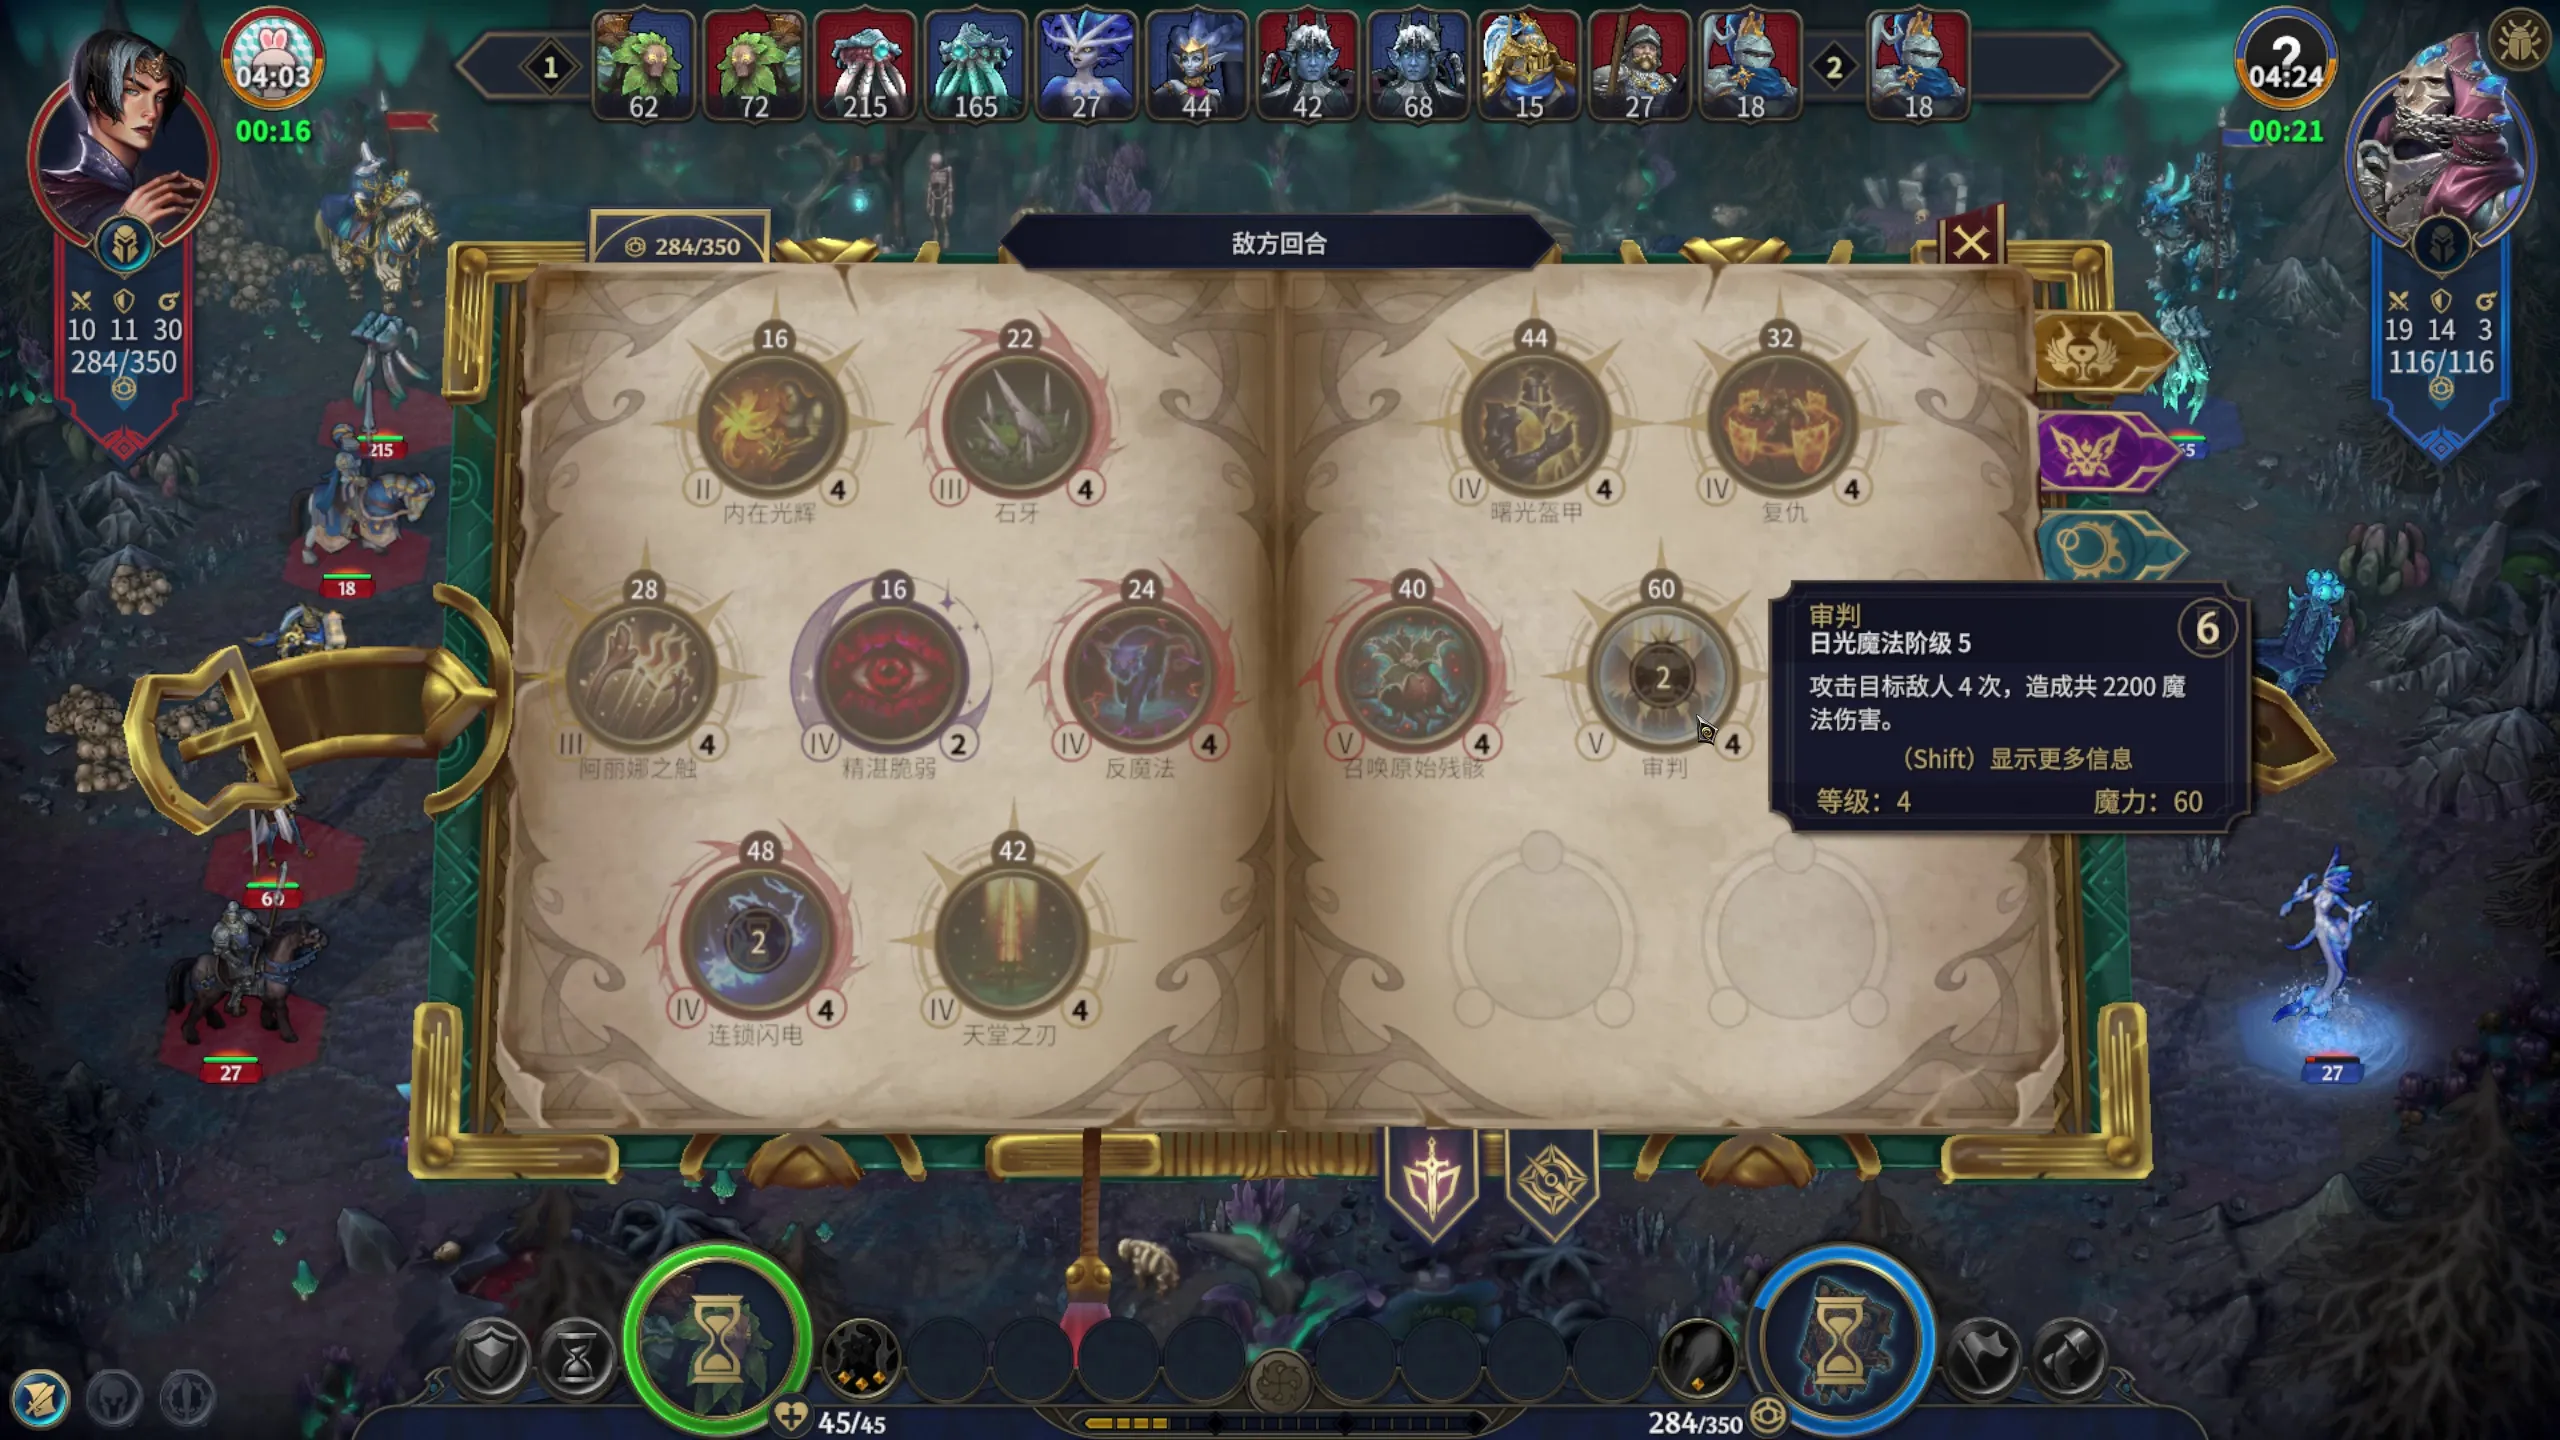
图 2:同一张原图里有许多不同任务。可以点击放大;这张图用于说明观察目标,不是算法已经全部识别成功的结果图。
例如右侧说明写着“审判”和“魔力:60”。我们希望记录这段原文、它的区域和来源时刻,再把 60 关联到说明里的魔力字段。它是画面显示的说明值,不能直接改写成“刚才已经消耗了 60 点魔力”。
再看书页外的战场:一个生物身体通常代表一支部队,而不是一名士兵。脚下的小牌显示数量,顶部的小卡片显示行动顺序。同一种生物可能属于不同部队;找到身体、认出种类、读数量、把几处画面关联起来,是不同问题。
程序最后把这些观察放到同一条时间线上。左右切换关键帧时,人能看到原图、识别框、读数及其来源;缺了哪一部分也应当明确显示。下一章先解决供样:怎样从视频留下清楚、少重复的图。
查阅:实验分工与历史接口说明
本篇曾承担跨模块总合同角色,现在这部分已由系统合同替代。这里保留历史场景设计和 Perception 内部测量,不重新定义现行模块边界。
P02 · 设计与接线评估 · 实验记录与相关篇目
2026-09-12:继续将 10 fps 离线供样、小切块 OCR 和本地数字复读接入视频流程。保留既有 275 张完整录像候选;处理完成不代表所有元素找齐。
| 实验 | 负责的问题 | 现状与文章 |
|---|---|---|
| B020 | 各模块怎么组成可审核系统 | 本篇,系列总览、历史设计与最新接线;不是现行跨模块合同 |
| B021 | 文字及其位置支持什么场景 | OCR 场景识别,已有原型,补齐全部命中类别示例 |
| B022 | 文字不足时,固定 UI 能否识别场景 | 视觉补充,本轮复用历史颜色/边缘参考分类 |
| B023 | 名称描述哪个图标、哪个游戏身份 | 标题与图标关联,已有五类关系预标注 |
| B024 | 文字和小数字该使用哪种 OCR 配方 | OCR 失败对照,已扩展至整屏扫描与局部精读实验 |
| B025 | 面板字段写了什么、出现在何处 | 场景字段与属性,已有单帧字段读取,不维护战局状态 |
B021–B022 识别场景,B023–B025 理解场景内部。B024 是 B023 的 OCR 子模块评估,不是另一套全屏场景分类器。时序跟踪消费这些观测,但不是给分类结果加一个合法转移图就完成了。
配套视觉实验分别研究固定槽位的图标分类 B11、战场生物 B12、六边形网格 B15和高亮范围、障碍与路径 B16。它们回答不同问题,可以按需要阅读。
读过旧文章:实验编号改到了哪里?
早期B04、B026、B06、B07曾分别改为B11、B12、B15、B16,原B08并入B023。这是上一轮历史迁移。当前阅读目录已统一到P系列,文章网址也随之更新;原实验路径与冻结测量保留,不把改名算作新结果。
场景未知时,B021 先对完整截图做文字检测与识别;知道场景后,B023 才按相应布局关联图标,必要时精读小标题。OCR 引擎自动裁出的文字行不需要游戏场景标签,游戏固定槽位则需要。这样避免“先知道场景才能 OCR、先 OCR 才能知道场景”的循环。各原型的自动串联与拒识仍需完整视频评估,B024 的小裁图成绩不能代替这项验收。
共享实现留在 Perception 包;实验目录保存配置、数据入口、固定案例和评估记录。博客只有桌面 Blogs 中这一份正文,项目侧保留可复现代码与技术合同。旧编号与旧测量通过迁移说明和 Git 历史追溯。
2. 场景层级与状态转移不是同一棵树
一张图有包含关系:场景包含面板,面板包含文字和图标,名称可以关联目录身份。视频则有有向的状态转移。标签界面的三列“开局前、战斗准备、战斗开始”只是方便选择;排兵布阵放在第三列,因为它使用战场 UI。
| 顶层类别 | 子类或局部状态 |
|---|---|
| 菜单 | 主菜单、排行、展开的子菜单 |
| 对局设置 | 配置对局 |
| 匹配等待 | 匹配、网络校验 |
| 加载 | 游戏加载进度 |
| 英雄选择 | 英雄候选与预览 |
| 技能选择 | 主技能、子技能 |
| 宝物选择 | 宝物候选 |
| 法术选择 | 法术候选 |
| 生物选择 | 生物候选、刷新 |
| 战前收尾 | 属性奖励、最终确认 |
| 战场 | 排兵布阵、实际战斗 |
| 对局结果 | 胜利;其他结果仍需样本 |
flowchart TD
 M[Menu] --> S[Match setup or quick start]
 S --> W[Matchmaking and checks]
 W --> L[Loading]
 L --> H[Hero selection]
 H --> K[Main skills and subskills]
 K --> A[Artifacts]
 A --> P[Spells]
 P --> C[Creatures]
 C --> F[Attribute rewards]
 F --> Q[Final confirmation]
 Q --> D[Deployment]
 D --> B[Battle]
 B --> R[Results]
 R --> M
图 3:正常流程示意,不是所有异常路径的可执行全集。快速开始可跳过设置;取消、退出和恢复需要各自验证。最终确认不能返回修改属性,这条用户确认的约束已纳入设计。技能内部可以反复出现主技能与子技能页。
切出游戏可能发生在任何时刻,因此“非游戏可见性”不应排在上述流程的固定位置。浮层也要有父场景约束:主菜单没有战斗魔法书,但可以只识别断线提示而不知道下面是什么场景。
3. 场景与内容就绪一起判断,输出仍然分开
技能翻页时,英雄卡仍在、选项未显示。判断内容缺失需要知道期望的页面,因此简单的“先测图像质量、再分类”不够。我们使用同一个场景理解入口,共享 OCR 和图像证据,分别输出场景候选、可见性、浮层、内容就绪程度与处理决定。这不要求只有一个神经网络。
| 当前证据 | 处理策略 |
|---|---|
| 稳定且关键区域可见 | 提取对应字段 |
| 场景可辨,但选项未出现 | 保留场景,内容标为未就绪,等下一帧 |
| OCR 与视觉都不足 | 当前场景未知;历史阶段单独保留 |
| 暂停或断线 | 记录中断,暂停普通提取,继续监测恢复 |
| 悬浮提示遮住部分区域 | 保留浮层;被遮挡字段不提交新观测 |
| 非游戏画面 | 暂停游戏提取;返回后重新识别 |
之前被称为“英雄技能总览”的空页已按用户判断撤销,视为翻页过渡。不能把所有识别失败都重新命名为过渡;需要画面或时序证据。旧数值、旧场景有时间年龄,不能成为本帧的检测结论。
4. 视频压缩要保留内容变化
我们使用五帧稳定检测与内容去重,只导出稳定区间的原尺寸代表帧。9 月 10 日的完整录像用 5 fps;9 月 12 日的离线接线显式选择 10 fps,让五帧首尾间隔缩短到 0.4 秒,更容易留下短暂停留的说明。两个版本共用已有模型,没有在这里重训。仍未启用独立的短提示补捞分支,也不要求在线系统以同样速度运行。
等待匹配的重复片段可以保留代表帧、开始/结束与断线等异常。十秒未变的主技能页可以只展示一张;但同一场景中刷新候选、选中不同对象、升级、数值变化、打开详情都应产生新证据。只按 scene label 去重会丢掉这些事件。
最终审核器左侧原始图,右侧同一时间戳的文字框、图标、身份、属性和关联线。左右方向键跳到下一个有意义的关键帧。折叠区间保留时间范围、原因与原视频入口;原始预测和时序修订并列,不能暗中覆盖历史证据。
5. 当前交付与下一步
目前已经能把原视频转成带来源的关键帧,并在同一张原图上检查各模块输出。不过,读到了一个数,不等于已放进正确字段,更不等于整帧读全。 例如画面显示 62/102,一块残缺裁图只能读到 62/10;另有 102 个位置已经读对,却没传到公共结果中。修裁图与修结果传递,解决的是不同问题。
今天的全局结论看 P00 总报告,同一张图的缺口看 P120 整帧检查。下面是形成这套流程的历史,不必按日期读完才能理解设计。
展开早期接线与逐次修复记录(9月10日至22日)
现在,已有四个开发运行、328 张原图可以在同一条时间线里检查。数字留空时可以单格重读,魔法书的左下罗马字面和周围数字也已接入。原字段不会消失,新读数在旁边作为另一份证据。
读到了 88/100,还要把两个数完整传出去
这次补的是识别之后的一处接口缺口:程序内部已经能保存“当前值 / 上限”,旧公共出口却不认识这种成对数值,下游收到的仍是未知。现在新增一个显式选择的出口,保留原读数,并把它拆成两个整数。旧出口不变,调用方不会被自动切换。
例如一张原图已有 200/200 的读数,新出口保留 200 和 200,以及它们共同的原图位置。它们来自同一次读数,不能算作两次独立识别;也不能只凭屏幕左侧,就认定属于我方英雄。读不清时仍留空,不能补成零。
我们用四个既有运行的全部328张候选验证这条路径:面板字段中281个已读数值对完整通过导出与读回,139个位置仍未知。全部已读对都来自其中一段较长录像;两个高精度OCR片段的112个数值对位置,在这套原字段读取里仍然留空。出口修好了,不等于上游也读对了。 当时单格补读还不在出口中,下面继续检查并补上这条路径;独立HUD读法和书页字面仍需分别接入。
逐帧核验页可以展开原图、字段状态和实际导出的JSON。这一轮没有重新跑OCR或新增标注,所有记录仍是离线证据;完整英雄关联与实时决策另行验证。下面继续说明这些本地读数是怎样产生的。
112个留空位置,不等于112次都没读出来
为了弄清这个缺口,我们把两个片段中所有相关位置都裁出来,隐藏模型答案后逐个看原图。34张图上逐一核对112项数值,其中100项是新参考位置、12项复核已有参考;包括英雄角落、生物属性面板和底部头像旁的数值。同一显示会重复出现,实际只有13种数值对。这是一轮开发排错,不是未见视频测试。
结果分成两类:102个位置的局部补读已经与原图一致,只是没有进入公共出口;另10个仍因读法冲突留空。 前一类提醒我们,识别模型和结果传递都要检查,不能看到空白就认定需要更强的模型。
后一类更具体:原图显示 62/102,一块小切图却只读出了 62/10,相邻切图又读到了完整值。按扫描器保存的实际裁剪范围逐张检查后,10张都能看到同一个问题:小切块的右边界把末位 2 留在了外面。 把这块残图放得再大,也不能还原它没有包含的数字。
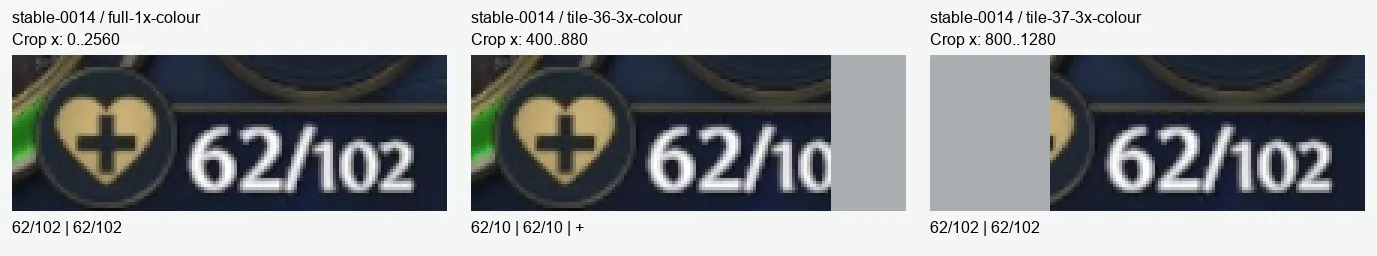
图 4:1704.1 秒的实际来源区域,按原像素放大三倍。灰色表示该部分不在对应切块里,不是模型抹掉了文字;下方列出各次原始读法。全部10处对照可逐张查看。原拒识保留,后面的独立实验比较完整小格重读,不按票数选答案。
排错页把这10个拒识放在最前面,展开即可对照原始读法;统一时间线可逐帧切换原图、补读和助手参考。参考仍待你确认,原字段没有被覆盖。本轮补的是审核依据,没有重跑OCR或把这些图标成整帧完成。
补读成功后,让下游真正拿到这个数
9 月 13 日补上了这条接线。比如 1682.6 秒的左上数值,原字段因没有可靠分数而留空,单格读取已经得到 131/350。现在导出的观察里同时保留“原字段未知”和“补读得到 131/350”,不替换前者,也不把两个结果当作两处不同的数字。
全部328张开发图都通过了新出口检查,旧字段逐条不变。另有270次单格读取进入统一结果:137次可读,包括114个数值对和23个其他数值;133次拒识,继续留空。前面核对过的102个数值对已经在其中,10个冲突位置则没有产生新的读数。这是把已有识别结果传出去,不是新一轮OCR准确率提升。
还有一个容易误导人的细节:识别器拿到的是程序选出的“小格子”,没有输出每个字的精确框。因此新结果只记录搜索范围,不给数字伪造紧贴文字的框。英雄身份、数字含义与实时决策也没有因此自动确定。
可以打开单格结果导出页,展开一帧,对照原图、原字段、补读文字和实际JSON;原来的参考时间线继续保留。
别让一块残图否决完整的数字
接着做了一个小对照。程序先检查:文字框是否贴着某块小图的边界,而且另一次读取的同排文字框确实越过了那里?只有满足这两个条件,才把那次读法列为“可能截断”,再看剩下的完整读法是否一致。最后重新裁出整个数值小格,用同一个本地识别器读一次;新读数也必须一致,才留下单独的候选。
对全部328张图、949个自动数值格执行后,只有前面10处请求重读,均得到了 62/102;其余939项不变。没有更换模型,也没有按具体数字写例外。这个结果说明,修正输入范围就能恢复这批数字,不一定要换更大的模型。
但10处全来自同一小段录像、显示同一个值,不能当成10种数字都通过了测试。我们还没有足够的不同录像和真实背景反例来全局采用它,所以旧冲突和默认输出仍然保留。独立对照页可展开原冲突、实际裁图和新读法。下一步先补不同录像的短悬停、属性面板与非文字数据,不再围绕这10个重复值调参。
2026-09-12:把缺失的数值补回同一张原图
前面的自动单格 OCR 对照发现,把数字从整屏里单独拿出来读有帮助,但统一放大四倍反而更差。因此这里采用开发比较中更好的 PP 原尺寸读法;这不是为了省时间,而是为了保住实际测到的精度。
“原尺寸”指不先把裁图统一放大四倍,不代表模型内部没有调整输入大小。所用 PP-OCRv6_medium_rec 是当前 PaddleOCR 系列的文字识别器;它与局部视觉语言模型的对照支持这批数据上的选择,不能证明它是所有游戏画面的最强模型。
程序只补原来缺失、低分或无法完整解析的数值;已有可读字段、真实读数冲突和不可见区域保持原样。新读数必须是完整数字格式,且通过预先固定的分数要求。能读出一个整数,还不等于找对了数字。
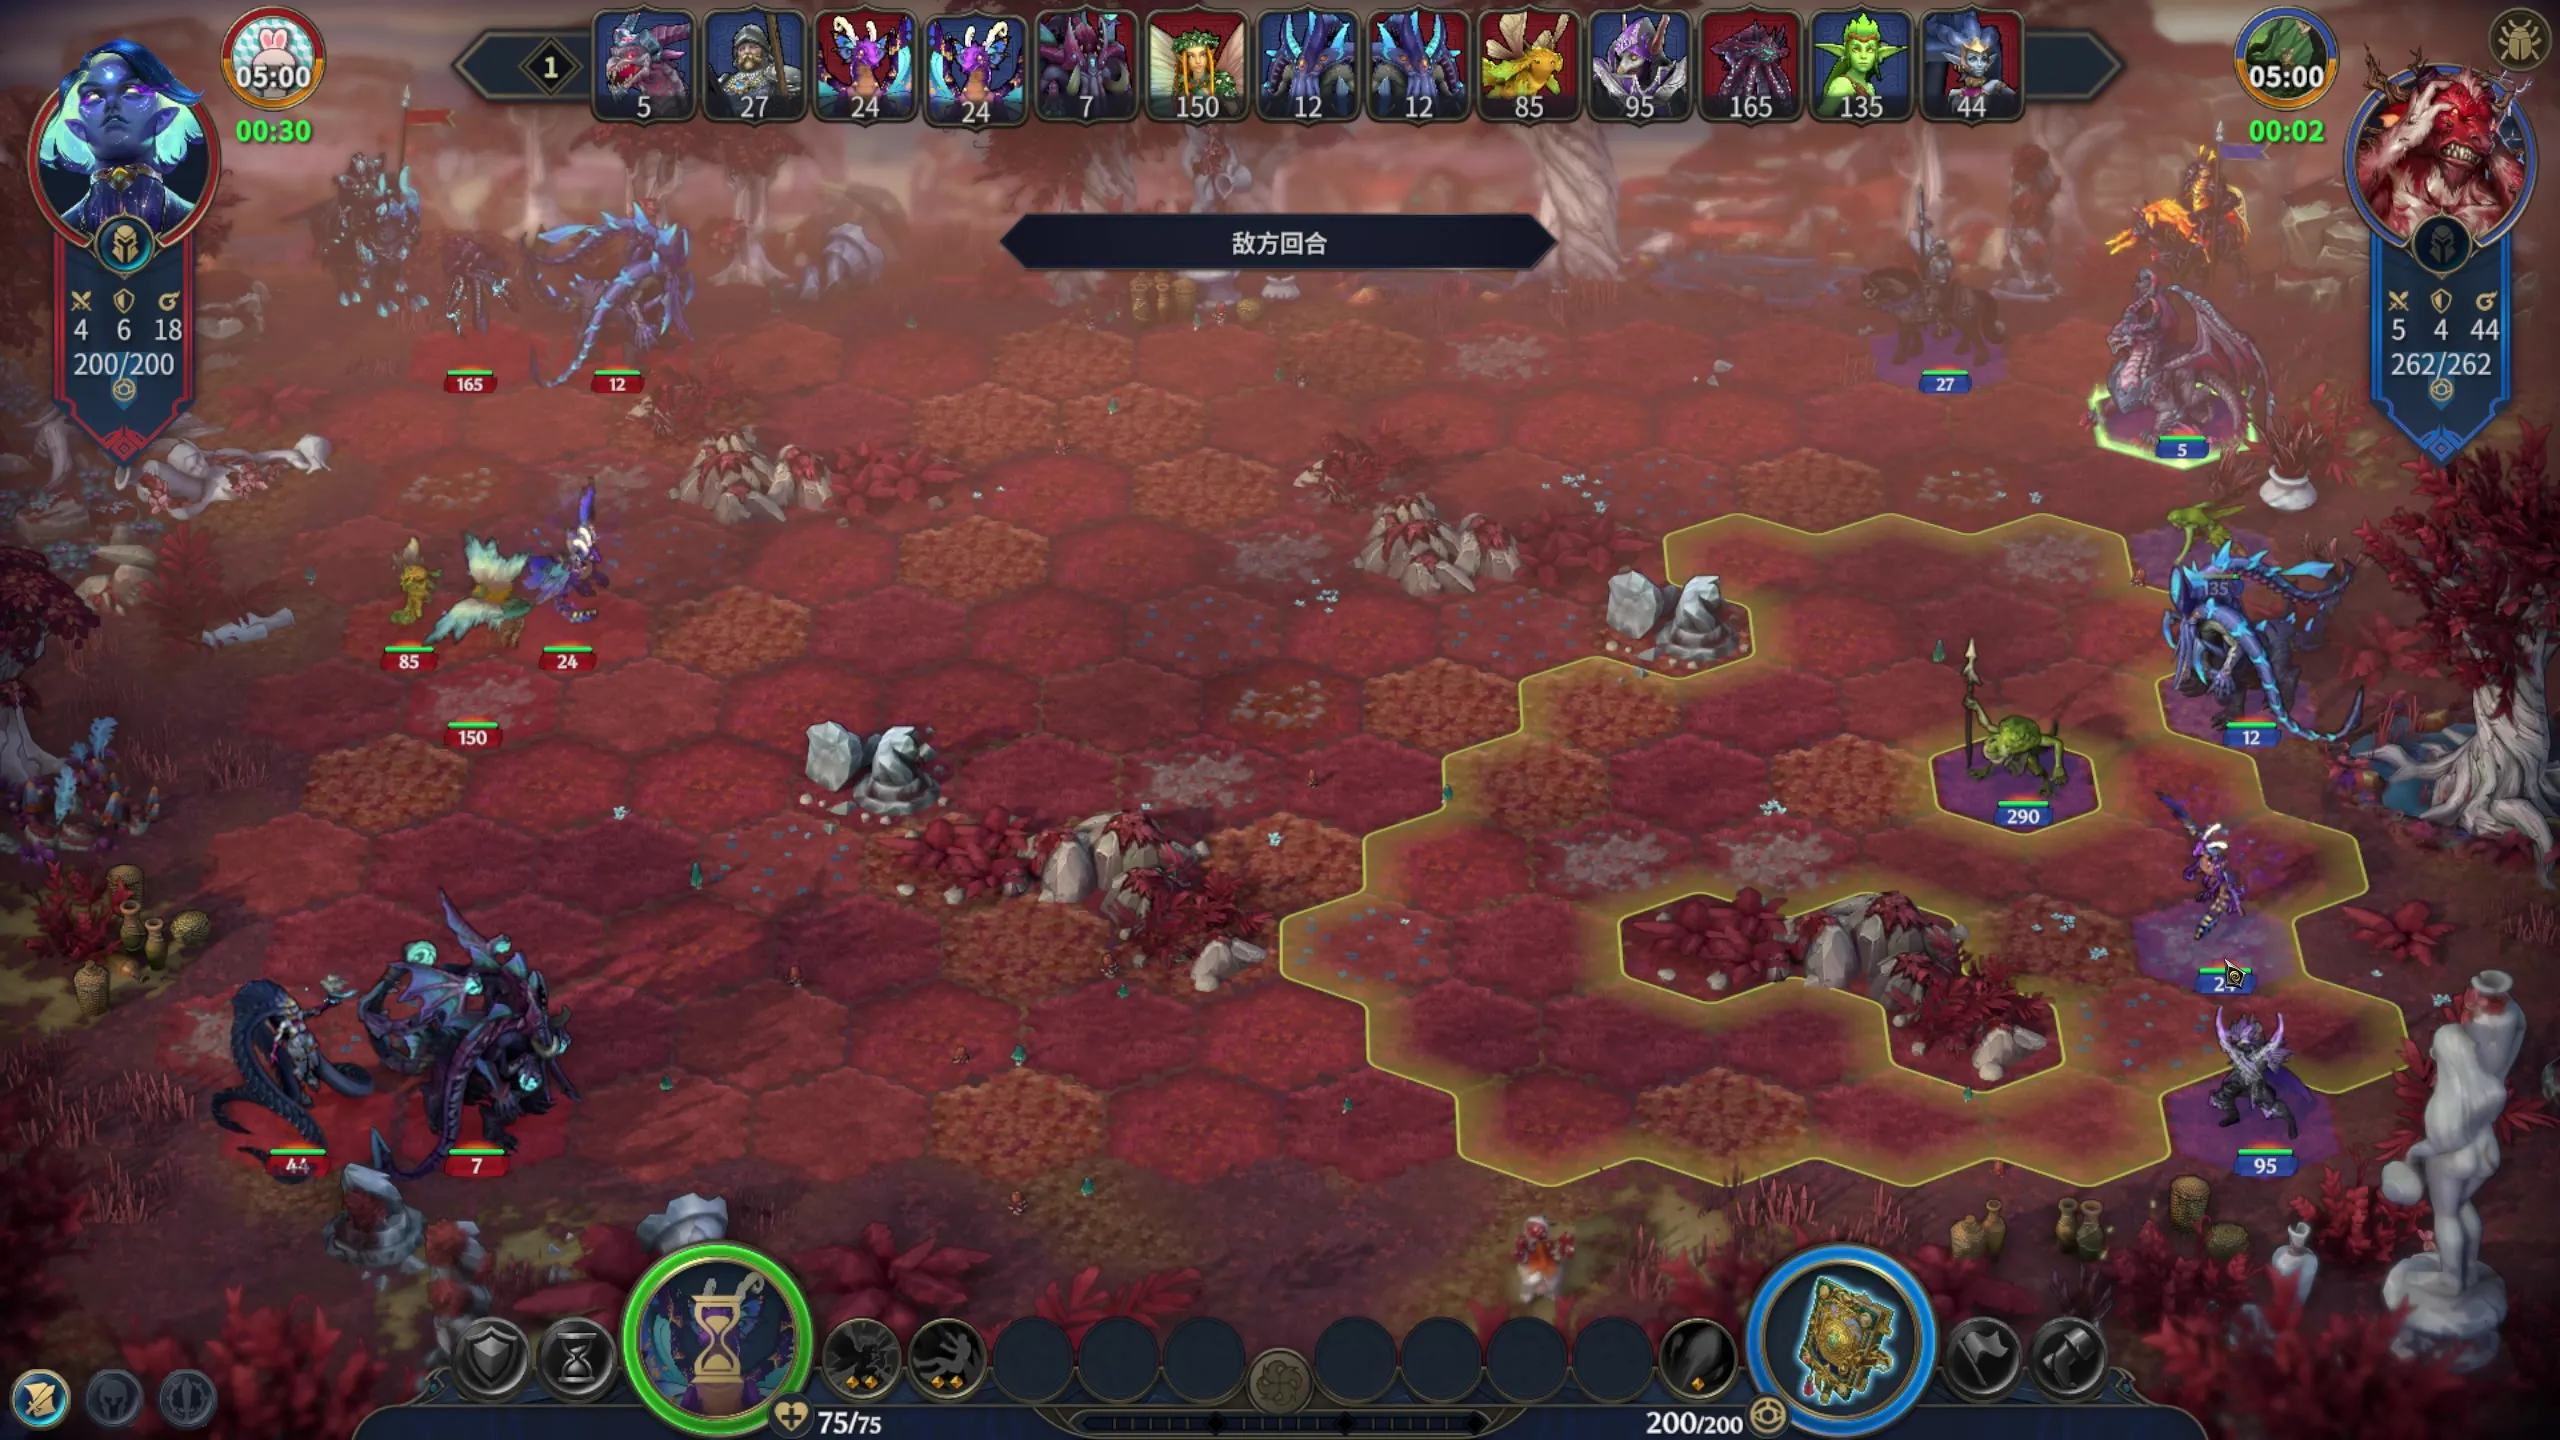
图 5:录像 428.8 秒,底部沙漏头像右下方显示 75/75。原字段因低分留空;局部重读得到 75/75。点击放大查看原像素,时间线另列两种读法和助手参考。这张图没有被标成“所有内容都已识别”。
| 本轮做了什么 | 实际结果 |
|---|---|
| 保留现有视频候选 | 4 个运行、328 张图,来自 3 段原录像 |
| 补读原来缺失的自动小格 | 270 个裁图全部完成,137 个可解析候选,133 个拒识 |
| 检查此前留空的稀疏参考 | 17 项都恢复了与原图一致的数值 |
| 核对较长录像的全部新增项 | 15 项逐图一致,但只有五种显示值 |
两组参考分别计分:前 17 项早已用于开发比较,后 15 项是在预测产生后逐图核对的,尚待作者确认。这里没有重训,也没有打开预留的验收录像。这些结果证明新读数能到达实际视频页面,不能推出整段视频的准确率。
按字段位置检查后,需要纠正最初对这批拒识的解释:133个拒识裁图中,121个来自“图案中央数字格”,不能等同于上方或右下数字漏读;后两类各121个字段,原读取器都已保留读值。下面这张图的17也早已读对,低分d来自中央图案。这里还没有逐像素确认121个中央全为空;后续扩展在其他书页发现中央1、2、4,必须保留这种可能。
看原图:数字在图标上方,错误裁图却落进图案
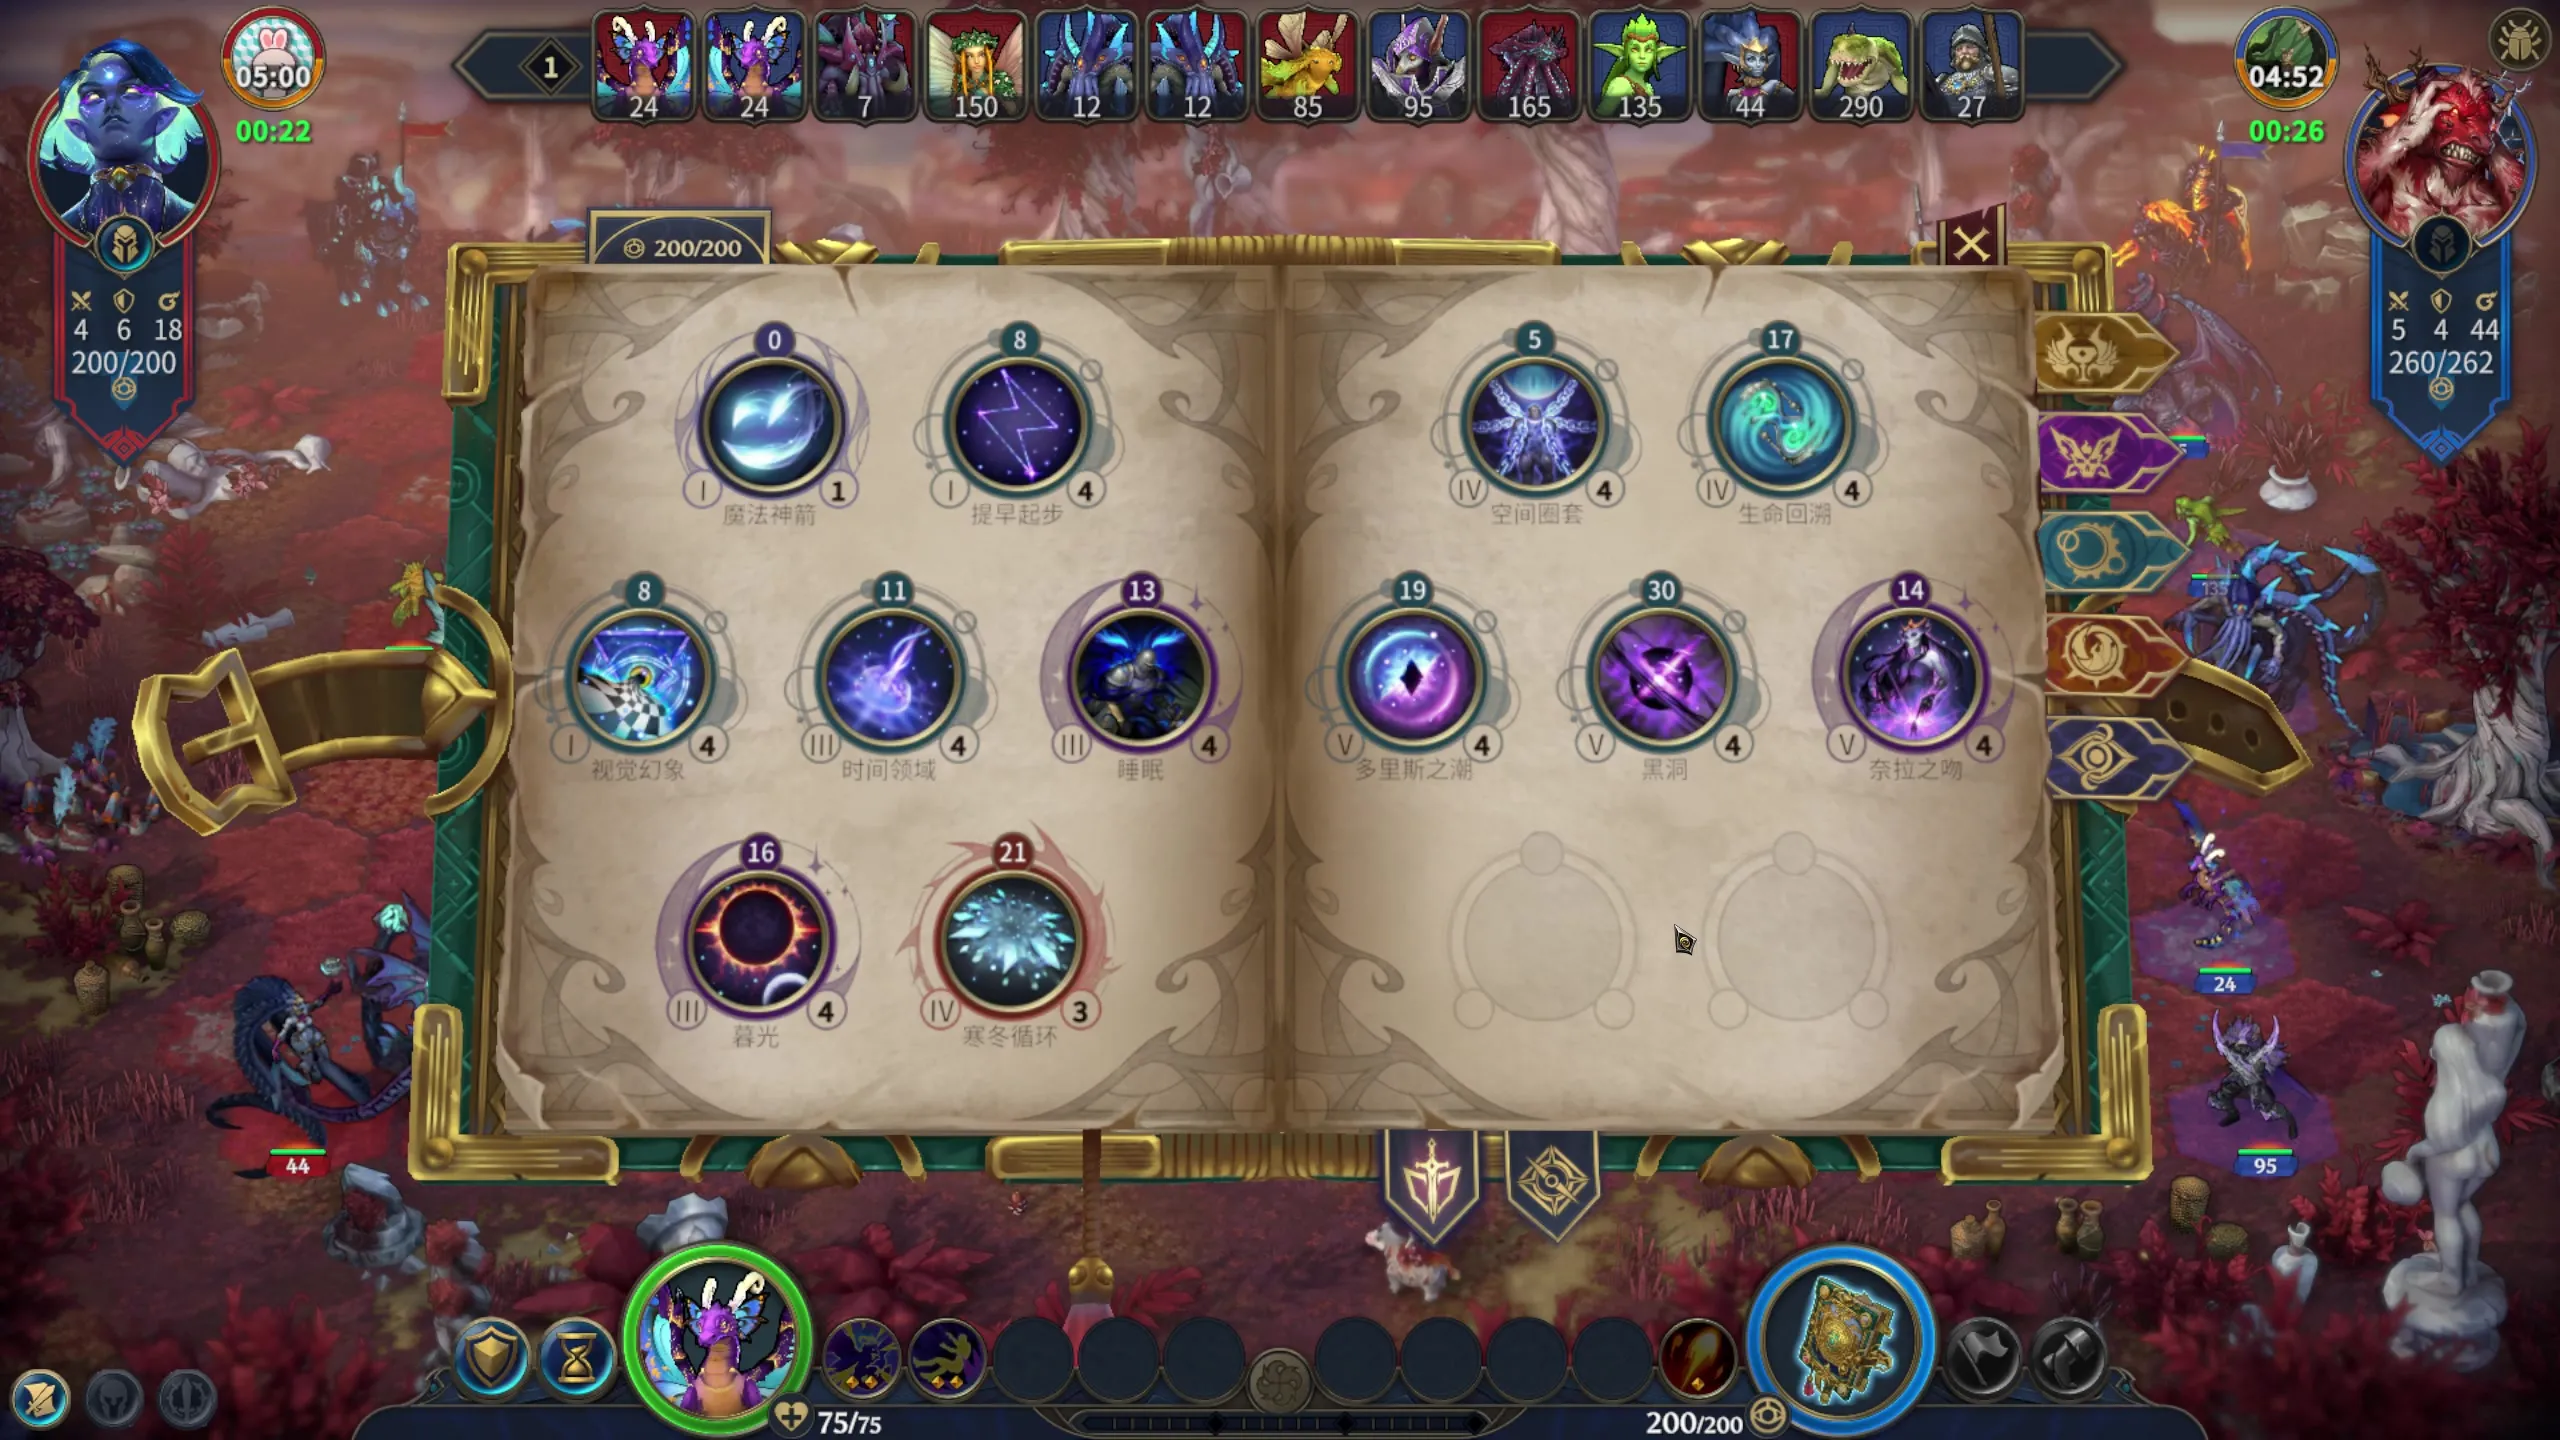
图 6:录像450.2秒。真正欠缺的还包括左下角罗马数字,以及名称没被读到的法术格子。魔法书徽标实验分别检查周围数字和中央图案;中央在本图没有字,不代表其他画面也没有。
审核页现在能切换“15 张新增参考”和“全部 328 张候选”,逐项查看原读数、补读原文、分数与拒识;绿色框是助手参考,黄色框是自动搜索区域,小数字上不再盖长标签。
生物面板的小数字,也由视频入口自动补读
单项实验读得更好,只有接进视频流程才会帮助下一段录屏。现在可以开启生物标题与四个小属性格的原尺寸VL读取:程序从自动面板生成裁图,不需要人工框,并把新候选与原字段一起保存。
续接四个已有开发运行后,328张帧中有5张产生25个局部裁图,全部完成读取;182张因场景跳过,141张没有找到生物面板。这里没有增加独立测试视频或人工答案,25是可解析候选数量,不是正确数量。打开这5张原图能看到原读数和新候选;全部328张的处理状态也保留。原有模块与书页结果未改写,局部字面仍不授权在线状态提交。
状态提示也能自动找到,再整段重读
同一批328张图现在还接入了状态提示局部读取:先沿用自动生物面板,再找金色标题与正文,分别尝试原尺寸和放大后的裁图。两张提示产生四个文字区域、八次读取;182张场景跳过,144张未定位到支持的提示。旧读数、失败和没有找到的图片都保留,四个新字面候选不算已审标注。
打开视频状态提示能看到“阿丽娜之触”正文里的20%已经读回,原完整切块的低分拒识仍在旁边。这里接通的是提示文字,不是图标身份、单位归属或剩余回合;这些字段仍未知。
之后又用同一已曝光录像的20秒片段,从原视频执行单命令处理,得到11张关键帧并跑完已配置步骤。两张提示完成局部重读;本次运行单独查看,不与旧运行混在一起解释。总入口现在339张,但新增11张是接线回归,不增加独立来源或准确率证据。
魔法书数字也接到实际视频,而不只留在实验页
魔法书实验已经比较裁框、原尺寸与放大读法。这里先接入其中冻结的原尺寸双模型组合:自动找到书页,分别读取每格的上方、左下、右下与中央,再把字面和来源并列显示。新增的更小中央框试验仍单列,不混进本次视频结果。
这一步遍历18分46秒录像的248张既有候选,不输入人工框或答案。首次接线只读了11张书页,另7张被“两页都应有标题”的条件挡住。后来逐张查看发现,这7张都是左页有内容、右页空白的清晰书籍;单页实验因此补上“同一侧标题足够密集且排布整齐时,也尝试读取”的分支。
现在18张书页的1,008个位置都完成双模型读取:原616处复用完全相同的旧记录,新增392处各读两遍。共有535个可读候选、473个拒识;没有书页的94张和场景条件不满足的136张,也保留各自状态。接线检查确认全部248帧的旧模块不变,原11张书页的候选也不变。
打开全部书页时间线可以左右切帧、展开两模型原文与分数;7张单页对照还会把青色参考和黄色候选按位置相邻排列。可以分别筛选两种来源,不把参考答案混进预测。框是位置范围,不是精确字框,数字也没有自动解释成费用、等级或冷却。
随后逐张核对剩余10张双页,新增360个字面、200个负位置参考:冻结输出353项精确、7项拒识,没有错收。连同原7张单页和450.2秒图,18张书页的543个可见字面中535个读对、8个拒识,465个负位置没有误收。这只回答书页这些位置是否读对,不是整段视频或所有UI的准确率;相似书页也不是独立样本。
这10张图没有只标书页:还逐图核对了两侧80项英雄字段、40项角落时钟,冻结的本地视频读数120项都一致。打开同帧HUD对照可切换参考与本地结果;数值仍按屏幕位置保存,不自动认定资源类型或哪侧是我方。新增参考待作者确认,其他UI仍有缺口。下一步转向不同录像和短悬停说明,避免继续积累同一书页的重复成绩。
查阅前两轮接线:整屏复读怎样进入视频,各模块怎样串联
2026-09-12:读得更清楚,还要让下游收到新读数
小字 OCR 对照已比较小切块和局部数字复读,但视频入口原来仍固定旧配方。另一个隐蔽问题是:审核页面可以显示合并后的文字,HUD 解析却读取原始多次尝试。如果只替换显示文字,模型的改进未必到达后面的字段读取。
现在一个命令可以选择 10 fps 稳定供样、小切块整屏 OCR,再把自动找到的数字区域交给本地 PaddleOCR-VL-1.6 重读。程序保存原文、复读原文、是否采用以及未采用原因,并把复读作为独立一次读取交给下游。不同读法仍可能导致字段拒识;复读没有沿用旧模型的置信分数。
两个相邻的一分钟开发片段,共留下 53 张原图,完成 1,997 个自动数字区域的复读,38 处候选文字改变。它们来自此前用于短悬停研究的同一段录像,没有输入人工框或答案,但也不是独立测试集。这些数字只说明接线和处理范围:改写不等于改对。
| 视频区间 | 稳定原图 | 完成数字复读 | 采用的文字改写 |
|---|---|---|---|
| 27:00–28:00 | 29 | 1,100 | 23 |
| 28:00–29:00 | 24 | 897 | 15 |
例如 1635.8 秒原图左上角清楚显示 02:47。整屏合并结果原先是 02:4,局部复读补成 02:47;时间线上可以同时看到原读数和复读值。该图的小切块原始尝试其实已经读对,所以这里证明的是新候选与证据确实传到了页面,不能把它额外算作此前 HUD 从未读出的新字段。
同一图也有反例:一块背景纹理先被读成 10,复读又变成 2。两个模型都输出数字,仍不能证明那里有数字。下一步必须同时检查文字位置是否可信,不能只比较识别器谁的读法更像一个整数。
更明显的缺口出现在场景判断:29 张图中,10 张被送往战斗模块,19 张仍为未知。其中一张已经识别出“生物属性面板”,但两个视觉方法对“是否遮挡”的标签不同,整个战场补充判断被拒绝了,面板字段也随之跳过。修好 OCR 不能自动修好这道门。接下来应分开评估“底层是不是战场”和“局部内容能不能读”,保留过渡、遮挡及非游戏画面的反例。
两个片段合计有 30 张图进入战斗模块、23 张因场景未确认跳过。已运行部分产生 360 个行动条框、358 个身体框和 83 个数量牌候选;这些数量也不是召回率,原图抽查仍能看到没有提出的牌。所有结果在统一时间线中按模块展示。技能栏、玩家身份和状态图标的完整检测仍未接通,不会因 OCR 能读出几行文字就被标成完成。下面保留先前完整录像接线的测量,便于比较任务范围。
2026-09-10:让各模块真正处理同一段录屏
过去各实验可以展示自己的案例,但这不等于输入一段新视频就能得到整套结果。这次先补这个缺口:一个命令接收原录像和固定模型配置,生成稳定候选、整屏 OCR 和逐帧模块结果。审核器不再要求一张图先有标注,才允许它出现在列表里。
flowchart TD
 V[Source video] --> S[Stable candidate frames]
 S --> O[Full-screen OCR]
 O --> C["OCR and visual<br/>scene candidates"]
 C --> M["HUD, turn strip, panels, logs,<br/>body and quantity candidates"]
 M --> R["Timeline: outputs<br/>and module status"]
图 7:9 月 10 日连接的路径,尚不含后来的单格补读。没有运行的模块也进入状态列表;空检测结果不能代替“尚未接入”。视觉场景模型使用历史参考库,待测帧的参考答案不进入推理。
两段 2560×1440 录屏全段采样,采用已有稳定模型和 paddle-fused-guarded OCR 配方,没有针对这两段视频重新训练。OCR 保留原始多次读取与合并结果,原尺寸彩色读取、其他预处理和裁块读取的来源不会被混成同一种证据。
| 本轮录屏 | 长度 | 稳定候选 | OCR 已处理 | 选中的文字/数字读数 |
|---|---|---|---|---|
| 02:51 开始的录屏 | 4 分 22 秒 | 27 | 27 | 1,101 |
| 06:46 开始的录屏 | 18 分 46 秒 | 248 | 248 | 12,978 |
| 合计 | 约 23 分钟 | 275 | 275 | 14,079 |
含未选中的备选,共保留 32,639 条 OCR 记录。这些数量只说明处理范围,重复读数与错误仍可能存在。本轮是开发接线数据,不是盲测:没有穷尽整帧人工参考,也尚未完成录像别名与历史训练来源的独立审计,不能由此报识别准确率。
一个接起来才发现的漏口
第二段录像的 553.4 秒是普通战场:顶部行动条存在,但没有明显的回合提示文字。OCR 场景规则输出未知,后面的战斗模块因此被跳过。这说明文字搜索很有用,却不能负责判断所有战斗画面。
本轮复用 B022 的历史参考模型,让颜色布局与边缘布局分别找相似场景。两者标签一致,颜色距离不大于 0.10、与次近类别的差距至少为 0.008,才允许给 OCR 未知帧补一个“战场候选”。阈值没有用这两段录像重新选择;已有菜单判断、过渡或中断不会被覆盖。即使补上战场,也不推断是否我方回合、是否准备好行动。
第二段的两条路线都跑完了 248 帧:加入视觉后,战场候选从 45 增至 112,未知从 72 降至 5,其他顶层场景数量没有变化。战斗模块因此多处理了 67 帧,行动条框从 334 增至 1,163。其中仍有 113 个框的身份未知、269 个框的红蓝颜色未知。这些是处理数与拒识数,不是正确率;大量头像来自同一段录像的连续画面,也不能算作独立泛化样本。
原图抽查包括上述普通战场,以及两张打开魔法书的画面。它们能支持“底层仍是战场”,却没有证明书页内所有技能都已识别。全部新增帧尚待逐项参考审核,不能因为未知数减少,就认定每个补充判断都正确。
在时间线里应该看到什么
每张新候选保留原图、视频时刻、角落场景标签、OCR 框和已接模块的输出。时间线支持左右键、滑条和文字检索,并分别显示成功、失败、场景条件不满足、等待输入、未接入与延期。原图或 OCR 改变时,旧模块结果停止展示,避免文字框贴到错误图片上。
9 月 10 日的接线包括整屏 OCR、场景、英雄数字与计时、顶部行动条位置/类别/颜色、面板字段、日志字面声明、双行数字预览,以及战场生物身体和数量牌候选。当时 HUD 只使用全图 OCR 读数,没有再次扫描局部裁图,不能沿用专门 HUD 裁图实验的最好成绩;9 月 12 日的数字复读增量见上文。固定布局的 HUD 和行动条只接受原生 2560×1440。
新增的身体与数量牌模块处理了第二段的 112 张战场候选,其余 163 张按场景条件跳过。它们产生 1,234 个身体框、1,176 个数量牌候选,其中 1,055 项通过同一 OCR 模型的两次读数一致检查、121 项数值留空。这里的两次一致不是两个独立算法共同证实,更不是正确数量的保证。
身体使用已有的历史检测与分类模型,类别排名只作建议,尚未通过身份接受校准;没有把历史模型称为最新最佳模型。数量牌则独立寻找血条和下方红蓝区域,不要求身体先检测成功。检测位置靠得近只提供可能的身体—数量关联,不确认它们属于同一支部队。
为检查读数,我们从算法已经提出的区域中选了 10 帧、40 个裁图:32 个清晰数字读数一致,另有 2 个遮挡牌与 6 个非牌。其中两个魔法书装饰边框被读成 1,一个无法可靠转写的遮挡牌仍被输出为确定数字。这是开发阶段的后验抽查:它能发现“读数一致也会错”,不能估计未提出的牌有多少,更不能推出整场 OCR 准确率。逐项图片和分组结果见数量牌文章。
| 9 月 10 日的部分 | 可在时间线检查的结果 | 尚不能据此确认 |
|---|---|---|
| 场景、文字与字段 | 原文、位置、场景候选及模块执行状态 | 所有文字找齐、最终选中了哪个选项 |
| 身体与行动条 | 位置、类别建议或未知、红蓝外观 | 每个类别正确;红色或蓝色必然等于我方 |
| 数量牌 | 数字候选、拒识、可能的身体关联 | 血量百分比、全场所有部队数量或关联正确 |
| 日志 | 当时写下的效果与持续时间 | 当前剩余回合、完整持续战局状态 |
| 尚未接入 / 暂缓 | 玩家头像、底栏技能、选择页完整元素仍缺;状态图标暂缓 | 未运行不等于检测后确认不存在 |
上述 9 月 10 日检查点及测量保留不变。后续还要补多视频的非牌与遮挡参考,并比较扩充数据身体检测器的实际接线表现;处理数量变多不直接等于准确率提高。行动条颜色、绿色移动范围、底部头像高亮和计时变化可以作为回合判断的待验证线索:计时是否在走必须比较多帧,单个高亮不能直接确认行动方。
只想查进度时,可以从这里跳转
下面只是给已经了解方法、想快速查结果的读者准备的索引,不是另一套章节顺序。
展开各专项的结果入口
| 阅读顺序 | 文章与具体位置 | 这次主要看什么 |
|---|---|---|
| 1 · 整体结果 | 本篇第 5 节 | 328 张候选和局部数字补读;哪些模块运行、哪些缺失;为什么不是盲测 |
| 2 · 身体与数字 | 生物身体的最新接线、数量牌真实视频抽查 | 框、类别建议、数字候选各自代表什么;遮挡和魔法书装饰为何误读 |
| 3 · 找图与读字 | 整屏与局部 OCR、视觉场景补充 | OCR 选型和扫描范围;没有明显文字时怎样保留战场候选 |
| 按需 · HUD / 属性 | 计时与上方行动条、英雄与生物属性字段 | 定位、类别、颜色、字段读数要分开核对;专项高分不自动适用于整段视频 |
| 按需 · 效果证据 | 日志中的效果与持续时间、状态图标与短悬停供样 | 日志说过几回合不等于当前还剩几回合;稀疏参考不冒充完整检测模型 |
读结果时,先分清两种记录:模型候选是算法提出的框或读数;助手参考是看原图核对后的标注。B12 的部分参考已获作者授权采纳,本轮数量牌裁图参考仍待用户确认,各批次分别注明。
再看标注范围:一张图的生物都画了框,不表示它的文字和图标也标全了。当前 328 张本地视频候选没有算作全标注图;旧批次 159 张精选图的整帧完成数仍为 0。这是不同批次,不能混用分母。
目前已经能从原视频产生可追溯的本地候选,缺失字段的局部补读也能到达同一张原图。局部场景门控已做过保守改进;这轮则把下一步指向数字定位,尤其是魔法书和非数字背景。独立来源与完整元素参考仍要继续补。标注网站按视频、时刻和图像编号提供原图对照;博客解释方法和证据,不公开整个本地录屏库。
保留的早期快照:2026-09-06
早期整理的 640 张关键帧中,OCR 规则命中 467 张、173 张未知;当时审核记录为 1 张确认、639 张待确认,另选 45 张代表帧排错。B023 当时缓存五类、186 帧、617 个图标槽位与 530 个已解析身份。这些是原日期的实验快照,不是本轮处理数,也不是当前全库完成度。
Comments