P64 · 生物属性 · 实验记录与相关篇目
局部入口已接可选视频和网站:6秒原片得到5图,两张未知场景单独读面板。先前15张开发图相符99/165→165/165;已知半透明反例已另修复,泛化未验收。参考待CTO审阅;能力、图标与说明未全标。
在《英雄无敌:上古纪元》的回合制战斗里,同一个战场可以打开魔法书、英雄资料、生物属性或战斗日志。AI 不仅要知道打开了哪个界面,还要读到里面的数值,并知道它属于谁、是否仍然有效。读出数字、给数字找到字段、把字段绑定到正确对象,是三个不同步骤。
先看字段怎样组织和读取,再看局部入口的改善。最新一轮同 15 张开发图的 165 项候选与参考相符,但能力列表、状态图标和时长不在这个分母里。
展开局部入口的已知错误修复与视频接线记录
字读不出来,有时是因为程序根本没有去读。 从已有录像截图中选了 15 张生物面板,逐张记录名称、阶级、数量,以及一行八个属性,共 165 项。原局部候选只有 99 项相符;另外 6 张面板被整图场景判断挡住,66 项都没输出。
现在程序只检查当前面板中的标题、阶级、数量、生命行和外观;这些信息能拼成一个明确面板,就只读这一块。整图仍可以是“未知”,其他检测器不会跟着放行。这次没有换识字模型,新增 42 个局部请求、复用 57 个严格匹配的旧请求后,同一批图的 165 项均与参考相符。
打开这 15 张原图与逐字段对照。蓝框是程序找到的局部搜索区域,不是人工真值或精确面板边界。页面还保留 22 张阻断、20 张无面板的反例,以及一张仍误放行的半透明面板。
现在新入口也接进了可选视频流程。这段 6 秒原视频选出 5 张图,其中两张场景未知,仍能单独读取生物面板。第二张读到了“圣骑兵”、13/18、102/119 和多个属性;第四张的伤害字段仍冲突,页面如实留空。首跑约 72 秒、续跑约 6.7 秒,已有图片和读数没有重写,全部输出约 6.84 MiB。
这次验证的是流程接通,没有新增独立准确率。先前165项仍是开发参考,待CTO审阅、未批准训练,也没有覆盖能力列表、悬浮说明、魔法图标和时长。随后补查背景,把已知半透明反例改为等待,15张清楚面板仍保留;最新对照没有重算165项OCR,也不代表所有过渡都能挡住。旧结果继续保留;下文解释字段怎样组织和读取,不把不同批次混成一个总准确率。
此前的标题识别模块已经能够把选择卡名称与图标身份关联起来。本篇往前推进一步:用现有原图和全图 OCR,加上已核对的字段区域,把读数保存成带有面板、对象角色和视频时间的观测。首轮在 9 张原图的 47 个可读数字字段中,45 个精确读对、2 个拒识,没有接受错误数字。这是给定区域的开发实验;自动找到所有字段、判断归属和跨帧跟踪仍未验证。
例如生物面板显示攻击 24,程序可以保存原文、数值 24、字段位置和视频时刻;如果还没认出是哪一支部队,就把身份和归属留空。这比只保存一个没有来源的 24 更方便复查。第 3 节给出这条实际输出。
下面先看字段如何组织、真实画面和读取过程,再看开发检查。第 5 节用新视频流水线中的例子解释:为什么 OCR 已经读对数字,最终字段却仍然为空。第 6 节用文字检索找到更多法术和生物面板,检查同样的问题是否还在。相关历史设计放在文末,第一次阅读可以略过。
flowchart TB
 A[Full-frame OCR] --> C[Strict field reader]
 B[Reviewed view and regions] --> C
 C --> D[Values or abstentions]
 D --> E[Source-linked observations]
 E --> F[Canonical names]
 E --> G[Literal log claims]
图 1:已有全图 OCR 与已核对区域先产生字段观测,名称和日志解析再消费其中合适的文字。拒识保留在输出中,历史状态与动作结果不由这条单帧流水线补全。
1. 场景 → 面板 → 对象 → 字段
| 层级 | 示例 | 必须区分 |
|---|---|---|
| 场景 | 技能选择、战场 | 当前画面与历史阶段 |
| 面板 | 选择过程的英雄卡、双方英雄边栏、英雄详情浮层 | 面板是否打开、是否被遮挡 |
| 对象 | 某个已识别英雄 | 玩家身份、队伍归属、界面左右位置 |
| 字段 | 等级、攻击、防御、法术相关属性、法力当前/上限 | 数字旁图标语义、基础值/显示总值/临时增益 |
| 观测 | 原文、解析值、矩形、时间、方法 | 本帧看到的数值与从历史保留的值 |
字段名应以当前版本游戏面板的实际含义为准。没有经过图标语义核对时,先记录“第 2 行左侧数值”,不要猜成攻击或法力。1、+1、1/20 也不能共享一个无单位数字字段。
这次要覆盖的信息比英雄属性更广:
| 界面 | 需要提取的信息 | 容易混淆的地方 |
|---|---|---|
| 战场两侧英雄栏 | 攻击、防御、魔法强度、当前/最大魔法量等可见字段 | 左右位置不直接等于我方、敌方 |
| 自己的英雄详情 | 面板属性、可见技能和装备 | 面板读数与战场有效显示值分开保存 |
| 双方生物详情 | 身份、攻击、防御、速度、先攻及可见效果 | 当前对象、数量与属性会随战斗变化 |
| 魔法书与提示框 | 法术身份、说明、消耗、已显示冷却、翻页 | 描述中的数值不是已造成的伤害 |
| 指向目标的预览 | 目标相关伤害或其他结果预览 | 要绑定法术和目标;预览不等于已施放 |
| 底部资源与技能条 | 资源填充、技能身份、明暗和冷却角标 | 暗按钮不能单独解释为资源不足或未轮到 |
| 战斗日志 | 每行原文、先后顺序、滚动上下文 | 相同文字可能是两次不同的行动 |
英雄归属不能永久写成“左边=我方”。应结合玩家栏、队伍颜色、英雄身份、面板标题和进入面板的已知上下文;证据不够时归属留空。同一个英雄可能出现在候选卡、选中英雄栏或战场敌方栏里,需要对象角色而不只是名字。当前导航设计只列自己的英雄详情入口,没有假设能打开敌方完整英雄详情。
2. 先看真实画面里有哪些信息
这轮选取同一录像 2026-09-08T02-42-52.657Z.mp4 中 302.024–1715.979 秒的 9 张缓存原图,均为 2560 × 1440。下面三个例子直接来自这次运行;点击可放大原图。画面中的中文是游戏原始像素。
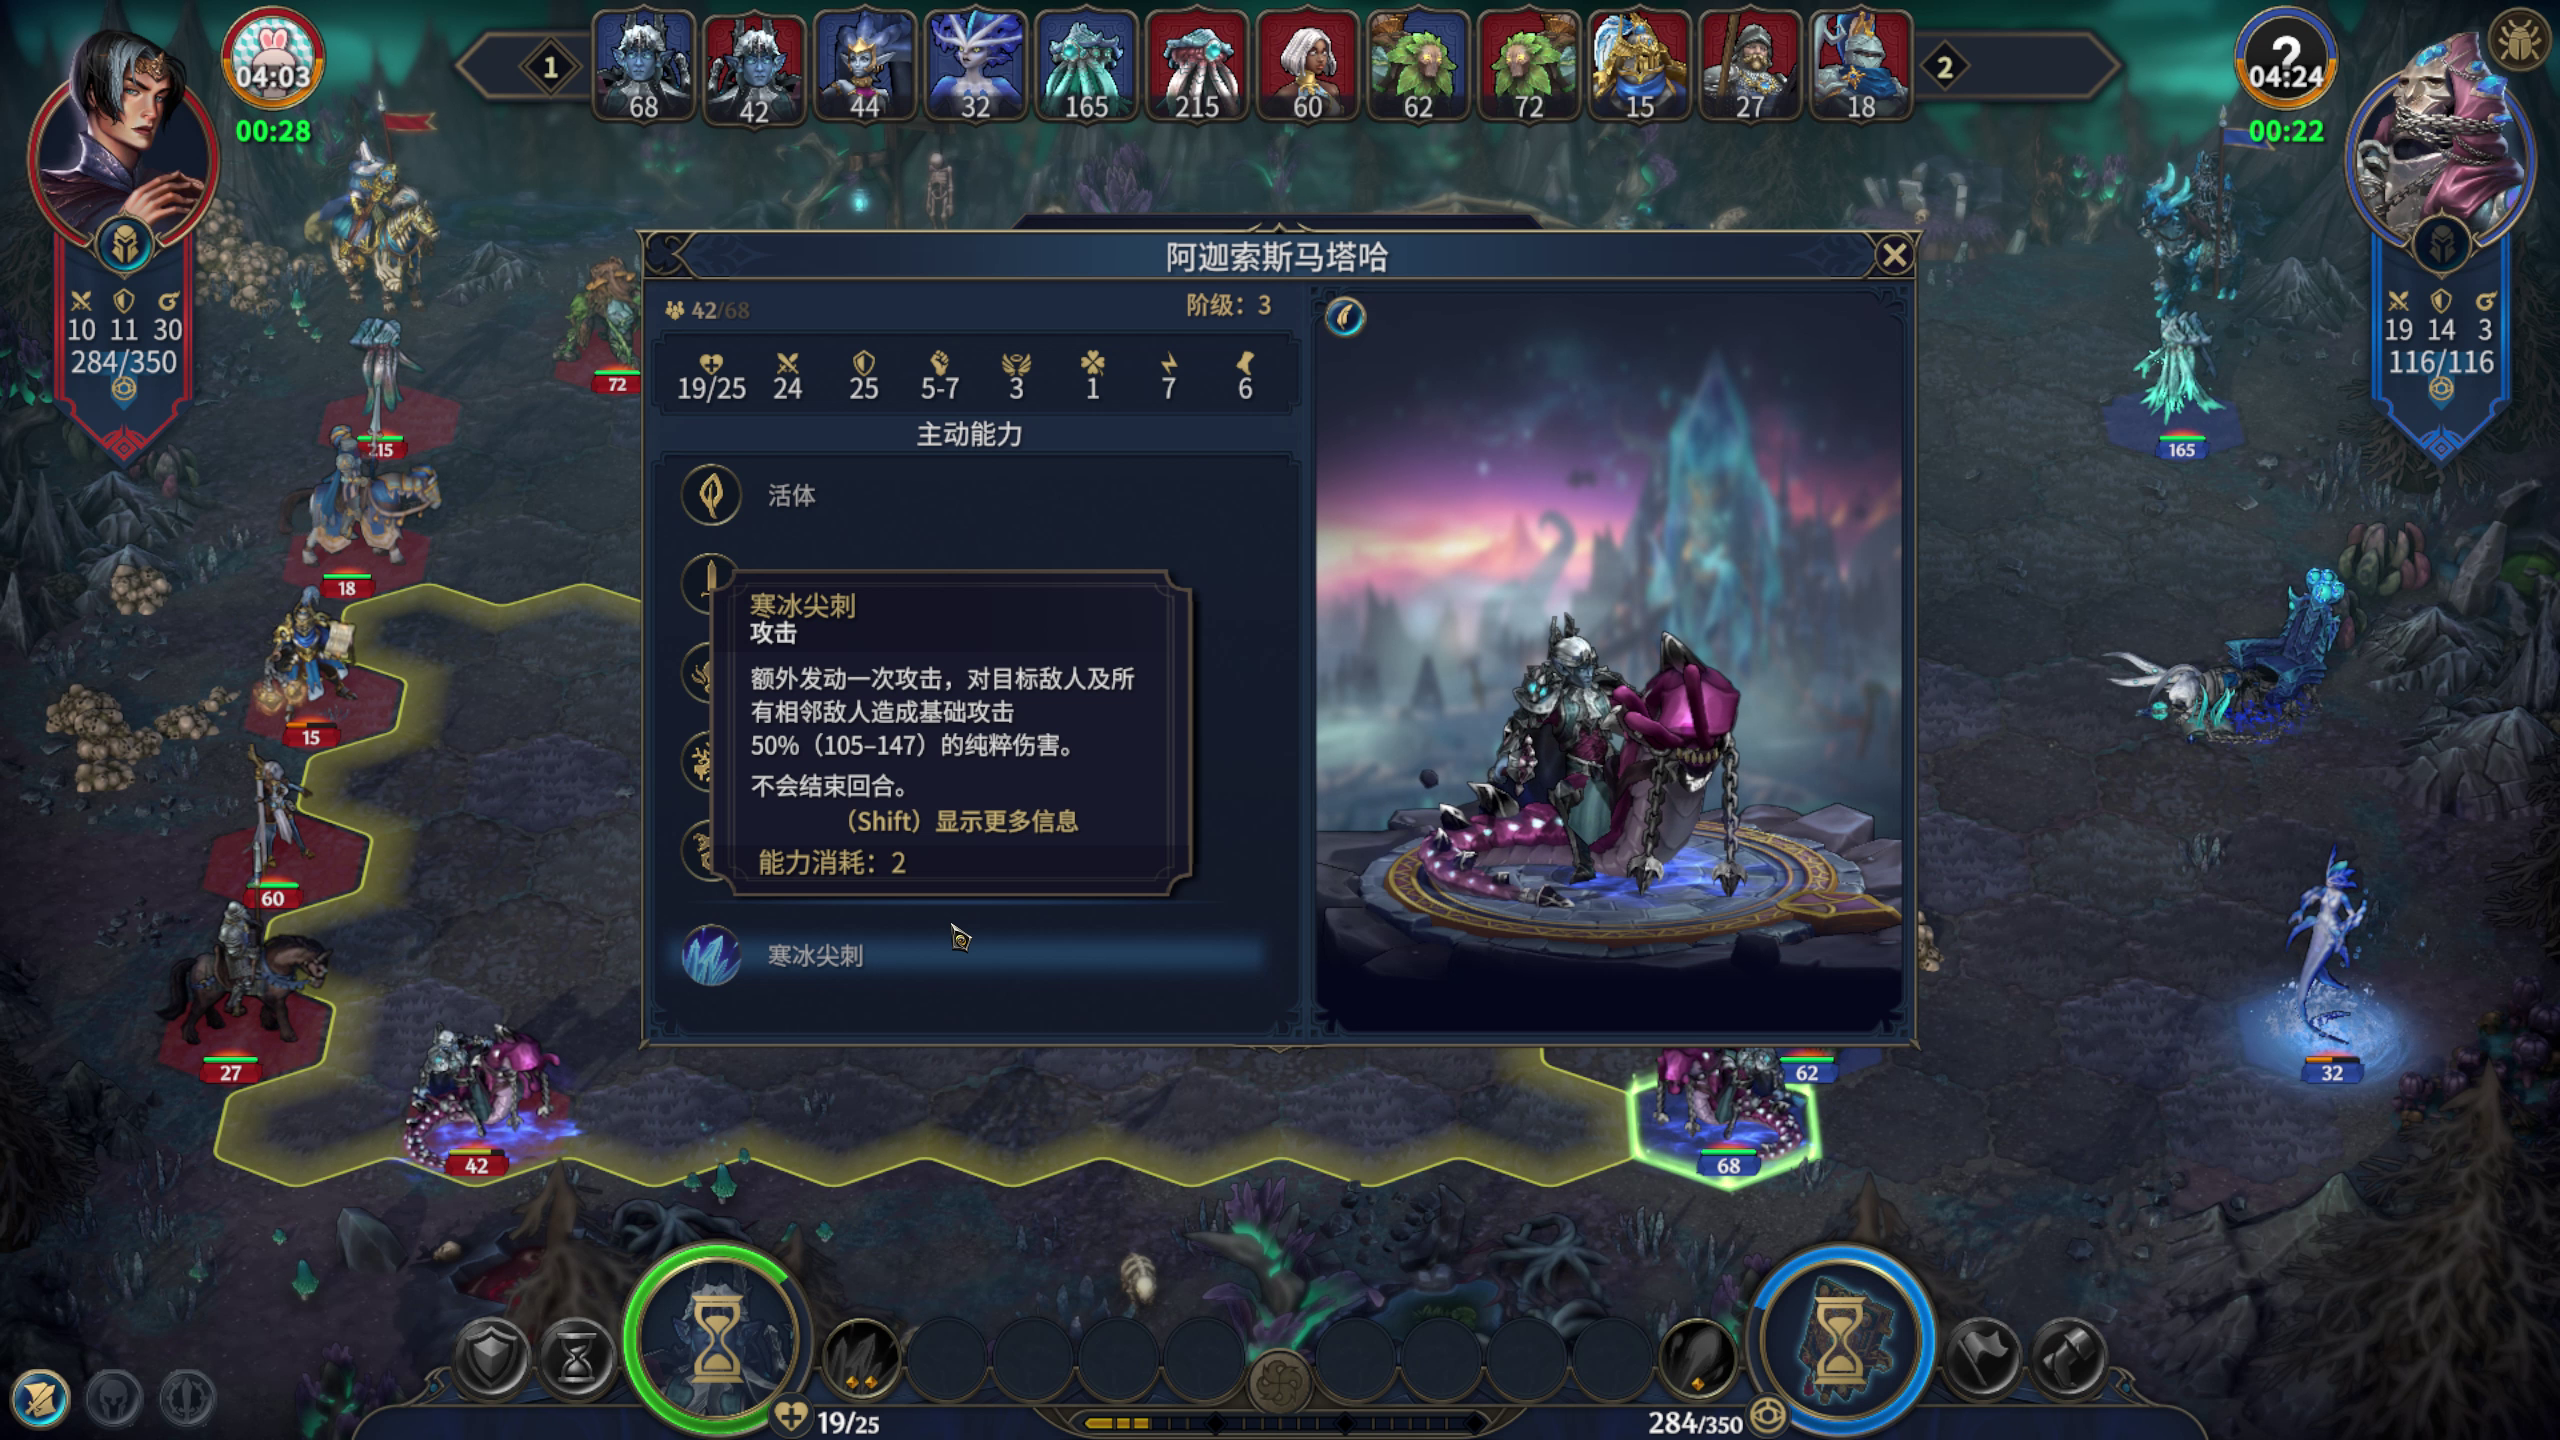
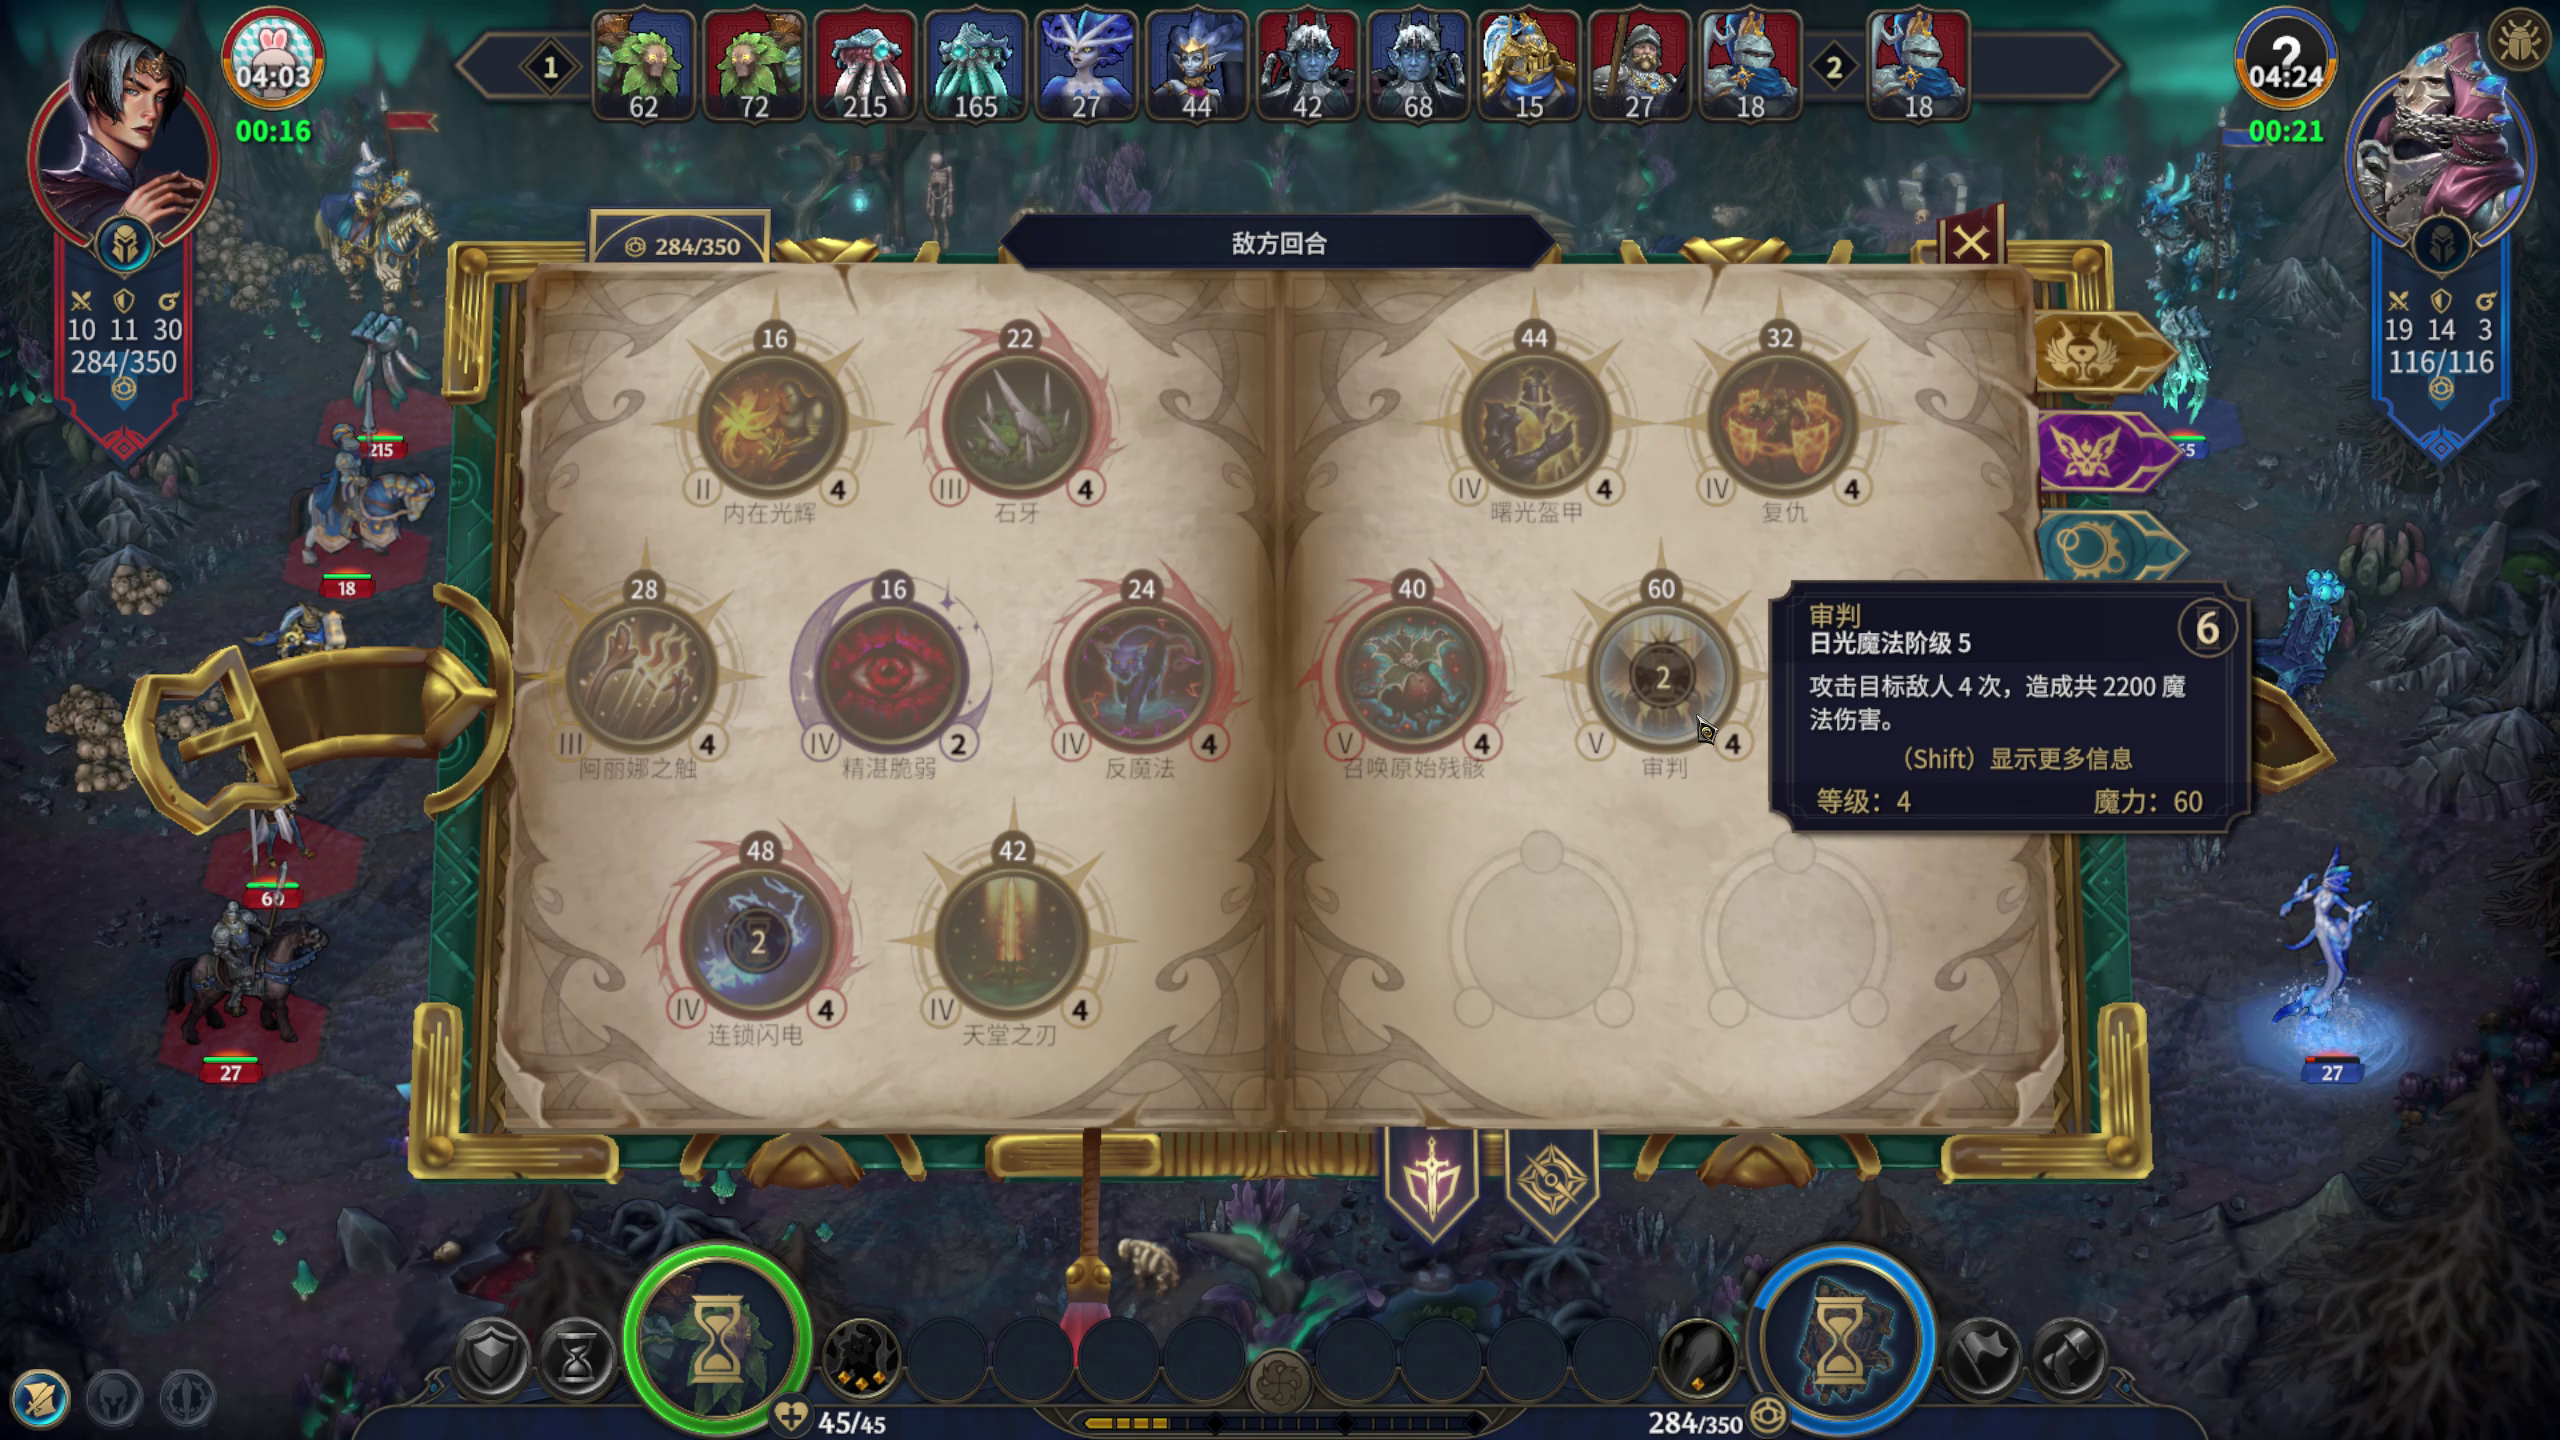
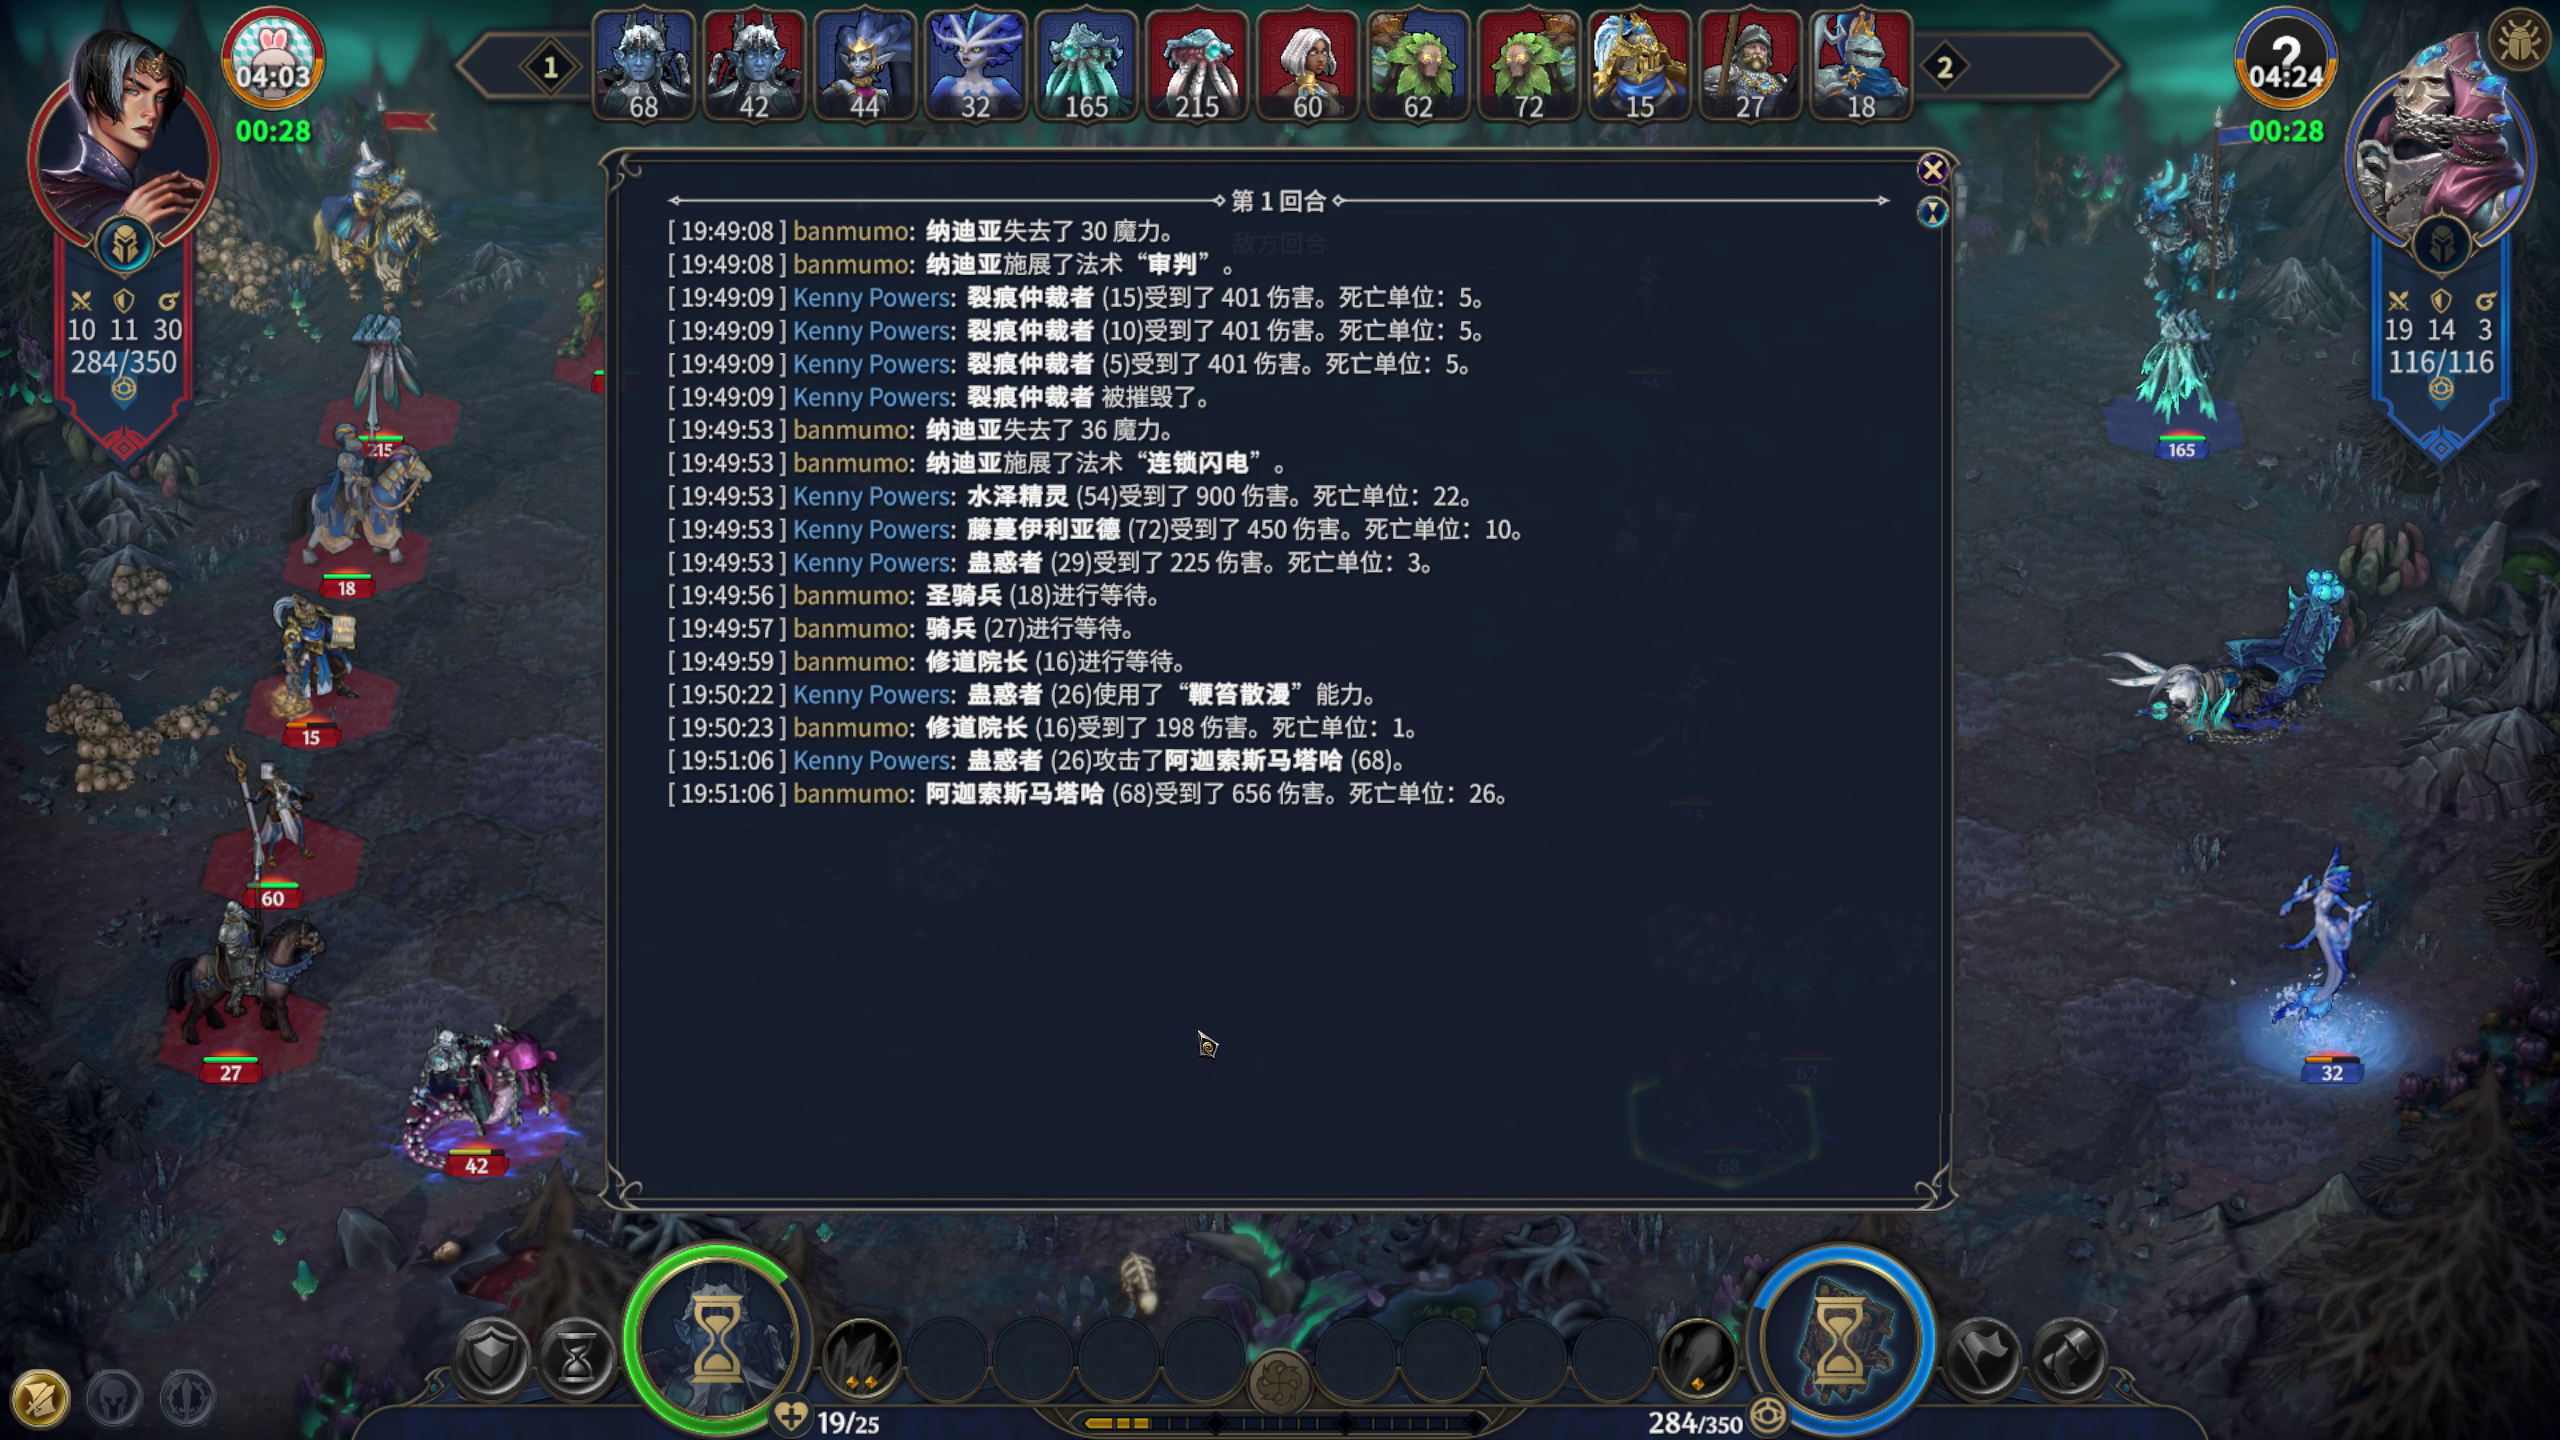
战场侧栏可能只展示部分属性,详情面板才展示其余字段。缺少的字段应该记为未观测,不能从选择阶段的老值推断现在仍相同。
首轮共准备 23 个面板/区域、72 个字段机会:68 个有可读参考,另外 4 个检查翻页中的固定位置、没有显式数字的底部分段条和空白技能位。分段条的能量/专注含义尚未核实。区域和语义角色由助手对照原图给定,期待值另外保存用于比对,不传入解析函数。这份原始运行中的敌我归属与规范实体身份保持空值。
OCR 输入是已保存的 PP-OCRv6 medium 全图检测与识别,包括原图和放大增强两次读法;本轮没有重跑 OCR、裁图识别或解码视频。解析器只筛选落在给定字段区域内的既有文字。初始引擎分数门槛为 0.90,尚未在独立视频上选择;引擎分数不等于整条状态正确的概率。
| 字段组 | 参考数量 | 精确一致 | 已接受但不一致 | 拒识 |
|---|---|---|---|---|
| 可读数字 | 47 | 45 | 0 | 2 |
| 可读文字 | 21 | 17 | 2,均仅空格差异 | 2 |
| 不应输出值的控制区域 | 4 | — | 0 | 4 |
数字的两次拒识有不同原因:一个可见的 7 没被 OCR 检出;另一个 350/350 仍清晰,但整帧被上游判为翻页,当前保守的整帧门控也阻止了侧栏更新。这正好指出下一处改进:只冻结正在变化的面板。没有显式数字的底部分段条被拒识,只说明数值 OCR 没有读数,并不说明视觉填充量无法检测。
文字结果按保留内部空格的转写比对。开发时发现第一版会删除空格,修正后保留了旧运行,再生成上述 v2 结果;因此不能将这组数据包装成一次未接触的独立测试。两条冲突日志还说明,多次 OCR 读法的一致性判断需要区分排版差异和内容差异。
完整 9 张原图、区域框、原文、输出与拒识原因可在本机只读结果页逐项查看,需要本机标注服务运行。可复现入口为 perception/experiments/b025_scene-field-understanding/run_pilot.py,实验协议和小型参考表与代码同目录保存。
标题 OCR 通常识别中文名称;数值 OCR 还必须处理小数字、符号、分数、颜色变化和图标紧邻文字。可以比较整面板 OCR 与字段小裁图 OCR,输出 raw_text 后再做类型解析。一个高置信度的 4 仍可能来自错误的英雄、错误的行,或错误的字段图标。
第一版字段解析器先复用已经存在的全图 OCR,按明确的字段区域收集文字。整数、百分比、当前/上限、范围和带括号的显示值分别解析。括号里的数字只记录为括号值,没有证据时不命名为“基础属性”或“加成”。
同一区域的不同 OCR 读法必须相容。出现低分字符、读不完整或互相冲突时,保留原文并拒识;不会先删掉看不懂的字符,再把剩下的数字当作结果。例如两段文字 8 9 不能拼成 89,O 不能按常识修成 0。没有冷却角标也不能自动记作零冷却。这会拒绝一些实际可读的区域,但可以等待后续清晰帧或专门的小区域重读。
用同帧标签核对角标含义
为了进一步理解数字旁边的图标,后续从同一开发视频选出 15 帧、6 个稀疏窗口或锚点组,与首轮样本有重叠。助手逐张核对原始像素和可见区域,并验证已有原图与 OCR 的帧 ID、尺寸、文件大小、修改时间及全图处理范围相符。它们是已审核的手工记录,没有加入上表的自动读数成绩,也没有构成新的独立测试。
“审判”图标上方在 355.986 秒显示 30,414.002 秒显示 45,553.988 秒显示 60。最后一帧的提示文字提供了位置与含义的直接联系:右下 4 对应等级 4,上方 60 对应魔力 60。中央覆盖的 2 与提示框圆圈中的 6 是另外两个读数,不能一起叫作冷却;中央没有数字时也不能补成零。这种同帧核对只解释已经看到的标签,不用目录中的基础消耗覆盖当前读数。
另有一个来源问题需要纠正:资源审核曾把英雄详情的右侧分数区域命名为魔法量,但所引用的旧字段本身仍是未证实语义。该名称不能反过来证明含义。自动流程继续保存 resource_right 和实际读数,等明确标签或独立图标证据确认;历史数值与参考评分保持不变。
底部技能图标从彩色变暗、肖像或书本上出现沙漏、分段条出现短黄色填充,都可以先保存为外观。现有像素还不足以把暗色换算成“不可用”,或把填充长度换算成专注点数。502.061 秒的技能提示明确写有“能力消耗:2”;这解释的是该提示中的消耗,没有给出剩余冷却。属性图标也与知识目录的原始图标逐项对照,面板显示值仍与基础属性、敌我归属分开记录。
3. 观测更新,不等于凭规则补全数值
下面摘录首轮 502.061 秒生物详情里攻击字段的实际输出,并从父记录带入视频时间。字段和面板位置由本轮参考给定;owner 和 entity_id 为空,表示该运行尚未解决归属与规范身份。完整结果还保留字段框和原始 OCR 行。
{
  "video_id": "2026-09-08T02-42-52.657Z",
  "timestamp_seconds": 502.0606333333334,
  "subject_ref": "creature-information",
  "semantic_view": "PANEL_DISPLAYED_VALUE",
  "entity_id": null,
  "owner": null,
  "field": "attack",
  "raw_attempts": [{"variant": "ORIGINAL", "raw_text": "24"}],
  "value": {"number": 24},
  "status": "OBSERVED",
  "authority": "OCR_OBSERVATION_NOT_GROUND_TRUTH"
}
当前实现可以保存一条归属未定的局部 OCR 观测;只有进一步解决字段含义与对象归属,才适合更新对应英雄或生物的游戏状态。解析器目前不携带历史值,也没有实现过期策略。
名称可以先解决其中一部分。新增的共享名称解析器消费已读出的标题、明确的对象类型和来源,在游戏知识目录的规范名称及已有别名中寻找唯一精确对应,不通过近似拼写猜身份。例如画面里的“审判”可以通过已有别名关联到同一个规范法术记录,同时保留原文。
在原 9 帧的名称开发检查中,8 次可读名称、涉及 5 个不同名称,全部找到唯一目录对应(8/8);缓存 OCR 与人工转写指向相同记录,另一个不可见名称保持未观测。这验证的是给定标题文字与类型之后的目录对应,不是从全图找到名称的正确率。名称相同也不能确定某一支战场部队或其玩家归属,因此不会据此填写 owner,也没有改写上面的历史字段结果。
下一阶段的时序层应在翻页期间保留上一条观测的时间,同时把当前值标为不可见或待确认;不能把历史值复制进“本帧检测结果”。观察到新数字时先保存原文与来源,异常跳变可以触发重读或下一帧确认,不能为了符合模拟器预期而强行改成旧值。
升级、技能、装备或战斗效果可能伴随数值变化。系统可以记录“前后发生变化”,但仅凭画面时序不能证明某个动作是唯一原因。基础属性、当前显示总值和临时修正要分开;首次实现可以只提取屏幕显示值,不推算隐藏规则。
还要保留同一时刻、不同面板上的不同读数。例如玩家观察到,战场边栏的魔法强度有时小于自己英雄详情里的值,怀疑与敌方宝物有关。当前应记录为两个来源不同的显示值;原因仍需独立核对。既不能用详情值覆盖战场值,也不能为了符合某条规则改写 OCR。
切出游戏、断线、暂停时,当前单帧门控会停止正常字段提交。后续时序层还需观察恢复,返回时重新识别英雄与面板,给历史数据标记年龄和可能过期状态。阈值、过期时间和连续确认次数要从序列验证中选择,不能作为已经可靠的默认保证。
悬浮提示框则需要区别处理:它挡住的背景字段暂停读取,但提示框自身可能正是我们想要的法术伤害、技能消耗或属性解释。认识到具体面板后只读取其可见区域,不再把所有悬停画面一律丢弃。
4. 给定区域时,实际读到了什么?
这轮补标复用已有原图:16 张面板或悬浮说明图新增 230 个字段,加上 B030 的 4 张日志图、46 个字段,共 20 张图、7 段录像、30 个区域框和 276 个字段框。这些是助手补标、等待用户复核的参考,不是新采集的录像。
最新补标包含法术书悬浮说明、生物属性与能力说明、英雄详情、专注值提示和日志。类别可在同图重叠,不能把各类图片数直接相加。复用 B024 已选定的 OCR 配方,在这批 276 个给定字段区域中精确读回 262 个:数字表达 99/103、文字 163/173。保留失败包括字母图标黏住数字、法术名称错字和标点漏读;未知槽位不擅自补语义。
这批图是通过 OCR 检索挑出的开发资料,容易偏向本来就能读到文字的画面;262/276 不是新视频的整图准确率,也不测遗漏字段的召回。新增标签没有改变旧模型或历史划分,下一批继续补不同名称、来源与布局,以及不依赖 OCR 命中的视觉对照。
第一轮已经建立可执行的字段解析与视图观察合同,复用已有原图和 OCR 核对明确区域。它回答“给定这些区域能读出什么”,不等于自动字段定位器。后续比较整面板 OCR、小区域 OCR、位置约束及组合方法,按字段分别报告精确匹配、漏读、错误归属和拒识。
第二步在连续窗口比较数值变化时间、错误更新、过期值被误用,以及遮挡后的恢复。必须按视频隔离训练/开发/测试,不能用相邻帧的高度重复性制造高分。
自动面板与字段区域定位已交给独立的 B027 实验,检验程序如何从全图产生区域,再交给这里的字段解析器读取。其评估与本文的给定区域开发结果分开报告。资源条、技能明暗和冷却则可以从这次审核的窗口继续验证;“每 6 点充满一格、最多 3 格”等用户描述仍是待核对线索,不能直接变成像素计算规则。
此前的场景与图标审核不会要求用户重做。助手会继续按原视频和时间挑选面板、翻页及动作片段,记录每个新结果的用途与来源,只将确实无法消除的疑问交给用户。
给定区域的实验说明了字段如何读取。不过,把它接到自动视频流程后,还会遇到另一类问题:新模型读出了正确文字,后面的合并规则却不接受。
5. OCR 读对了,为什么字段仍然为空?
离线扫描会让多个模型或多种裁图方式读取同一处文字,再把这些读法交给字段解析器。这样做本来是为了核对,却暴露出一个接线问题:原来的 PP-OCRv6 会提供识别分数,新接入的 PaddleOCR-VL-1.6 数字复读没有同类分数。旧规则只要遇到一个无分数读法,就把整个字段留空,即使几遍都读成了同一个数。
以这张图左上角的生物数量 32/68 为例。已有完整高分读数,其他读法也一致,但旧字段输出仍是“含无分数读法”。新的实验规则允许保留这个数,同时保留每遍原文;它不会给新模型编造一个分数,也不把一致理解成已由用户确认。
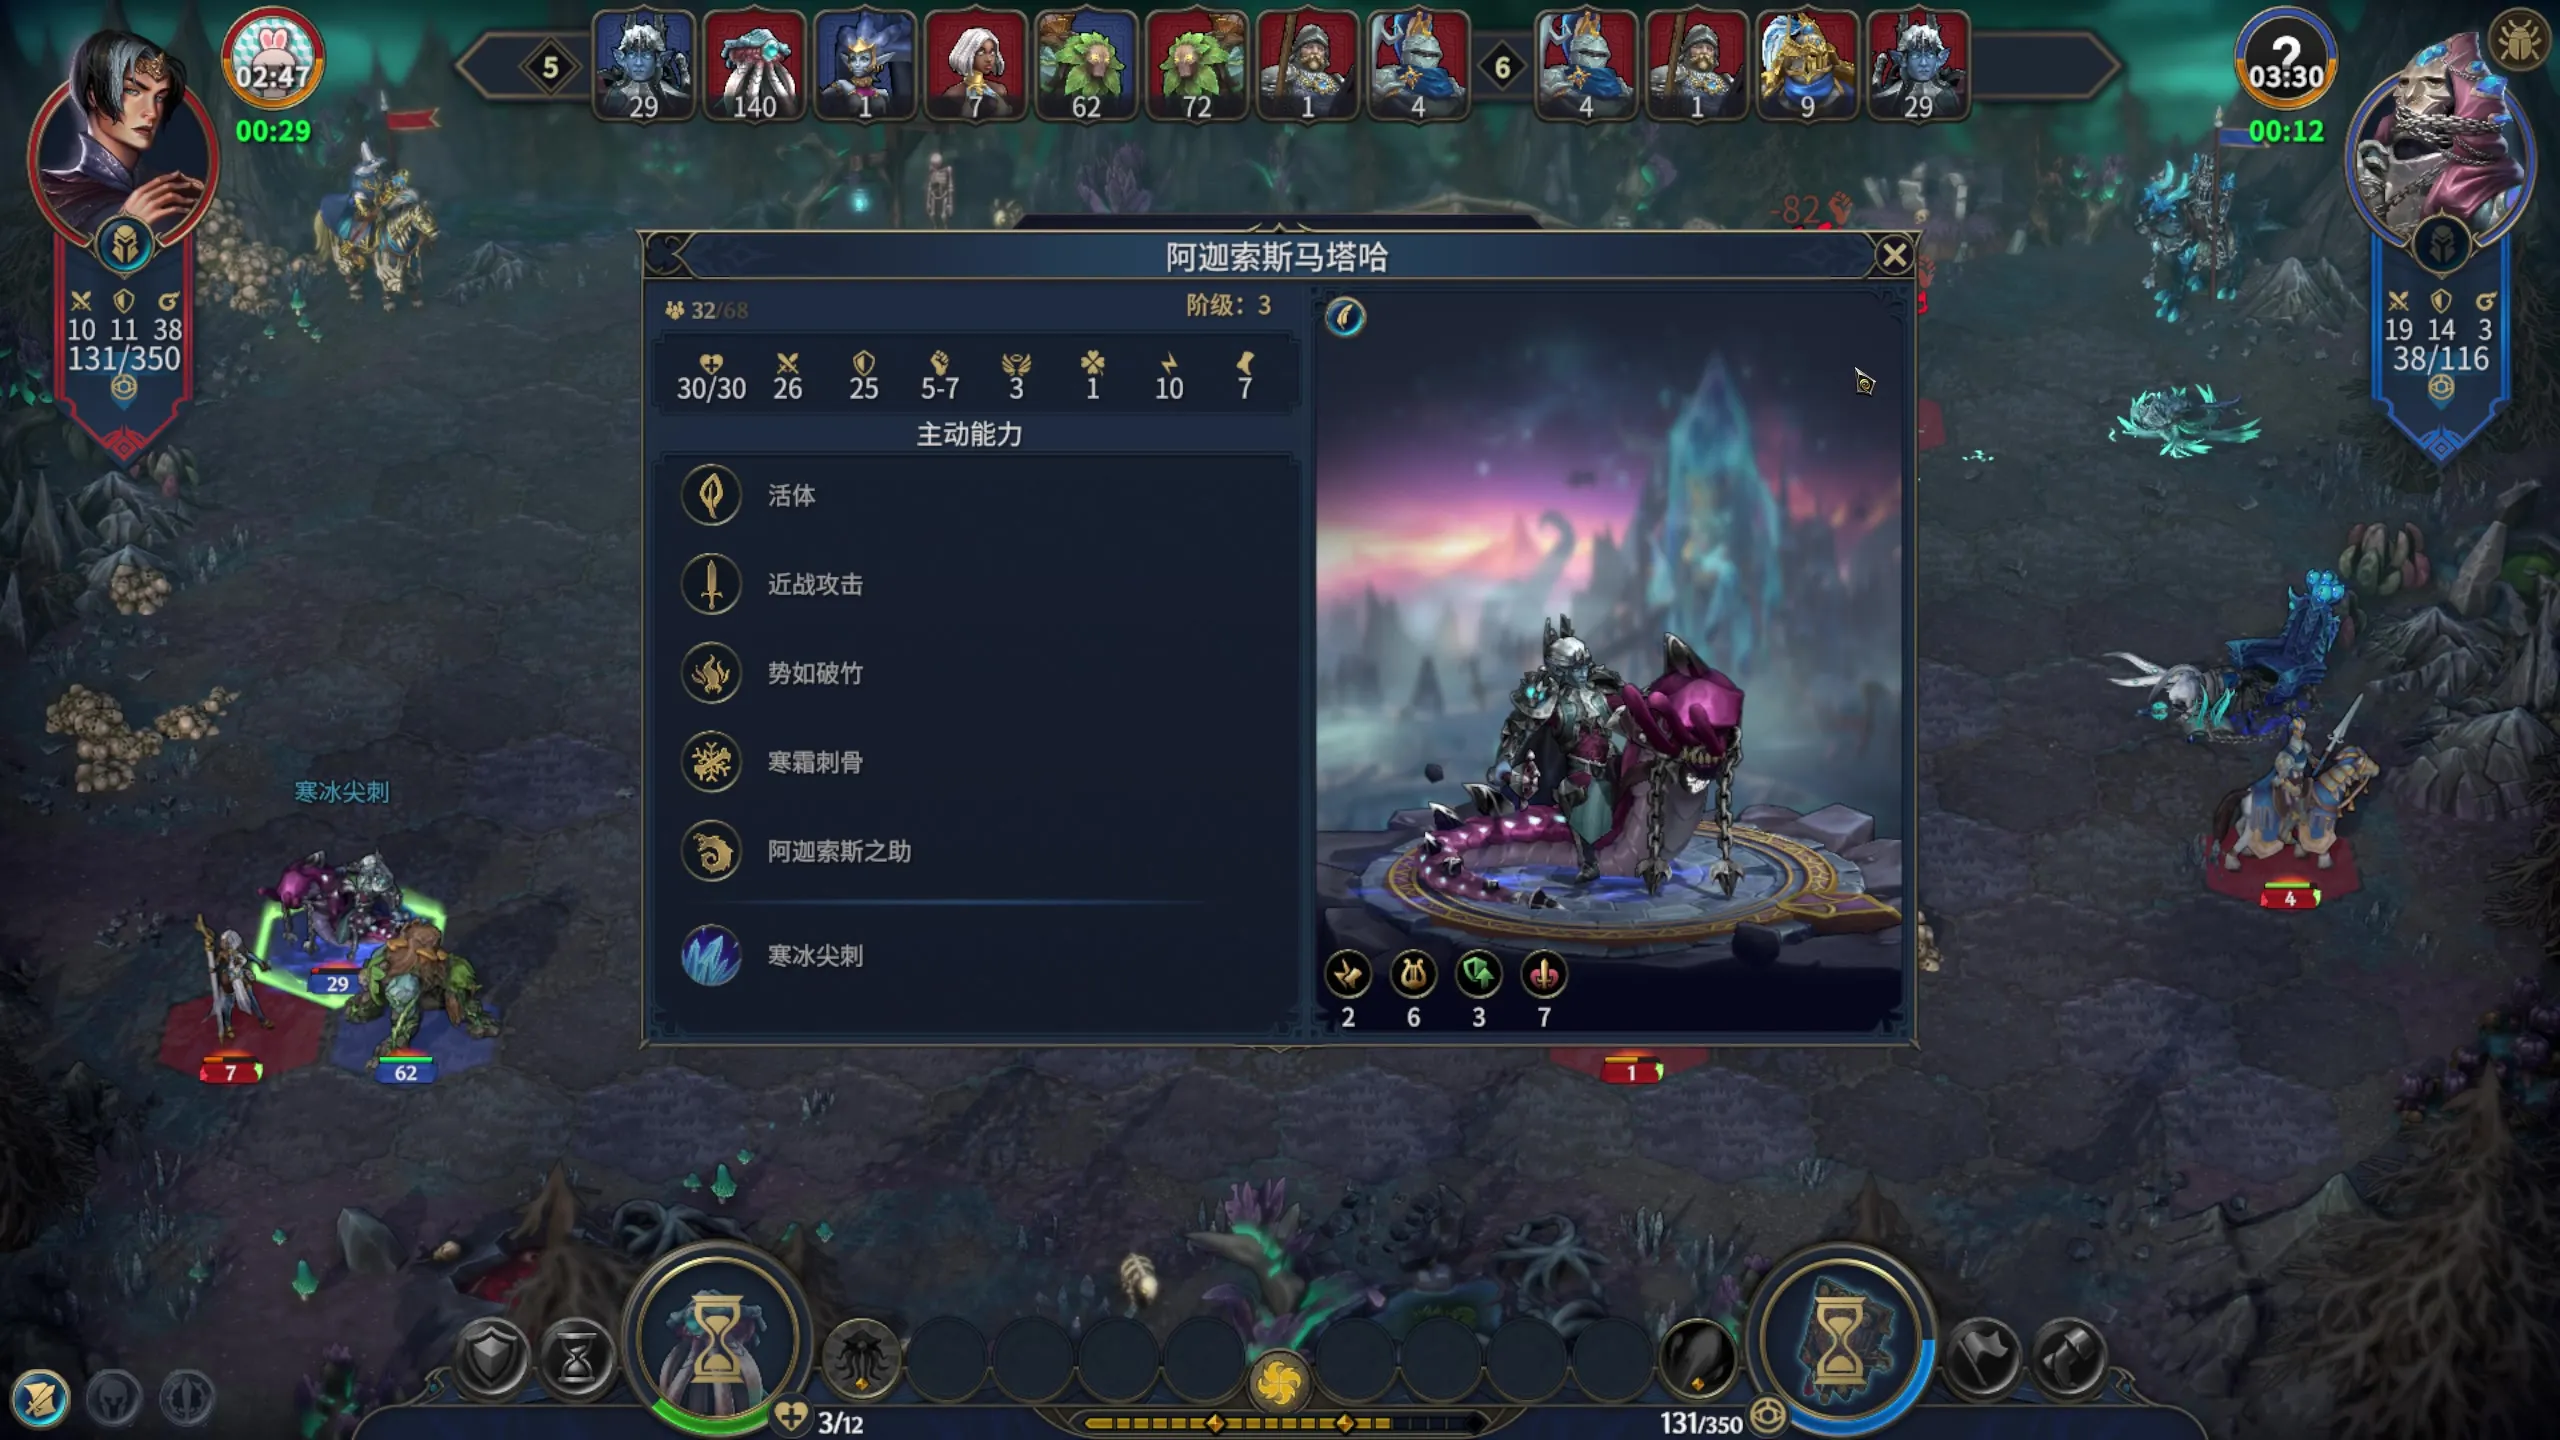
1648.1 秒原图:新规则恢复了左上角的 32/68;同一张图的防御 25 仍为空。数字本身都清楚,但后者还遇到了文字框跨格的问题。点击可查看原尺寸。
这里的“允许”有几个条件:它必须是数字字段;每遍完整读法都能解析且相同;至少有一遍完整读法,其用到的每条 OCR 文字行都有不低于 0.90 的引擎分数。这个分数不是逐字符分数,也不是校准后的正确概率。低分、内容冲突、一个数跨了几行,或者文字框越出字段边界,都继续拒识。只有半个数字具备高分,也不够。
对照复用同一录像的 53 张图,不重新解码视频或运行 OCR,也不改场景和自动定位。34 张图通过原有场景门控,产生 108 个面板记录、234 个字段机会。这里数的是面板模块的字段,不包含整条时间线的所有检测结果。
| 同一批 234 个字段 | 旧规则 | 新规则 |
|---|---|---|
| 接受为数字或文字候选 | 0 | 12 |
| 含无分数读法,仍留空 | 160 | 148 |
| 低分、冲突、位置未定或无法解析 | 74 | 74 |
这 12 个新增数字分布在 11 张图里:6 个底栏生命分数、5 个生物面板数量分数、1 个伤害范围。逐张打开原生图片核对后,12 个都与可见数字一致。另补了 5 个仍被拒识的可读字段,方便下一轮检查。这些图只有一个录像来源,新增值也只有 6 种,而且人工核对发生在看过预测之后;12/12 不能当作新视频的准确率。所有新增参考都等待用户复核。
再回放历史 9 张图、72 个字段,新旧输出完全相同:数字仍是 45/47 精确、2 个拒识,4 个负例区域仍不输出值。这说明新规则没有改变这批旧读数,不说明所有场景都已兼容。
为什么清楚的 25 还是没读进来?
文字框可能真的包含相邻几个数字,也可能只是比字宽了一圈。图中的 25 属于后者:三个越界读法也都写着 25,其中一个框还包进了旁边的图标,分数约为 0.896。它并不是数字内容冲突,而是框太松触发了保守拒识。这批图中有 77 个无分数数字字段触发边界检查;不能因此说这 77 处都读错了,或都混进了相邻属性。
这个问题后来促成了自动属性格重读实验:先由程序定位面板和单个属性格,再只对这一格重新 OCR,比较原尺寸与有选择的放大。人工框只用于最后评分,不作为算法输入。局部放大值得试,但重复放大整张图并不能解决数字属于哪一格的问题;模型和裁图的前一轮比较见小字 OCR 实验。
本轮的新旧候选、17 个像素参考、自动框和各遍读法,都在本机字段对照页中。页面可以左右切换、放大局部、展开原图,并筛选“人工可读、仍被拒识”。原语义时间线和旧结果未被覆盖,新规则目前只作为实验保留。
这次对照把问题分清了:有些数字缺的是合并规则,有些缺的是可靠的字段位置。单格重读提供了一条解决办法,但还需要更多不同画面来检查它。
6. 用文字检索,找到更多悬浮说明和属性
只盯着几张相似面板,很容易把一个问题修好,却不知道其他技能长什么样。因此这次先用已保存的 OCR 搜索“持续时间”“防御”“攻击”等词,再打开命中的原图逐项转写。这样省下的是找图时间,标注仍然要看原图。
这次从四段已曝光开发录像的 403 张已扫描图中,选出 13 张原图,补了 14 个面板、158 个文字或数字字段,以及 13 个无文字局部。内容包括奈拉之吻、暮光、绝望、石牙、连锁闪电、召唤说明、注能盔甲、寒冰尖刺和生物属性。没有新训练模型;这批参考已进入统一时间线,可切换到旧 OCR 层对照,仍等待用户确认。
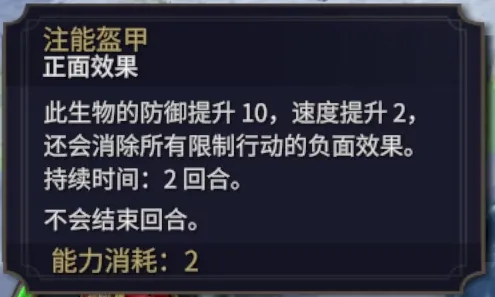
图 2:9 月 7 日录像的 693.2 秒,底栏技能悬浮显示“持续时间:2 回合”。这说明提示框写了什么,不证明某个单位已经获得效果,更不表示当前还剩两回合。
同一种说明也可能在不同时间显示不同数值。“绝望”的两张图分别写着 525 伤害、持续 10 回合,以及 555 伤害、持续 11 回合。两份原文都保留,但它们仍是同一录像中的同一种法术,不能当作两个独立类别。圣骑兵面板也与旧参考相近,本轮用它检查没有额外悬浮窗的显示状态。
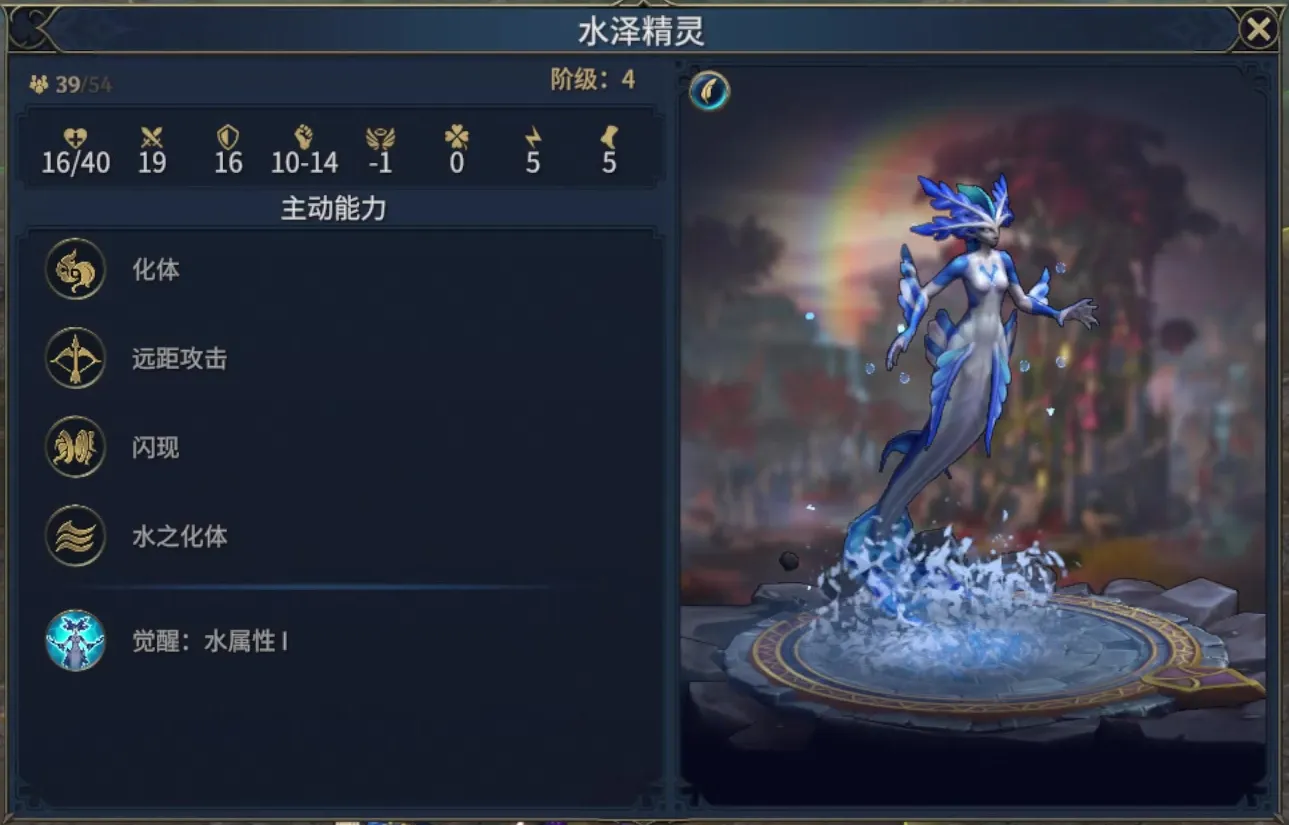
图 3:9 月 5 日录像的 1085.7 秒,属性行里 -1 和 0 是两个不同的可见值。参考保留符号和显示槽位,不把零当作“没识别到”。同帧右侧的攻击预览尚未包含在本次稀疏参考中,因此不能称整帧已标完。
随后用这些给定区域检查冻结的旧 OCR:去掉空白、统一全角半角后,151/158 个字段完全一致,13 个无文字局部都没有报字。这些局部主要是面板空白、书页纹理,也包含鼠标和雪地背景,不足以代表所有复杂背景。
剩下七处差异并非同一种错误:圣骑兵的 102/119 与旁边的 65 被合成一行,影响两个字段;另一个 3 旁多了一条 X3;“地属性 I”末尾被读成竖线。还有两处是比较程序把同一行的 (Shift) 排到了中文后面,以及一处连接号字形差异。原读法全部保留在逐项对照页,不把后面这三处称作数字读错。
这组结果说明文字检索能有效帮助补标,也留下了可复查的合并和误读案例。它不测自动找框或整帧召回,而且选样本就依赖 OCR 命中,所以不能拿 151/158 作为新视频准确率。下一步要把自动定位、单格读取和字段解析放到这批更丰富的画面上对照,再通过视觉检查补入 OCR 搜不到的短悬浮与遮挡案例;不继续只围绕几个重复数字调参。
本章从给定区域的读取走到了自动流程中的合并问题。面板定位见 p43,具体部队归属见 p104。接下来继续读日志原文和伤害预览,分别检查已经发生与尚未执行的内容。
相关设计记录
展开界面导航、日志与地图的历史设计
这些记录保留当时的实现与测量,不是阅读字段提取所需的前置知识。后续专项文章使用各自的数据与评估条件。
界面导航与战斗动作分开记录
魔法书打开和关闭是界面变化;法术是否成功施放是战斗事件。一个导航关系至少应记录出发视图、输入方式、控件或目标位置、预期视图以及观察证据。位置不知道时留空,可以继续准备其他字段,而不用编一个点击坐标。
flowchart LR
 B[Battlefield] -->|Open| S[Spellbook]
 S -->|Close| B
 S -->|Page left or right| S
 S -->|Hover| T[Spell tooltip]
 S -->|Select and hover target| P[Target preview]
 B -->|Open own panel| H[Own hero information]
 H -->|Close| B
 B -->|Right click reported| C[Creature information]
 C -->|Close| B
 B -->|Open log| L[Battle log]
 L -->|Close| B
图 4:待逐条核对操作证据的战斗导航关系。右键打开生物详情来自用户陈述;箭头描述导航候选,没有声称发生了攻击或施法。
已实现的视图模块消费上游场景、浮层、可见性和对象证据,把战场、魔法书、英雄/生物资料、日志、专用法术提示和目标预览分开记录。它本身不从图片自动识别这些界面,也不补齐缺失的归属和页码。孤立的“英雄详情”标签不会自动被解释成战斗:选择阶段同样可能出现英雄面板。
相邻视频采样点可以组成导航片段,但只有同一原视频、明确同一场战斗和同一视图/对象/页码才能合并。区间只到最后实际看到的采样点;中间太久没有观察、跨战斗、翻页或看不清时会断开。这样的时间轴方便定位原图,不能证明区间内从未发生其他变化。
首轮 9 张图的战斗编号都尚未绑定,实际输出是 7 个单点组、0 次跨帧合并;另有翻页和通用技能提示两种未解析视图。因此这轮验证了单帧合同和保守切分,没有验证完整导航轨迹。
后续 15 帧审核留下了 8 个逐帧关闭 X 区域,覆盖英雄详情、魔法书、生物详情和日志,另有 1 个底左日志按钮候选。这里数的是可见区域记录,不是 8 种控件。414 秒的魔法书整体向下移动,关闭框也随之移动,不能沿用上一张图的坐标。可见框已审核,但实际点击命中范围和点击结果没有验证,仍不能据此声称支持执行。书页左右箭头与“自己英雄按钮”的位置继续留空。
日志、行动与地图怎样接起来
战斗日志是整理行动的重要线索。第一步读出每行文字和位置,第二步才结合滚动上下文、轮次、行动头像以及资源变化解释事件。同一句攻击描述可能在两轮各出现一次,不能仅因文字相同就去重。现有稀疏关键帧也不能保证每次行动都被录入;这一点需要连续片段和逐动作参考来验证。
共享日志解析器只做第一步之后的文字拆分:只接收日志面板中 OBSERVED 的 log_line 字段,最初限定 7 类明确句式——失去魔力、施展法术、受到伤害及显式死亡数量、被摧毁、等待、使用能力、攻击。句子必须完整匹配;时钟缺括号、数字断裂或多次读法冲突都会拒识,不补字,不从法术图标或伤害预览生成日志。
496.022 秒的已有开发结果中,两条已接受文字被解析为“纳迪亚失去了 30 魔力”和“纳迪亚施展了法术‘审判’”。另外 2 条上游冲突行未消费,1 条轮次标题也未进入动作句式解析。这是两条日志文本声明,既不改变前面保留空格的逐字评分,也不是整页动作提取率。
每条声明保留原文、OCR 行号和区域、原视频路径与观察秒数。例子中的 banmumo 是玩家显示名,“纳迪亚”是句中的行动者,二者分开保存;规范实体和敌我归属仍可为空。日志显示的 [19:49:08] 与视频观察时刻 496.022 秒也是两种时间,没有自动对齐。同帧或跨帧重复出现的文字全部保留,后续才可能凭滚动和时序证据判断是否为同一事件。
从四张日志图检查漏掉的句式
后续复用上面的开发图,以及 B027 首轮 26 帧评估中已经看过的 3 张日志图,逐行核对现有原图、OCR 和保存字段,得到 105 条日志及 1 个轮次标题。其中 44 条被上游接受为 OBSERVED,61 条为读法冲突。这是用已曝光图像扩展语法的开发集,原来的 9 图、72 字段和两条日志声明结果保持原样。
| 同一批字段的处理结果 | 原七类句式 | 扩展后九类句式 |
|---|---|---|
| 接受且结构化值与手工参考一致 | 26 | 31 |
| 已接受文字中,句式不支持而拒识 | 18 | 13 |
| 上游冲突,保持跳过 | 61 | 61 |
| 非日志轮次标题,跳过 | 1 | 1 |
新版只增加“恢复魔力”和“被召唤”两类严格句式。新增接受的 5 条全部是魔力恢复,例如“纳瓦尔之子克拉尔恢复了 18 魔力”。唯一“星之子 (58) 被召唤了”虽然在原图中可读,保存字段仍是冲突,因此继续跳过;它只支持文字语法测试,尚未获得端到端接受的召唤记录。复合句和否定句也继续拒识,不把前半句吞进对象名称。
这次历史回放剩下的 13 条 OBSERVED 都是当时尚未支持的“获得效果/持续时间”。两版已接受的结构化值均未发现不符,但 31 条一致只说明这批开发参考上的结果,不能当作独立精度或完整行动覆盖率。近邻图重复行全部保留;一处被光标遮挡的手工伤害参考仍为空,没有借下一帧的数字补齐。
后续已在 B030 效果与持续时间单独检查效果名称与日志记载时长。它采用自己的参考和输入口径,不回写本表,也不代表当前效果状态已经恢复;上游读法冲突仍需处理。
日志还需要与地图位置关联
网格模块已经能够把图像位置映射到六边形格子,可移动范围模块也已有黄色、绿色高亮识别实验。接下来需要把这些结果与当前部队、移动方式和动态占位关联起来。未高亮的格子不一定是障碍,高亮也不自动等于某个单位的全部合法移动范围。
地图信息应分层保存:固定地形、当前活体部队占位、可见尸体、法术产生的物体,以及规则支持的阻挡状态。普通尸体不一概挡路;特殊生物尸体或法术障碍需要前后图像、日志与独立机制证据。移动轨迹预测暂缓,先为后续时间领域、空间陷阱等规划需求保留这些输入。
Comments