P41 · 视觉场景补充 · 实验记录与相关篇目
9 月 15 日新增距离差对照:视觉战场候选704→1210,非战场误收不增,但过渡放行增加。仅接短悬浮离线对照,旧默认不变;独立新视频和在线路由未验收。
加载插画、进度条和战场边栏很容易被人识别,却未必包含能唯一标识场景的文字。我们希望利用整体画面辅助文字规则,先把“现在看到了什么”分清,再决定去哪里找生物、数值或说明。
做法是把当前截图与已检查的画面比较,再用 OCR(文字识别)检查两者是否矛盾。这样已经能帮助整理场景数据;下面先看它怎样判断一张图,再检查为什么整体页面认对了,小提示仍会漏掉。
flowchart LR
 A[Original frame] --> B[Color, edge and SVM]
 A --> C[Full-frame OCR]
 B --> D[Compare labels and evidence]
 C --> D
 D --> E[Visual review or candidate]
 E --> F[Scene, subscene and condition]
图 1:三种视觉方法与文字证据互相检查;一致只能形成算法候选,不能变成人亲眼看过的标注。
B020 最新视频接线只复用本文的颜色、边缘参考方法来补充战场候选;不是本文全部视觉方法和审核流程都已成为运行时系统。
1. 场景看得清,不代表每个提示框都看得清
输入是一张完整截图,输出分三层。例如“战场”是主场景,“魔法书”是内部页面,也就是子场景;过渡、遮挡或小提示另记在 Other 条件中。打开魔法书时,背景仍可能读到“战斗开始”;不能让这行文字否定前景已经打开的面板。
下面保留早期 OCR 没认出的七张原图,但按标注网站的最新分类整理。例如,写着“正面效果”、提供法术强度与知识奖励的页面属于属性选择,不是选择生物;打开日志的战场也要保留“战斗日志”子场景。每张图都注明审核来源,旧预测和旧草稿放在折叠记录中,不再充当图片标题。
按标注网站的分类分组,更新于 2026-09-12。每张图分别注明用户确认、助手检查或算法候选;旧草稿不再用于分组。青框仍是历史 OCR 规则当时使用的文字;没有框不代表这张图现在仍未分类。点击图片放大。
加载界面 · LOADING 2 张示例
历史规则匹配文字:无匹配;当时返回 UNKNOWN。
查看历史预测与旧标签
历史 OCR 预测:未识别。当时参考标签:加载界面(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 0 个 OCR 文本区域
未检测出文字
历史规则匹配文字:无匹配;当时返回 UNKNOWN。
查看历史预测与旧标签
历史 OCR 预测:未识别。当时参考标签:加载界面(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 0 个 OCR 文本区域
未检测出文字
选择英雄 · HERO_SELECTION 1 张示例
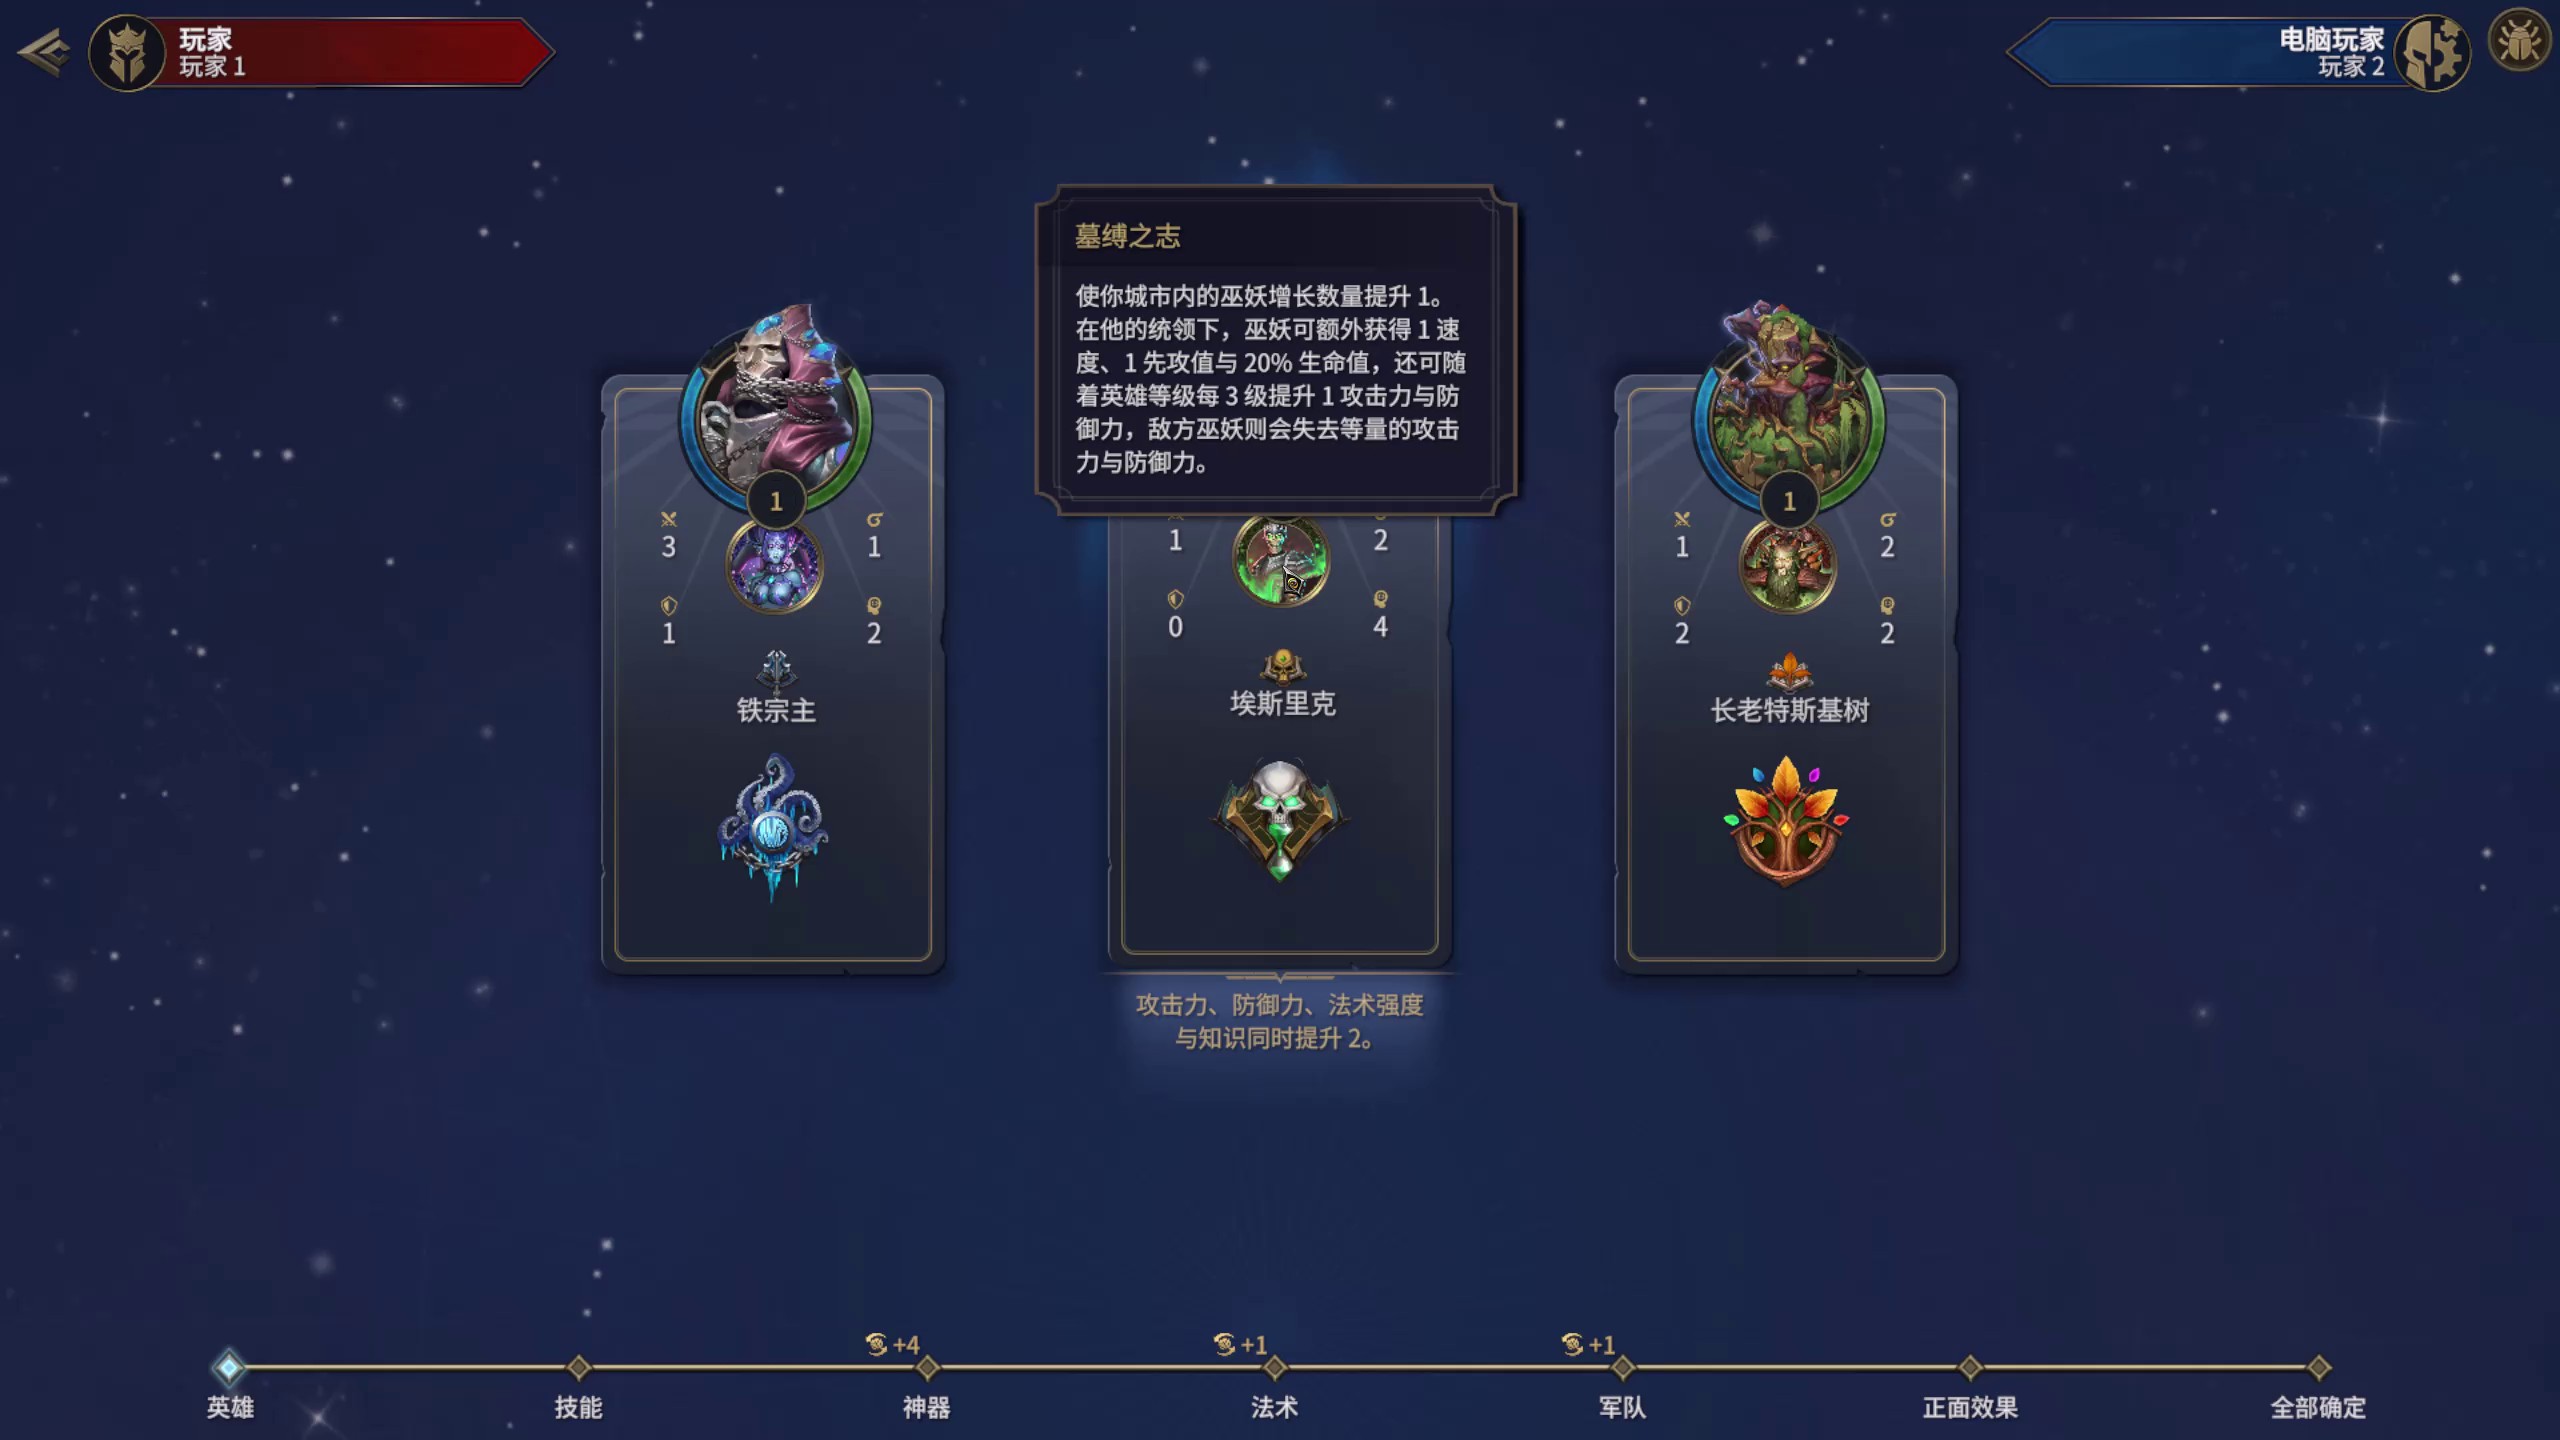
历史规则匹配文字:无匹配;当时返回 UNKNOWN。
查看历史预测与旧标签
历史 OCR 预测:未识别。当时参考标签:选择英雄(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 41 个 OCR 文本区域
玩家 | 电脑玩家 | 玩家2 | 玩家1 | 墓缚之志 | 使你城市内的巫妖增长数量提升1。 | 在他的统领下,巫妖可额外获得1速 | 度、1先攻值与20%生命值,还可随 | 着英雄等级每3级提升1攻击力与防 | 御力,敌方巫妖则会失去等量的攻击 | 力与防御力。 | 1 | 1 | X3 | 3 | b2 | x1 | b1 | 2 | 1 | 2 | 2 | 4 | 0 | 1 | 2 | 埃斯里克 | 铁宗主 | 长老特斯基树 | 攻击力、防御力、法术强度 | 与知识同时提升2。 | +1 | +1 | +4 | 英雄 | 技能 | 法术 | 军队 | 神器 | 正面效果 | 全部确定
正面效果(属性选择) · ATTRIBUTE_SELECTION 2 张示例
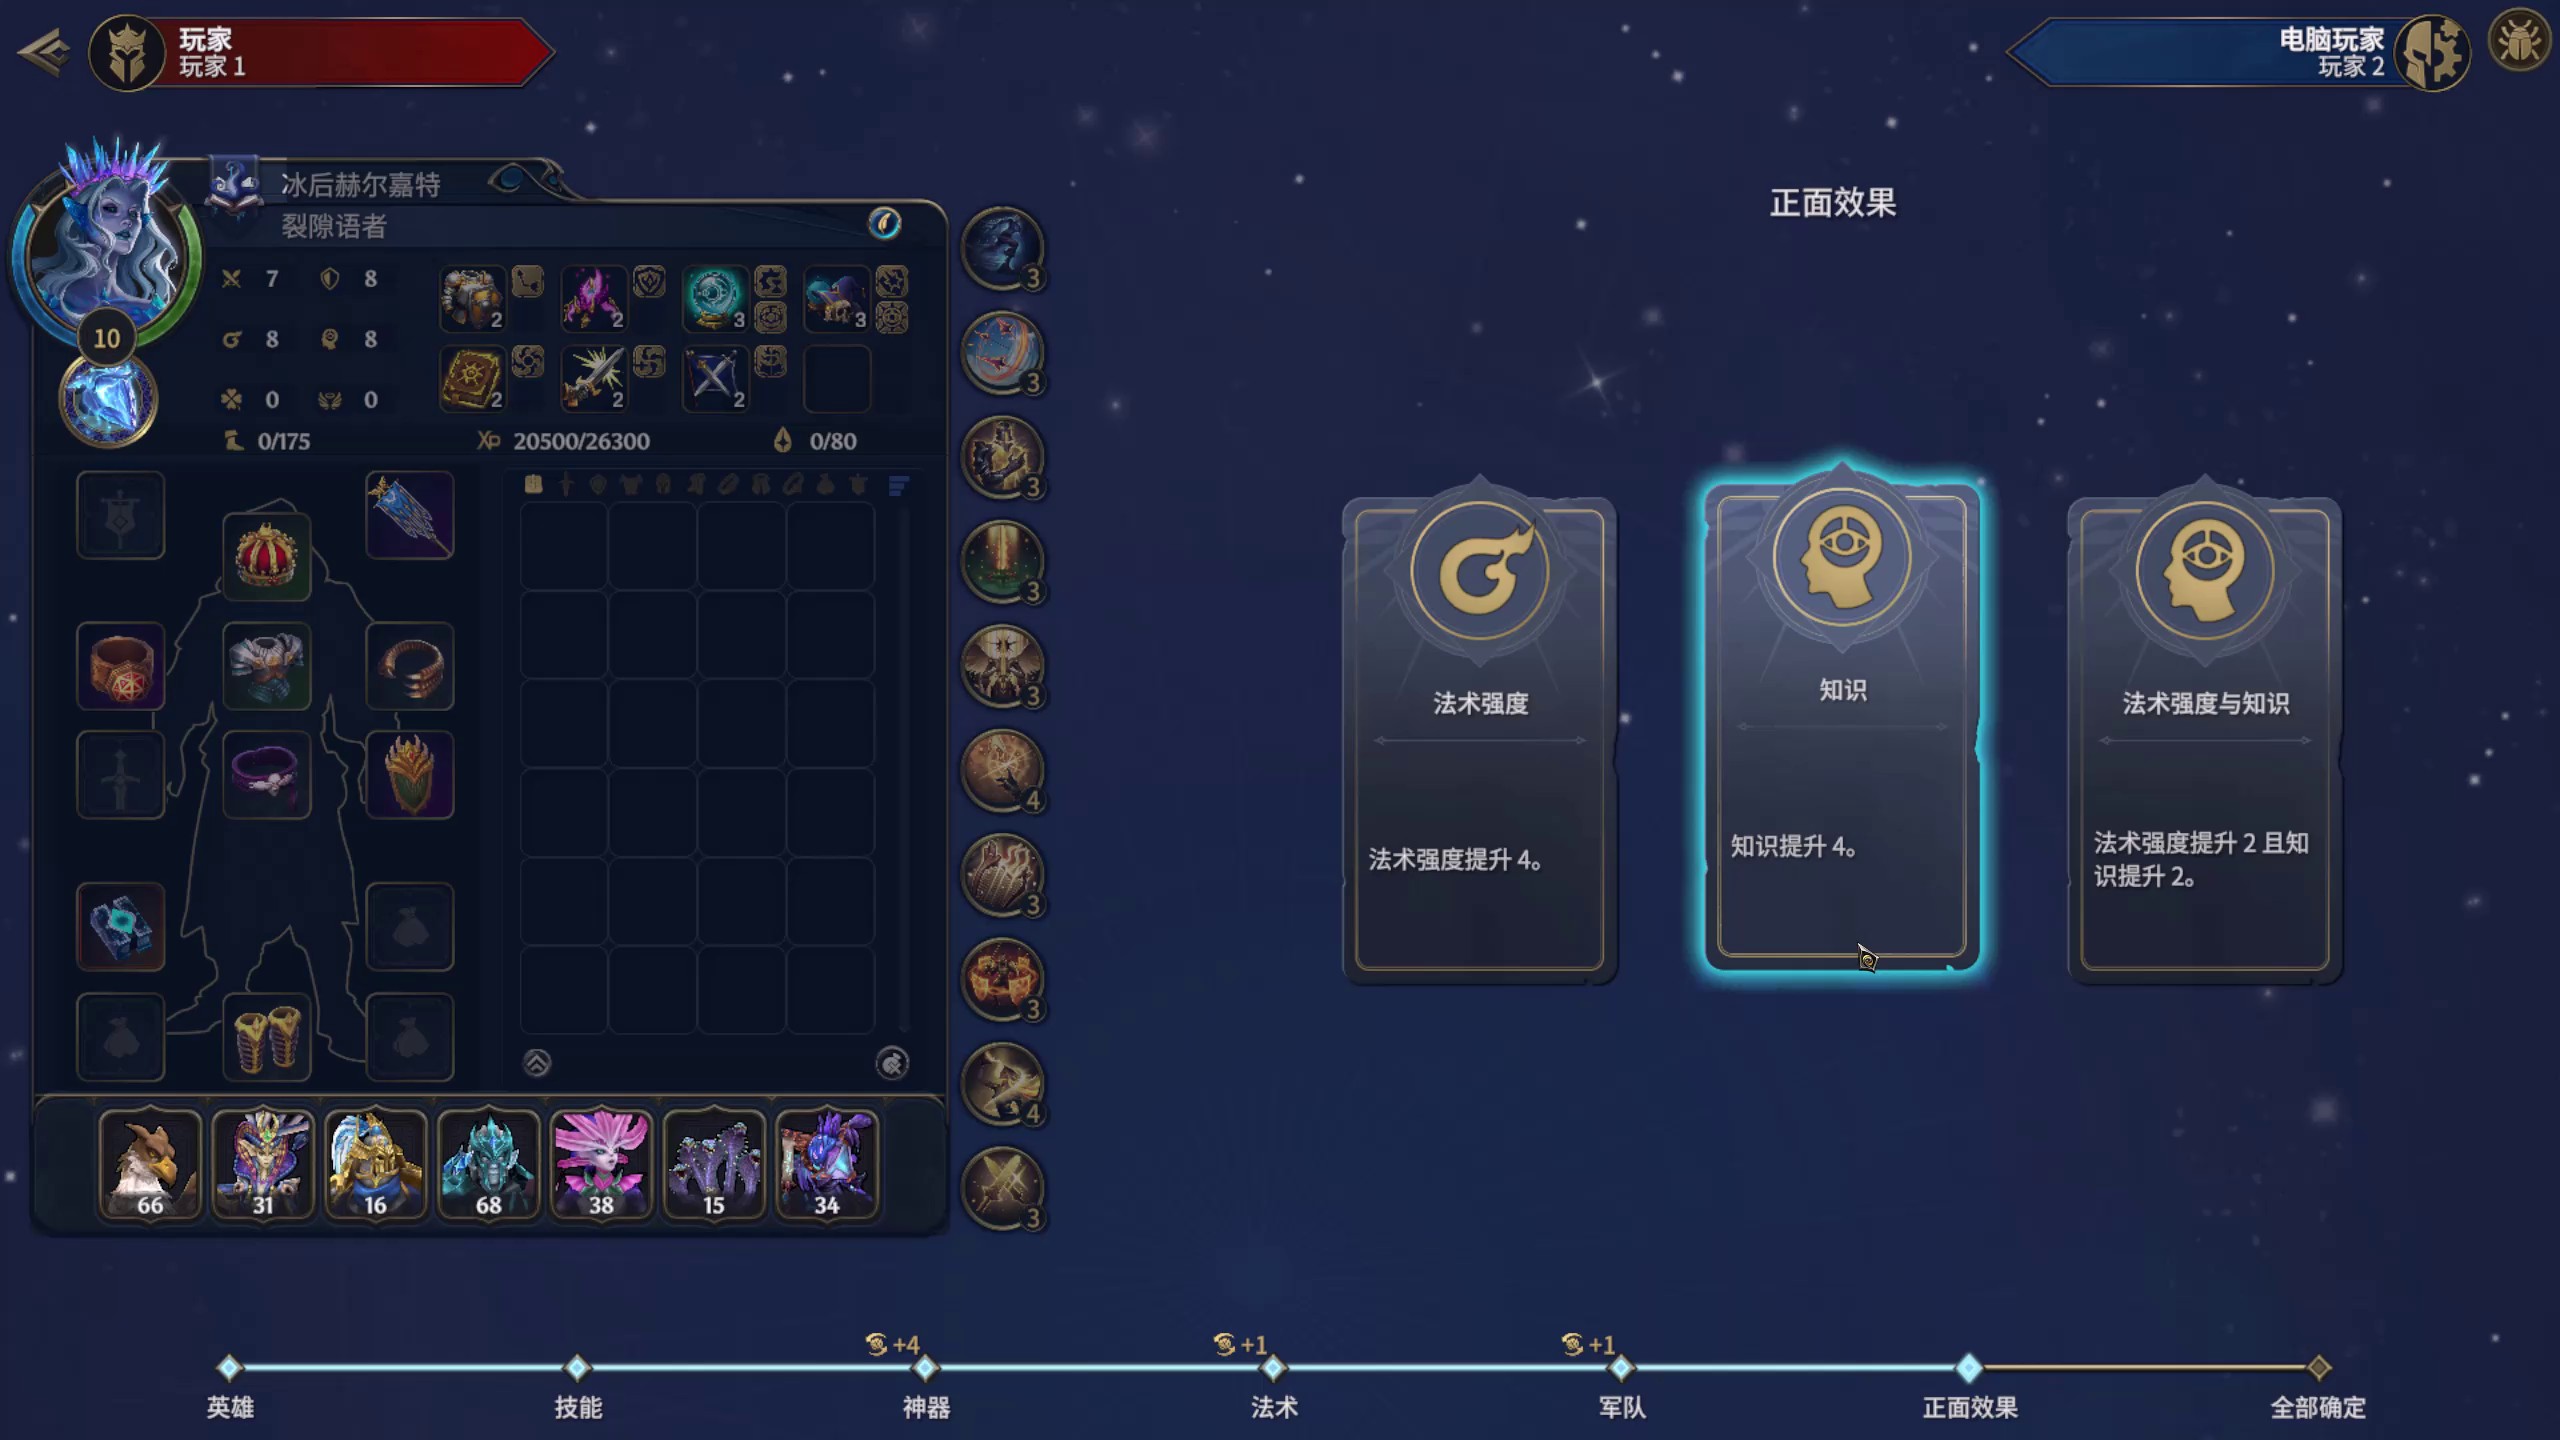
历史规则匹配文字:无匹配;当时返回 UNKNOWN。
查看历史预测与旧标签
历史 OCR 预测:未识别。当时参考标签:选择生物(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 54 个 OCR 文本区域
玩家 | 电脑玩家 | 玩家1 | 玩家2 | 冰后赫尔嘉特 | 正面效果 | 裂隙语者 | 3 | . 8 | 7 | 8 | 3 | 3 | 10 | 8 | 8 | 3 | 2 | 0 | 2 | X 20500/26300 | 0/175 | 0/80 | 3 | 3 | 知识 | 3 | 法术强度 | 法术强度与知识 | 法术强度提升2且知 | 知识提升4。 | 法术强度提升4。 | 识提升2。 | 3 | 射 0 | 0 | 16 | 66 | 68 | 38 | 15 | 34 | 31 | 3 | +1 | +1 | +4 | 技能 | 英雄 | 神器 | 法术 | 军队 | 全部确定 | 正面效果
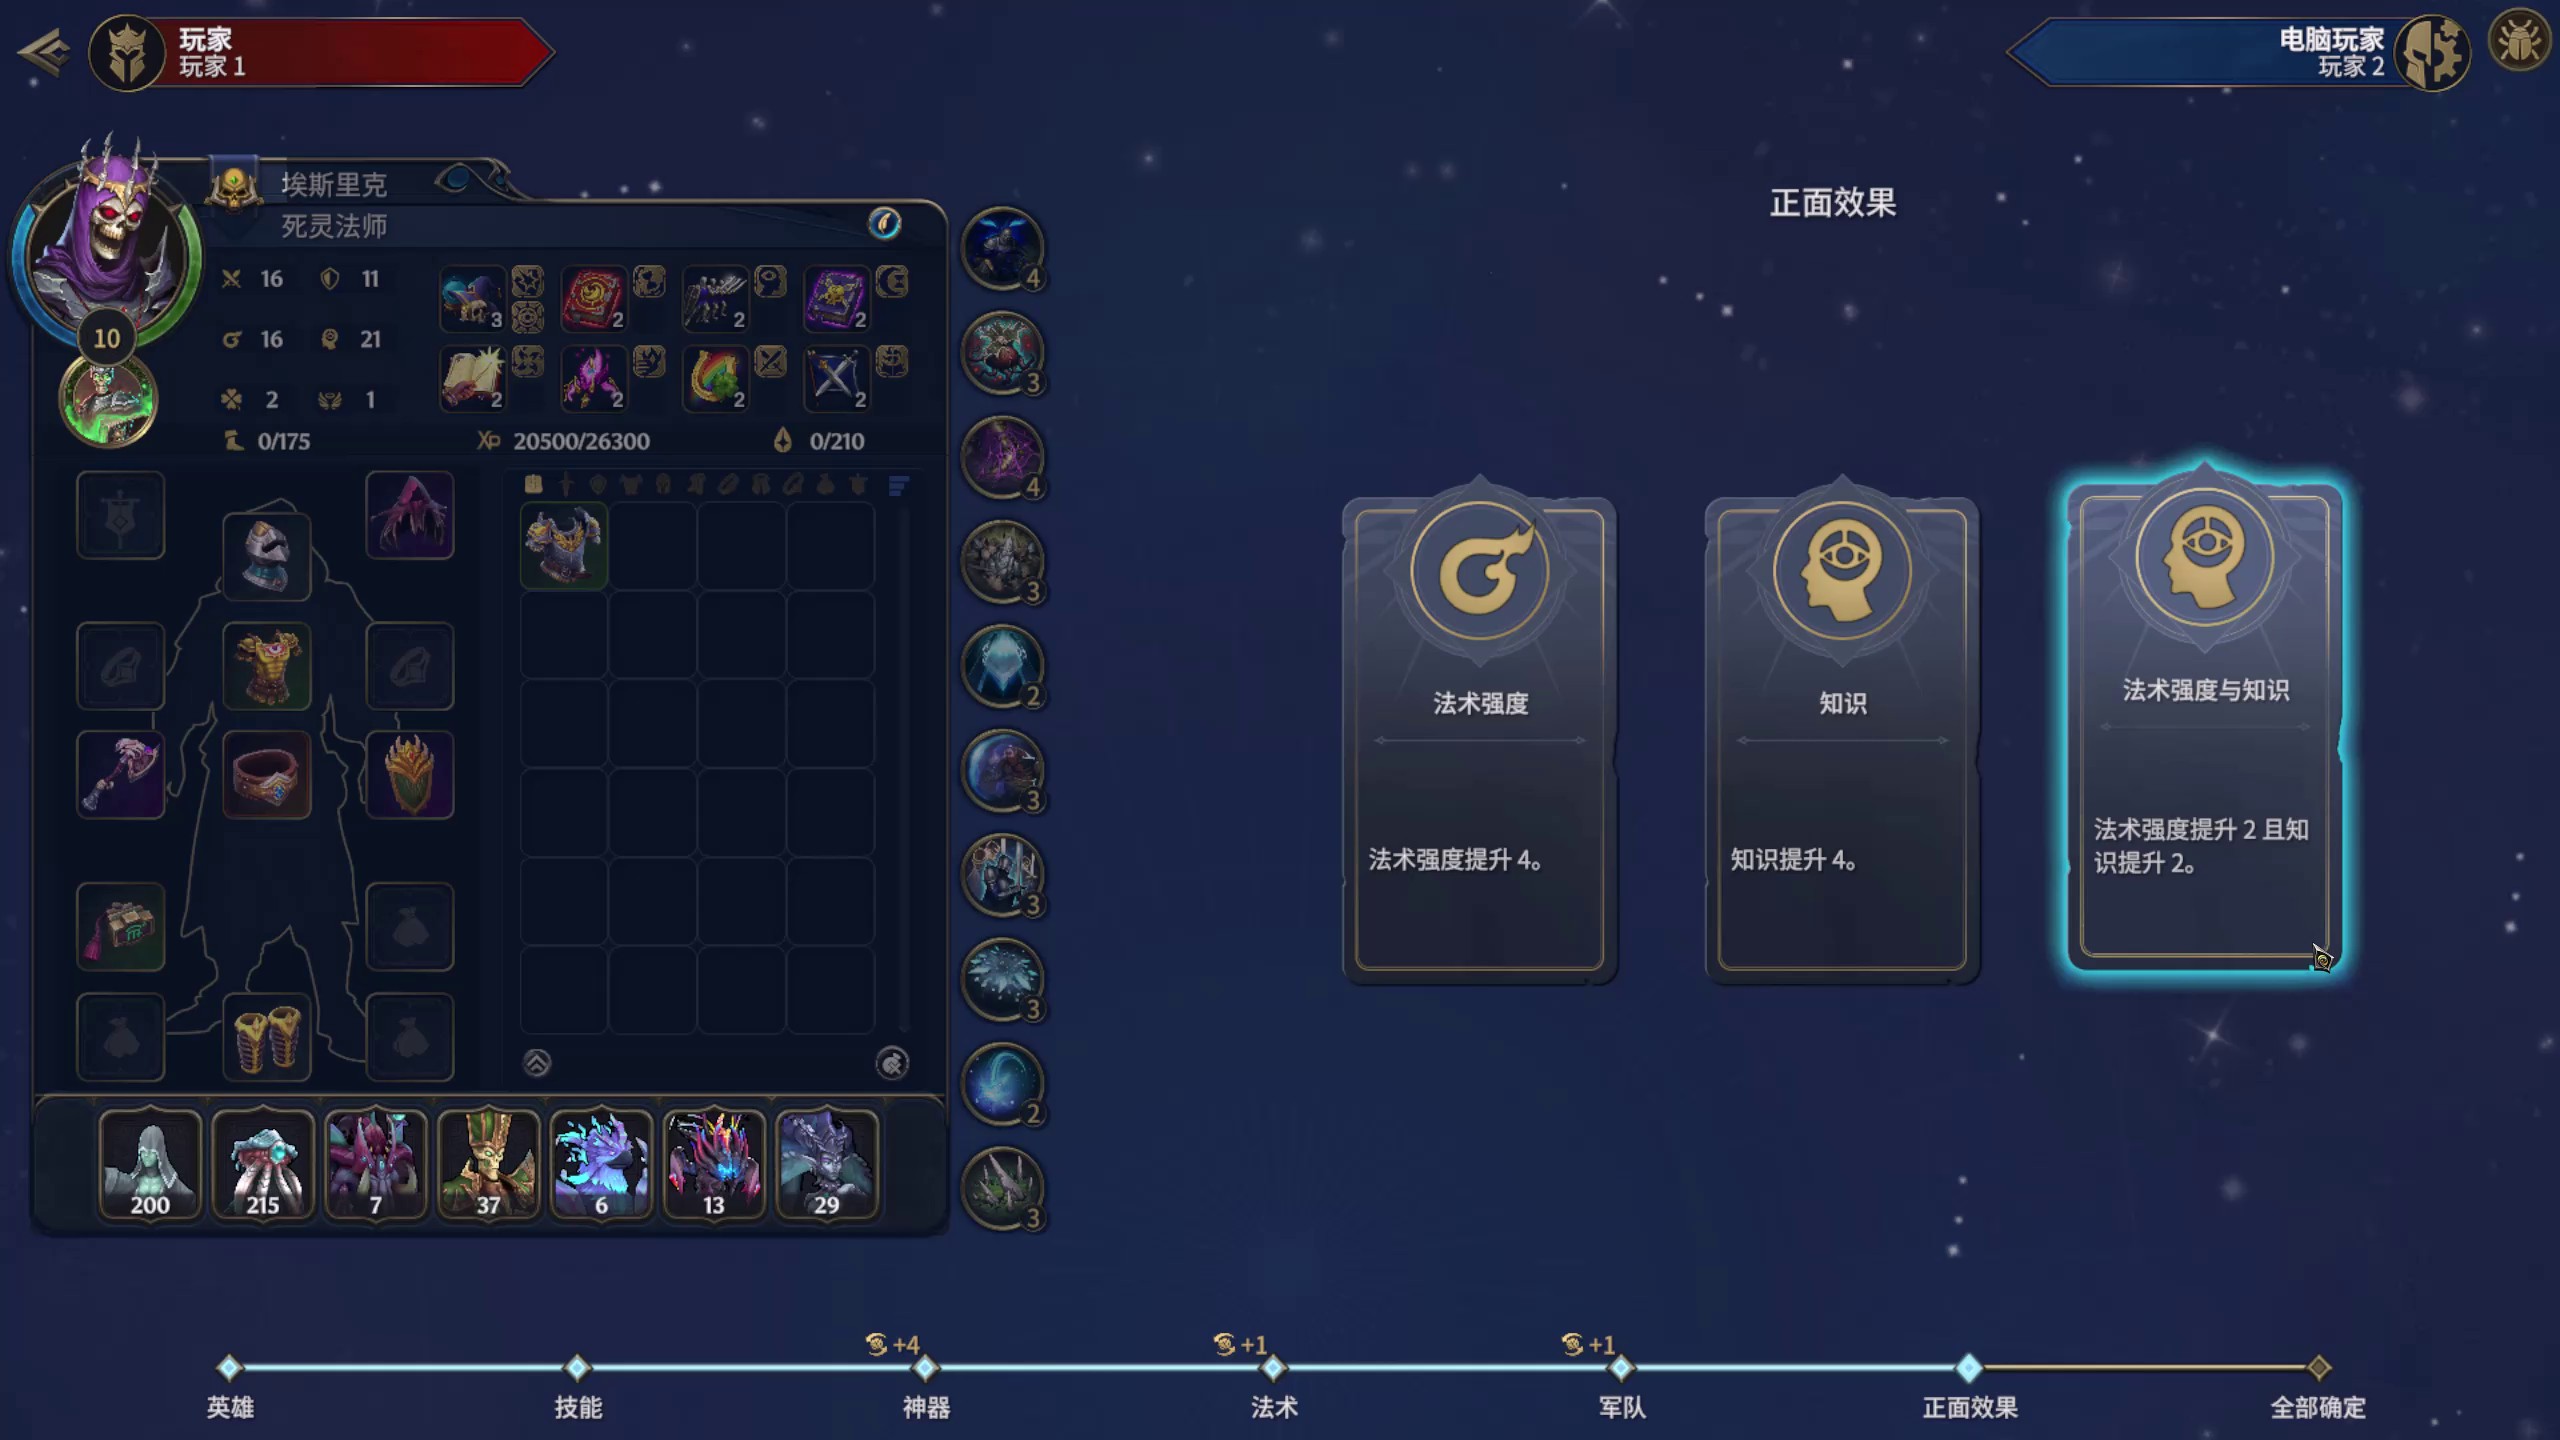
历史规则匹配文字:无匹配;当时返回 UNKNOWN。
查看历史预测与旧标签
历史 OCR 预测:未识别。当时参考标签:选择生物(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 53 个 OCR 文本区域
电脑玩家 | 玩家 | 玩家1 | 玩家2 | 埃斯里克 | 正面效果 | 死灵法师 | 16 | 0 冫 0 | 0 | 11 | 16 . 11 | 3 | 2 | 10 | 21 | 16 | G | 3 | 2 | 2 | Xp 20500/26300 | X 20500/26300 | 0/175 | 0/210 | 1 | 3 | 法术强度与知识 | 知识 | 法术强度 | 3 | 法术强度提升2且知 | 知识提升4。 | 法术强度提升4。 | 识提升2。 | 帘 | 3 | 200 | 215 | 13 | 37 | 29 | 3 | +1 | +1 | +4 | 技能 | 英雄 | 神器 | 法术 | 军队 | 全部确定 | 正面效果
战斗进行中 · BATTLE_ACTIVE 1 张示例
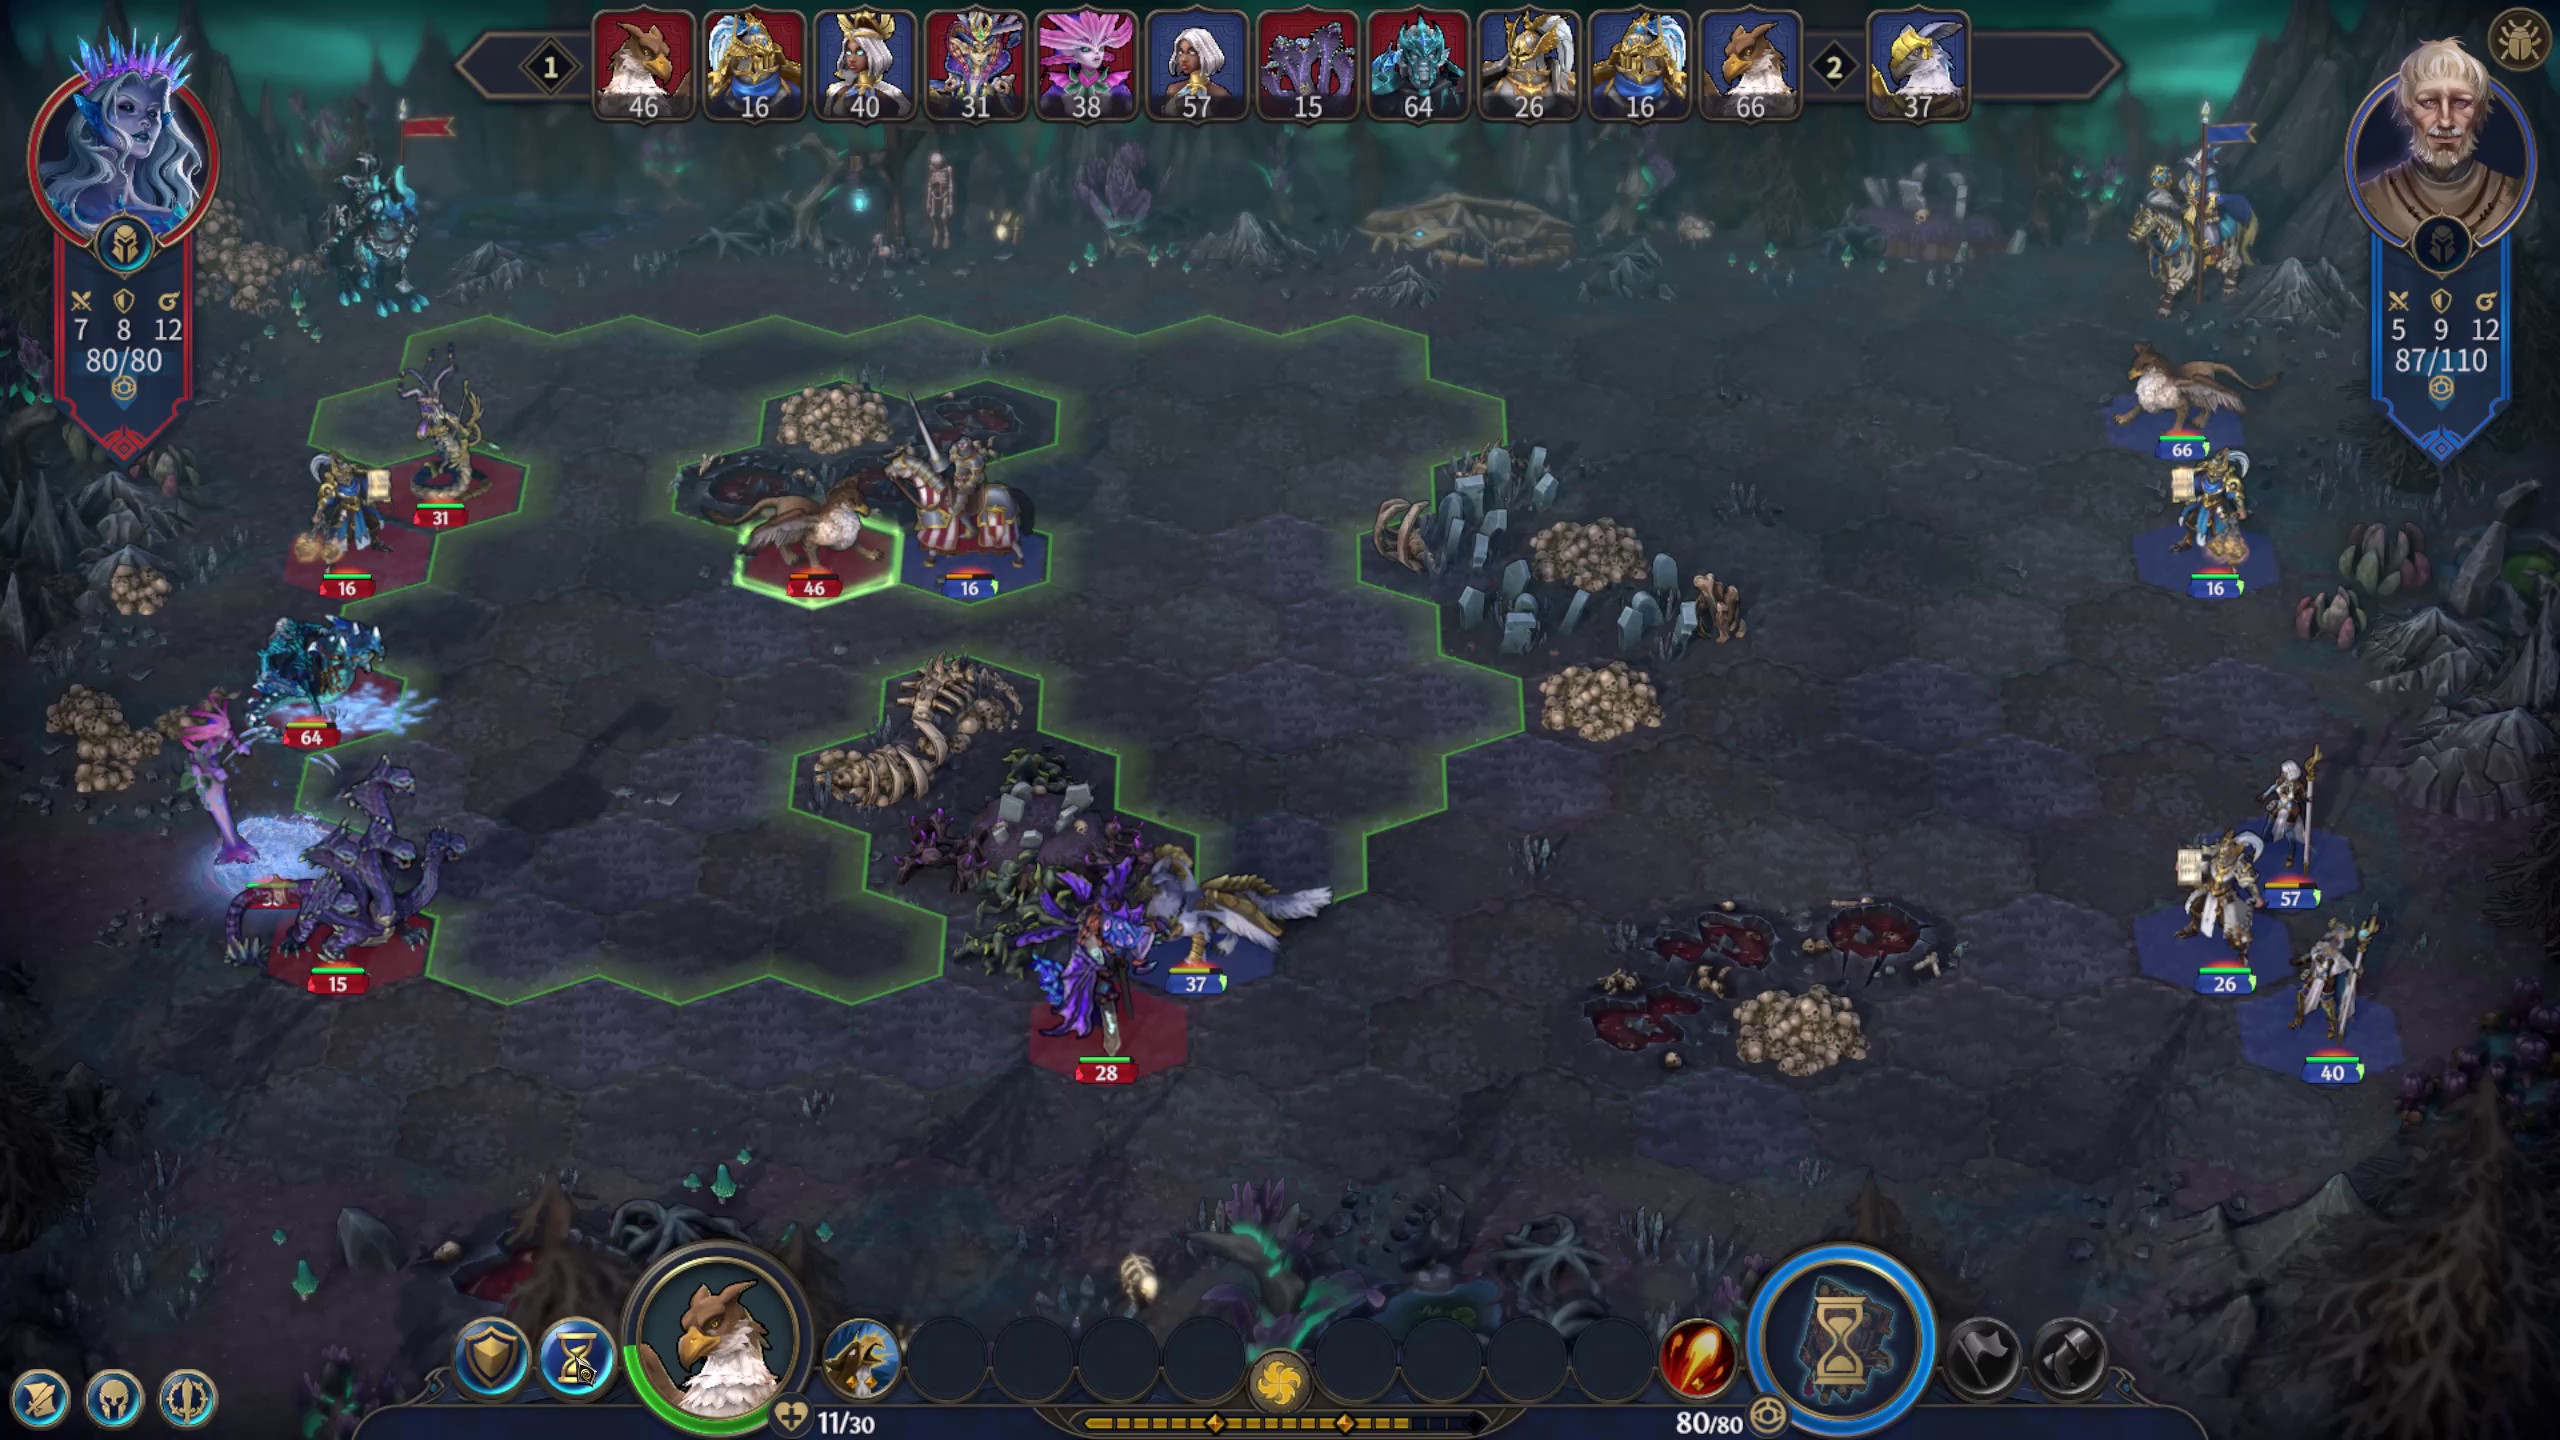
历史规则匹配文字:无匹配;当时返回 UNKNOWN。
查看历史预测与旧标签
历史 OCR 预测:未识别。当时参考标签:战斗进行中(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 38 个 OCR 文本区域
2 | 1 | 16 | 57 | 64 | 15 | 37 | 46 | 40 | 38 | 26 | 16 | 66 | 31 | XI a | XI a | ① a | X | 5 9 12 | 7 8 12 | 80/80 | 87/110 | 66 | 31 | 46 | 16 | 16 | 16 | 64 | 38 | 57 | 37 | 26 | 15 | 28 | 40 | 11/30 | 80/80
战斗日志浮层 · BATTLE_LOG 1 张示例
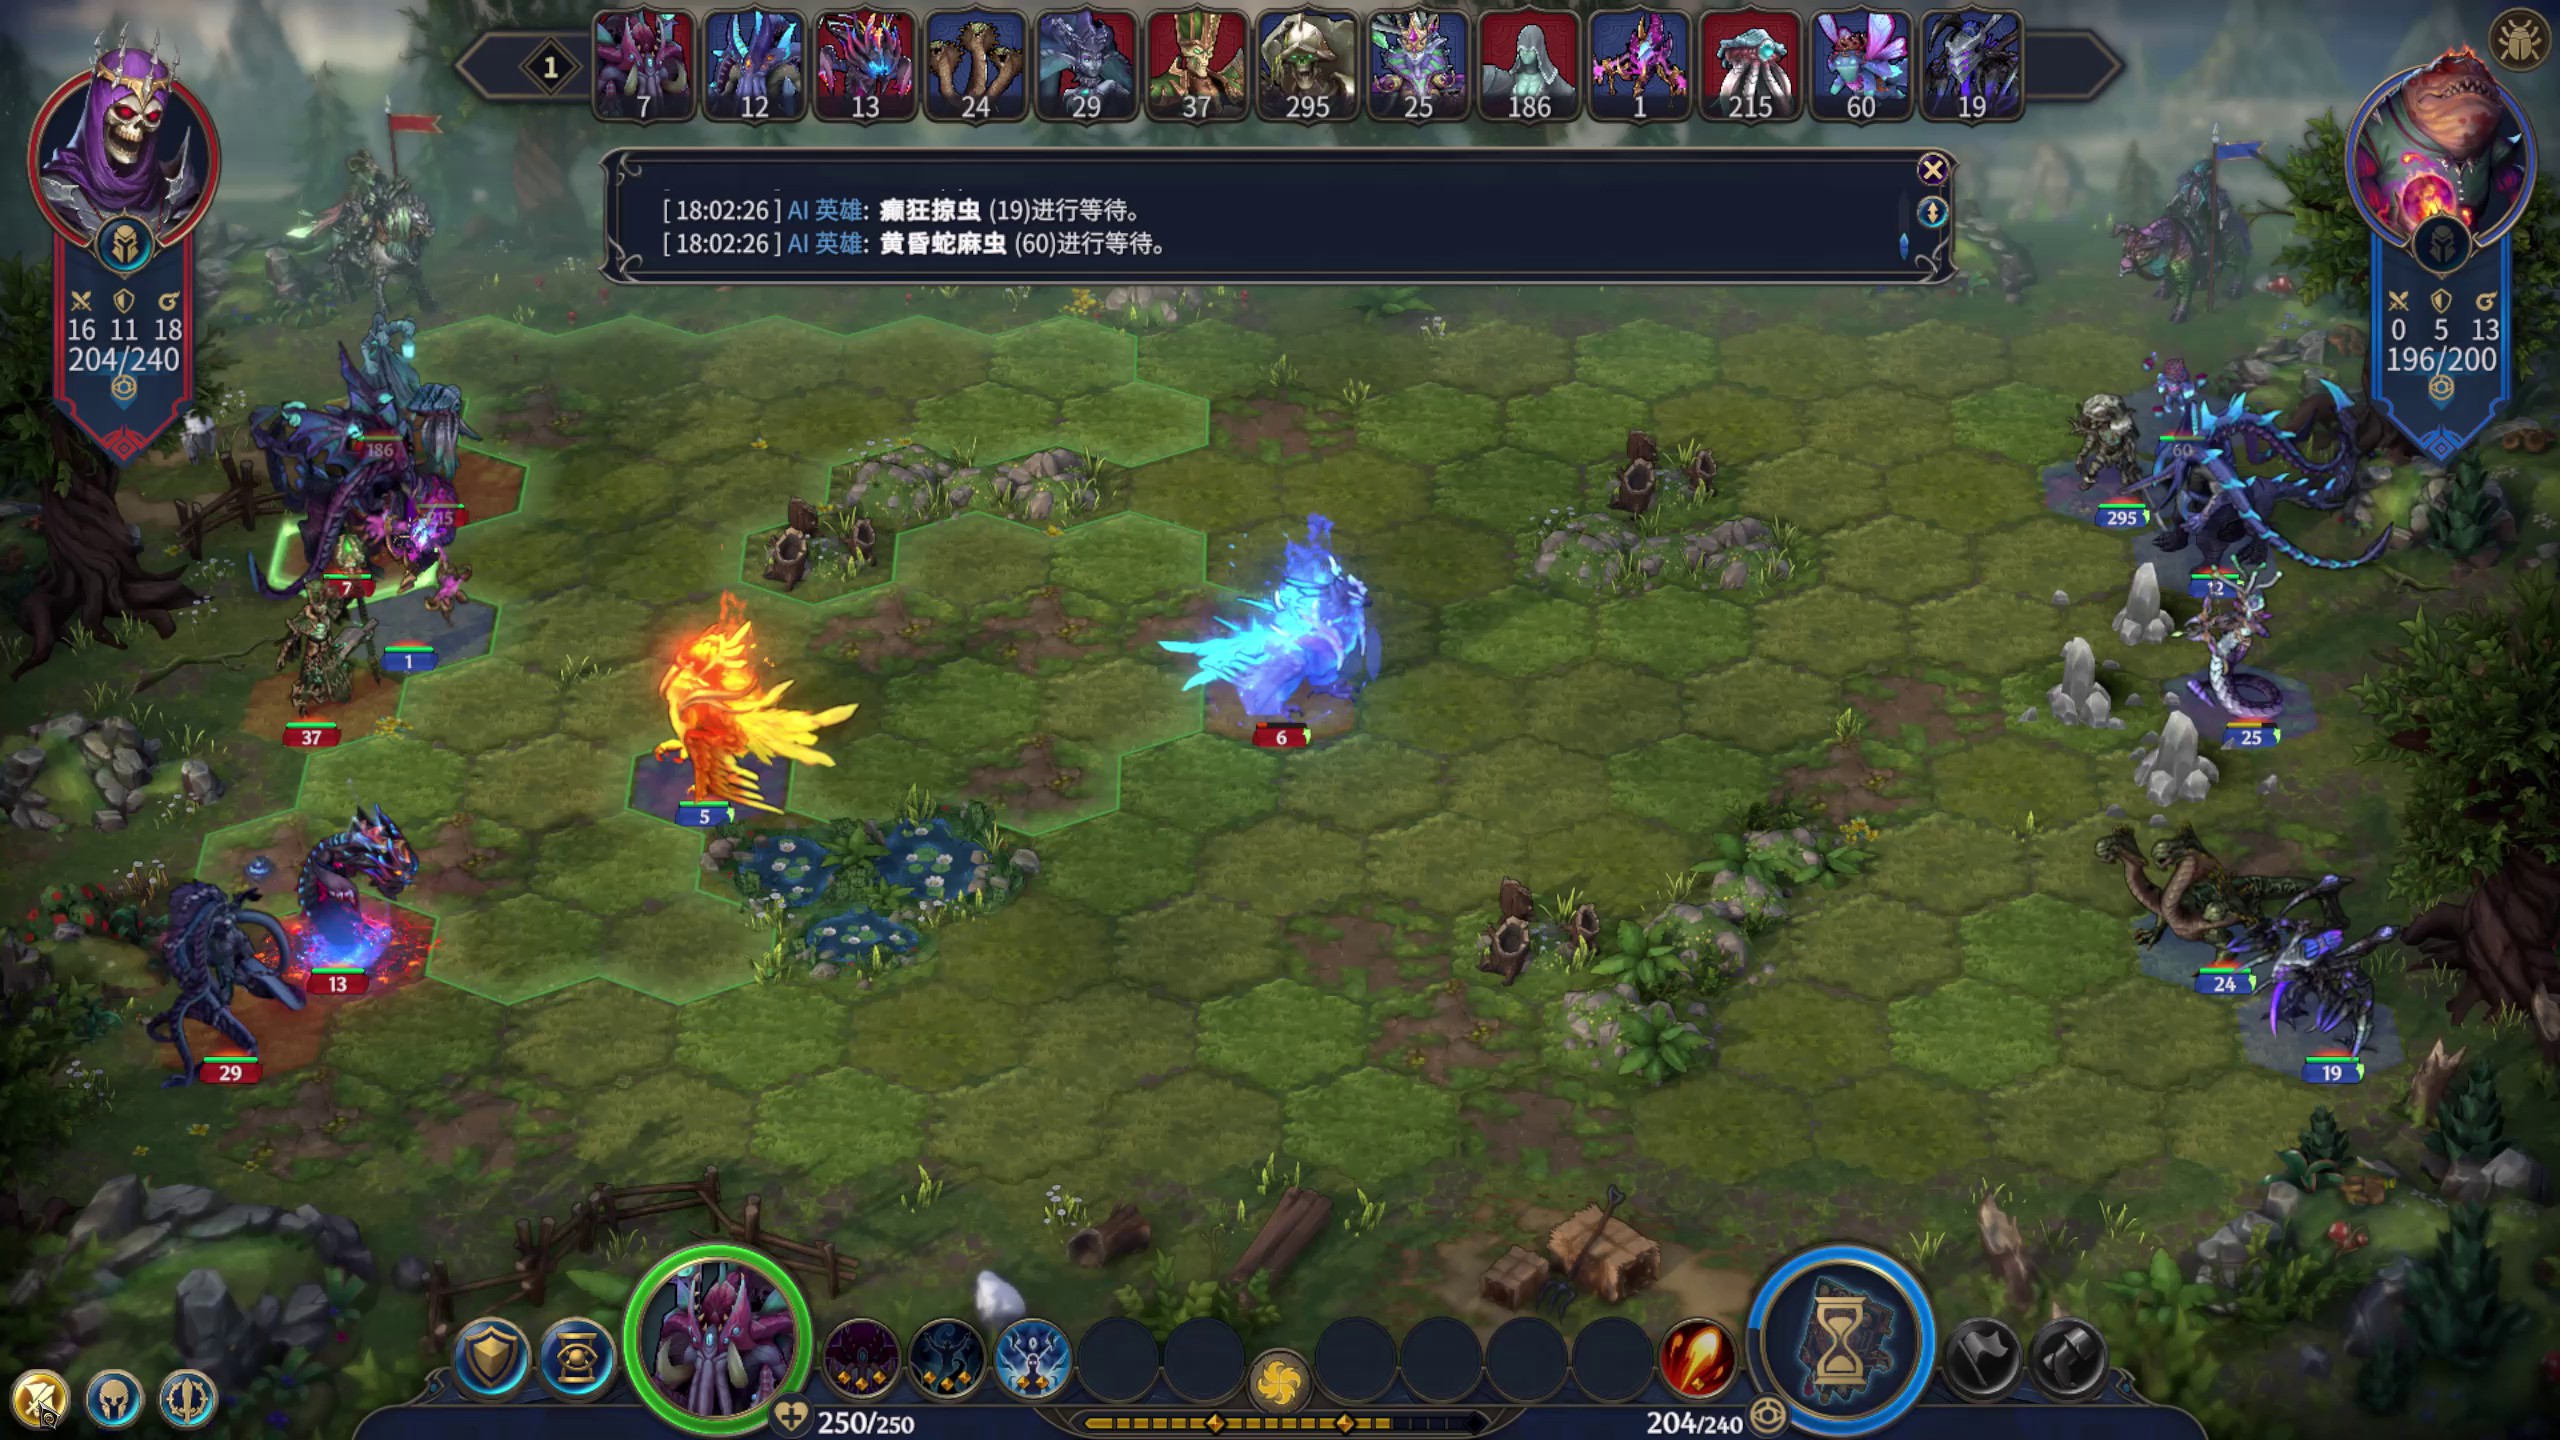
历史规则匹配文字:无匹配;当时返回 UNKNOWN。
查看历史预测与旧标签
历史 OCR 预测:未识别。当时参考标签:战斗进行中(草稿,非测试真值)。旧标签仅保留历史,不覆盖上方分类。
查看本帧全部 40 个 OCR 文本区域
24 0 00 冲出 | 1 | 186 | 295 | 215 | 19 | 13 | 24 | 29 | 25 | 60 | 12 | 37 | 1 | X | [18:02:26]AI英雄:癫狂掠虫(19)进行等待。 | H | [18:02:26]AI英雄:黄昏蛇麻虫(60)进行等待。 | a | X①a | a | Xa | 0 5 13 | 16 11 18 | 196/200 | 204/240 | 186 | 60 | 215 | 295 | 37 | 25 | 6 | 5 | 13 | 24 | 29 | 19 | 250/250 | 204/240
加载页的布局、战场的两侧 HUD 和顶部行动条都提供视觉线索。但技能栏边一个很小的悬浮提示,缩小全图后可能消失。这解释了为什么“场景正确”和“每个局部都可读”必须分开检查。
2. 先比较便宜的全图方法
三种视觉方法都直接读取全图,不需要预先知道场景。近邻方法找与已检查图片最相近的例子;支持向量机(SVM)则从同一批参考学习类别分界。
例如一张魔法书画面,三个视觉方法都建议“战场 / 魔法书”,OCR 又读到书页相关文字,可以进入一致候选;如果有方法认为它还是普通战场,就回到原图检查。三个模型共用开发参考,不是三份独立真值。
| 方法 | 实际输入与处理 | 主要限制 |
|---|---|---|
| 颜色近邻 | 缩为 24×14 的 BGR 图,比较归一化像素差 | 容易记住地图和背景颜色 |
| 边缘近邻 | 灰度图的横/纵梯度,各缩为 40×24 后比较 | 比较外形,但也会丢掉小提示 |
| RBF SVM | 拼接颜色和加权边缘,类别平衡,C=10 | 得分未校准,不是正确概率 |
| OCR 规则 | 全图文字、位置与场景词汇 | 没读到提示文字不代表提示不存在 |
全图 OCR 使用 PP-OCRv6 medium,分别读原图与 1.5 倍局部对比度增强图。640 条复用了兼容缓存,另外 6,795 条重跑;来源包含高清图与 640 像素宽的旧缩略图,不能混称高清数据。后来的 B024 高精度整屏扫描是另一批输入和选型,不把两批数量相加当成去重全库规模。
3. 7,435 条记录怎样分层审核?
这批来源来自 23 个录屏标识,7,435 是记录数,不是去重图片数,也不是按录像隔离的独立测试集。最后候选模型使用 1,202 条逐图参考;不一致或与 OCR 冲突的 1,188 条再看原图,剩余一致候选再抽查。没有把聚类中心的人工结论自动传播成整组已审。
| 最终来源等级 | 有效记录 |
|---|---|
| 用户确认 | 30 |
| 助手逐图检查 | 2,626 |
| 算法交叉核对 | 4,779 |
| 未处理 | 0 |
实际看过 2,630 条不同来源,其中 4 条与用户确认重合,用户标签优先。因此“全部处理过”不等于“全部人工逐图审核”,更不表示每张图的生物和文字都标全了。
这些结果已经接入现有场景审核网站。每条保留原图、标签和审核来源;源图变化、OCR 不完整、模型冲突或标签组合不合法时,不能直接导入为一致候选。
4. 最容易漏掉的仍是小浮层
冻结候选和抽样顺序后,分别检查 120 张按类别与录屏挑选的压力样本,以及剩余池的随机 120 张。下面比较的是修正前预测与助手逐图检查,不是最终标注与自身的比较。
| 开发抽查 | 主场景一致 | 子场景一致 | Other 一致 | 三项同时一致 |
|---|---|---|---|---|
| 压力样本 120 | 120 | 120 | 112 | 112 |
| 随机样本 120 | 120 | 120 | 116 | 116 |
| 合计 240 | 240 | 240 | 228 | 228 |
12 处差异都是小提示遗漏或遮挡误报,已经逐条修正。早一轮另试了文字密度特征的条件 SVM 与 Extra Trees,Other 均为 220/240,没有改善当时基线,因此没有替换默认方法。早晚两轮不是同一队列,不能用 220 与 228 宣称提高了八张。
这轮检查说明,全图方法能帮助整理场景数据,却不擅长发现小浮层。到了真实视频流程,另一个问题出现了:程序有时已经认出了生物面板,却仍不让后面的字段读取运行。
5. 认出了战场,为什么还跳过检测?
下面这张图中央打开了生物属性面板,顶部行动条和两侧英雄仍然可见。新接入的高精度 OCR 已读到“阶级”和“主动能力”,但后面的英雄数字、行动条和面板字段模块全部被跳过。原因不在 OCR,而在决定“要不要运行后续模块”的场景检查。
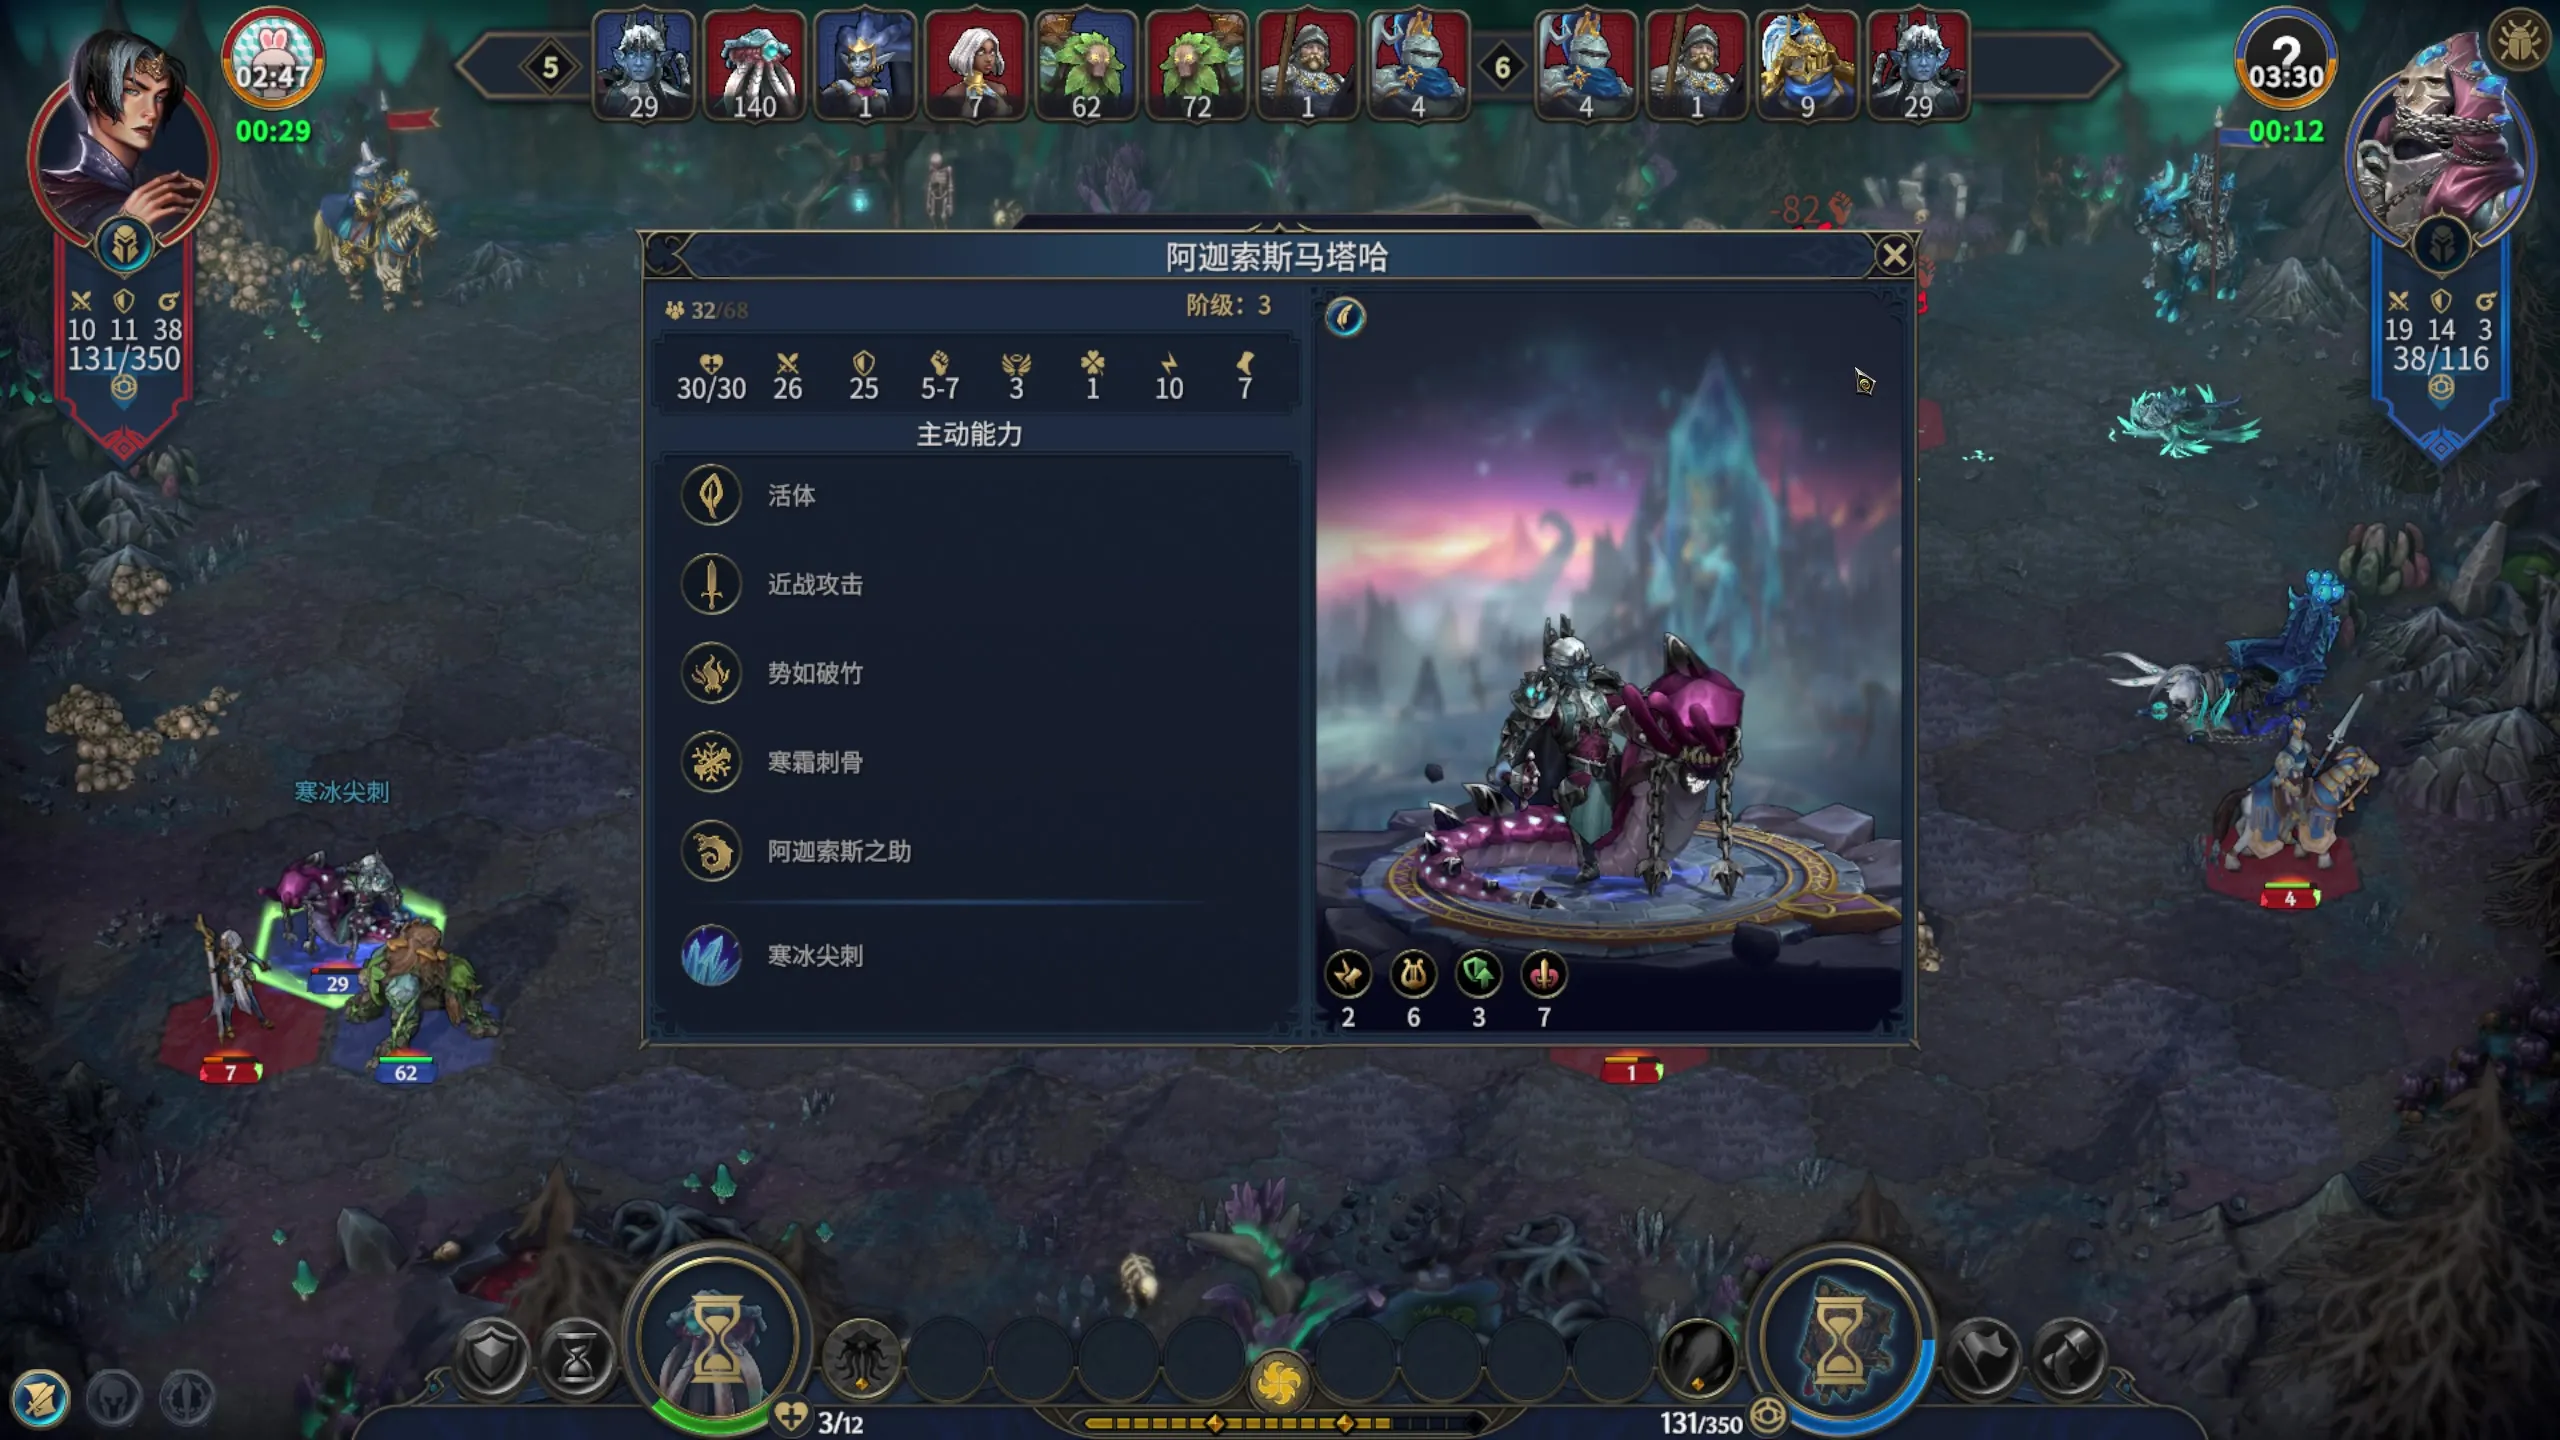
图 2:两种视觉方法都给出“战场 / 生物面板”。一种认为没有额外遮挡,另一种认为有;旧规则要求三个标签完全一致,于是把整张图拦住了。这是已知开发失败图,不是未见测试样本。
最小的改法是:仍要求底层场景和面板类别一致,但容忍“有遮挡 / 没有遮挡”的分歧。距离太远、候选太接近,或已有文字明确指出菜单、过渡、暂停时,仍然拒绝。通过以后也只说“可以尝试战斗相关检测”,不说每个区域都能读清。
另一种更宽松的办法是只检查“是不是战场”。它连普通战斗和魔法书之间的分歧也容忍,并把距离差改为与最近的其他主场景比较。这样可能找回更多图,但会不会把不该处理的画面也带进来?
我们先固定这三种方案,再回放原来逐图检查过的 2,630 条来源。每次查询时,排除同录像的全部参考;两段已知连续对局也放在同一个排除组,共 22 组。这是按来源分组的开发比较,不是新视频盲测:这些资料曾参与历史标签整理,不能排除间接影响。
| 只比较视觉补充分支 | 战场中给出战场候选 / 1,435 | 非战场误判 / 1,195 |
|---|---|---|
| 三项完整一致 | 608 | 0 |
| 只容忍遮挡分歧 | 704 | 0 |
| 只判断顶层场景 | 1,221 | 2 |
保守改法多找回 96 张战场图,没有新增非战场误判。更宽松的顶层方案虽然找回更多,却把下面这样的外部软件窗口当成了可继续处理的游戏画面:两边确实还露着英雄,但中间已经是另一个程序。
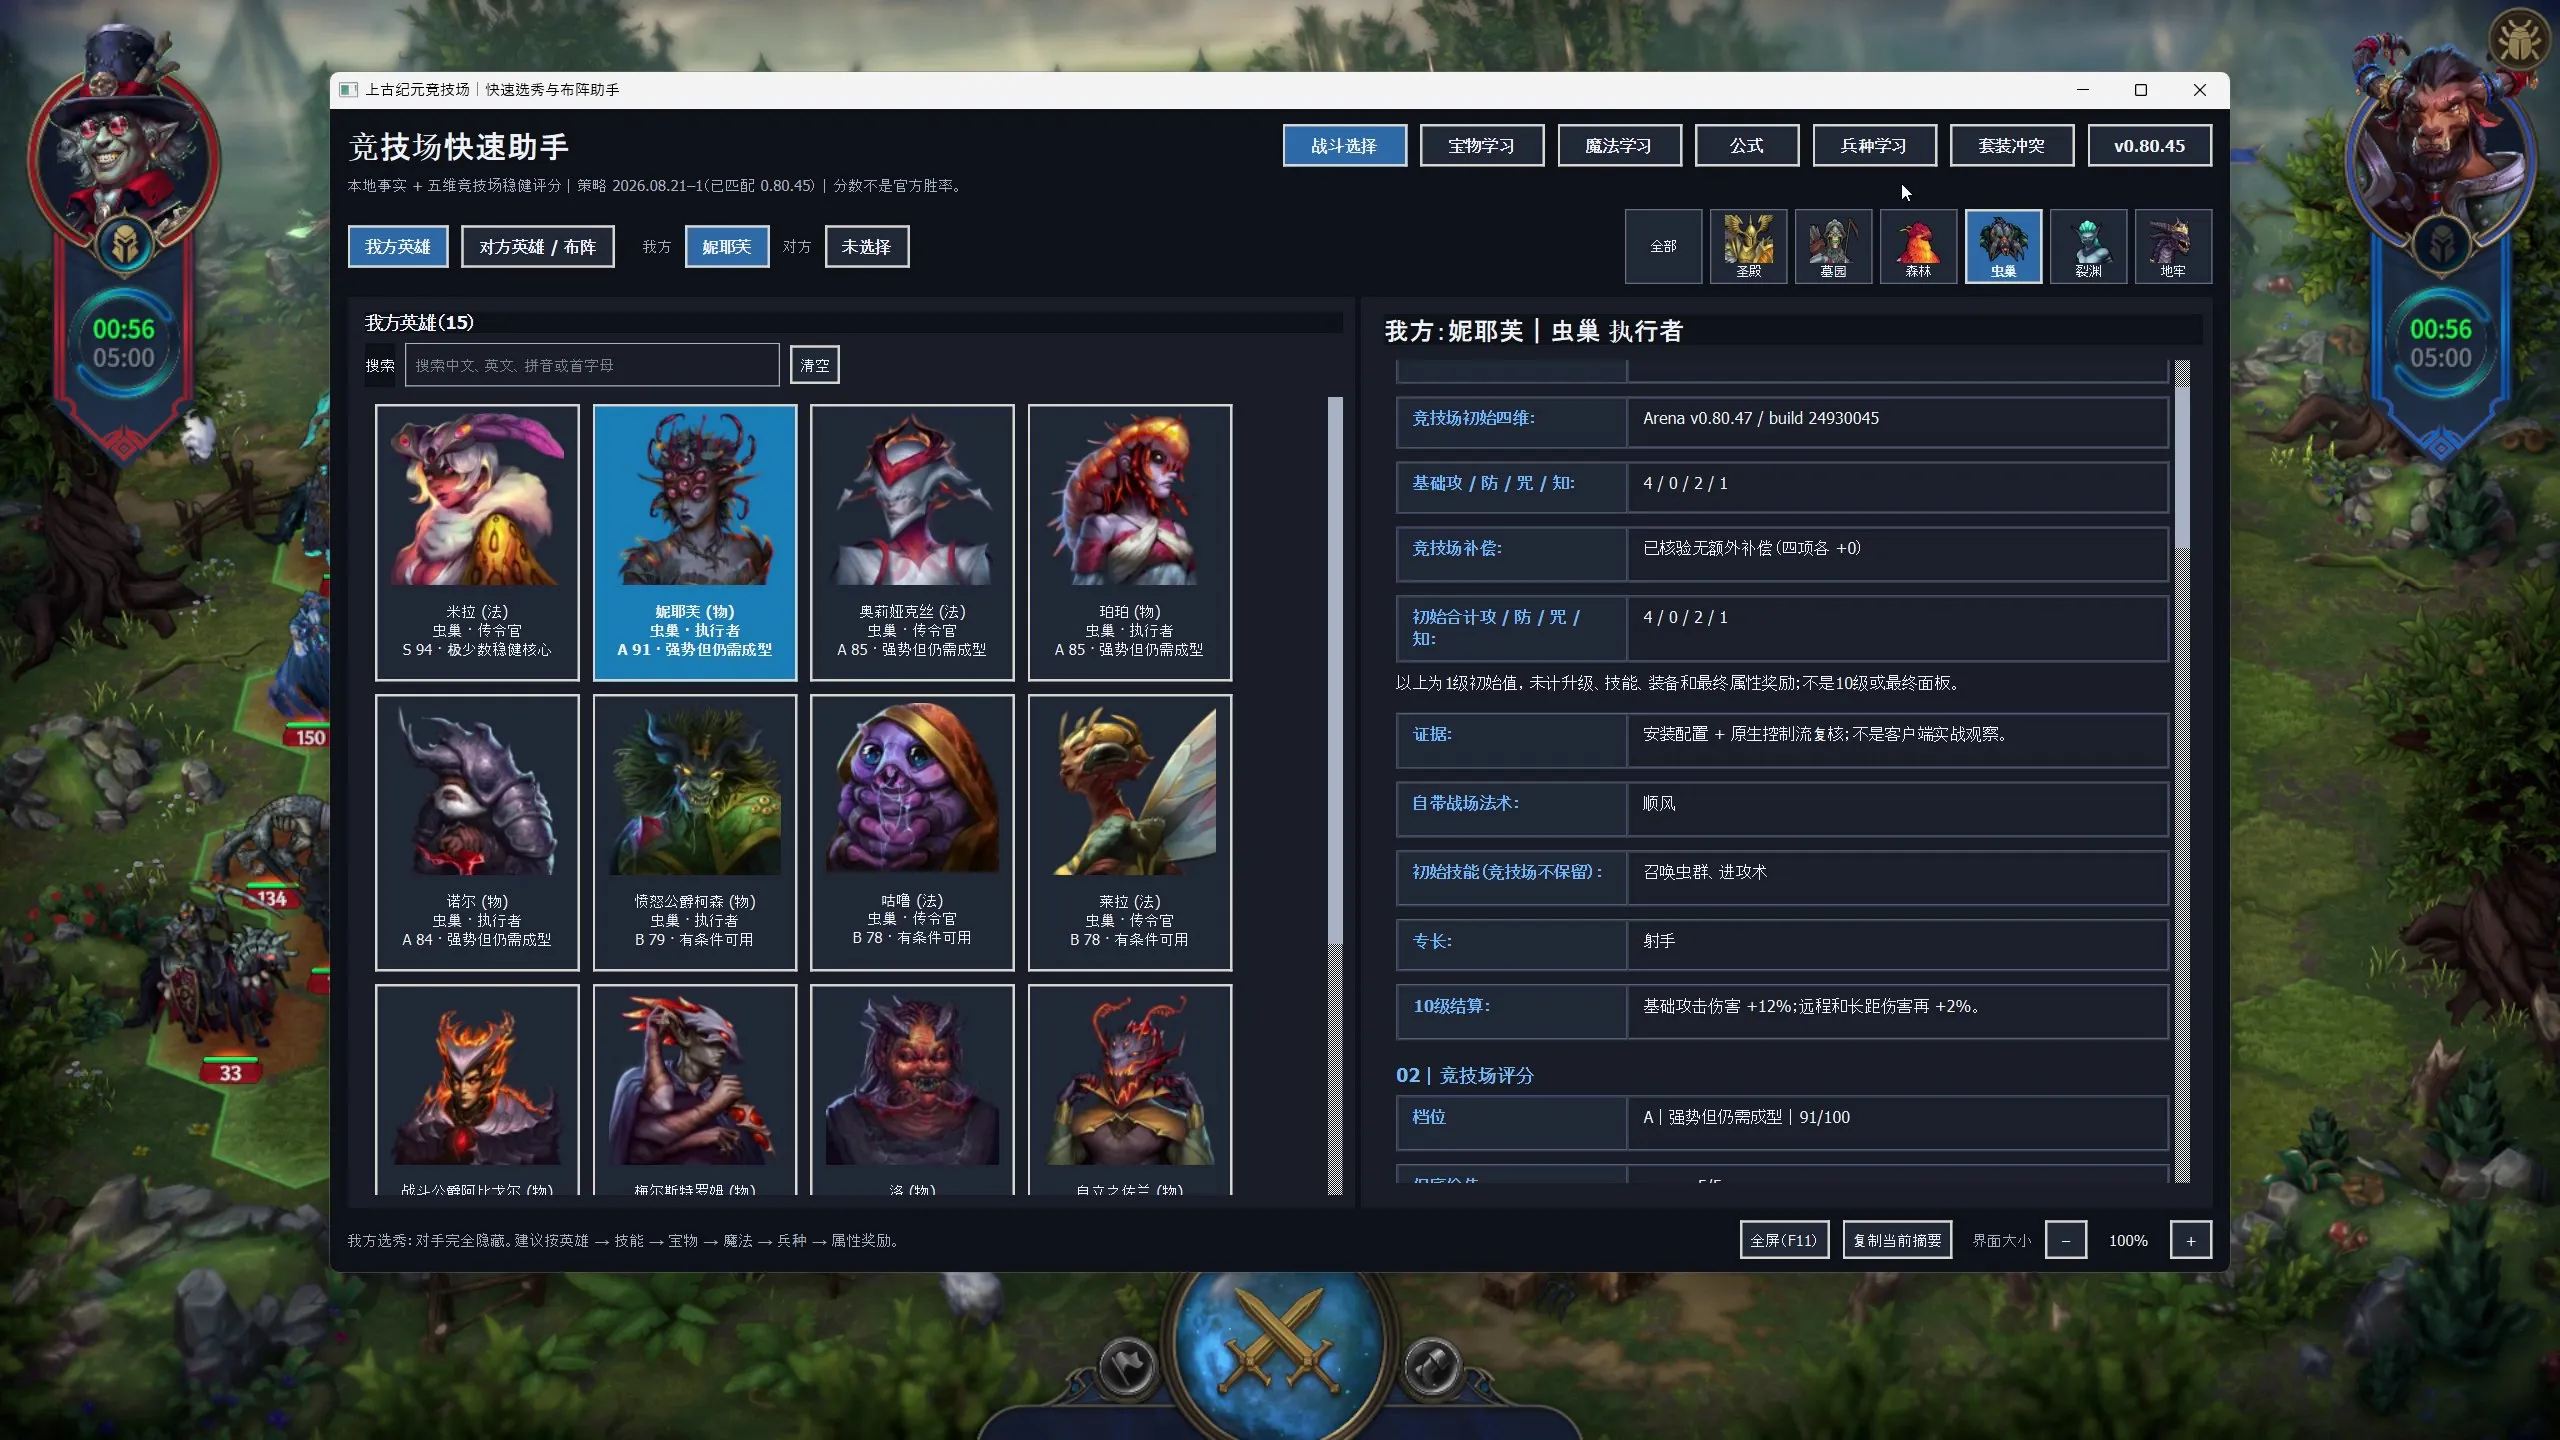
图 3:只看底层布局容易漏掉前景应用。两处新误判来自这个窗口的相邻画面,不是两个独立错误来源。
“非战场误判为零”也不是完全安全。另有 337 张参考带过渡、暂停、断线或非游戏条件,三种方案分别在其中 17、18、42 张上输出战场。这里可能仍是战场,只是不适合直接读取全部内容。保守方案也多放行了一张参考标为过渡的魔法书画面;我们保留这个失败,不把它算作成功找回。
真正接上已有 OCR 后,三种方案在 1,435 张战场中分别输出 739、827、1,276 张战场候选,非战场误判为 4、4、6。OCR 自己也会犯错,所以不能把上表的视觉分支成绩当成整条流程成绩。
因此,9月12日先把容忍遮挡分歧接为显式离线选项,旧默认和原始结果保留;只判断顶层的方案不进入视频入口。在当时两个一分钟片段的 53 张原图中,战场候选从 30 张变成 34 张,新增的是四张生物面板画面。这说明原来被跳过的模块有机会继续工作,不是说这 34 张已经标全或判断全对。
实际补跑也暴露了下一层问题:图 2 中的防御数字 25 已被多次读到,最终字段却仍因保守的合并检查而留空。后续字段合并与完整裁剪读取分别处理这些问题,不能只统计模块有没有运行。
不过,短悬浮说明接上后,六张已经有参考标注的图片仍被场景检查拦住。它们的两种视觉方法不仅都认为是战场,连面板类型也一致。这次到底卡在哪里?
6. 两个候选很接近,但它们其实都是战场
程序原来要求:最像的参考图,要比另一类别的参考图明显更像。这个“另一类别”包含了全部标签。因此,“战场 / 生物面板 / 有遮挡”和“战场 / 生物面板 / 无遮挡”也会互相竞争。两者得分接近,程序就拒绝整张图,尽管它们都支持继续检查战场内容。
这次只改变比较对象:仍要求颜色与边缘同意战场及其子类型,但把差距与最近的非战场参考比较。 图片不能离参考太远,差距阈值也不变。与上节被否决的宽松方案不同,它没有放弃子类型检查;那两张外部窗口画面仍因“英雄面板 / 普通战斗”的分歧而被拒绝。
在相同的2,630条来源分组开发参考上,结果如下。设计时已经看过上述失败,所以这仍是开发改进,不能当新录像盲测。
| 视觉补充分支 | 找到战场 / 1,435 | 误收非战场 / 1,195 | 放行过渡 / 283 |
|---|---|---|---|
| 与不同完整标签比较 | 704 | 0 | 18 |
| 与非战场比较,保留子类型一致 | 1,210 | 0 | 35 |
新方案多找到506张战场,但也多放行17张过渡。逐张查看后,它们包括九张半透明生物面板、六张正在开关或翻动的魔法书、一张半透明英雄面板和一张半透明日志。下面是其中一个例子。
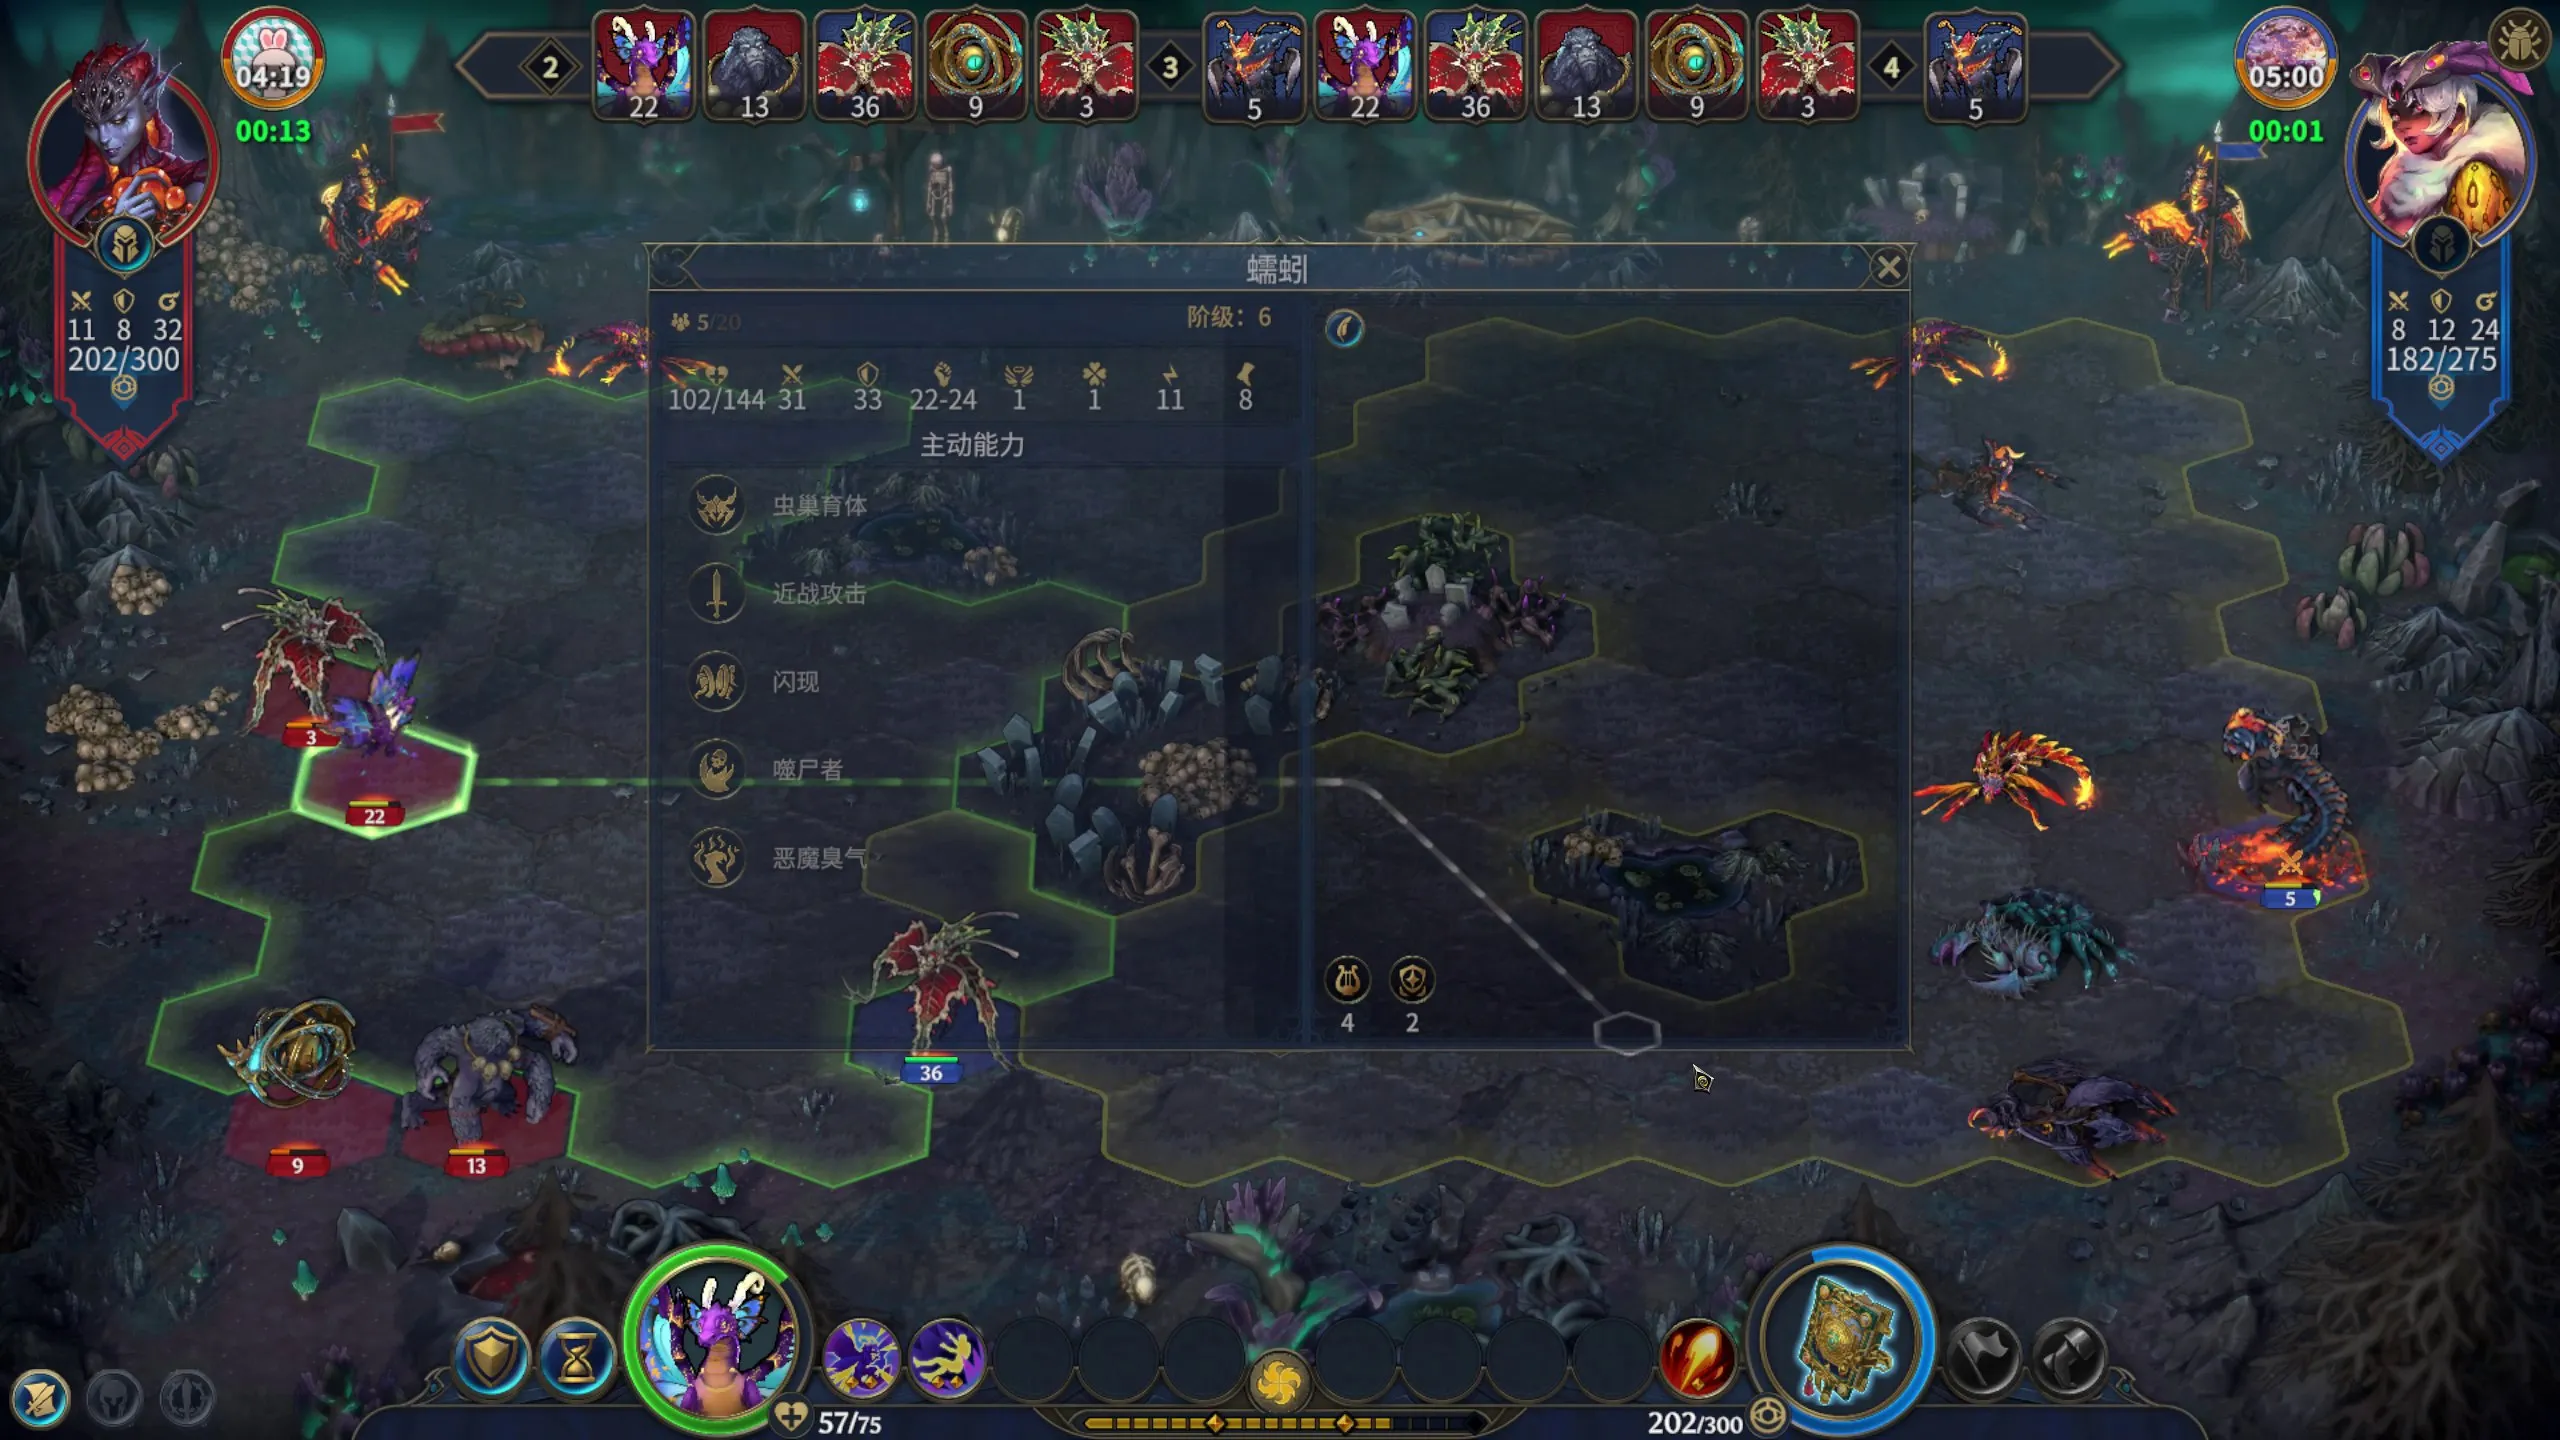
图4:背景确实是战场,但面板还未完全显示。认出场景只能让局部检测开始,不能替代对面板可读性或稳定性的检查。原过渡标注保留,没有为了提高成绩而改成普通战斗。
真实流程还会先读OCR。加上历史OCR预测后,战场候选为827→1,271,非战场误判仍为4;其中OCR原有的误判不会被视觉补充分支自动消除。因此,这个版本只进入独立的短悬浮离线对照,不替换默认视频入口,也不宣称画面已经可安全操作。
找回图片后,真的多读到了什么?
我们把新规则用于四段较新的开发录像,复用403张图已有的OCR,没有重新解码或读取留出视频。完成面板流程的图片从206张增加到369张,另34张仍被场景检查跳过;整个采集清单中还有1,465张待OCR,网站继续显示这些状态。
原先被挡住的六张参考图全部进入了后续处理。在同一组13张图、158个文字或数字参考中,完全匹配项从46增至69,没有丢掉原来匹配的项。另有四段“描述+限制”合并文本匹配,单列报告,不拆成八项成功。
这离“全部内容读出来”仍有距离:66项角色尚不支持,11项拒识,4项没找到读取位置,8项属于刚才单列的合并文本。法术提示可以靠标题、学派与底部等级/魔力的布局定位;生物能力说明和状态效果常没有这一套布局,不能直接套用。
现在可以在新旧场景逐图对照查看收益和过渡失败,也能在语义时间线切换原入口、新候选和参考标注。这里保留当时的开发结果;后续局部入口和质量检查见 P40 组报告。
这轮修复把“不像其他场景”和“面板已经显示完整”分开了,确实增加了可读字段。补齐状态说明布局后,我们又遇到一个更具体的问题:历史参考的转场标签,是否应阻止当前文字进入OCR?
7. 像一张转场图,不等于眼前的字读不了
新采集的状态提示中,有三张文字清楚,颜色和边缘也都认作战场生物面板;只因边缘最近的旧参考标着“转场”,整帧就被跳过了。这里混淆了两件事:历史图是否在变化,以及当前局部能否读取。
新的离线对照只增加一条窄规则:两个方法都同意战场生物面板,其中一个参考是转场、另一个是普通或遮挡面板时,允许继续尝试局部读取。相似度阈值、当前OCR阻挡与局部质量检查不变。双方都是转场仍拒绝,更不会因为字读出来就允许游戏操作。
| 相同来源分组开发参考 | 原入口 | 生物面板离线尝试 |
|---|---|---|
| 视觉分支找到战场 / 1,435 | 1,210 | 1,219 |
| 视觉分支误收非战场 / 1,195 | 0 | 0 |
| 视觉分支放行过渡 / 283 | 35 | 41 |
新增九张已查看原图:四张面板半透明,两张右侧生物显示区仍是黑色,另三张带有悬浮说明。原标签全部保留。加上历史OCR的实际组合后,战场输出为1,271→1,280,非战场误收仍有旧的四张;这个修改没有解决那些OCR误判。
随后在新88张状态批上重跑,五张原场景跳过全部进入面板流程,其中三张补出了状态提示。固定13张正例的26项文字,原完整切块读法从20项匹配增至25项,局部重读则为26项匹配;六张相似负例均无状态提示。另158张含选秀、结算的控制批,处理/跳过结果未变化。
逐图场景对照保留2,630张参考与246张实际接线图;状态文章解释哪些文字被补回。设计已看过这些失败,因此不是独立测试。结果支持继续做离线数据采集,不支持将此规则改为线上“稳定且可操作”的判断;默认入口保持不变。
Comments