竞技场通过英雄、技能、宝物、生物选择页组建军队。程序理解陌生界面时,必须先找到美术图位置,再判断它表示什么。
本实验给公开预训练检测器整张截图,不提供选项坐标。检测器学习提出矩形,独立图像模型再将框内像素与图鉴比较以建议身份。框正确与名字正确是不同任务。
小规模试验中,微调后找到八张留出截图全部 24 个标注目标,多出一个框。但部分留出与训练共享来源录像,因此未证明战场生物检测可靠。
flowchart LR
    A[Whole game screenshot] --> B[Learned detector proposes boxes]
    B --> C[Filter implausible sizes]
    C --> D[Crop each remaining box]
    D --> E[Separate catalog matcher suggests a name]
    E --> F[Human reviews box and identity separately]
图 1。检测提供位置,图鉴匹配提供身份假设,两者都不会自动成为真值。
1. 测量什么?
裁图是候选框内像素,图鉴是英雄头像、宝物等带标签美术图。检测器不区分具体身份,只预测“候选美术图”;下游 P902 匹配器负责命名。
用人工确认框检查几何。IoU 是交集面积除以并集面积,当前匹配要求至少 0.50。Precision 看接受的框有多少真实匹配,recall 看标注目标找到多少,F1 综合两者。
AP 还考虑跨分数阈值的预测排序。AP50 使用 IoU=0.50,mAP50–95 平均 0.50–0.95 更严格重叠要求。初始检测器按后者选,因此固定阈值 F1 最高者未必赢。
试验有 39 图、117 目标:英雄 30、技能 30、宝物 27、生物选择美术 30。这是 UI 图片,不是战场移动生物标注集。全部检测器共用尺寸过滤:任一边小于 12 px 或面积大于整屏 18% 则拒绝。
2. 从四个通用检测器开始
四模型来自 Torchvision 官方 COCO 摄影目标预训练。这里“零样本”只指没有游戏专用训练,不是没有预训练。忽略摄影类别名,只评估矩形。
| 检测器 | AP50 | mAP50–95 | Precision | Recall | F1 |
|---|---|---|---|---|---|
| Faster R-CNN ResNet-50 FPN V2 | 18.32% | 7.94% | 14.20% | 41.03% | 21.10% |
| RetinaNet ResNet-50 FPN V2 | 13.29% | 4.55% | 15.11% | 17.95% | 16.41% |
| FCOS ResNet-50 FPN | 22.73% | 11.89% | 9.13% | 55.56% | 15.68% |
| SSDlite320 MobileNetV3 Large | 2.50% | 0.81% | 11.76% | 1.71% | 2.99% |
Precision/recall/F1 统一用 0.20 阈值。FCOS 在选择指标 mAP50–95 胜出,作为微调起点。本比较未隔离各架构成功或失败的原因。
第二阶段已暴露问题:给定人工框裁图,B02 在该试验认对英雄、技能、宝物,却只认对 53.3% 生物选择裁图。只改善框不能解决身份问题。
3. 教检测器适应游戏布局
骨干提特征,检测头读特征输出框与前景分数。冻结 FCOS 骨干,只训练头部 474 万参数,共 12 轮,使用一个前景类别。
| 分区 | 截图 | 目标 | 用途 |
|---|---|---|---|
| 训练 | 27 | 81 | 更新检测头 |
| 验证 | 4 | 12 | 选择权重和接受阈值 |
| 留出 | 8 | 24 | 报告选定方案 |
验证选择微调 FCOS 第 11 轮、阈值 0.50,原 FCOS 阈值 0.35。下表两者用相同八张留出图,不是前面全部 39 图基线表。
| 留出测量 | 原 FCOS | 微调 FCOS |
|---|---|---|
| AP50 | 23.08% | 100.00% |
| mAP50–95 | 11.56% | 81.85% |
| 定位 precision | 35.29% | 96.00% |
| 定位 recall | 25.00% | 100.00% |
| 定位 F1 | 29.27% | 97.96% |
| 框与身份 F1 | 19.51% | 85.71% |
微调模型有 24 个匹配框和一个多余框,匹配器给其中 21 个取对名称。联合指标同时要求重叠合格和身份正确,比定位 F1 严格。
**这不是完全按录像隔离的测试。**宝物与生物选择的训练/留出共享录像,英雄与技能才使用不同录像。原小样本也参与模型家族选择,因此应理解为布局适配试验,而非全新游戏上的无接触测量。
4. 新界面暴露另一类问题
随后每段录像均匀取 60 时刻,扫描六段:四段不在 Golden Dataset,另两段是评估录像的新时刻。保留 18 张时间分离、高响应图,在 0.50 阈值产生 216 候选。
这偏向检测器有响应的画面,不是全部游戏的随机抽样。许多包含战斗或魔法书浮层,而非选择页。
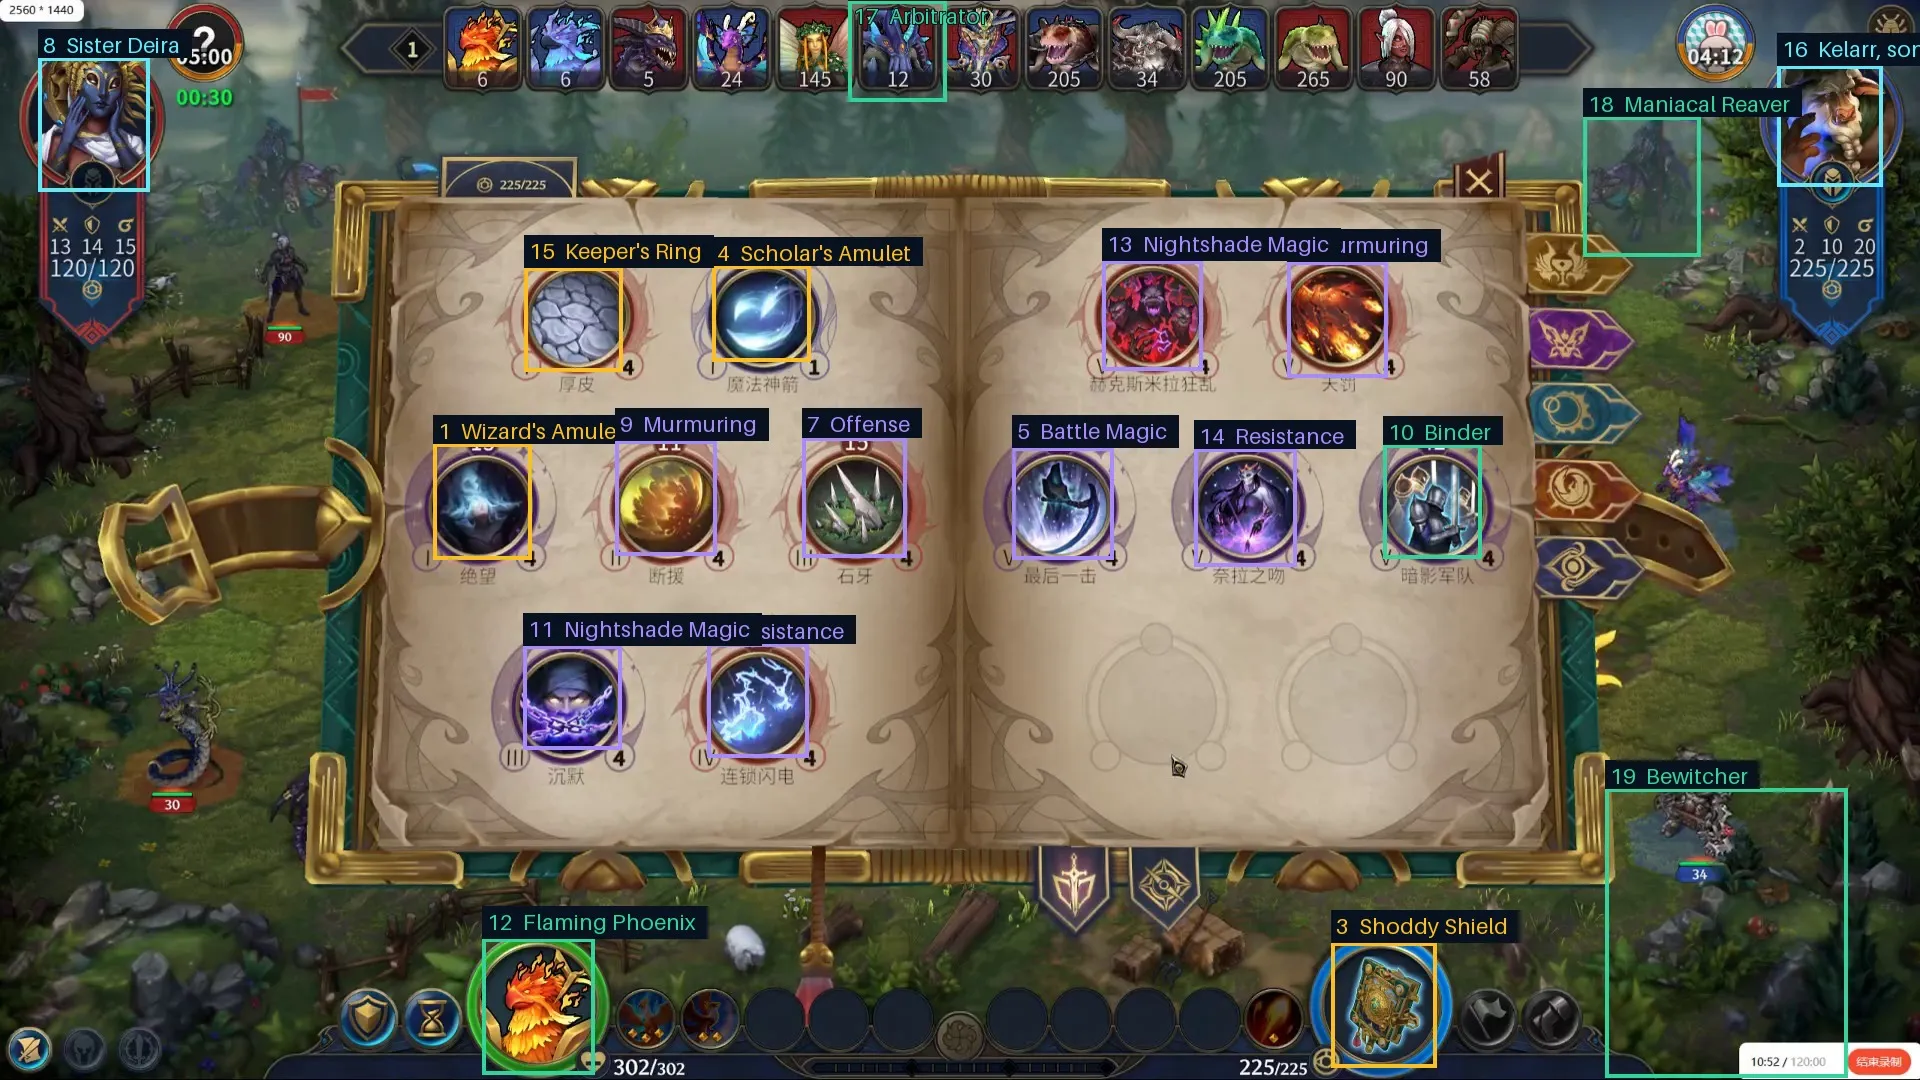
图 2。新时刻魔法书界面的检测假设。框是预测,不是人工确认;空槽、浮层控件和陌生美术都可能混淆系统。
这说明检测图标不等于理解战场。有些框围住有用 UI,有些是空槽或无关区域;合理框也可能被命名错误。216 条建议没有完整独立标签,只能用于展示失败,不能报告准确率。
5. 本实验在项目中的职责
这是 P903。与滑动窗口图鉴搜索不同,它学习提出框,而非代码穷举;与固定裁图分类也不同,后者已知正确槽位。
9 月 3 日导入管线用不区分身份的检测生成战斗和准备页的粗审核候选,不等于验证它们是生物。更大语料中有 27,743 条这类候选,不能算成 27,743 个已标注战场训练样本。
选择页的印刷名称提供补充路线。OCR 实验不依赖当前视觉匹配器即可建议生物身份供审核。将修正后的选择图迁移到战场精灵是后续实验,不是 B03 成果。
6. 证据与下一测试
下一检测评估需要独立录像的已审核战场框,区分 UI 图标、实际单位、阴影/特效、空格和遮挡单位。先分别报告定位与命名,再报告联合成功。
选择页检测器可以作为起点,却不证明站立、移动、飞行和部分遮挡单位都能找到。六边形配准也只能建议位置;当前误差不足以把推断格直接视为可靠点击目标。
证据来源:detector-pipeline-v1 下保存的 benchmark-summary.json、data-split.json、fine-tuning-summary.json、blind-review-v1。代码在 perception/experiments/b03_off-the-shelf-detectors-and-segmentors/。本文说明既有试验,本次写作未重训模型。
Comments