At a glance
Sliding-Window Icon Detection · Catalog-Trained Backbone
September 3 status: the A–F results below remain the historical catalog-only study. Newer work separately tests learned box detection, reviewed gameplay classification, and printed-title OCR. Their different inputs and test sets make their scores non-interchangeable.
Heroes of Might and Magic: Olden Era is a turn-based strategy game. In Arena mode, players build a temporary army through choice screens with three heroes or three large Main Skill icons. This detector receives the complete screenshot without the icons' slot coordinates. It must find the icons as well as name them.
Ordinary code generates sliding-window candidate boxes and extracts their crops. A visual feature extractor—the backbone—encodes each crop for comparison with the known icon catalog. This experiment keeps that search formulation, but trains the backbone on catalog artwork and adds explicit crop-quality learning. Only the clean catalog and generated images update model weights, not gameplay screenshots or human-drawn boxes.
This is not a conventional learned object detector: the code-generated grid supplies the initial rectangles. D and the F follow-ups score those rectangles without moving them; E separately tests adjusting them with learned offsets. The A–F comparison below preserves that distinction.
The answer on this small engineering benchmark is: catalog training makes identity recognition strong, but full-screen detection still depends on choosing a tight crop and rejecting background. Learning crop quality raises the detector from 12 correct / 7 false / 6 missed to 13 correct / 3 false / 5 missed. The precision–recall summary, F1, rises from 0.649 to 0.765. A later spatial-head variant looks better on the already-inspected engineering-test set, but separate model-selection screenshots choose a different variant, so that apparent gain still needs a new test.
You do not need to memorize A–F. Read the sequence as four questions: Can a generic feature recognize the icon? Does catalog training improve identity? Can a separate score choose a better crop? Which later-stage change addresses the remaining misses?
Expand the A–F method key when needed
All experiment-specific weights are learned from 390 clean catalog images and generated variations, with no gameplay screenshot pixels or boxes used for weight updates. The real screenshots choose operating settings or report results; they never send gradients back into the model.
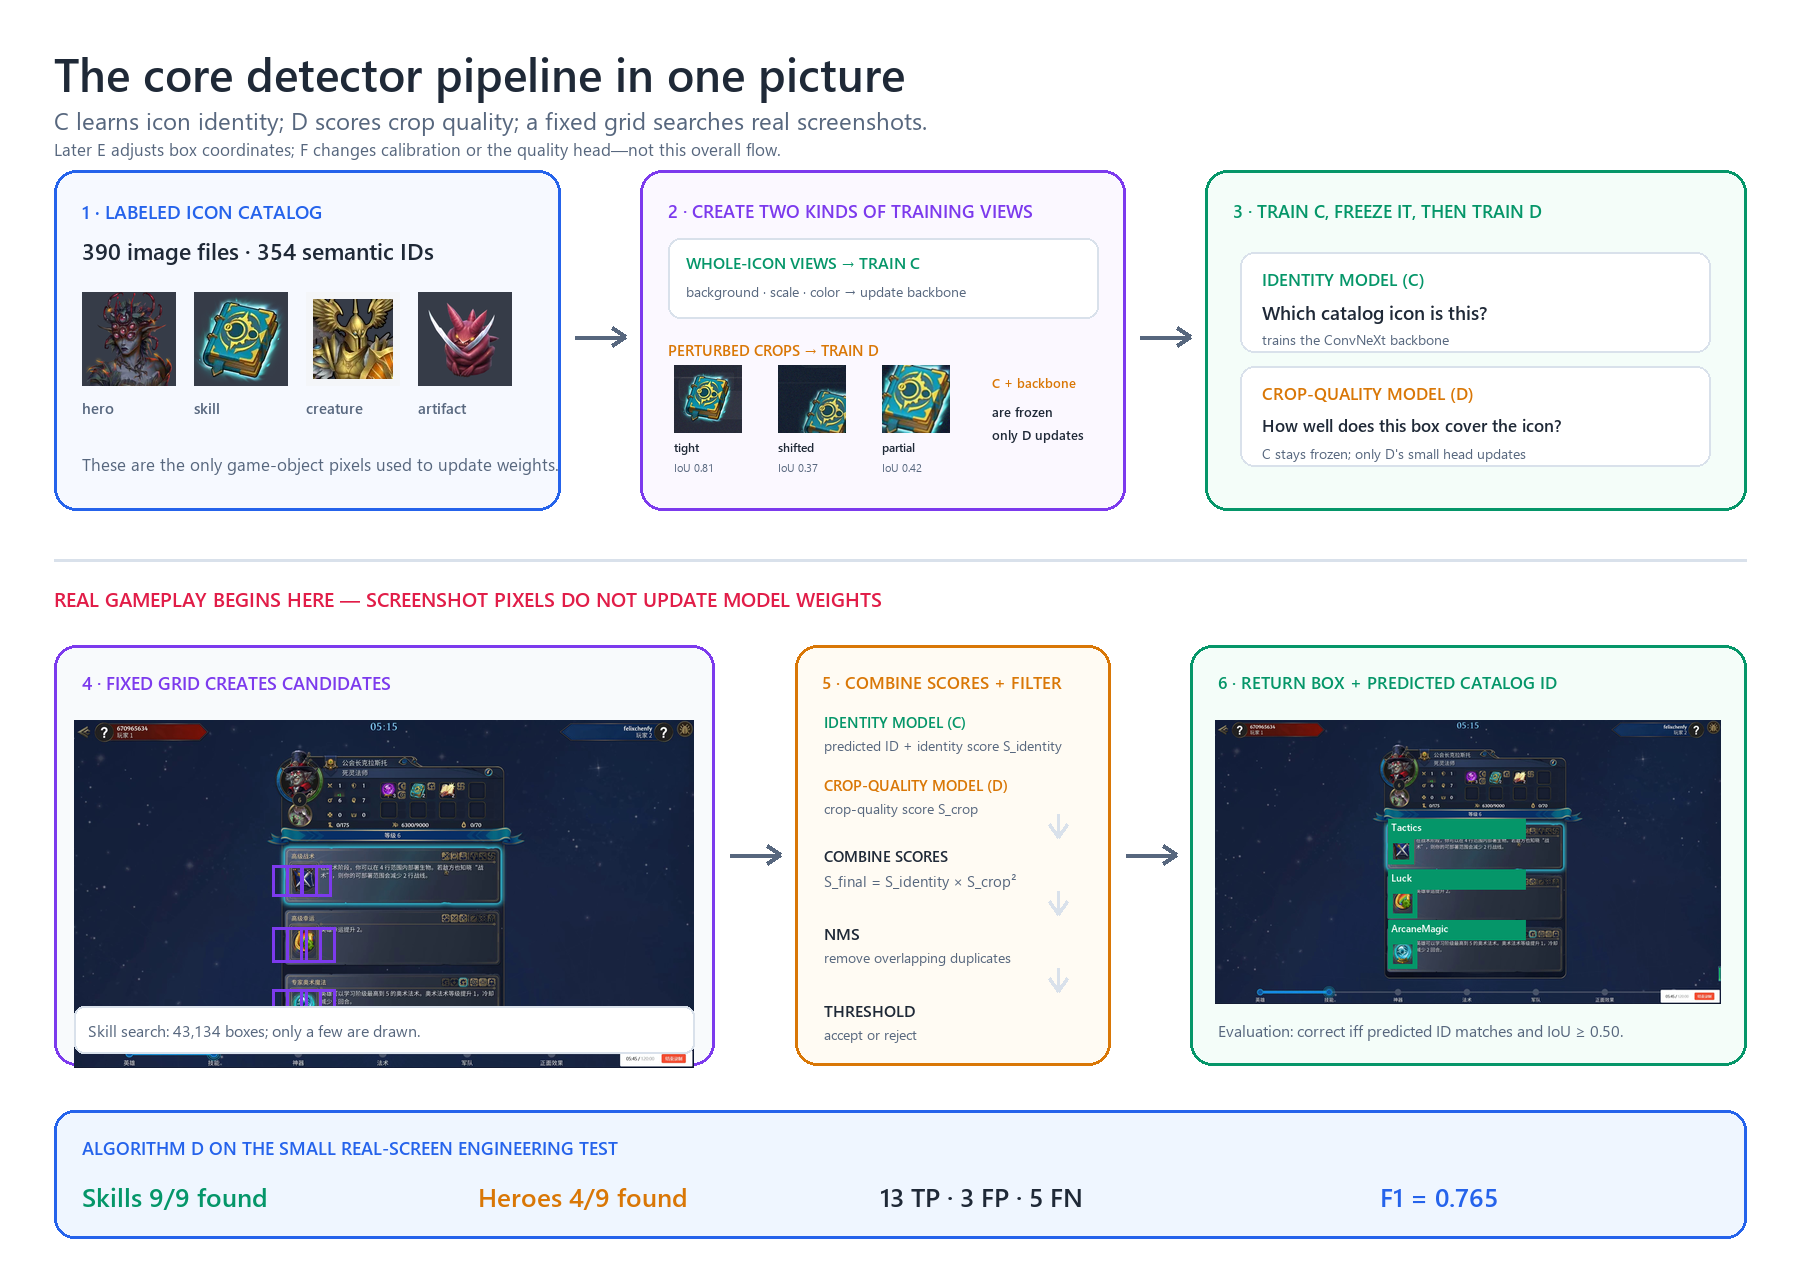
Expand historical results; scope is explained below
1. What is the system trying to do?
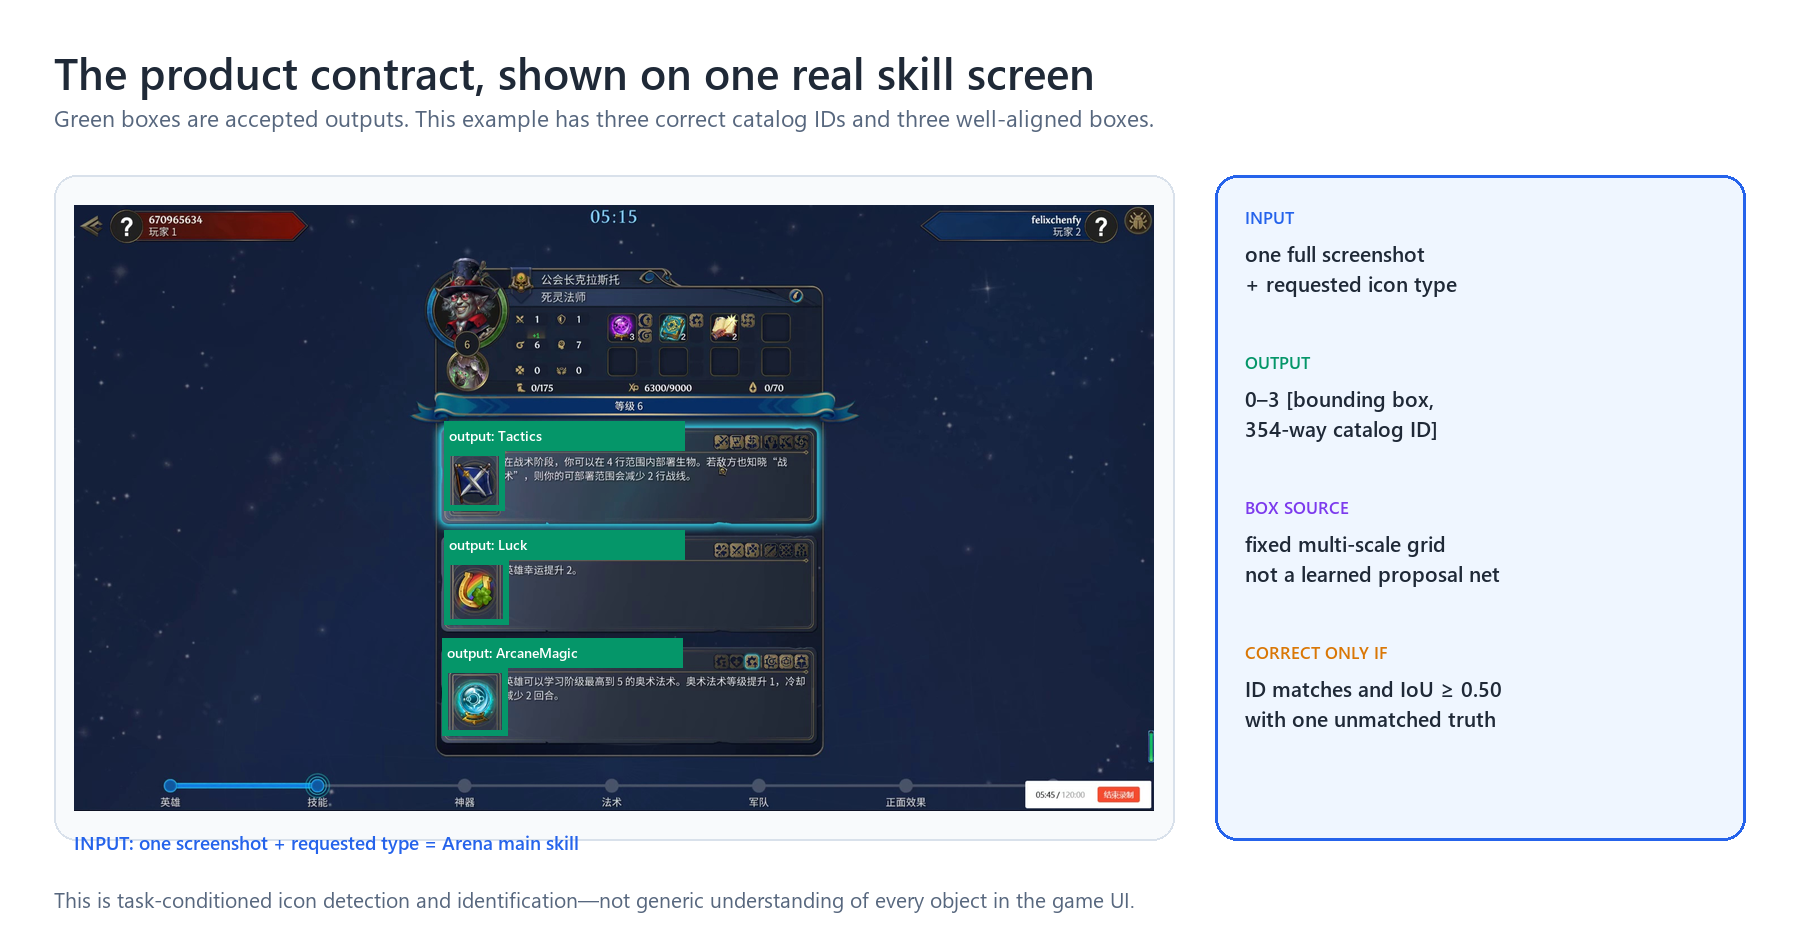
An Arena choice screen can contain three selectable heroes or three Main Skills. A Main Skill is the large ability icon offered on that dedicated choice screen, not every small skill symbol elsewhere in the interface. The detector receives the complete screenshot plus the requested family—Hero or Main Skill—and may return zero to three rectangles with identities.
A correct detection—a true positive (TP)—requires both conditions: the predicted identity matches the label, and the rectangle overlaps the human-drawn rectangle by at least IoU 0.50. An accepted wrong result is a false positive (FP); a labeled target that remains unmatched is a false negative (FN), or miss.
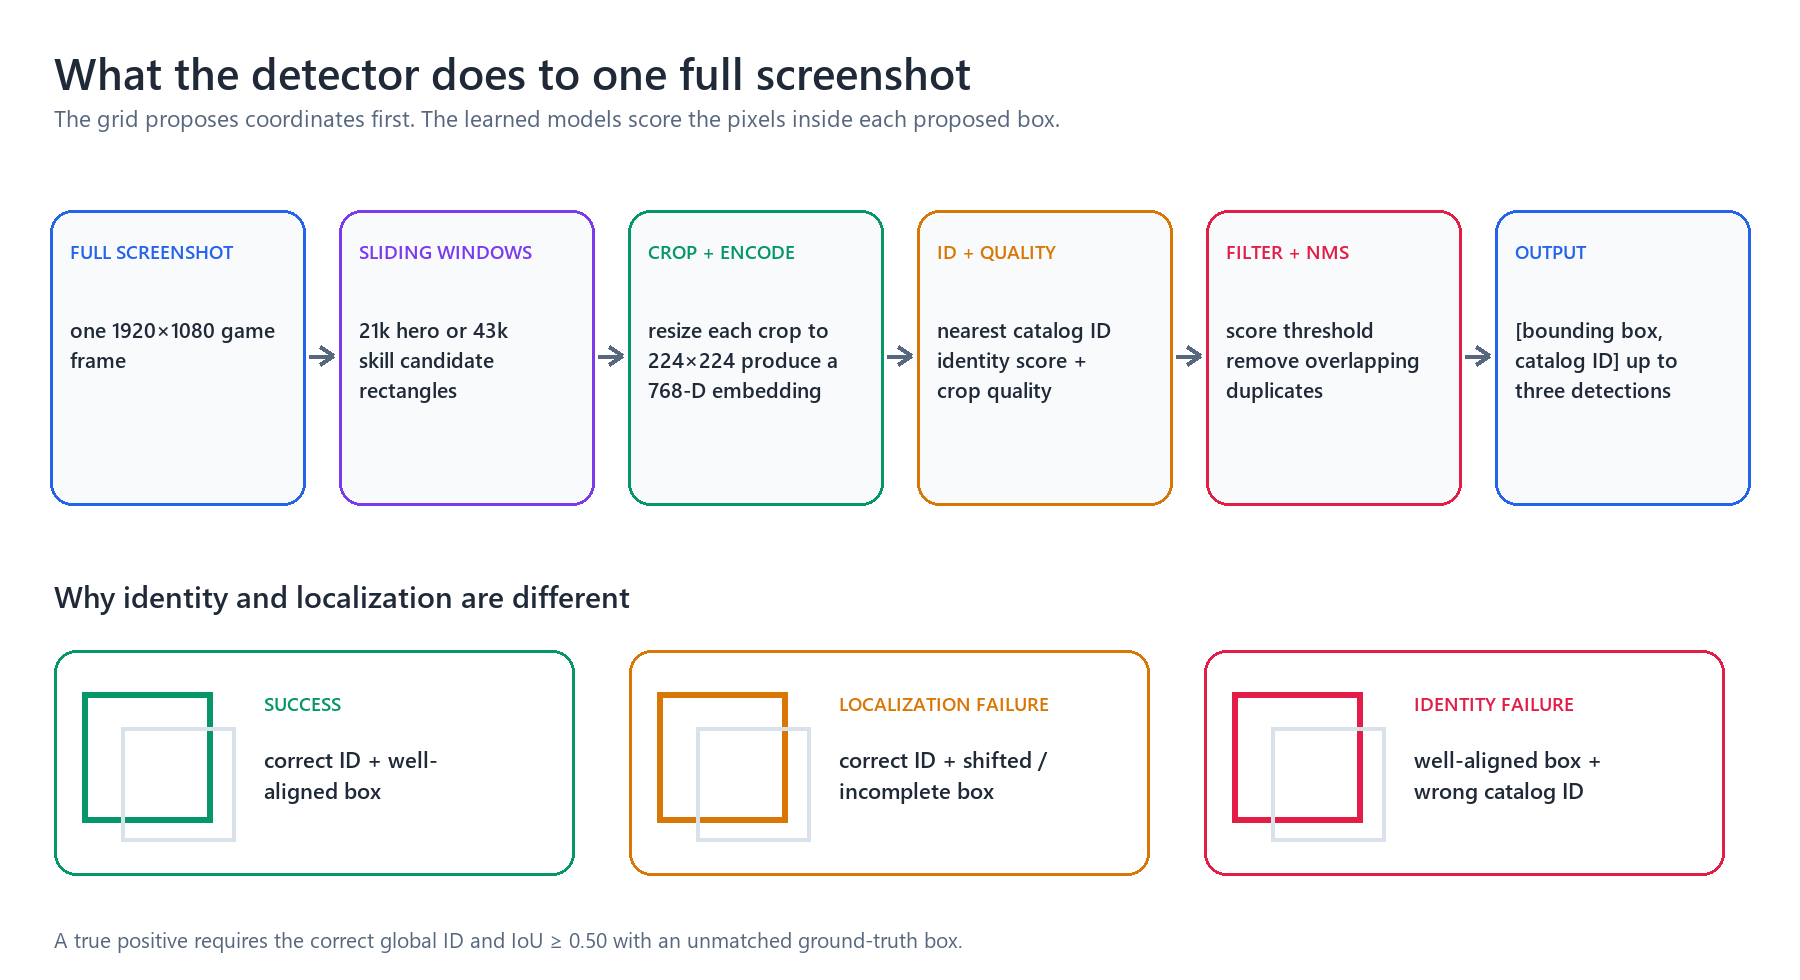
Where do the rectangles come from? The fixed grid comes first
Unlike a conventional learned object detector, the neural network never proposes a bounding box in this experiment. A deterministic sliding-window grid first enumerates 21,193 square hero candidates or 43,134 square skill candidates on a 1920×1078 screenshot. Only then does the network inspect each crop. Hero windows move in 20-pixel steps—about 10–16% of their 128–192 pixel widths—while skill windows move in 16-pixel steps, about 12–22% of their 72–132 pixel widths. Localization is therefore discrete in x, y, and size, and restricted to square boxes.
Image-size note: the actual validation and engineering-test JPEGs are 1920×1078, matching the first experiment's inputs. The wider source collection also contains 1920×1080 files, but those are not the validation/test frames reported here. The search reads each image's actual dimensions; only its candidate crops are resized to 224×224.
Identity question
“Which known icon does this crop depict?” This is solved by an embedding and cosine retrieval.
Localization question
“Does this candidate tightly overlap the icon?” This is solved by window generation, quality scoring, duplicate removal, and a threshold.
Vocabulary used below
Candidate slots are not supplied to this detector. They describe where choices appear in the game, but the search still scans the whole screen. Its only location-related hints are plausible box sizes and grid spacing. The later fixed-crop experiment deliberately changes this rule: it uses known slot coordinates and tests recognition without searching for boxes.
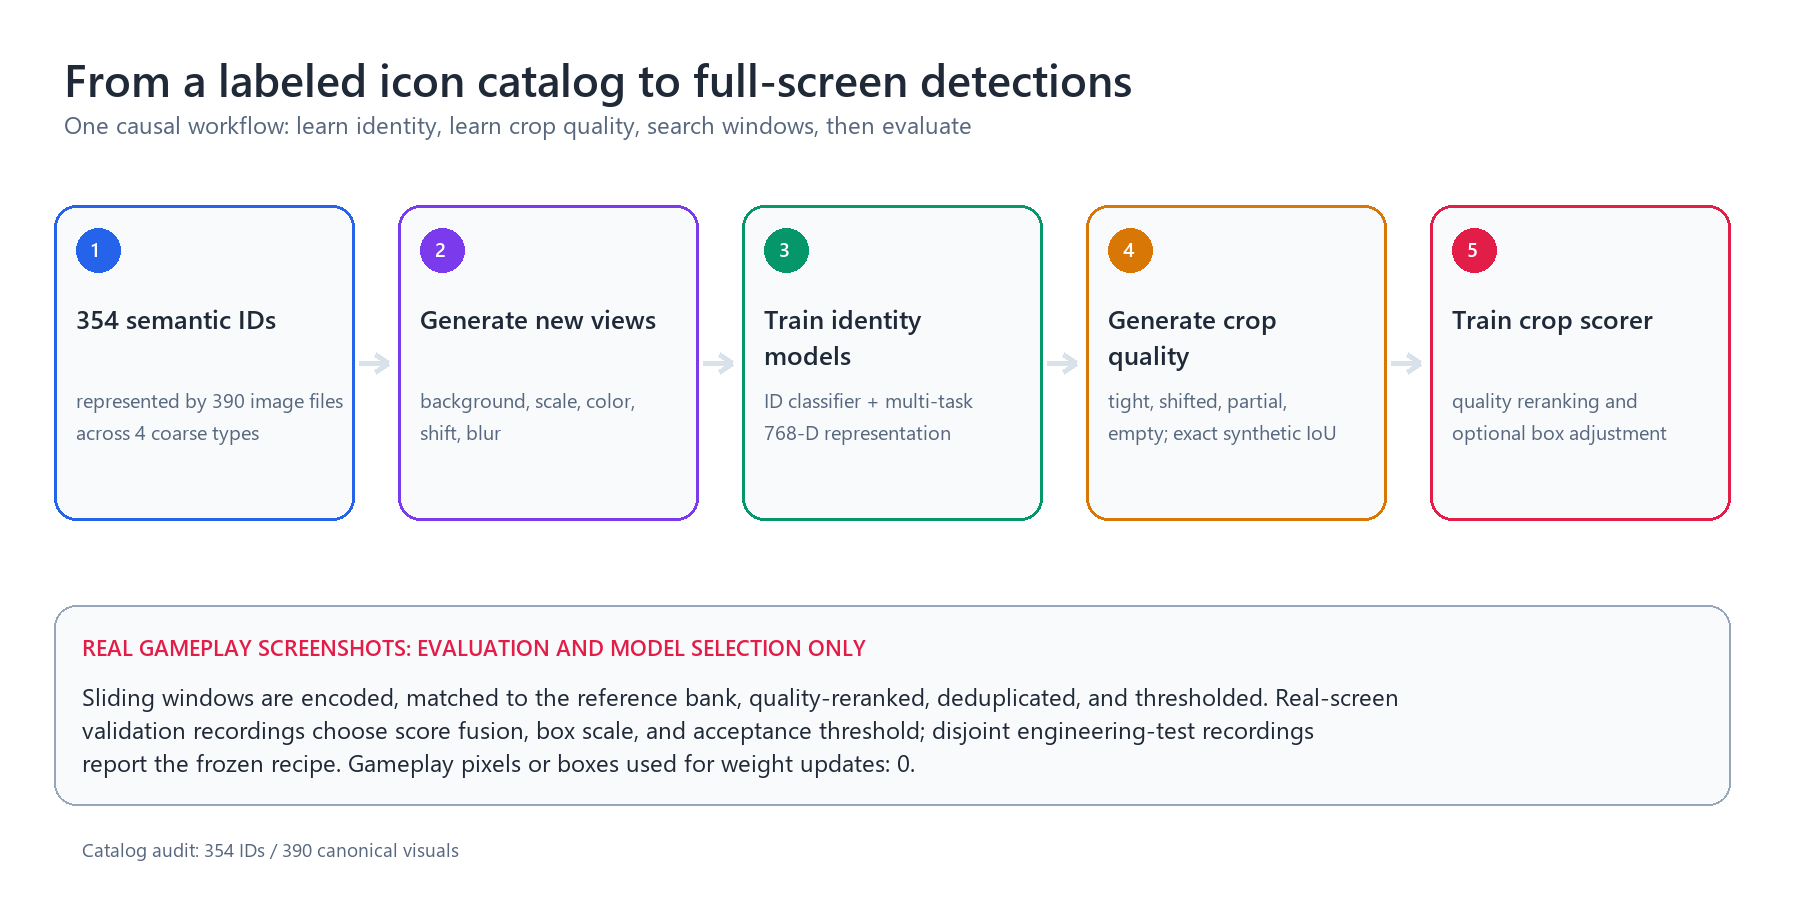
2. Exactly what does “icon-only training” mean?
The catalog contains 354 semantic identity classes represented by 390 clean image files. Some Arena skills have several valid visual variants, so the number of files is larger than the number of IDs; the extra files are not extra classes. Compared with the first experiment's 60 Main Skill references, a catalog audit removed four incorrect scroll-shaped basic references for Arcane, Daylight, Nightshade, and Primal Magic. That leaves 56 visuals for the same 20 Main Skill identities. This experiment also adds Creature and Artifact identities; Spell is not one of its four types.
| Type | Global IDs | What it means |
|---|---|---|
| Hero | 77 | Selectable character portraits |
| Main Skill | 20 | Arena main-skill icons; 56 valid visual variants |
| Creature | 141 | Unit icons, using icon-sized catalog art |
| Artifact | 116 | Equipment or treasure icons |
| Total | 354 identity classes | 390 clean image files |
The internal label Skill means Main Skill throughout this experiment; it does not include subskills or spells. Some original figure labels use that shorter name.
Audit count: Gameplay screenshot pixels used to update the ID-trained, multi-task, or crop-aware model weights = 0; gameplay bounding boxes used to update those weights = 0. Real-screen validation and real-screen engineering-test screenshots are evaluation evidence, not training examples.
Procedural backgrounds are generated by code: smooth colors, faint rectangles, and lines. They are not copied from gameplay screenshots. Color jitter, resizing, blur, rotation, and synthetic cropping also create new pixels, but they do not introduce a new photographed or game-recorded object.
3. Which images train the model, and which only measure it?
All 354 icon IDs appear in training because the product must recognize every known game icon. The test does not hide entire IDs. Instead, it generates new appearances using different random seeds, so each test image has a new combination of background, scale, shift, rotation, color, and blur.
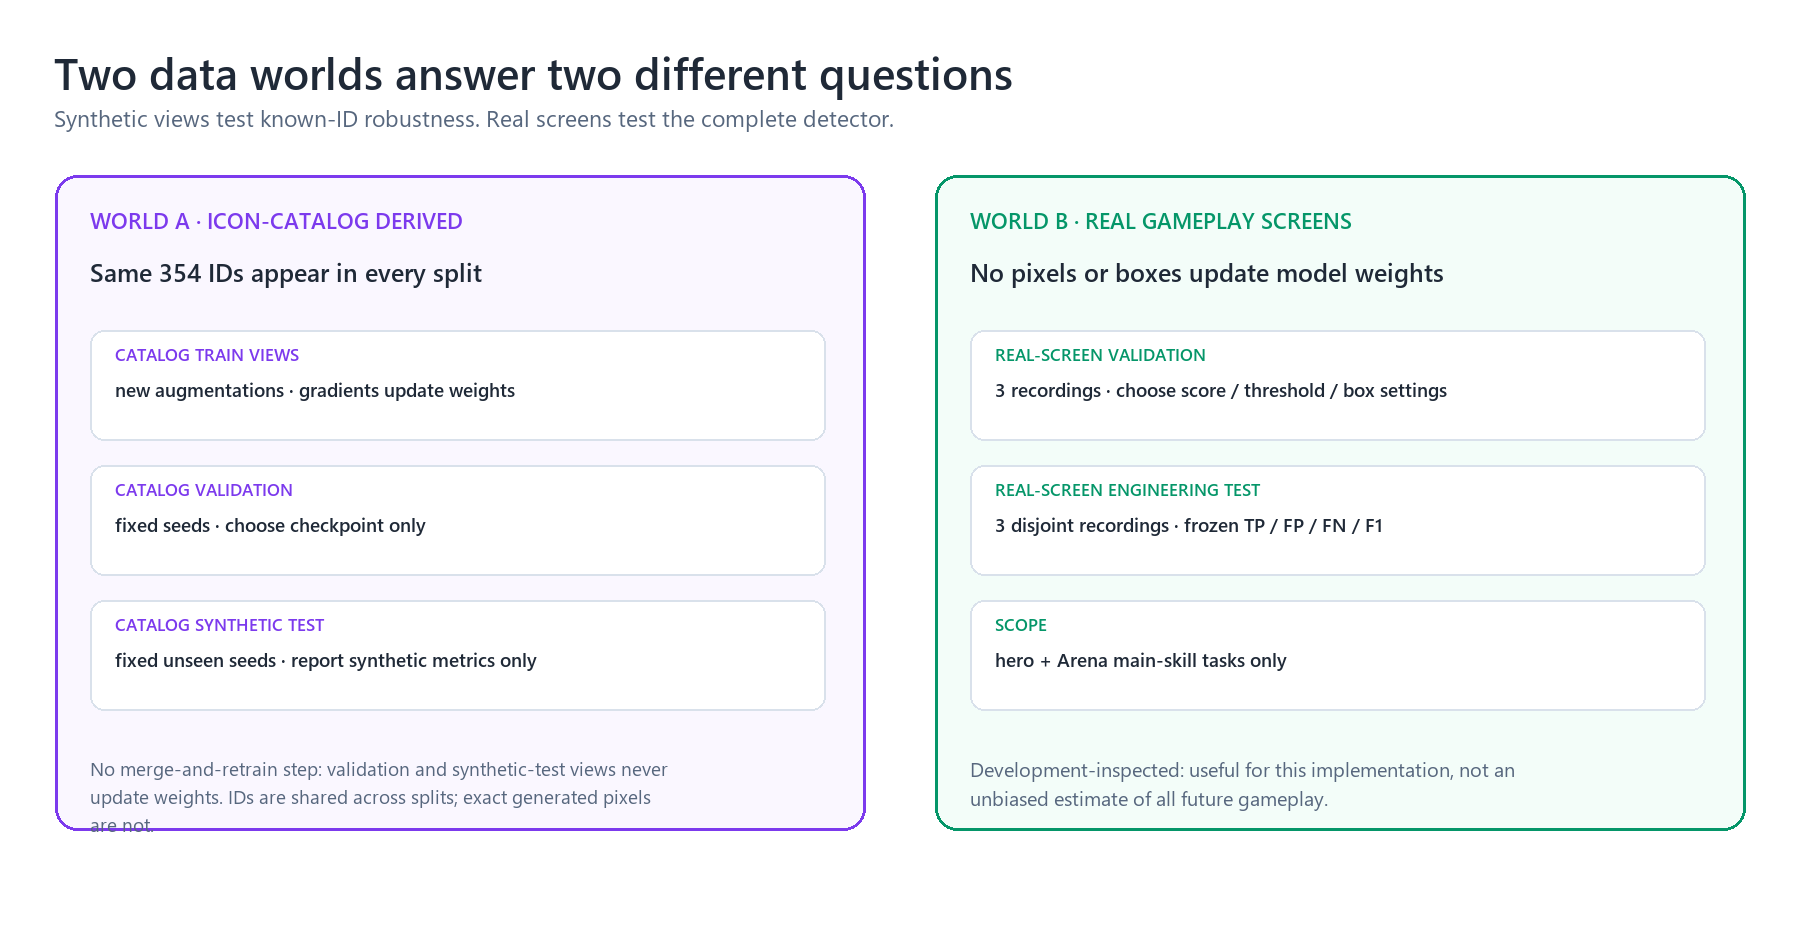
| Split | Its only role | Updates neural-network weights? |
|---|---|---|
| Catalog train | Backpropagation / gradients | Yes |
| Catalog validation | Select a checkpoint | No |
| Catalog synthetic test | Report synthetic metrics | No |
| Real-screen validation | Select score fusion, threshold and box settings | No |
| Real-screen engineering-test set | Report the frozen end-to-end result | No |
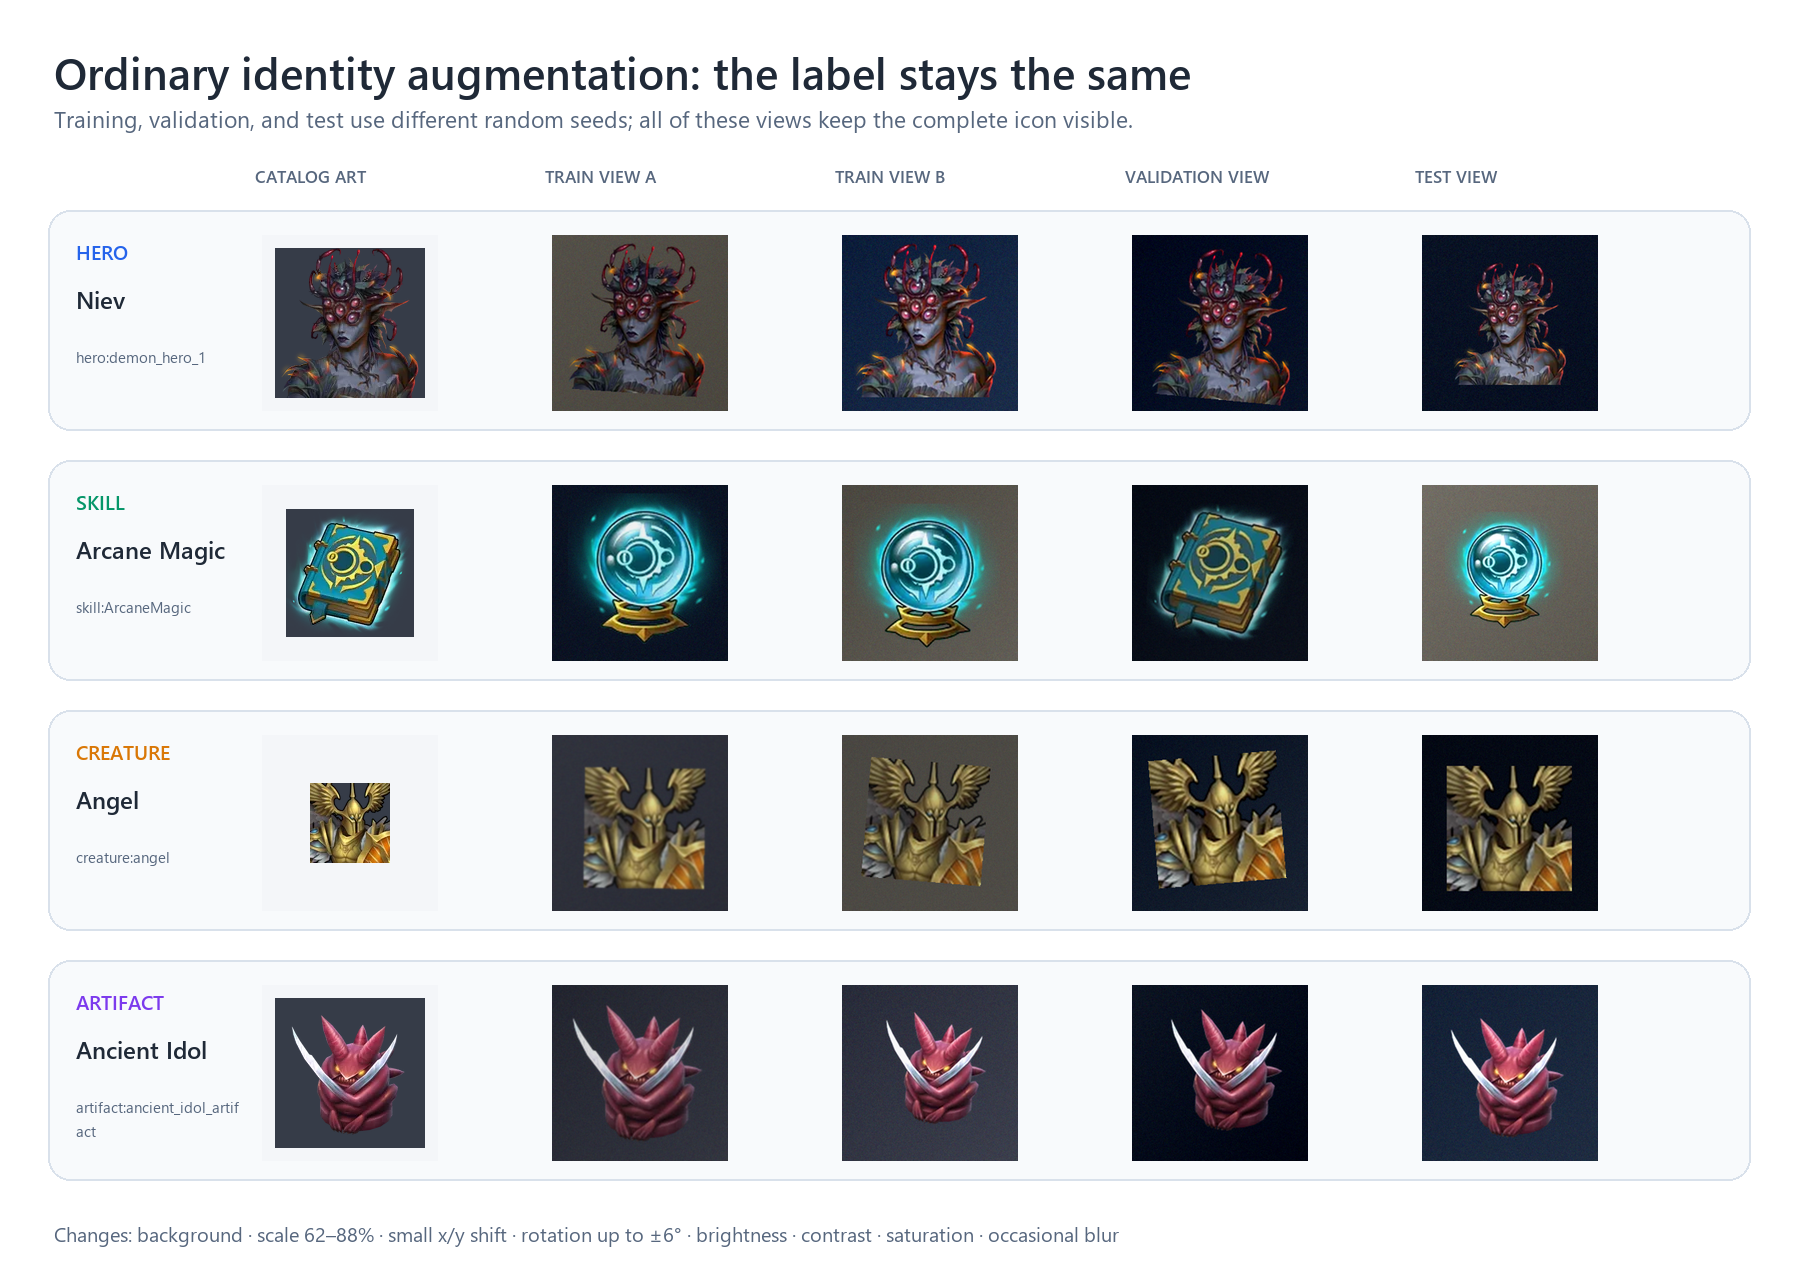
The ID-trained and multi-task models train for twelve epochs. In every epoch, each identity contributes four independently generated view-pairs; each pair contains two views, and a batch covers 32 identities. Catalog validation uses four fixed views per ID to retain a checkpoint; the catalog synthetic-view test uses six fixed views per ID, for 2,124 test queries. Neither set updates weights. When an ID has several image files, each generated view may start from a different legitimate visual, encouraging cross-variant grouping.
Reproduction details for identity training
Seed 20260824; 224×224 input; all ConvNeXt layers fine-tuned; AdamW for 12 epochs; cosine learning-rate schedule; backbone/head learning rates 1.2×10⁻⁵/4×10−4; weight decay 0.02; gradient clipping at 1.0; label smoothing 0.05. Augmentation places an alpha-cropped icon at 62–88% of a 256-pixel canvas, adds ±3.5% position jitter, optional ±6° rotation, brightness 0.78–1.20, contrast 0.82–1.18, color 0.78–1.22, and optional Gaussian blur radius 0.2–1.1. The best catalog-validation checkpoint is retained.
What augmentation is trying to teach
Identity augmentation says, “these visual changes should not change who this is.” It therefore encourages the backbone to ignore modest changes in background, brightness, scale, and position. That is good for recognition, but it creates a localization tension: if the model becomes too shift-invariant, a poorly aligned crop can still receive a high identity score.
4. How do A–F change one part of the system at a time?
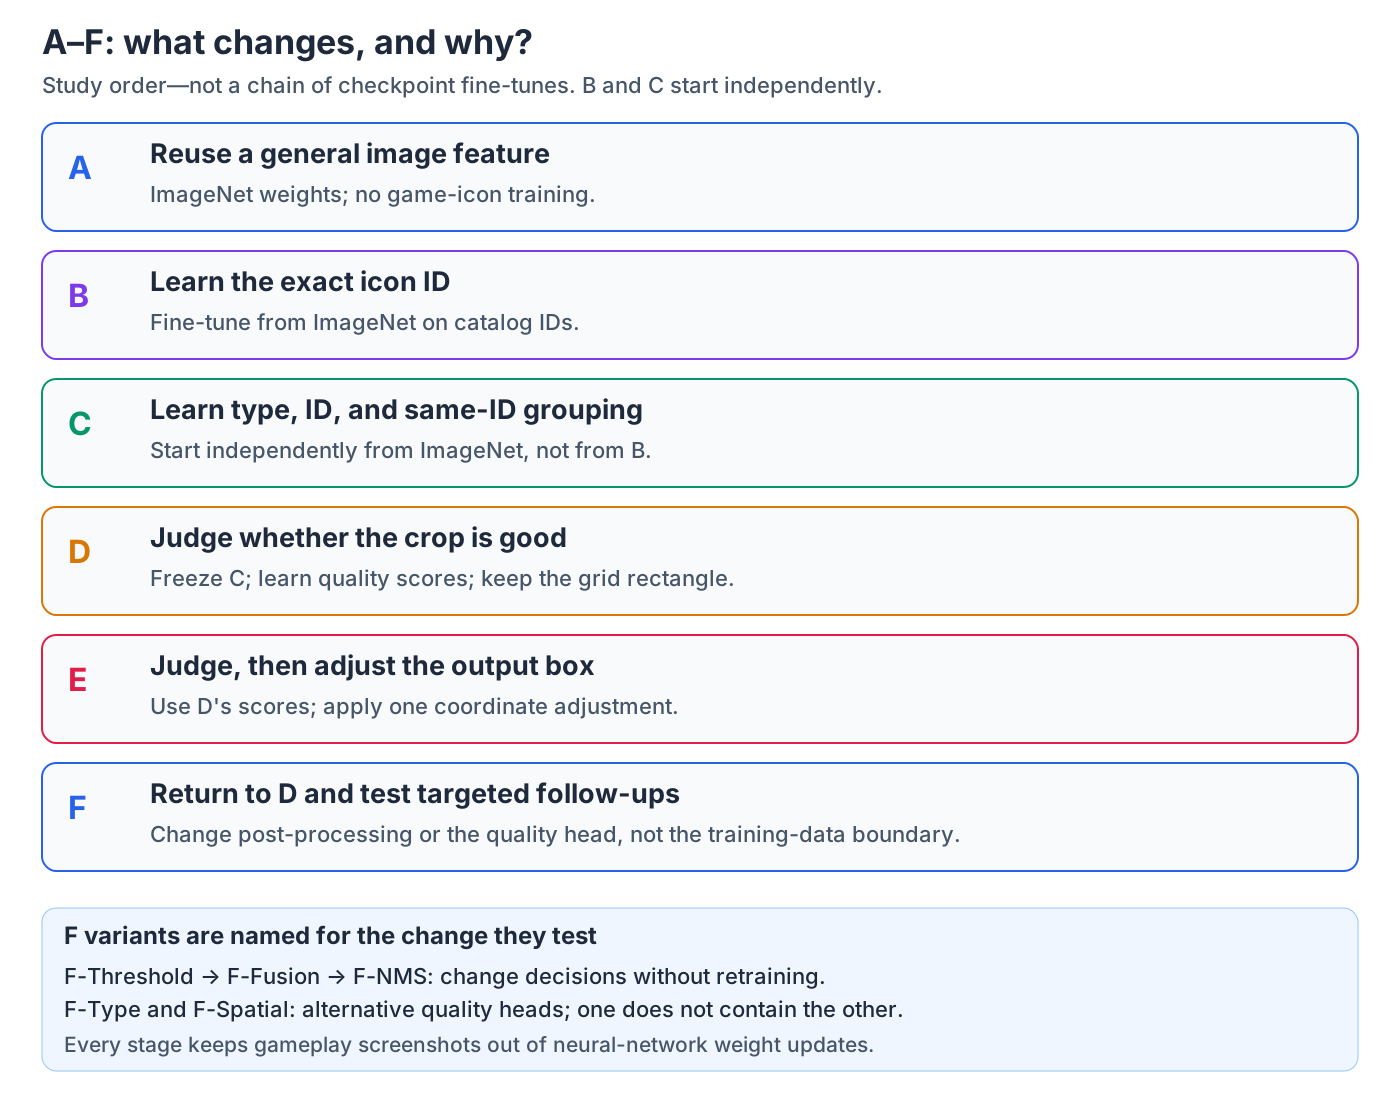
The methods are labeled A–F; these labels are not a single training chain. A, B, and C compare three ways to obtain the identity feature. B and C each start independently from the same ImageNet weights; C does not continue training from B. D freezes C and learns how to score crop quality. E uses exactly the same identity and quality scores as D, then adds one final coordinate adjustment. F returns to D's unchanged grid boxes and contains five targeted follow-ups, each named for the change it tests.
| Stage | What changes | Purpose |
|---|---|---|
| A · General image feature | No game-icon training | Generic baseline |
| B · Learn the exact icon ID | 354-way ID classification | Test ordinary supervised fine-tuning |
| C · Learn type, ID, and grouping | Type + ID + same-ID grouping | Shape the retrieval embedding |
| D · Judge whether the crop is good | Add crop-quality scoring to frozen C | Rerank fixed grid boxes |
| E · Judge and move the box | Apply D's predicted offset once | Test coordinate adjustment |
| F · Diagnose and specialize | Five variants change calibration, NMS, or the quality head | Target D/E's observed failure modes |
Algorithm A — Reuse a general image feature
A is the starting point. It uses torchvision 0.28.0 convnext_tiny(weights=ConvNeXt_Tiny_Weights.IMAGENET1K_V1) and removes the final 1,000-class linear layer. Inputs use ImageNet mean (0.485, 0.456, 0.406) and standard deviation (0.229, 0.224, 0.225). For any 224×224 crop, features → AdaptiveAvgPool2d(1) → classifier LayerNorm produces the 768-D pre-linear vector, which is L2-normalized.
For a query crop q and a reference icon vector r, the score is cosine similarity:
This is a matched baseline for the methods in this article, not a direct rerun of the first experiment. The model input is now 224×224 rather than 128×128, the catalog has been audited, and the reviewed screen benchmark differs from the earlier seven illustrative frames. Compare A–E within this experiment, not their scores with the earlier qualitative examples.
A receives no game-icon fine-tuning. It tells us how much the generic ImageNet representation already knows. This is essential: without A, a strong-looking result might merely restate what the pretrained network could already do.
Algorithm B — Train the feature to recognize 354 icon IDs
B starts from the same weights but adds one 354-way classification head and fine-tunes on the labeled icons. The training target is ordinary cross-entropy: raise the logit of the correct ID and lower the others. After training, the ID head is discarded and retrieval again uses the normalized 768-D penultimate representation.
B is the cleanest answer to “does training over icons and labels help?” It does. Augmentation MAP@R rises from 0.8995 to 0.9954, and real-screen F1 rises from 0.5161 to 0.6111. B is also scientifically important because it prevents us from crediting every C gain to the more elaborate losses.
Algorithm C — Train type, ID, and same-ID grouping together
C attaches three training outputs to the same backbone representation:
768-D shared representation r
 ├─ 4-way type head: Hero / Main Skill / Creature / Artifact
 ├─ 354-way global-ID head
 └─ 128-D projection head used only by supervised contrastive loss
The total objective is:
Cross-entropy answers “which label?” The type head supplies a coarse semantic signal. Supervised contrastive loss directly shapes the geometry of the representation. Its temperature 0.07 controls how sharply the loss emphasizes the closest competing samples; it is a scale parameter, not an accuracy threshold.
The type and ID predictions count as jointly correct only when both match. The multi-task model reaches 1.000 type accuracy, 1.000 ID accuracy, and 1.000 joint accuracy on 2,124 newly generated test views whose exact random seeds were not used for training. The small projection head is discarded after training; the detector still uses the full backbone's normalized 768-D feature.
C's MAP@R is 0.9945, slightly below B's 0.9954. That tiny ordering means the extra losses did not improve this already-saturated synthetic retrieval metric. Yet C's screen F1 is 0.6486, above B's 0.6111. Different downstream behavior can improve even when a nearly saturated proxy metric moves sideways.
5. How do D and E learn whether a crop is good?
The first three algorithms learn which icon is present, but a recognizable crop can still be shifted or incomplete. Algorithm D learns a second question: “How well does this proposed box overlap the generated truth box?” The training code places one catalog icon on a 320×320 generated background and cuts out a candidate square. Because the code knows where it placed the icon, it can calculate the correct box and overlap automatically.
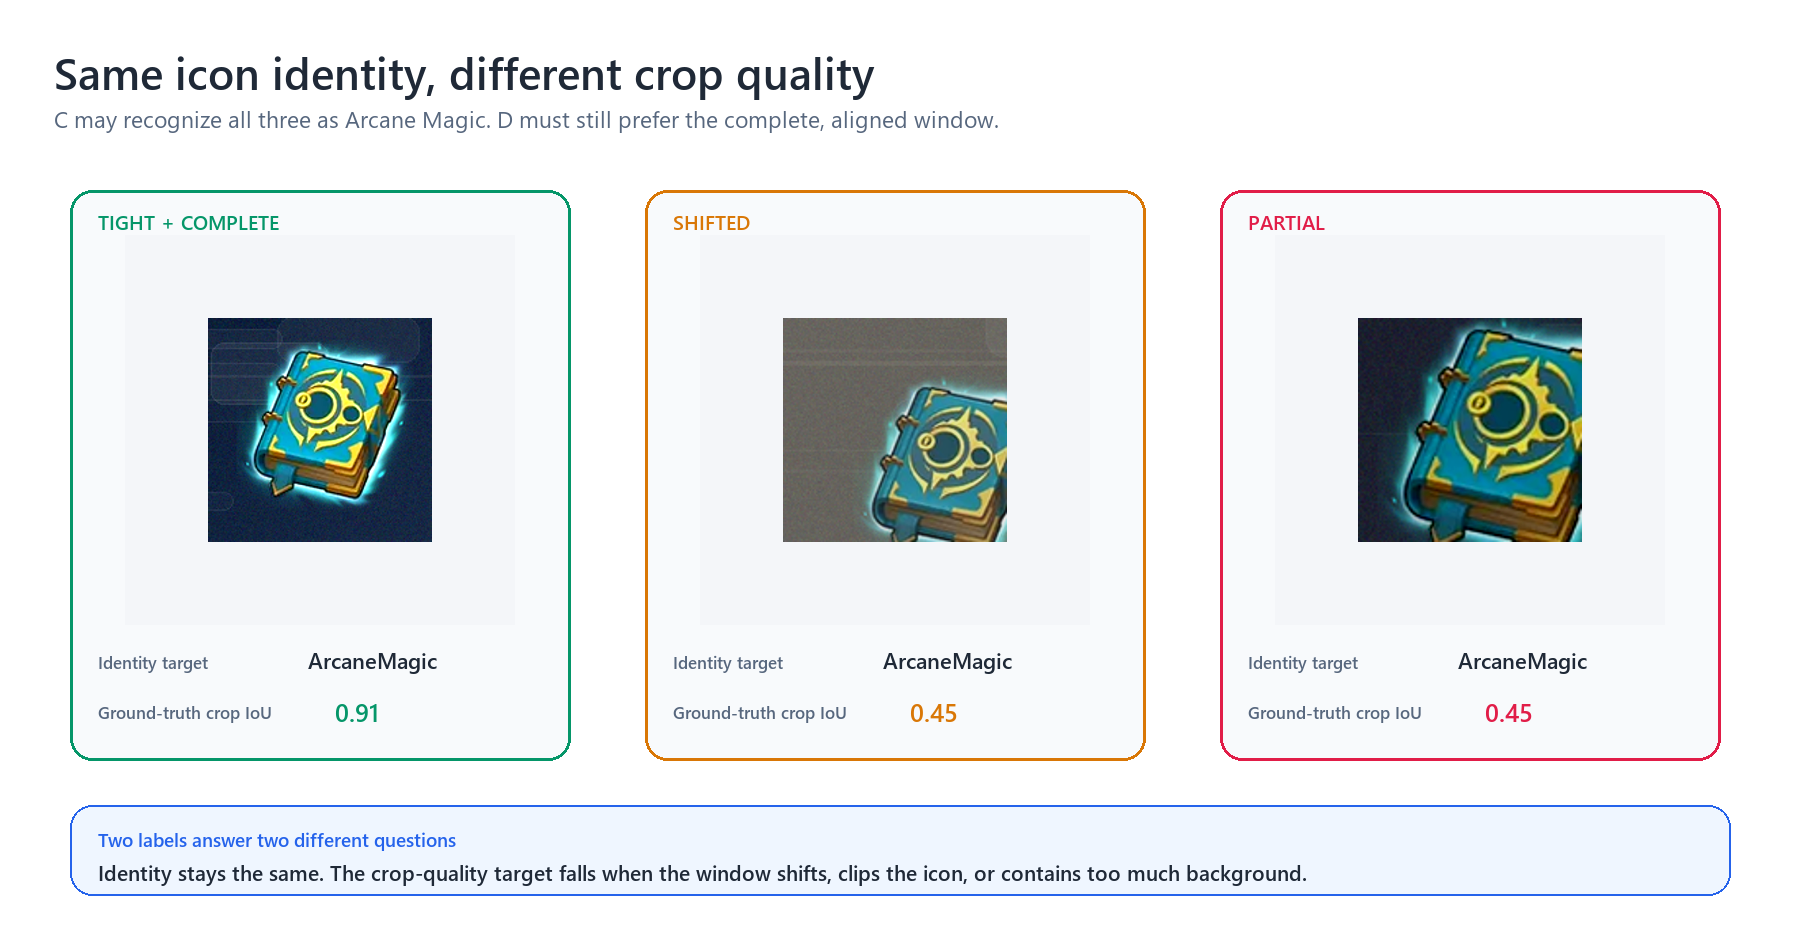
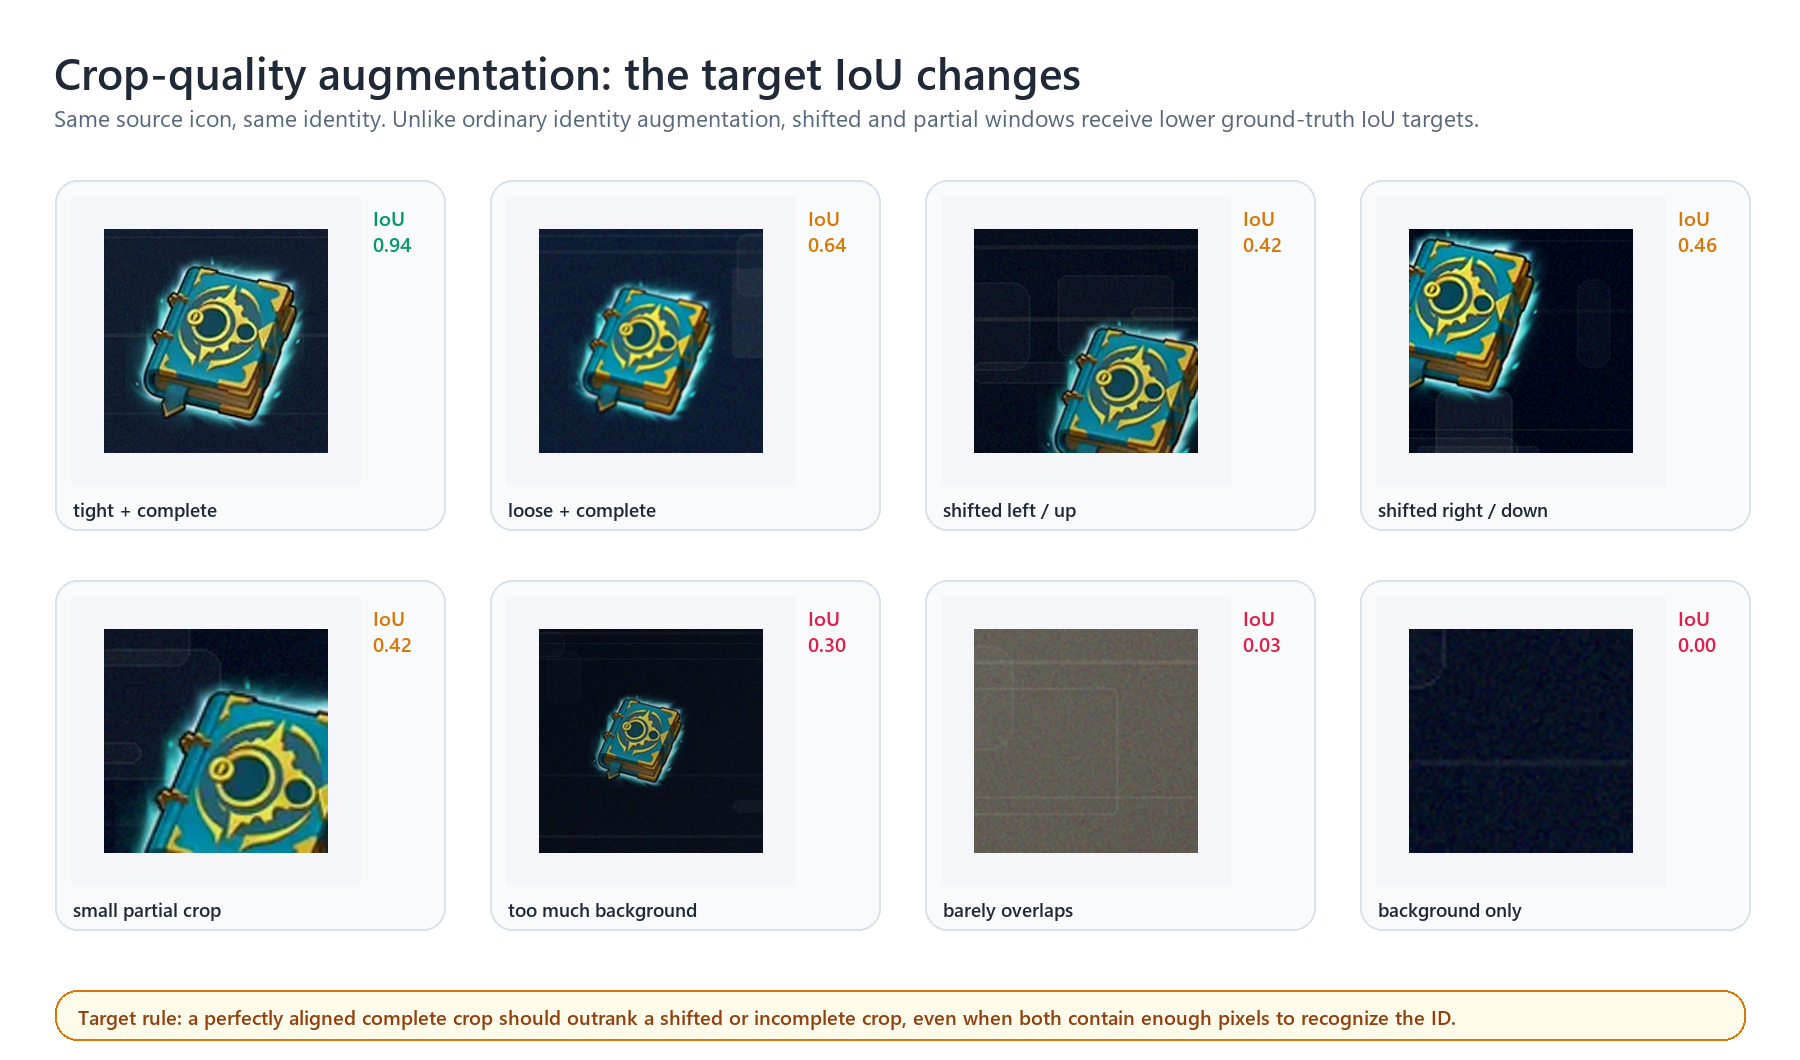
For each of 390 catalog image files, this stage uses 16 weight-updating training crops, 8 catalog-derived crop-validation crops, and 8 catalog synthetic-test crops. Because there are eight families, catalog crop validation and catalog synthetic test contain each family exactly once per image file: tight complete, loose complete, two shift directions, small partial, oversized with background, barely overlapping, and background only. Split-specific seeds keep the exact pixels disjoint.
Algorithm D freezes C, so identity features no longer change. Its new crop-quality head reads C's 768×7×7 spatial feature map, reduces it to 3×3, and predicts four outputs:
- continuous IoU between proposal and synthetic truth;
- whether IoU is at least 0.50;
- whether IoU is greater than 0.02;
- class-agnostic center and size offsets from the proposal to the truth.
Exact crop-quality head architecture
The 768×7×7 map is pooled to 768×3×3 and flattened to 6,912 values. A LayerNorm → Linear(6912,256) → GELU → Dropout(0.10) → Linear(256,96) → GELU trunk feeds the four output layers.
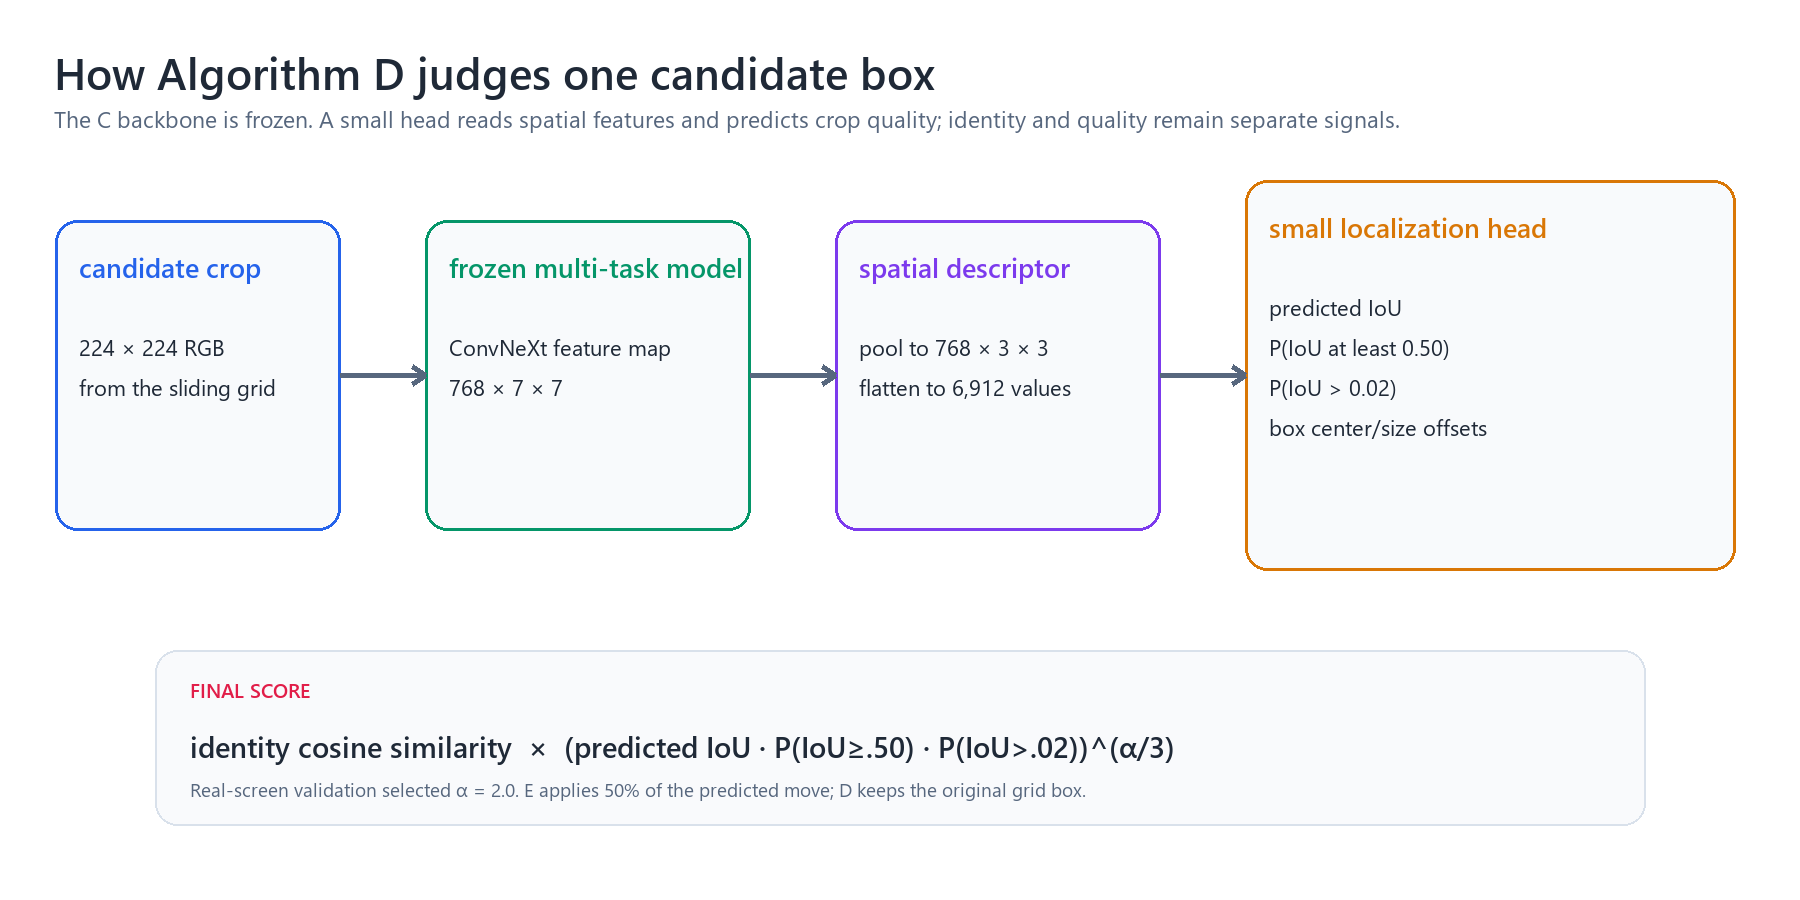
The synthetic-test results show that this head learned its generated task: IoU MAE 0.0485, IoU rank correlation 0.9547, IoU≥0.50 AUROC 0.9622, and IoU>0.02 AUROC 0.9963. AUROC is threshold-free. Spearman correlation measures ordering rather than exact calibration.
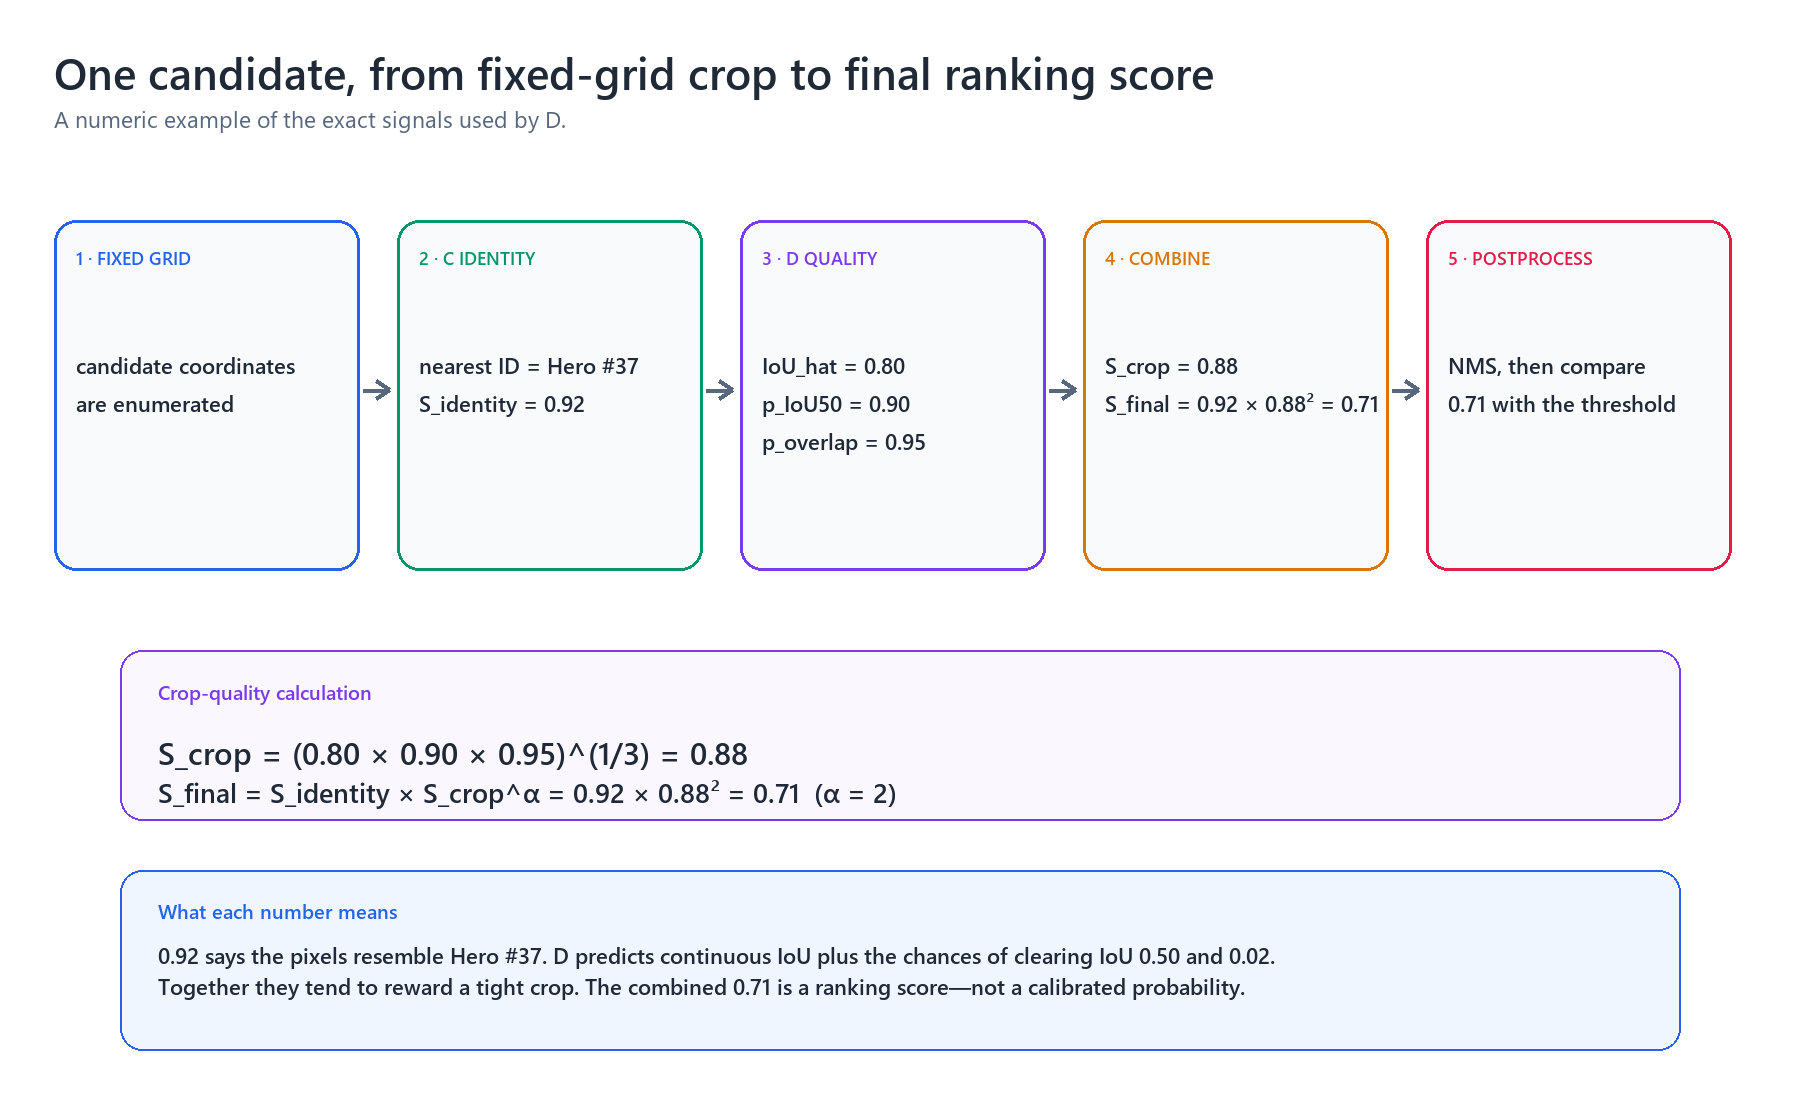
The head predicts three related synthetic targets. IoU_hat estimates the proposal–truth IoU; the hat means predicted, not an IoU calculated from test ground truth. p_IoU50 estimates the probability that IoU is at least 0.50. p_overlap estimates the probability that IoU is greater than 0.02. The latter two are thresholded-overlap signals: p_IoU50 is not a literal test that every icon pixel is visible, and p_overlap is not generic objectness. We combine them as follows:
Sfinal = Sidentity × Scropα
S_crop is not itself an IoU prediction. It is the geometric mean of the three overlap signals, all scaled to [0,1]. Together they tend to favor complete, tightly aligned crops, but their ground-truth definitions are the IoU thresholds above. α controls how strongly this combined crop quality modifies identity similarity. Real-screen validation tried α ∈ {0.25, 0.5, 0.75, 1.0, 1.5, 2.0} and selected 2.0.
Quality near 1
The icon is present, complete, and tightly aligned. Identity evidence is preserved.
Intermediate quality
The correct icon is recognizable but shifted, partial, or surrounded by excess background.
Quality near 0
The window contains mostly background or almost none of the icon, so even a lucky identity match is strongly reduced.
Reproduction details for crop-head training
The frozen descriptors train only this head for 30 epochs with AdamW (learning rate 7×10⁻⁴, weight decay 0.02), batch size 128, cosine decay to 10−5, and gradient clipping at 1.0. The loss is 2.0×Smooth-L1(sigmoid IoU) + 1.0×weighted BCE(IoU≥0.50) + 0.5×weighted BCE(IoU>0.02) + 0.75×Smooth-L1(box offsets for IoU≥0.10). Catalog-derived crop validation selects the checkpoint by IoU≥0.50 AUROC, then IoU rank correlation, then IoU MAE.
S_crop only to reorder the original grid boxes; it never moves or regenerates them. Reranker + box adjustment (E) also moves each reported box using 50% of the predicted offset selected on real-screen validation. This separates “choose a better existing window” from “regress a more accurate rectangle.”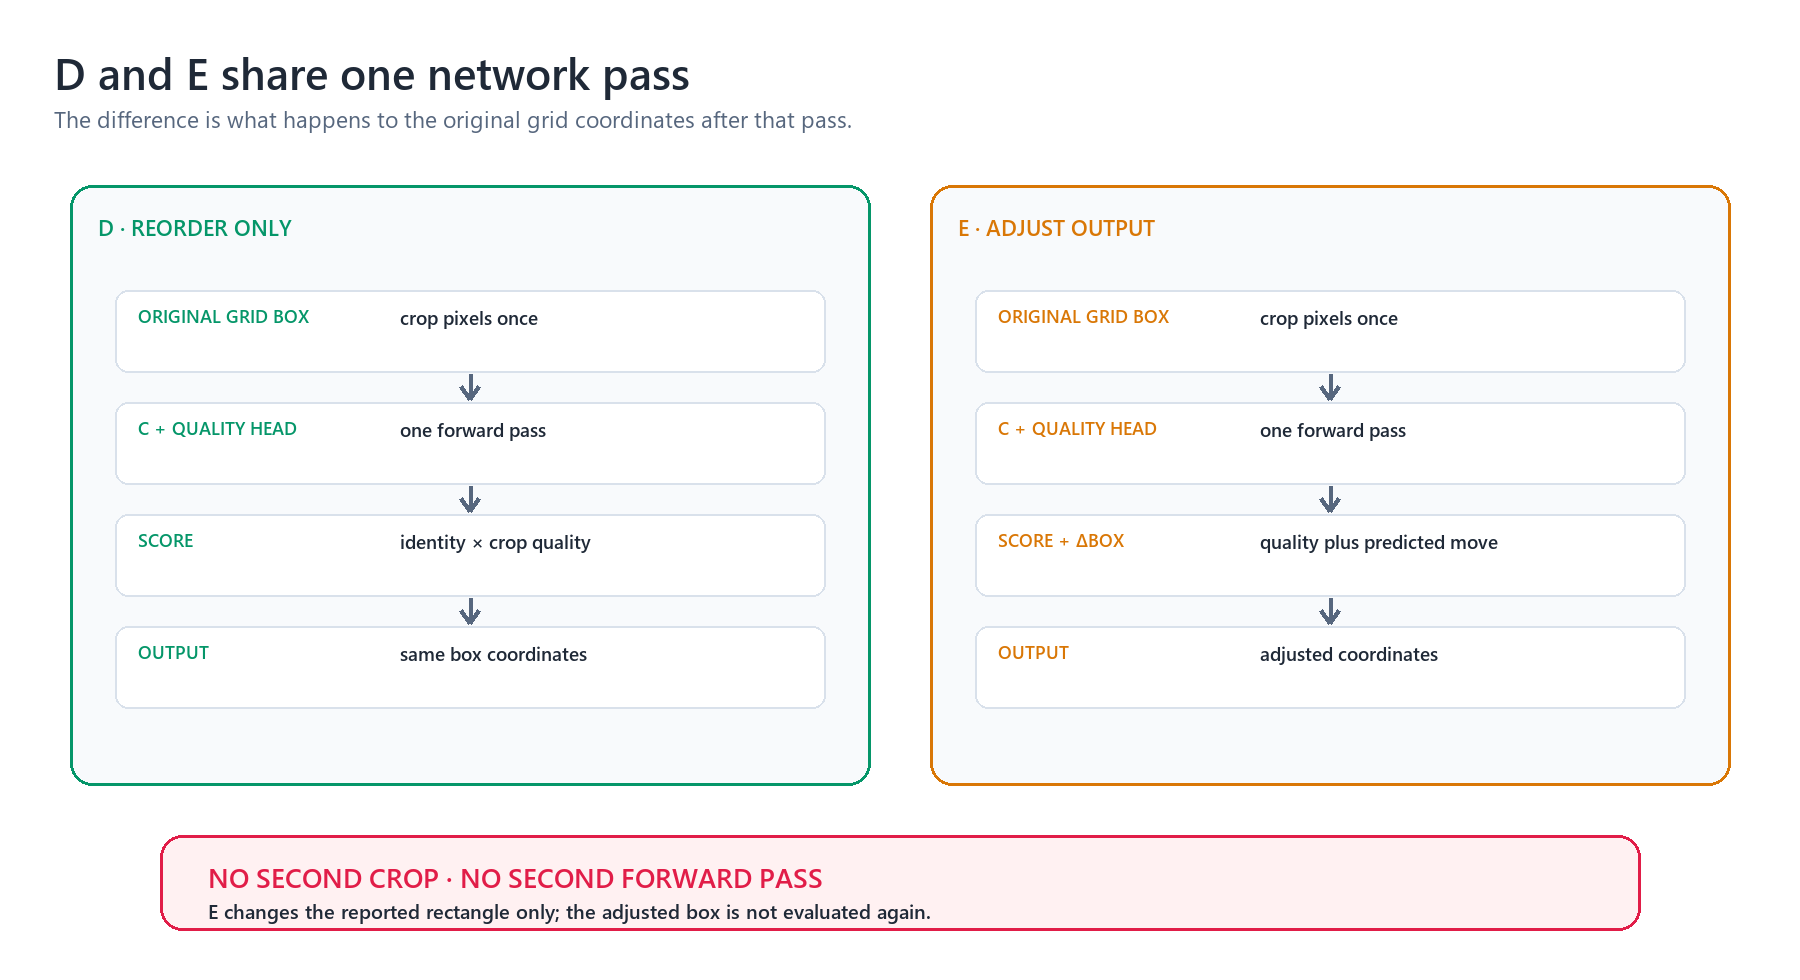
6. How does the program search a complete screenshot?
The detector does not use pixel template matching. Template matching would compare raw aligned colors and be fragile to scale, background, and visual effects. Here the program enumerates many square candidate boxes, resizes each crop to 224×224, encodes it, and compares its vector to the reference bank.
Why only these windows? These selection screens constrain icon sizes to a narrow range. Rather than enumerate every possible rectangle, the program tries several plausible square sizes at regular positions. This UI prior reduces the search to tens of thousands of predefined windows, but it also quantizes location and shape. This report evaluates detection quality; it does not establish real-time or interactive runtime.
- Use the requested type. A hero request selects the hero grid and restricts retrieval to the 77 hero IDs; a main-skill request selects the skill grid and restricts retrieval to the 20 Arena skill IDs. C's four-way type head is an auxiliary training objective and is not consulted at runtime.
- Enumerate proposals. Hero search uses five sizes from 128 to 192 pixels with 20-pixel stride, producing 21,193 windows on a 1920×1078 screen. Skill search uses six sizes from 72 to 132 pixels with 16-pixel stride, producing 43,134 windows.
- Retrieve the best ID. Compare the candidate embedding with reference embeddings only for the requested type. When an ID has multiple valid images, keep its best similarity. This produces
S_identity: “how much does this crop resemble the best allowed catalog ID?” It is a ranking similarity, not a calibrated probability. - Apply crop quality in Algorithm D.
S_cropcombines predicted IoU,P(IoU≥0.50), andP(IoU>0.02). D uses it only to reorder existing grid boxes; it does not move or regenerate them. D's final ranking score isS_identity × S_crop^2, with exponent 2 selected on real-screen validation; the later acceptance threshold acts on this combined score. - Remove duplicates. NMS sorts every candidate by the variant's final score, regardless of predicted ID. NMS runs before the acceptance threshold. It keeps the highest score and suppresses any later box with IoU>0.10 against a kept box, stopping at 20 survivors. Two overlapping boxes with different predicted IDs compete and cannot both survive.
- Optionally move output coordinates in Algorithm E. E begins from D's score and applies half of the predicted box offset after the single forward pass. It does not recrop or rescore the adjusted box.
- Accept detections. A real-screen-validation-selected score threshold is frozen for the real-screen engineering-test set, with at most three detections per task-screen.
7. What did A–E achieve before the targeted follow-ups?
Can the model group new appearances of the same icon?
| Model | MAP@R | R-Precision | Precision@1 | Same–different cosine gap |
|---|---|---|---|---|
| A · General image feature | 0.8995 | 0.9035 | 0.9939 | 0.4794 |
| B · Learn the exact icon ID | 0.9954 | 0.9955 | 1.0000 | 0.8621 |
| C · Learn type, ID, and grouping | 0.9945 | 0.9945 | 1.0000 | 0.8524 |
Metric key and protocol. This is a closed-set augmentation-robustness test, not category-level generalization. Each of the 2,124 test views is a query; its own vector is removed, the other 2,123 test views form the gallery, and R=5 because each ID has five other test views. Precision@1 checks only the nearest neighbor. R-Precision measures the fraction of same-ID views in the first R results. MAP@R also rewards putting those relevant views earlier. The cosine gap is mean same-ID similarity minus mean different-ID similarity.
Precision@1 reaches 1.000 for the ID-trained and multi-task embeddings. The ID-trained model wins MAP@R by 0.0009; this is too small and too close to saturation to justify a general superiority claim.
Can Algorithm C predict both the broad type and exact ID?
| Metric | Accuracy |
|---|---|
| Broad type is correct | 1.0000 |
| Exact icon ID is correct | 1.0000 |
| Both type and ID are correct | 1.0000 |
| Predicted type and ID agree | 1.0000 |
“Both correct” requires the four-way type and the 354-way ID to match simultaneously. “Hierarchy consistency” means the predicted coarse type agrees with the catalog type implied by the predicted ID.
Can Algorithm D tell a good crop from a bad one?
| Samples | IoU MAE ↓ | IoU Spearman ↑ | IoU≥0.50 AUROC ↑ | IoU>0.02 AUROC ↑ |
|---|---|---|---|---|
| Crop-aware synthetic-view test | 0.0485 | 0.9547 | 0.9622 | 0.9963 |
IoU MAE is the mean absolute error between predicted and true overlap; lower is better. Spearman measures whether crop-quality ordering is correct. AUROC measures threshold-free separation of positive and negative crops.
What happens on real screenshots?
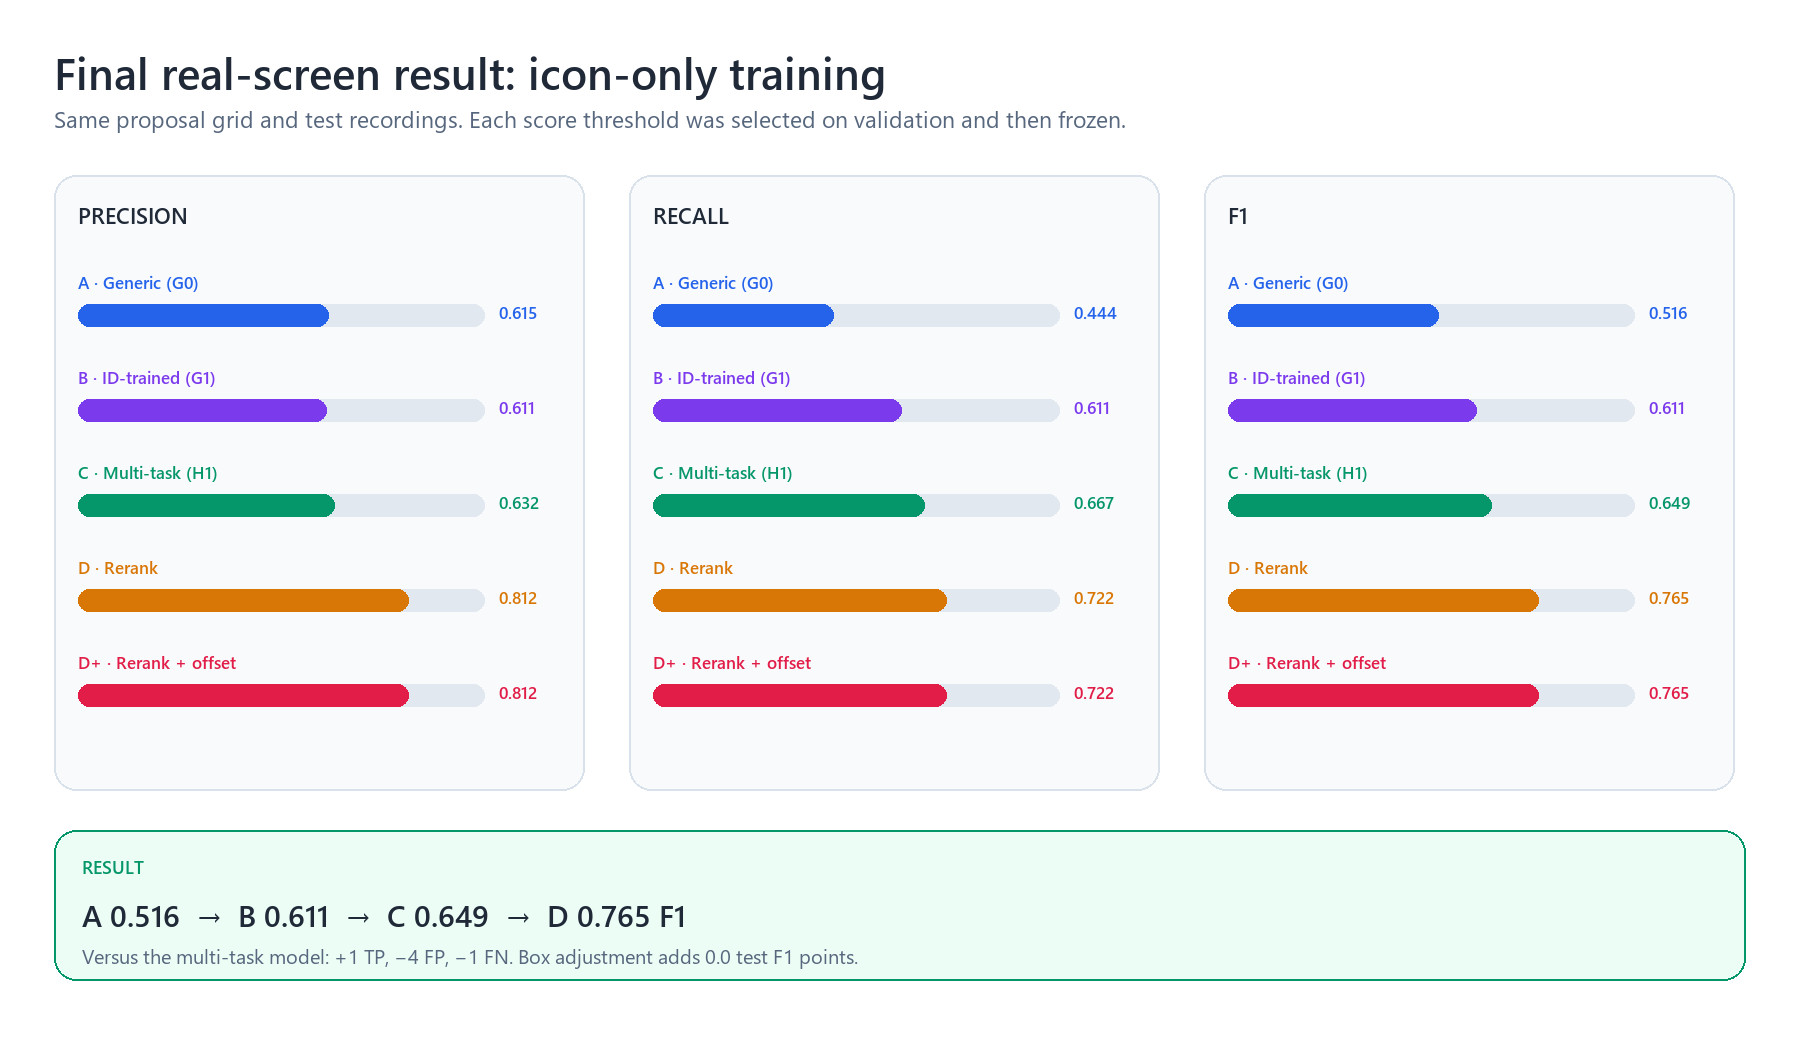
| Model | Precision | Recall | F1 | TP / FP / FN | Accepted negative task-screens |
|---|---|---|---|---|---|
| A · General image feature | 0.6154 | 0.4444 | 0.5161 | 8 / 5 / 10 | 1 / 6 (0.1667) |
| B · Learn the exact icon ID | 0.6111 | 0.6111 | 0.6111 | 11 / 7 / 7 | 3 / 6 (0.5000) |
| C · Learn type, ID, and grouping | 0.6316 | 0.6667 | 0.6486 | 12 / 7 / 6 | 3 / 6 (0.5000) |
| D · Judge whether the crop is good | 0.8125 | 0.7222 | 0.7647 | 13 / 3 / 5 | 3 / 6 (0.5000) |
| E · Judge and move the box | 0.8125 | 0.7222 | 0.7647 | 13 / 3 / 5 | 3 / 6 (0.5000) |
Do not read the ladder as uniform domination. From Algorithm A to C, TP rises from 8 to 12 and FN falls from 10 to 6, but FP also rises from 5 to 7. Algorithm C's improvement is primarily a recall gain; it does not solve false-positive rejection. Algorithm D is the stage that later reduces FP to 3.
Why does box regression tie instead of improve? On real-screen validation, the selected 0.50 scale raises F1 from 0.7222 to 0.7778 and mean correct-ID IoU from 0.5341 to 0.5517. On the development-inspected real-screen engineering-test set, however, it leaves TP/FP/FN unchanged at 13/3/5 and mean correct-ID IoU changes from 0.5270 to 0.5261. Synthetic box geometry did not improve this test reliably.
| Test recording | Hero TP / FN | Main Skill TP / FN | FP on negative tasks | Total TP / FP / FN |
|---|---|---|---|---|
| Recording A | 1 / 2 | 3 / 0 | 2 | 4 / 2 / 2 |
| Recording B | 3 / 0 | 3 / 0 | 1 | 6 / 1 / 0 |
| Recording C | 0 / 3 | 3 / 0 | 0 | 3 / 0 / 3 |
Per-recording counts reveal failure clustering that the aggregate F1 hides: Recording C misses its entire hero screen, while all three skill screens succeed.
8. The F study — Trace five misses, then change the responsible stage
Start with the failure, not with another model
D and E both finish with 13 correct detections, 3 false detections, and 5 missed targets. Before changing the network, the F study traces each miss through the full pipeline: Did the grid create a usable box? Did retrieval assign the correct ID? Did NMS keep it? Did it survive the final threshold?
5 misses = 4 correct-ID boxes rejected by the threshold + 1 wrong-ID failure
This diagnosis rules out “the grid never covered the object” as the main explanation. It motivates two kinds of fixes: first tune the decisions made after scoring; then test alternative crop-quality heads. The per-object evidence is in Section 9.
How the five F variants relate to one another
F is the name of a follow-up study, not one deployable model. The names below describe the change: threshold, score fusion, NMS, type-specific outputs, or spatial layout. F1 denotes the evaluation score, not a method name. F-Threshold, F-Fusion, and F-NMS form a small post-processing sequence. F-Type and F-Spatial then replace the crop-quality head with two alternative designs. F-Spatial does not contain F-Type.
| Step | What changes from the previous step? | Neural weights retrained? | How to read it |
|---|---|---|---|
| D · starting point | One quality exponent, one threshold, class-agnostic NMS | Already trained | Baseline with 5 misses |
| F-Threshold · separate thresholds | Hero and Main Skill acceptance cutoffs | No | Same D scores; only the final accept/reject rule changes |
| F-Fusion · separate score fusion | Hero and Main Skill each get their own quality exponent and threshold | No | Replaces F-Threshold's shared exponent |
| F-NMS · NMS search | Duplicate-removal policy and overlap cutoff | No | Builds on F-Fusion calibration |
| F-Type · duplicate the four final layers by type | Keep D's shared trunk; replace 4 shared output layers with 4 layers for each of 4 icon types | Quality head only | 16 final linear layers total; only the matching type's four are used |
| F-Spatial · preserve 7×7 layout | Alternative spatial quality head that keeps finer feature positions | Quality head only | Alternative to F-Type, not an addition to it |
Group 1 — Change decisions without retraining
F-Threshold · Separate Hero and Main Skill thresholds
Change: validation selects one acceptance cutoff for heroes and another for skills. Kept fixed: D's scores, α=2, grid boxes, and NMS. Observed result: engineering-test F1 rises to 0.842, but negative-screen acceptance also rises from 0.500 to 0.667. The detector finds more targets by becoming less cautious.
F-Fusion · Separate Hero and Main Skill score fusion
Change: validation selects both a quality exponent α and a threshold for each task. A larger α makes crop quality punish recognizable but poorly aligned crops more strongly. Kept fixed: D's shared crop-quality head and original NMS. Observed result: validation and engineering-test F1 both become 0.824, with negative-screen acceptance reduced to 0.333.
F-NMS · Search the NMS rule
Change: starting from F-Fusion's calibration, validation compares class-agnostic NMS with same-ID NMS and several overlap cutoffs. Observed result: validation chooses the original class-agnostic rule at IoU 0.10, so F-NMS exactly matches F-Fusion. Changing duplicate removal did not improve this validation comparison.
Group 2 — Retrain only the crop-quality head (F-Type and F-Spatial)
F-Type · Duplicate the four final output layers for each icon type
D first sends every crop through the same large quality trunk, which converts a 6,912-value crop descriptor into one 96-value hidden vector. After that shared trunk, D has exactly four learned output layers: (1) predicted IoU, (2) P(IoU≥0.50), (3) P(overlap), and (4) four box-regression offsets. The same four layers—and therefore the same four sets of weights—serve heroes, skills, creatures, and artifacts.
shared trunk
└─ 4 shared output layers: IoU · P(IoU≥0.50) · P(overlap) · box offsets
F-Type
shared trunk
├─ Hero: 4 output layers
├─ Main Skill: 4 output layers
├─ Creature: 4 output layers
└─ Artifact: 4 output layers
F-Type leaves the shared trunk unchanged. It only makes four copies of D's final group: one group for each icon type. A hero crop uses the hero group's four layers; a skill crop uses the skill group; and so on. The number of final linear layers therefore increases from 4 to 16. The output seen by the rest of the detector does not change: each crop still produces three scalar scores and one four-number box offset.
Implementation and tensor-shape check
The code uses four ModuleList objects. Each contains four type-specific linear layers: Linear(96,1) for IoU, Linear(96,1) for IoU≥0.50, Linear(96,1) for overlap, and Linear(96,4) for box offsets. For a batch of N crops, the shared trunk returns [N,96]. Before type selection, the scalar heads stack to [N,4,1] and the box heads to [N,4,4]. The known icon-type index selects one row, returning the same public shapes as D: [N], [N], [N], and [N,4]. D has 1,808,903 trainable quality-head parameters; F-Type has 1,810,940, an increase of exactly 2,037 (about 0.11%).
Why try this? A well-aligned hero portrait and a well-aligned book-shaped Main Skill icon may leave different patterns in the 96-value hidden vector. F-Type tests whether the final quality decision should specialize by type while the expensive representation remains shared. Observed result: F-Type has the best validation F1, 0.833, so the predeclared selection rule chooses it. Its engineering-test F1 is 0.800.
F-Spatial · Preserve the full 7×7 spatial feature layout
Change: instead of averaging C's 768×7×7 map down to 3×3, a 1×1 convolution compresses channels and a 3×3 convolution processes the full 7×7 layout. This 222,119-parameter head keeps finer relative positions. Observed result: F-Spatial reaches 17 TP / 3 FP / 1 FN, F1 0.895, on the development-inspected real-screen engineering-test set—heroes 8/9 and skills 9/9. F-Spatial is an alternative to F-Type, and validation did not select it.
Which F variant should we choose?
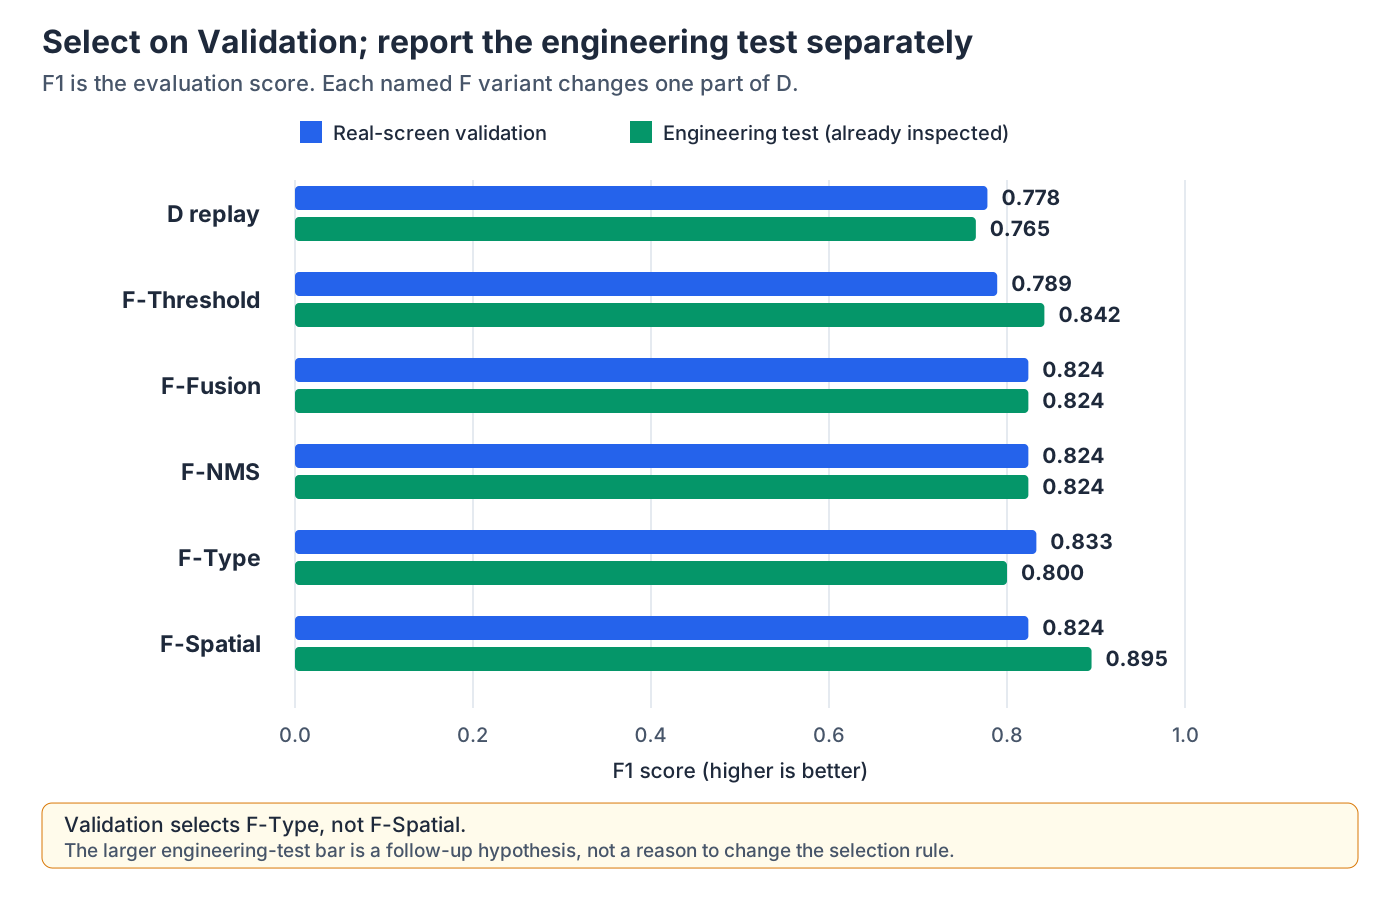
| Variant | Validation TP / FP / FN | Validation F1 | Engineering-test TP / FP / FN | Engineering-test F1 | Engineering-test negative-task acceptance |
|---|---|---|---|---|---|
| D replay · frozen D rerun in the F study | 14 / 4 / 4 | 0.778 | 13 / 3 / 5 | 0.765 | 0.500 |
| F-Threshold · task-specific acceptance thresholds | 15 / 5 / 3 | 0.789 | 16 / 4 / 2 | 0.842 | 0.667 |
| F-Fusion · task-specific score fusion | 14 / 2 / 4 | 0.824 | 14 / 2 / 4 | 0.824 | 0.333 |
| F-NMS · NMS policy sweep | 14 / 2 / 4 | 0.824 | 14 / 2 / 4 | 0.824 | 0.333 |
| F-Type · type-conditioned quality outputs | 15 / 3 / 3 | 0.833 | 14 / 3 / 4 | 0.800 | 0.500 |
| F-Spatial · preserve the 7×7 spatial layout | 14 / 2 / 4 | 0.824 | 17 / 3 / 1 | 0.895 | 0.500 |
9. Exactly where did the five misses happen?
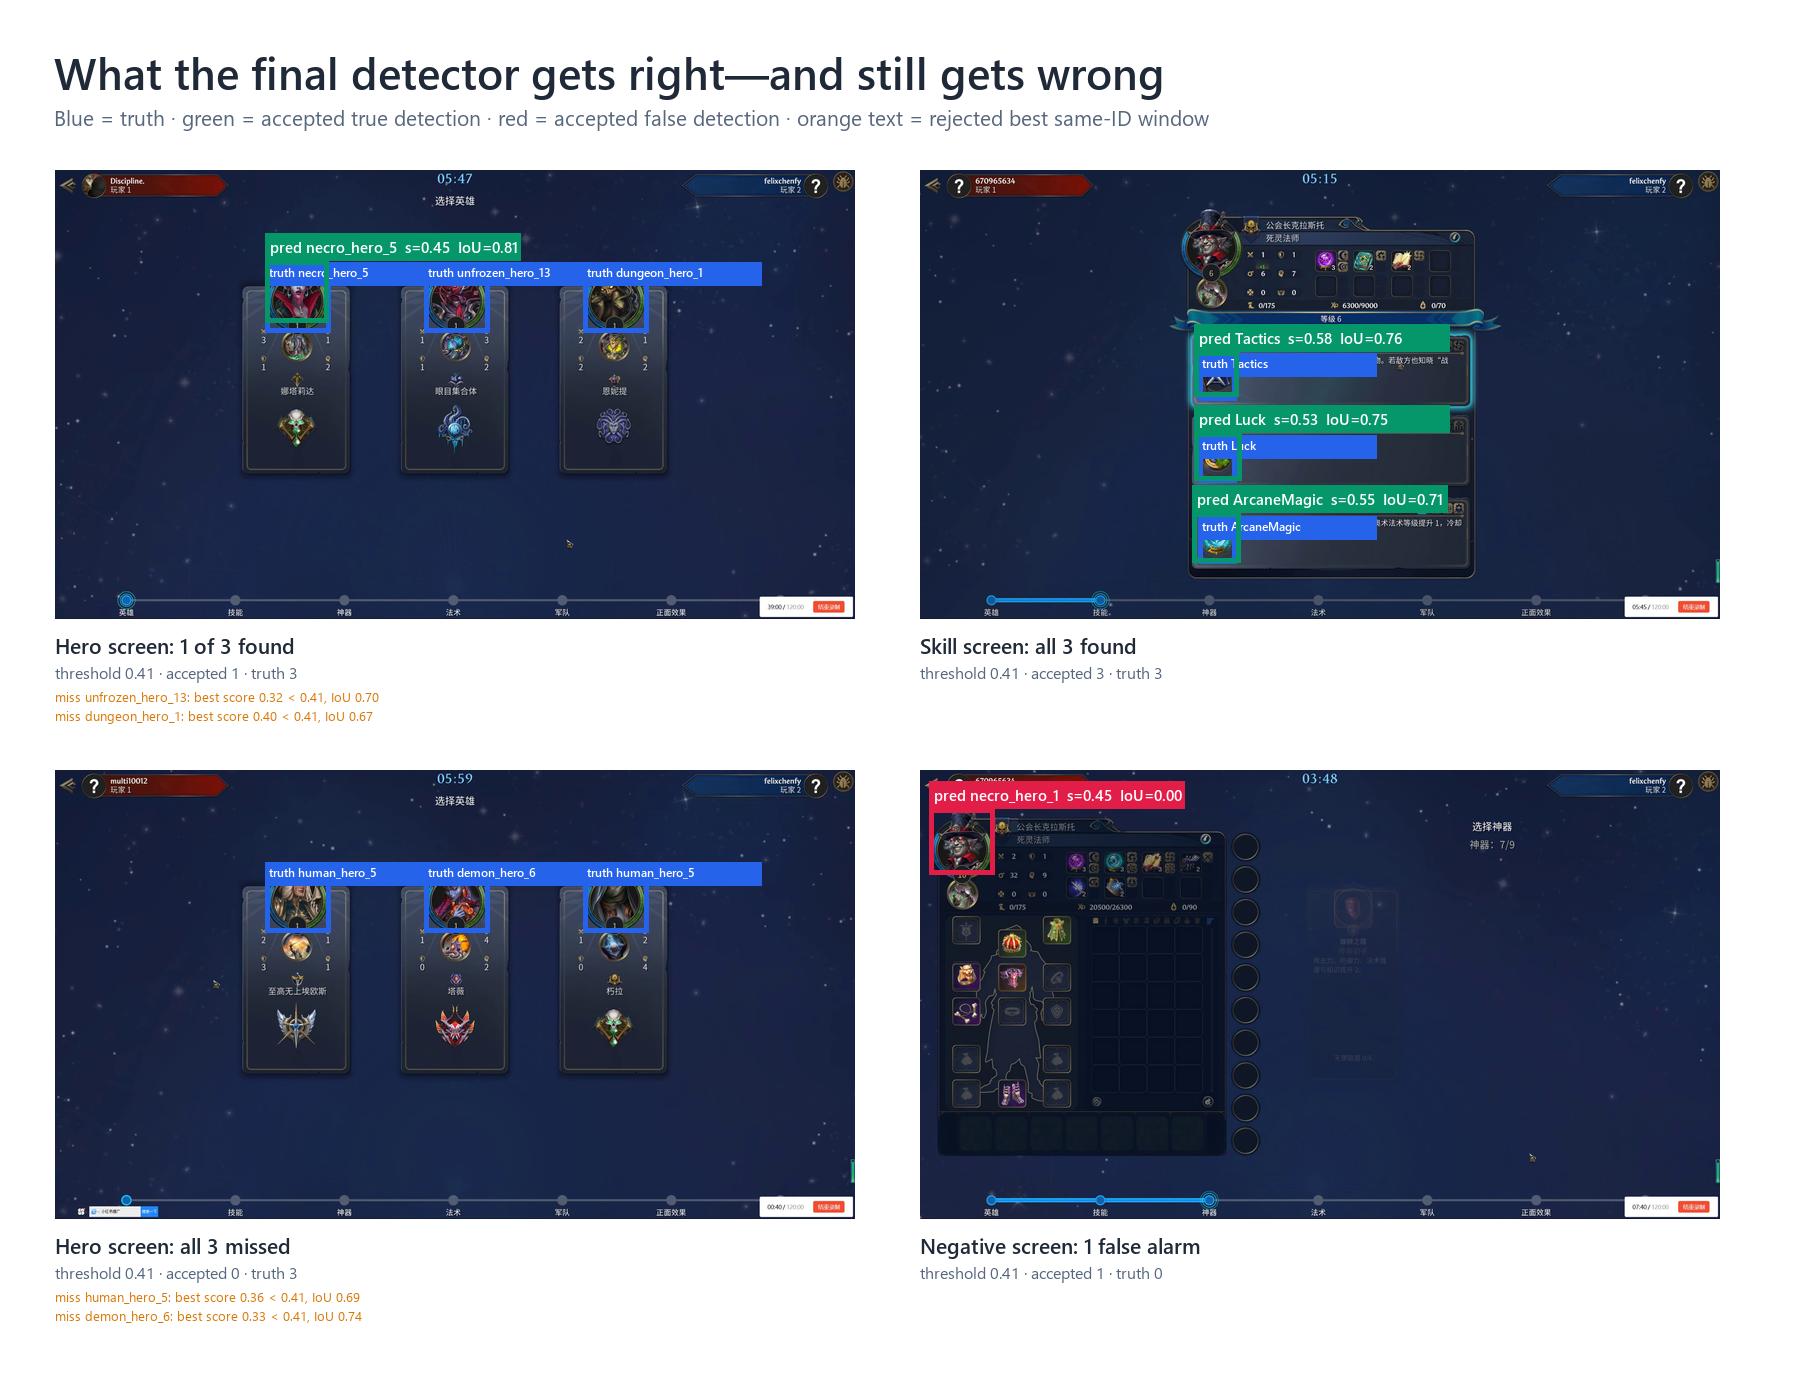
The D/E result is asymmetric. Main skills transfer well: all nine are found. Heroes are the weak point: only four of nine are found. One entire hero screen falls below the frozen threshold, while three false alarms occur on negative task-screens.
Did the fixed grid fail to cover the five missed objects?
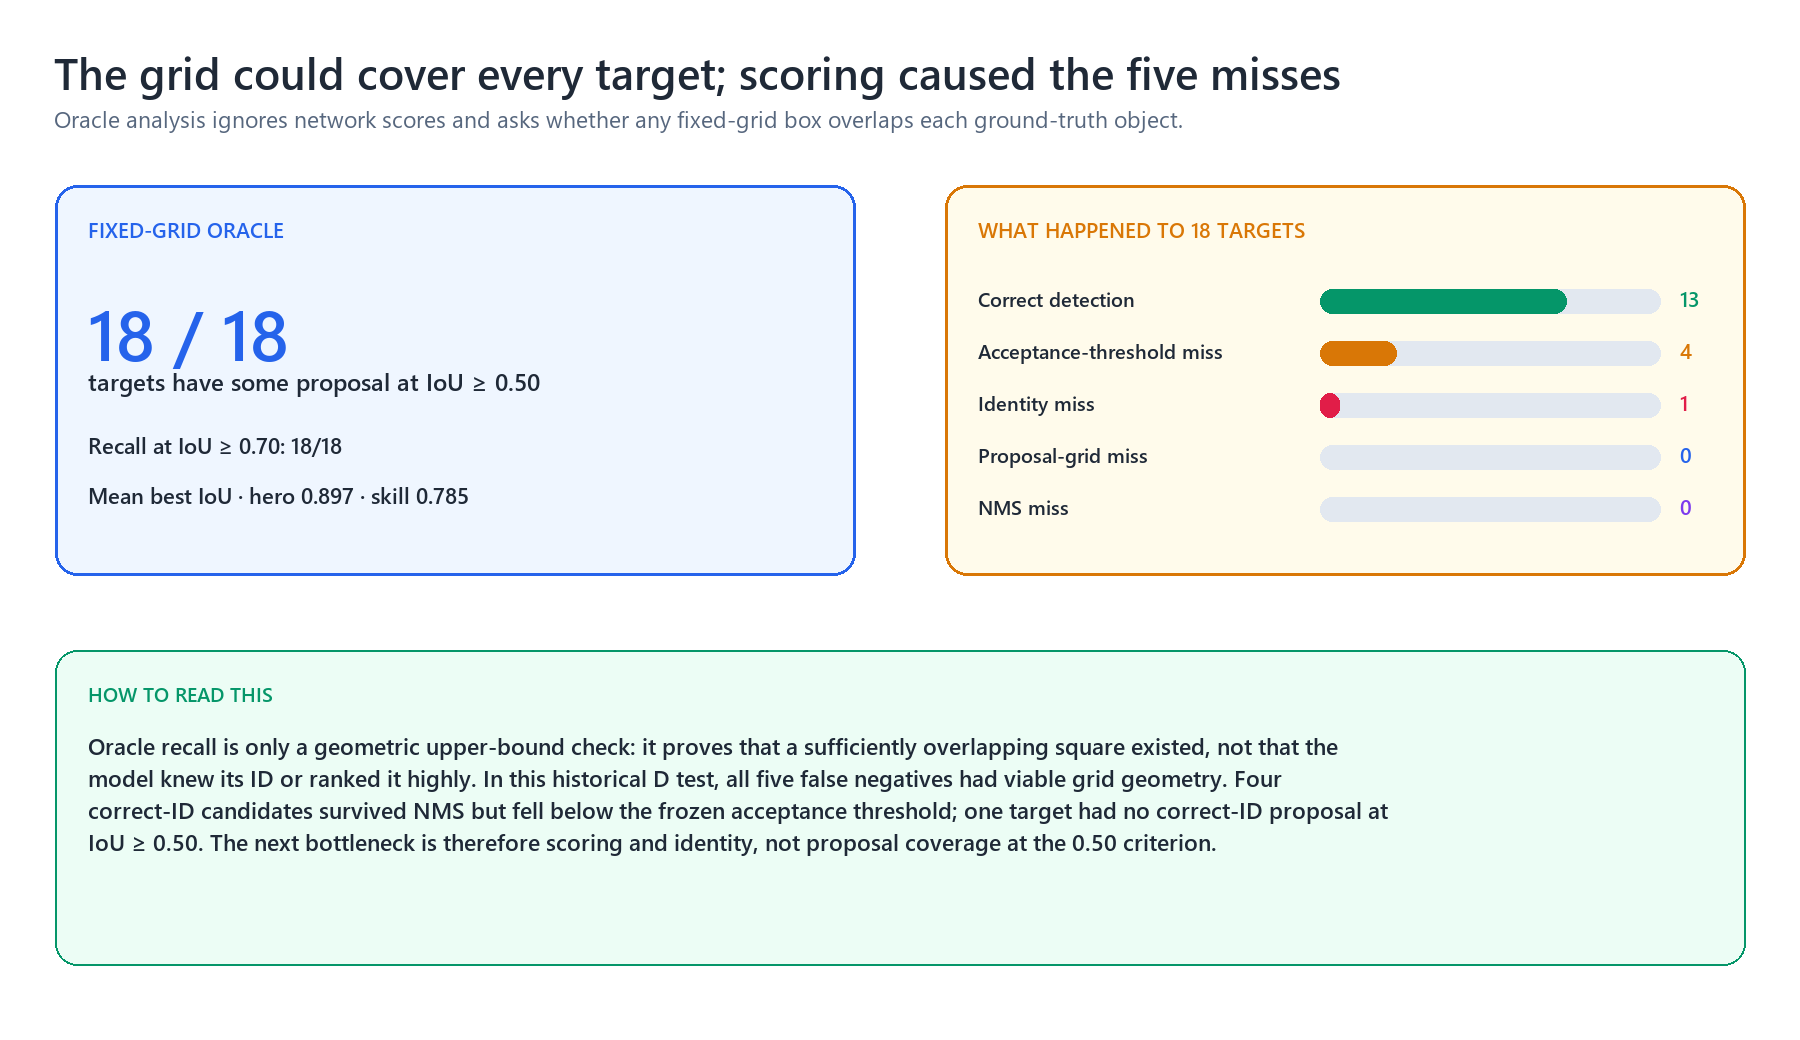
The answer is no at the IoU≥0.50 detection criterion. The fixed grid produced a sufficiently overlapping proposal for 18/18 targets, and 18/18 still had one at IoU≥0.70; mean best-grid IoU was 0.841. Among the five historical D false negatives, four had a correct-ID candidate survive NMS but its final score stayed below the frozen acceptance threshold. The remaining miss was an identity failure: no IoU-qualified proposal received the correct ID.
The model usually knows which icon it sees. All 13 accepted boxes that overlap a labeled object at IoU≥0.50 also have the correct global ID. The four threshold misses explain why F-Threshold and F-Fusion test task-specific calibration; the remaining identity miss explains why F-Spatial can recover only 4/5 old misses. Generated canvases still differ from real hero-selection UI through decorative frames, text, non-square portraits, and complex backgrounds.
10. Why is an older 0.857 result not directly comparable?
An earlier D prototype trained a similar quality head on 3,970 proposals cut directly from gameplay recordings and their real bounding boxes. It reached test F1 0.8571 with TP/FP/FN 15/2/3. This earlier result is useful as a diagnostic comparison: matched real-proposal supervision appears to reduce the remaining domain gap.
The gap between icon-only D (0.765) and the real-proposal prototype (0.857) is consistent with a domain-mismatch explanation. It does not prove that 0.857 will generalize to a larger untouched set, but it shows where additional labeled data would likely buy improvement if the project later relaxes the data constraint.
11. What did we learn, and what should we try next?
- Training on icon labels clearly helps. MAP@R rises from 0.8995 to 0.9954, and screenshot F1 rises from 0.5161 to 0.6111.
- Training type, ID, and grouping together helps on screenshots. F1 rises again to 0.6486, even though the already-near-perfect generated-view metric barely changes.
- Generated good and bad crops help the model choose boxes. Algorithm D reaches 0.7647 F1 without using gameplay screenshots or boxes to update its weights.
- Moving the boxes does not help this engineering test. E improves validation, but ties D on the frozen engineering-test set.
- Algorithm F locates the failures behind these five D misses. Every target has a good grid box; four D misses are threshold calibration and one is identity.
- F-Spatial is promising, not yet proven. Its observed engineering-test F1 is 0.895, while validation selects F-Type. Both require a new sealed test.
If the next experiment must still train only on icons, the remaining options are more realistic procedural UI backgrounds, multi-scale features, and a full detector trained on generated icon placements. If real gameplay crops are allowed later, even a small reviewed set is likely to improve stability.
The next crop-level study relaxes the catalog-only rule and introduces verified gameplay images. It also removes localization by using known UI slots, so its classification accuracy is not directly comparable with this detector's F1 score.
The icon catalog is enough to teach the model the identities very well and to improve hero/skill search on this small screenshot test. It is not enough, with the current generated training images, to guarantee precise boxes and almost no false alarms throughout the game.
12. Plain-language glossary
Key terms above can be hovered with a mouse or focused with the keyboard. This always-visible glossary contains the same ideas.
- Backbone
- The shared visual network that converts pixels into feature maps and embeddings.
- Embedding
- A numeric vector used for similarity search rather than a final class probability.
- Classification head
- A training-time layer that maps the shared representation to class logits.
- Cosine similarity
- Similarity between normalized vector directions; higher means more alike.
- Proposal / sliding window
- A candidate rectangle generated before inference. The crop is the screenshot pixels extracted from it.
- IoU
- Intersection area divided by union area for two rectangles.
- NMS
- A rule that keeps the highest-scoring box and suppresses overlapping duplicates.
- Threshold
- The score cutoff above which a prediction is accepted.
- AUROC
- Threshold-free ranking quality for a binary target.
- MAP@R
- Retrieval metric that evaluates whether all relevant same-ID views rank early.
- Precision / recall / F1
- False-alarm control, miss control, and their harmonic-mean balance.
- Box regression
- Predicting how to move and resize a proposal toward a target box.
Internal reproducibility artifacts retained with the experiment include metrics.json, algorithm-d-e-icon-only-metrics.json, algorithm-f-metrics.json, Algorithm F training histories, raw-grid caches, checkpoints, and source scripts. They are not currently linked from this public page.
概览
滑动窗口图标检测 · 图标库训练的视觉骨干
9 月 3 日进度:下文 A–F 保留历史图标库实验,不混入新的训练结果。后续分别研究了学习式框检测、人工审核后的游戏裁剪分类和标题 OCR。输入与测试集不同,不能把它们的数字当作同一种准确率直接比较。
《英雄无敌:上古纪元》是一款回合制策略游戏。在 Arena 模式中,玩家通过三选一页面组建临时军队,例如选择英雄或主技能。本检测器只得到完整截图,不知道图标槽位的坐标。它既要找到图标的位置,也要认出图标身份。
普通代码用滑动窗口生成候选框,再提取框内的图片。视觉特征提取器,也就是 backbone(视觉骨干),把每张裁剪编码成特征,与已知图标库比较。本实验保留这套搜索方式,改用图标库训练视觉骨干,并单独学习裁剪质量。只有干净图标库和程序生成的图片更新模型权重;游戏截图和人工框不参与权重训练。
这不是常规的学习式目标检测器:最初的矩形由代码生成的网格提供。D 和 F 后续方案只评分,不移动这些框;E 则单独测试使用模型预测的偏移量调整坐标。后面的 A–F 对比会保留这个区别。
这个小型工程 评测集 给出的答案是:图标库训练能让身份识别变得很强,但全屏检测仍然取决于能否选中一个贴合的裁剪,并拒绝背景。加入独立裁剪质量后,结果从 12 个正确 / 7 个误检 / 6 个漏检 提高到 13 个正确 / 3 个误检 / 5 个漏检;同时兼顾误检与漏检的 F1 从 0.649 提高到 0.765。后来一个空间质量 输出分支 在已经看过的工程测试集上更好,但单独用于模型选择的截图选中了另一个方案,所以这个表面提升仍需全新测试。
不需要先记住 A–F。把整篇文章理解成四个问题即可:通用特征能否认出图标?用图标库训练后身份识别是否提高?独立的裁剪质量能否选出更好的框?哪个后期改动能解决剩余漏检?
需要时展开 A–F 方法速查
本实验的所有专用权重都来自 390 张干净图标库图片及程序生成的变化,没有使用游戏截图像素或人工框更新权重。真实截图只负责选择运行参数或报告结果,梯度不会从真实截图传回模型。
展开历史结果摘要;正文会解释分母与限制
1. 系统到底要做什么?
一个 Arena 选择页面可能显示三个英雄,或者三个主技能。主技能是这个专用选择页面上出现的大型能力图标,不是界面其他位置的所有小技能符号。检测器的输入是完整截图以及指定目标家族——英雄或主技能;输出可以是 0–3 个带身份的矩形框。
只有两个条件同时满足才算真阳性(TP):预测身份正确,而且预测框与人工标注框的 IoU 至少为 0.50。被接受的错误结果是误检(FP);没有匹配到的人工目标是漏检(FN)。
矩形框从哪里来?先理解固定网格
与常见的学习式目标检测器不同,本实验中的神经网络不会生成候选框。一个确定性的滑动窗口固定网格(sliding-window grid)先在 1920×1078 截图上枚举 21,193 个英雄方框,或 43,134 个技能方框,然后神经网络才逐一查看裁剪。英雄框每次移动 20 像素,约为 128–192 像素框宽的 10–16%;技能框每次移动 16 像素,约为 72–132 像素框宽的 12–22%。所以 x、y 和尺寸都是离散的,而且当前候选框只允许正方形。
图片尺寸说明:实际验证集和工程测试集的 JPEG 都是 1920×1078,与第一个实验的输入相同。更大的源图片集合中也有 1920×1080 文件,但不是这里报告的验证/测试帧。搜索使用每张图片的实际尺寸,只有候选裁剪才会缩放到 224×224。
身份识别问题
“这个裁剪是哪一个已知图标?”模型把图片变成 embedding,再用余弦相似度找最像的参考图标。
定位问题
“这个候选框是否紧密覆盖图标?”系统需要生成候选框、预测裁剪质量、去重,并用阈值决定是否接受。
下文会反复使用的词
为避免同义词来回切换,下文统一使用“图标 ID”表示具体身份,“候选框”表示网格生成的矩形,“裁剪质量分数 S_crop”表示这个窗口是否完整、贴合。
这个检测器并不知道候选位置的坐标。候选位置只是解释游戏布局的词;程序仍扫描全屏,只知道合理的框尺寸和网格步长。后来的固定裁剪实验才有意改变这个条件:直接使用已知位置,单独测试识别,不再搜索框。
2. “只用图标训练”具体是什么意思?
图标库包含354 个语义身份,由 390 张干净图片表示。一些 Arena 技能有多个合法等级外观,所以图片数大于 ID 数;多出来的图片不是多出来的类别。相比第一个实验的 60 张主技能参考图,审计移除了 Arcane、Daylight、Nightshade 和 Primal Magic 的四张错误卷轴形基础参考图,因此保留 56 张图片,仍对应同样的 20 个主技能身份。本实验还加入了生物和宝物,但没有把魔法(Spell)列为第五类。
| 类别 | 不同 ID 数 | 游戏里的含义 |
|---|---|---|
| 英雄 | 77 | 可选英雄头像 |
| 主技能 | 20 | Arena 主技能;共 56 张合法外观图片 |
| 生物 | 141 | 生物/单位图标 |
| 宝物 | 116 | 宝物或装备图标 |
| 总计 | 354 个 ID | 390 张干净图标库图片 |
代码里的 Skill 在本实验中只表示主技能,不包括子技能或魔法。部分原始图表沿用了这个简写。
审计结果:用于更新 ID 训练、多任务和裁剪感知模型的真实游戏截图像素 = 0;人工标注框 = 0。真实验证/测试截图只用于选择运行参数和评测,不参与反向传播。
程序背景由代码绘制,包括平滑颜色、浅色矩形和线条;它们不是从游戏截图复制的。颜色抖动、缩放、模糊、旋转和合成裁剪会生成新像素,但不会引入新的游戏截图对象。
3. 哪些图片真的训练模型,哪些只负责评测?
全部 354 个图标 ID 都参加训练,因为产品目标就是识别所有已知图标。测试集没有藏起整个 ID,而是使用不同随机种子生成新的背景、缩放、位移、旋转、颜色和模糊组合。换句话说,图标是谁并不新,但它这次出现的样子是新的。
| 数据划分 | 唯一用途 | 更新神经网络权重? |
|---|---|---|
| 图标库训练集(Catalog train) | 反向传播、更新权重 | 是 |
| 图标库验证集(Catalog 验证集) | 只选模型 模型检查点 | 否 |
| 图标库合成测试集 | 只报告合成指标 | 否 |
| 真实截图验证集 | 只选分数融合、接受阈值与框参数 | 否 |
| 真实截图工程测试集 | 只报告冻结后的端到端结果 | 否 |
ID 分类与多任务模型都训练 12 个 epoch。每个 epoch,每个 ID 生成 4 对独立增强视图;每对包含两张图,每个 batch 覆盖 32 个 ID。目录 验证集 为每个 ID 固定生成 4 张图,只用于保留 模型检查点;目录 合成测试 生成 6 张,共 2,124 个查询,只报告合成指标。二者都不更新权重。若一个 ID 有多个合法图片,生成器可以从不同版本起步,从而教模型把它们聚在一起。
身份训练的完整复现参数
随机种子 20260824;输入 224×224;ConvNeXt 所有层都参与 fine-tune;AdamW 训练 12 个 epoch;余弦学习率调度;backbone/输出分支 学习率分别为 1.2×10⁻⁵ 和 4×10⁻⁴;weight decay 0.02;梯度裁剪 1.0;label smoothing 0.05。增强时,图标占 256 像素画布的 62–88%,位置抖动 ±3.5%,可选旋转 ±6°,亮度 0.78–1.20,对比度 0.82–1.18,颜色 0.78–1.22,可选高斯模糊半径 0.2–1.1。保留 catalog 验证集 最优 模型检查点。
数据增强想让模型学到什么?
身份增强的含义是:“这些外观变化不应该改变它是谁。”因此 backbone 会学着忽略适度的背景、亮度、尺度和位置变化。这对识别很好,却带来定位上的矛盾:模型如果对位移过于不敏感,一个没有对齐的裁剪仍可能得到很高的身份分数。
4. A–F 怎样每次只改变系统的一个部分?
方法编号为 A–F,但它们不是从头到尾连续训练的一条链。A、B、C 比较三种身份特征;B 和 C 都从同一份 ImageNet 权重独立开始,C 不是接着 B 训练。D 冻结 C,学习裁剪质量评分。E 使用与 D 完全相同的分数,只在最后调整坐标。F 又回到 D 的原始网格框,开展五项针对性后续实验。
| 阶段 | 本阶段改变什么 | 要回答的问题 |
|---|---|---|
| A · 通用图像特征 | 不训练游戏图标 | 通用 baseline 有多好? |
| B · 学会精确图标 ID | 354 类 ID 分类 | 普通监督微调是否有用? |
| C · 学习类别、ID 和聚类 | 类别 + ID + 同 ID 聚拢 | 怎样塑造检索 embedding? |
| D · 判断裁剪是否合格 | 给冻结 C 增加裁剪质量分数 | 能否从固定网格框中选得更好? |
| E · 判断并移动框 | 最后应用一次 D 的预测偏移 | 坐标调整是否有帮助? |
| F · 诊断并专门改进 | 五项 F 方案分别改校准、NMS 或质量预测头 | D/E 的 5 个漏检究竟怎样减少? |
算法 A — 直接复用通用图像特征
A 使用 torchvision 0.28.0 的 convnext_tiny(weights=ConvNeXt_Tiny_Weights.IMAGENET1K_V1),并移除最后的 1,000 类线性分类层。输入使用 ImageNet 均值 (0.485, 0.456, 0.406) 和标准差 (0.229, 0.224, 0.225)。任意 224×224 裁剪依次经过 features → AdaptiveAvgPool2d(1) → classifier LayerNorm,得到线性分类层之前的 768 维向量,再做 L2 归一化。
对于查询向量 q 和参考向量 r,余弦分数是:
A 是本篇各方法的共同对照,不是第一个实验的直接重跑:输入从 128×128 改为 224×224,图标库经过审计,评测也换成了带人工框的截图集,而不是先前七张示例。应当在本实验内部比较 A–E,不要把这些分数与上一篇的定性示例直接比较。
A 不做任何游戏图标 fine-tune。它回答“通用 ImageNet 特征本来就能做多好?”保留这个对照组,才能把后面的提升归因于图标领域学习或裁剪质量学习,而不是更换了整个流程。
算法 B — 训练特征识别 354 个图标 ID
B 从相同权重开始,加一个 354 类分类预测头(classification 输出分支),用带标签图标训练。标准交叉熵(cross-entropy)会提高正确 ID 的 logit、压低错误 ID。训练结束后丢掉分类头,检索仍使用归一化后的 768 维倒数第二层特征。
这是回答“直接用图标和 ID 标签做普通分类是否有帮助?”最干净的实验。答案是有:合成视图 MAP@R 从 0.8995 升到 0.9954,真实画面 F1 从 0.5161 升到 0.6111。
算法 C — 同时训练类别、ID 和同 ID 聚类
C 在同一个 768 维共享特征上连接三个训练输出:
768-D shared representation r
 ├─ 4-way type 输出分支: Hero / Main Skill / Creature / Artifact
 ├─ 354-way global-ID 输出分支
 └─ 128-D projection 输出分支: 只用于 supervised contrastive loss
Cross-entropy 回答“是哪一个标签?”类别头提供粗粒度语义。Supervised contrastive loss 直接改变 embedding 空间的几何结构。Temperature 0.07 控制 loss 对最近竞争样本有多敏感,它不是准确率阈值。
只有类别和 ID 同时正确才算联合正确。多任务模型在 2,124 个固定种子的合成测试视图上,类别准确率、ID 准确率和联合准确率都是 1.000。Projection 输出分支 训练后丢弃,实际使用的 embedding 仍是 backbone 的 768 维特征。
C 的 MAP@R 是 0.9945,比 B 的 0.9954 略低 0.0009,说明这个合成指标已经接近饱和;但真实画面 F1 从 0.6111 升到 0.6486。代理指标几乎不动,不代表下游行为不能改善。
5. D 和 E 怎样学习一个裁剪好不好?
前三个算法主要学习“这是哪个图标”,但一个能认出来的裁剪仍可能偏移或残缺。算法 D 另外学习:“这个候选框与生成真值框重叠得有多好?”训练代码把一张图标库图片放到 320×320 的生成背景上,再裁出一个候选方框。因为代码知道图标放在哪里,所以生成真值框和重叠比例可以自动算出来。
每张图标库图片生成 16 个更新权重的训练裁剪、8 个图标库验证裁剪和 8 个图标库合成测试裁剪。八类分别是:紧贴完整、宽松完整、两个位移方向、小幅残缺、包含过多背景、几乎不重叠和纯背景。不同数据划分使用不同随机种子,精确像素不重合。
算法 D 会冻结 C,因此身份特征不再改变。新的裁剪质量 输出分支 读取 C 的 768×7×7 空间特征图,缩小为 3×3,再分别预测连续 IoU、IoU 是否至少为 0.50、IoU 是否大于 0.02,以及候选框到真值框的中心与尺寸偏移。
裁剪质量 输出分支 的完整网络结构
768×7×7 特征图先 pool 成 768×3×3,再展平成 6,912 个数。随后经过 LayerNorm → Linear(6912,256) → GELU → Dropout(0.10) → Linear(256,96) → GELU,连接四组输出。
在固定种子的合成裁剪测试上,IoU MAE = 0.0485,IoU 排名相关性 = 0.9547,IoU≥0.50 AUROC = 0.9622,IoU>0.02 AUROC = 0.9963。这说明它确实学会了生成器定义的 overlap 任务;能否迁移到游戏画面,仍要看真实画面评测。
这个预测头输出三个相关的合成目标。IoU_hat 估计候选框与生成真值框的 IoU;hat 表示它是模型预测,不是用测试人工标注框算出的真实 IoU。p_IoU50 估计 IoU 至少达到 0.50 的概率;p_overlap 估计 IoU 大于 0.02 的概率。后两者只是“重叠是否超过某个阈值”的信号:p_IoU50 并不严格表示“每个图标像素都完整可见”,p_overlap 也不是通用的物体存在概率(objectness)。定义清楚后再组合:
Sfinal = Sidentity × Scropα
S_crop 本身不是 IoU 预测值,而是三个 overlap 信号在 [0,1] 上的几何平均数。它们通常会让完整、贴合的裁剪排在松散、残缺或空白裁剪之前,但监督标签的准确含义仍是上面的 IoU 阈值。α 控制这个综合质量对身份相似度的影响强度。Real-screen 验证集 尝试 α ∈ {0.25, 0.5, 0.75, 1.0, 1.5, 2.0},最终选择 2.0。
质量接近 1
图标存在、完整,而且候选框贴合。身份相似度基本保留。
中等质量
正确图标仍能认出,但候选框发生位移、裁掉一部分,或包含过多背景。
质量接近 0
窗口几乎只有背景,或只包含极少图标;即使偶然匹配到某个 ID,也会被大幅降分。
裁剪质量 输出分支 的完整训练参数
冻结后的特征只训练这个小 输出分支,共 30 个 epoch;AdamW 学习率 7×10⁻⁴、weight decay 0.02、batch size 128,余弦衰减到 10−5,梯度裁剪 1.0。总损失为:2.0×Smooth-L1(sigmoid IoU) + 1.0×加权 BCE(IoU≥0.50) + 0.5×加权 BCE(IoU>0.02) + 0.75×Smooth-L1(只对 IoU≥0.10 的框偏移)。Catalog 验证集 依次按 IoU≥0.50 AUROC、IoU 排名相关性和 IoU MAE 选择 模型检查点。
S_crop 重新排序原始网格框,不会移动或重新生成框;E 还会应用真实截图验证集选出的 50% 预测位移。这样可以区分“从已有候选框里选得更好”和“直接回归更准的框”。6. 程序怎样搜索一张完整截图?
这个检测器不是原始像素的 template matching。模板匹配会直接比较对齐像素,对尺度、背景和视觉特效很敏感。这里的程序枚举大量方形候选框,把每个裁剪缩放到 224×224,编码成 embedding,再和参考库比较。
为什么只试这些框?这些选择界面把图标尺寸限制在一个较窄范围内。程序不枚举所有可能矩形,而是只在规则位置尝试几种合理的正方形尺寸;这个 UI 先验把搜索缩小到数万个预定义窗口,但也把位置和形状离散化了。本文只评测检测质量,还没有用 latency、显存或吞吐量证明它能实时运行。
- 先使用指定类别。英雄请求选择英雄网格,并把检索范围限制为 77 个英雄 ID;主技能请求选择技能网格,并限制为 20 个 Arena 技能 ID。C 的四分类预测头只在训练中提供辅助监督,运行时不参与决策。
- 生成候选框。英雄任务使用 128–192 像素的 5 种尺寸、20 像素步长;1920×1078 画面上共 21,193 个窗口。技能任务使用 72–132 像素的 6 种尺寸、16 像素步长,共 43,134 个窗口。
- 找最佳 ID。候选 embedding 只与指定类别的参考 embedding 比较;一个 ID 有多个合法图片时取最大相似度。
S_identity回答:“它有多像当前允许范围内最匹配的图标 ID?”它是排序相似度,不是校准后的正确概率。 - 算法 D 加入裁剪质量。
S_crop综合 predicted IoU、P(IoU≥0.50)和P(IoU>0.02)。D 只用它重新排序已有网格框,不移动也不重新生成框。最终排序分数是S_identity × S_crop^2;指数 2 由真实截图验证集选择,之后的接受阈值作用在这个组合分数上。 - 删除重复框。NMS 按当前算法的最终分数对所有候选框排序,不区分预测 ID,而且先于接受阈值运行。它保留最高分框,并删除与任意已保留框 IoU>0.10 的后续框,直到留下 20 个;两个重叠但预测 ID 不同的框也会竞争,不能同时保留。
- 算法 E 可选移动输出坐标。E 从 D 的分数开始,在唯一一次前向推理(forward)之后应用一半预测偏移,不会重新裁剪或重新评分。
- 接受或拒绝。真实截图验证集选择分数阈值;真实截图工程测试集使用冻结值。每个任务-截图对最多返回 3 个检测。
7. 做针对性改进前,A–E 分别做到了什么?
模型能把同一图标的新外观放到一起吗?
| 算法 | MAP@R | R-Precision | Precision@1 | 同 ID 与异 ID cosine 差 |
|---|---|---|---|---|
| A · 通用图像特征 | 0.8995 | 0.9035 | 0.9939 | 0.4794 |
| B · 学会精确图标 ID | 0.9954 | 0.9955 | 1.0000 | 0.8621 |
| C · 学习类别、ID 和聚类 | 0.9945 | 0.9945 | 1.0000 | 0.8524 |
怎么读、怎么算:这是闭集增强鲁棒性测试,不是新类别泛化。2,124 张测试图逐一作为查询;查询自身从图库中移除,其余 2,123 张作为候选。每个 ID 还有 5 张相关测试图,因此 R=5。Precision@1 只看最近邻;R-Precision 看前 5 个结果里有多少是同 ID;MAP@R 还奖励把相关图排得更靠前。Cosine gap 是平均同 ID 相似度减去平均不同 ID 相似度。
算法 C 能同时预测大类和精确 ID 吗?
| 检查内容 | 准确率 |
|---|---|
| 大类正确 | 1.0000 |
| 精确图标 ID 正确 | 1.0000 |
| 大类和 ID 同时正确 | 1.0000 |
| 预测大类与预测 ID 互相一致 | 1.0000 |
“同时正确”要求大类和精确 ID 都匹配。例如,模型不能一边说“这是英雄”,一边给出某个技能 ID。最后一行检查的就是这两个输出是否互相一致。
算法 D 能区分好裁剪和坏裁剪吗?
| 样本 | IoU MAE ↓ | IoU Spearman ↑ | IoU≥0.50 AUROC ↑ | IoU>0.02 AUROC ↑ |
|---|---|---|---|---|
| 裁剪感知合成测试 | 0.0485 | 0.9547 | 0.9622 | 0.9963 |
IoU MAE 是 predicted overlap 与 true overlap 的平均绝对误差,越低越好;Spearman 看排序是否正确;AUROC 衡量不选 threshold 时,positive 是否通常排在 negative 前面。
放到真实游戏截图上会怎样?
| 算法 | Precision | Recall | F1 | TP / FP / FN | 被接受的负截图任务 |
|---|---|---|---|---|---|
| A · 通用图像特征 | 0.6154 | 0.4444 | 0.5161 | 8 / 5 / 10 | 1 / 6(0.1667) |
| B · 学会精确图标 ID | 0.6111 | 0.6111 | 0.6111 | 11 / 7 / 7 | 3 / 6(0.5000) |
| C · 学习类别、ID 和聚类 | 0.6316 | 0.6667 | 0.6486 | 12 / 7 / 6 | 3 / 6(0.5000) |
| D · 判断裁剪是否合格 | 0.8125 | 0.7222 | 0.7647 | 13 / 3 / 5 | 3 / 6(0.5000) |
| E · 判断并移动框 | 0.8125 | 0.7222 | 0.7647 | 13 / 3 / 5 | 3 / 6(0.5000) |
不要把算法阶梯理解成每个指标都单调变好。从算法 A 到 C,TP 从 8 增加到 12、FN 从 10 减少到 6,但 FP 也从 5 增加到 7。算法 C 的提升主要来自召回率,不代表它解决了误检;真正把 FP 降到 3 的是算法 D。
为什么框调整(box adjustment)没有继续提升?在真实截图验证集上,50% 框位移把 F1 从 0.7222 提到 0.7778,正确 ID 的平均 IoU 从 0.5341 提到 0.5517;但在开发过程中已经查看过的真实截图工程测试集上,TP/FP/FN 仍为 13/3/5,平均 IoU 反而从 0.5270 变为 0.5261。合成框的几何规律没有在这个测试集上带来稳定提升。
| 测试录像 | 英雄 TP / FN | 主技能 TP / FN | 负任务误检 | 总计 TP / FP / FN |
|---|---|---|---|---|
| 录像 A | 1 / 2 | 3 / 0 | 2 | 4 / 2 / 2 |
| 录像 B | 3 / 0 | 3 / 0 | 1 | 6 / 1 / 0 |
| 录像 C | 0 / 3 | 3 / 0 | 0 | 3 / 0 / 3 |
分录像计数揭示了总 F1 看不出的失败聚集:录像 C 的整张英雄画面全部漏掉,而三张技能画面都成功。
8. F 实验 — 先追踪 5 个漏检,再修改出错的环节
先找失败原因,不要一上来就换模型
D 和 E 都得到 13 个正确检测、3 个误检和 5 个漏检。F 实验没有直接假设“模型太小”或“grid 太稀”,而是让每个漏检依次通过四项检查:网格有没有生成可用候选框?检索有没有给出正确 ID?NMS 有没有保留它?最终阈值有没有接受它?
5 个漏检 = 4 个正确 ID 框被阈值拒绝 + 1 个 ID 识别错误
因此,主要问题不是“网格根本没有框住目标”。后续改进分成两类:先调整评分之后的决策,再比较新的裁剪质量 输出分支。逐目标证据放在第 9 节。
五项 F 方案到底是什么关系?
F 是一组后续实验的总称,不是一个可以部署的单独模型。下面按改动命名:Threshold 是阈值,Fusion 是分数融合,NMS 是去重规则,Type 是分类别输出,Spatial 是空间布局。F1 只表示评测分数。F-Threshold、F-Fusion、F-NMS 构成一小段后处理改进链;F-Type、F-Spatial 再分别替换裁剪质量 输出分支。F-Spatial 不包含 F-Type。
| 步骤 | 相对上一步改变什么? | 重新训练神经网络权重? | 应该怎样理解 |
|---|---|---|---|
| D · 起点 | 一个质量指数、一个阈值、不区分 ID 的 NMS | 已经训练完成 | 有 5 个漏检的基线 |
| F-Threshold · 分开阈值 | 英雄与技能分别设接受阈值 | 否 | D 的分数不变,只改最终接受/拒绝 |
| F-Fusion · 分开融合分数 | 英雄与技能分别设质量指数和阈值 | 否 | 替代 F-Threshold 共享的质量指数 |
| F-NMS · 搜索 NMS | 去重规则和重叠阈值 | 否 | 建立在 F-Fusion 的校准之上 |
| F-Type · 按类型复制最后四层 | 保留 D 的共享 trunk;把 4 个共享输出层改成 4 种图标各 4 个 | 只训练质量 输出分支 | 最终共有 16 个 linear layer;每张图只使用对应类型的 4 个 |
| F-Spatial · 保留 7×7 布局 | 换成保留更细空间位置的质量 输出分支 | 只训练质量 输出分支 | F-Type 的替代方案,不是叠加在 F-Type 上 |
第一组:不重新训练,只改变决策
F-Threshold · 英雄和主技能分别设阈值
改变:验证集 为英雄和技能分别选择接受阈值。不变:D 的模型分数、α=2、网格框和 NMS。观察结果:工程测试集 F1 提高到 0.842,但负画面接受率也从 0.500 升到 0.667。它找回更多目标的代价是变得不够谨慎。
F-Fusion · 英雄和主技能分别融合分数
改变:验证集 为两类任务分别选择质量指数 α 和阈值。α 越大,裁剪质量越会惩罚“能认出 ID、但框没有对齐”的候选。不变:D 的共享裁剪质量 输出分支 和原始 NMS。观察结果:验证集 与工程测试集 F1 都是 0.824,负画面接受率降到 0.333。
F-NMS · 搜索 NMS 去重规则
改变:从 F-Fusion 的校准出发,验证集 比较不区分 ID 的 NMS、只压制相同 ID 的 NMS,以及多个重叠阈值。观察结果:验证集 仍选择原来的 class-agnostic、IoU=0.10,所以 F-NMS 与 F-Fusion 完全相同。在这次验证集比较中,改变去重规则没有带来提升。
第二组:只重新训练裁剪质量 输出分支(F-Type、F-Spatial)
F-Type · 为每种图标复制最后四个输出层
D 先让所有裁剪通过同一个大型质量 trunk,把 6,912 维裁剪描述压成一个 96 维隐藏向量。共享 trunk 后面只有四个学习出来的输出层:(1) predicted IoU,(2) P(IoU≥0.50),(3) P(overlap),以及 (4) 四个 box-regression offsets。英雄、技能、生物和宝物共用这四个层,也就是共用完全相同的四套权重。
共享 trunk
└─ 4 个共享输出层:IoU · P(IoU≥0.50) · P(overlap) · box offsets
F-Type
共享 trunk
├─ 英雄:4 个输出层
├─ 技能:4 个输出层
├─ 生物:4 个输出层
└─ 宝物:4 个输出层
F-Type 完全不改共享 trunk,只把 D 最后的“四件套”复制四份:每种图标一份。英雄裁剪使用英雄的四层,技能裁剪使用技能的四层,以此类推。因此最终 linear layer 的数量从 4 个变成 16 个。但 detector 后面的接口没有变化:每个裁剪仍然只得到三个标量分数和一组四维 box offset。
实现与 tensor shape 核对
代码里有四个 ModuleList,每个都包含四个按类型区分的 linear layer:IoU 使用 Linear(96,1),IoU≥0.50 使用 Linear(96,1),overlap 使用 Linear(96,1),box offset 使用 Linear(96,4)。一个含 N 张裁剪的 batch 经过共享 trunk 后是 [N,96]。按类型选择之前,三个标量输出分别堆成 [N,4,1],box 输出堆成 [N,4,4];再根据已知图标类型选出一行,恢复成和 D 相同的公开 shape:[N]、[N]、[N]、[N,4]。D 的质量 输出分支 有 1,808,903 个可训练参数;F-Type 有 1,810,940 个,只增加 2,037 个,约 0.11%。
为什么值得尝试?一个对齐良好的英雄头像和一个对齐良好的书本形主技能图标,可能在 96 维隐藏向量里留下不同模式。F-Type 测试的是:昂贵的表示仍然共享,但最后的质量判断是否应该按类型专门化。观察结果:F-Type 的 验证集 F1 最高,为 0.833,因此预先规定的选择规则选中 F-Type;它的工程测试集 F1 是 0.800。
F-Spatial · 保留完整的 7×7 空间布局
改变:不再把 C 的 768×7×7 特征图平均池化成 3×3,而是用 1×1 convolution 压缩 channel,再用 3×3 convolution 处理完整 7×7 布局。这个 222,119 参数的 输出分支 保留了更细的位置关系。观察结果:F-Spatial 在已经查看过的工程测试集上得到 17 TP / 3 FP / 1 FN、F1 0.895;英雄 8/9、技能 9/9。F-Spatial 是 F-Type 的替代方案,而且 验证集 没有选中它。
最后应该选哪一个 F 方案?
| 方案 | Validation TP / FP / FN | Validation F1 | 工程测试集 TP / FP / FN | 工程测试集 F1 | 工程测试集负任务接受率 |
|---|---|---|---|---|---|
| D 重放 · 在 F 研究中重新运行冻结的 D | 14 / 4 / 4 | 0.778 | 13 / 3 / 5 | 0.765 | 0.500 |
| F-Threshold · 英雄/技能分别设接受阈值 | 15 / 5 / 3 | 0.789 | 16 / 4 / 2 | 0.842 | 0.667 |
| F-Fusion · 分任务融合分数 | 14 / 2 / 4 | 0.824 | 14 / 2 / 4 | 0.824 | 0.333 |
| F-NMS · 比较 NMS 去重规则 | 14 / 2 / 4 | 0.824 | 14 / 2 / 4 | 0.824 | 0.333 |
| F-Type · 分类型裁剪质量输出 | 15 / 3 / 3 | 0.833 | 14 / 3 / 4 | 0.800 | 0.500 |
| F-Spatial · 保留 7×7 空间布局 | 14 / 2 / 4 | 0.824 | 17 / 3 / 1 | 0.895 | 0.500 |
9. 5 个漏检到底发生在哪里?
D/E 的结果明显不对称:9 个主技能全部找到,但 9 个英雄只找到 4 个;负任务-截图对上仍有 3 个误检。
固定网格没有覆盖到那 5 个漏检目标吗?
在 IoU≥0.50 的检测标准下,答案是否定的。固定网格为 18/18 个目标都生成了足够重叠的候选框;18/18 个目标甚至有 IoU≥0.70 的候选框,最佳网格框的平均 IoU 是 0.841。算法 D 的 5 个 FN 中,4 个已经有 ID 正确的候选框通过 NMS,但最终分数低于冻结的接受阈值;剩余 1 个是身份识别失败:没有任何 IoU 合格的候选框被判成正确 ID。
13 个达到 IoU≥0.50 的接受框,其图标 ID 全部正确。那 4 个阈值漏检解释了 F-Threshold/F-Fusion 为什么去做分任务校准;剩余 1 个身份错误也解释了 F-Spatial 为什么只能救回旧 5 个漏检中的 4 个。真实英雄界面的边框、文字、非正方形头像和复杂背景仍然与程序生成画布存在 domain gap。
10. 为什么旧的 0.857 结果不能直接比较?
早期 prototype 用真实游戏录像和标注框生成的 3,970 个候选框,训练类似的质量 输出分支,测试 F1 = 0.8571(15 TP / 2 FP / 3 FN)。这个结果可作为诊断性对照:与任务匹配的少量真实候选框监督,似乎能缩小剩余领域差异。
纯图标 D 的 0.765 与真实候选框原型的 0.857 之间存在差距,这与领域不匹配的解释一致;但它不证明 0.857 能推广到更大的全新测试集。
11. 我们学到了什么,下一步该试什么?
- 用图标标签训练明显有帮助。MAP@R 从 0.8995 提到 0.9954,截图 F1 从 0.5161 提到 0.6111。
- 类别、ID 和聚类一起训练,截图 F1 继续升到 0.6486。
- 生成好裁剪和坏裁剪能帮助模型选框。D 不使用游戏截图或人工标注框更新权重,F1 达到 0.7647。
- 移动框没有改善这个工程测试集。E 在 验证集 变好,但在工程测试集与 D 打平。
- F 定位了 D 这五个漏检的出错环节。所有目标都有好 grid 框;4 个漏检是阈值校准,1 个是身份识别。
- F-Spatial 很有希望,但还没被证明稳定。工程测试集 F1=0.895,而 验证集 选中 F-Type;两者都需要新 sealed test。
如果下一项实验仍然只用图标训练,可以继续做更像真实 UI 的程序背景、多尺度特征,或在生成的图标摆放数据上训练完整 detector。以后如果允许少量真实游戏裁剪,一小组经过审核的数据也很可能提高稳定性。
后来的固定裁剪实验放宽了只用图标库训练的限制,加入人工确认的游戏裁剪;同时用已知 UI 位置去掉定位问题。因此,它的分类准确率不能直接与本篇检测器的 F1 分数比较。
图标库足以让模型很好地学会图标 ID,也能明显改善这个小型截图测试中的英雄和技能搜索。但只靠当前图标库和生成数据,还不能保证在所有游戏画面中都给出精确框,并把误检降到接近零。
12. 术语表
- Backbone
- 把像素转换成特征图和 embedding 的共享视觉网络。
- Embedding
- 用于相似度搜索的数值向量,不是最终类别概率。
- Classification 输出分支
- 训练时把共享特征映射成各类别 logit 的最后几层。
- Cosine similarity
- 比较归一化向量的方向;越高通常越相似。
- Proposal / sliding window
- 模型推理前生成的候选矩形坐标;crop 是从该矩形切出的截图像素。
- IoU
- 两个矩形框的交集面积除以并集面积。
- NMS
- 保留高分框并压掉高度重叠重复框的规则。
- Threshold
- 超过这个分数才接受预测的阈值。
- AUROC
- 不固定阈值时,二分类分数的排序质量。
- MAP@R
- 检验同 ID 视图是否整体排在检索结果前面的指标。
- Precision / recall / F1
- 分别关注误检、漏检,以及两者的平衡。
- Box regression
- 预测候选框应该怎样移动和缩放,才能更接近真值框。
实验内部保留了 metrics.json、algorithm-d-e-icon-only-metrics.json、algorithm-f-metrics.json、F 的训练历史、raw-grid cache、模型检查点 和源代码;当前公开页面没有提供下载链接。
Comments