《英雄无敌:上古纪元》的竞技场选择页通常提供三个英雄头像或主技能图标。游戏布局虽然固定,本实验不把位置告诉程序。输入是整张截图,目标是找到并命名三个选择。
这是滑动窗口路线最简单的基线:普通代码枚举矩形并裁出像素,公开预训练视觉模型——骨干或特征提取器——把每张裁图变为向量,再与带标签的干净图鉴比较,输出候选框与身份。不进行游戏专用训练,也不学习预测框位置。
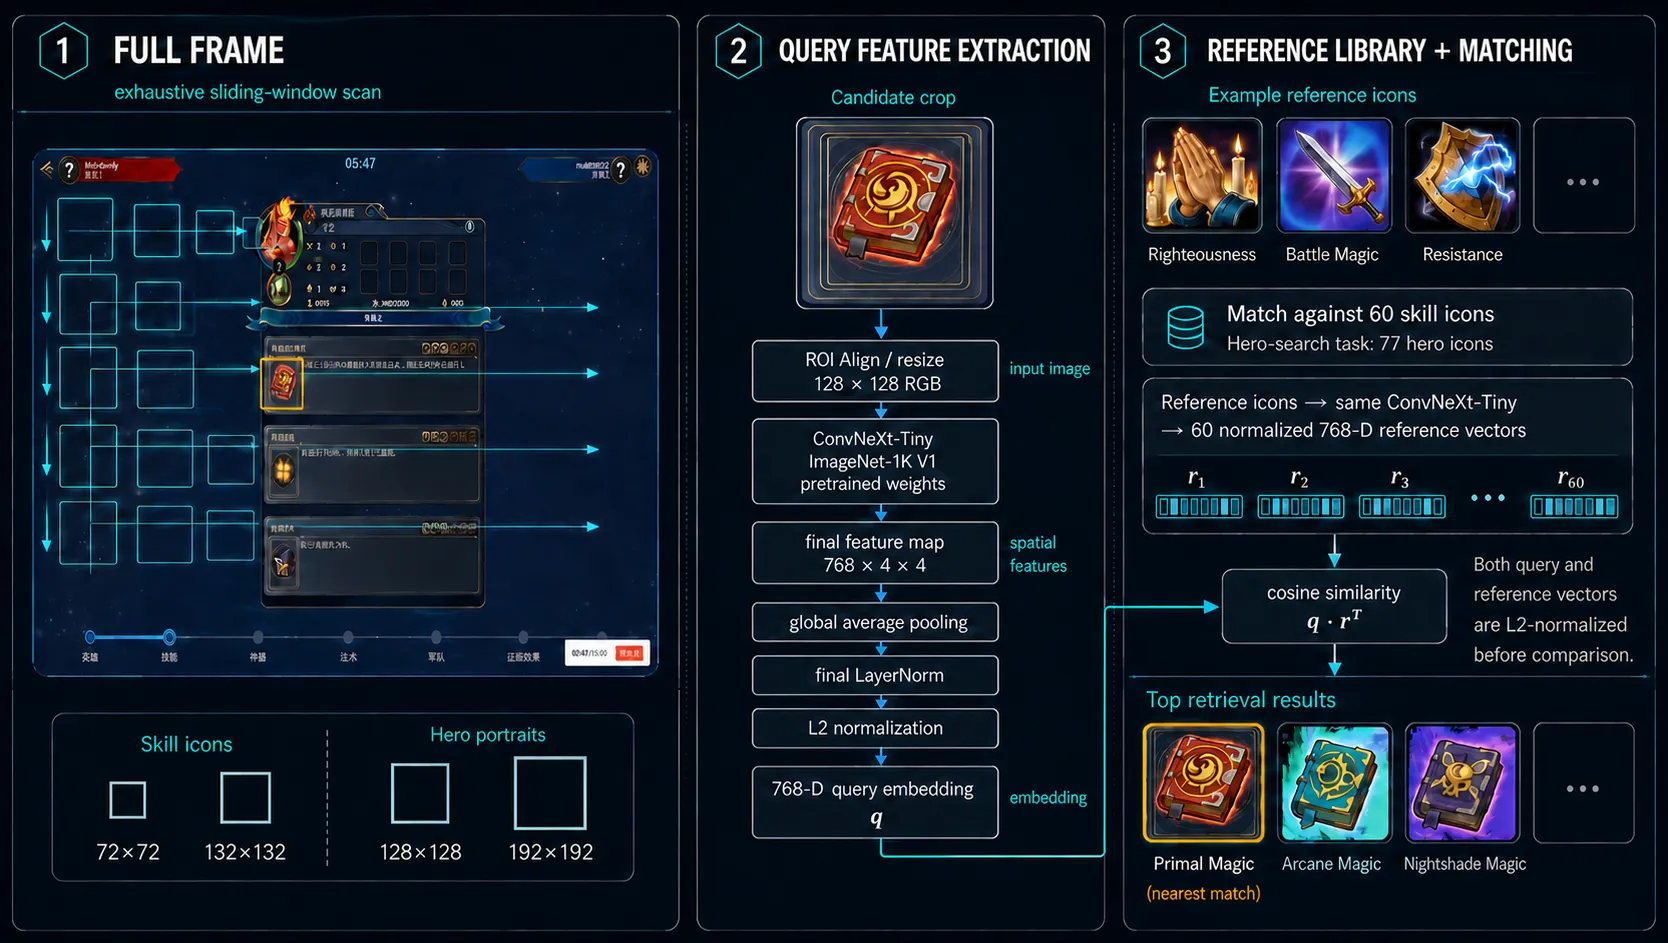
图 1。代码生成矩形,预训练网络提取特征,再检索最相近的已知图鉴。
预期用途是标注初稿:给出三个框和身份,让人快速确认或修正,而非从零画框。检查的七帧中,经常能认对英雄或技能,但不能稳定框紧目标。
这是探索性工程实验,不是准确率基准或生产检测器。七帧太少,也没有完整人工框进行计分,无法估计检测率。
**9 月 3 日项目说明。**本文保留原基线,不把后续运行混入结果。后续分为学习式检测、固定槽位分类与拒识和读取名称。这些解决不同问题,百分比不能放在同一准确率榜单。
1. 输入和目标输出是什么?
输入是一张完整 1920×1078 截图和指定目标类型:Hero 或 Main Skill。主技能指竞技场选择页的大图标,不包括界面中所有小技能图标。程序找三个选择,返回三个矩形,并给每框显示三个最相近的图鉴标签。
候选框是愿意测试的矩形,裁图是其中的截图像素,图鉴是干净参考库:每英雄一个头像,每主技能三个等级美术图。
| 英雄选择输入 | 主技能选择输入 |
|---|---|
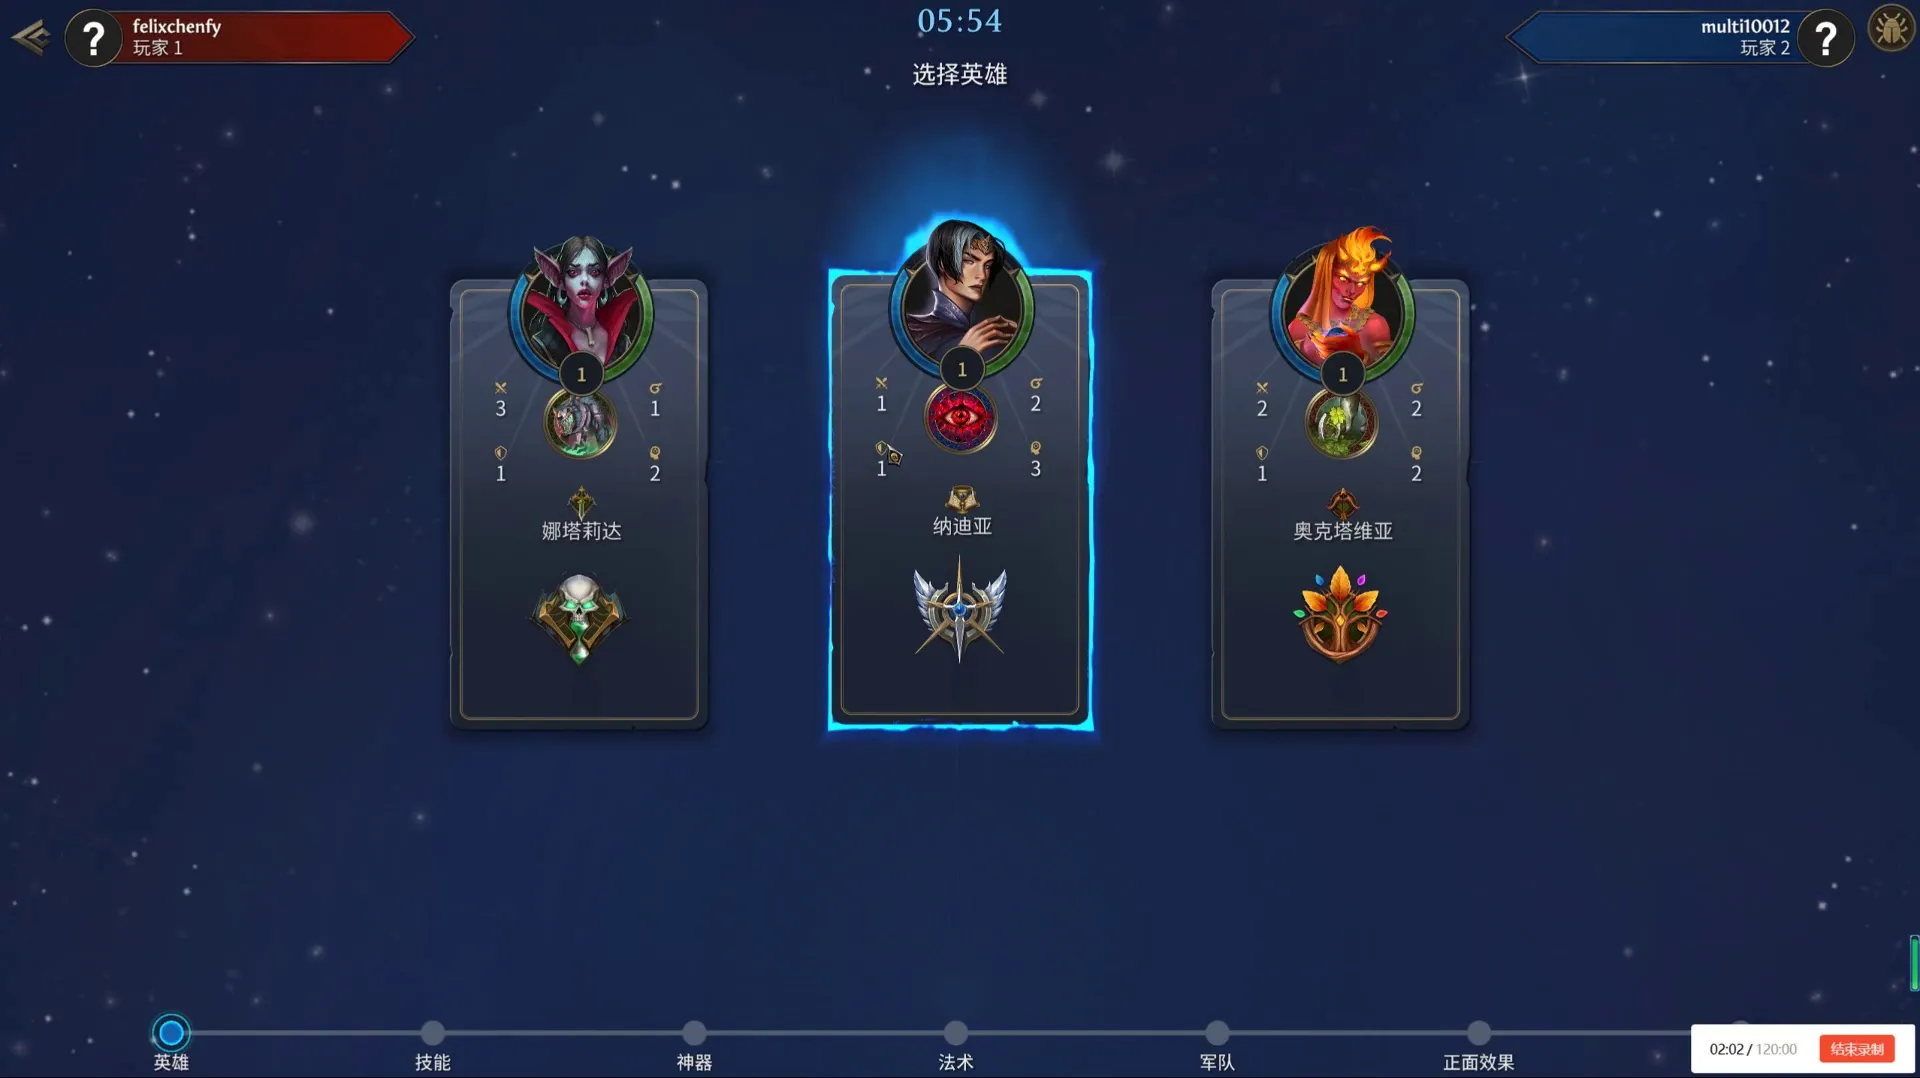 |
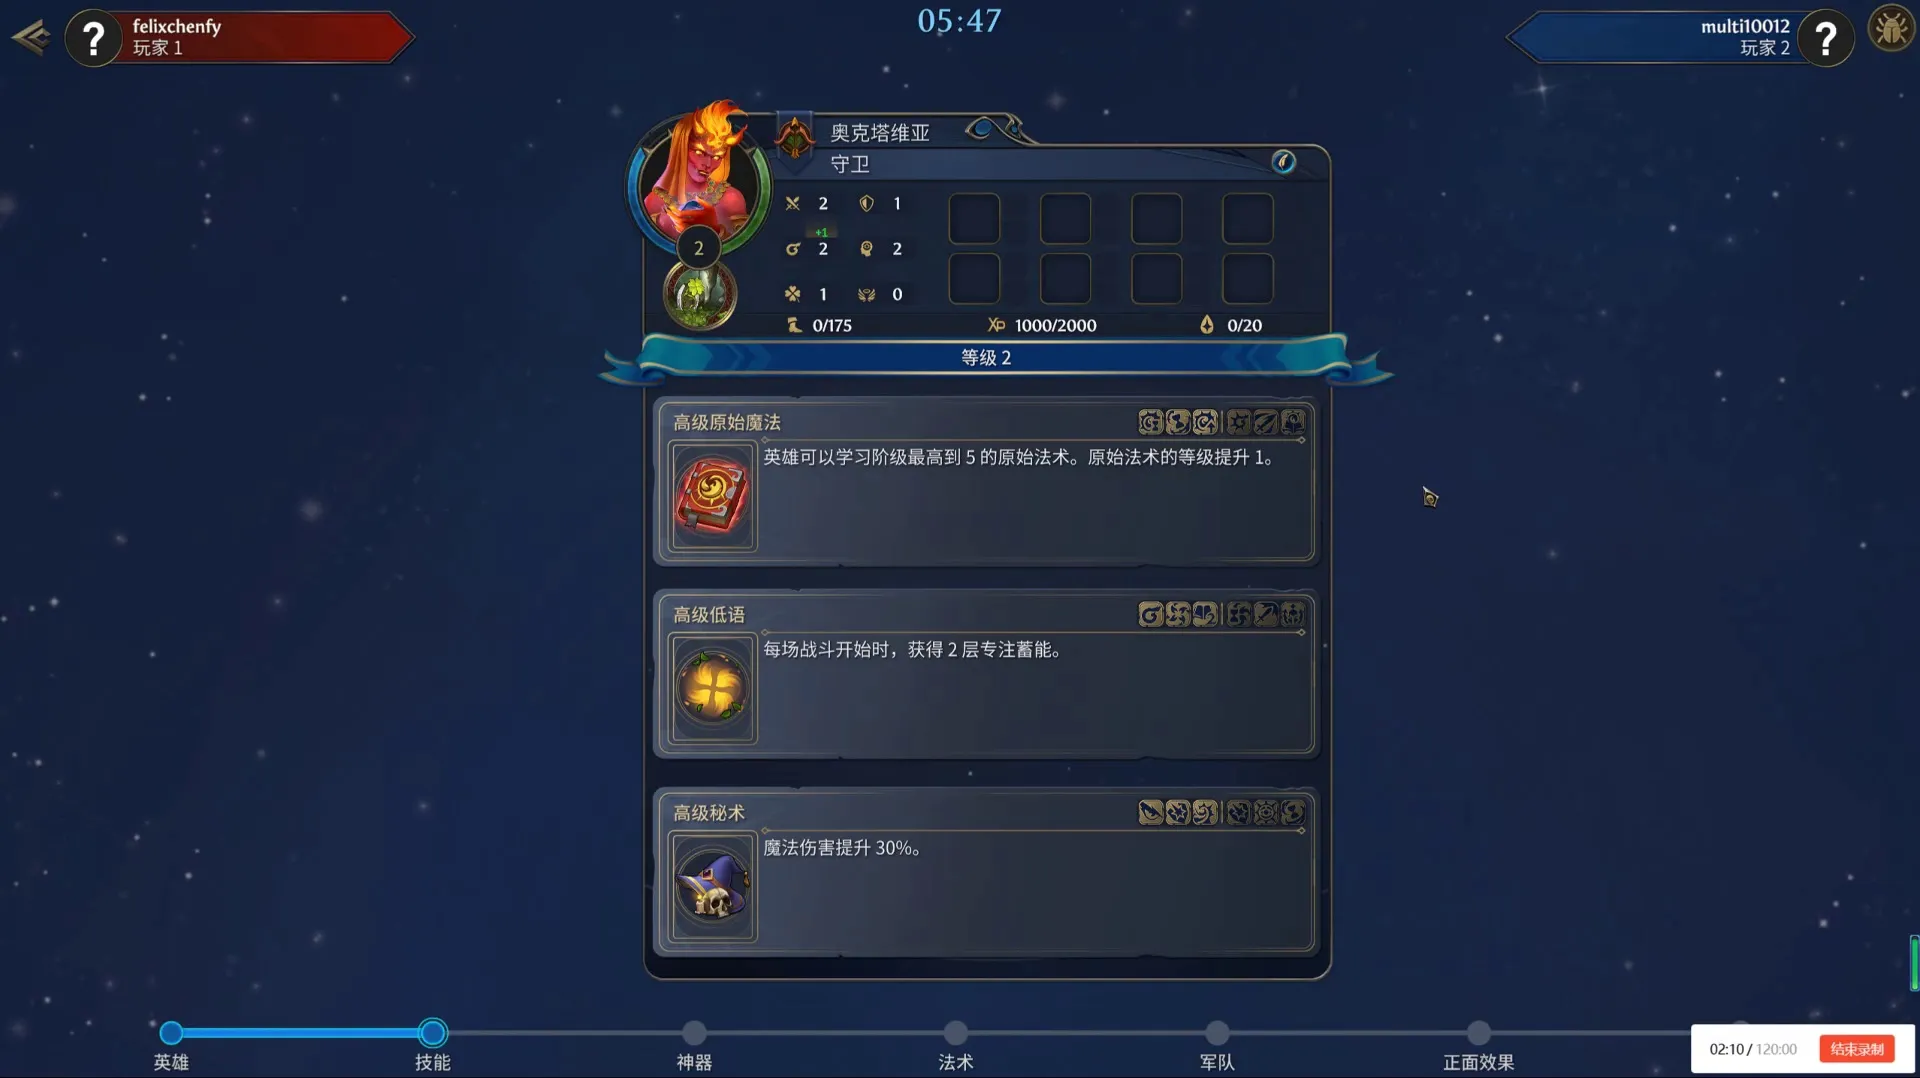 |
| 找到三个英雄头像。 | 找到三个技能图标。 |
| 任务 | 目标 | 候选标签 | 参考图片 |
|---|---|---|---|
| 英雄 | 3 个头像 | 77 英雄 | 77 头像 |
| 主技能 | 3 个图标 | 20 技能 | 60 图标 |
程序只知道图标大致尺寸,不知道常见行列或坐标。固定布局是背景知识,不是输入坐标表。程序也不能返回少于三个结果,因此没有目标的区域仍可能争到输出位置。
2. 一张截图怎样得到三个建议?
流程把几何与识别分开:代码生成矩形决定看哪里,视觉模型判断框内像什么,网络本身不预测坐标。
五步流程如下:
complete screenshot
  → try many box sizes
  → resize each box to ConvNeXt's 128 × 128 input
  → ConvNeXt creates a 768-number feature vector
  → compare it with known icons
先生成大量候选框
方形窗口扫描整图。英雄边长 128–192 像素,技能 72–132 像素。英雄 128×128 尺寸对应 91 列×49 行=4,459 框。全部尺寸合计每图 21,193 个英雄框或 43,134 个技能框。
尺寸是唯一位置相关提示;每种尺寸仍扫整图,所以称为滑动窗口搜索,而非学习式检测器。
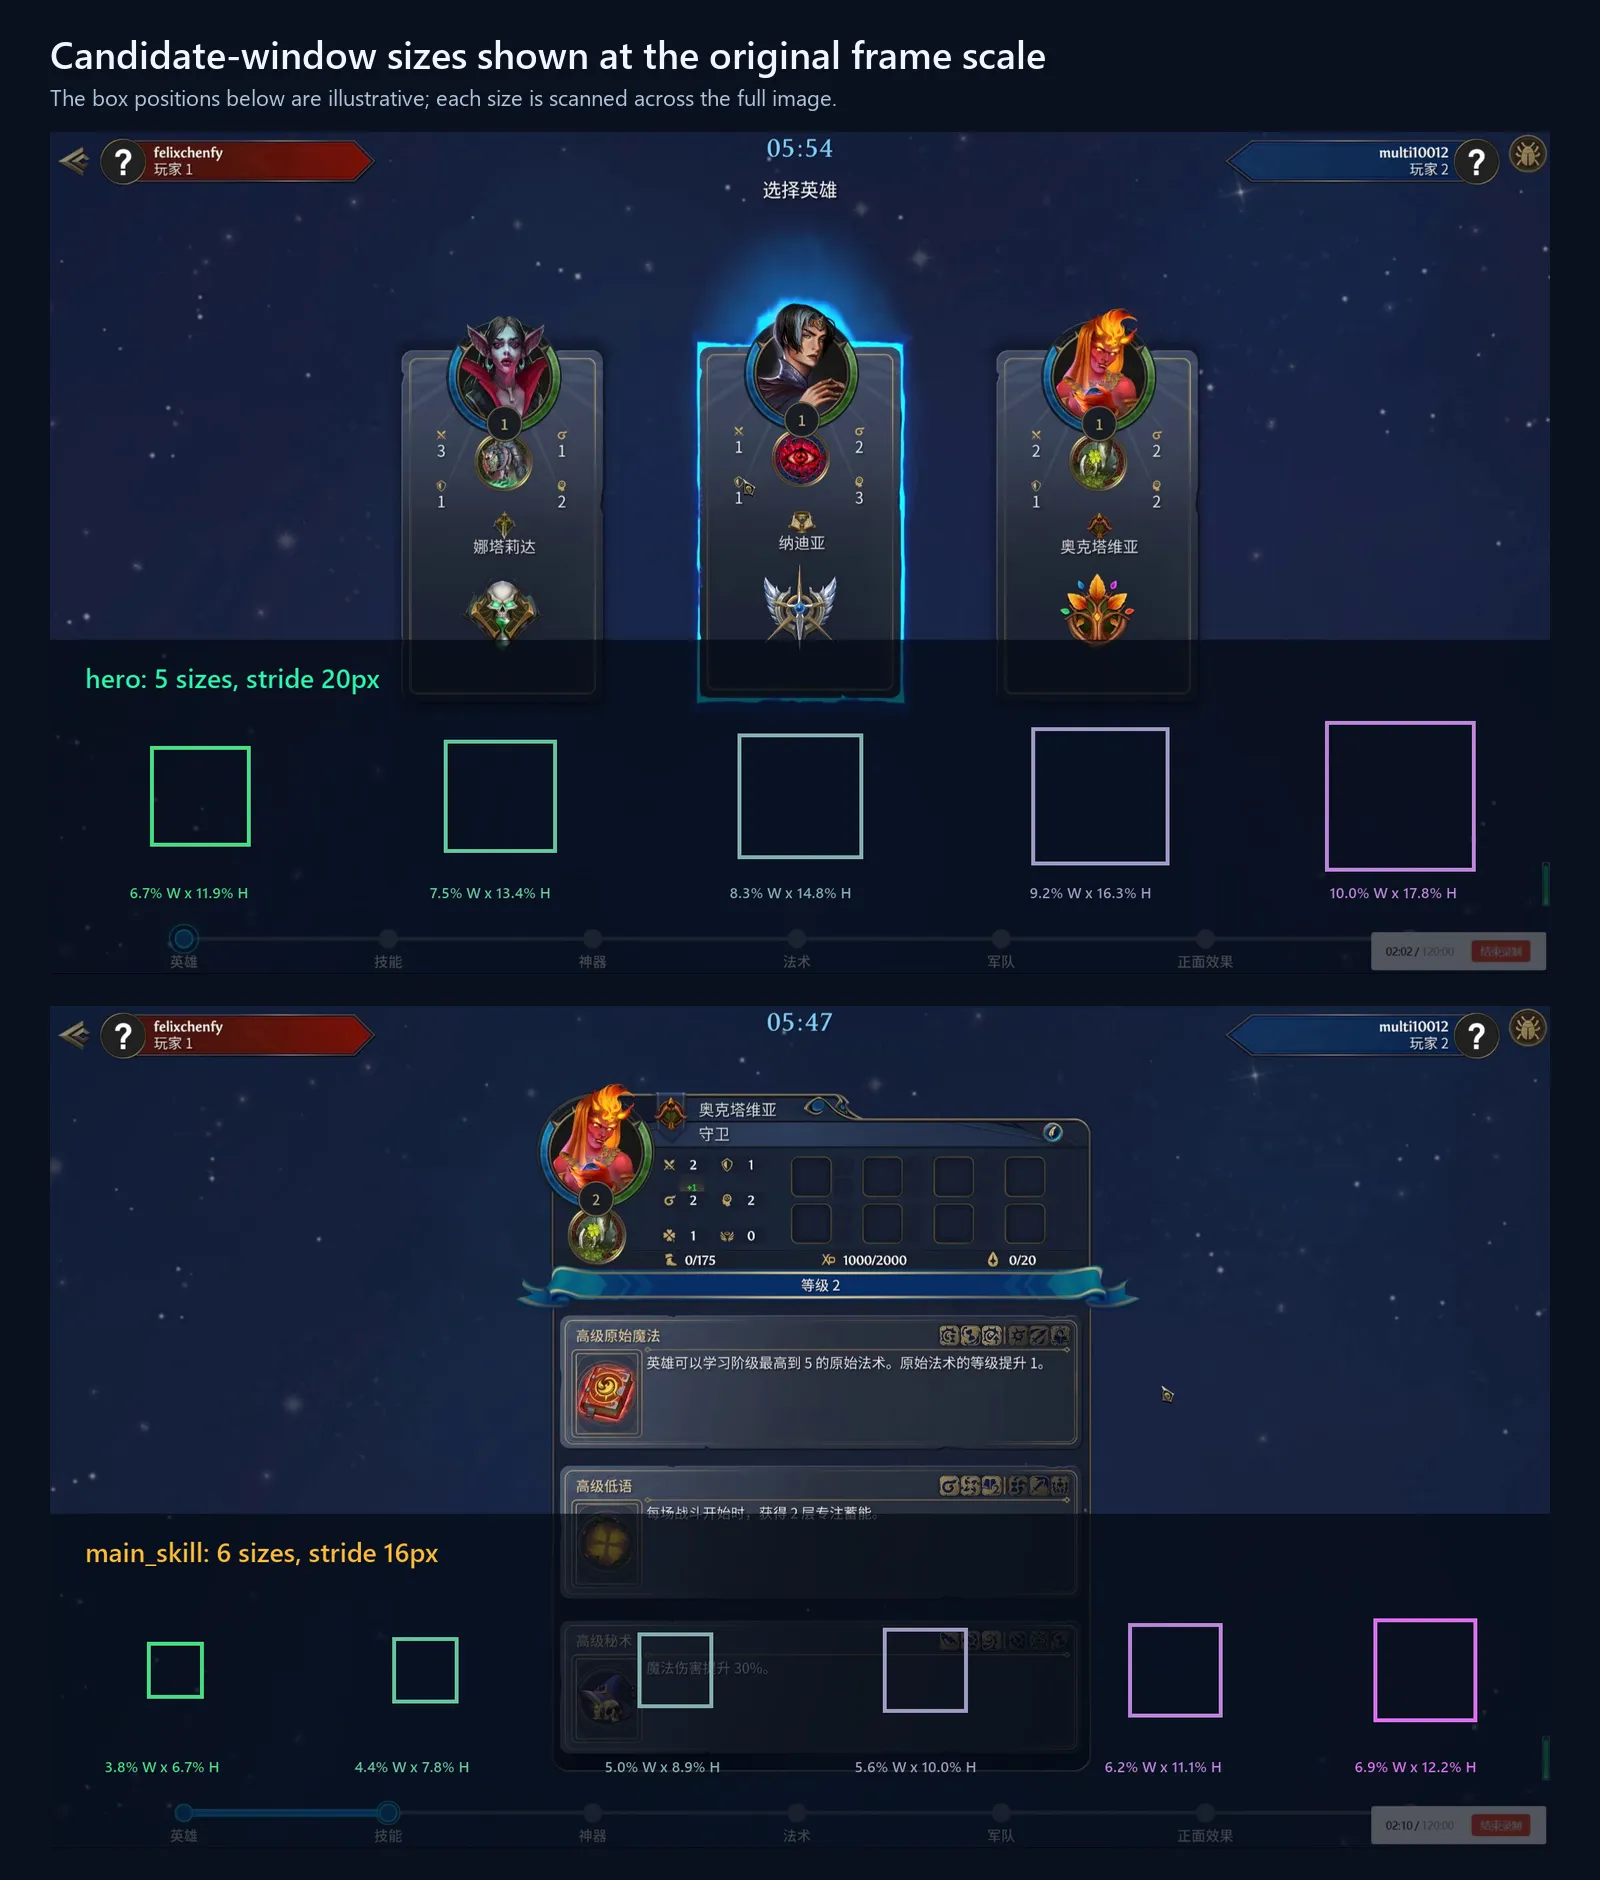
图 2。候选尺寸按真实比例画在原截图上。
把每个框变成 768 个数
RoI Align 把不同大小区域采样成固定输入。ConvNeXt-Tiny 来自 ImageNet 公开预训练,没有为本实验训练游戏图标。它把 128×128 裁图变为归一化的 768 维特征,即 embedding:
candidate box → 128 × 128 RGB → ConvNeXt-Tiny → 768 × 4 × 4
              → global average pooling → LayerNorm → normalized 768-D vector
采用 128×128 是因为原候选已较小,英雄 128–192、技能 72–132 像素。放大到 384×384 会增加计算,却不能增加原始像素。本轮没有测量更大输入是否改善准确性。
截图裁图带边框、发光、缩放和压缩;参考图则是放在简单背景上的干净美术图。这种外观差异让匹配更难。
最后逐框比较全部已知图标
程序计算每个候选向量与每个参考向量的余弦相似度。ConvNeXt 特征相近时得分高。每库只有 60–77 个参考,所以直接做全比较。
技能的基础、高级、专家图归于同一名称。每框按最佳匹配排序,**非极大值抑制(NMS)**保留高分框,移除与它重叠超过 10% 的低分框。重叠较小时,同一图标附近两个框仍可能都留下。
最后强制返回三个框,不能说“这里没有图标”。NMS 只能去掉部分重复,不能移动、缩放或修复坏框。
3. 图鉴里究竟有什么?
本轮参考库为 77 英雄各一个头像,20 主技能各三个等级图:60 张技能图、20 个身份。截图只与指定类型的参考比较。
后续审核移除了 Arcane、Daylight、Nightshade、Primal Magic 的四张错误卷轴参考,所以后续实验用 56 张图、相同 20 个技能身份。本文 60 张是原运行记录,不追溯改写。
透明参考先去空白、补边,再放到三种背景上,分别提取向量并平均:
r(entity, level) = normalize(mean(r_dark-blue, r_dark-gray, r_light-gray))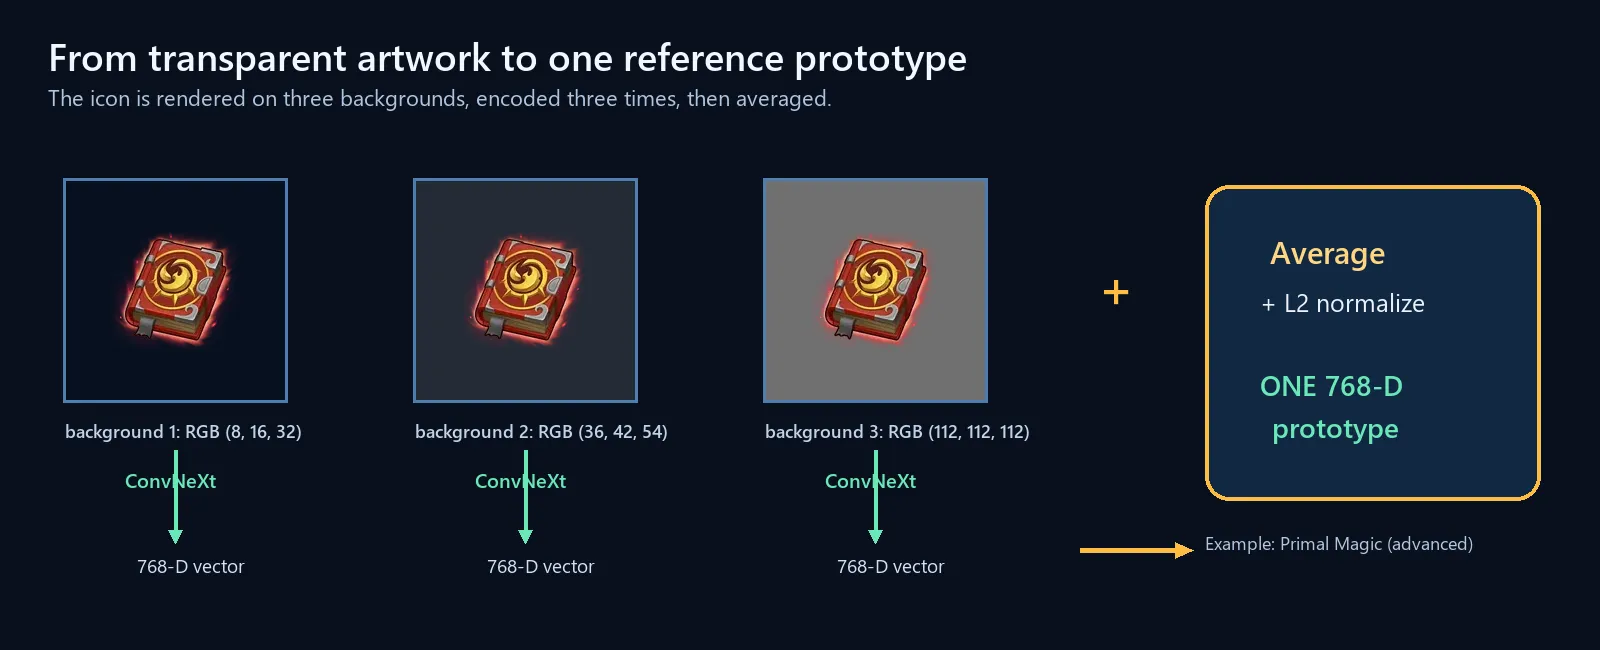
图 3。三种背景版本平均成一个参考向量。
每技能三个参考,只显示三者最高得分。这是视觉特征比较,不是逐像素模板匹配;尚未单独验证三背景或三等级各自是否改善检索。
4. 穷举搜索有多少计算量?
三张英雄图、四张技能图产生 236,115 个框和 1,525 万次框与参考比较。128×128 运行在 RTX 5080 上耗时 28.77 秒。这是一次运行的计时,不是通用速度基准。
5. 七张截图的观察结果
七张中有近重复,因此只展示三张代表帧。每面板有三个选中框及最近图鉴候选。没有完整审核框集,只能定性观察,不能据此报告 precision、recall 或准确率。
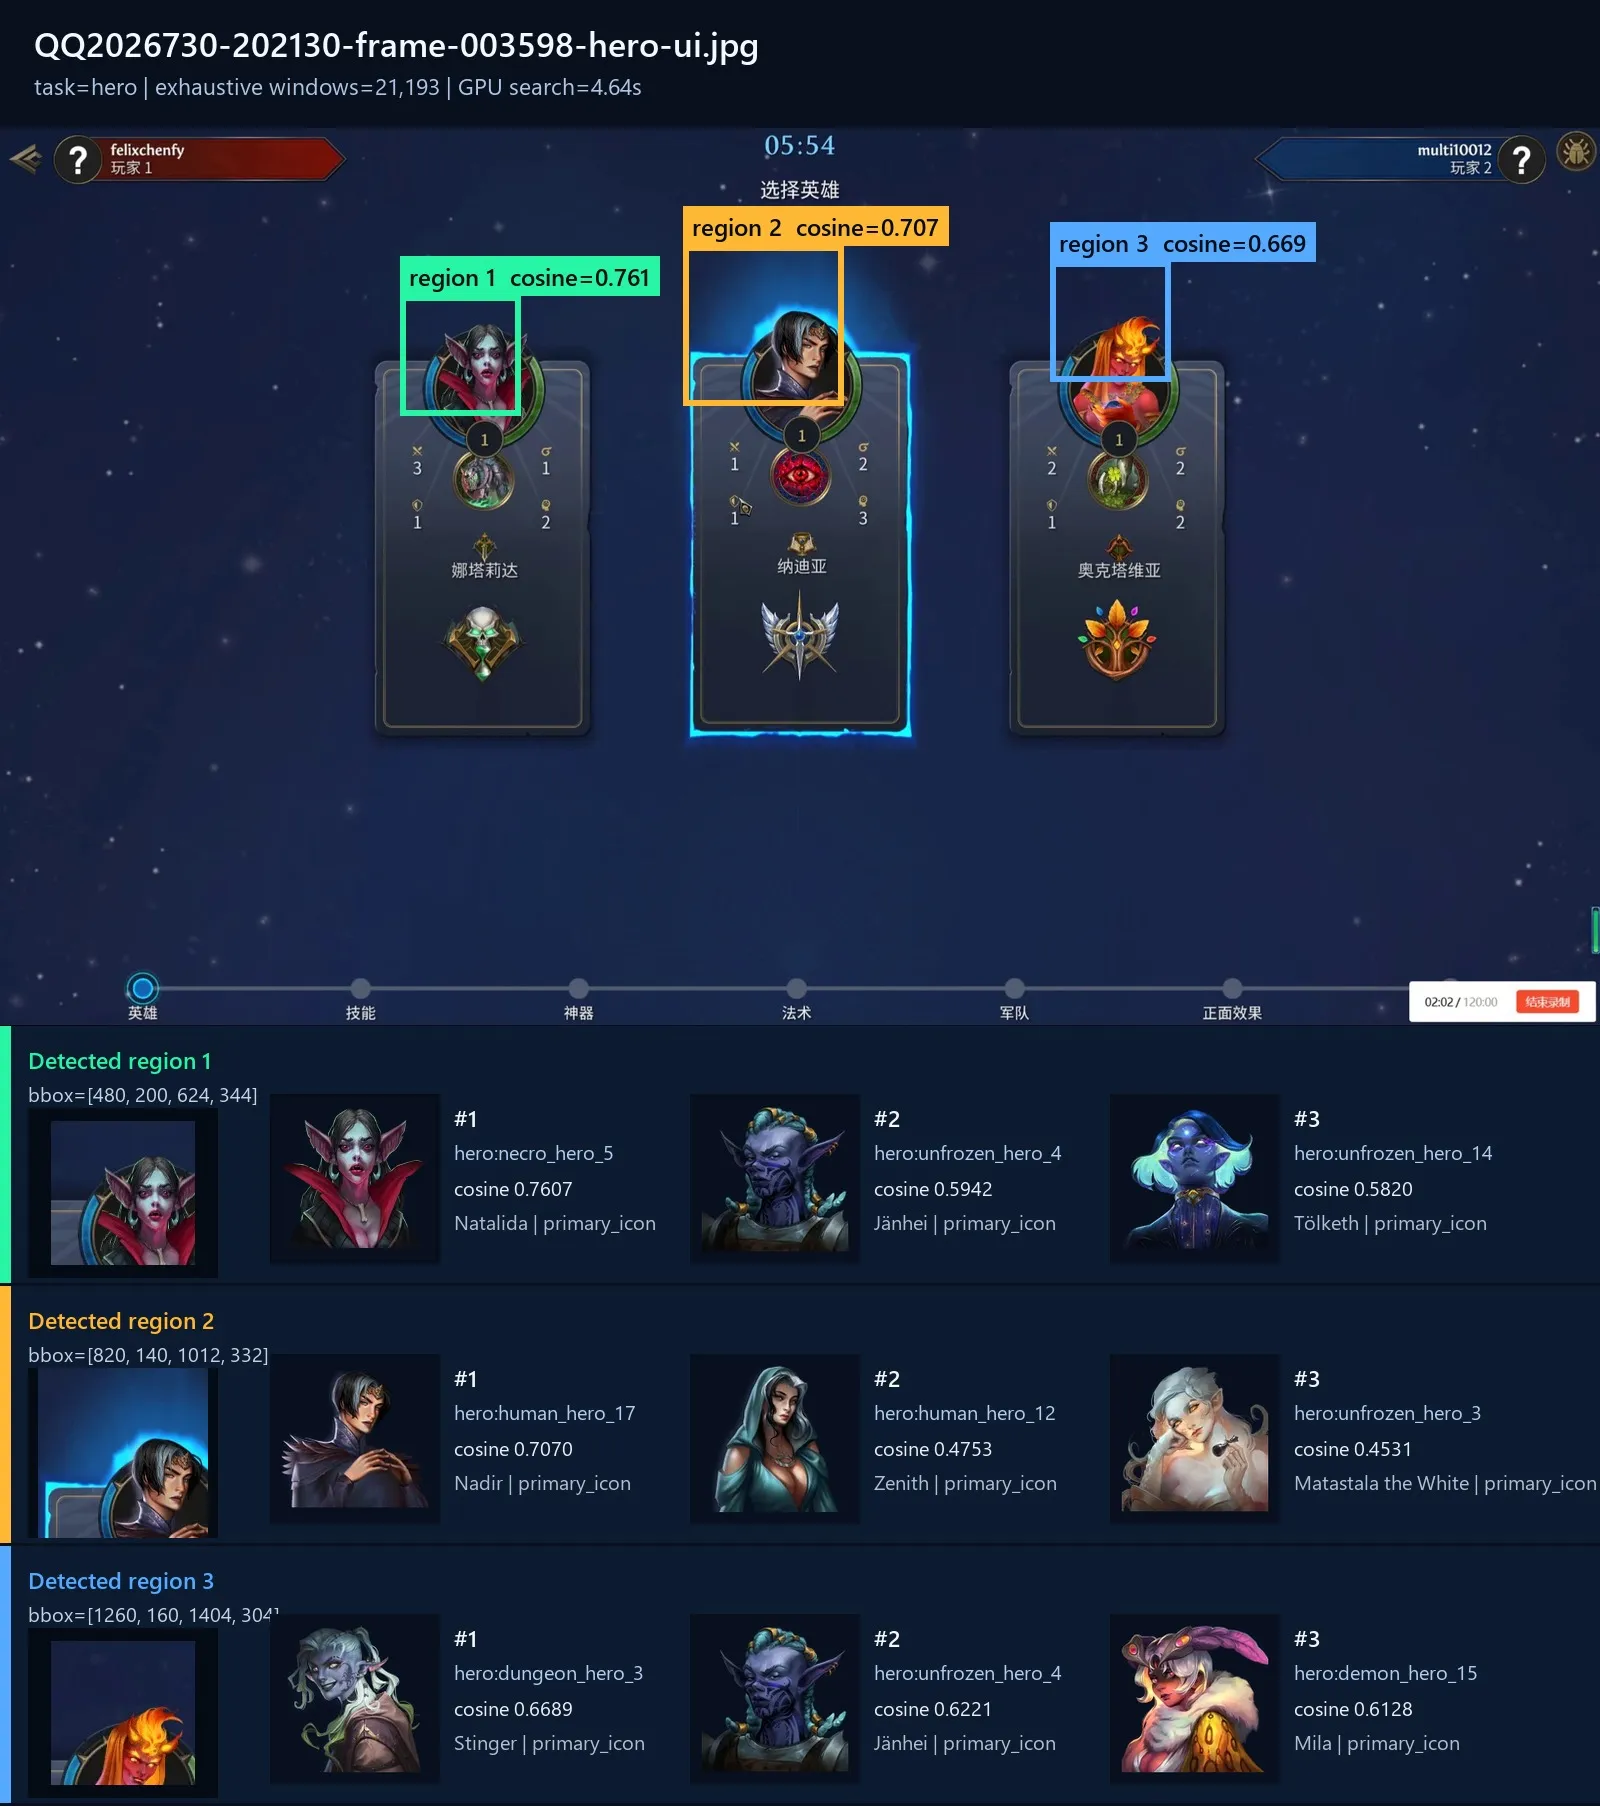
图 4。三个英雄身份都正确;框可用,但未完全对齐。
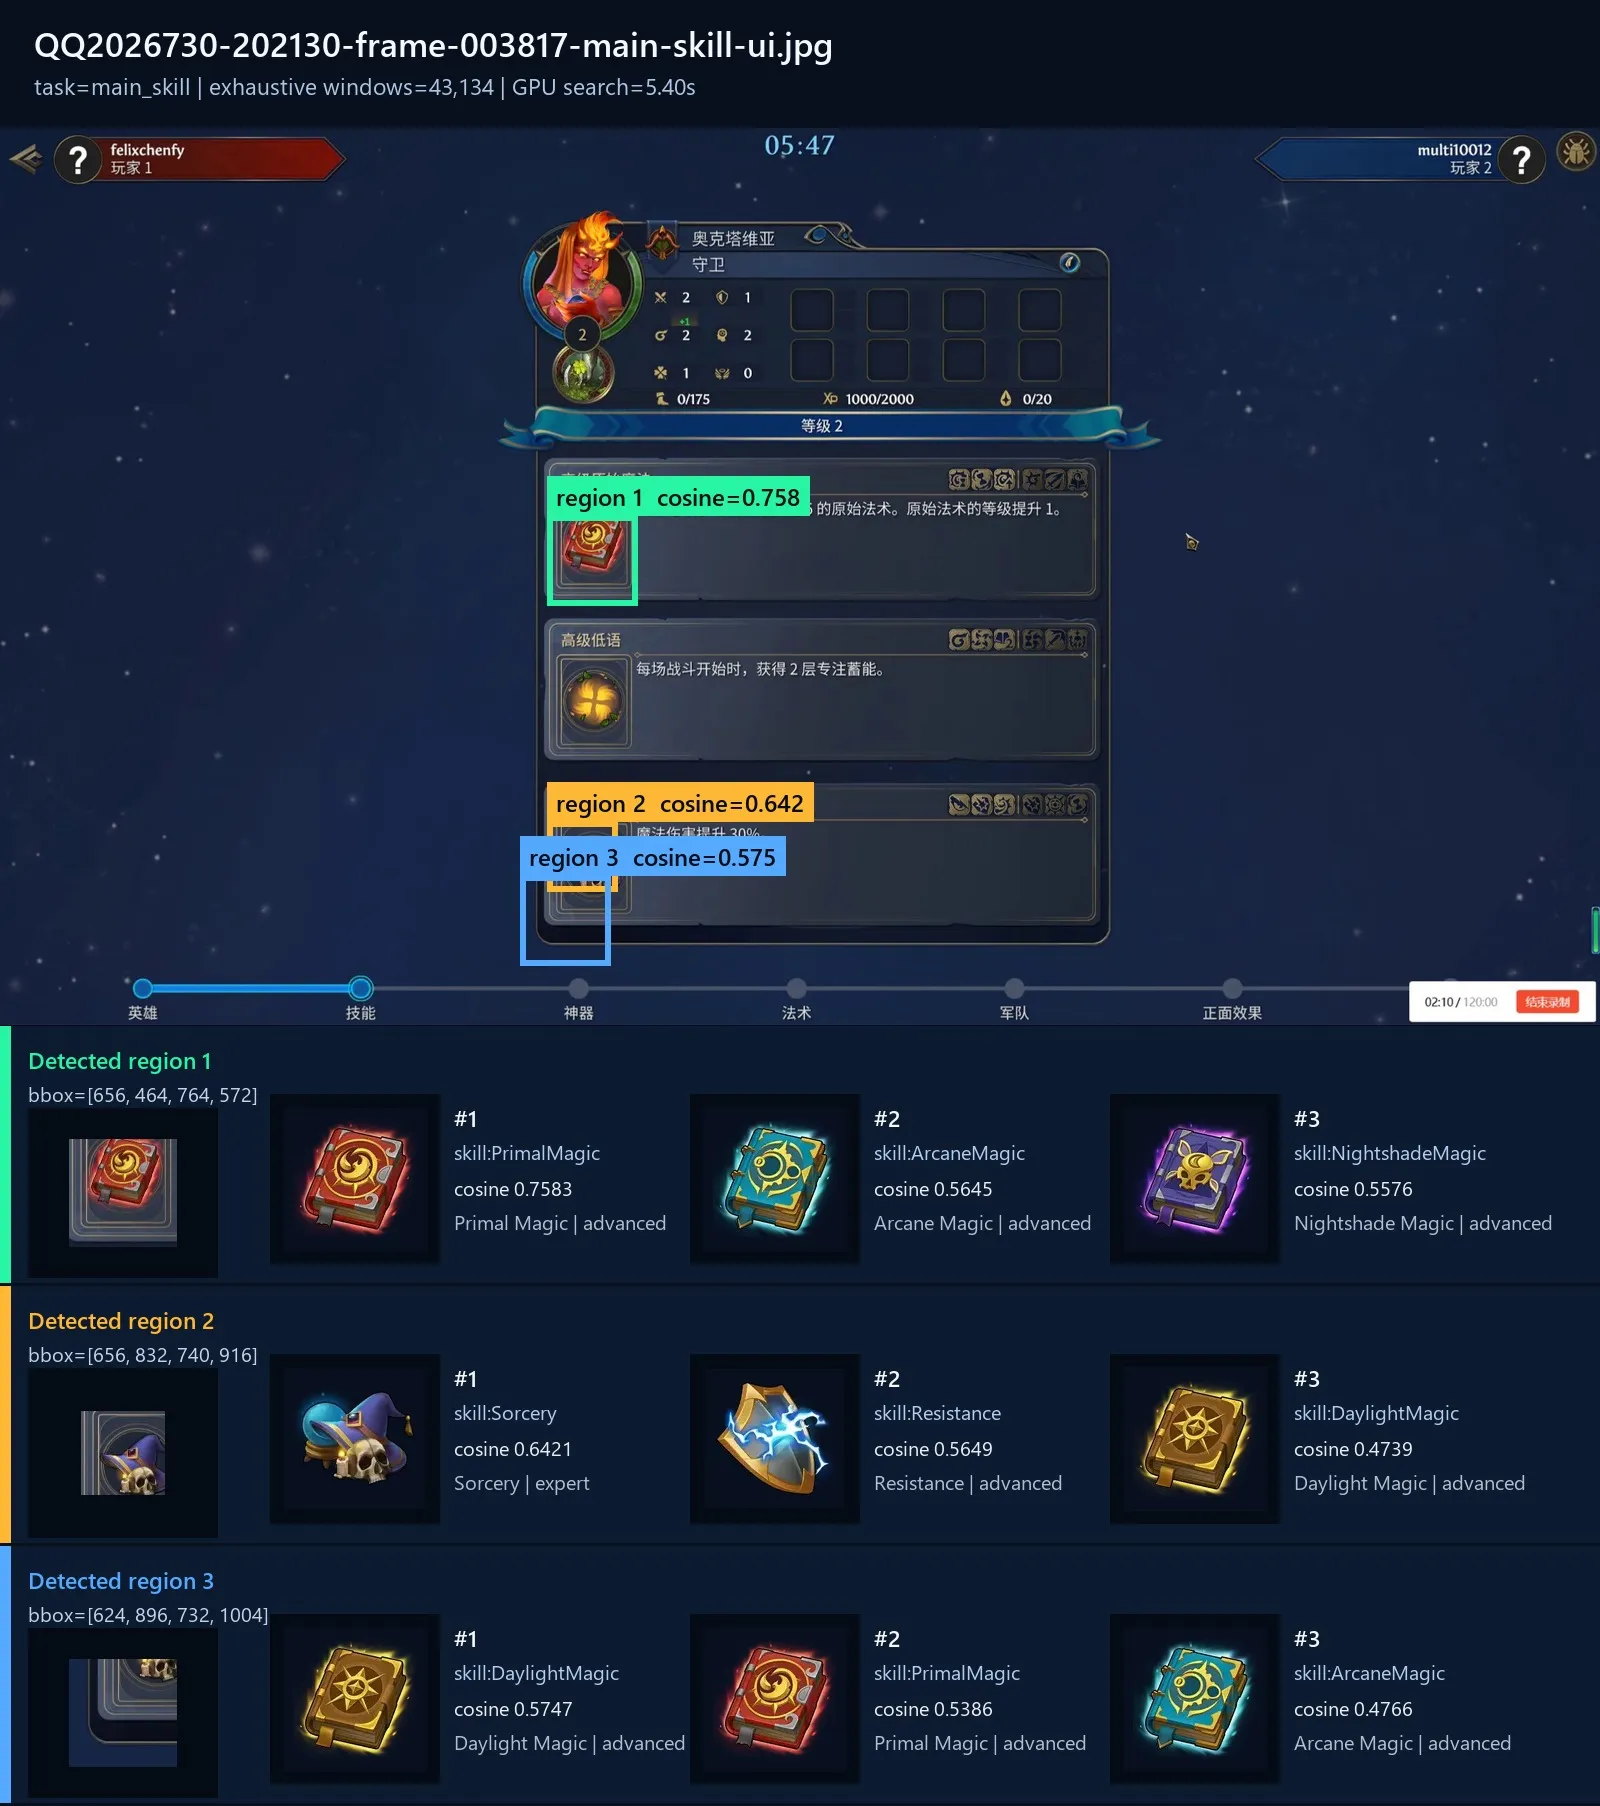
图 5。原始魔法与秘术正确;秘术附近第二个局部框也保留,被误认成日光魔法。
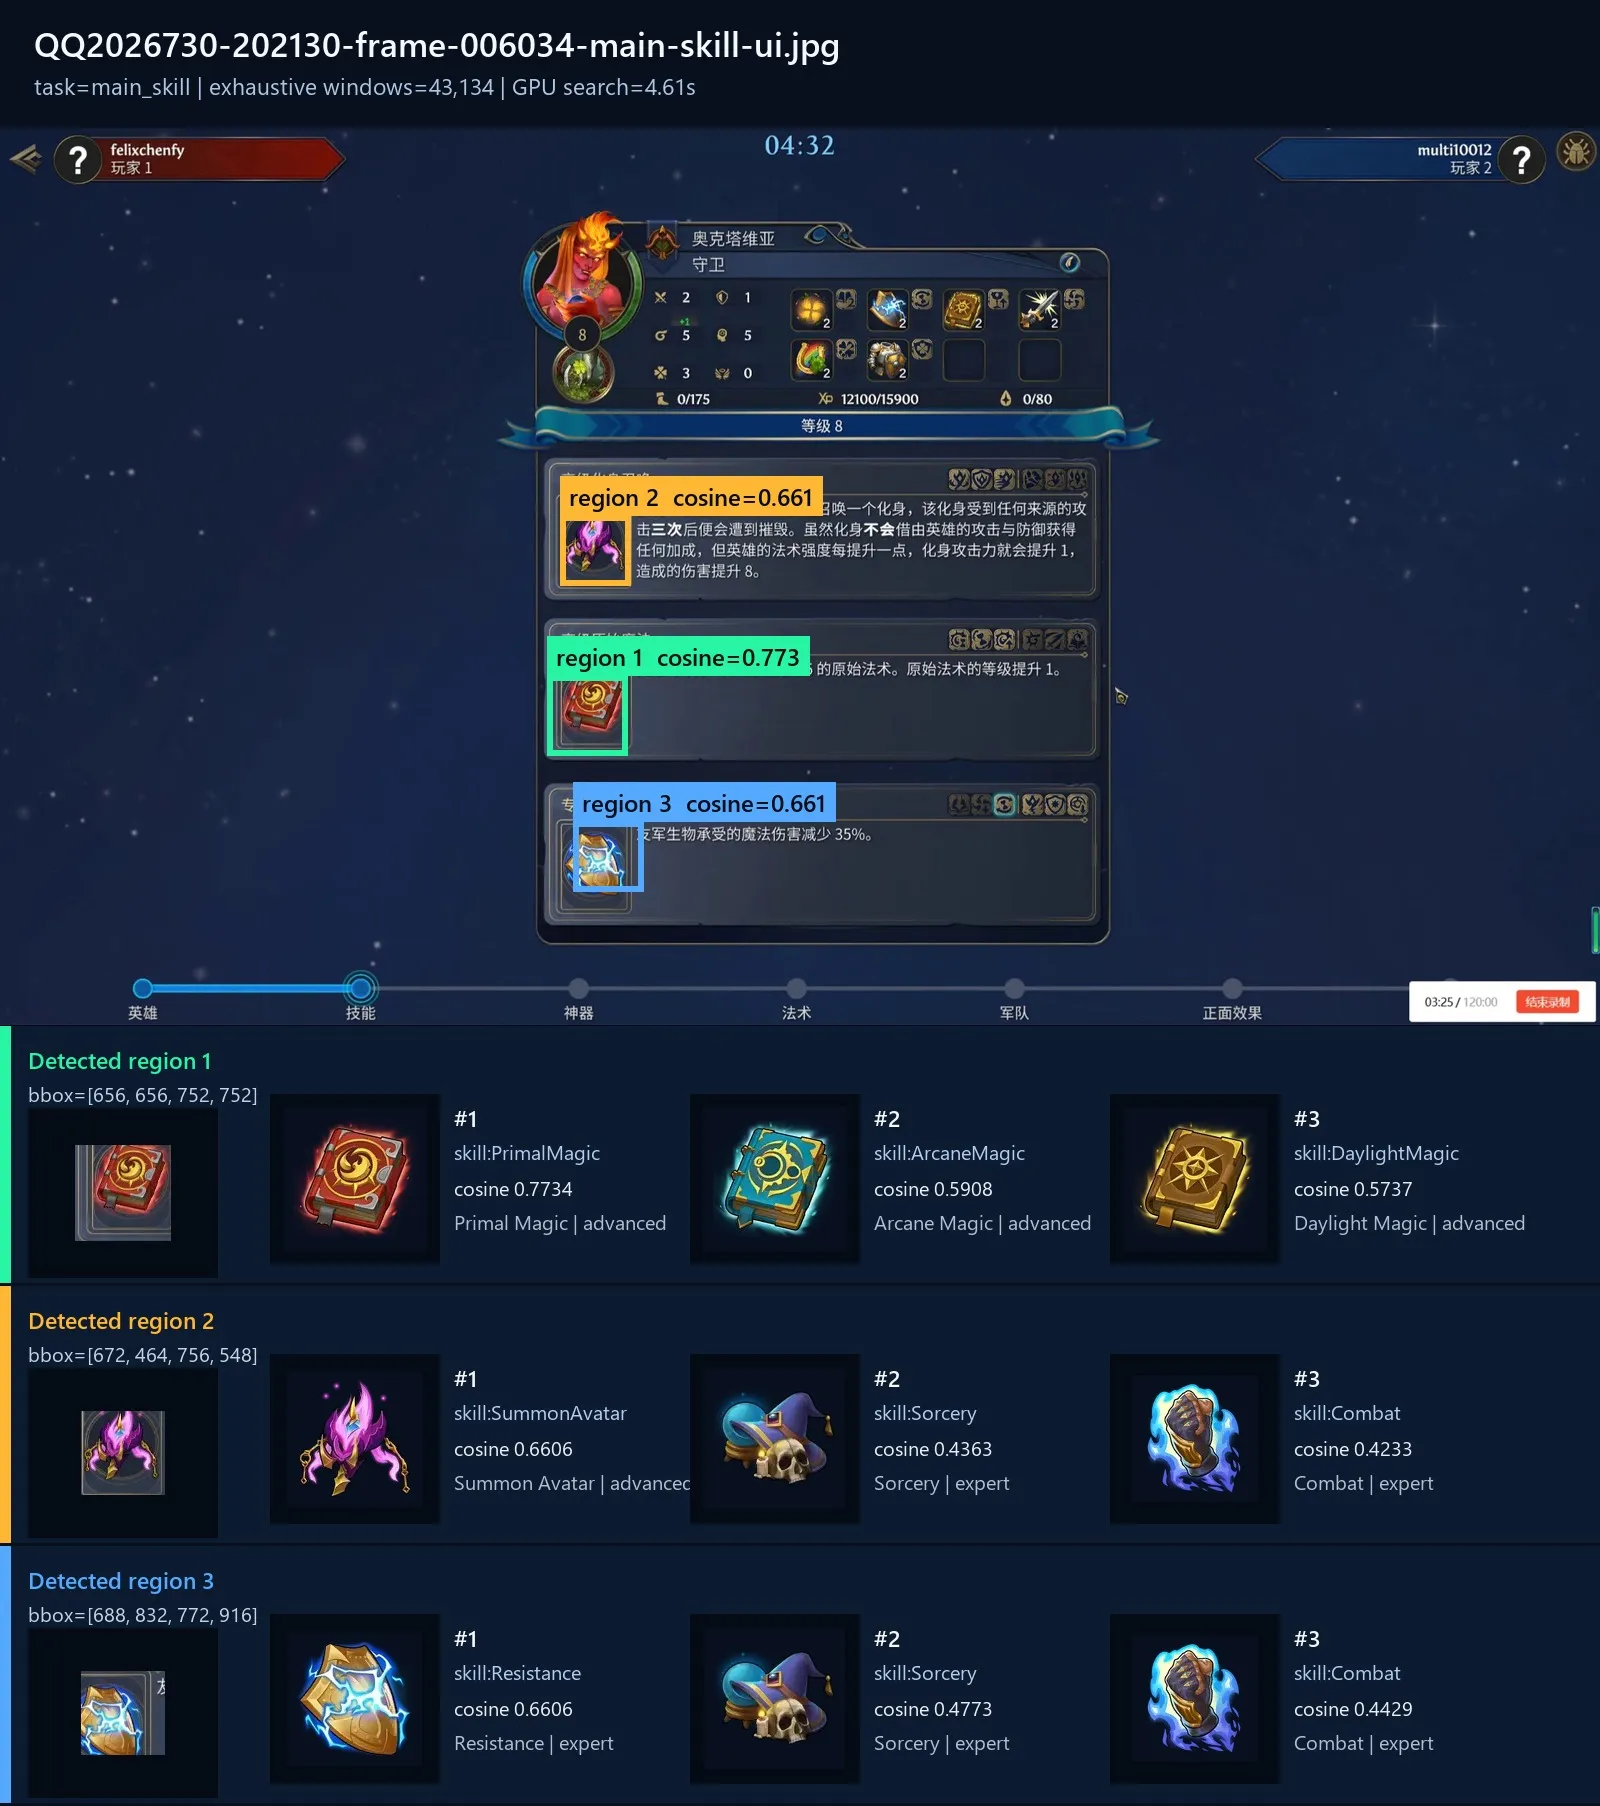
图 6。三个可见技能身份都正确,但框的位置仍有差异。
图 5 最能说明问题:认出原始魔法与秘术,并不能阻止另一个秘术局部框存活并被标成日光魔法。正确身份证据不保证框完整、唯一。
6. 身份正确为何仍切错框?
**同一个分数回答两个问题。**余弦相似度既决定图标在哪里,又决定它是谁。预训练模型测外观相似,却没被教过完整居中框应比局部框分数高。
**局部框也可能看起来熟悉。**局部细节足以获得高分,平均池化把空间图压成向量,最终表示不明确说明图标是否完整或居中。
**尝试上万框会产生偶然高分。**大量坏框竞争且必须输出三个,无“都不是”选项,无关 UI 也可能入选。尺寸与 NMS 也会出错,需要人工框才能区分识别、定位与拒识失败。
7. 下一实验改什么?
后续训练共享图像模型识别带标签图鉴,再单独学习裁图质量。位置、尺度、补边、边框、发光和背景小幅变化可展示同一身份的正常变体。已完成的后续覆盖英雄、主技能、生物、宝物,不包括法术。
严重切歪或残缺框不应都当作正常身份样本,而应监督独立问题:“图标是否完整且对齐?”身份检索和框质量分别评估,不让一个余弦分数包办。
8. 结论
七帧上,通用 ConvNeXt 经常能检索对可见英雄与主技能,可作为标注起点。主要失败是定位和拒识:局部框也可高分,且流程强制三个答案。下一实验训练游戏图鉴特征、单独监督质量,并分别评分。
继续阅读图鉴训练骨干的滑动窗口检测。它沿用搜索形式,但训练特征并单独学质量;224×224 输入与审核后的图鉴都不同,因此不是本文七帧 128×128 基线的直接重跑。
Comments